GeoRA: 为RLVR设计的LoRA——ACL 2026杰出论文解析
原创 美团履约平台 2026-08-27 10:24 北京
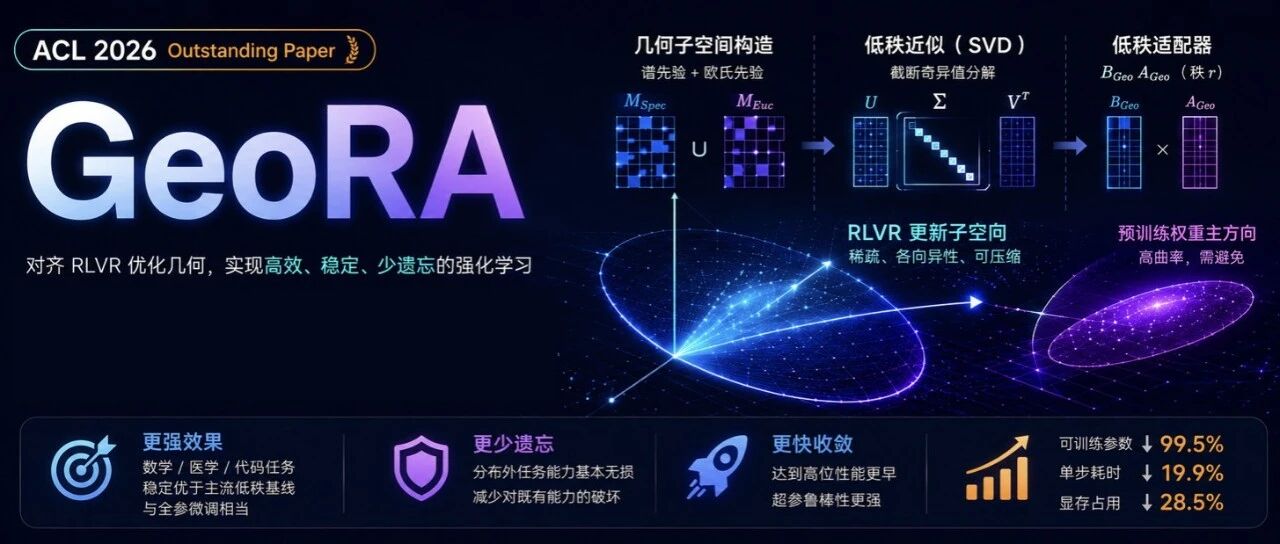
本文介绍了一种专为 RLVR 设计的低秩训练方法,以及它在业务 Agentic RL 中的落地经验。
点亮👆“☆”星标,不错过推送内容~
全文速读
ACL(Annual Meeting of the Association for Computational Linguistics)是计算语言学和自然语言处理(NLP)领域的国际顶级学术会议,属于 CCF-A 类会议,也是中国计算机学会推荐的自然语言处理方向最高等级国际学术会议。ACL 2026杰出论文奖(Outstanding Paper)在圣地亚哥揭晓,全球共 18 篇入选,美团履约技术团队的《GeoRA:Geometry-Aware Low-Rank Adaptation for RLVR》 就是其中之一。
🎈我们还在文末增加了读者互动环节,欢迎大家晒出自己的见解、思考,分享实践经验,一起交流学习。
本文目录
01 背景、洞察和目标
1.1 RLVR的优化几何
1.2 现有PEFT的错位
1.3 GeoRA 的目标
02 方法:GeoRA 的构造
2.1 构造几何子空间
2.2 低秩近似构造适配器
2.3 建立残差锚点
03 实验验证
3.1 数学推理与分布外能力
3.2 医学与代码领域
3.3 收敛效率与稳定性
3.4 计算效率
3.5 低秩结构分析
04 业务应用
05 总结
RLVR已经成为提升大模型推理能力的关键范式,但它的训练开销较高,于是一个自然的技术就是用 LoRA 这类参数高效微调方法来做 RLVR。但是,LoRA 及其变体几乎都是在 SFT 场景下建立并验证的。而近期一系列机制研究表明,RLVR 与 SFT 的优化几何存在本质差异:RLVR 则更像一次受约束的优化,有效更新分散在稀疏的子空间中,并倾向于避开预训练权重的主方向。因此,把为 SFT 设计的先验直接搬到 RLVR 上,就构成了几何错位,后果是效果欠优、能力遗忘甚至训练崩溃。
针对这个问题,美团与北京大学的研究者提出了 GeoRA(Geometry-Aware Low-Rank Adaptation),把低秩适配显式地对齐到 RLVR 的更新几何上:先用几何先验定位出 RLVR 偏好的稀疏更新区域,再用 SVD(奇异值分解)把它压缩成低秩稠密的适配器。在 1.5B 到 32B 的 Qwen 与 Llama 模型上,GeoRA 在数学、医学、代码三类 RLVR 任务上稳定优于流行的低秩基线。该工作已被 ACL 2026 接收为杰出论文(Outstanding Paper)。
本文介绍了一种专为 RLVR 设计的低秩训练方法,以及它在业务 Agentic RL 中的落地经验。
01 背景、洞察和目标
以 OpenAI o1、DeepSeek-R1 为代表的大型推理模型,把 RLVR 确立为解锁复杂推理能力的关键范式。要理解为什么现有 PEFT 方法在这个范式下不够好,得先看清 RLVR 的更新究竟长什么样。
| 1.1 RLVR的优化几何
近期一批机制分析工作勾勒出了 SFT 与 RLVR 的分野,表明两者的优化几何存在本质差异:SFT 通过改写权重的主方向来显式注入新信息,RLVR 更像一次受约束的优化,它靠奖励诱导的采样偏置放大模型推理行为,有效更新分散在稀疏的子空间中,并倾向于避开预训练权重的主方向。这个画像还有另一面——RLVR 对更新稳定性敏感,它需要在类信赖域边界内做策略更新,过于激进或落在主方向上的更新则容易引发谱漂移、探索多样性坍塌乃至训练崩溃。
| 1.2 现有PEFT的错位
几何错位。LoRA 及其变体是当前的事实标准,它们的一个关键差异在于采用了什么谱先验:LoRA 用高斯和全零初始化,与预训练权重无关;PiSSA 对原始权重做 SVD,把可训练预算都分配给主奇异方向;MiLoRA 则取尾部奇异方向。这些先验主要在 SFT 场景下被设计和验证,没有考虑上一节描述的 RLVR 更新规律。以 PiSSA 为例,它把更新强行推到主成分上的强归纳偏置,恰好与 RLVR 偏好的子空间相冲突,这也预示了实验中更容易崩溃的现象。
工程错位。一种直观的做法是:既然 RLVR 只更新一小部分参数,那直接对这个子空间做稀疏微调就好了。这种方式在更新模式上确实更契合 RLVR 的偏好,但现代 GPU 对非结构化稀疏计算并不高效,减少参数量并不意味着效率提升。本文的效率实验里,稀疏微调把训练参数降低 68.0%,训练耗时却增加了 10.8%。
| 1.3 GeoRA 的目标
一边是计算友好但几何不对,一边是几何对但算不快。GeoRA 要同时解决这两个错位,目标即定位契合 RLVR 的稀疏子空间,用低秩稠密的方式去训练它。
02 方法:GeoRA 的构造
GeoRA 可以拆成三个步骤:
构造几何子空间:基于谱先验和欧氏先验,从预训练权重中筛出更稳定、更可塑的参数区域。
低秩近似构造适配器:用 SVD 对几何子空间做低秩近似,用以初始化低秩适配器。
建立残差锚点:将残差权重冻结,使模型初始化时函数不变,平滑冷启动并保护预训练结构。
整个过程只在训练开始前执行一次,属于一次性预处理;训练阶段的计算图与标准 LoRA 完全一致。
| 2.1 构造几何子空间
我们用两个互补的掩码(Mask)从预训练权重矩阵 W 中筛选参数区域,两者共用同一个稀疏率 ρ。
谱先验 M_Spec 强调稳定性。 先对 W 做秩为 r 的低秩近似得到 Ŵ_r,然后选出 Ŵ_r 中幅值最小的 ρ 比例位置。直觉上,主成分中的高幅值分量也是高曲率区域,改动它们容易破坏预训练结构;把更新限制在低幅值区域,可以改善 RLVR 下的谱稳定性。
欧氏先验 M_Euc 强调可塑性。 直接在原始权重 W 上选出幅值最小的 ρ 比例位置。这些接近零的参数在预训练中被「用得少」,可调整空间大,能为训练保留足够的自由度。
最终的几何约束矩阵取两者的并集:W_Geo = W ⊙ (M_Spec ∪ M_Euc)。
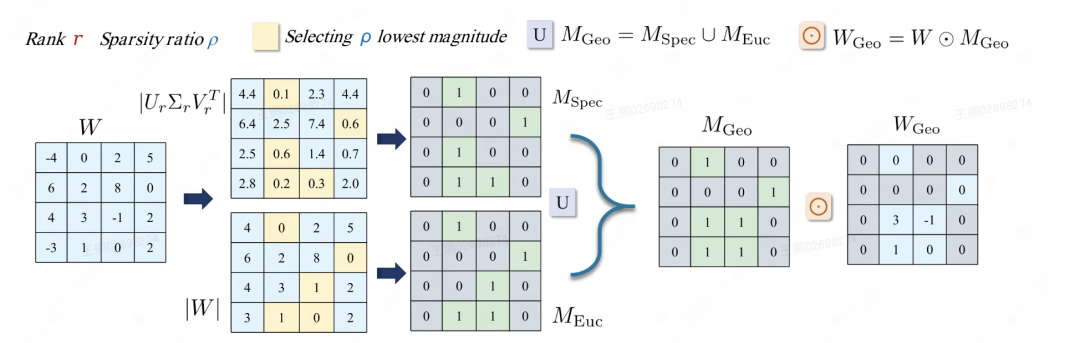
两个掩码看起来规则相似,实际选出的参数集合却很少重叠。例如,在 Qwen3-8B 上取 ρ = 0.2,两者各选中 20.0% 的参数,但交集只有 4.55%,Jaccard 相似度仅 0.128。这说明它们捕捉的是两类不同的参数区域,是互补而非冗余关系,论文中的消融实验也印证了这一点:去掉任何一个先验都会带来性能下降。
| 2.2 低秩近似构造适配器
拿到 W_Geo 之后,对它做 SVD:
W_Geo = U_Geo Σ_Geo V_Geoᵀ
取前 r 个奇异分量来初始化两个低秩矩阵:
A_Geo = Σ_Geo[:r,:r]^(1/2) · V_Geo[:,:r]ᵀ
B_Geo = U_Geo[:,:r] · Σ_Geo[:r,:r]^(1/2)
这样 B_Geo A_Geo 就是 W_Geo 的最优秩-r 近似(Eckart–Young 定理保证了 Frobenius 范数下的最优性)。
这里有一个容易被忽略的要点:GeoRA 取的是 W_Geo 的 top-r 方向,而不是原始权重 W 的 top-r。适配对象的变化,是 GeoRA 与 PiSSA / MiLoRA 的核心区别。
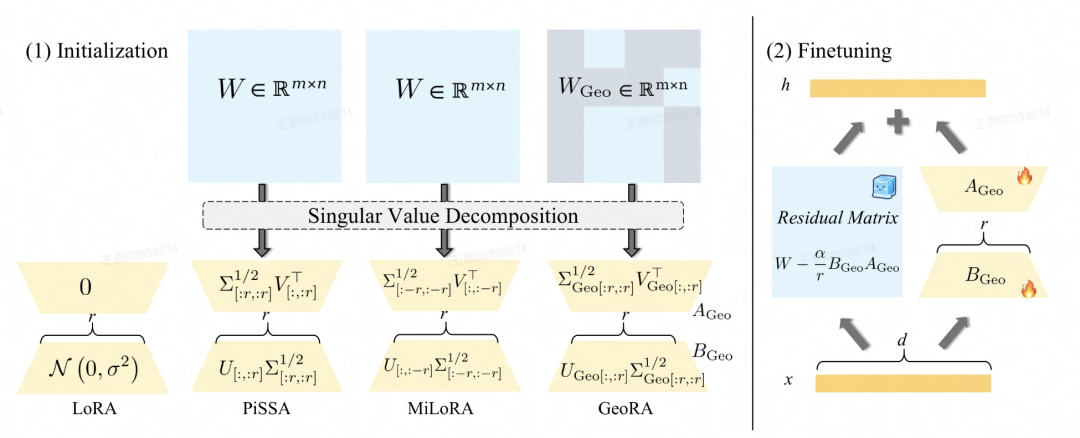
从这个角度看,四种方法的区别可以概括为一句话:LoRA 不看权重,PiSSA 看主方向,MiLoRA 看尾方向,GeoRA 先换一个更合适的适配对象,再在其中取主方向。
| 2.3 建立残差锚点
最后一步是把剩余权重冻结。按照 LoRA 的缩放约定计算残差矩阵:
W_res = W − (α / r) · B_Geo A_Geo
前向传播时,W_res 冻结,只有适配器可训练:
h = W_res x + (α / r) · B_Geo A_Geo x
这个设计带来两个性质。一是初始化时函数不变,因为两项之和恰好等于 W x,训练启动时模型输出不会突变,避免了冷启动阶段的策略抖动——这对 RLVR 很重要,初期的输出扰动会污染 rollout 采样分布。二是施加了结构约束:优化器只能在 A_Geo、B_Geo 参数化的流形上更新,W_res 作为稳定锚点,防止预训练表示被破坏。
03 实验验证
主实验在 DeepMath-103K 上用 GRPO 算法对 Qwen3-8B 和 Llama-3.1-8B 做数学 RLVR,对比对象包括 LoRA、PiSSA、MiLoRA、稀疏微调(SparseFT)和全参微调(FullFT)。同时在 4B 与 1.5B 模型上用 GSM8K 做了规模验证。
| 3.1 数学推理与分布外能力
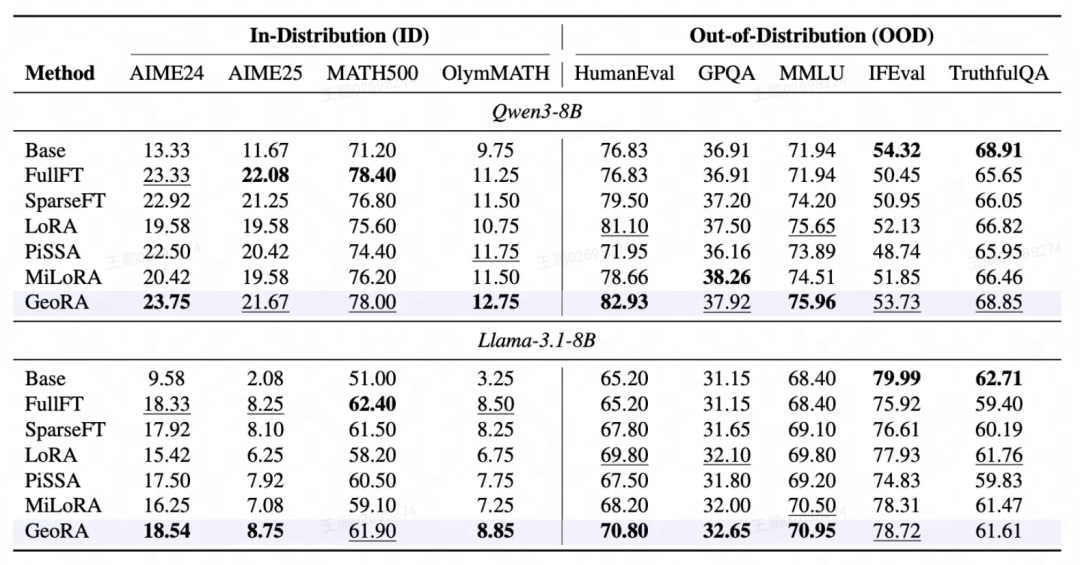
在分布内(ID)的数学基准上,GeoRA 在两个骨干模型上都取得了最强的整体表现,对低秩基线的领先在竞赛难度的基准上尤为一致——Qwen3-8B 的 AIME24 达到 23.75%,甚至略高于全参微调。
分布外(OOD)结果更值得关注:全参微调在 IFEval、TruthfulQA 上都出现了明显回退,而 GeoRA 基本无损,HumanEval 反而从 76.83 提升到 82.93。
这说明在几何对齐的子空间更新,可以在提升目标域推理能力的同时,显著减少对既有能力的遗忘。
| 3.2 医学与代码领域
为了确认收益不局限于数学,我们在医学和代码场景做了扩展实验。
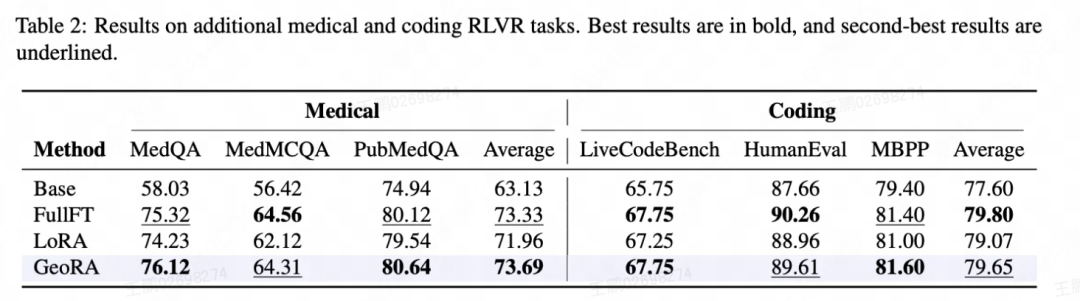
两个领域的结论一致:GeoRA 稳定优于低秩基线,并与全参微调相当。
| 3.3 收敛效率与稳定性
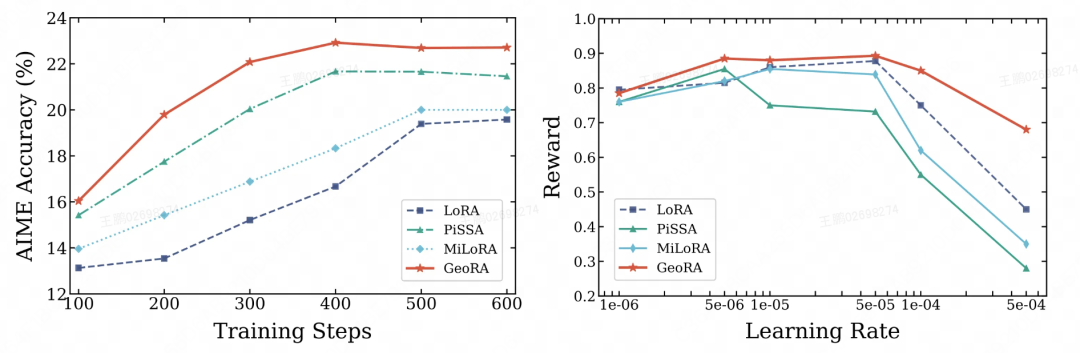
收敛效率更高。在训练动态上,GeoRA 全程保持领先,并且达到高位性能的时间点显著早于其他低秩基线。
超参鲁棒性更强。这里以学习率为例,GeoRA 在很宽的区间内都维持高奖励,其他方法在大学习率下明显下滑。这意味着实践中 GeoRA 无需精心超参调优。
| 3.4 计算效率
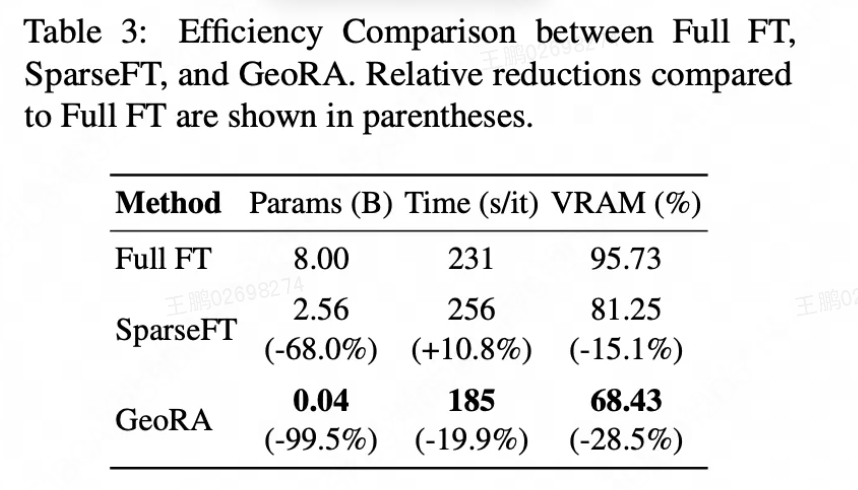
相比全参微调,GeoRA 使可训练参数降低 99.5%,单步耗时降低 19.9%,显存占用降低 28.5%。对照 SparseFT 的数据可以看得更清楚:它虽然把参数降了 68.0%,但单步耗时反而上升了 10.8%。GeoRA 的关键工程价值,就在于把几何先验落成了稠密低秩计算,因此参数效率能够真正转化为速度与显存收益。
| 3.5 低秩结构分析
我们进一步做了结构性分析:W_Geo 是一个稀疏矩阵,把它压缩成秩 r 的形式,为什么损失是可控的?我们对奇异值谱做了三组分析来回答。
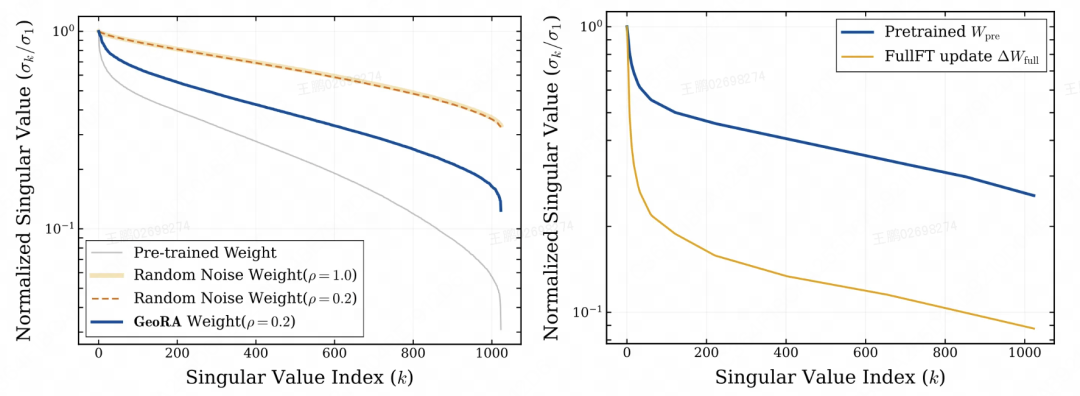
稀疏本身不带来低秩性。作为对照,我们先构造了两个不同稠密度的随机噪声矩阵。两者的奇异值谱几乎重叠,都呈现相对平缓的衰减,说明稀疏本身依然近似各向同性,没有可利用的主方向。
W_Geo 具有低秩特性。图中 GeoRA Weight(W_Geo)的谱形与预训练权重类似,大部分谱能量集中在少数前导分量上。这说明被选中的区域继承了结构化、可压缩的低秩形态。
全参 RLVR 的实际更新也是低秩的。我们直接检验了 ΔW = W_FullFT − W_Pretrain,它也呈现出高度可压缩的重尾谱。
三组分析合起来给出了 GeoRA 的结构依据:低秩特性是 RLVR 具备的内在属性。这也解释了为什么 GeoRA 只训练 0.5% 的参数就能与全参微调效果相当——它逼近的正是 RLVR 更新本身的形态。
04 业务应用
GeoRA 这个工作的出发点不是发论文,而是实际业务中对高效强化学习的需求。我们所处的场景是 AI 骑手招聘:由 Agent 主动触达和跟进候选人,在多轮沟通中识别其意愿、顾虑与决策卡点,针对性地制定下一步策略,进而把候选人逐步推进到面试和入职。过程上这需要类似于销售的情商、策略、话术和临场应变;目标和结果却明确、可验证(约面/入职/ROI),很适合用 RLVR 来优化;而这一垂直域场景也有着特别的训练需求组合:
基模大、上下文长。这一 Agent 对基础智能和长程能力要求较高:需要建立在大尺寸基模之上,且单条轨迹的上下文很长,强化学习的资源开销可观。
增量能力规模不大。垂直域需要额外构建的知识和能力规模通常不大,训练数据量远小于基模,低秩适配的容量基本足够承载。
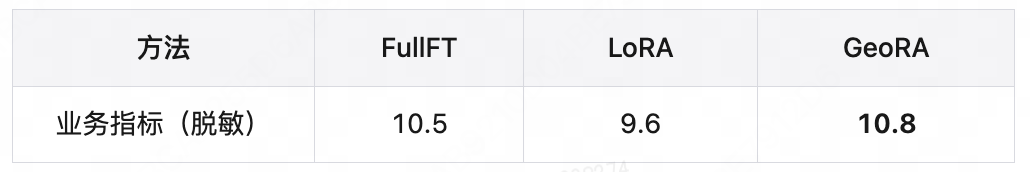
一边是训练开销高,一边是增量容量小,这正是面向 RLVR 的低秩高效训练的用武之地。事实上,最早让我们怀疑「为 SFT 设计的低秩先验未必适合 RLVR」的,也是业务训练中的体感:LoRA、PiSSA、MiLoRA 之间效果差异明显,学习率调大训练就不稳甚至崩掉。这说明初始化的几何先验在 RLVR 下是一个大变量,存在优化空间。目前 GeoRA 正在 AI 招聘场景中落地,Agentic RL 实验效果:
效果:与全参训练相当,相比 LoRA 提升约 12%。
效率:与 LoRA 相当,显存相比全参训练降低 54%,若配合 QLoRA 等量化方法可进一步降低。
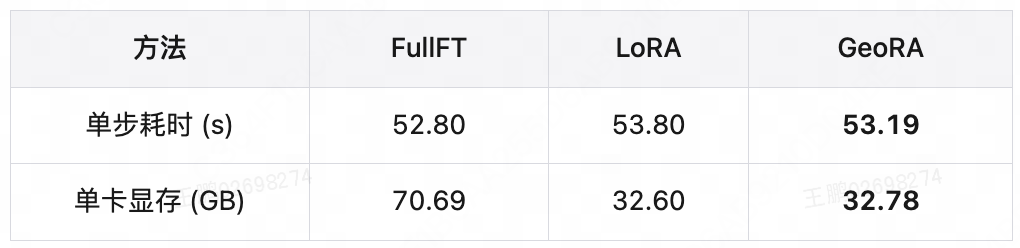
可见,GeoRA 用 LoRA 的训练成本取得了全参的优化效果,这正是它的应用价值。
落地时还有两点经验,也供同样想在 RLVR 中应用的同学参考:
随机 SVD 初始化。SVD 初始化是一次性的预处理,并且由于只需要前 r 个奇异分量,可以用随机 SVD(Randomized SVD)加速,即用随机投影把矩阵压到一个小得多的空间去做分解,即使 72B 模型处理也只需不到 1 分钟。
省略参考模型存储。RLVR 需要一个参考策略来算 KL,常规做法是再存一份完整权重。而 2.3 节的函数不变性质给出了免费的替代方案:原始权重 = 残差权重 + 初始适配器,因此只要在 actor 内多留一份冻结的初始适配器(低秩,开销很小),就能现算出准确的参考策略。
05 总结
GeoRA 是首个面向 RLVR 的优化几何设计的低秩训练方法,其核心贡献可以归纳为三点:
揭示了 RLVR 更新的结构:RLVR 的更新子空间稀疏但各向异性可压缩,这是低秩适配成立的前提。
提出定位加压缩的适配方法:用谱先验与欧氏先验定位 RLVR 偏好的更新区域,再用截断 SVD 压缩为低秩适配器、冻结残差作锚点,这避免了几何错位与稀疏计算的效率瓶颈。
广泛实验验证了优越性能:从 1.5B 到 32B 的模型,在数学、医学、代码场景的 RLVR 上验证方法稳定优于基线,分布外遗忘更少,兼具速度与显存的优越性。
除论文实验之外,GeoRA 也在实际业务场景 Agentic RL 中验证,以更低的成本取得更好的训练效果。我们会继续把它推广到更多同类场景,也希望该方法能为 RLVR 的高效训练提供一个新的参考。
欢迎大家在文末评论区积极留言,可以围绕大模型推理能力、RLVR等相关技术,展开深入的讨论和经验分享。我们会精选一些评论,给大家送上一份美团定制的小礼品。
---------- END ----------

❤️❤️❤️ 如果这篇文章对你有帮助,欢迎大家帮忙点赞、评论,分享给更多的小伙伴。⬇️