Transformer 之后,AI 到底在进步什么?
原创 p4nda 2026-08-13 13:34 浙江
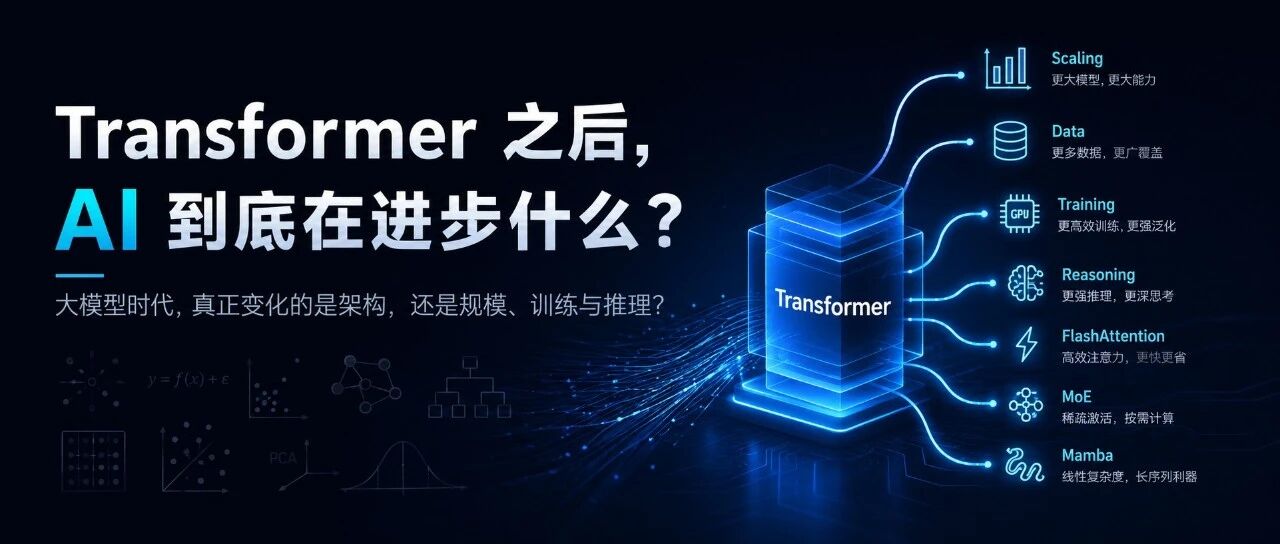
这么多年,AI 到底在进步什么?
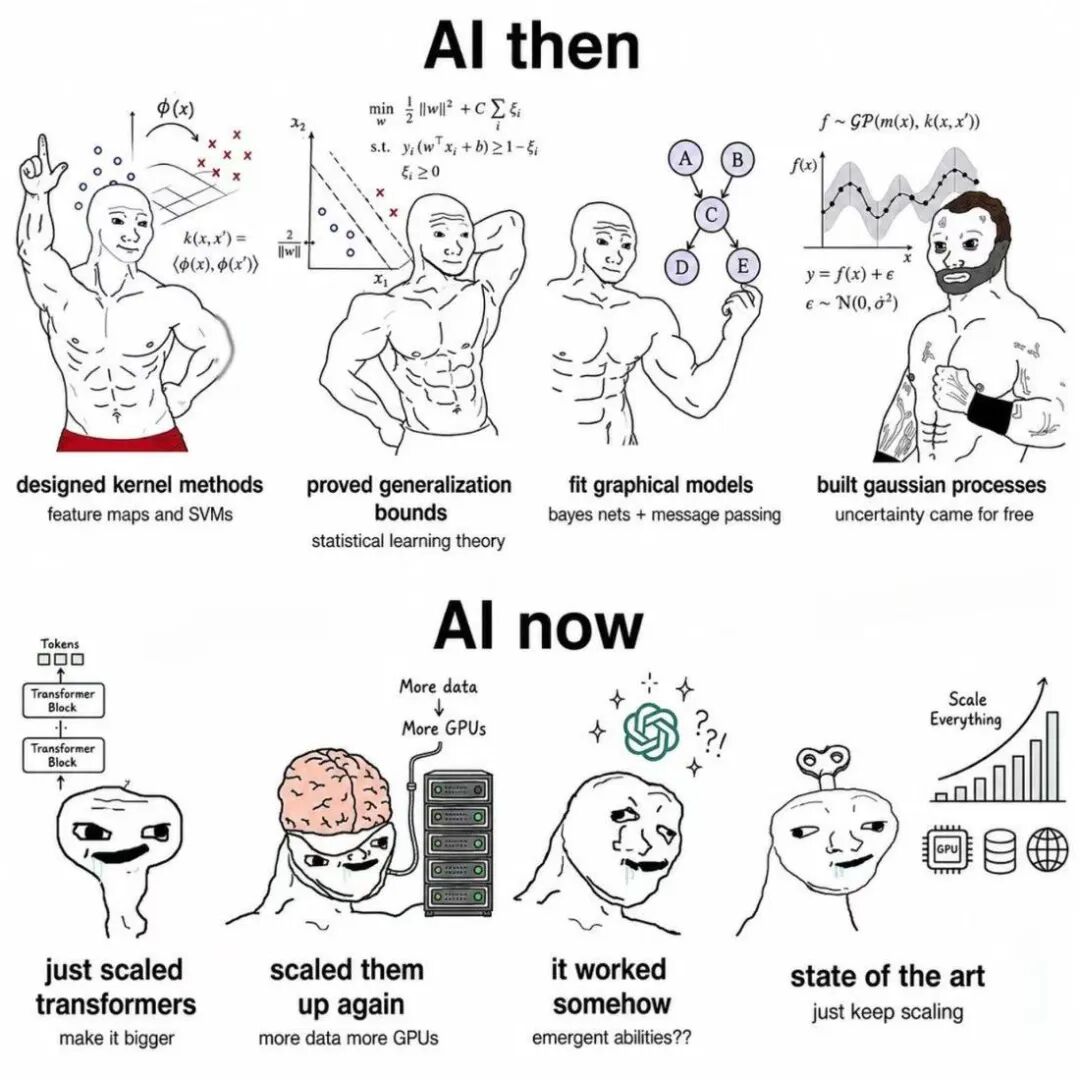
这当然是一张梗图,但它之所以好笑,是因为确实抓住了过去几年 AI 发展的一个特点:
如果讨论的是大语言模型的主干架构,这张图的讽刺相当准确;但如果因此得出“AI 已经没有新的底层技术”,又有些过头。
最关键的一点是:2017 年 Transformer 出来以后,到现在确实没有再出现一次类似 “RNN/CNN → Transformer” 这种统治级的架构替换。
Transformer 当时是一次很底层的变化是它直接用 self-attention 处理序列中不同位置之间的关系,不再依赖 RNN 那种按顺序逐步传递信息的方式[1]。
Transformer / Self-Attention 是什么
Transformer 是一种神经网络架构。Self-Attention 是它的核心机制之一,可以让模型直接判断一段内容中不同位置之间的关系。现在绝大多数主流大语言模型仍然建立在 Transformer 体系上。
此后的前沿大语言模型,大体可以理解成:
Transformer
• 更多、更好的数据
• 更大的计算量
• 更好的训练方法
• 更高效的模型结构
• 更多推理阶段的计算
• 工具调用
而不是:
Transformer
→ 一个完全不同的新理论
→ 下一代 AI
这张图“对”在哪里
如果回头看 2000 年前后的机器学习,会看到很多差异非常大的技术路线:
• SVM / Kernel Method
• Gaussian Process
• Bayesian Network
• HMM
• Decision Tree
• Boosting
• Graphical Model
• Neural Network
它们的建模假设、数学形式,甚至训练方法都可能完全不同。
而今天看很多公开的大模型,会发现主干非常相似。
以 DeepSeek-V3 为例,它当然有很多创新,但仍然建立在 Transformer 体系上,主要变化可以概括成:
Transformer + MoE + MLA + Multi-Token Prediction + 训练工程优化
DeepSeek-V3 有 671B 总参数,但每个 token 实际只激活约 37B 参数。本质上,是通过 MoE 把“模型总规模”和“每次真正参与计算的规模”拆开;MLA 则主要用于降低推理阶段的缓存和计算成本[2]。
MoE(Mixture of Experts)
可以理解成一个模型内部有很多“专家模块”,但每次处理一个 token 时,只调用其中一部分。这样可以把模型做得很大,又不必每次把全部参数都计算一遍。
MLA(Multi-head Latent Attention)
DeepSeek 使用的一种 Attention 改进方法,主要目标是压缩推理时需要保存的中间信息,从而减少显存和计算开销。
所以,如果画成:
2017
Transformer
    │
    ├── Scaling
    ├── MoE
    ├── RoPE / GQA / MLA
    ├── FlashAttention
    ├── Better Data
    ├── RLHF / DPO / RL
    ├── Long Context
    ├── Test-time Compute
    └── Tool Use
其实比:
2017 Transformer
2020 ??? 全新架构
2023 ??? 全新架构
2026 ??? 全新架构
更符合实际。
“Scale”本身,可能就是这一轮 AI 最大的发现之一
这一点反而经常被低估。
2020 年的 Scaling Laws 工作发现,在相当大的范围内,语言模型的效果和参数量、数据量、计算量之间存在比较稳定的关系[3]。
也就是说,不一定要先发明一种新的算法,仅仅把已有方法按正确的比例扩大,性能就可能比较稳定地继续提高。 也即是在后训练上,有了重大发展。
Scaling Laws
研究模型规模、训练数据、计算量和模型效果之间的关系。它最重要的意义不是“模型越大越好”,而是说明这些投入和最终效果之间存在一定规律,可以被估计,而不是完全靠试错。
后来 Chinchilla 又发现,很多大模型的问题不是参数不够,而是训练数据不够。
于是重点从:
模型越大越好慢慢变成了:
模型大小 × 数据量 × 训练计算量
需要合理配比
70B 参数的 Chinchilla,在相近训练计算量下,可以超过当时 280B 参数的 Gopher[4]。
这其实非常反直觉。
过去更习惯的一条路线是:
发明一个更聪明的算法 → 提升性能
到了大语言模型时代,开始出现另一种路线:
找到一个足够通用的架构
→ 把数据和算力扩大几个数量级
→ 能力继续增长
所以那张图里的:
it worked somehow
虽然是调侃,但确实说中了一个很特别的现象。
但“只是把 Transformer 变大”也不完全准确
过去几年出现了不少很重要的技术,只是它们没有改变主干架构。
FlashAttention 就是一个典型例子[5]。
FlashAttention
一种更高效地计算 Attention 的方法。它主要减少 GPU 在显存和高速缓存之间来回搬运数据的次数,因此可以提高速度、减少显存占用。
它更像是“把同一个公式算得更聪明”,而不是发明一个新的公式。
它没有改变 Attention 最终要计算的数学结果,而是重新设计了 GPU 处理 Attention 时的数据读取和计算过程。
简单来说:
数学:
Attention 还是那个 Attention
实现:
重新设计了计算过程这类技术非常重要,但它属于计算机系统层面的底层优化,而不是机器学习理论层面的架构替换。
MoE 也是类似的情况。
普通 Transformer:
token
  ↓
整个 FFN
MoE:
token
  ↓
Router
 ├→ Expert 3
 └→ Expert 17
于是就可能出现:
总参数:600B
实际激活:30B
模型可以拥有很大的总参数量,但每个 token 不需要跑完整个模型。
Switch Transformer 很早就系统展示了这种稀疏 MoE 的扩展能力[6]。
如果按“有没有改变基础范式”来判断,这类技术更接近:
对 Transformer 的重大改造
而不是:
新的 AI 基础范式
所以说 AI 这些年“没有创新”显然不对。
更准确的说法应该是:
创新很多,但很长时间没有出现一次能够替代 Transformer 主干地位的架构革命。
真正值得注意的变化其实是推理阶段也开始 Scaling
2024 年以后,一个越来越明显的变化,是 Scaling 不再只发生在训练阶段。
以前:
更多 GPU
    ↓
训练更大的模型
    ↓
模型更强
现在又增加了一条:
同一个模型
    ↓
回答问题时计算更久
    ↓
进行更多搜索 / 验证 / 推导
    ↓
答案更好
OpenAI 在介绍 o1 时公开描述过这个现象:随着强化学习训练计算量增加,以及模型在推理阶段使用更多计算,模型的表现都会继续提高[7]。
DeepSeek-R1 则进一步展示了类似结果:R1-Zero 通过强化学习,可以逐渐形成更长的推理过程,并在复杂问题上使用更多推理计算[8]。
Test-time Compute / 推理阶段计算
指模型已经训练完成以后,在真正回答一个问题时愿意投入多少计算资源。
过去通常更重视“把模型训练得更大”,现在则开始重视“同一个模型面对难题时,能不能多算一会儿”。
因此现在的 Scaling 大致可以分成:
Scaling 1:
参数规模
Scaling 2:
训练数据
Scaling 3:
训练计算量
Scaling 4:
推理计算量
这个变化可能比单纯把模型从 70B 做到 700B 更重要。
但如果问题是:
“这算新的底层神经网络理论吗?”
答案仍然是:
不太算。
它更像是训练方法和模型使用方式发生了变化,而不是神经网络的基本结构被重新发明。
当然,也有人真的在尝试替换 Transformer
最典型的一条路线是 Mamba / State Space Model[9]。
State Space Model / Mamba
一类不同于标准 Transformer Attention 的序列模型。它通过内部状态逐步保存和传递信息,一个重要优势是处理超长序列时,计算成本可以比标准 Attention 更低。
它不是对 Attention 做一点修改,而是真的采用了另一种处理序列的方式:
Transformer
token ↔ token
通过 Attention 建立关系
Mamba
token → hidden state → hidden state
通过内部状态持续传递信息
Mamba 的一个重要目标,就是降低 Attention 在长序列上的计算成本,使计算量可以随着序列长度近似线性增长[9]。
到 2026 年,Mamba-3 还在继续沿着这条路线发展,引入新的状态更新和多输入多输出机制[10]。
如果按“是否真正更换模型骨架”来判断,Mamba 更接近真正的底层架构创新。
问题是,它目前还没有像 Transformer 在 2017 年以后那样,把整个行业的主流路线替换掉。
所以至少到现在,Transformer 的主导地位依然非常强。
怎么评价这个梗图
如果简单打个分:
图中的观点 | 准确程度 |
|---|---|
现在 AI 很大程度依靠 Scaling | 9/10 |
Transformer 很多年没有被根本替代 | 9/10 |
很多新模型本质上仍是 Transformer 改进版 | 8/10 |
现在没有算法创新 | 3/10 |
现在没有底层创新 | 5/10 |
AI 进步基本就是“堆 GPU” | 6/10 |
更准确的描述应该是:
过去 8~9 年真正特别的地方,不是 AI 没有创新,而是 Transformer 这个基础架构异常耐用。大量最重要的进步发生在规模、数据、训练、推理和计算系统上,而不是不断更换神经网络的基础架构。
这也带来了一个更值得继续追问的问题:
我们现在到底是在接近 Transformer 的上限,还是无意中找到了一种可以沿用很多年的通用架构?
这件事现在还没有答案。
如果以后真的再出现一次 Transformer 级别的突破,它可能不会只是把 Attention 的公式改一改。
更大的变化,可能来自对现在几个基本假设的改变:
一个是 固定参数模型
模型训练结束以后,核心参数基本不再变化。未来的模型是否仍然必须如此?
其次是 Context Window
现在模型主要依赖一次输入中的上下文来获得临时信息。未来是否会有更自然、更长期的记忆机制?
最后是 Token-by-token 推理
现在绝大多数语言模型仍然是一个 token 接一个 token 地生成结果。未来是否一定还要这样?
如果这些基本假设中的某一个被真正改掉,也许才会再次出现一次类似 2017 年的变化。
到那个时候,“AI then / AI now” 这张图,可能就真的要重新画了。
参考资料
[1] Vaswani, A., et al. Attention Is All You Need. NeurIPS, 2017.
https://arxiv.org/abs/1706.03762
[2] DeepSeek-AI, et al. DeepSeek-V3 Technical Report. 2024.
https://arxiv.org/abs/2412.19437
[3] Kaplan, J., et al. Scaling Laws for Neural Language Models. 2020.
https://arxiv.org/abs/2001.08361
[4] Hoffmann, J., et al. Training Compute-Optimal Large Language Models. 2022.
https://arxiv.org/abs/2203.15556
[5] Dao, T., et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS, 2022.
https://arxiv.org/abs/2205.14135
[6] Fedus, W., Zoph, B., & Shazeer, N. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. 2021.
https://arxiv.org/abs/2101.03961
[7] OpenAI. Learning to Reason with LLMs. 2024.
https://openai.com/index/learning-to-reason-with-llms/
[8] DeepSeek-AI, et al. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. 2025.
https://arxiv.org/abs/2501.12948
[9] Gu, A., & Dao, T. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. 2023.
https://arxiv.org/abs/2312.00752
[10] Lahoti, A., et al. Mamba-3: Improved Sequence Modeling using State Space Principles. 2026.
https://arxiv.org/abs/2603.15569