LLM推理能力进化:自我反思和策略优化
原创 Li JieJie 2025-08-20 12:13 北京
让我用一个简单案例,介绍LLM推理能力的进化。LLM在越来越多的任务中,表现出了典型的自我反思,它主动评估结果,尝试改进方法,优化策略,并最终得到用户所需的结果,越来越显示出解决复杂问题的 "思路"和能力。
安装爱奇艺PC客户端的设备
运营同事发送给安全机器人一个常见任务,甚至并不包含任何动作:安装爱奇艺PC客户端的设备
LLM规划任务如下
调查计划
为了找到安装了“爱奇艺PC客户端”的设备,我需要查询终端设备上的软件安装情况。
* EDR: 查询所有安装了“爱奇艺PC客户端”的设备信息。
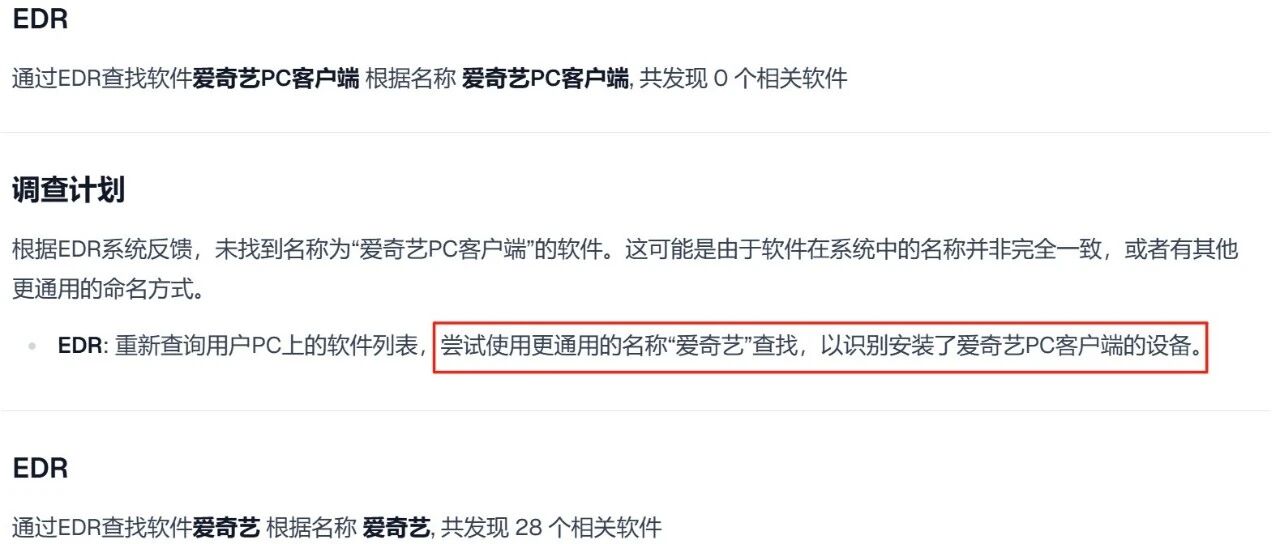
EDR 根据名称 爱奇艺PC客户端, 共发现 0 个相关软件
EDR处理任务,没有找到对应软件。这个结果是正常的,因为并不存在一个名字正好就叫爱奇艺PC客户端的软件。
LLM看到EDR的回复后,立即重新规划了查询。它不再搜索【爱奇艺PC客户端】,转而尝试搜索【爱奇艺】。
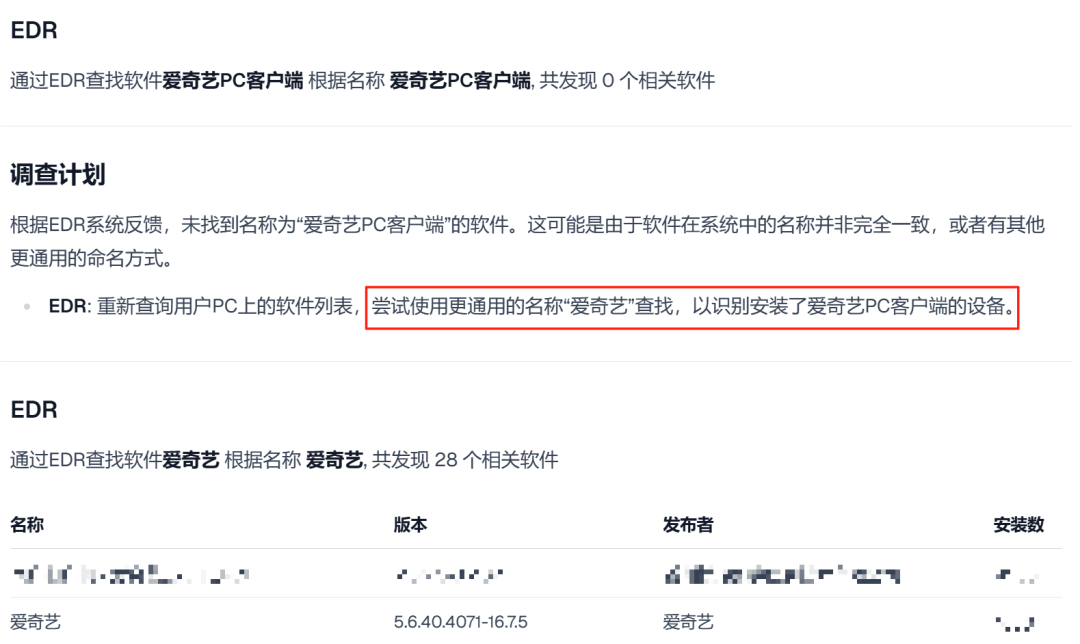
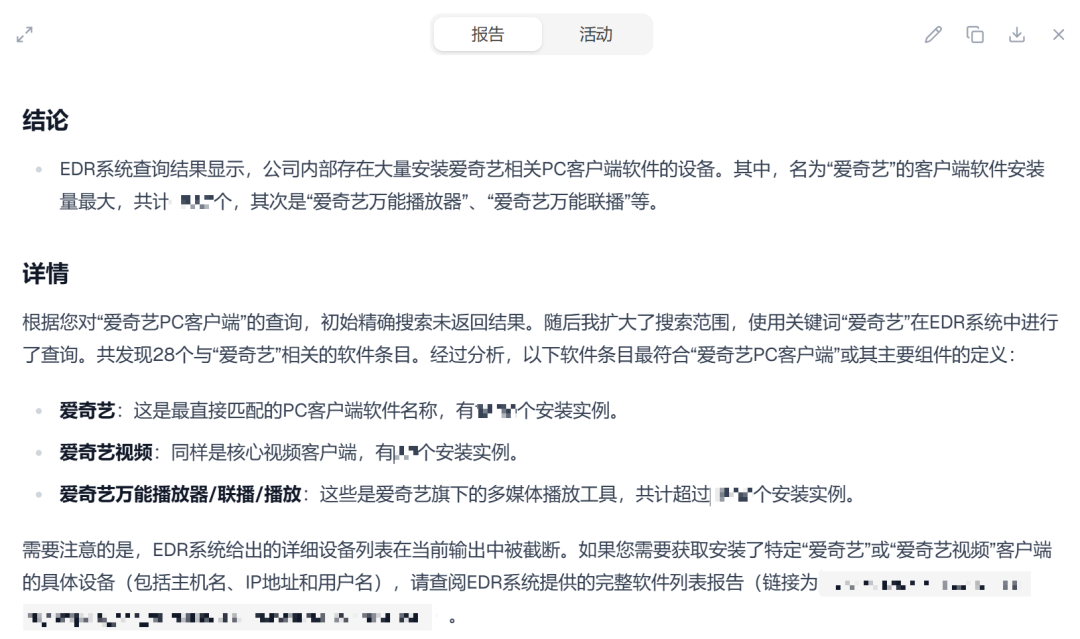
最终,EDR Agent 查到28个名字中带【爱奇艺】的软件,LLM经过分析过滤,认为其中最符合“爱奇艺PC客户端”定义的软件包括3个,并输出对应的列表,给出了安全运营想要的结果。
案例总结
让我们来观察这个任务的执行,LLM的智能到底体现在哪些细节上:
制定行动:理解用户问题后,基于常识,LLM知道需要委派EDR查找【爱奇艺PC客户端】
评估结果:EDR通知LLM查询到0个软件,LLM收到负反馈。
提出假设:精确匹配失败后,LLM反思失败的原因,它提出一个假设:可能是由于软件在系统中的名称并非完全一致,或者有其他更通用的命名方式。基于这个假设,它调整策略,使用“爱奇艺”进行第二次搜索。
过滤结果:EDR返回了28个名称中包含【爱奇艺】的软件,LLM经过分析,精准挑选出了最符合查询要求的3个软件
自我反思
EDR Agent返回 “共发现 0 个相关软件” 这个负反馈 ,触发了LLM第二轮思考和行动。
感知失败 -> 重新规划 -> 尝试解决复杂问题,是LLM“智能”的典型体现。
LLM在我们的Agent中,它能够根据下游Agent的反馈(即所谓的环境感知),动态调整自我行为。
常识推理
LLM学习到了大量的常识,比如:
爱奇艺是1个品牌名
软件命名规范
它理解 “爱奇艺PC客户端” -> “爱奇艺客户端” ->“爱奇艺” 这3个词之间,是从“具体”到“通用”的层级逻辑关系。
它知道软件命名可能出现各种变体,但核心的品牌名称,"爱奇艺",通常是不变的。软件名称、版本号可以不规范,但无论如何,【爱奇艺】这个核心品牌名称,一般是存在的。于是,它将策略调整为只搜索核心关键词“爱奇艺”,制定覆盖范围最广、容错率最高的策略。