Cairn 深度架构分析
原创 yzddMr6 2026-06-08 22:56 浙江
Cairn 的独特价值在于:不给 LLM 贴角色标签,不注入领域知识,而是提供一个结构化的"棋盘"和规则,让 LLM 的涌现能力自行驱动问题求解。
项目:oritera/Cairn
分析日期:2026-06-02
分析模式:深度分析(核心模块 100% 覆盖)
有效代码:6000 行核心 + 3400 行前端
1. 引言与竞品定位
Cairn 是一个基于 Blackboard Architecture 的多 Agent 协作框架,让多个 LLM Worker 围绕一张共享的 Fact-Intent 有向无环图(DAG)协作求解问题。与当前主流的 Multi-Agent 框架相比,Cairn 选择了一条截然不同的技术路线:
Cairn 的独特价值在于:不给 LLM 贴角色标签,不注入领域知识,而是提供一个结构化的"棋盘"和规则,让 LLM 的涌现能力自行驱动问题求解。
2. 项目全景
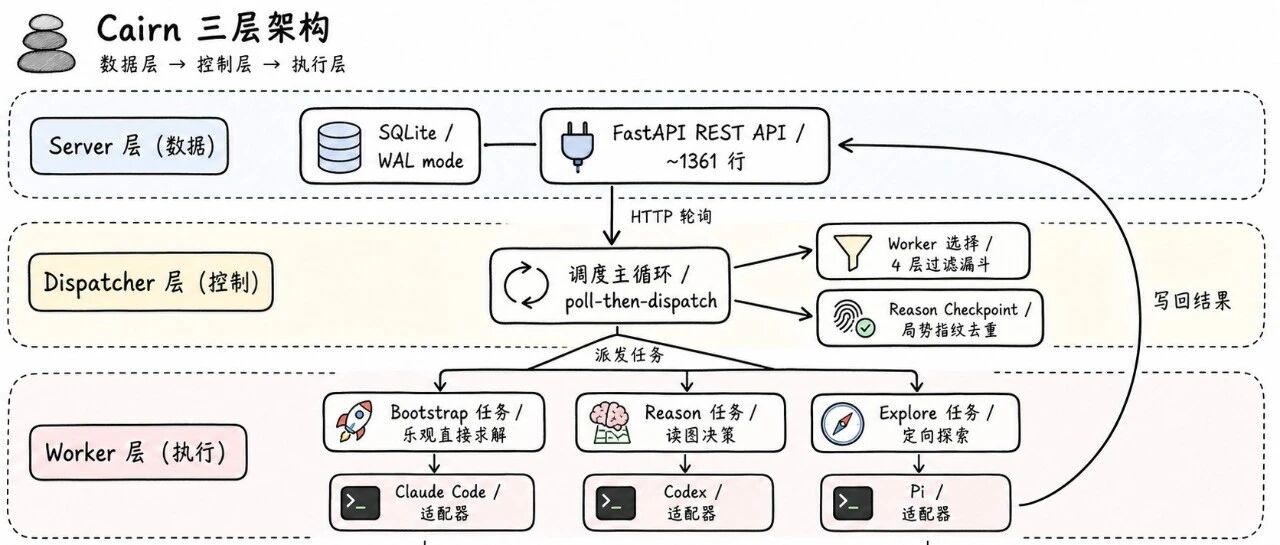
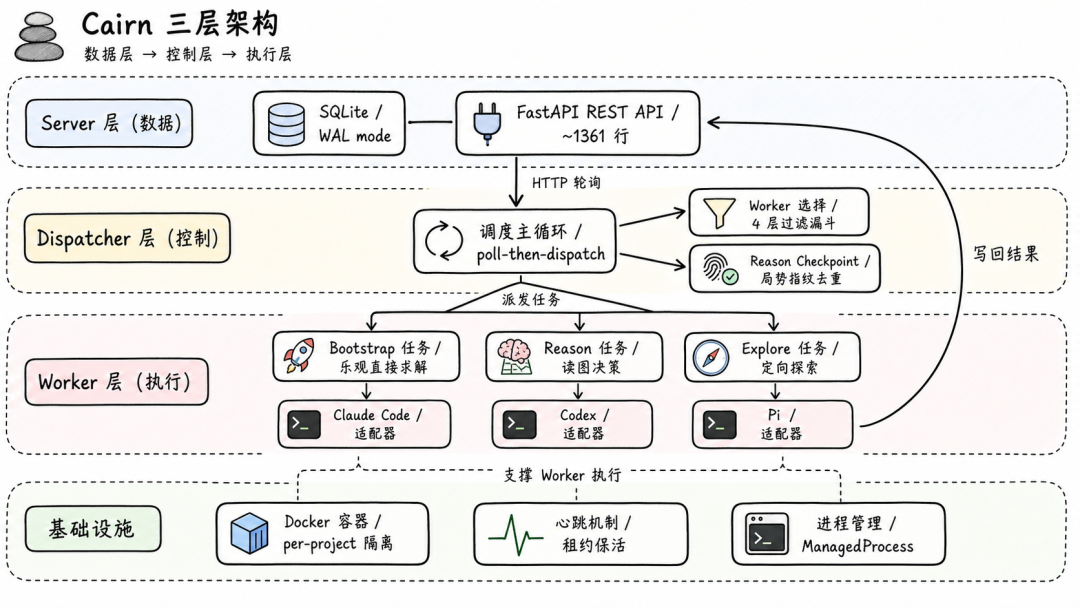
2.1 三层架构
2.2 关键数据流
一个典型的问题求解过程:
1. 用户创建 Project,Server 生成
origin(起点事实)和goal(目标事实)2. Dispatcher 检测到新项目,派发 Bootstrap 任务尝试直接求解
3. 如果 Bootstrap 成功,项目直接完成;否则进入迭代循环
4. Reason 任务读取完整的 DAG,决定下一步需要探索什么方向(创建新 Intent)
5. Explore 任务沿着 Reason 指定的方向探索,产出新 Fact
6. 新 Fact 触发新一轮 Reason→Explore 循环,直到 Reason 判定问题已解决
7. Reason 创建 completion intent(指向
goal),项目完成
2.3 技术栈与规模
3. 设计哲学:从黑板到涌现
3.1 Blackboard Architecture 的前世今生
1970 年代,卡内基梅隆大学的 Hearsay-II 语音识别系统面临一个挑战:如何让多个专家系统(音素识别、词汇匹配、语法分析等)协作?直接让专家之间两两通信会导致 O(n²) 的接口爆炸。Hearsay-II 的解决方案是引入一块"黑板"——所有专家只读写黑板,不直接对话。
Cairn 将这个 50 年前的设计模式与 LLM 结合,产生了一个现代变体:
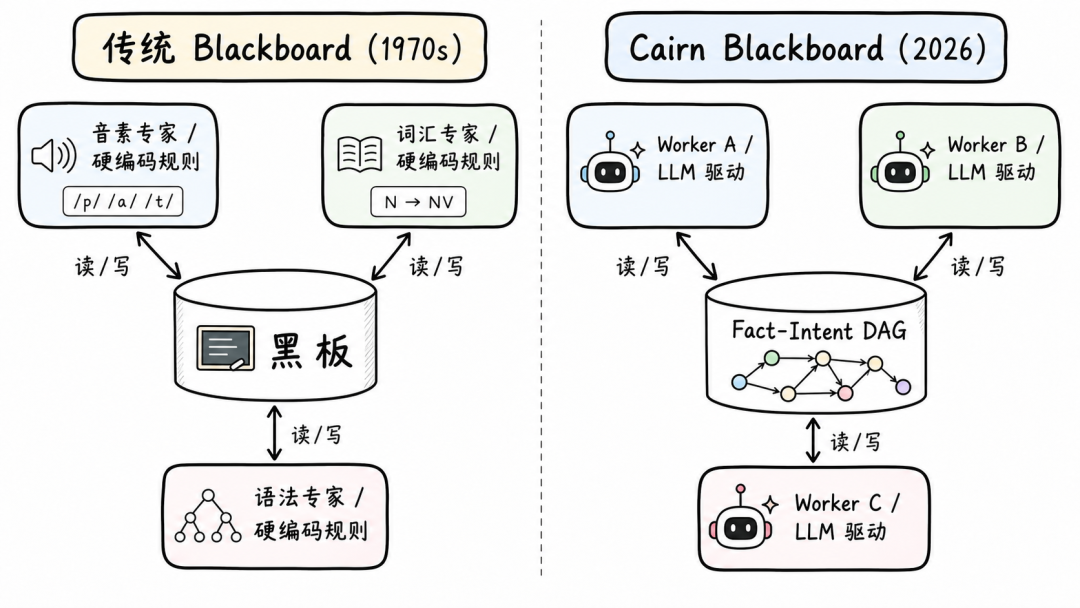
关键变化:Knowledge Sources 从硬编码的领域规则变成了通用的 LLM。传统 Blackboard 的致命弱点——每换一个领域就要重写所有专家规则——被 LLM 的通用推理能力彻底消解。
3.2 Stigmergy:蚁群智慧的工程化
Stigmergy(间接协调)是蚂蚁寻路的机制:蚂蚁不直接告诉同伴"往左走",而是在路上留下信息素,其他蚂蚁通过感知信息素浓度自行决策。Cairn 中的 Stigmergy 体现在:
• Fact 是信息素:Worker 的探索结果以 Fact 形式留在 DAG 上,其他 Worker(通过 Reason 任务)读取这些 Fact 来决定下一步。
• Intent 是路径标记:Reason 任务创建的 Intent 标记了"这个方向值得探索",但不指定"谁去探索"。Explore Worker 自行认领(或由 Dispatcher 分配)。
• Worker 之间无直接通信:翻遍全部代码,没有任何 Worker-to-Worker 的消息传递机制。所有协作通过 DAG 间接完成。
与直接消息传递(如 CrewAI 的 Agent-to-Agent 通信)相比,Stigmergy 的优势在于天然解耦——增加或移除 Worker 不需要修改任何通信协议,系统自动适应。代价是协调效率较低(Worker 只能通过轮询发现变化),但对于 Cairn 的任务粒度(秒到分钟级的 LLM 调用),这个延迟可以忽略。
3.3 OODA Loop 与 Mission Command
Cairn 的三种任务类型映射到军事决策理论的 OODA Loop(Observe-Orient-Decide-Act):
更深层的是 Mission Command(任务式指挥)哲学:上级(Reason)只下达"做什么"(Intent 的 description),不规定"怎么做"。下级(Explore)有充分的自主权决定具体执行方式。这给了 LLM 最大的发挥空间。
3.4 "Less Than Nothing" — 零知识注入
分析 Cairn 的 5 个默认 prompt 模板后,一个惊人的事实浮现:没有一行领域知识被注入。
•
bootstrap.md:只说"you are a domain expert",不说专家在哪个领域•
reason.md:只提供 DAG 的 YAML 快照和结构化输出格式,不提供推理策略•
explore.md:只说"explore this direction",不指导如何探索
这不是疏忽——设计文档(server-protocol.md)明确称之为"Less Than Nothing":不仅不注入领域知识,甚至连通用的推理启发式都不提供。系统相信 LLM 面对结构化的问题表示(DAG)时,会自行涌现出合适的推理策略。
这种设计的风险和收益都很极端:
• 收益:完全通用——同一套 Cairn 可以用于代码调试、学术研究、安全分析、任何需要迭代求解的领域
• 风险:如果 LLM 的推理能力不足以应对某个领域,系统没有任何兜底机制
4. Fact-Intent 图:共享知识的数据结构
Blackboard Architecture 的核心是"黑板上写什么"。Cairn 的回答是 Fact-Intent DAG——Fact 为节点、Intent 为有向超边的有向无环图。
4.1 核心实体
整个 Server 的数据模型只有四个实体(models.py),极简到令人意外:
Fact(models.py:13-16)只有 id 和 description 两个字段。没有 created_at,没有 creator。这是刻意的——Fact 代表"已确认的事实",一旦写入就是客观真理。它的来源追溯通过产生它的 Intent 间接获取。
Intent(models.py:18-29)是信息最密集的实体,承载了超边结构和并发控制。关键字段:from_(源 Fact ID 列表,超边的多个输入端)、to(目标 Fact ID,未完成时为 None)、worker(当前持有者)、last_heartbeat_at(心跳时间戳)。超边语义意味着一条 Intent 可以从多个 Fact 出发,表达"综合多个已知事实推导出新结论"。
Hint(models.py:32-37)是图的"旁注"——即使项目处于 stopped 或 completed 状态也可以写入(services.py:65-69),是人类用户随时向 Worker 传递指导信息的专用通道。
ProjectReason(models.py:39-43)嵌入 projects 表的四个字段,实现项目级推理锁。每个项目最多一个 reason lease,一对一关系用列比关联表更高效。
4.2 DAG 的拓扑语义
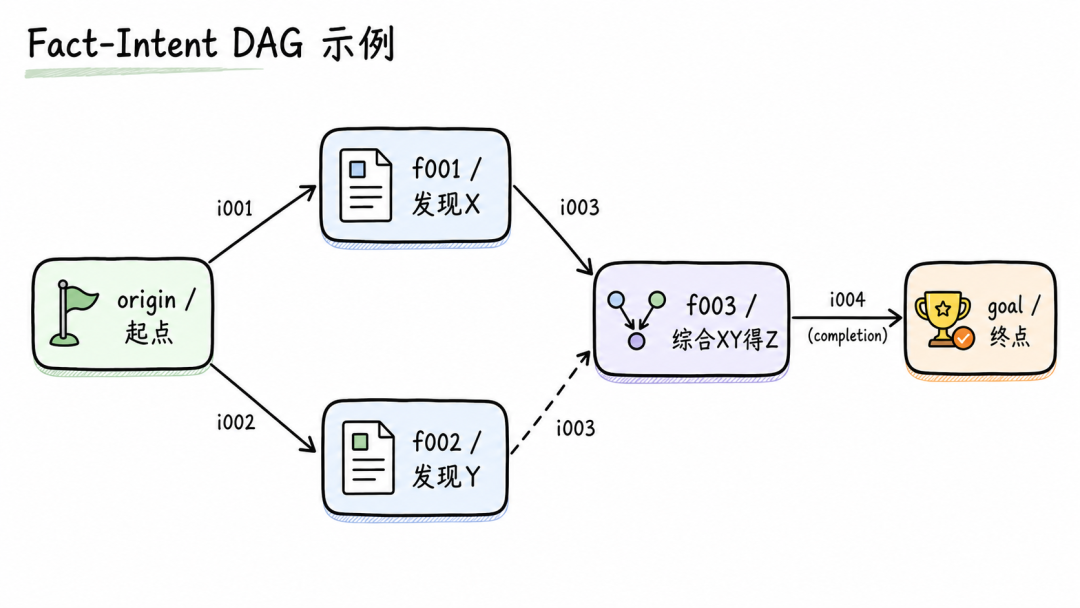
每个项目自动插入两个特殊 Fact:origin(source 节点,描述问题起点)和 goal(sink 节点,定义完成条件)。goal 被严格禁止出现在 Intent 的 from_ 列表中(services.py:90-92),保证 DAG 的拓扑方向。
当 Intent 的 to 被设为 goal 时,它是 completion intent——声明"已知事实足以满足目标",同时将项目标记为 completed(projects.py:269-280)。超边语义在数据库层通过 intent_sources 关联表实现(db.py:51-57),保证了源 Fact 的顺序稳定性。
4.3 Append-Only:不可变的事实
翻遍整个 Server 代码,找不到任何 UPDATE facts 语句。Fact 只有 INSERT,没有修改,没有独立删除。这带来三个好处:引用完整性免维护、时间线可审计、并发读安全。如果需要"修正"Fact,正确做法是通过新 Intent 产生新 Fact——状态变化通过图的生长表达。
4.4 Project 生命周期:不对称的状态机
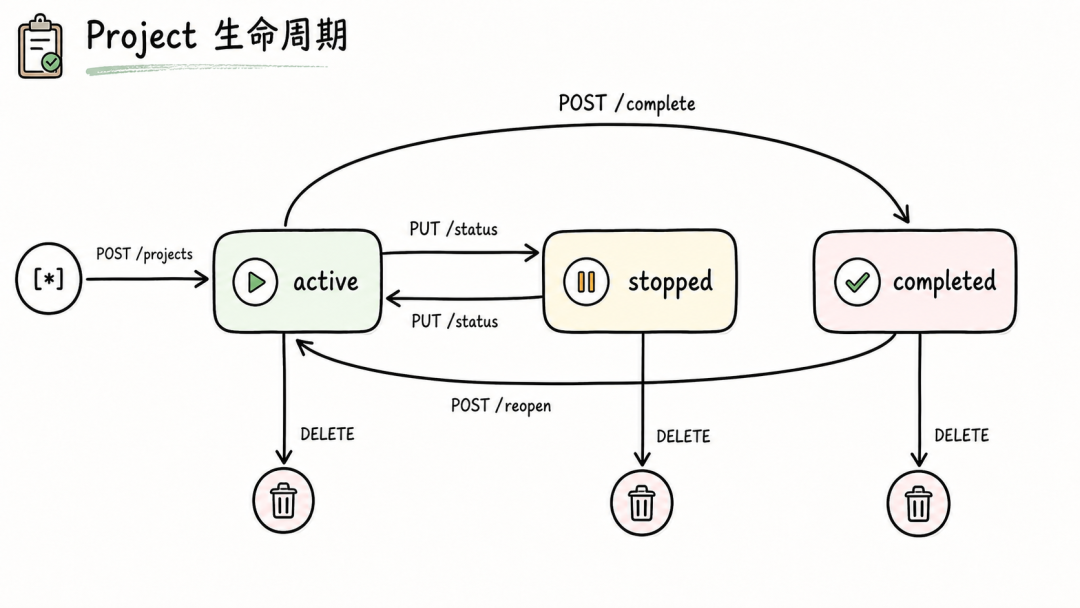
active ↔ stopped 是轻量对称转换。但完成和重开是语义更重的操作:
重开(projects.py:295-350)是 Server 中最复杂的单个事务——不是翻转状态位,而是在图中留下完整审计轨迹:删除 completion intent(代码中唯一删除单条 Intent 的操作)、创建新 Fact(记录重开原因)、创建新 Intent(from=原 completion 的源 Fact, to=新 Fact)、清除 reason lease、恢复 active。
4.5 并发控制:心跳保活与惰性清理
Intent 的 claim 通过心跳保活(默认 15 秒超时),超时的 Intent 自动释放回 unclaimed 状态。清理采用惰性触发——在每次读操作时顺便执行(services.py:221-236),超时计算完全在 SQL 层完成(julianday() 函数)。
Reason lease 与 Intent claim 使用独立超时设置(intent_timeout vs reason_timeout),允许对不同操作类型设置不同超时——推理通常比执行更慢。
4.6 存储层:SQLite 的刻意选择
SQLite WAL 模式(db.py:99)允许读写并发,foreign_keys=ON 保证引用完整性。7 张表使用复合主键((id, project_id)),ID 语义仅在项目作用域内有效。所有子表配置 CASCADE 删除,删除项目只需一条 SQL。
ID 生成采用两级计数器:全局计数器(project ID)+ 项目内计数器(fact/intent/hint ID),三位数零填充(f001、i001)使字典序等价于数值排序。
Server 是"无观点的真理源"。图定义了棋盘,但棋盘不会自己下棋。接下来看谁来推动图的生长。
5. 调度引擎:谁来推动图的生长
Dispatcher 是 Cairn 的"棋手"——持续读取 DAG 状态,决定下一步在哪里落子、派谁执行。
5.1 主循环:poll-then-dispatch
DispatcherLoop.run()(loop.py:72-102)每个心跳周期严格按序执行:回收结果(reap)→ 感知世界(refresh)→ 清理过时(cancel/cleanup)→ 调度决策(dispatch)→ sleep。
这个顺序隐含因果链:先"收割"上一轮结果获取 Worker 负载信息,再"感知"项目变化,然后"清理"过时状态,最后才"决策"新任务。颠倒顺序会基于过时信息决策,导致超发。
并发模型选择 ThreadPoolExecutor 而非 asyncio——任务粒度为秒到分钟级 LLM 调用,并发量个位数到低两位数,线程模型的简单性远比事件循环的性能优势重要。两个独立线程池:主执行池(max_workers 容量)承载核心任务,清理池(min(8, max_workers) 容量)专门处理 Docker 容器 stop/remove,避免阻塞调度循环。
5.2 两阶段派发:Running 优先 + Idle 补充
_dispatch_available(loop.py:120-170)的设计思想是集中资源、加速收敛:
1. 阶段 1:遍历 running 项目(round-robin 排序),优先处理图状态变化频繁的项目
2. 阶段 2:检查
max_running_projects限制后,从 idle 项目中引入新项目3. 每成功为 idle 项目派发一个任务后,立即回到阶段 1——确保 running 项目的优先级是持续维护的
跨项目公平通过递增的 project_cursor 实现 round-robin,每个周期从不同项目开始遍历。
5.3 项目内决策链
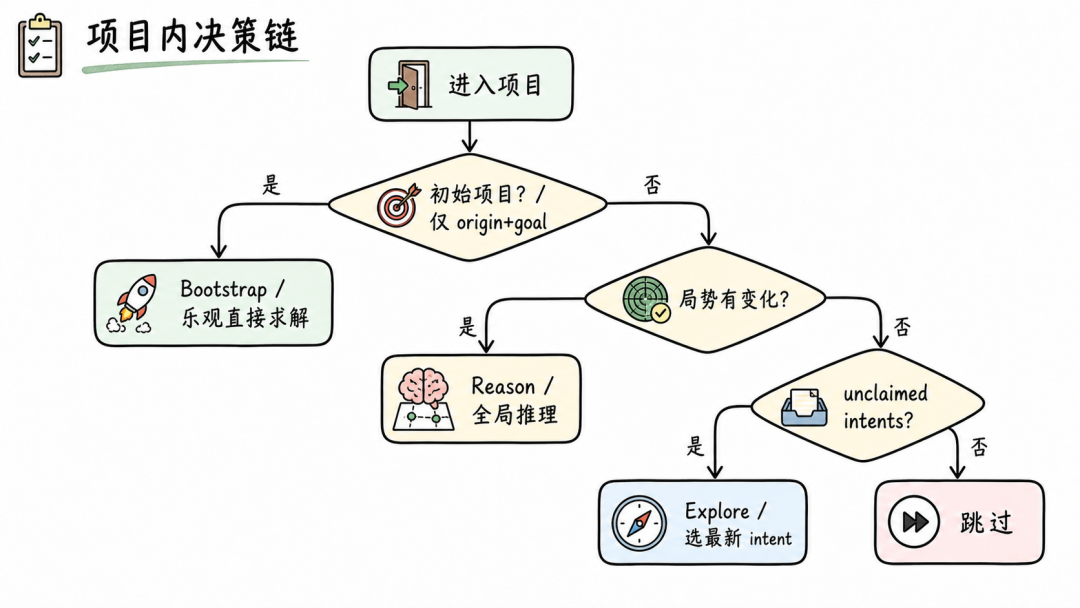
Bootstrap 最优先:新项目先试简单路径,一步到位则不需迭代。Reason 先于 Explore:没有决策者就没有新 Intent,图的生长会停滞。Explore 选最新:深度优先倾向,优先探索最新方向。
5.4 Worker 选择:四层过滤 + 三级排序
四层过滤漏斗:task_type 能力过滤 → busy 容量过滤 → unhealthy 5 秒冷却 → rejected 三元组粒度冷却。
rejected 以 (project_id, task_type, worker_name) 三元组为 key——Worker 拒绝项目 A 的 explore 不影响接受项目 B 的 explore 或项目 A 的 reason。这种细粒度反映了 LLM 拒绝通常与具体上下文有关。
三级排序:priority(配置声明,低值优先)→ fewest_running(负载均衡)→ random(打破平局)。成功完成任务立即清除所有不健康状态——"一次成功即康复"。
5.5 Reason Checkpoint:局势指纹去重
ReasonCheckpoint 由三个数值构成"局势指纹":fact_count、hint_count、open_intent_count。只有指纹变化才触发新的 Reason 任务。
关键细节:checkpoint 更新使用提交时快照而非完成时实时值(loop.py:684-699),避免"跳过中间变化"的竞态。这与 Server 端 reason_lease 形成双层去重:Server 防多 Dispatcher 竞争,Dispatcher 防自身重复。
调度引擎决定了"什么时候派什么任务给谁"。任务被派发后具体怎么执行?
6. 三种任务类型:Bootstrap / Reason / Explore
6.1 公共基础设施
三种任务共享一套运行时基础设施(tasks/common.py),包括进程管理、心跳集成、结果写入等底层能力。
核心执行原语 run_worker_process 做四件事:构建容器内子进程 → 挂载心跳(心跳失败可直接 kill 进程)→ 挂载取消信号 → 带超时的阻塞等待。finally 块中无论成败都 detach 进程引用,防止心跳线程持有已失效的进程对象。
一个精巧的设计是图快照不直接嵌入 Prompt(write_graph_snapshot_reference)。图快照可能非常大(数十个 Fact 和 Intent 的 YAML),直接内嵌会占用大量 Token 预算。系统将图快照写入容器内文件系统(/tmp/cairn-prompts/),Prompt 中只包含文件路径和读取指引——LLM Worker 可以用工具调用按需加载图信息。
6.2 Bootstrap:一步到位的快速路径
Bootstrap 是最"乐观"的任务类型。它的假设是:也许这个问题足够简单,一个 Worker 直接就能解决。它不看图(此时图还只有 origin 和 goal),直接把 origin、goal 和 hints 交给 LLM 全力尝试。成功则项目直接完成,省去迭代循环。
双阶段超时模型
这是 Bootstrap(和 Explore)最核心的设计:
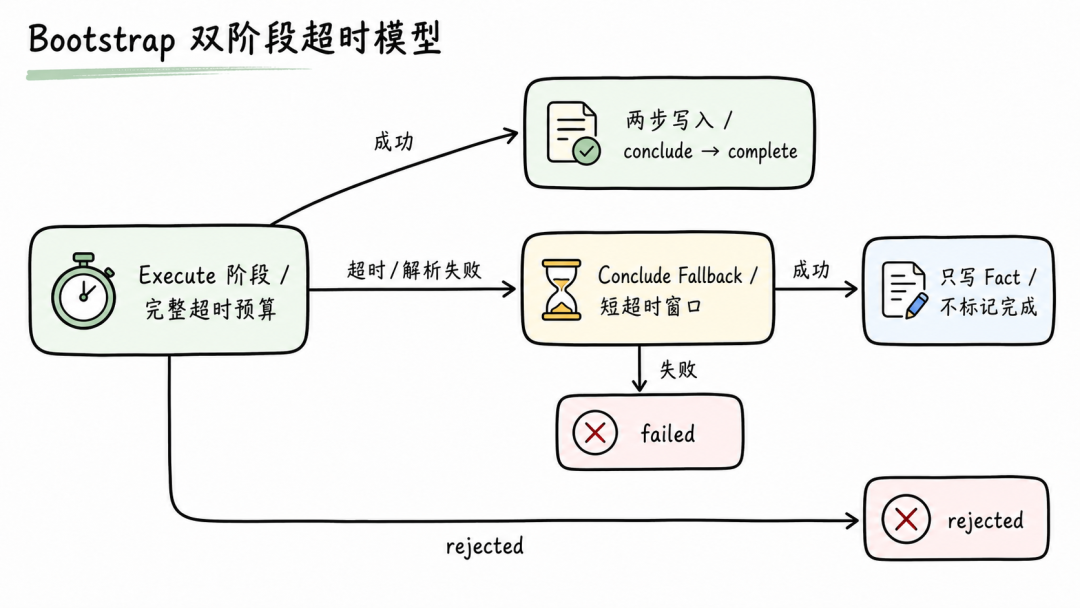
为什么需要 Conclude Fallback? 这是一个投资回收机制。LLM 在 execute 阶段可能花了 10 分钟做了大量探索工作,但超时了还没来得及输出结构化 JSON。直接丢弃太浪费。Conclude Fallback 在同一个 LLM session 中注入新指令——"停止当前操作,总结已确认的发现"——利用 session 的连续性准确总结中间成果。这些成果作为新 Fact 注入图中,成为后续迭代的基础。
Prompt 模板中预埋了阶段切换优先级:execute 阶段说"持续工作",conclude 阶段说"立即停止并总结",且明确 conclude 指令覆盖 execute 指令。这让两个阶段在同一个对话上下文中无缝衔接。
进入 conclude 前需通过五个检查门:Driver 支持 conclude、session 有效、心跳正常、未被取消、项目仍 active。任何一个不满足就直接放弃——对已完成的项目执行 conclude 既浪费资源又可能产生冲突。
Bootstrap 成功时的两步写入
当 execute 返回 {fact, complete} 时,_write_bootstrap_complete_result(bootstrap.py:412-466)执行两步操作:先 conclude intent 产出新 Fact 并获取 fact_id,再调用 client.complete 以该 Fact 为依据标记项目完成。如果 complete 调用返回 403/409(项目已被其他 Worker 完成),仍然返回 "success"——Fact 已写入,complete 的竞态失败是可接受的。
6.3 Explore:图的叶节点生长器
如果 Bootstrap 是"一步到位",Explore 就是"分步推进"的执行单元。每个 Explore 任务领取一个 Intent(探索方向),执行探索,产出一个 Fact(客观发现)。
与 Bootstrap 的核心区别:输入——Explore 接收完整的图快照 + 具体 Intent,而非仅 origin/goal;输出——只产出 {description}(新 Fact),不尝试完成项目;职责——只负责推进一步。
Explore 的 Prompt 模板核心指令是:解读图信息理解整体进展、只在当前 Intent 方向上探索(不偏离方向)、description 只包含增量发现(不重复图中已有信息)。
Explore 同样拥有双阶段超时模型,结构与 Bootstrap 几乎一致,但 conclude 阶段会重新写入一份图快照(新进程需要访问图信息),且 Prompt 使用 explore_conclude.md。
6.4 Reason:图的"大脑"
Reason 是最独特的任务类型。它不执行任何实际操作,只做一件事:读取当前图的状态,决定下一步该探索什么方向。如果把图比作一棵生长的树——Bootstrap 试图一步从根长到叶,Explore 负责长出一段新枝条,Reason 决定枝条往哪个方向长。
Reason 有五个与 Bootstrap/Explore 的结构性差异:
单阶段模型——没有 Conclude Fallback。Reason 不调用外部工具、不执行命令、不等待网络响应——它只是读图、思考、输出 JSON。如果在合理时间内都无法完成这样的"纯思考"任务,conclude 也救不了。
不同的心跳类型——Reason 没有 Intent(它的任务是创建 Intent),心跳走 client.reason_heartbeat 而非 client.heartbeat。
三种输出类型——不是简单的 accept/reject:complete(Fact 已满足 Goal,标记项目完成)、intents(需要新探索方向,逐个创建 Intent)、noop(当前 Intent 已覆盖需求,暂无新方向)。
最复杂的 Prompt 构造——五个变量注入:图快照文件引用、除 goal 外所有 Fact ID(限制 Intent 的 from 来源)、当前未完成 Intent 列表、最大可创建 Intent 数。allowed_fact_ids 排除 goal 保证了 DAG 的方向性——Intent 应从已知事实出发朝 goal 生长,而不是反向。
Reason 可直接完成项目——当多个 Explore Worker 各自找到部分答案,Reason 综合所有 Fact 后发现答案已完整,它可以调用 client.complete 标记项目完成。data["from"] 是一个 Fact ID 列表,记录完成的依据来自哪些 Fact,保证可追溯。
6.5 三种任务的协作关系
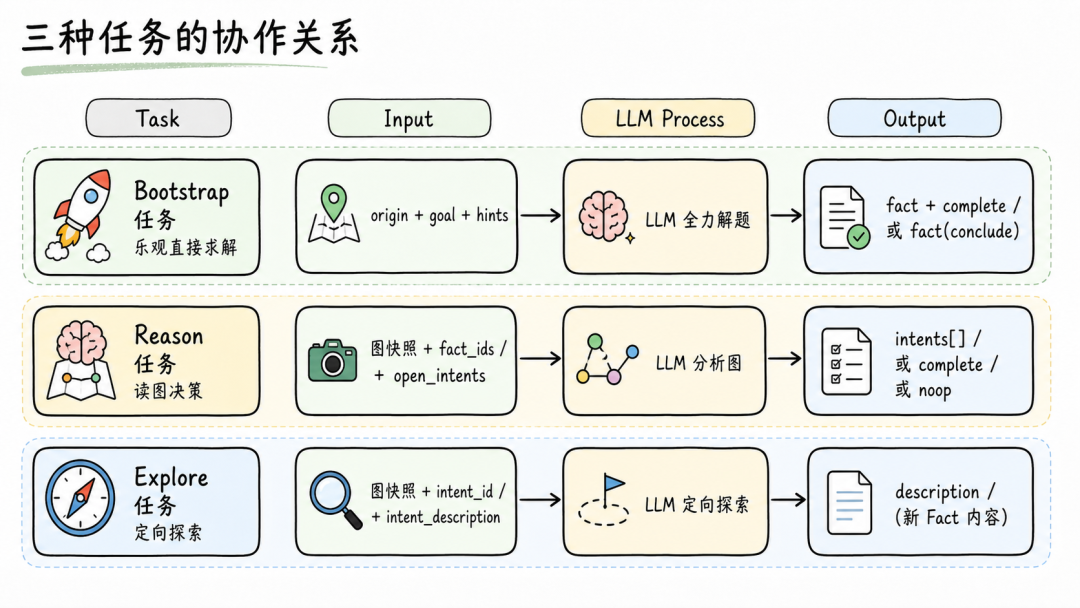
三种任务形成认知循环:Bootstrap 快速尝试 → 失败则进入 Reason(审视→规划方向)→ Explore(执行探索→产出 Fact)→ 新 Fact 触发 Reason → 循环直到 Reason 判定完成。
去掉任何一种都不行:去掉 Bootstrap,简单问题也要走迭代循环——过度设计;去掉 Reason,Explore 没有方向指引——图无法生长;去掉 Explore,Reason 能规划但无人执行——纸上谈兵。
6.6 Driver 接口:任务与 LLM 后端的桥梁
三种任务都通过 get_driver(worker.type) 获取对应的 Driver 实例。Driver 的核心职责是将统一的 build_execute(prompt, session) 接口翻译成具体 LLM CLI 的命令行。
Session 在每一步都可能被更新的设计——prepare_session() → build_execute() 中 session 可能被修改 → extract_session() 从输出中更新——让不同 Driver 可以用完全不同的策略管理 LLM session,而任务代码无需关心细节。
任务系统定义了"做什么"。但它需要在真实的容器和进程中运行——容器如何管理?进程如何监控?心跳如何保活?
7. 运行时基础设施与 Worker 适配器
运行时层由两个子系统构成:运行时基础设施(容器管理、进程执行、心跳维持、健康检查、任务取消)回答"在哪里跑、跑多久、怎么知道还活着";Worker 适配器(Driver)回答"这条指令对具体 LLM 后端意味着什么"。
7.1 容器生命周期管理
ContainerManager 实现了一个 Project 对应一个 Docker 容器的映射。容器以 sleep infinity 作为入口命令——它只是一个"空壳执行环境",所有实际工作通过 docker exec 注入。这种模式的优势在于:环境隔离(不同 Project 互不干扰)、状态持久(同一 Project 的多次任务共享容器内文件系统)、生命周期独立(容器不依赖某次任务的成败)。
ensure_running(containers.py:37-74)采用三阶段幂等策略:已 running → 直接返回;已存在但停止 → 启动;不存在 → 创建新容器。并发安全通过 per-name 锁实现——为每个容器名称维护独立的 threading.Lock,外层用 guard lock 保护锁字典本身。
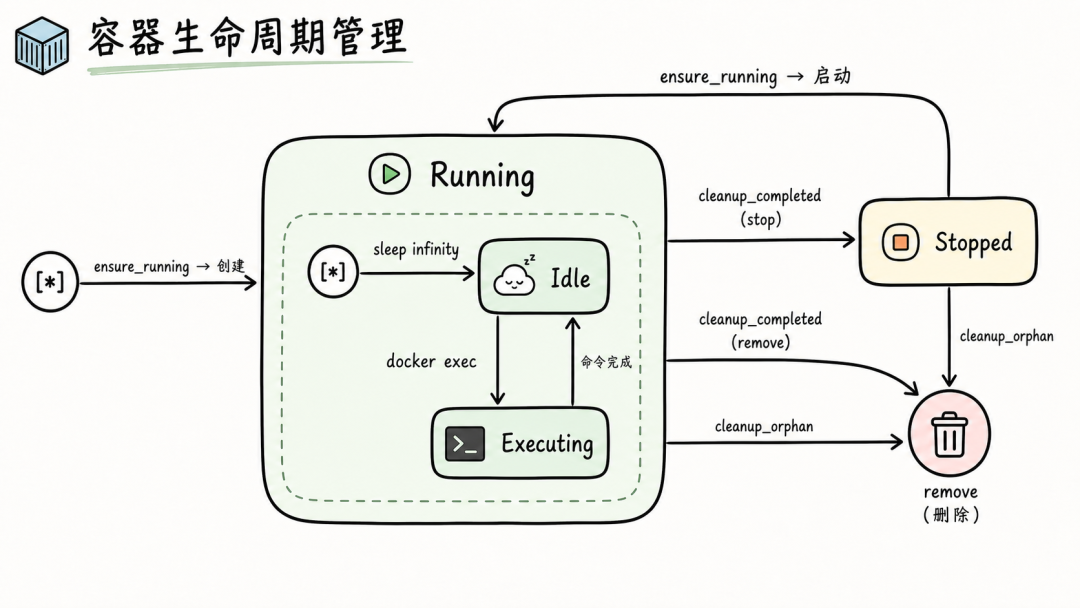
为什么不用容器池? Worker 需要在同一 Project 的多次任务间共享容器内状态——Claude Code 的 --session-id 依赖容器内的 session 数据,Pi 需要 PI_CODING_AGENT_DIR 下的 models.json。容器池每次分配"干净"容器会丢失这些状态,维护亲和性映射又等价于当前设计,反而增加复杂度。
7.2 进程执行模型
ManagedProcess(process.py)封装了容器内命令执行的完整流程。启动后,daemon 线程使用 demux=True 读取流,将 stdout 和 stderr 分离为元组。communicate 方法是外部等待入口——超时后标记 timed_out → kill 进程 → 再等 5 秒 → 若仍存活则硬设退出码 137。
kill 的三重回退是对 Docker 容器环境不确定性的务实应对——不同镜像的 kill 命令位置和 shell 配置可能不同:
1.
kill -KILL {pid}—— 标准方式2.
/bin/sh -lc "kill -KILL {pid}"—— 通过 login shell3.
sh -lc "kill -KILL {pid}"—— 回退到另一个 sh 路径
注意这三步都是 SIGKILL(不是信号升级),区别仅在执行路径。exit_code 0 或 1 均视为成功——进程可能已自行退出。
容器层面还有一层超时保护:build_exec_process 在命令前包裹 Linux timeout 命令(带 -k 参数),与 communicate 的外层超时形成双重超时机制。
7.3 心跳机制
HeartbeatLease 在后台线程中定时向 Server 发送心跳,维持 Worker 对 intent 或 reason 的"租约"。两个工厂方法对应两种场景:for_intent(Worker 持有具体 Intent)和 for_reason(Worker 持有 Reason 锁)。
故障分级处理是心跳设计的精华:
• 致命错误(403/409):立即失败——403 表示 Project 已不活跃,409 表示 intent 已被其他 Worker 接管,不可恢复
• 瞬时故障(其他非 200):进入 grace period(
interval × 2),只要在窗口内恢复一次心跳就重置计时
心跳最终失败时做两件事:记录 HeartbeatFailure、kill 关联进程。attach_process 将进程绑定到心跳租约——心跳失败时主动终止进程,形成从"Server 拒绝心跳"到"Worker 进程被杀"的完整反应链。
为什么选心跳而非 WebSocket? HTTP 请求无状态,网络抖动只影响单次心跳;与 Server 的 REST API 架构匹配;配合 intent TTL 机制——Worker 挂掉心跳停止,TTL 到期后 intent 被清理,其他 Worker 可接管,比 TCP keepalive 的超时检测更可靠。
7.4 任务取消机制
TaskCancellation(cancellation.py,仅 38 行)解决取消请求与进程生命周期的竞态:
• 场景 A:进程已启动,收到取消 → 直接 kill 进程
• 场景 B:取消先到,进程还没启动 → 记录原因,后续
attach_process时立即取消刚绑定的进程
两种场景通过同一个 Lock 保证原子性。这本质上是 Cancellation Token 模式(类似 C# 的 CancellationToken 或 Go 的 context.Context),与 HeartbeatLease 的 attach_process 形成对称:心跳失败和外部取消两条路径最终都汇聚到 ManagedProcess.kill()。
7.5 四种 Worker 适配器
WorkerDriver 抽象基类定义了 Dispatcher 与 LLM 后端的契约。所有方法都返回 list[str](命令行参数)或包含它的 DriverResult——命令行是最大公约数,不管什么后端最终都是在容器内执行一个 CLI 程序。
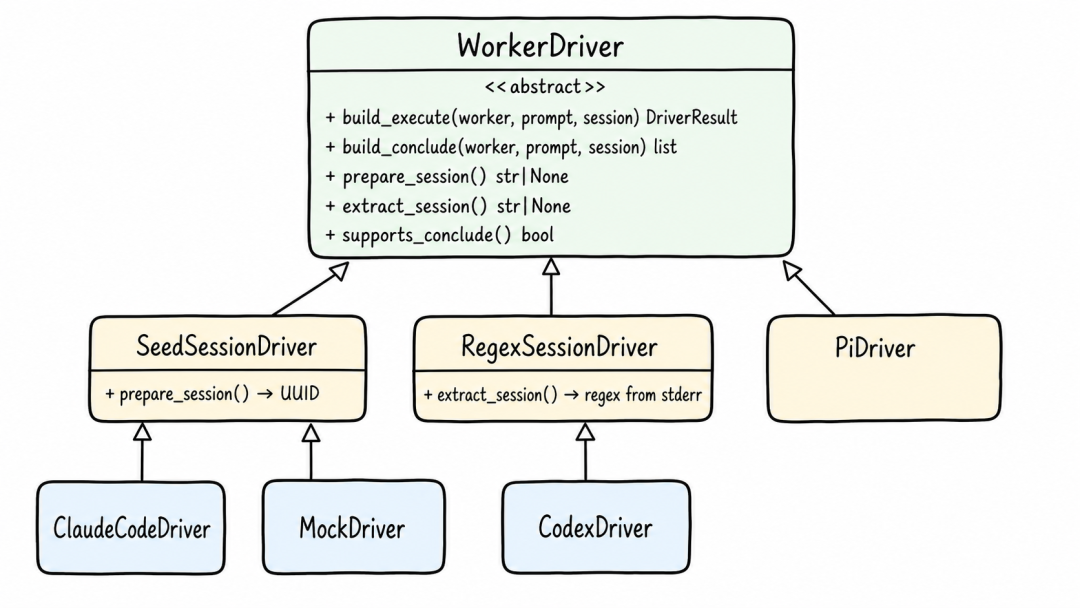
Claude Code 适配器:最"原生"的实现。执行命令 claude --session-id {uuid} --dangerously-skip-permissions -p -- {prompt},conclude 用 claude -r {session} 恢复对话。继承 SeedSessionDriver,预生成 UUID 传给 Claude Code。
Codex 适配器:通过大量 -c 参数定义名为 "cairn" 的自定义 model provider,指定 wire API、base URL 和 API key。继承 RegexSessionDriver,从 stderr 正则提取 session ID。
Pi 适配器:最复杂——Pi 需要 agent 目录结构和 models.json 配置文件,所有命令被包裹在 shell 脚本中先创建文件再 exec pi。Session 从 JSON Lines 事件流中的 {"type": "session"} 事件提取。直接继承 WorkerDriver,因为输出格式与其他后端差异太大。
Mock 适配器:内嵌 Python 脚本模拟所有任务阶段。通过概率配置和规则匹配(如"没有 open_intents 时移除 noop 选项")实现语义正确的随机输出,不依赖真实 LLM。
7.6 运行时协作全景
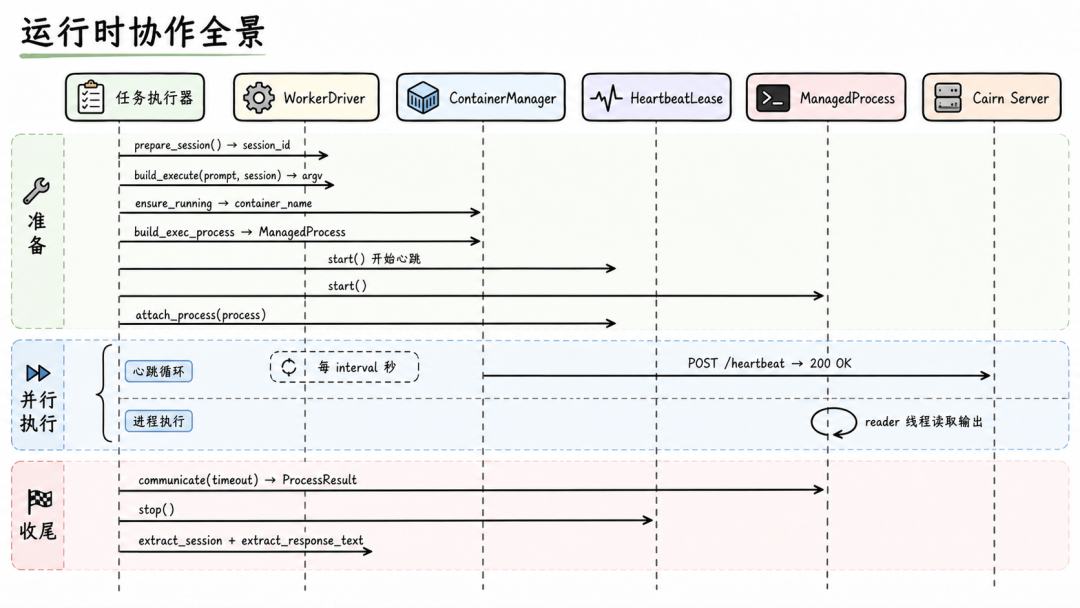
整个运行时层的核心理念是将不确定性封装在边界处:容器管理消化 Docker 环境的不确定性(名字冲突、外部删除)、进程执行消化退出的不确定性(超时、被杀、API 异常)、心跳消化网络的不确定性(瞬时故障、致命错误)、Driver 消化 LLM 后端的不确定性(CLI 格式、session 策略、输出格式)。向上层暴露的接口是干净的:ProcessResult 告诉你成功还是失败,HeartbeatFailure 告诉你心跳是否存活,DriverResult 告诉你该执行什么命令。
至此,Cairn 的四层技术架构——Server(数据)、Dispatcher(控制)、Tasks(执行逻辑)、Runtime(物理执行)——已完整展开。最后简要看一下前端 Dashboard 如何可视化这一切。
8. 前端 Dashboard
Cairn 的前端是一个纯静态的单页应用(server/static/index.html,~3400 行),技术栈为 Alpine.js + Cytoscape.js + TailwindCSS,不需要构建步骤,由 FastAPI 直接 serve。
8.1 核心功能
项目管理面板:列出所有项目,显示状态(active/stopped/completed),支持创建、停止/恢复、删除、重开等操作。项目列表按状态分组(active 优先),每个项目显示 Fact 和 Intent 数量作为进度指示。
Fact-Intent 图可视化:使用 Cytoscape.js 渲染 DAG。Fact 节点和 Intent 边都有颜色编码——origin(绿色)、goal(橙色)、普通 Fact(蓝色)、completion intent(特殊标记)。支持点击节点查看 Fact/Intent 详情,以及自动布局(dagre 算法保证 DAG 的层次结构清晰)。
实时轮询:通过 setInterval 定期拉取项目状态和图数据(与 Dispatcher 的 poll 模式一致),更新时保持 Cytoscape 视图的平滑过渡,不会因为数据刷新导致布局跳动。
Hint 管理:可以随时向项目添加 Hint,即使项目处于 stopped 或 completed 状态。这与 Server 端的 Hint 写入规则(services.py:65-69)一致——Hint 是人类用户向 Worker 传递指导的专用通道。
8.2 设计特点
零构建依赖——所有第三方库通过 CDN 引入(Alpine.js、Cytoscape.js、dagre、TailwindCSS),无 npm、无 webpack、无 node_modules。这与 Cairn 的工程风格一致:用最简单的技术满足需求。
Server 驱动渲染——前端不维护复杂的本地状态,每次渲染基本依赖 Server 返回的最新数据。Alpine.js 的响应式绑定让数据到视图的映射足够声明式。
9. 评价与启发
9.1 系统性设计哲学
"Less Than Nothing"——不是"少即是多",而是"什么都不给"
分析全部 ~6000 行核心代码和 5 个 prompt 模板后,最惊人的事实是:整个系统不包含一行领域知识。
• Server(1361行):纯 CRUD + 并发控制,不理解 Fact 的语义
• Dispatcher(1466行):基于结构化指标调度,不评估 Intent 的质量
• 任务系统(1488行):执行框架,不注入探索策略
• Prompt 模板(~220行):只有结构约束(JSON 格式、角色定义),零领域知识
这不是"忘了加"——这是刻意的架构决策。传统 Multi-Agent 系统给每个 Agent 分配角色和领域知识,Cairn 反其道而行之:给 LLM 一个结构化的"棋盘"和规则,然后完全信任 LLM 的推理能力。这是一个只有 LLM 才能让其工作的架构——传统软件中,零知识的系统不可能有效工作。
三个贯穿全局的设计模式
"宽容输入、严格输出"——与 LLM 协作的核心原则。Server 对已 unclaimed 的 Intent release 不报错(幂等);Worker 选择中 rejected 状态以三元组粒度冷却(精准容错);Bootstrap conclude 检测到 complete payload 时 warn 但不拒绝;kill 三重回退、心跳 grace period、exit_code 0/1 都算成功。LLM 的输出不可精确预期,系统在接收端做最大努力的解析。
"智能下推、接口上提"——每一层都把自己的复杂性消化在内部。Server 向上只暴露 CRUD + 状态查询,内部吸收 WAL 并发、惰性清理、超边关联表;Dispatcher 向上只暴露 outcome 字符串,内部吸收 checkpoint 去重、多层 Worker 选择;Runtime 向上只暴露 ProcessResult,内部吸收容器 per-name 锁、三重 kill、流式 demux。
"成功即清白"——Worker 成功完成任务后,unhealthy 和 rejected 状态立即清除;心跳恢复一次成功就重置 grace period。不累积"前科",一次成功就完全恢复信任。这是一种乐观的健康管理策略,适合 LLM 失败通常与具体上下文相关而非系统性故障的场景。
9.2 值得学习的设计
极简并发控制——~250 行代码实现完整的分布式协调(Intent claim/heartbeat/expire、Reason lease、惰性过期清理)。没有 Redis、Zookeeper、消息队列,只有 SQLite + 心跳超时。在目标规模(个位数到低两位数并发 Worker)下完全够用,复杂度与规模匹配。
Reason Checkpoint 的竞态防护——checkpoint 更新使用提交时快照而非完成时实时值,避免"跳过中间变化"的竞态。与 Server 端 reason_lease 形成双层去重:Server 防多实例竞争(分布式互斥),Dispatcher 防自身重复(本地去重),两者互补缺一不可。
双阶段超时模型——对 LLM 不可预期执行时间的务实应对。execute 超时后,conclude 在同一 session 中给 LLM"最后一次机会"总结已有成果,而非直接丢弃所有工作。通过 Driver 的 supports_conclude() 实现能力声明,不支持 session 复用的后端自动跳过 conclude。
Append-Only 的 Fact——只有 INSERT 没有 UPDATE/DELETE。reopen 操作是这个哲学的极致体现——不是翻转状态位,而是在图中留下完整的"完成→推翻→重新开始"的审计轨迹。
9.3 改进空间
单点 SQLite 的规模天花板——WAL 模式下写事务串行。Worker 数量增长到数十个、项目增长到数百个时,Server 可能成为瓶颈。惰性清理机制在低频读操作时可能导致过期 Worker 长时间未被清理。改进方向:PostgreSQL 替换(保持 SQL 语义)或后台定时清理补充惰性策略。
缺少 Worker 输出质量反馈——Dispatcher 只知道任务"成功还是失败",不评估 Fact 的质量。Worker 可以持续产出低质量的 Fact(如"我尝试了但没结果"),系统无法检测和纠正。改进方向:在 Reason 阶段增加 Fact 质量评估(仍由 LLM 完成,不破坏通用性),或引入 Fact 投票机制。
Explore 的深度优先偏向——选择 created_at 最大的 unclaimed Intent,倾向于深度优先。某些场景下广度优先更合适。改进方向:让 Reason 标注 Intent 优先级或探索策略。
无内置监控——如果所有 Worker 进入死循环(不断产出无意义 Fact),系统会持续消耗 API Token 而不自知。改进方向:图生长速率监控、Token 消耗追踪、"图停滞"告警。
容器缺少资源限制——ContainerManager 创建容器时没有设置 CPU/内存限制。多 Worker 重负载时可能导致宿主机资源争抢。
9.4 "如果重新设计"
保留的核心设计:Fact-Intent DAG(最核心的创新)、三种任务分离(Bootstrap/Reason/Explore 分工清晰)、Server 零智能(分层解耦的基石)、双阶段超时(对 LLM 不确定性的务实应对)。
建议调整:
1. 事件驱动替代轮询:引入 SSE(Server-Sent Events),Server 推送"黑板有变化"通知,Dispatcher 收到后再拉取,减少空轮询同时保持读写分离语义
2. Fact 质量信号:让 Reason 对已有 Fact 做有用性评分,帮助 Explore 选择更有价值的方向,在不破坏通用性的前提下增强收敛效率
3. 图的分支与合并:支持"假设分支"——在某个节点上尝试不同方向,保留最优路径,增强探索效率
4. 可观测性层:OpenTelemetry 集成、结构化日志、Token 消耗追踪——当前的 logging 是面向调试的,不足以支撑生产环境运维
9.5 Cairn 的独特定位
Cairn 不是"又一个 Multi-Agent 框架"。它的核心差异在于三点:
1. 无角色分工——不给 LLM 贴标签("你是安全专家"),而是让 LLM 面对问题自行判断。这放弃了 prompt engineering 的精确控制,换取了完全的通用性
2. 结构化涌现——通过 DAG 结构引导但不限制探索方向。图的生长由 LLM 的推理能力驱动,系统只提供棋盘和规则
3. 完整审计——每一步推导都在图中留痕,可回溯、可分支、可重开。reopen 不是 undo,而是在历史上追加新的叙事
这三者结合,使 Cairn 成为一个真正的通用问题求解引擎——同一套代码可以用于代码调试、学术研究、安全分析、任何需要迭代求解的领域,无需任何领域适配。这种"Less Than Nothing"的极端通用性,既是 Cairn 最大的赌注,也是它最大的价值所在。