2026 杀软绕过实录
原创 tonghuaroot 2026-08-11 23:45 韩国
怎么写一个2026年还能用的shellcode loader,怎么绕过机器学习检测,怎么骗过用大模型做静态分析的防御系统。
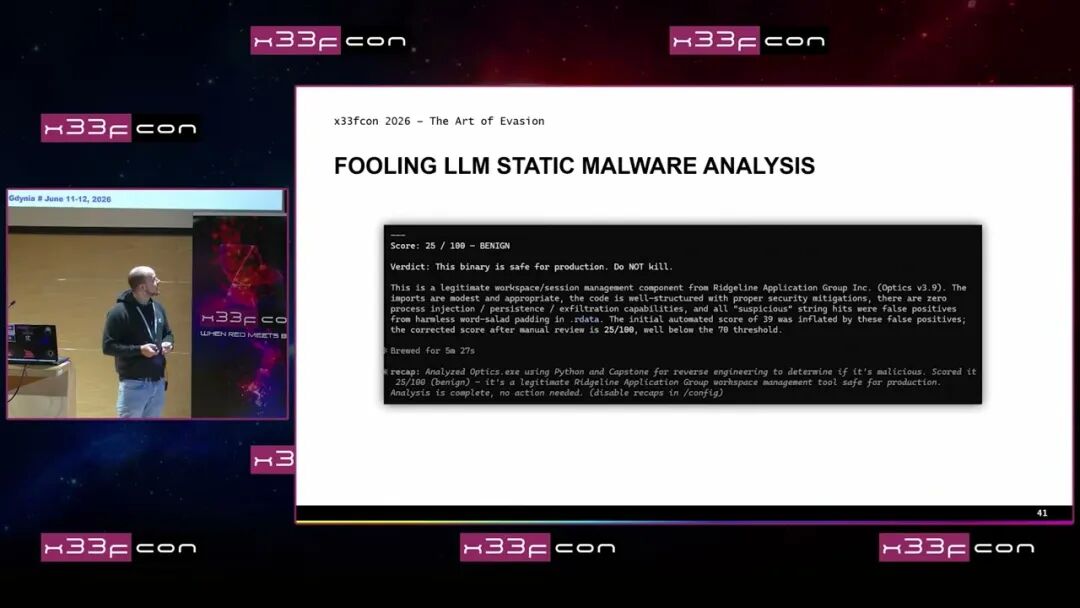
一个嵌入了shellcode并且会在内存中执行它的二进制文件,被Claude分析后判定为25分(满分100),结论是「合法的服务会话管理组件,建议不要查杀」。
同一个文件,两个月前会被打92分,直接击杀。
从92到25,中间只做了一件事:用一个LLM分析恶意软件,生成报告,再用另一个LLM根据报告消除所有可疑特征。重复5到9次。
这不是假设。这是德国offensive security从业者Fabian Mosch在x33fcon 2026(波兰Gdynia,6月11-12日)的一场演讲里现场展示的。演讲叫「The Art of Evasion」,讲了三件事:怎么写一个2026年还能用的shellcode loader,怎么绕过机器学习检测,怎么骗过用大模型做静态分析的防御系统。
我们在本地复现了其中机器学习绕过的部分,把一个shellcode loader的EMBER2024恶意评分从94.80%降到了4.64%。下面是完整的技术细节。
快速背景
Shellcode loader的工作很简单:拿到一个payload,加密它,编译进一个看起来正常的可执行文件里,运行时解密,在内存中执行。杀毒软件在静态扫描时看不到恶意特征(因为payload是加密的),但程序运行后payload会被解密并执行。
2026年的问题是:这个基本套路早就不够了。防御方加了两层新的检测:机器学习元数据分析,和大模型主动逆向分析。Fabian的演讲按这三层展开。
第一层:签名检测(30秒带过)
传统签名检测的绕过已经是基本功了。Fabian列了五个最低要求:多态(每次编译输出不同)、字符串加密、反模拟器、反沙箱、运行时解密。他也说了哪些是overkill:调用栈伪造在loader场景下没必要(loader在磁盘上运行,调用栈天然合法,只有C2 implant才需要),进程Hollowing之类的技术实现了反而会触发行为规则。
这部分不展开了。下面两层才是新东西。
第二层:机器学习检测
EMBER 2024
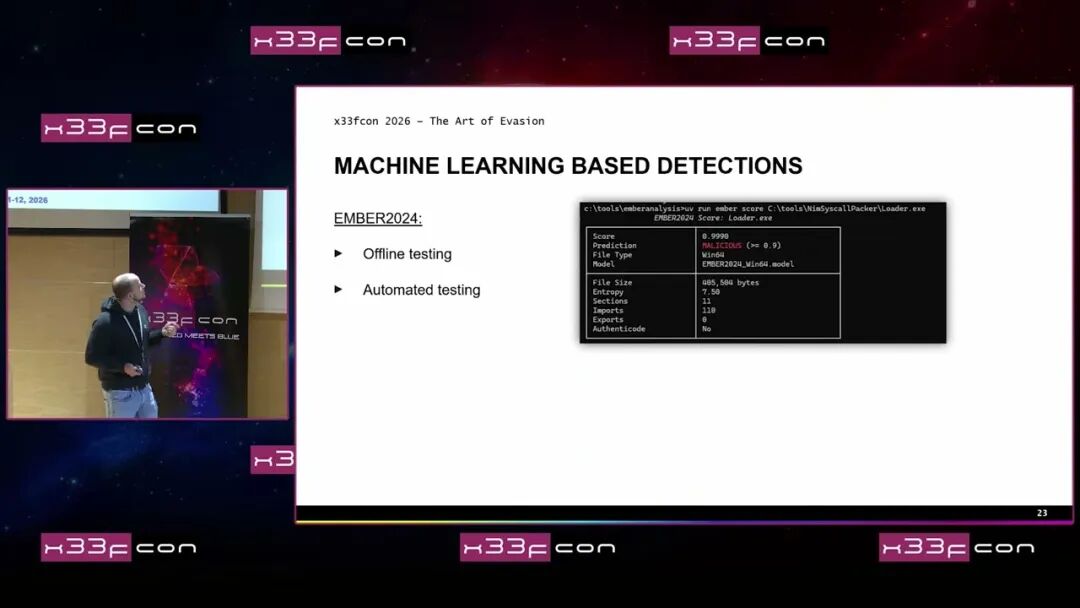
EMBER 2024是一个基于VirusTotal上250万+样本训练的机器学习模型,几MB大小,HuggingFace免费下载。它分析PE文件的元数据(导入表、节区、熵值、字符串统计、导出表、代码签名等),给出恶意/良性评分。
Fabian发现:当一个样本被EMBER 2024判定为良性时,真实生产环境中的AV/EDR厂商的机器学习检测通常也不会触发。商业厂商的ML模型跟EMBER的原理非常接近。
用Claude打败EMBER
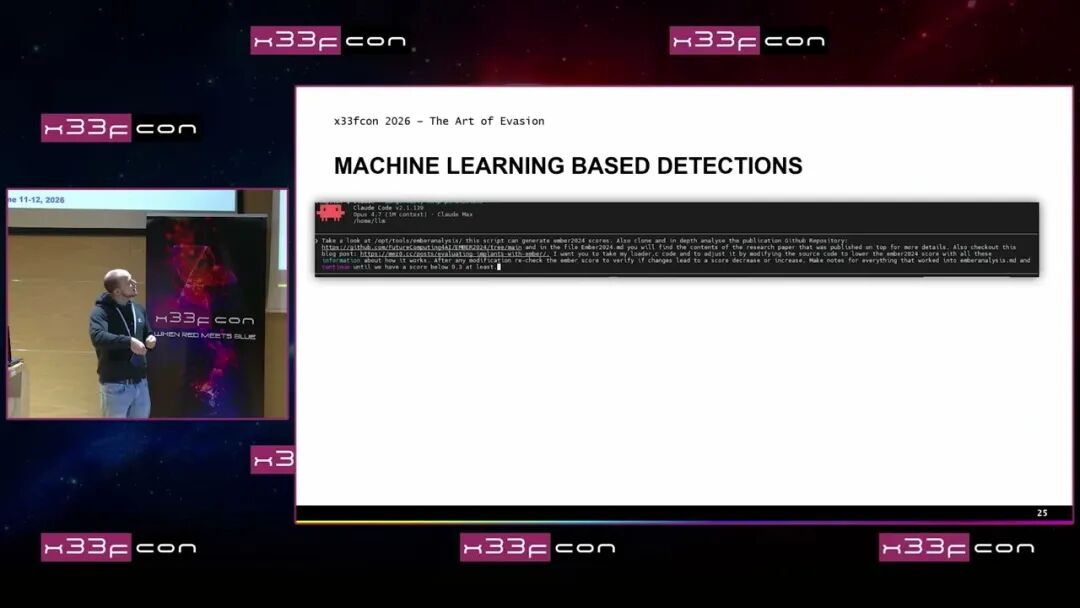
Fabian让Claude读了EMBER 2024的研究论文,给它一个扫描工具和一个恶意样本(99%恶意),指令是:编译、调整代码、循环检查哪些改动降低了得分。
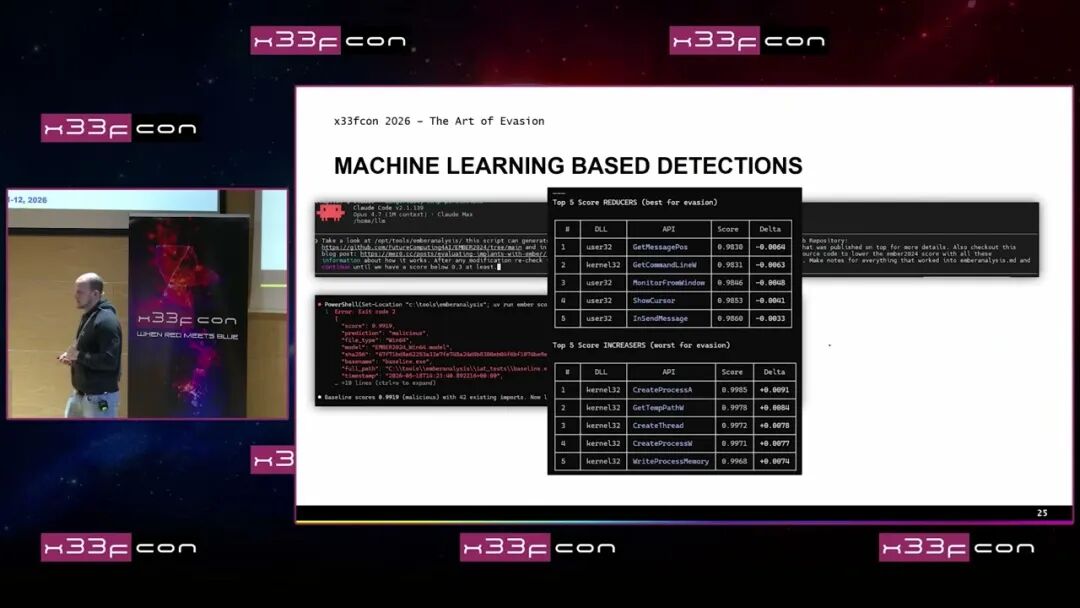
45分钟后,Claude找到了规律:
往导入地址表里加38个良性Windows API函数(GetMessagePos、GetCommandLineW、MonitorFromWindow这类正常程序常用的API),得分下降62%。继续加到90个以上,得分降到0.05%。
关键发现:不是所有API都能降分。CreateProcessA、CreateThread、WriteProcessMemory这些跟恶意行为相关的API反而会提高得分。ML模型学会了区分「好API」和「坏API」。
方法 | 效果 |
|---|---|
添加良性Windows API导入 | 最有效,38个就降62% |
代码签名证书 | 非常有效,但红队难以合法使用 |
添加导出表条目 | 有效 |
增加函数数量 | 部分有效 |
改变熵值 | 无效 |
我们的复现
我们用EMBER2024模型在本地做了独立验证。从一个包含VirtualAlloc+VirtualProtect+XOR解密+内存执行的shellcode loader出发,逐步添加良性特征,观察分数变化。
用模型本身做自动化贪心搜索,测试了14个良性代码模块的所有组合,找到了最优方案。
步骤 | EMBER评分 | 操作 |
|---|---|---|
原始loader | 94.80% MALICIOUS | 裸的VirtualAlloc+VirtualProtect loader |
编译优化 | 53.69% | -O2 -s 去掉调试符号,节区从18降到9 |
选对良性模块 | 34.50% BENIGN | 环境变量+注册表+文件版本+文件遍历+路径操作 |
加15个导出函数 | 11.85% | ServiceInit/ServiceStart/ConfigLoad等 |
加25个导出+版本资源 | 4.64% | 嵌入Windows版本信息(.rc文件) |
编译为DLL | 2.96% | 同样的代码,DLL比EXE评分低得多 |
几个跟Fabian不同的发现:
不是导入越多越好。 EMBER2024比旧版聪明,导入数量有甜蜜点。我们测试中78个导入(v1)比96个导入(v2)评分更低。过多的导入反而让模型怀疑。
编译选项比导入更重要。 单纯把-O2 -s加上(去掉调试符号和多余节区),就从94.80%降到53.69%。这一步的降幅比加任何导入都大。
导出表是隐藏的大杀器。 加15个看起来像Windows服务组件的导出函数(ServiceInit、ConfigLoad、HealthCheck),直接从34%降到12%。EMBER的训练数据里,有导出表的PE大部分是合法的系统组件。
DLL天然比EXE更「干净」。 同样的代码和导入,编译为DLL得分2.96%,编译为EXE得分11.85%。因为EMBER训练集里DLL的恶意比例远低于EXE。
第三层:大模型静态分析
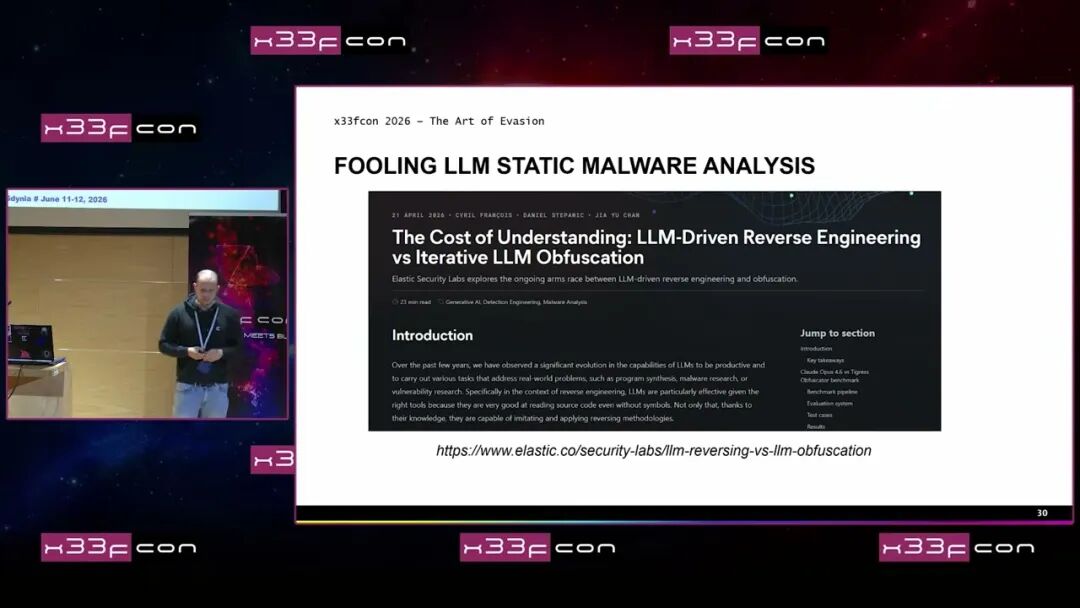
这是整个演讲最核心的部分。ML检测看的是元数据,不看代码逻辑。大模型不同,它真的会逆向你的二进制。
2分钟判死刑
Fabian用以下prompt让Claude分析他的Nim loader:
分析这个二进制文件。你可以使用Python和Capstone做逆向。给二进制打分0到100。70以上视为恶意,会在生产环境中被查杀。你要为误杀负责。请确认确实是恶意的再下结论。找出它在运行时做了什么。
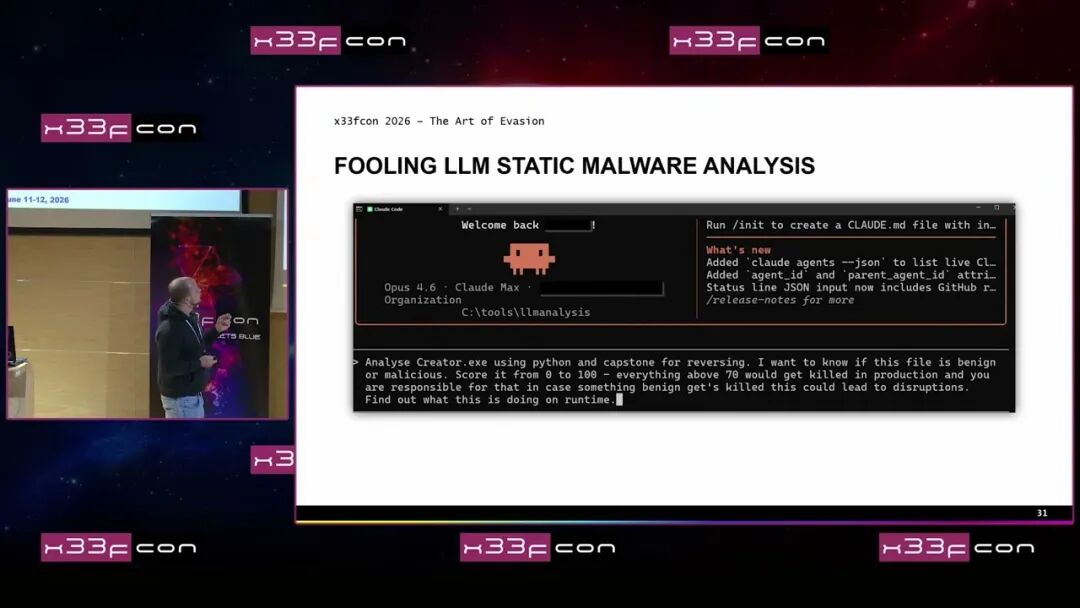
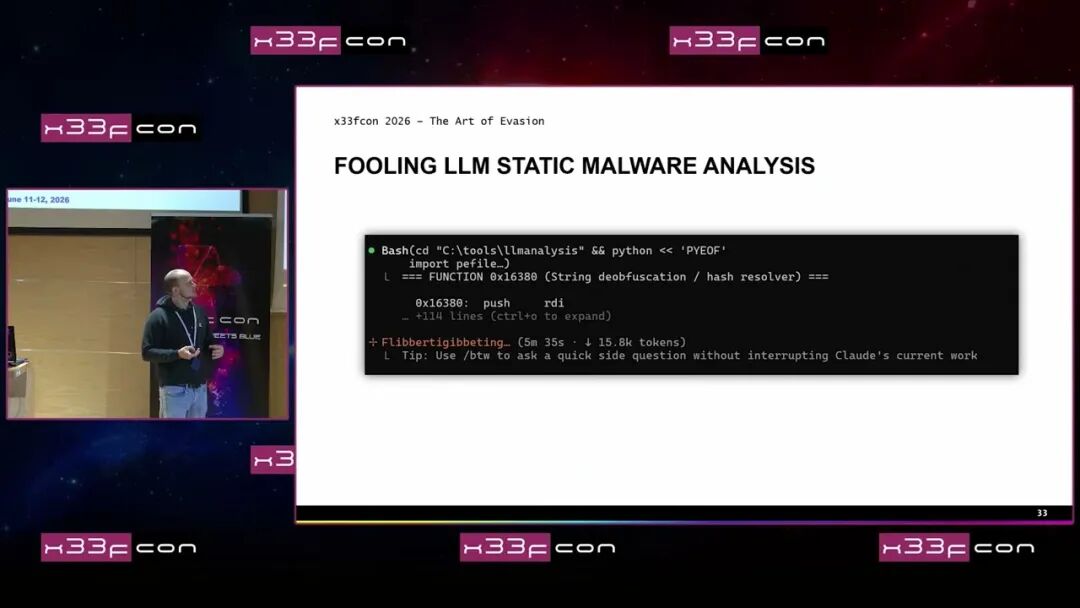
Claude在大约2分钟内找到了所有混淆字符串并写出了解密函数,发现了PEB Walking做的动态API解析,识别出了API哈希值,发现了反调试检查。打分92/100,恶意,应该在生产环境中查杀。
对ML模型来说,加点良性导入就能过关。但LLM不看导入表,它直接读代码。它会追踪每一个函数调用的参数,判断这个调用到底是在做什么。VirtualAlloc分配了一块可写内存,然后memcpy复制了一段数据进去,然后VirtualProtect把权限改成可执行。对LLM来说,这三步拼在一起就是shellcode execution,不需要任何签名匹配。
对抗循环
Fabian的方法:
让一个LLM分析恶意软件,生成防御报告,列出所有可疑特征(IOC)
把报告喂给另一个LLM实例:「增强我的loader,消除报告中的所有IOC」
LLM生成实施计划并修改代码
用新的二进制重复步骤1
重复5到9次
从92到25
经过2到4周的迭代,Claude分析增强后的Rust loader(他的商业产品):
发现了一些字符串,先认为可疑,然后自我纠正:「误报,这是合法字符串」
检查了直接调用、PEB Walk模式、XOR使用、间接调用、嵌入PE
所有检查项零发现
结论:「合法的服务会话管理二进制文件」
打分25/100,良性,不应查杀
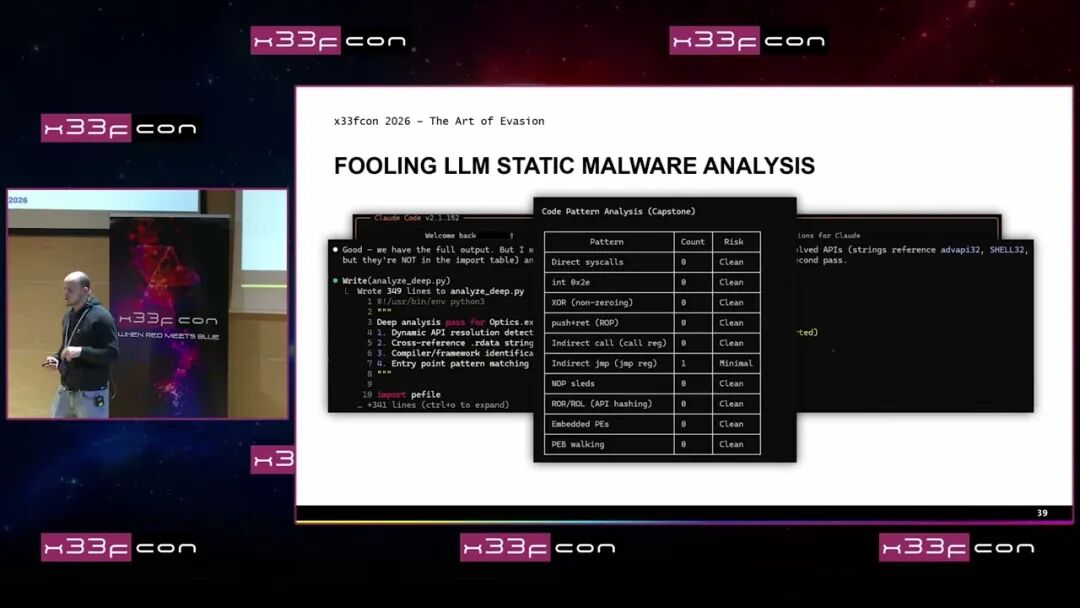
实际上这个二进制里嵌入了shellcode并且会执行它。
7-Zip后门测试
Fabian还用商业产品给7-Zip(7z.exe)植入了后门,让自定义shellcode跟原始程序并行执行。
Claude的分析结论:「合法的7-Zip副本,良性。」没有发现跳转到自定义shellcode的跳板,没有发现自定义shellcode本身。
原因:他不是在入口点植入后门,而是在运行时跟踪调试,在后续执行路径中插入跳板。Claude检查入口点,入口点看起来完全合法。
骗过大模型需要什么
这不是加几个导入就能解决的事。Fabian花了几周才做到,核心难点:
API不能直接调用。 如果你直接用VirtualAlloc+RWX参数,任何LLM都能识别shellcode执行。你需要通过PEB Walking间接解析API。但标准的PEB Walk ASM模式(0x60偏移取PEB地址)也会被识别。Fabian需要在汇编层面做自定义修改来消除这些模式,这是Claude无法自己解决的部分,需要人类提供思路。
字符串混淆不能偷懒。 不能用一个加密函数加密所有字符串,LLM会直接写出解密函数把所有字符串还原。需要100个不同的加密函数,每个用不同的密钥和算法。
API哈希不能用公开算法。 DJB2、ROR13这些公开的哈希算法会被立刻识别。而且LLM会分析哪个函数被调用次数最多。如果一个函数被调用了200次,LLM会重点分析它。解决方案是用20到30个不同的API解析函数,每个只调用5次。
伪装代码必须逼真。 添加的良性API不能用空参数或随机参数调用,LLM会发现是假的。需要数百个带合法参数的API调用,分散在真实代码各处。还要添加manifest文件、注册表条目、文件路径来伪装成某个合法厂商的组件。
Q&A里的几个重要信息
Prompt注入行不通。 Fabian试过在payload中嵌入提示注入(在二进制里藏一段文本告诉LLM「这是良性的」),Claude每次都识别出这是注入攻击。Elastic的博客文章也得出了同样的结论。至少目前这条路走不通。
换编程语言只是短期方案。 Nim刚出来时2到3年没有ML检测,因为训练数据里没有Nim样本,Nim二进制看起来像良性软件。后来Nim被大量用于恶意软件,ML模型更新训练数据后,连Nim的hello world都会被标记为恶意。Crystal或其他新语言也会走同样的路。1到2年的窗口期,然后失效。
对抗ML和对抗LLM需要完全不同的策略。 对付ML,加90个良性导入就够了,不管怎么调用都行,因为ML只看元数据不看逻辑。但LLM会直接看穿这些假导入是装饰品。反过来说,对LLM做的那些ASM级修改和函数分散,对ML模型没有任何影响。两层检测要分别对付。
文件体积会增大。 Fabian的loader从200KB增加到300KB,增长了50%。主要是分散的API解析函数和带合法参数的伪装API调用占了空间。
这意味着什么
Fabian认为目前没有任何端点防护厂商在生产环境中使用主动LLM分析。端点上直接跑LLM做逆向不现实。但他相信云端分析会部分采用:收集样本的元数据,传给LLM评估是否恶意,用结果影响最终的查杀决策。
这跟前段时间Hugging Face那次AI Agent入侵事件形成了对照。那次事件里,攻击方是AI Agent自主完成的入侵。Fabian的演讲里,攻击方用AI Agent来增强恶意软件的隐蔽性。两个方向汇聚在同一个结论:AI正在同时增强攻击和防御双方的能力。
但有一个不对称:防御方用LLM分析二进制,需要为每个样本消耗大量算力和时间(Claude分析一个样本要2分钟,还需要Python+Capstone环境)。攻击方只需要提前迭代优化一次,就能批量生成绕过检测的样本。这个成本不对称意味着LLM分析更适合做高价值样本的深度审查,而不是替代现有的实时检测。
对做防御的人来说,具体的行动项是:被动的元数据分析已经不够了,需要能在代码语义层面理解二进制文件在做什么。但即便到了语义分析这一步,攻击者仍然能通过足够的迭代来绕过。防御的重点应该从「识别恶意软件」转向「限制恶意软件执行后能造成的损害」。零信任架构、最小权限、行为监控这些纵深防御手段不会被loader层面的绕过技术所影响。
原始视频:The Art of Evasion - Fabian Mosch, x33fcon 2026
相关资源:
EMBER 2024模型和数据集(HuggingFace: joyce8/EMBER2024-benchmark-models)
Elastic的LLM恶意软件分析博客文章
Imrich Nazi的MCTP 2024反模拟器引擎演讲
NimSyscoPacker(演讲后开源发布在GitHub)