从配置驱动到业务原生:基于 AgentScope 的企业级 Agent 开发实践
原创 丁磊(雷茂) 2026-07-15 20:00
AgentScope 企业级业财智能体的核心设计与实战复盘。
01
背景
Aliware
▍1.1 出发点
1.1.1 业务思考
tips:笔者是海外物流业财团队,所以付款流程是非常核心的能力。
最近的一次需求规划讨论,引发了团队对现有产品的深刻反思。产品同事针对我们之前上线的“付款审批 Agent”提出了几个关键问题,直指当前系统的局限性:
首先,Agent 是否具备真正的“记忆”与“智慧”?
目前的审批场景中存在大量重复性的拒绝原因。例如,当因为供应商存在未处理的负数账单而拒绝付款 A 后,几天付款 A+ 再次提交时,Agent 能否记得之前的拒绝原因,并自动检查该问题是否已解决?此外,Agent 能否通过分析审批轨迹,发现像用户 A 那样“一次性清晰反馈”的高效模式,并将这种最佳实践推荐给像用户 B 那样需要多次往复才能通过审批的用户,从而提升整体效率?
其次,交互能否更加个性化?
Agent 能否自动记忆个人的操作习惯,在对话中根据用户平常关注的重点,提供定制化的提示信息?
第三,能否实现运营自助式的快速定制?
我们希望未来在非技术人员的参与下运营同学也能快速定制专属 Agent。例如在“已计费溯源分析”场景中,帮助业务人员理解“为什么这笔费用是这样计算的”。理想状态下应具备快速配置、快速测试、快速上线的能力。
第四,如何确保财务级的操作安全?
财务安全是第一要义,任何写操作都需要苛刻的审批和确认。目前依靠 Prompt 提示模型进行二次确认的做法无法做到百分百拦截。我们需要一种更精准的机制,在自规划、自执行的工作流中,严格控制哪些写操作必须经由用户确认。
最后,是否支持精准的灰度与实验?
系统需要支持针对特定用户群体进行灰度发布,甚至开展 A/B Test,以验证不同策略的效果。
这些问题让我们猛然醒悟:原来我们之前做的只是一个简单的 Chatbox(聊天框),而非真正的智能 Agent。这一认知激发了团队的沉思。在接下来的一个多月里我们采访了其他团队的案例,展开了多轮分析与讨论,最终沉淀出了以下的技术思考方向。
1.1.2 技术思考
1.1.2.1 思考
先问一句:您的高代码长什么样?
我们观察了几个基于 Google ADK、AgentScope等框架构建的 Agent 应用(Java)。它们呈现出惊人的相似结构:
my-agent-app/├── FinanceAgent.java ← new ReActAgent(), 硬编码 prompt├── HRAgent.java ← new ReActAgent(), 硬编码另一个 prompt├── SalesAgent.java ← new ReActAgent(), 又一个 prompt├── FinanceTool.java ← 注解,直接注册├── HRTool.java ← 注解,直接注册├── SessionManager.java ← 自建会话管理├── ContextCompressor.java ← 自建上下文压缩├── SSEController.java ← 自建 SSE 流式输出└── ...
每个团队都在做同样的事:
1. 手写 Agent 类:每个应用有 10+、甚至几十个手写 Agent;每个 Agent 对应一个 Java 类,在构造函数里写死 prompt、指定模型、注册 tool。
2. 手建基础设施:会话持久化、上下文压缩、SSE 协议适配、HITL 框架——每个团队各搭一套。
3. 修改需要发版:改个 prompt 、新加一个 SKILL、新增一个MCP tool,要改代码、编译、部署,一个简单的提示词调优变成一次完整的研发流程。
这是一个工程问题,不是 AI 问题。
1.1.2.2 Agent 工程中的典型坏味道
在实际的 Agent 系统落地过程中,由于缺乏统一的工程化规范与平台支撑,代码库中往往充斥着大量重复、僵化且难以维护的实现模式。以下总结了七类典型的“坏味道”,它们不仅增加了研发成本,更引入了严重的稳定性与安全风险。
坏味道 1:样板代码泛滥——“克隆”而非“创建”
现象描述:
每个 Agent 都被实现为一个独立的 Java 类,且每个类都包含完全一致的双重检查锁定(DCL)单例模式、@PostConstruct 初始化逻辑以及硬编码的依赖注入。
java// BAD:每个 Agent 类都复制了 200+ 行的样板代码public class FinanceMasterAgent {private static volatile LlmAgent instance;// ... 标准的 DCL getInstance() 实现 ...public void initializeOnStartup() {AgentRegistry.register(getInstance());}}
问题分析:
在一个拥有 20+ 个 Agent 的项目中,private static volatile instance 出现了 30+ 次,getInstance() 逻辑被复制了 20+ 次。新增一个 Agent 的本质变成了“复制粘贴 -> 修改类名/Prompt/工具列表 -> 修正 @DependsOn”。这种“克隆式开发”导致代码冗余度极高,任何底层框架的升级都需要修改所有 Agent 类,维护成本呈线性增长。
坏味道 2:核心配置硬编码——Prompt 迭代受阻
现象描述:
Agent 的三大核心要素——Prompt(指令)、模型参数(Temperature 等)、API Key——全部以 Java 常量或字符串字面量的形式写死在代码中。
java// BAD:500+ 行的业务决策树硬编码在 Java 方法中private static String buildInstruction() {return """你是一个专业的财务诊断助手...## Act 0: 识别用户输入...## Act 1: 诊断问题根因... (30+ 个错误码逻辑)""";}// BAD:敏感信息与模型配置硬编码public class ModelFactory {public static final String API_KEY = "sk-xxxxxxxx"; // 甚至提交到了 Git}
问题分析:
研发瓶颈:Prompt 的微调需要经历“改代码 -> Code Review -> 编译 -> 部署”的全流程,周期以周计,而业务对 Prompt 的迭代需求以天计。
安全隐患:API Key 等敏感信息直接暴露在代码仓库中。
灵活性缺失:不同 Agent 的 Temperature 参数散落在各处,无法统一管控或动态调整。
坏味道 3:能力绑定僵化——工具与 Skill 无法动态编排
现象描述:
Agent 拥有的工具集(Tools)和技能(Skills)在代码构建阶段即被固定,通过硬编码列表或 Classpath 路径加载。
java// BAD:工具列表焊死在代码里.tools(List.of(AgentTool.create(OrderAgent.getInstance()),AgentTool.create(RefundAgent.getInstance())))// BAD:Skill 路径硬编码Skill diagnosisPlan = factory.createSkillFromResource("skills/diagnosis/diagnosis_plan");
问题分析:
运维困难:若某个 MCP 服务故障需临时下线,或需灰度发布新工具,必须修改代码并重新发版,无法做到运行时热插拔。
耦合度高:上百处散落的能力绑定使得全局视角下的依赖关系难以梳理,阻碍了 Agent 能力的复用与组合。
坏味道 4:MCP 管理缺失——连接泄露与环境混淆
现象描述:
MCP Server 的地址硬编码在代码中,且每次工具调用都重新建立连接,缺乏连接池管理。
java// BAD:预发环境地址硬编码,极易引发生产事故private static final String ORDER_MCP_URL = "https://...pre-region...";// BAD:每次调用都执行 TCP 握手 + 初始化 + 关闭public static String invokeMcpTool(...) {McpSyncClient client = McpClient.sync(transport).build();client.initialize();// ... execute ...client.closeGracefully();}
问题分析:
高风险配置:硬编码的环境地址(如 pre-)若在发布时未清理,将导致生产环境调用预发服务,引发 P1 级事故。
性能低下:ReAct 循环中频繁短连接导致额外的 100-500ms 延迟,且无熔断机制,高并发下易拖垮 MCP Server。
坏味道 5:身份透传断裂——“上帝视角”的安全隐患
现象描述:
用户身份仅在 Session 层标识,未透传至下游工具或 MCP 调用中,所有操作均以应用服务账号身份执行。
java// BAD:工具调用时操作人为空,或使用应用级认证request.put("creatorNo", "");ClientMcpRequestAuth auth = ClientMcpRequestAuth.of(serverUrl).generateAuthMaterial(); // 应用身份
问题分析:
审计缺失:无法追踪具体是哪个用户通过 Agent 执行了敏感操作(如创建规则、审批)。
权限失控:缺乏用户粒度的数据隔离与权限控制,违背零信任安全原则。在财务等敏感场景下,这是不可接受的红线问题。
坏味道 6:HITL(人工确认)逻辑分散且脆弱
现象描述:
人工确认逻辑由各个工具自行实现,方式五花八门:有的返回魔术字符串期望 LLM 识别,有的阻塞线程轮询 Redis,有的抛异常中断流程。
java// BAD 6a:依赖 LLM 理解魔术字符串,易陷入死循环return "NEED_CONFIRM: 金额过大,请确认";// BAD 6b:阻塞 Agent 线程等待确认Thread.sleep(1000); // 占用宝贵线程资源
问题分析:
不可靠:LLM 不一定能正确解析停止信号,可能导致死循环或误执行。
资源浪费:阻塞式等待严重消耗服务器线程资源。
体验割裂:不同工具的确认交互不一致,前端适配困难。
覆盖不全:外部 MCP 工具无法嵌入本地 HITL 逻辑,导致高危操作缺乏必要的人工把关。
坏味道 7:配置版本管理缺失——回滚如“考古”
现象描述:
即使配置外置到数据库或配置中心,也缺乏完整的版本快照、审计日志和灰度机制。
问题分析:
回滚困难:Prompt、模型参数、工具集往往联动变更。当出现幻觉或效果下降时,无法一键回滚到“上周的稳定状态”,因为相关配置散落在不同的 Commit 或记录中,恢复过程如同“考古”。
无迹可寻:缺乏“谁在何时改了什么”的审计链路,也无法进行 A/B 测试或灰度发布,导致优化效果无法量化,风险不可控。
总结:上述坏味道反映了 Agent 工程从“原型演示”向“生产系统”演进过程中的典型阵痛。解决之道在于构建统一的 Agent Runtime 平台,将单例管理、配置外置、动态编排、连接池、身份透传、HITL 拦截及版本控制下沉为平台基础能力,让开发者专注于业务逻辑与 Prompt 优化,而非重复造轮子。
1.1.3 结论总结
基于以上的业务思考和技术思考,我们总结出来:
1. 长期记忆需要结构化、持久化、定制化。
2. Agent 自进化需要定义到业务维度,而且要做到自动闭环就需要具体灵活的高定制
3. 真正做到运营可随时定制 Agent,就要零代码配置化接入:新增 Agent/SKILL/MCP 无需编写代码,仅通过页面配置即可实现即时上线,降低使用门槛。
4. hitl 的能力要做到工程级别的精确匹配,就要在框架级别做改造,研发工程级别的 hitl。
5. 灰度策略的定制自然也是工程级别的研发。
我们一开始在希望在内部的各类 AI 平台寻找最优解,后来慢慢发现要做到以上几点,很难依托 AI 技术平台来完成全链路闭环,原因有以下节点:
1. 比如长期记忆的业务定制化,一般平台提供的往往是 RAG 的模式,这往往很难做到精准可控。
2. 再比如运营可用更是难上加难,毕竟 Agent 的配置平台充斥着大量的技术要点,且如何和业务平台精准绑定需要有技术做大量改造。
3. hitl 工程级别的定制更不可能依靠技术平台了。
有了以上的思考,一个难以自控的想法不断在脑海间滋生,我们要基于高代码开发一套完全和业财平台深度融合,快配置、快发布、灰度、自进化的 Agent 平台!
▍1.2 平台建设要点总结
- 零代码配置化接入:新增 Agent/SKILL/MCP 无需编写代码,仅通过页面配置即可实现即时上线,降低使用门槛。
- 轻量级隔离运行时 Runtime:采用“即用即建”机制,运行时动态构建轻量级 Agent 实例外壳。该机制复用了底层的 Skill、SKILL 及 MCP 实例,在确保①资源高效共享、②性能卓越的同时,实现 Agent 会话执行环境的完全隔离,保障稳定性与安全性。
2. 低成本兼容各个生态平台
- 通用的 Skill 市场扩展能力:可快速支持其他 Skill 市场
- 生产环境:对接 Aone Skill 市场,满足高可用、高标准的生产级需求。
- 研发测试:建设 OSS Skill,提供灵活便捷的调试与验证环境,加速迭代周期。
3. 多方位推动 Agent 整体效果进化
- 内循环:对话和用户操作轨迹持久化、结构化,定时自动进行偏好和 case 整理。
- 支持配置化开启和定制搜集策略
- 特点:自闭环
- 外循环:用户反馈闭环优化,自动收集会话评价、工具调用成功率与任务完成率等指标,结合人工标注数据驱动 Prompt 与 Skill 策略迭代,让 Agent 越用越准。
- 非自动闭环,需要人工介入
- A/B 实验与灰度发布:支持多版本 Agent 并行运行与流量切分,通过真实业务数据验证改进效果,确保每次升级都带来可量化的体验提升。
- 非自动闭环,需要人工介入
4. 完全垂直的业务 Agent 配置,和业财平台综管打通,实现完全自由化定制页面
- 业务语义原生映射:Agent 配置项直接对应业财领域的业务对象(如发票类型、结算主体、费用科目),而非抽象的技术参数,业务人员无需理解底层模型结构即可精准定义 Agent 行为边界。
- 综管平台一体化管控:Agent 的创建、发布、权限分配与版本管理全部集成至业财综管后台,与现有组织架构、角色体系及审批流程无缝衔接,确保智能体治理与企业管理体系同频共振。
- 零代码页面自定义:支持通过可视化编辑器自由编排对话界面、表单字段、结果展示卡片及操作按钮,不同业务线可独立打造专属交互体验,无需前端开发介入即可快速响应个性化需求。
- 在原有系统中,我们基于 Web 层实现了权限管控,采用 ACL、数据标识以及用户白名单等方式进行分层管理。但随着 MCP 逐步下沉至 HSF 接口层,并由 Agent 主导调用链路,传统的 Web 层权限模型已难以覆盖新的调用路径。
02
技术选型
Aliware
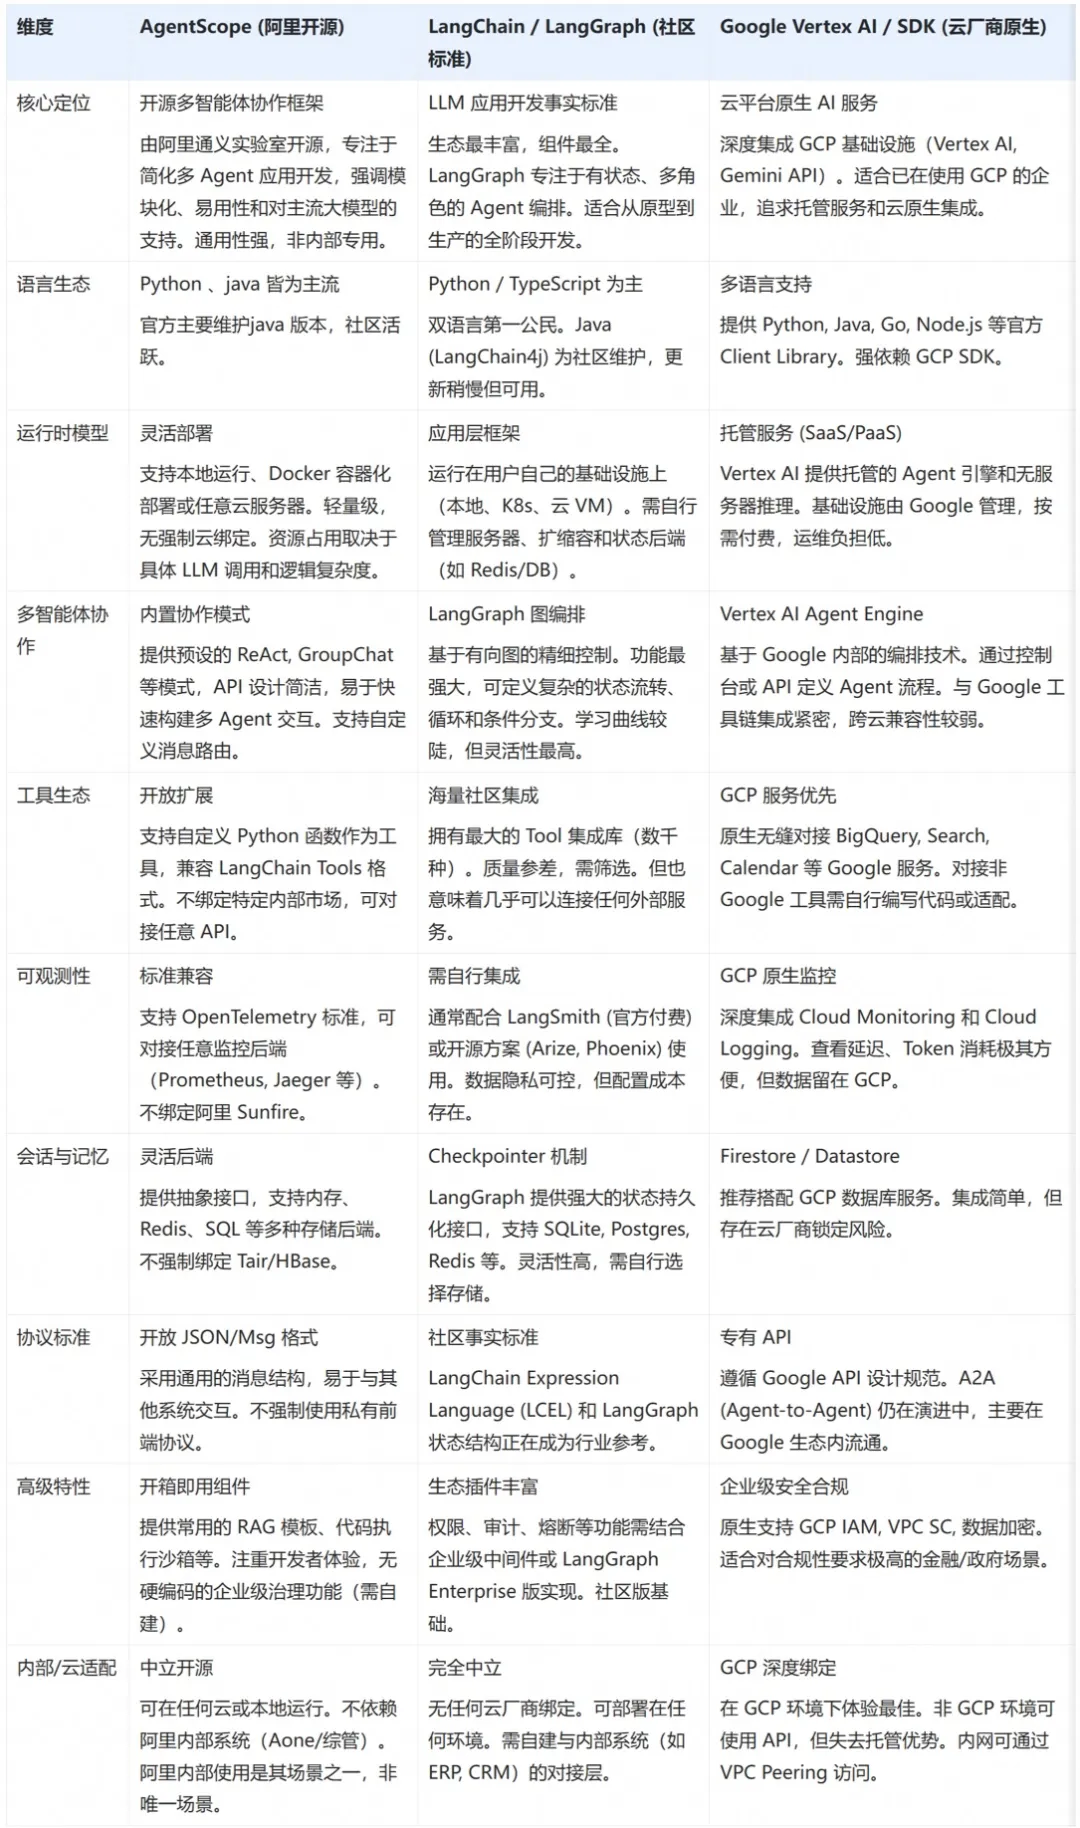
在 Agent 运行时框架的选型上,我们系统评估了 LangChain、Google ADK 与 AgentScope 三大主流技术体系,最终选择 AgentScope 作为核心底座,是基于企业级生产诉求、阿里内部生态适配性及业财业务特殊性三重维度的综合决策。
▍2.1 三大框架核心能力对比
▍2.2 最终选择
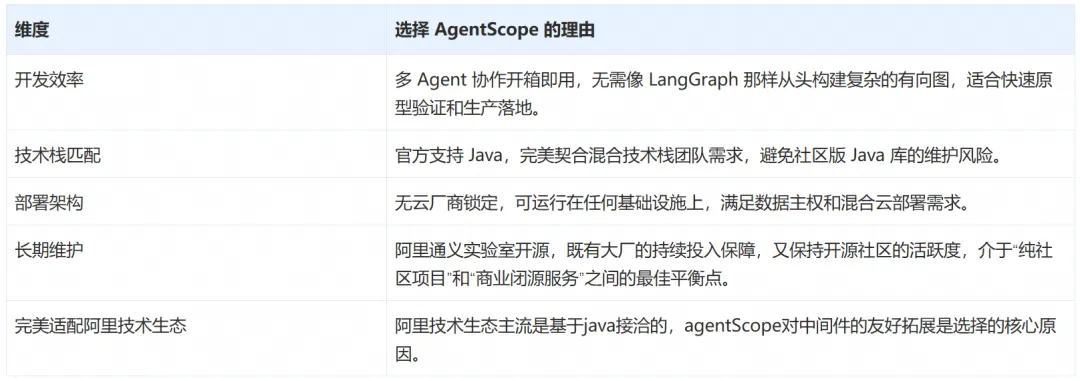
03
AgentScope 的三层架构框架能力分析
Aliware
我认为 AgentScope 分为三层能力,模型层、ReAct 推理循环层和对外抽象体系层:
▍3.1 模型层
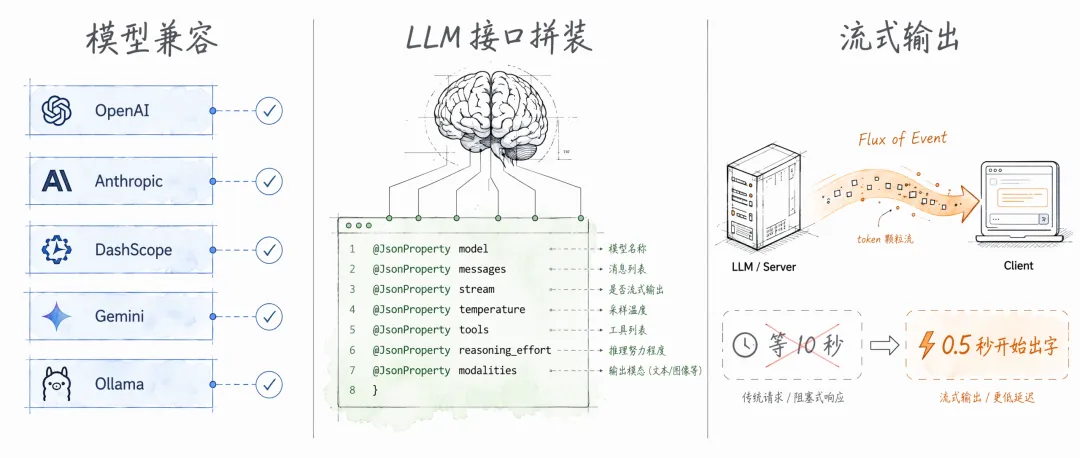
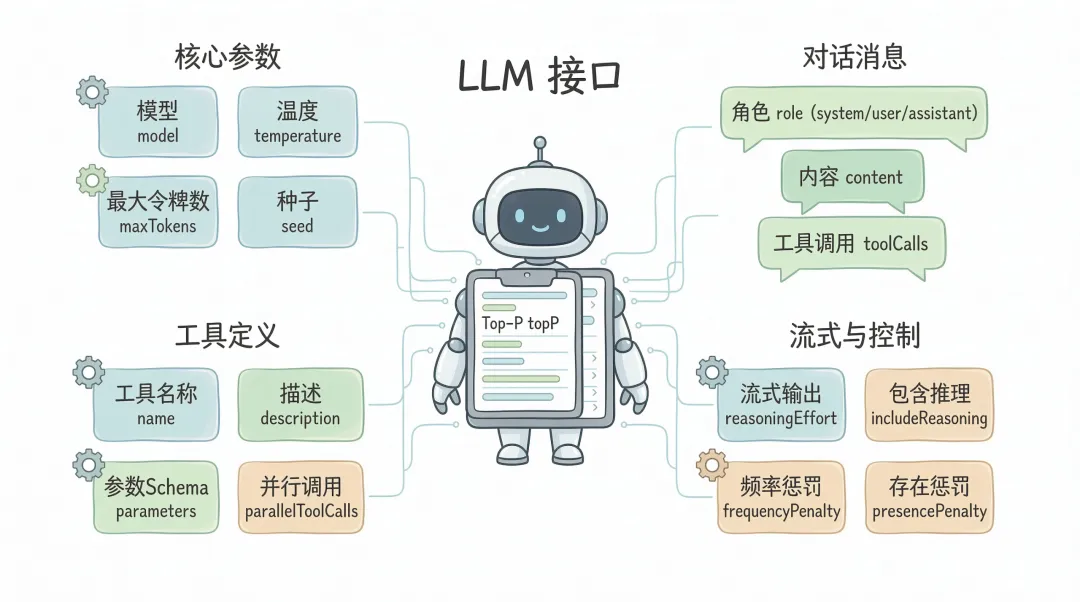
作为最底层的架构,它的核心是和 llm 的打交道,它的核心是以下 5 点:
1. 统一抽象与协议解耦
规则:所有模型实现必须继承 ChatModelBase,通过 Formatter 机制将平台无关的 Msg 转换为特定厂商的请求/响应格式。
源码分析:OpenAIChatModel 内部持有 Formatter<OpenAIMessage, OpenAIResponse, OpenAIRequest>,新增模型只需实现对应 Formatter,无需修改核心调用逻辑,天然支持 OpenAI 兼容协议及各类国产模型。
2. 精细化参数控制与多层级配置合并
规则:生成参数通过 GenerateOptions 标准化封装,支持“运行时参数 > 构建时默认参数”的优先级合并,并允许透传厂商特有扩展字段。
源码分析:GenerateOptions.mergeOptions(primary, fallback) 实现配置合并;additionalHeaders/BodyParams/QueryParams 三类扩展 Map 确保框架不滞后于 API 演进。
3. 内置企业级调用治理
规则:超时、重试、熔断等治理能力下沉至模型层,作为数据流的一部分自动注入,而非外部包装。
源码分析:ModelUtils.applyTimeoutAndRetry() 在 Flux 链上直接注入 .timeout() 与 .retryWhen(Retry.backoff(...)),基于 ExecutionConfig 自动生效,业务代码零侵入。
4. Reactor Flux 原生流式输出
规则:整个模型调用链路完全基于 Project Reactor 构建,流式/非流式同接口返回 Flux,支持背压与非阻塞 I/O。
源码分析:doStream0() 根据 stream 参数动态切换 SSE 流式响应或 Flux.defer().subscribeOn(boundedElastic()) 同步调用;治理操作符无缝嵌入流中,上游感知为连续数据流。
5. 可观测性与高级推理能力零侵入集成
规则:Trace 埋点、Prompt 缓存、工具调用增强等能力在模型层自动完成,业务代码无需手动处理。
源码分析:ChatModelBase.stream() 通过 TracerRegistry.get().callModel() 自动包裹调用;cacheControl=true 时 OpenAIBaseFormatter.applyCacheControl() 自动添加缓存标记;toolChoice 与 parallelToolCalls 参数直接控制工具行为。
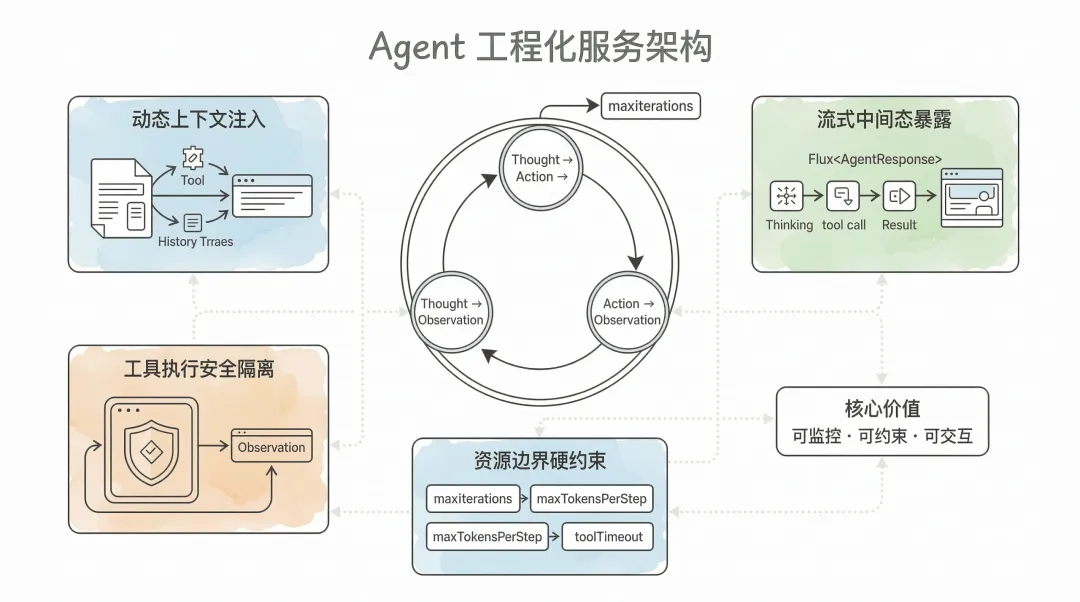
▍3.2 ReAct 推理循环——从“一问一答”到“多步自主决策”
1. 标准化三阶循环:严格遵循“Thought → Action → Observation”状态机,由模型自主判断终止或达到 maxIterations 强制退出,避免无限递归。
2. 动态上下文注入:每轮推理前自动将可用工具 Schema 与历史轨迹格式化注入 Prompt,确保模型决策基于最新信息,减少幻觉调用。
3. 流式中间态暴露:返回 Flux<AgentResponse>,实时推送思考、工具调用、执行结果等事件,支持前端逐字展示推理过程,打破黑盒体验。
4. 工具执行安全隔离:工具调用独立执行、参数校验、返回值过滤,异常作为 Observation 反馈给模型自修正,防止崩溃或数据泄露。
5. 资源边界硬约束:通过maxIterations、maxTokensPerStep、toolTimeout 等配置在 Flux 链中自动拦截超限请求,保障生产环境 SLA 可控。
核心价值:将 LLM 推理转化为可监控、可约束、可交互的工程化服务,支撑业财复杂任务的自主完成。
▍3.3 对外抽象体系
3.3.1 核心大类
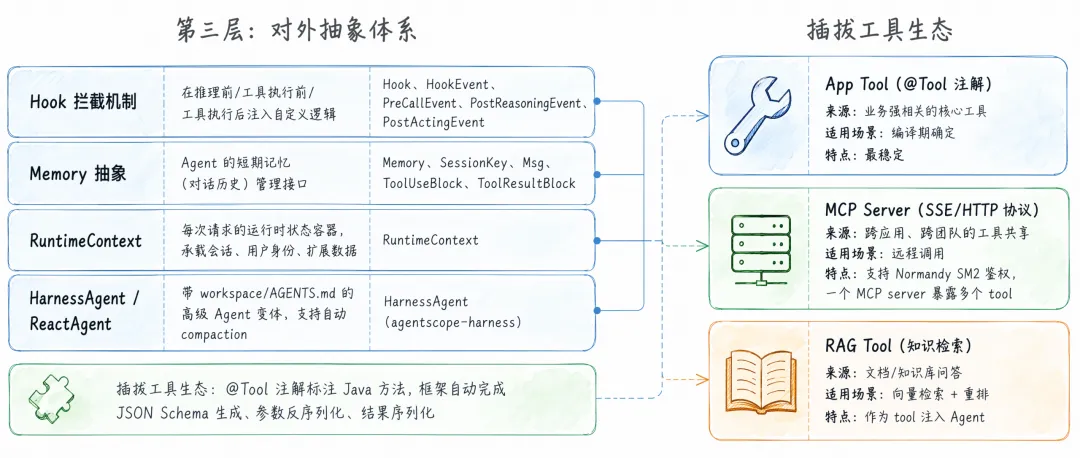
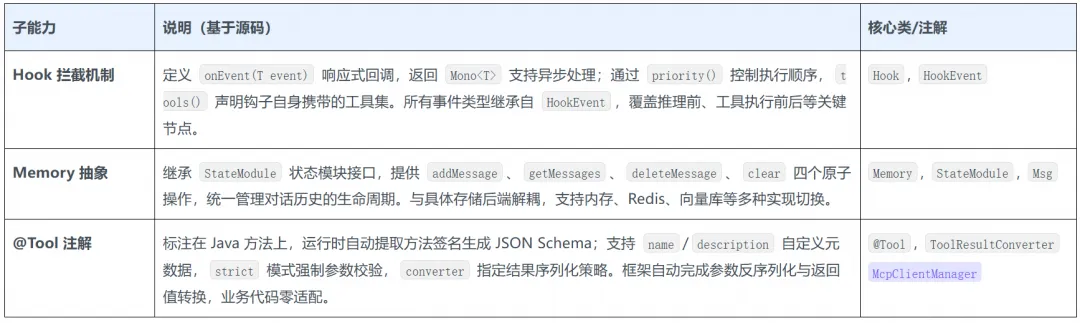
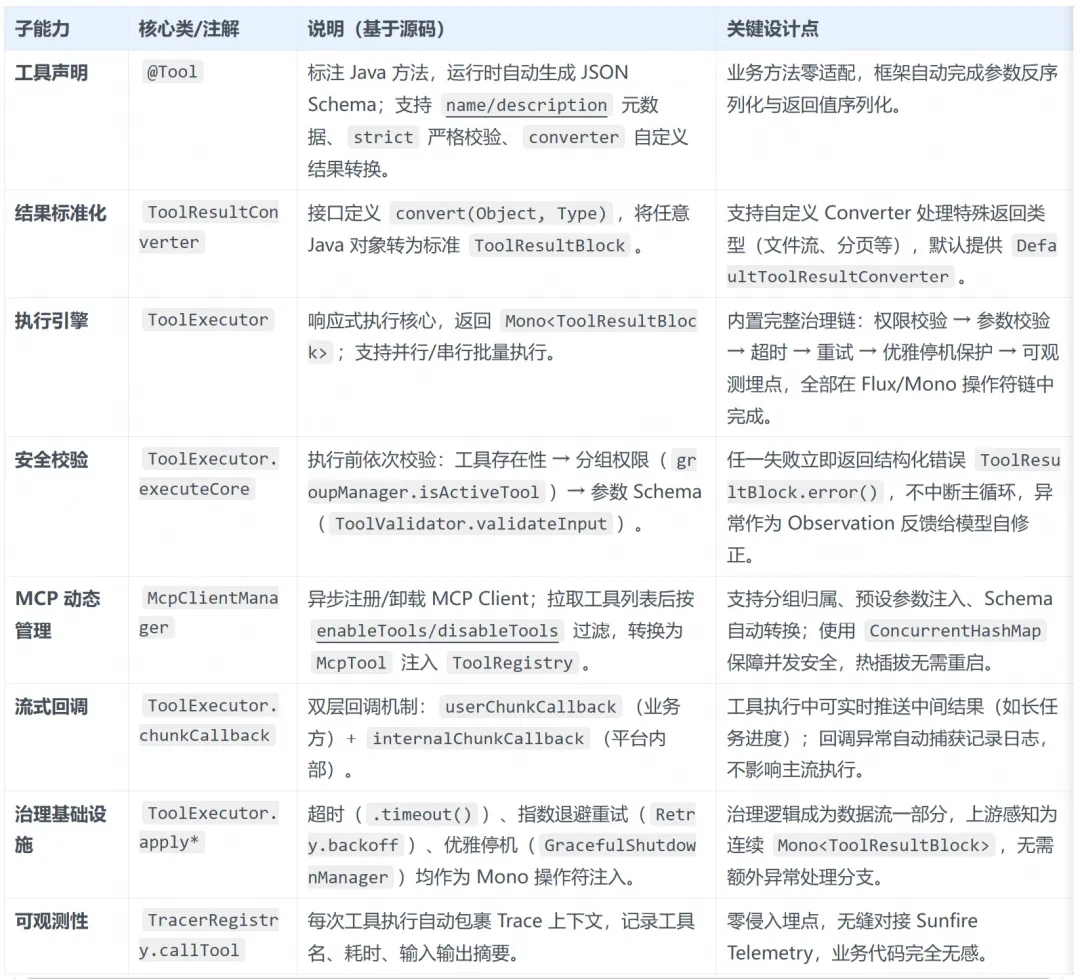
3.3.2 tool 快捷机制
04
复用层的三层架构
Aliware
除了考虑平台建设的要点,我们在实践之前会考虑复用层的建设,这是为了做到在阿里生态结合后,更高层次的开箱即用!
也会考虑未来其他业务想要参考我们的 Agent 实现可以更方便的进行快速定制!
▍4.1 tools 类与阿里生态平台的结合
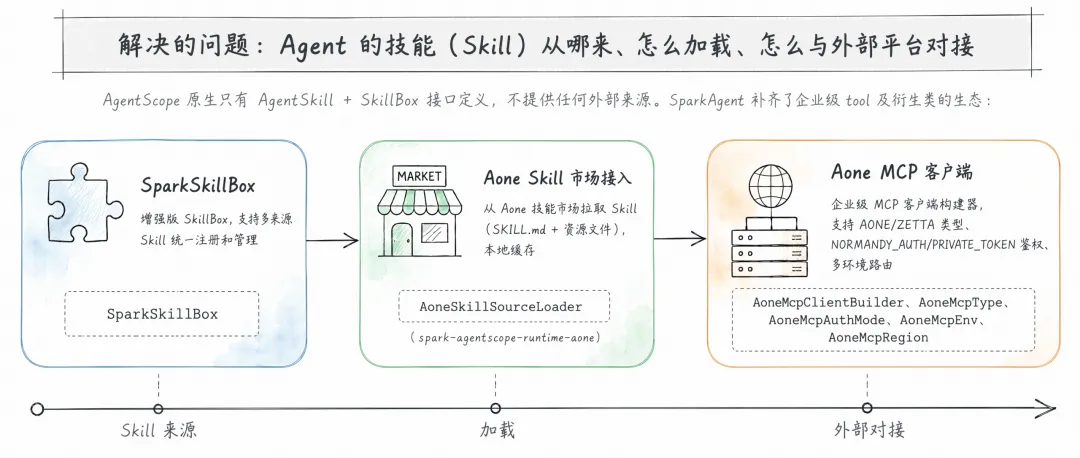
AgentScope 原生只有 AgentSkill+ SkillBox接口定义,不提供任何外部来源。复用层补齐了企业级 tool 及衍生类的生态:
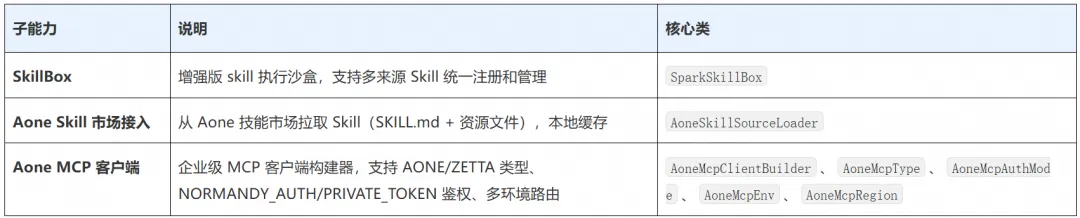
这一层为了提供阿里市场的简单接入的能力。
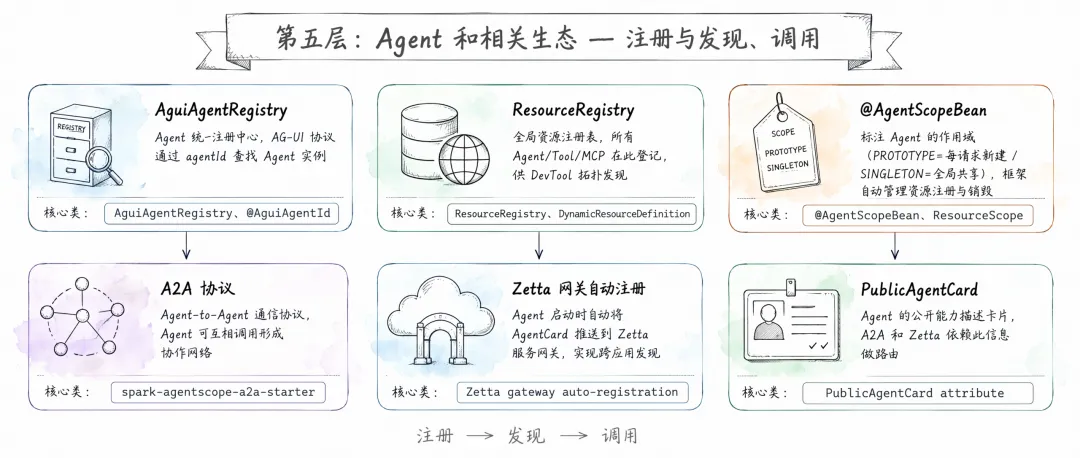
▍4.2 Agent 和相关生态 注册与发现、调用
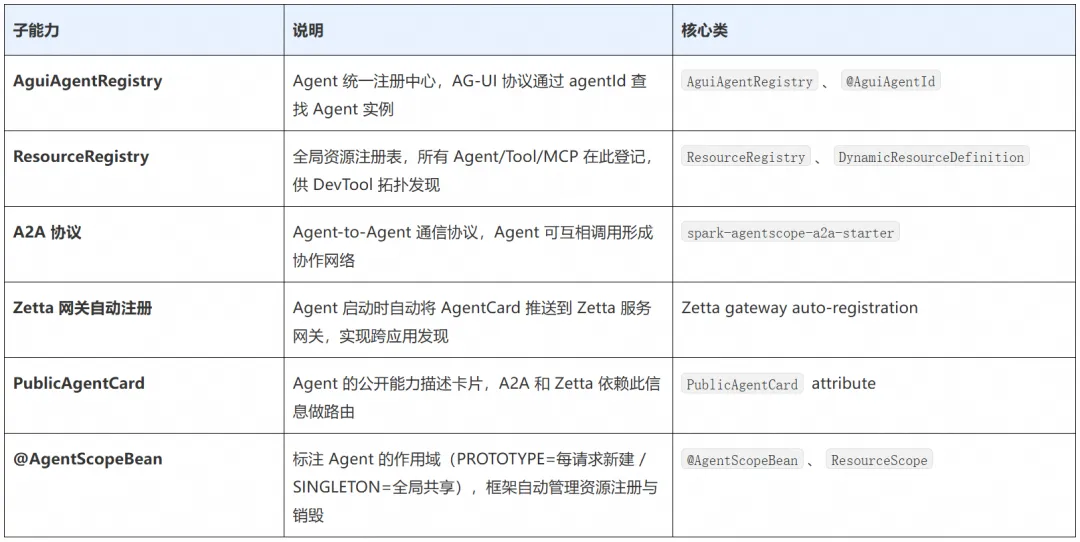
▍4.3 链路串联、管理丨AG-UI 协议链路串联
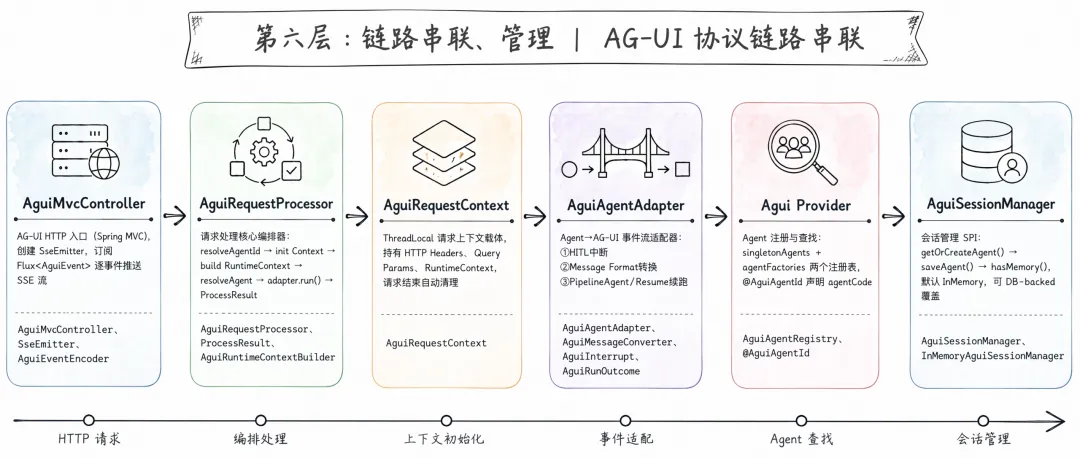
复用层基于 AG-UI 协议(SSE)实现了前端到 LLM 的端到端流式链路:对外暴露 AG-UI 标准输入输出(AguiMvcController 处理 RunAgentInput/ 发射 AguiMessage事件流);对内以 ReActAgent为核心编排引擎驱动 LLM 推理-工具调用循环,通过 AguiRuntimeContextBuilderSPI 和 RuntimeContext承载请求级上下文(用户身份、RAG query),通过 Session SPI 和 AguiSessionManager管理会话级状态持久化(Memory / Toolkit / AgentMeta)。
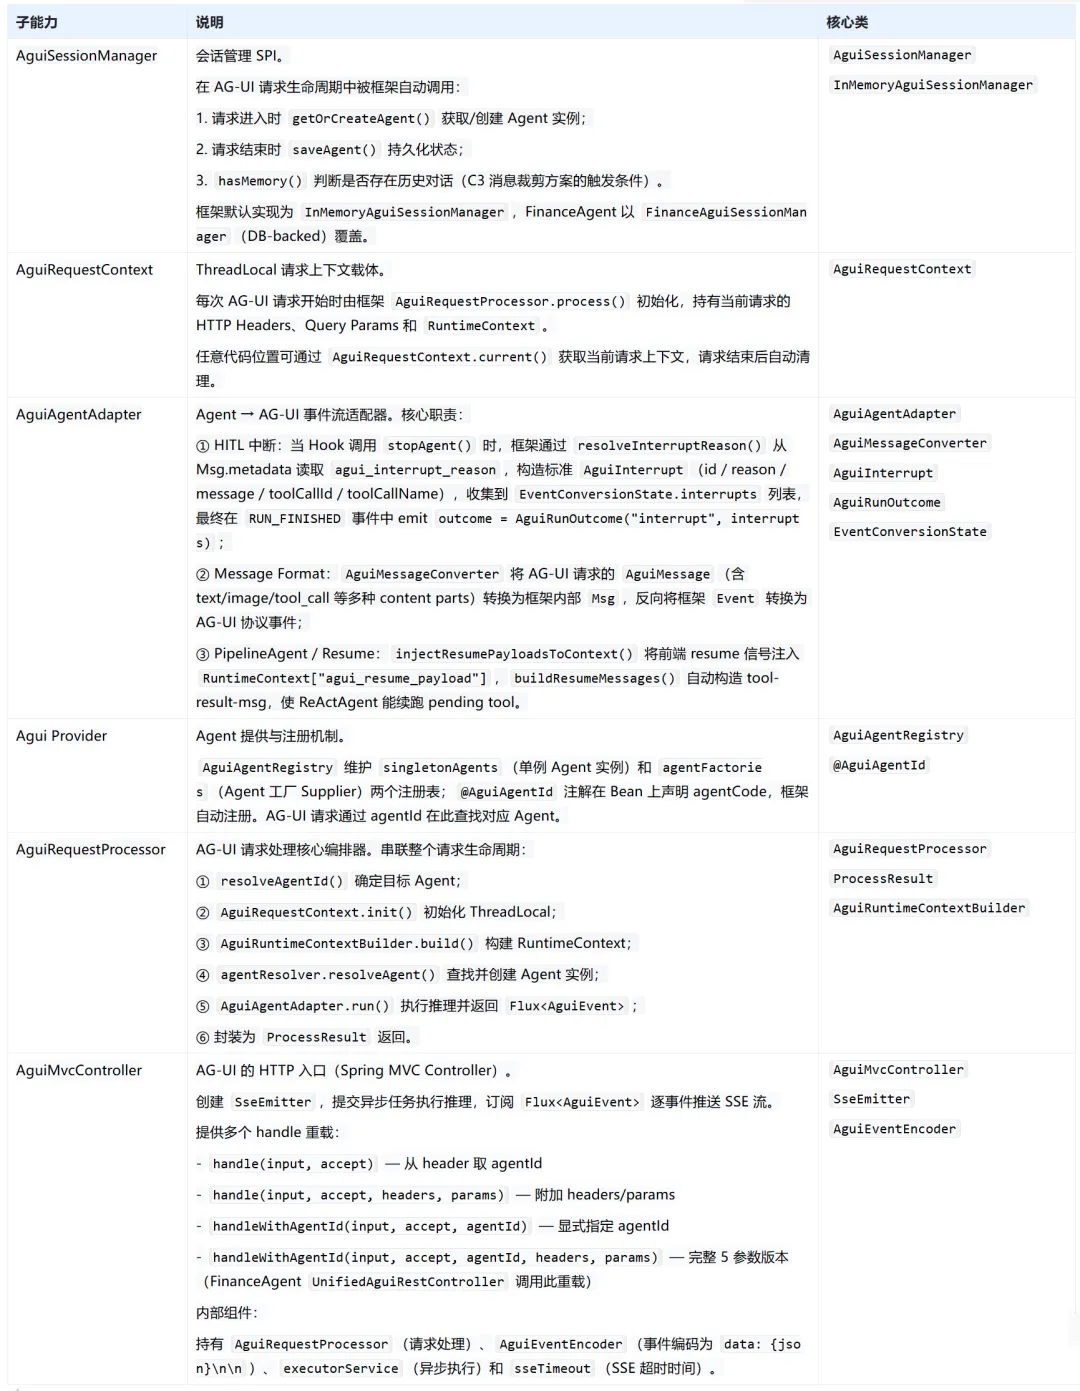
运行层的概念有点多,我会在后续的时间过程结合细节来阐明实战的思路。
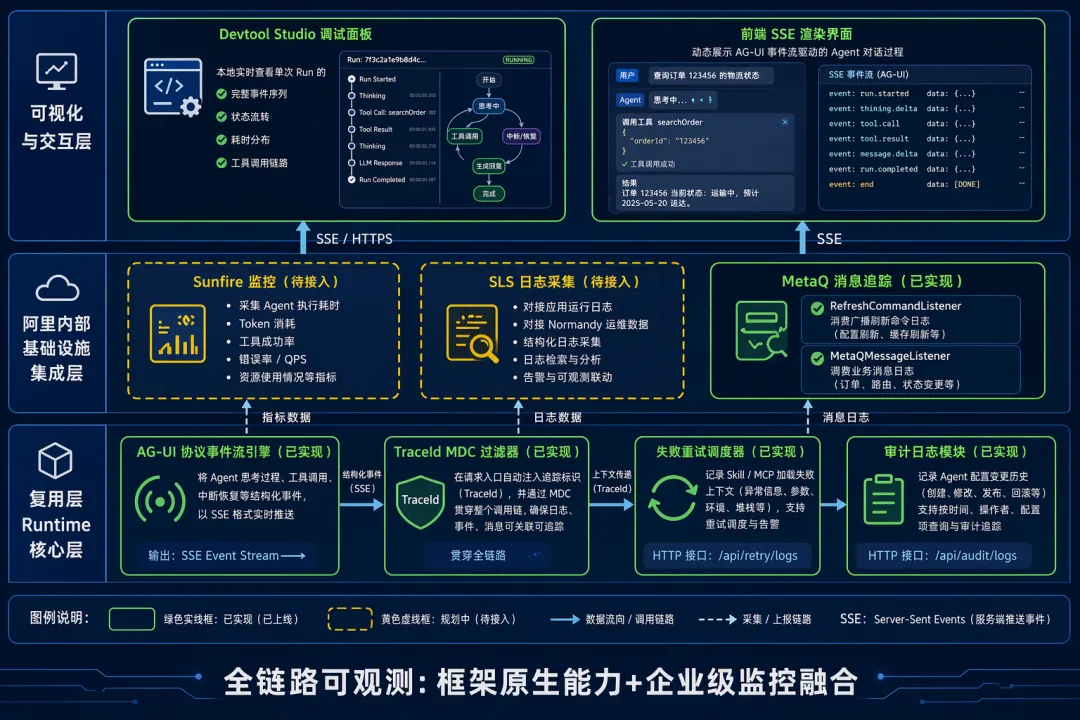
▍4.4 全链路观测
05
基于开发要点的实践过程
Aliware
前文梳理了 AgentScope 和复用层的核心架构与能力边界。基于此,我们围绕五大建设要点,逐一展开实践过程——遇到了什么问题、如何拆解、如何设计并落地解决方案。
▍5.1 要点一:基于 DB 驱动的 Agent 运行引擎
5.1.1 聚焦目标
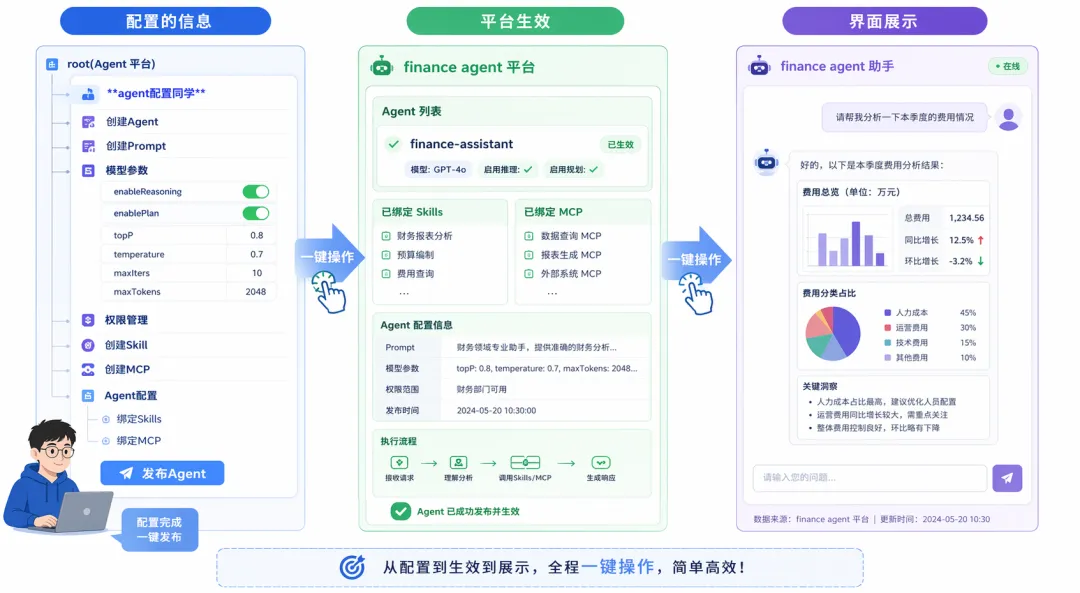
俗话说,“功能服务于价值”。在深入探讨技术实现之前,让我们先共同描绘一幅属于物流成本业财团队的未来工作图景。
想象一下,在我们的平台上,活跃着上百位深耕一线的运营小二。他们每天穿梭于计费、结算、资金流转、发票处理及财务核算这五大核心链路之间。当前的现状是,尽管系统庞大,但大量高价值的精力被消耗在低效的“人工校验”与“重复搬运”中——眼神在屏幕间疲惫切换,数据在表格间机械复制。他们渴望解放,急需一位不知疲倦、精准高效的数字助手。
因此,我们的目标不仅仅是交付几个固定的自动化工具,而是要构建一个生机勃勃的 Agent 使用生态。
在这个生态中,最懂业务痛点的不再是远程的开发人员,而是身处一线的小二同学。我们将赋予他们 Agent 手动配置的能力,让他们能够像搭积木一样,根据当下的业务波动和个性化需求,亲手定义并训练专属的 Agent。无论是应对大促期间的结算高峰,还是处理复杂的异常账单,他们都能按需配置、即时发布、快速迭代。
这不仅是一次效率的革命,更是一场角色的重塑:让每一位小二从繁琐的操作者,进化为智能流程的设计师,真正实现“人人都是开发者,处处皆有智能化”。
5.1.2 DB 设计
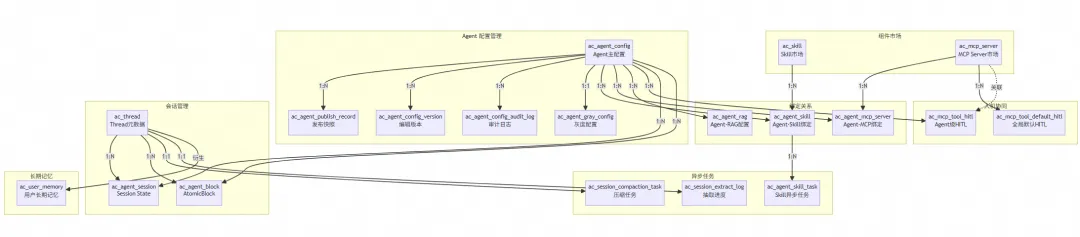
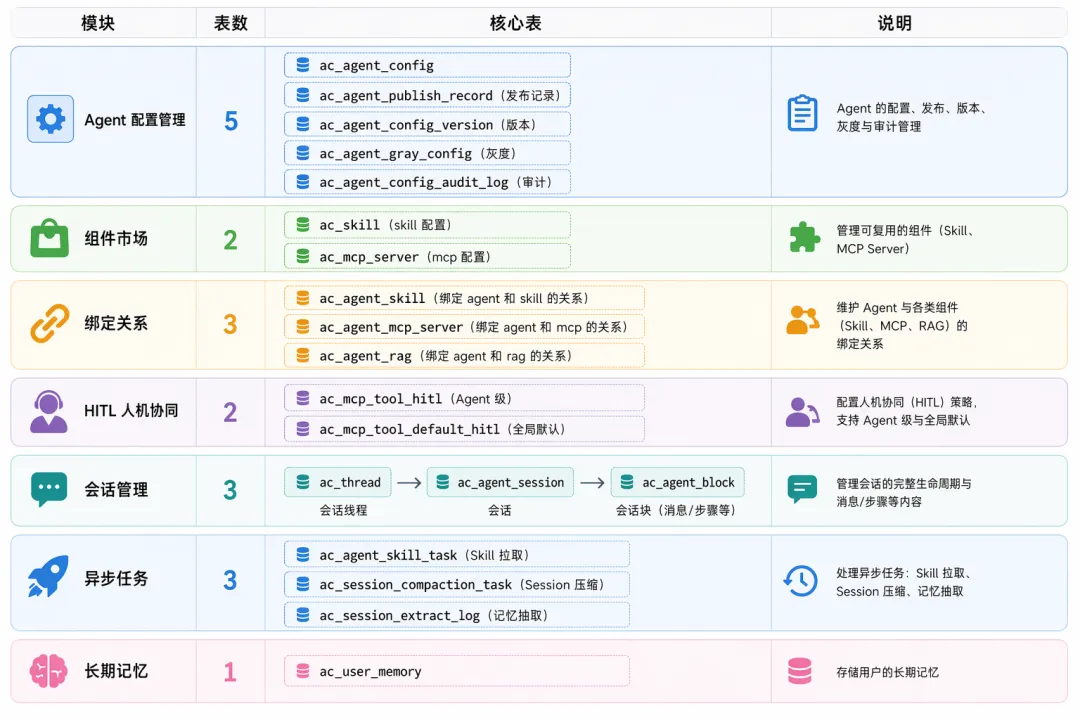
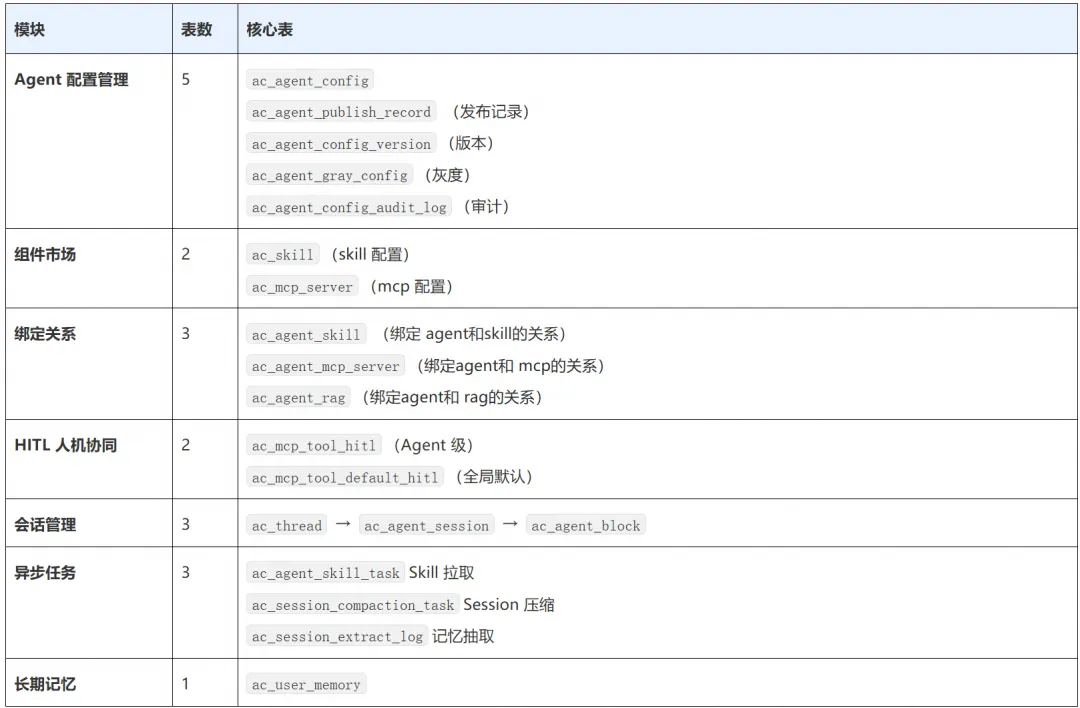
项目全部 19 张表,按功能域分为 7 个模块:
5.1.3 整体流程核心设计(结合复用层来看)
如何达到 DB 驱动 Agent 运行的核心设计有以下几点:
5.1.3.1 核心链路一:启动注册 —— 从 DB 到内存快照
复用层会有大量的注册能力存在,DB驱动的设计核心,自然是需要通过讲DB数据接洽到注册点,这是设计模式的插座模式的典型设计!
那什么时机做接洽比较合适?答:应用启动和更新核心 sql 属性,都需要通过注册中心出发点整体 Agent 配置的更新!
先说说应用启动时,我们会统一基于一个超级基类出发,扫描 DB 并实现接洽,他就是 AgentFactoryRegistry!
AgentFactoryRegistry除了要做接洽,其另外一个核心目标是构建一个运行时的 snapshot,该 snapshot 在后续的 chat 对话当中会起着关键作用!
AgentFactoryRegistry(实现 SmartInitializingSingleton)在所有 Spring Bean 初始化完成后执行三阶段启动:
。2. 读 DB 分流:从 ac_agent_config读取全量启用配置,与静态集合取交集:
静态 Agent(有对应 Factory 类)→ 调用 factory.refreshFromDb()
动态 Agent(DB 中有但代码中无 Factory 类)→ 调用 dynamicRegistry.register(agentCode) 自动创建 DynamicAgentEntry
最后也会调用 refreshFromDb
先看看 AgentFactoryRegistry:
(Ordered.HIGHEST_PRECEDENCE)public class AgentFactoryRegistry implements SmartInitializingSingleton {private static final Logger logger = LoggerFactory.getLogger(AgentFactoryRegistry.class);private List<BaseFinanceAgentFactory> staticFactories;private DynamicAgentRegistry dynamicRegistry;private AcAgentConfigMapper acAgentConfigMapper;private DynamicAgentProperties dynamicProperties;private final Map<String, BaseFinanceAgentFactory> staticIndex = new LinkedHashMap<>();public void afterSingletonsInstantiated() {// ==================== 阶段 1: 建静态索引(排除 DynamicAgentEntry 防御性兜底) ====================for (BaseFinanceAgentFactory f : staticFactories) {if (f instanceof DynamicAgentEntry) continue;String agentCode = f.simpleName();BaseFinanceAgentFactory previous = staticIndex.put(agentCode, f);if (previous != null) {logger.warn("[AgentFactoryRegistry] duplicated static agentCode '{}': {} replaced by {}",agentCode, previous.getClass().getName(), f.getClass().getName());}}logger.info("[AgentFactoryRegistry] static factories ({}): {}",staticIndex.size(), staticIndex.keySet());// ==================== 阶段 2: 读 DB 全集,分流 ====================List<AcAgentConfigDO> allEnabledConfigs;try {allEnabledConfigs = acAgentConfigMapper.selectAllEnabled();} catch (Exception e) {throw new IllegalStateException("Failed to load active configs (status>=1) from ac_agent_config", e);}if (allEnabledConfigs == null) {allEnabledConfigs = Collections.emptyList();}// 2a. 启动期自检:禁止存量 agentCode 含 _published 子串(防御后缀法 R1 命名撞 key)List<String> illegalCodes = allEnabledConfigs.stream().map(AcAgentConfigDO::getAgentCode).filter(c -> c != null && c.contains(AgentVariant.PUBLISHED_SUFFIX)).collect(Collectors.toList());if (!illegalCodes.isEmpty()) {String msg = "ac_agent_config 存在含保留子串 '" + AgentVariant.PUBLISHED_SUFFIX+ "' 的 agent_code(与 PUBLISHED variant 后缀冲突):" + illegalCodes;if (dynamicProperties.isStrictMode()) {throw new IllegalStateException(msg);} else {logger.warn("[AgentFactoryRegistry] strict-mode=false, continuing despite illegal agent_code: {}", msg);}}List<String> dbCodes = allEnabledConfigs.stream().map(AcAgentConfigDO::getAgentCode).collect(Collectors.toList());Set<String> dbCodeSet = new LinkedHashSet<>(dbCodes);Map<String, Throwable> failures = new LinkedHashMap<>();// 2b. 静态:DB 中必须有对应启用行(与 V1 强约束一致);调 refreshFromDbfor (Map.Entry<String, BaseFinanceAgentFactory> e : staticIndex.entrySet()) {String code = e.getKey();if (!dbCodeSet.contains(code)) {failures.put(code, new IllegalStateException("static factory exists but ac_agent_config has no active row (status>=1) for agent_code='" + code + "'"));continue;}tryRefresh(code, e.getValue()::refreshFromDb, failures);}// 2c. 动态:DB 全集 - 静态集合,自动创建 DynamicAgentEntry(DRAFT variant)List<String> dynamicCodes = dbCodes.stream().filter(c -> !staticIndex.containsKey(c)).collect(Collectors.toList());for (String code : dynamicCodes) {tryRefresh(code, () -> dynamicRegistry.register(code), failures);}// 2d. 为 current_publish_version > 0 的 agent 注册 PUBLISHED variant(key=${code}_published)// 注:PUBLISHED variant 失败不影响 DRAFT 服务可用,单独聚合,仅告警不 fail-fastMap<String, Throwable> publishedFailures = new LinkedHashMap<>();List<String> publishedCodes = new ArrayList<>();for (AcAgentConfigDO cfg : allEnabledConfigs) {Integer cpv = cfg.getCurrentPublishVersion();if (cpv == null || cpv <= 0) {continue;}String code = cfg.getAgentCode();String publishedKey = AgentVariant.PUBLISHED.registryKey(code);tryRefresh(publishedKey,() -> dynamicRegistry.registerPublishedVariant(code),publishedFailures);publishedCodes.add(code);}if (!publishedFailures.isEmpty()) {String summary = publishedFailures.entrySet().stream().map(e -> " - " + e.getKey() + " → " + e.getValue().getMessage()).collect(Collectors.joining("\n"));// PUBLISHED variant 失败仅告警,不抛 fail-fast(DRAFT 仍可服务)logger.warn("[AgentFactoryRegistry] PUBLISHED variant init failed for {} agent(s), DRAFT remains available:\n{}",publishedFailures.size(), summary);}// ==================== 阶段 3: 失败聚合 + strict-mode 控制(仅 DRAFT 失败参与 fail-fast) ====================if (!failures.isEmpty()) {String summary = failures.entrySet().stream().map(e -> " - " + e.getKey() + " → " + e.getValue().getMessage()).collect(Collectors.joining("\n"));String msg = "Agent init failed for " + failures.size() + " of " + dbCodes.size()+ " agent(s):\n" + summary;if (dynamicProperties.isStrictMode()) {throw new IllegalStateException(msg);} else {logger.warn("[AgentFactoryRegistry] strict-mode=false, continuing despite failures:\n{}", msg);}}logger.info("[AgentFactoryRegistry] init OK. static={}, dynamic={}, published={}, total={}, strict-mode={}",staticIndex.size(), dynamicCodes.size(), publishedCodes.size() - publishedFailures.size(),dbCodes.size(), dynamicProperties.isStrictMode());}private static void tryRefresh(String agentCode, Runnable r, Map<String, Throwable> failures) {try {long start = System.currentTimeMillis();r.run();logger.info("[AgentFactoryRegistry] init OK for '{}' in {} ms",agentCode, System.currentTimeMillis() - start);} catch (Throwable t) {logger.error("[AgentFactoryRegistry] init FAILED for '{}': {}", agentCode, t.getMessage(), t);failures.put(agentCode, t);}}// ==================== 对外查询 / 派发 API ====================/*** 统一查找:静态优先,未命中再查动态。*/public BaseFinanceAgentFactory find(String agentCode) {BaseFinanceAgentFactory f = staticIndex.get(agentCode);return f != null ? f : dynamicRegistry.get(agentCode);}/*** 按注册 key 派发刷新(key 可能是 DRAFT 的业务 agentCode,也可能是 PUBLISHED 的* {@code agentCode_published})。** <p>已注册 → {@link BaseFinanceAgentFactory#refreshFromDb};未注册 → on-demand 动态注册:</p>* <ul>* <li>PUBLISHED key(命中 {@link AgentVariant#PUBLISHED_SUFFIX})→* {@link DynamicAgentRegistry#registerPublishedVariant}(按发布快照路径加载);</li>* <li>DRAFT key → {@link DynamicAgentRegistry#register}(按草稿路径加载)。</li>* </ul>** <p>这样集群广播 {@code AGENT/xxx_published} 在其他节点接收时也能正确注册 PUBLISHED* variant,而不会被误认为是新建 DRAFT agent。</p>*/public void refresh(String key) {BaseFinanceAgentFactory f = find(key);if (f != null) {f.refreshFromDb();return;}AgentVariant.ParsedKey parsed = AgentVariant.parse(key);if (parsed != null && parsed.variant() == AgentVariant.PUBLISHED) {logger.info("[AgentFactoryRegistry] PUBLISHED key '{}' not registered yet, attempting on-demand register", key);dynamicRegistry.registerPublishedVariant(parsed.agentCode());} else {// 运行期 DB 新增了一行 → on-demand 动态注册 DRAFT variantlogger.info("[AgentFactoryRegistry] '{}' not registered yet, attempting on-demand dynamic register", key);dynamicRegistry.register(key);}}/*** 全量刷新所有已注册 Agent。* <p>单个失败不影响其他 Agent;失败的 agentCode 通过返回值告知调用方。</p>*/public Map<String, String> refreshAll() {Map<String, String> failures = new LinkedHashMap<>();for (String code : allAgentCodes()) {try {find(code).refreshFromDb();} catch (Exception ex) {logger.error("[AgentFactoryRegistry] refresh failed for agentCode='{}'", code, ex);failures.put(code, ex.getMessage());}}return failures;}/** 已注册的全部 agentCode(静态 ∪ 动态,去重,保序)。*/public Set<String> allAgentCodes() {Set<String> all = new LinkedHashSet<>(staticIndex.keySet());all.addAll(dynamicRegistry.agentCodes());return Collections.unmodifiableSet(all);}/** Controller 的 GET endpoint 用:按 agentCode 拿 Factory(用于查看 snapshot)。 */public BaseFinanceAgentFactory get(String agentCode) {return find(agentCode);}/** 已注册的 agentCode 列表,保留旧方法名以兼容现有 Controller。 */public Set<String> agentCodes() {return allAgentCodes();}}
为什么要用 afterSingletonsInstantiated?
首先 AgentFactoryRegistry需要收集所有静态BaseFinanceAgentFactory并且获取 DB 的配置数据,如果这里用 @PostConstruct或 InitializingBean.afterPropertiesSet(),会有时序问题。
可以通过下图来了解:
无论是静态 Agent 还是动态 Agent 最终都会做refreshFromDb()操作,refreshFromDb() 的核心动作是构建AgentConfigSnapshot—— 一个不可变的 volatile 快照对象,聚合了 Prompt、模型参数、Toolkit(含 MCP Client)、SkillBox(含 Skill 内容)。后续 createAgent() 只做一次 volatile 读即可获得跨字段一致的视图,无 DB 调用。
除了快照还有注册,注册环节做三件事:
注册到 AguiAgentRegistry:sparkRegistry.registerFactory(agentCode, entry::createAgent),以方法引用实现 PROTOTYPE 语义(每次请求创建新实例),后续由框架 DefaultAgentResolver按 agentCode 查找。
注册到 ResourceRegistry:使 Agent 出现在 DevTool 拓扑图中。
注册到 A2A 网关:通过 DynamicA2ARegistrationAdvice暴露为 A2A 协议端点。
5.1.3.2 核心链路二:所有主表和关联性质都是在管理态,管理员通过页面去持久化
在管理态(Management State)下,所有 Agent 相关配置均通过前端页面进行操作,并持久化至关系型数据库。运行时(Runtime)仅作为只读消费者,根据配置的发布状态加载相应的配置快照或草稿,确保配置变更与线上运行的解耦。
配置体系分为主配置域(独立实体)与绑定关系域(关联实体),具体映射如下:
为平衡“配置灵活性”与“线上稳定性”,系统采用严格的双轨制版本管理机制。
草稿阶段 (Drafting):
操作:用户在页面修改 Prompt、模型参数或绑定关系。
持久化:所有变更直接更新至主表 ac_agent_config及其关联的绑定表。
状态标记:ac_agent_config.status 保持为 1(Enabled/Draft)。
影响范围:仅影响开发/测试环境或明确指定读取草稿的调试会话,不影响线上正式流量。
发布阶段 (Publishing):
触发:用户点击“发布”按钮。
快照生成:系统将当前主表及所有绑定表的完整配置序列化为 JSON,写入 ac_agent_publish_record。此记录为不可变 (Immutable),用于审计与回滚。
版本晋升:
影响范围:线上正式流量立即切换至新发布的快照版本。
运行时加载 (Runtime Loading):
DRAFT Variant:主要用于 DevTool 调试或灰度测试场景,直接读取 ac_agent_config中的最新草稿数据。
PUBLISHED Variant:生产环境标准模式,根据 current_publish_version 从 ac_agent_publish_record 中加载对应的不可变快照。
优势:
安全隔离:配置修改过程中的中间状态(如未完成的 Prompt 编辑)不会污染线上服务。
即时回滚:若发布后出现异常,可通过将 current_publish_version指向前一个版本号,或重新发布旧快照,实现秒级回滚。
审计追溯:ac_agent_publish_record保留了每一次发布的完整现场,配合 ac_agent_config_audit_log可实现全链路配置变更追溯。
5.1.3.3 核心链路三:运行态 —— 复用层全链路 SPI 定制
前面第四章定义了复用层的运行链路,这是为了让后续所有的后续 Agent 的运营链路保持着一致!而 AguiMvcController正是掌管着复用层的整体运行入口!
UnifiedAguiRestController是我们定义用于处理chat请求的核心 controller,它会将请求直接委托给复用层框架的 AguiMvcController,完整复用 AG-UI 协议的 SSE 流式处理、ReAct 循环、Tool 调用等运行时能力。
复用层的能力无法覆盖定制场景怎么办?
复用层的定制通过框架预定义的 SPI 接口实现:
关键设计:我们既不改框架运行链路也不充血链路,而是在框架留的 SPI 点上替换默认实现。框架负责协议解析和 ReAct 编排,项目负责业务逻辑和基础设施对接。
5.1.4 运行时详解
上节我们说到运行链路复用复用层全链路,但也说明了他链路的所有关卡都充斥着大量的 SPI,本节我们是分析这条链路,以及说明我们是如何达成设计目标:
目标:轻量级隔离运行时 Runtime:采用“即用即建”机制,运行时动态构建轻量级 Agent 实例外壳。既要复用了底层的 Skill、SKILL 及 MCP 实例(前面说的 snapshot),也要确保:
①资源高效共享
②性能卓越
同时还要实现 Agent 会话执行环境的完全隔离,保障稳定性与安全性。
链路的部分概念明细在第四章的运营链路层,会有详细内容,这里重点还是分析如何结合实际场景进行运行设计。
再看看复用层运行时的核心类以及关键 SPI:
复用层 SPI 关键设计模式:
1. 策略模式:AguiRuntimeContextBuilder、AguiSessionManager、AgentTool、Hook都是可替换的策略。
2. 工厂模式:AguiAgentRegistry存储 Supplier<Agent> 工厂,每次请求创建新实例。
3. 适配器模式:AguiAgentAdapter将 ReActAgent 的内部事件转换为 AG-UI 标准事件。
4. 观察者模式:Hook通过事件监听实现工具调用拦截。
读者如果不 care 技术细节,可以通过下图看看复用层 SPI 设计的节点所在:
如果您是技术的话,建议看看在完整的调用链路图中,这些核心类所在节点:
再看看我们如何结合运行链路 4 大 SPI 的能力,扩展出符合即用即建、身份传递、人机精准协同、回话持久的核心能力:
4 个 SPI 都会推出定制的 Finance 级别的实例,请看下面的详细说明。
5.1.4.1 FinanceAguiRuntimeContextBuilder( SPI1)
FinanceAguiRuntimeContextBuilder 是我们针对运行链路定制的第一个SPI;public ProcessResult process(RunAgentInput input, String headerAgentId, String pathAgentId) {String threadId = input.getThreadId();String agentId = this.resolveAgentId(input, headerAgentId, pathAgentId);RunAgentInput effectiveInput = input;if (this.agentResolver.hasMemory(threadId) && !input.hasResume()) {logger.debug("Using server-side memory for thread {}, extracting latest user message", threadId);effectiveInput = this.extractLatestUserMessage(input);}// 在运行之前构建的上下文RuntimeContext runtimeContext = this.buildRuntimeContext(effectiveInput);Agent agent = this.agentResolver.resolveAgent(agentId, threadId);AguiAgentAdapter adapter = new AguiAgentAdapter(agent, this.config, runtimeContext);Flux<AguiEvent> events = adapter.run(effectiveInput).doFinally((signal) -> {logger.debug("Request completed for thread {}, signal: {}", threadId, signal);this.agentResolver.onComplete(threadId, agent);});return new ProcessResult(agent, events);}
它本质上是构建了一个贯穿 AgentScope 整条请求链路的上下文对象。复用层框架将 RuntimeContext的创建通过 AguiRuntimeContextBuilder SPI 开放给业务层定制。
本项目实现了通过继承 AguiRuntimeContextBuilder开发了FinanceAguiRuntimeContextBuilder,将每次 AG-UI 请求的上下文数据组装进框架的 RuntimeContext,包含 4 个字段:
为什么这么做?
原因一:线程安全。复用层底层是异步线程池模型,线程会被多个会话复用。如果通过 ThreadLocal传递请求级数据,线程归还线程池后残留数据可能污染后续其他会话。RuntimeContext由框架绑定到 AgentBase实例上(per-agent-instance),随请求创建、随请求销毁,天然隔离,不存在跨会话串数据的风险。
原因二:全链路可达。RuntimeContext贯穿 Agent 从创建到执行的完整生命周期,下游多个链路节点可以直接通过 agent.getRuntimeContext() 消费,无需额外传参:
两条设计优势合在一起:既避免了线程池复用导致的数据串扰,又让请求级数据在全链路任意节点随手可取——这是选择 RuntimeContext而非 ThreadLocal或方法参数透传的根本原因。
5.1.4.2 FinanceAguiSessionManager(SPI2)
光听名字,可能你会以为它只是一个 session 的管理者,但其实并不完全是,让我们看看它的 interface 就知道了:
public interface AguiSessionManager {Agent getOrCreateAgent(String var1, String var2, Supplier<Agent> var3);boolean hasMemory(String var1, String var2);boolean removeSession(String var1, String var2);voidcleanupExpiredSessions();intgetSessionCount();defaultvoidsaveAgent(String threadId, String agentId, Agent agent) {}voidclear();}
1)AguiSessionManager 的设计初衷
AguiSessionManager 是复用层的核心设计之一,它本质上是 Agent 实例与持久化存储之间的桥梁——解决 AG-UI 协议下无状态 HTTP 与有状态 Agent 之间的矛盾。框架通过 5 个方法定义了完整的会话生命周期契约:
复用层框架默认提供 InMemoryAguiSessionManager(ConcurrentHashMap 缓存,进程重启丢数据)和 SessionAwareAguiSessionManager(走框架 Session SPI,但每次全量序列化/反序列化 memory)。两者都无法满足生产级需求。
我们在复用层设计 AguiSessionManager的 getOrCreateAgent方法时,既是为了实现“即用即建”机制的,当然也可以使用缓存机制。
很显然复用层在运营链路上支持定义实时的 Agent 创建入口——框架把 Agent 的创建权通过 Supplier<Agent> 参数交给业务层,而我们的 AgentConfigSnapshot其实也是为了缓存机制才设计的。
前面说了 snapshot 构建了包含 Agent 的所有相关能力:MCP、Skills、SkillBox、modelParams、Toolkit 等等。所以我们可以快速创建一个轻量级的 agent,并且达到以下几点:
资源高效共享:snapshot 是 volatile 引用,所有请求共享同一份配置快照,创建 Agent 时只做一次 volatile 读,零 DB/网络开销。
性能卓越:createAgent() 不触发任何远程调用,只是从 snapshot 中组装 prompt + model + tools,毫秒级完成。
完全隔离,保障稳定性与安全性:每个请求拿到独立的 ReActAgent 实例(PROTOTYPE scope),per-request 的 memory、RuntimeContext 互不干扰。
目标确定后,我们还要理解 AguiSessionManager 是什么;要理解 AguiSessionManager,就要理解 AguiRequestProcessor的核心作用。
2)复用层 AguiRequestProcessor:运营链路前两大阶段的管控中枢
复用层的运营链路如果拆细的话会有 20 多个节点,但粗略分类可以分成 4 个阶段:
1. 请求预处理 — 构建请求上下文、初始化各类核心组件。
2. Agent 创建和会话/记忆加载 — 实例化 Agent 并恢复历史状态。
3. ReAct 循环机制 — LLM 推理 → tool 调用 → 观察结果 → 再推理。
4. 会话持久化和收尾工作 — 保存状态、触发异步任务。
AguiRequestProcessor 是除了 ReAct 循环机制阶段以外的核心管控类。从框架代码结果看,它持有三个关键组件和一个核心方法,让我们一起来看看:
public class AguiRequestProcessor {private final AgentResolver agentResolver; // → 桥接 AguiSessionManagerprivate final AguiAdapterConfig config; // 适配器配置private final AguiRuntimeContextBuilder runtimeContextBuilder; // → 我们的 FinanceAguiRuntimeContextBuilder}
它有一个核心方法是 process,我们来看看:
这个核心方法编排清晰地展示了 AguiRequestProcessor 的角色:它不负责具体的 Agent 创建、状态加载或上下文构建,而是编排这些 SPI 的调用顺序。每个 SPI 各司其职:
AgentResolver管理着获取 Agent 实例的生杀大权,spark 是支持自定义的,这里我们默认用了复用层的 DefaultAgentResolver,不做任何改造。
DefaultAgentResolver的设计初衷是解决一个核心矛盾:AguiRequestProcessor只关心"给我一个 Agent",但 Agent 的获取方式在不同部署模式下可以完全不同。
DefaultAgentResolver做了两件事:
1. 缓存 threadId 和 agentId 的关系。
2. sessionManager.getOrCreateAgent 的方法。
a. 并且传递给 getOrCreateAgent 的 AguiAgentRegistry 获取 Agent 的权限。
由此可见创建 Agent 的方式是完全可以定义的。
来理一理关系:
AguiRequestProcessor通过 DefaultAgentResolver管理 Agent,DefaultAgentResolver 又将周期托给 sessionManager,sessionManager 本质是可以进行 SPI 定制,所以我们决定定制一个 sessionManager,来真正管理 FinanceAgent 的 Agent 实例和历史、记忆。
来看看我们 FinanceAguiSessionManager 的设计是如何达到轻量、隔离的目标:
getOrCreateAgent方法的组装过程分为三个阶段,全程只依赖一次 volatile 读拿到的:
1. 通过 agentSnapshot 轻量组装 Agent。
2. 加载历史 session + 长期记忆。
3. 检测是否需要提交异步压缩任务。
其中 agentSnapshot 的设计需要一些考量,前面我们讲过 BaseFinanceAgentFactory 会构建 snapShot,所以我们最好是快速定位到对应的BaseFinanceAgentFactory,所以我们在项目初始化的时候就会把BaseFinanceAgentFactory 专门通过 snapshot 创建 Agent 的方法 createAgent 注册到 sparkRegistry:
sparkRegistry.registerFactory(agentCode, entry::createAgent);然后 registry.get 就可以拿到对应创建函数,执行即可!
而 createAgent 核心逻辑就是组装 ReactAgent;
具体而言,createAgent() 的组装过程分为三个阶段,全程只依赖一次 volatile 读拿到的 AgentConfigSnapshot,不再触发任何 DB 或远程调用:
阶段一:Prompt 增强
原始 prompt(来自 snapshot)↓ 拼接用户长期记忆(memoryService.loadInjectionText)↓ 拼接 RAG 检索结果(ragRetriever.retrieve,mode=inject)= finalPrompt
两步增强都是非致命的:任何一步失败都只打 warn 日志,降级为原始 prompt,绝不阻断请求。这里有个关键设计——长期记忆和 RAG 的注入时机选在了 createAgent() 而非 refreshFromDb(),因为它们依赖请求级的 userId和 ragQuery(来自 RuntimeContext),而不是配置级的静态数据。
阶段二:ReActAgent.Builder 组装
ReActAgent.builder().name(agentName()) // snapshot.agentName.sysPrompt(finalPrompt) // 阶段一的增强 prompt.model(getModel()) // qwenModel bean(Spring 单例).generateOptions(buildGenerateOptions(snap)) // temperature/topP/maxTokens/modelName.maxIters(resolveMaxIters(snap.modelParams())).toolkit(snap.toolkit()) // 预构建的 Toolkit(MCP + App Tools + RAG Tools).skillBox(snap.skillBox()) // 预构建的 SparkSkillBox.hook(hitlHook) // Human-In-The-Loop 拦截钩子.build();
注意 toolkit和 skillBox都是 snapshot 里已经构建好的对象。这就是 snapshot 的核心价值:把耗时的 MCP 客户端建连、Tool 注册、Skill 加载全部前置到 refreshFromDb() 阶段,createAgent() 只做引用传递,真正实现每次请求的 Agent 组装是纯内存操作。
阶段三:参数覆盖级联
temperature、topP、maxTokens、maxIters、enablePlan、modelName六个参数都遵循同一优先级链:
HTTP Header(X-Temperature 等) > DB JSON 字段(modelParams) > DEFAULT 常量这使得同一份 DB 配置可以支撑按请求粒度的参数微调,而不需要修改 DB 或触发 refresh。
3)snapshot 不可变设计
AgentConfigSnapshot 是一个 final类,所有 List 字段用 Collections.unmodifiableList() 包装,对外只暴露 getter,没有 setter。BaseFinanceAgentFactory持有一个 volatile AgentConfigSnapshot configSnapshot 字段:
写:只在 refreshFromDb() 中整体替换引用(this.configSnapshot = newSnapshot),不存在局部修改。
读:createAgent() 开头做一次 volatile 读到局部变量
snap,后续全程用这个局部引用。
这保证了跨字段一致性——同一次 createAgent() 调用中,prompt、toolkit、skillBox 一定来自同一版本,不会出现 prompt 是新版本而 toolkit 还是旧版本的中间态。
4)FinanceAguiSessionManager 的整体设计
除了 createAgent()的轻量级别的创建设计,还有 saveAgent和 removeSession、hasMemory的定制,对于 financeAgent 的整体轻量也有功不可没的作用。
hasMemory()— 双检存在性探测:先查 ac_agent_session,再查 ac_agent_block.maxSeq,避免全量加载对话历史即可判断“是否有历史”。这是复用层决定是否走 extractLatestUserMessage 的关键钩子。
saveAgent()— 增量持久化:通过 JdbcSession 黑名单跳过 memory_messages的全量写入,只增量 append 新 block(seq > dbMaxSeq),写放大从 O(N) 降到 O(Δ)。
removeSession()— 级联清理:单次锁获取内完成 ac_agent_session+ ac_agent_block的批量删除,并同步清理 tailSnapshot缓存。
完整生命周期性能画像表,汇总 createAgent→ hasMemory→ onEnter→ saveAgent→ removeSession各阶段的耗时与 DB 操作。
这四个方法共同构成了 finance agent 的轻量级运行时:createAgent解决创建轻(< 1ms,零 DB),hasMemory 解决探测轻(索引命中),saveAgent解决持久化轻(增量写),removeSession解决清理轻(批量删除)。
5.1.4.3 工程级别的 human in the loop(SPI3)
hitl 本身存在两种方式,一种是模型级别的方式,另一种是工程级别的。
他们的区别:
举个例子:
为什么要用工程级别 hitl?如果使用模型级别的 hitl 会有什么问题?
由于模型是不感知工程级别的 hitl,可见工程级别的 hitl 是需要做拦截操作,拦截点如下:
1. 如何确认用户在做确认操作?
2. 如何确认用户在使用工具前、后需要做拦截操作?
a 发现拦截点,如何停止 Agent 的所有行为!等待确认结果才能继续之前的链路;
非常荣幸的是 AgentScope 的 hooks 系统非常强大:
整体链路呈现方式:
总结一下:
1. 可识别用户传递的 message 格式,约定好 hitl 确定格式即可。
2. PostReaningEvent 是在调用工具之前,并具备工程级 stopAgent。
3. PostActingEvent 在调用工具之后,并具备工程级 stopAgent。
解决了 hitl 的基础能力,我们还要定义具体的优先级策略和工作模式!
HitlResolver 的决策优先级
before 和 after 模式,我们都会由 HitlResolver 来确定命中那个 hitl,具体 5 层拦截逻辑如下:
三种工作模式详解:
BEFORE(执行前拦截)
AFTER(执行后审核)
Resume(用户确认后恢复)
5.1.4.4 ContextInjectingMcpTool(SP4)
AgentTool 是 AgentScope 作为工具级别的 SPI 扩展点,可以定义封装工具调用逻辑:
public interface AgentTool {String getName();String getDescription();Map<String, Object> getParameters();Mono<ToolResultBlock> callAsync(ToolCallParam param);}
ContextInjectingMcpTool 实现该接口,以装饰器模式包装框架原生的 McpTool,解决一个核心问题:MCP Server 的鉴权身份不能在构建期焊死,必须在每次调用时动态绑定到当前请求用户。
1)问题背景
AgentScope 原生 McpTool的身份在 AoneMcpClientBuilder.buildSync() 构建期就已确定(DB ac_mcp_server.user_id),所有用户共享同一个身份调用 MCP Server。这在金融场景下不可接受——不同用户调用同一个 MCP 工具(如查询审批单),MCP Server 必须看到调用者本人的身份才能做权限校验和数据隔离。
2)设计:调用时身份注入
ContextInjectingMcpTool不改变工具的对外契约(getName/ getDescription/ getParameters全部透传 delegate),仅在 callAsync边界完成身份注入:
关键点:身份传递走 Reactor Context(响应式线程安全的上下文传播机制),而非 ThreadLocal。这是因为 MCP 调用链全异步(Mono/ Flux),ThreadLocal 在跨线程调度时会丢失。
3)McpCallIdentity:调用级身份载体
public final class McpCallIdentity {public static final String CONTEXT_KEY = "mcpCallIdentity";private final String empId; // BUC 工号 → Normandy bucUserIdprivate final String ssoToken; // BUC SSO token → Normandy bucSsoTokenprivate final Map<String, String> extras; // 预留扩展位}
设计为不可变值对象而非散键的原因:身份字段会增长(empId → +ssoToken → 未来可能 +sessionId / 租户号)。收敛为一个对象后,传输链中间层(ContextInjectingMcpTool → McpTransportContext)无需随字段增减改动,只有组装端(RuntimeContext 读取)和消费端(鉴权头生成)两头需要动。
5.1.5 七条设计哲学总结
1. 约定优于配置。
2. DB 与应用层同构(消除转换层)。
3. 草稿/发布双轨(修改不影响线上)。
4. 乐观锁全覆盖(防并发冲突)。
5. 组件市场 + 绑定分离(复用 + 独立演进)。
6. 异步任务解耦(不阻塞主流程)。
7. 增量持久化(减少写压力)。
▍5.2 要点二:低成本兼容各个生态平台
5.2.1 SkillSourceLoader
当前系统已建立 SkillSourceLoaderSPI 抽象层,将 Skill 来源的差异封装在接口实现层,上层 SkillRegistry+ BaseFinanceAgentFactory完全不感知底层来源细节。这意味着接入新生态平台的成本被压缩到“实现一个@Component类”的量级。
关键接口契约:
public interface SkillSourceLoader {String skillSource(); // 来源标识: "AONE" / "OSS" / "GITHUB" / ...AgentSkill load(SkillKey key); // 加载技能(下载+解析)defaultintpurgeLocalCache(); // 清理全部本地缓存default Path localCacheDir(); // 本地缓存根目录defaultvoidpurgeLocalCacheForKey(SkillKey key); // 清理单个缓存}
SkillKey 三元组:(skillSource, skillName, skillVersion)— source 是一等公民,天然支持多来源共存。
5.2.1.1 AoneSkillSourceLoader
生产级保障:
强约束层:ac_agent_skill 的每一行必须指向一个 enabled=1 的 ac_skill行,否则启动时 fail-fast(IllegalStateException),杜绝“配置了但加载不到”的隐患。
弱失败层:Aone 服务暂时不可用时,Agent 仍能启动(跳过该 Skill),后台定时重试恢复。
版本管理:ac_skill.skill_version 支持语义化版本,升级 Skill 只需在 DB 中新增一行 + 更新 ac_agent_skill 绑定。
5.2.1.2 OssSkillSourceLoader
研发加速价值:
零审批迭代:开发者修改 SKILL.md (http://skill.md/) → 打包 zip → 上传 OSS → DB 新增一行 ac_skill(source=OSS) → 刷新 Agent,全程无需走 Aone 发布审批。
版本快速切换:同一 Skill 可在 OSS 上维护多个版本,开发者通过修改 ac_agent_skill.skill_version 秒级切换。
本地调试友好:OSS Skill 的本地缓存目录与 AONE 隔离,互不干扰。
5.2.1.3 扩展新生态平台的成本分析
接入一个新 Skill 市场的步骤:
不需要改动的部分:
SkillRegistry— 自动发现新 Loader,无需修改。
SkillKey— 已包含 source 维度,天然兼容。
BaseFinanceAgentFactory.resolveSkills() — 只关心
SkillKey,不关心 source 实现。ac_agent_skill / ac_skill表结构 — skill_source字段已是开放字符串。
前端管理页面 — 下拉选择新增 source 值即可。
5.2.1.4 标准化 Skill 驱动流程
5.2.1.5 如何监控 Agent 绑定 Skill 完整驱动的生命周期
1)Skill 生命周期全景图
2)ac_agent_skill_task 状态机详解
这是 Skill 生命周期的核心驱动引擎,当前实现的状态流转:
阶梯式的 6 次重试策略:
调度器双轨制:
生产环境:AgentSkillTaskScheduler(SchedulerX2),推荐 cron 0/20 * * * * ?(20 秒一轮)。
开发环境:AgentSkillTaskLocalScheduler(Spring @Scheduled),fixedDelay=20s,需手动开启。
5.2.2 mcp
McpClientFactory.build() 只做一件事——把 DB 行逐字段映射到复用层框架的 AoneMcpClientBuilder:
// McpClientFactory.java:69-101AoneMcpClientBuilder builder = AoneMcpClientBuilder.create(server.getMcpServerName()).mcpId(server.getMcpServerId());// 每个 DB 列 → 一个 builder setter,全是 if-not-blank 映射if (isNotBlank(server.getMcpServerType())) builder.type(parseEnum(AoneMcpType, ...));if (isNotBlank(server.getAuthMode())) builder.authMode(parseEnum(AoneMcpAuthMode, ...));if (isNotBlank(server.getRegion())) builder.region(parseEnum(AoneMcpRegion, ...));// ... 共 8 个字段return builder.buildSync(); // transport/auth/URL解析 全交给框架
关键点:URL 解析、transport 选择、auth 实现全部在复用层框架内部。项目代码只做“DB → Builder”的哑映射。框架新增一个 AoneMcpType 枚举值,这边零行代码变更——parseEnum() 是泛型反射,自动识别新枚举。
5.2.3 Skill vs MCP 两种兼容策略
设计取舍很清晰:Skill 各平台差异大(仓库协议、文件格式、版本模型都不同),必须自建插件化;MCP 协议本身是标准化的(MCP schema + HTTP transport),差异只在 URL 解析和鉴权方式,这些恰好是框架已经解决的问题,所以选择让渡给框架,自己只做数据驱动的配置层。
▍5.3 要点三:Agent 整体效果进化
5.3.1 思考
2026 年被视为 AI 爆发的元年,Hermes 现象级的走红让“进化”一词成为行业热词。尽管各类技术文章铺天盖地地分析着各种“闭环进化”的策略,但业界似乎鲜少有人能清晰界定:究竟什么是真正的“进化?”其核心衡量指标又是什么?
我们需要回归本质,厘清一个关键命题:如何区分“变化”与“进化”?以 Hermes 的 Skill 创建策略为例,从严格意义上讲,这更多是一种随机的“变化”。由于缺乏有效的价值验证机制,我们很难判断新生成的 Skill 是否真正提升了系统能力——没有正向反馈的变化,只能称为扰动,而非进化。
我翻阅了部分 Hermes 的源码,也查看了响应的资料,得出了一个结论:
而 Hermes 并没有做到的是:
Hermes 的“进化”本质上是“自组织的知识治理”——它擅长控制熵(合并冗余、归档过时、去重命名),但没有闭环的效果反馈来证明变化是改善。Curator Prompt 自己明确承认 "DO NOT use usage counters as a reason to skip consolidation",说明系统知道自己无法从遥测数据判断 Skill 质量。这是设计上的有意取舍(优先结构治理),还是能力上的待补全缺口,取决于产品定位。
5.3.2 如何定义进化
在构建自主智能体(Agent)及其底层技能(Skill)的过程中,我们常陷入一个误区:认为存在一个完美的、终极的模型状态。然而,Agent 和 Skill 进化的核心驱动力并非抽象的自我完善,而是基于具体场景的效果反馈,尤其是可量化的效果对比。
必须明确一个核心认知:“绝对进化”是一个伪命题,只有“相对进化”才是工程实践中真实且可执行的命题。
1)为什么“绝对进化”是伪命题?
在开放域的自然语言处理或复杂任务规划中,不存在唯一的“标准答案”。同一个用户意图,可能有多种合法的执行路径;同一段代码,可能有多种等效的实现方式。因此,试图定义一个放之四海而皆准的“完美 Agent”不仅理论上不可行,工程上也无意义。
真正的进化,发生在有限边界内的比较优势中。我们需要将无限的现实世界映射到有限的评测集(Benchmark)上。只有通过构建高质量的测试用例,并引入如 3 分制、6 分制或 9 分制等细粒度的打分机制,才能将模糊的“好与坏”转化为可追踪、可优化的“高与低”。
这种相对进化的逻辑链条如下:
基线确立:在当前版本的评测集上建立性能基线。差异对比:新版本相对于旧版本,或在不同策略之间,在特定指标上的得分差异。迭代导向:根据得分差距定位短板,驱动下一轮的参数调整或逻辑优化。
2)定义指标
权重设计:
3)定义评测
5.3.3 如何研发进化闭环的能力?
人工闭环 vs 自动闭环
1)人工闭环:最小可行的进化系统
在讨论自动化之前,必须先承认一件事:人工闭环不是自动闭环的低级形态,它是自动闭环的原型验证。
人工闭环的流程是直观的:
这个流程看起来很原始,但它在特定阶段是不可替代的。
人工闭环的真正价值
第一,它建立了归因的心智模型。
在系统早期,你甚至不知道“失败”长什么样。用户的抱怨可能是路由问题,也可能是底层数据源的问题,还可能是用户自己的预期不合理。这些分类,必须由人肉 review 几百个 case 之后才能形成稳定的判断框架。
跳过这一步直接做自动化,等于是在没有标注数据的情况下训练分类器——你不知道自己在优化什么。
第二,它验证了干预是否有效。
早期最大的风险不是“进化太慢”,而是“进化方向错了”。人工闭环让你能直接感知:修改 skill description 之后,路由真的变准了吗?还是只是你构造的测试 case 碰巧过了?
这种直觉,在系统不成熟时,比任何自动评测都可靠。
第三,它发现了“不可修复”的 case。
有些失败不是 Skill 的问题,是系统架构的问题,甚至是产品定义的问题。这些 case 需要人工识别后推动上游变更,自动闭环没有这个判断力。
决策是否需要自动闭环:
2)人工闭环的瓶颈:为什么它必然会到达天花板?
人工闭环的瓶颈不是“慢”——慢只是表象。真正的瓶颈有三个:
瓶颈 1:评估一致性
同一个 bad case,两个开发者可能给出不同的归因结论。这不是能力问题,是认知偏差。
Case:用户问"上个月供应商的账期分布"开发者 A:归因为路由问题——应该走 financial-analysis-skill,结果被路由到了 data-query-skill开发者 B:归因为能力缺失——financial-analysis-skill 存在,但没有"账期分析"的子能力
两种归因都合理,但干预方向完全不同。如果归因不一致,后续的所有优化都会互相抵消——今天 A 改了路由描述,明天 B 又给 Skill 加了新能力,系统的演化方向变成了随机游走。
自动闭环解决这个问题不是通过“消除分歧”,而是通过固化一套评估标准,让所有决策在同一个标尺下做出。
瓶颈 2:评估覆盖率
人工 review 永远只能覆盖样本,而不是全量。当系统每天处理几千次请求时,人工 review 的可能只有 5%。
这 5% 里还有严重的选择偏差——被 review 的往往是“用户投诉了”的 case,大量“用户没投诉但其实效果一般”的 case 被忽略了。
自动闭环可以处理全量流量。它不需要用户投诉——它可以根据预定义的评估指标,主动发现效果不佳的 case。
瓶颈 3:反馈延迟
人工闭环的反馈循环是天级别的:今天发现问题,明天分析,后天修改,大后天发布。
但 Skill 的问题可能是小时级别的——一个底层数据源的 schema 变了,导致 SQL 生成 Skill 产出的 SQL 全部报错。等人工发现时,已经影响了几百次请求。
自动闭环可以把反馈延迟压缩到分钟级别:评测持续运行,指标一出现偏移就触发告警和自动干预。
3)自动闭环
这三层的关系是:数据管道提供原料,执行引擎提供算力,策略层提供评估逻辑。任何一层缺失,自动闭环都无法运转。
评测数据管道:从 Trace 到评测资产这是自动闭环中最容易被低估,但最重要的部分。
L1: Trace:结构化执行记录
Trace 不是日志,Trace 是结构化执行记录。两者的区别在于:日志是给人看的,Trace 是给机器分析的。一条合格的 Trace 必须包含:
Outcome Signals:结果信号体系
需要用数据管道,把这些异构信号统一为标准化的 outcome label。
打分机制:
几个容易踩的坑
坑 1:评测数据集的偏差
如果评测数据集主要来自用户投诉(显式反馈),它会有严重的偏差——只覆盖了“用户愿意投诉”的场景。大量“效果一般但用户懒得反馈”的 case 不在数据集中。
解法:主动采样。按 Skill、按意图类型、按时间段分层采样,确保评测数据集的分布接近真实流量分布。
坑 2:LLM-as-judge 的稳定性
用 LLM 评估 LLM 的回答,评分会有随机性。同一个回答,两次评估可能给出不同的分数。
解法:
使用四维 rubric(而非开放式打分),每个维度有明确的 1-5 分标准,减少评分随机性。
多次评估取均值(至少 3 次)。
定期用人工标注校准,确保自动评分与人工评分的 Pearson 相关系数 > 0.7。
性能维度完全走自动化指标,不经过 LLM-as-judge,避免不必要的评分噪声。
坑 3:过度优化
自动闭环可能会让系统“过拟合”到评测数据集。Skill 在评测中表现很好,但线上效果一般。
解法:
评测数据集定期更新(每月至少替换 20%)。
保留一个“隐藏”评测集,永远不用于优化,只用于验证。
线上指标和评测指标同时监控,两者出现背离时立即排查。
坑 4:忽视评测系统自身的成本
评测不是免费的。每次评测消耗 LLM API 调用、计算资源、存储资源。如果评测频率过高或评测集过大,成本可能失控。
解法:
增量评测优先:只评测受影响的 Skill,不全量回归。
评测集分层:核心集(必须每次都跑)+ 扩展集(低频跑)。
用小模型做 LLM-as-judge,只在不确定时升级到大模型。
坑 5:四维权重的校准缺失
默认权重(相关性 0.30 / 准确性 0.35 / 完整性 0.20 / 性能 0.15)是起点,不是终点。不同业务场景、不同用户群体的真实权重可能差异很大。如果长期不校准,综合分会与用户真实感受脱节。
解法:
收集人工标注的“整体满意度”评分,与四维加权分做回归分析,反推真实权重。
按 Skill 类型维护差异化权重(如告警类 Skill 性能权重上调至 0.30)。
每季度回顾一次权重配置,确保与用户体感一致。
▍5.4 要点四:上下文压缩策略和长期记忆的策略
5.4.1 目的
一句话说明目的:
上下文压缩:防止单次请求的 LLM context window 随对话轮次无限增长。核心思路:旧对话 → LLM 摘要 → 替换原 block,保留最近 N 个 block 完整不压缩。
长期记忆(User 级):管“跨会话记住用户是谁、偏好什么”。
5.4.2 压缩
Block 的 seq= 首条 Msg 的 timestamp(ms),保证严格递增且幂等。
什么时机开始?
答:还是 FinanceAguiSessionManager 的能力。
压缩时机发生在 createAgent 阶段,同步探测,三阈值任一超限即触发:
幂等保证:INSERT IGNORE + UK (agent_code, thread_id, status) → 同 thread 同时只有一条 PENDING。
完整设计:
关键设计点:
1. 异步执行:压缩不在请求链路上,不影响用户延迟。
2. CAS 抢占:多 worker 并发安全(updateStatus(id, PENDING, RUNNING) 返回 0 = 别人已抢)。
3. Session 锁内执行:避免与 onEnter/onExit 并发操作 block 表。
4. 失败重试:最多 5 次,超限后保持 RUNNING + last_error 等运维介入。
5. SUMMARY seq 冲突保护:INSERT IGNORE 返回 0 时放弃,避免重复归档。
6. 下次 createAgent 加载时:
a. blockMapper.selectActiveAsc() 只取 archived=0的 block
b. 返回:[SUMMARY block] + [最近 5 个 NORMAL block]
c. SUMMARY block 的 role=SYSTEM,文本以 [Conversation Summary] 开头,LLM 能识别为历史摘要
5.4.3 长期记忆的策略
从对话中自动抽取用户偏好和事实,跨会话持久化,在每次请求时注入 system prompt,使 Agent “认识”老用户。
▍5.5 要点五:和业财平台综管打通,自由化定制页面
▍5.6 要点六:全链路身份标识和建立细粒度权限控制机制
设计权限体系,重点考虑以下方面:
如何在 Agent 调用链路中嵌入权限校验逻辑。
如何实现基于用户身份和上下文的数据隔离。
如何支持动态、可视化、可审计的权限申请与授权流程。
如何确保 MCP/Skill 层与底层数据服务之间的权限策略一致。
该问题的解决将直接影响系统的安全性、合规性与可扩展性,需在架构演进中同步规划与落地。
5.6.1 梳理了现有权限体系的四个纵深防御切面
5.6.2 全链路身份统一
现状:financeAgent 工程内部的身份传递链路已基本打通——BUC SSO 在入口层完成认证,empId+ ssoToken通过 HTTP Header 桥接至 AG-UI 的 RuntimeContext,MCP 调用层通过 McpCallIdentity+ Normandy SM2 签名实现了 per-request 的身份隔离(ContextInjectingMcpTool → McpClientFactory.buildIsolated())。这条链路在工程内部是闭环的。
问题:但当调用链走出本工程边界时,身份上下文存在断裂:
规划:
1. HSF 调用链身份透传:在 HsfUtil泛化调用层注入 EagleEye RpcContext,将 empId作为 caller context 透传至下游 HSF 服务。下游服务可据此做用户级鉴权和审计,而非仅识别调用方应用。优先覆盖 AMDP 数据查询链路(当前所有用户查询共享同一 AuthParam,存在越权查询风险)。
2. MCP 身份隔离全覆盖:当前 shouldIsolate() 仅对 NORMANDY_AUTH + AONE/ZETTA 类型生效。未来应扩展至所有 MCP Server 类型,对于不支持 per-request 身份的 MCP Server,推动其接入 Normandy Auth 或 OAuth2 token exchange 模式,逐步消除共享 token 的安全面。
3. 统一身份上下文(Identity Context):抽象一层 CallerIdentity(超越当前 McpCallIdentity的 MCP 范畴),覆盖 HSF / MCP / HTTP 回调用 / MetaQ 消息生产者等所有出站调用场景。确保无论请求从哪个通道进入、从哪个通道出去,终端用户身份始终可追溯。
5.6.3 灰度体系建设
现状:灰度路由的核心框架已搭建完成——ac_agent_gray_config表 + GrayMatcher三维度匹配(百分比 / 白名单 / 环境)+ BaseFinanceAgentFactory.buildPublishedSnapshot() 的版本分流逻辑,支持灰度发布 → 验证 → 全量推进(promoteToStable)的完整生命周期。
当前短板与演进方向:
2. 灰度可观测性:当前灰度命中结果仅体现在版本加载逻辑中,缺乏显式的埋点和指标。需要:
在 AG-UI 响应 Header 中标记 X-Gray-Hit: true/false 和 X-Agent-Version,便于前端感知和调试。
按灰度/稳定版维度拆分核心指标(成功率、平均耗时、工具调用失败率),接入 Sunfire Dashboard。
灰度命中日志结构化输出,支持按 empId+ agentCode + version三维检索。
3. 多级灰度编排:当前灰度粒度是单个 Agent 级别。未来需支持:
Skill 级灰度:同一 Agent 内,部分 Skill 使用灰度版本(如新 prompt 模板),其余保持线上版本。
MCP Server 级灰度:新版本 MCP Server 仅对灰度用户开放,避免新工具的不稳定性影响全量用户。
组合策略:白名单 + 百分比可叠加(先白名单内部验证 → 再百分比放量),当前三种策略是互斥的。
4. 灰度自动推进与回滚:
设定灰度阶段的自动推进条件:灰度用户量 ≥ N 且成功率 ≥ 阈值 → 自动扩大百分比 → 全量。
设定自动回滚条件:灰度版本错误率突增(相对稳定版 > X%)→ 自动将灰度流量切回稳定版,发出 Sunfire 报警。
当前 promoteToStable是手动操作,需要在此基础上增加自动化决策层。
5. 灰度与 HITL 联动:灰度版本的新工具/Skill 应自动提升 HITL(Human-in-the-Loop)确认级别——灰度流量中的工具调用默认走 BEFORE 模式确认,稳定版则可降级为 AFTER 或免确认,降低灰度版本的爆炸半径。
5.6.4 其他安全基建
以上规划基于当前代码实际状态(GrayMatcher、McpClientFactory.buildIsolated()、HitlHook、UserUtils等),每项改进都有明确的代码切入点,可按优先级分阶段落地。
▍5.7 全链路可观测的实现
06
最后整体框架总结
Aliware