【CIKM'2026】CQ-SID:LLM生成式检索在手猫搜索召回中的探索与应用
原创 朱建波(玄羿) 2026-09-04 10:44 浙江
阿里妹导读
文章内容基于作者个人技术实践与独立思考,旨在分享经验,仅代表个人观点。
1 引言
1.1 背景
当前天猫APP中的搜索召回机制主要由三大类构成:文本倒排索引、向量检索(涵盖语义、多模态及个性化向量)以及基于Trigger的I2I召回。文本召回能够有效保证商品匹配的准确性,但受限于字符层面的精确匹配,难以克服语义鸿沟问题,无法识别语义相近但表述不同的文本;向量检索在一定程度上弥补了这一不足,能够捕捉语义层面的相似性,但在细粒度属性识别方面仍存在局限,难以精准区分关键属性的细微差异;Trigger召回则依赖用户历史行为商品进行相似推荐,具备较强的相关性保障,但在新颖性及多样性方面表现不足,容易陷入信息茧房。
随着大语言模型(Large Language Models, LLMs)技术在自然语言理解与生成任务上取得了突破性进展,生成式检索(Generative Retrieval)逐渐成为搜索与推荐系统的新兴范式。其核心思想是将传统的“索引-检索”流程完全参数化到一个模型中,即将商品语义信息编码为离散的语义标识符(Semantic ID, SID),并利用大模型强大的语义理解与生成能力,自回归地推理生成相关商品SID列表,从而实现对候选商品的直接检索,将检索任务转化为一个纯粹的生成任务,极大地简化了系统架构。
1.2 挑战
尽管生成式检索在学术上表现亮眼,但将其落地应用于实际电商搜索场景仍面临一系列挑战:
挑战一:搜索场景中端到端生成的落地可行性。 当前主流研究,如快手One系列等方法,普遍采用端到端生成模式,即摒弃传统“召回-粗排-精排”的多阶段漏斗架构,转而使用单一模型直接从海量候选商品中生成推荐结果。在推荐场景中,这种模式具备一定的可行性,因为推荐本身带有一定的探索性和多样性需求。然而,在搜索任务中,用户需求明确,对结果的准确性与相关性要求极高。端到端模型在应对上亿规模商品池时,能否充分建模所有商品、避免马太效应,以及是否具备足够的泛化能力以覆盖长尾查询,仍是亟待解决的关键问题。
挑战二:语义标识符的设计困境。 现有方法通常追求"一物一ID",以最大程度降低语义ID之间的碰撞率,从而提升Hitrate等指标。然而,在实际应用中,若SID划分过细,不仅训练阶段需要更多样本与更长时间以充分学习每个SID的语义信息,推理阶段为达到足够的召回数量,在Beam Search时也需通过加大Beam Size来生成大量候选SID,导致RT耗时和机器资源存在瓶颈,影响系统效率。如何在区分度与语义聚合之间取得平衡,是SID设计的核心难题。
挑战三:商品池的动态演化。 电商平台商品具有极强的时效性,每天都有大量新品上架和旧品下架。生成式检索模型将索引信息编码在模型参数中,如何高效地支持增量更新,也是一个难题。
挑战四:召回与下游排序一致性。召回模型通常利用点击购买作为目标来优化模型,然而一个好的召回模型不仅应该检索被点击的商品,还应该展现出更多下游排序可以利用的高质量商品。
基于以上分析,我们从现实出发将生成式检索定位于搜索召回阶段,作为召回中的一路补充,而非端到端生成。具体地:
提出了CQ-SID方法,基于RQ-VAE并通过商品类目感知与Query-Item对比学习进行构建的语义标识符,我们将其视为语义簇标识,在区分性与聚合性之间取得平衡。
设计了渐进式训练流程,基于LLM模型自回归SFT,通过Item2SID、Query2SID、(User+Query)2SI,逐步建立用户个性化Query到语义标识符的映射能力。
提出了EG-GRPO方法,即专家引导的群组相对策略优化,通过向策略梯度群组注入真实GT样本,在稀疏奖励环境中稳定学习过程,最终将生成式召回与下游排序曝光对齐。
2 方案设计
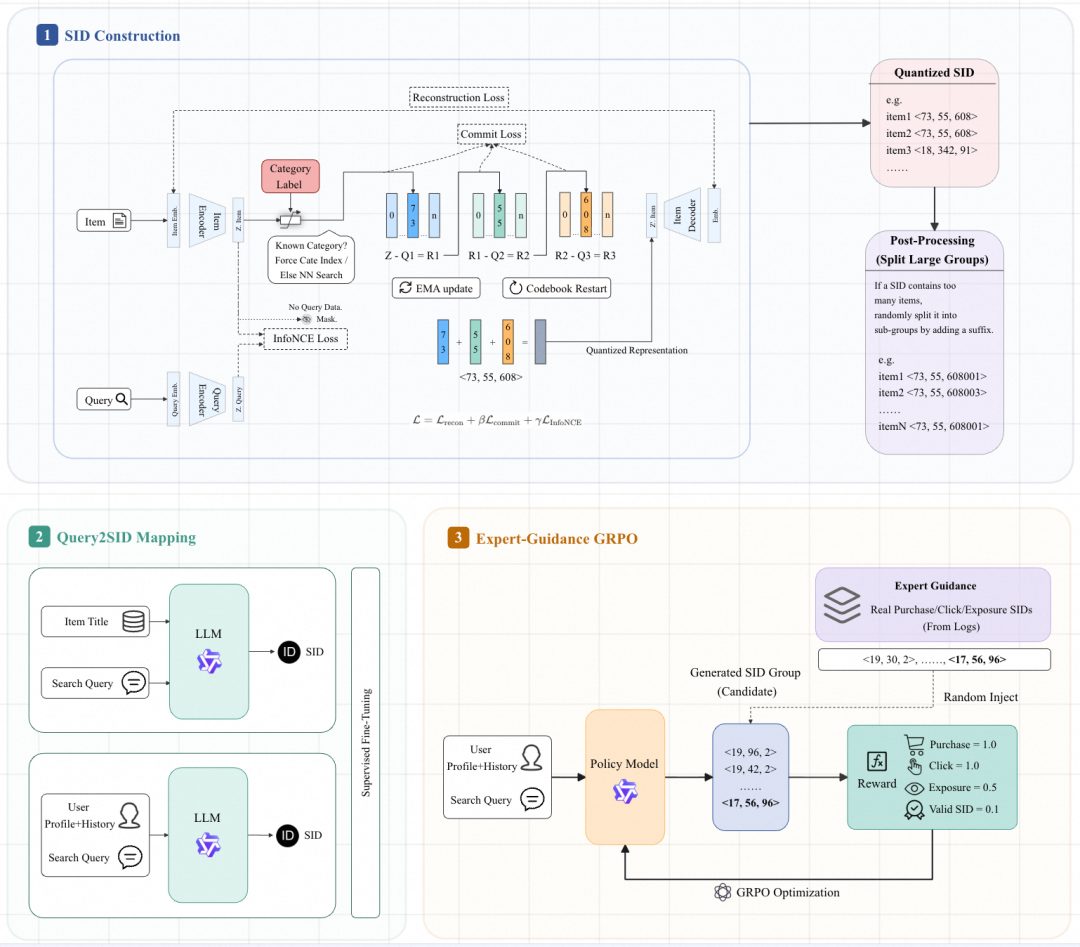
本节我们具体介绍在手猫搜索中落地的生成式召回方案。整体系统架构包含三个核心阶段:(1)商品SID的构建;(2)用户个性化Query到SID的映射;(3)对齐排序的专家引导强化学习。
2.1 商品SID构建
在SID构建过程中,我们并不追求SID的绝对唯一性,而是将SID视为一个“语义簇”的标识符,而非“单商品”的标识符。具体而言,我们期望召回阶段所使用的SID,既保证语义粒度的合理性,也兼顾了召回效率与覆盖广度,更贴合电商搜索对高效、可控召回的实际需求。其满足以下特性:
语义聚合性:语义或属性相似的商品可映射至同一SID,不追求SID低碰撞率,SID下挂载商品数保持在合理范围内即可;
区分度保障:不相似的商品应尽可能映射至不同的SID;
层次化结构:具备相似特征的商品应具有相同或相近的SID前缀。
2.1.1 模型结构
我们基于残差量化自编码器(Residual Quantized Variational Autoencoder, RQ-VAE),通过引入类目约束与Query-Item对比学习机制,构建具有层次化语义结构的商品SID,称为CQ-SID(Category-and-Query Constrained Semantic ID)。其中RQ-VAE中的输入向量特征,采用团队内已有的Query和Item多模态向量。CQ-SID的核心模型结构包含以下关键部分:
(1)类目引导的残差量化模块
我们采用三层残差向量量化结构,码本大小配置为K
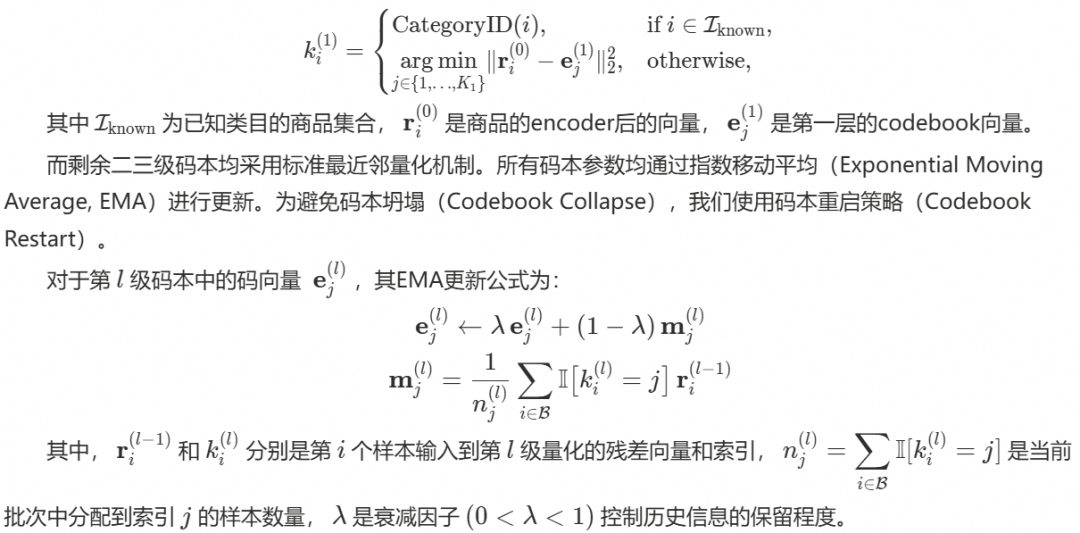
在训练第一级量化索引过程中,对于已知类目的商品,强制使用其类目标签作为索引,进行码本向量更新,其他商品则沿用最近邻检索:
(2)Query-Item对比学习机制
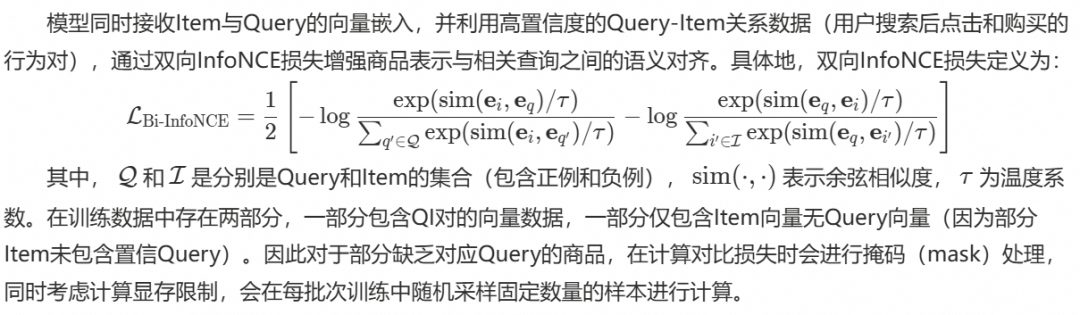
(3)联合训练目标
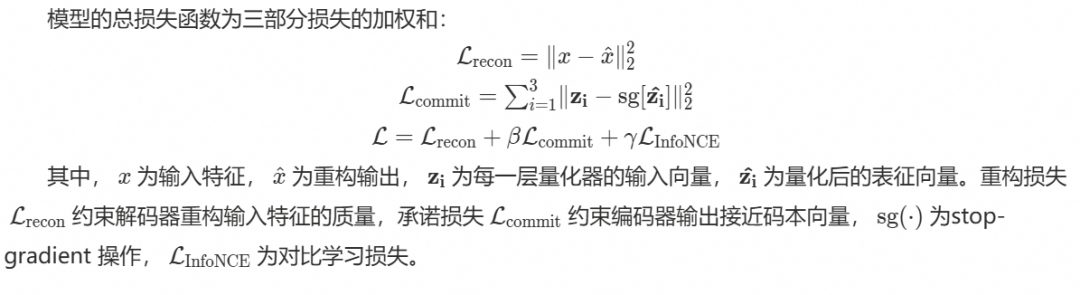
2.1.2 SID后处理
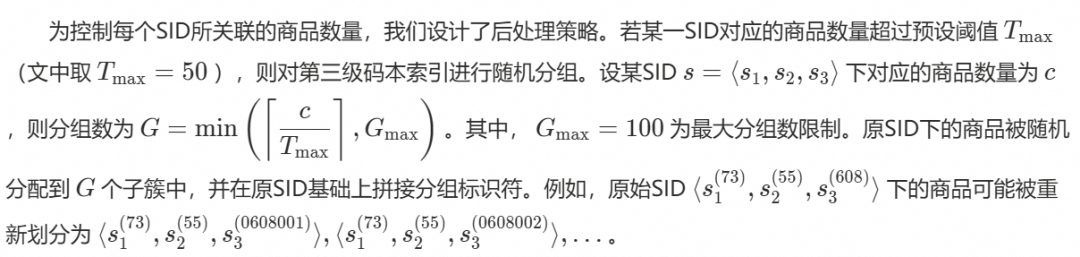
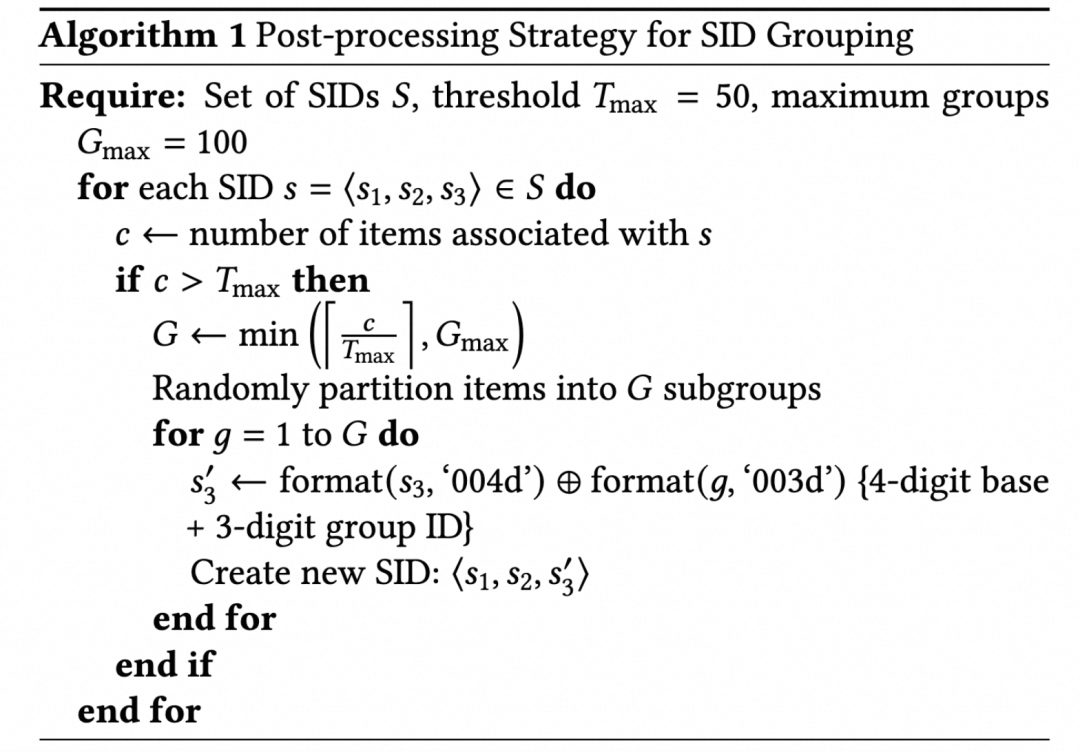
经过CQ-SID训练后,同一SID下的商品已经具有高度相似的语义和类别特征。因此,通过随机后处理分割大簇不会过度破坏语义连贯性。这一步主要是防止单个SID挂载太多的商品,避免了因某些热门语义簇过大而导致的检索偏差问题,同时维持了SID前缀的层次化语义结构。
2.2 Query2SID检索模型
第二阶段旨在建立从用户Query到商品SID的映射关系。我们采用渐进式训练策略,使模型逐步学习到从文本到个性化SID的生成能力。
2.2.1 Step1:Item-SID映射学习
通过第一阶段CQ-SID模型得到Item到SID的映射ϕ后,我们利用商品标题到SID的映射数据,使用Qwen2.5-0.5B模型进行监督微调SFT,损失函数为标准的NTP-Loss。训练样本的形式为:
Step1: I2SID- 输入:根据item生成对应的商品id,item:{商品信息}- 输出:{商品SID}
在这一阶段的训练,模型初步建立了从商品文本描述到语义标识符的映射能力,得到基础模型M1。此阶段的目标是让模型理解商品文本和SID的语义结构以及各级码本之间的层次关系。
2.2.2 Step2:Query-SID映射学习
进一步利用Query-Item关联数据,构造Query-SID映射样本。具体地,对于每个Query,随机采样N个(文中N=3)其关联的商品所对应的SID作为目标输出。训练样本的形式为:
Step2: Q2SID- 输入:根据query生成对应的商品id,query:{搜索词}- 输出:{商品SID}
对模型M
2.2.3 Step3:(U+Query)-SID学习
模型已经具备了Query2SID的能力,但是对于相同的Query,不同用户存在不同的兴趣偏好。因此为了更适合用户个性化召回,我们将用户性别购买力和近期点击的Query相关类目下的商品SID序列等特征信息加入模型继续进行训练,使模型能够根据用户的历史行为生成更具个性化的SID列表。训练样本的形式为:
Step3: UQ2SID- 输入:请根据以下内容,为用户推荐商品id。性别:{gender};购买力:{user_power};历史搜索词:{query_seq};历史相关类目点击商品:{rl_cate_seq_sid};当前搜索词:{query}- 输出:{商品SID}
对模型M
2.2.4 Step4:对齐精排的SID召回
前三阶段的训练主要以用户的点击为目标进行MLE优化。但作为召回模型,在保证召回点击Hitrate的前提下,还应召回更多用户可能感兴趣的商品,以提升后续排序阶段的选择空间。因此我们使用曝光商品集合作为参考信号,通过强化学习对齐精排的排序效果。
具体而言,我们对模型
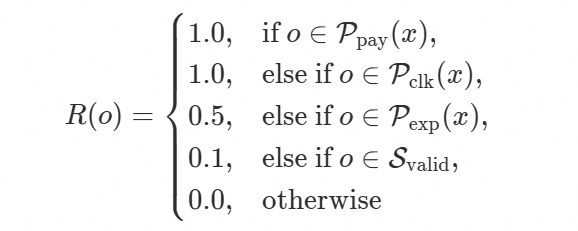
其中,P
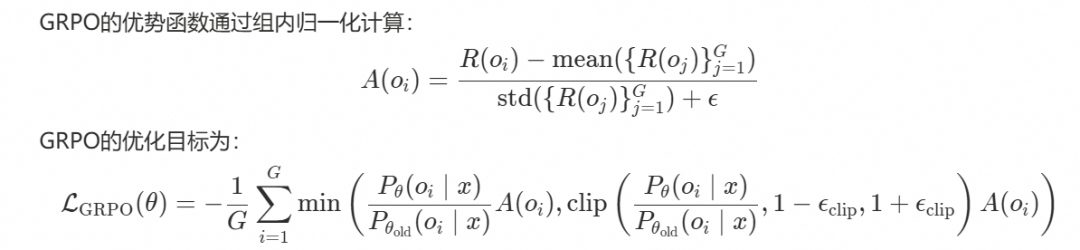
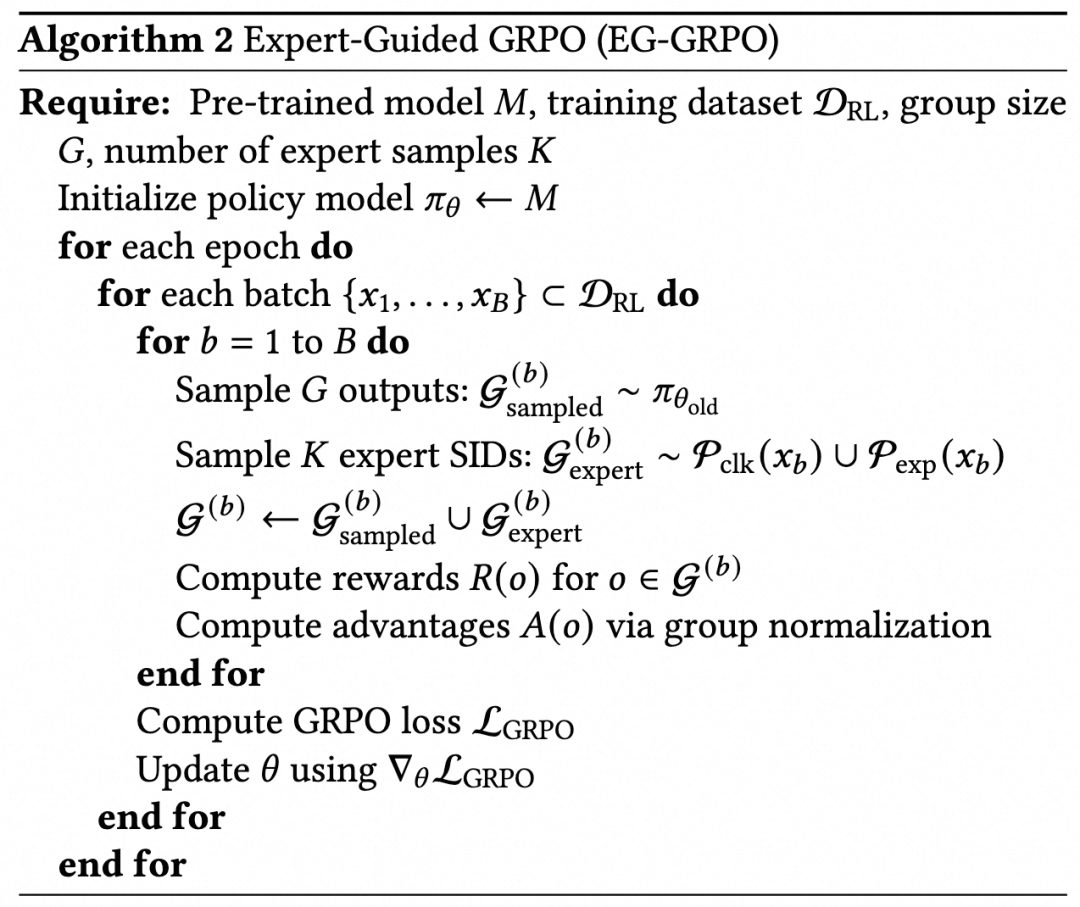
由于点击购买商品远小于曝光商品,且奖励较为稀疏,模型在探索过程中较难获得高质量信号,可能导致学习效率低下。为此,我们提出专家引导的GRPO(Expert-Guided GRPO, EG-GRPO):在每批次生成的G
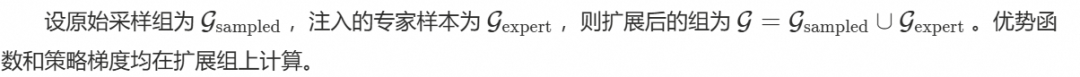
通过专家引导,模型能够在稀疏奖励环境中获得更稳定的优化信号,有效避免探索偏离。最终得到模型M
2.3 在线推理
在线推理生效阶段,组装用户Query和对应特征信息,通过模型进行Beam Search解码,生成Top-K个候选SID。随后根据预构建的SID-Item映射表,将SID列表转换为具体商品列表。由于每个SID对应一个语义相似的商品簇,且生成过程融入了用户个性化特征,最终返回的商品列表具备了相关性、多样性和个性化的综合优势,能够较好的作为一路召回补充。
2.4 商品底池筛选策略
在实验过程中,我们发现若将全量商品池作为生成式检索的底池,会召回许多相关性较差或是相关但效率较低的商品。这可能是因为我们追求的是商品语义簇,同SID下更多是相似品而非相同品,在非常细粒度的语义匹配上存在一定Gap;同时,我们将生成式召回定位为现有召回路径的补充而非完全替代。因此,我们从全量商品池中按效率分筛选出约2100万商品作为生成式召回的初始商品底池。该底池实施动态更新机制,每天根据效率分将新晋高效率商品进行推理并挂载到相应SID,保证了底池的时效性和质量。
3 实验与分析
3.1 SID实验设置
数据集:实验基于手猫搜索的真实业务数据。语义生成式召回的测试集通过从Query下用户点击的Top-10商品中按词频分层随机采样构建;个性化生成式召回则在Query基础上融入用户画像和历史行为信息。
评价指标:主要采用Hitrate作为评价指标。由于不同方案得到的SID挂载商品数量不同,我们从两个维度进行评估:(1)相同Beam Size下的Hitrate,用于衡量相同推理资源消耗下的效率;(2)按商品效率分截断取Top-1K商品后的Hitrate,模拟线上链路中的Quota截断,用于衡量相同商品召回量下的效率。
基线方法:RQ-VAE基础方法,即不使用类目约束和Query-Item对比学习的标准RQ-VAE模型。
消融实验设置:
●CQ-SID (w/o cate):移除类目约束,仅保留Query-Item对比学习;
●CQ-SID (w/o qi):移除Query-Item对比学习,仅保留类目约束;
●CQ-SID:完整的CQ-SID方法(同时包含类目约束和Query-Item对比学习)。
3.2 语义生成式召回实验结果
3.2.1 相同Beam Size下的对比
下表展示了不同方案在相同Beam Size下的Hitrate对比。
方案 | beam@1 | beam@10 | beam@100 |
RQ-VAE | 0.0598 | 0.2579 | 0.5199 |
CQ-SID (w/o cate) | 0.0680 (+13.71%) | 0.2870 (+11.28%) | 0.5578 (+7.29%) |
CQ-SID (w/o qi) | 0.0596 (-0.33%) | 0.2691 (+4.34%) | 0.5652 (+8.71%) |
CQ-SID | 0.0758 (+26.76%) | 0.3161 (+22.57%) | 0.6181 (+18.89%) |
从表可以看出,完整的CQ-SID方法相比基线RQ-VAE在不同Beam Size下均有显著提升。其中,beam@1的Hitrate提升高达26.76%,说明类目约束和Query-Item对比学习的联合作用能够有效增强SID的语义能力,使模型在生成第一个SID时就更有可能命中用户目标商品所在的语义簇。
消融实验也验证了各模块的有效性:移除类目约束后(CQ-SID w/o cate),性能仍有明显提升,说明Query-Item对比学习本身具有积极作用;移除对比学习后(CQ-SID w/o qi),在较大Beam Size下仍有一定提升,这主要得益于类目约束带来的层次化结构。两个模块同时使用时产生了协同效应,取得了最佳性能。即在相同Beam Size下的对比,验证了在相同推理计算资源下,CQ-SID能达到更好的效果。
3.2.2 Top-1K 下的对比
由于不同方案得到的SID挂载商品数量不同,直接比较相同Beam Size下的Hitrate在商品数量维度上可能存在偏差。因此,我们对每个Query生成不同数量的Beam,按商品效率分截断取Top-1K进行对比,如表2所示。
方案 | beam@25 | beam@30 | beam@35 | beam@60 | beam@65 | beam@70 |
RQ-VAE | 0.3675 | 0.3870 | 0.4016 | 0.4272 | 0.4275 | 0.4272 |
CQ-SID | 0.4370 | 0.4422 | 0.4403 | 0.4001 | 0.3911 | 0.3825 |
从表可以看出,RQ-VAE在Top-1K下Beam Size=65时达到最高Hitrate=0.4275,而CQ-SID仅需Beam Size=30即可达到最高Hitrate=0.4422。这意味着CQ-SID在Beam Size减少53.85%的情况下,Hitrate仍相对提升3.44%。这一结果对于实际应用至关重要:更小的Beam Size意味着更低的推理延迟和更少的计算资源消耗,同时还提升了召回质量。
值得注意的是,随着Beam Size的增大,Hitrate呈现先上升后下降的趋势。这一现象可从两个角度解释:一方面,由于离线实验中是直接按商品效率分截断,与线上实际召回链路存在一定差异;另一方面,这也印证了召回商品并非越多越好,在线上漏斗架构中,若后续粗排/精排链路对大量低质量候选的区分能力不足,反而可能导致优质商品被截断过滤。
3.3 个性化生成式召回实验结果
对于相同的Query,不同用户具备不同的兴趣点。排序侧已实现千人千面,召回侧也应根据不同用户召回差异化的商品,以提高召回商品质量。我们在输入Query基础上加入用户性别、用户近期交互的Query相关类目下的商品SID序列等个性化信息。
下表展示了个性化场景下不同方案在相同Beam Size下的Hitrate和Top-1K截断的对比情况。
相同Beam Size | ||||
方案 | beam@1 | beam@10 | beam@50 | beam@100 |
RQ-VAE | 0.1359 | 0.4787 | 0.6912 | 0.7513 |
CQ-SID | 0.1510 (+11.11%) | 0.5206 (+8.75%) | 0.7431 (+7.51%) | 0.8062 (+7.31%) |
Top-1K 截断 | ||||
方案 | beam@155 | beam@160 | beam@190 | beam@195 |
RQ-VAE | 0.7567 | 0.7575 | 0.7604 | 0.7607 |
CQ-SID | 0.7983 | 0.7984 | 0.7977 | 0.7975 |
加入个性化信息后,各方案的Hitrate均有明显提升,说明用户历史行为信息对于预测其意图具有重要价值。在相同Beam Size情况下,相比RQ-VAE方案,CQ-SID在个性化场景下同样保持了稳定的优势,beam@1到beam@100均有7%-11%的相对提升。
在Top-1K截断下,RQ-VAE在Beam Size=195时达到最高Hitrate=0.7607,而CQ-SID仅需Beam Size=160即可达到最高Hitrate=0.7984。这意味着CQ-SID将Beam Size减少17.95%,同时Hitrate提升4.96%。这一结果进一步验证了CQ-SID在资源效率与召回质量之间取得了更优的权衡。
3.4 目标引导的强化学习实验结果
经过上述多阶段SFT后,模型的能力已接近局部最优,为验证对齐排序结果的效果,我们在比较点击Hitrate的同时,对比曝光Hitrate,同时计算在beam@10下平均的曝光数量覆盖占比。
即:
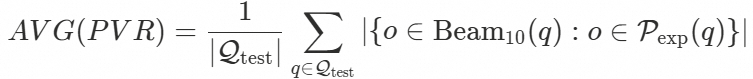
方案 | clk@1 | clk@10 | exp@1 | exp@10 | pvr@10 |
CQ-SID | 0.1510 | 0.5206 | 0.5056 | 0.8693 | 0.4371 |
+ GRPO (K=0) | 0.1519 | 0.5196 | 0.5077 | 0.8702 | 0.4360 |
+ EG-GRPO (K=2) | 0.1524 | 0.5221 | 0.5091 | 0.8703 | 0.4377 |
+ EG-GRPO (K=4) | 0.1523 | 0.5219 | 0.5087 | 0.8711 | 0.4378 |
其中K代表Group中使用多少个GroundTruth作为引导,从表中可以观察到:
仅使用标准GRPO(K=0)时,虽然在beam@1下点击Hitrate略有提升,但在beam@10下反而下降,曝光pvr也有所降低。这源于稀疏奖励导致的模式集中效应,在追求特定的精确点击和曝光目标时,导致模型将概率集中在少数高置信度的 SID 上,然而,这会降低更深层 beam 处的多样性,导致相似的候选对象重复出现,而不是探索更多语义相关的聚类。
引入专家引导后(K=2和K=4),点击Hitrate、曝光Hitrate以及曝光覆盖度均得到一致提升。这表明EG-GRPO通过注入Ground Truth作为策略梯度组中的高质量示范,有效引导模型在优化精确目标的同时保持召回广度,实现了精确性与多样性的更好平衡。
适度的专家引导即可带来收益,随着专家样本数K的增加,点击和曝光存在一定的跷跷板效应,但两者指标均优于不加入专家样本,这种多目标帕累托改进比单独最大化单一指标要困难得多,这也是EG-GRPO的主要贡献。
3.5 Case示例
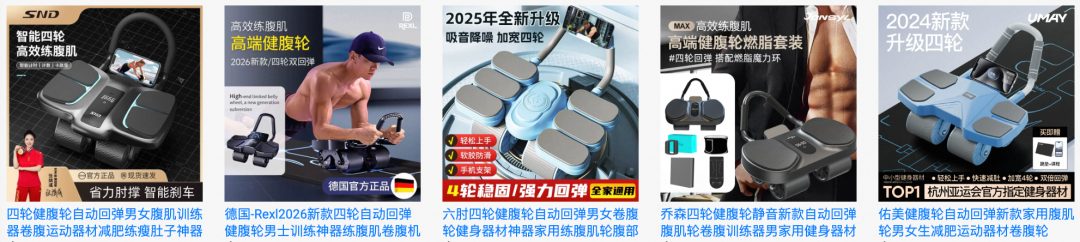
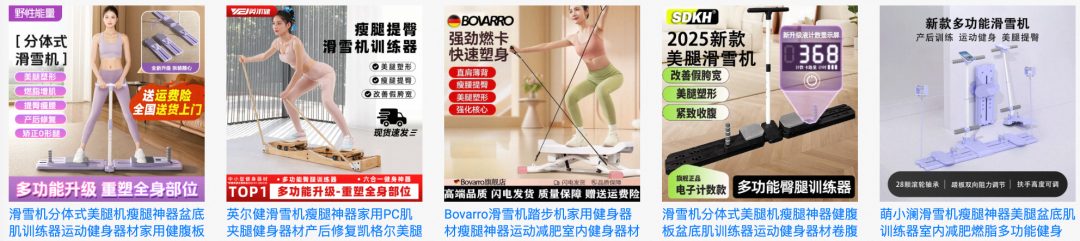
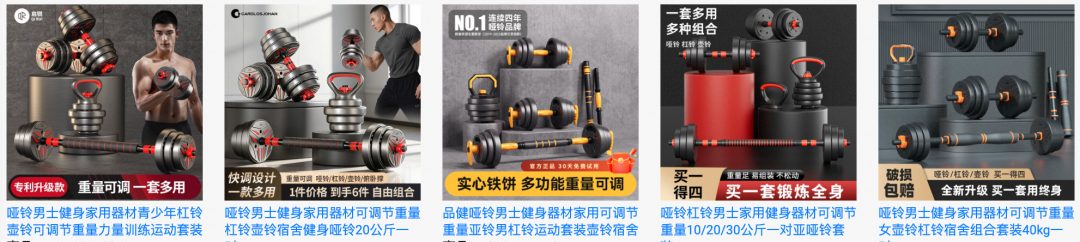
3.5.1 个性化差异离线示例:
输入 | 输出beam@1 | 商品示例 |
性别:男 历史点击商品:无 Query:健身器材 | <s1_1388><s2_456><s3_10196003> |
|
性别:女 历史点击商品:无 Query:健身器材 | <s1_1389><s2_104><s3_112> |
|
性别:男 历史点击商品:<s1_1388><s2_199><s3_10033002> Query:健身器材 | <s1_1388><s2_199><s3_10033000> |
|
3.5.2 线上曝光示例:
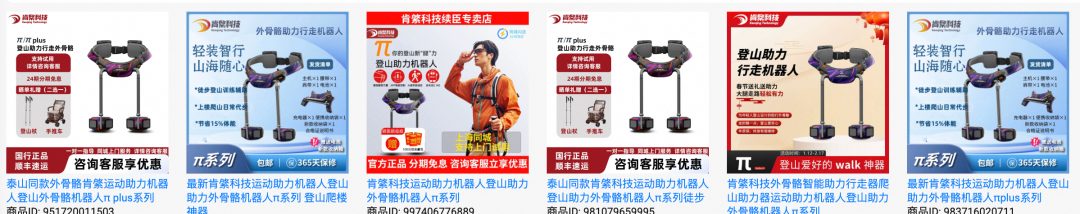
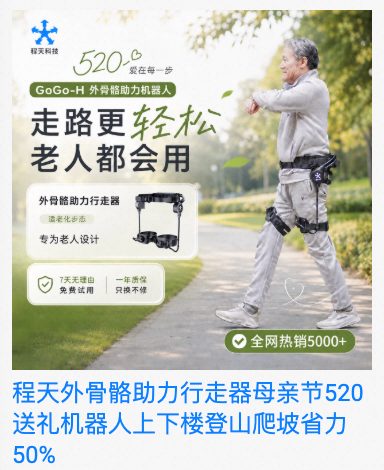
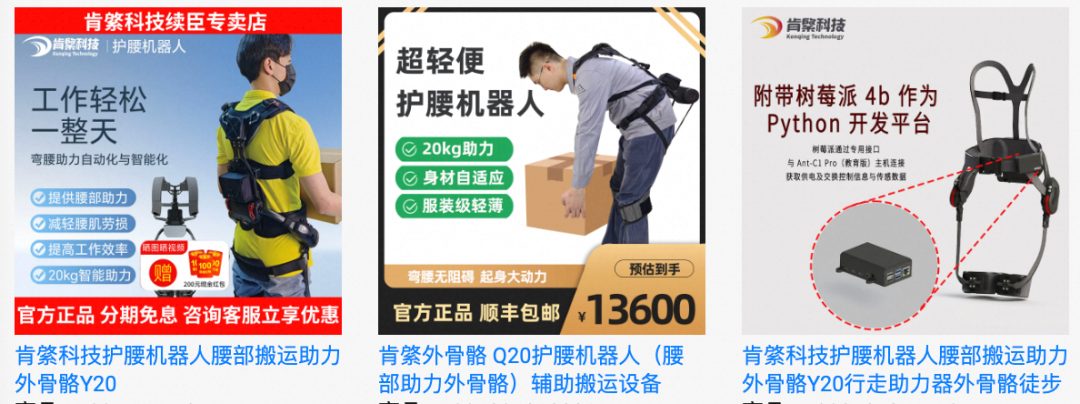
Query:外骨骼助力行走器
红色框:生成式独占。
绿色框:生成式未召回,其他路召回。
其他:均为生成式带重召回。
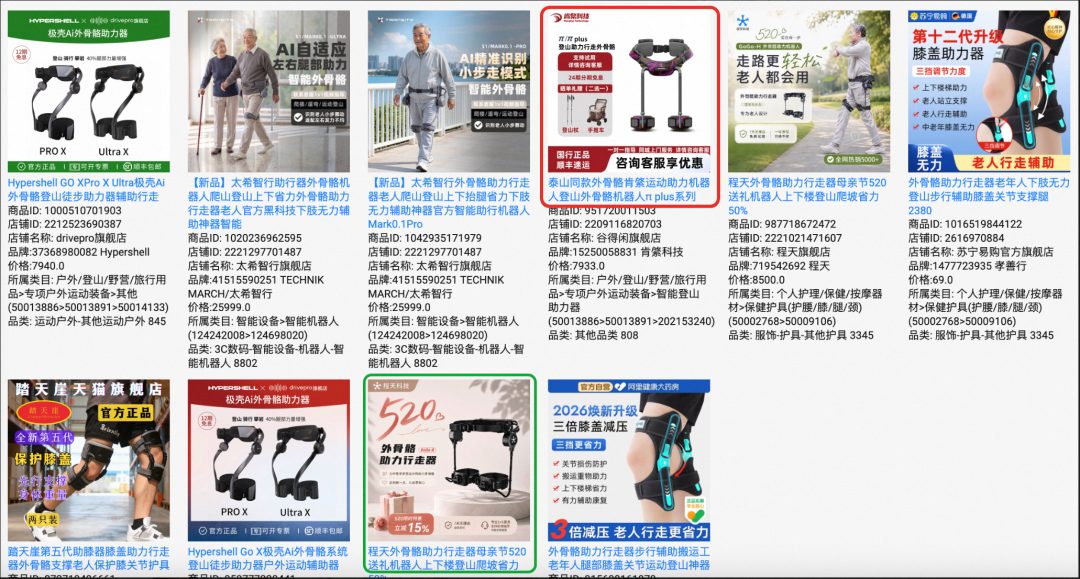
SID | 挂载商品示例 | 说明 |
0217042100000007 |
| 生成式召回曝光独占商品SID |
0217038600000138 |
| BeamSearch第一个SID |
0413017200000119 |
| BeamSearch最后一个SID |
3.6 线上实验
生成式召回上线采用动态BeamSize=[20,50,100],平均总RT约40ms,线上效果GMV+1.15%,UCTCVR+0.40%,目前已经在手猫搜索线上全量部署,生成式召回路的带重曝光占比达到50.25%,点击占比58.96%,成交占比72.63%。
4 总结与展望
本文主要介绍了LLM生成式检索在手机天猫搜索召回中的探索与实践。针对电商搜索场景的特点与挑战,我们提出了基于类目约束和对比学习的CQ-SID语义标识符构建方法以及目标引导的强化学习范式。实验结果表明,CQ-SID在语义召回和个性化召回场景中均显著优于基线方法,能够以更少的推理资源消耗实现更高的召回命中率;而目标引导的强化学习EG-GRPO,在提升点击hitrate的同时能更好的对齐排序效果,曝光更多高质量商品。
未来我们将探索搜索生成式召粗一体的范式,减少漏斗损失;以及演进至召回到曝光的端到端生成在特定垂类或长尾流量场景中的落地,逐步验证端到端生成的可行性与效果边界。
参考链接:
[1]https://arxiv.org/abs/2605.14434
千问AI平台-为Agent而生,驱动AI生产力
扫描下方二维码,直达千问AI平台体验
点击阅读原文即可体验!