北京大学 | GRIP:检索即生成——一种具有自触发信息规划的统一框架
原创 王昌坤 2026-08-19 18:30 四川
本文最重要的启示是:让模型训练时看到的序列语法与系统运行时执行的工具协议一致,工具使用才能从提示约定变成模型策略的一部分。
原文标题:Retrieval as Generation: A Unified Framework with Self-Triggered Information Planning
原文作者:Bo Li, Mingda Wang, Gexiang Fang, Shikun Zhang, Wei Ye
原文链接:https://aclanthology.org/2026.acl-long.196/
发表会议:ACL 2026
笔记作者:王昌坤@安全学术圈
主编:黄诚@安全学术圈
1 研究背景
检索增强生成(Retrieval-Augmented Generation,RAG)让大语言模型能够调用外部知识库,缓解幻觉并补充事实性知识。但"何时检索、用什么查询检索、何时停止检索"这三个关键决策,传统上由外部的控制器、启发式阈值或代理循环决定,与语言模型自身的解码状态相互分离。查询改写、证据整合与终止判断往往被拆成多个独立阶段,难以用统一目标学习,也难以判断一次检索失败究竟是过早检索、查询不准还是停止过晚。
现有动态检索方法(如 Self-RAG、DRAGIN、GainRAG)尝试根据不确定性触发新检索,但仍依赖手工阈值或外部分类器。本文关注的问题是:能否把检索控制表达为语言模型自己的序列决策,使检索与推理沿同一条轨迹协同演化。
论文提出 GRIP(Generation-guided Retrieval and Information Planning),把检索触发、查询改写与停止决策统一为单条自回归轨迹中的可训练生成动作,并在五个问答基准上超越了最强开放基线、逼近 GPT-4o。
2 核心方法与框架
2.1 自触发信息规划与控制符
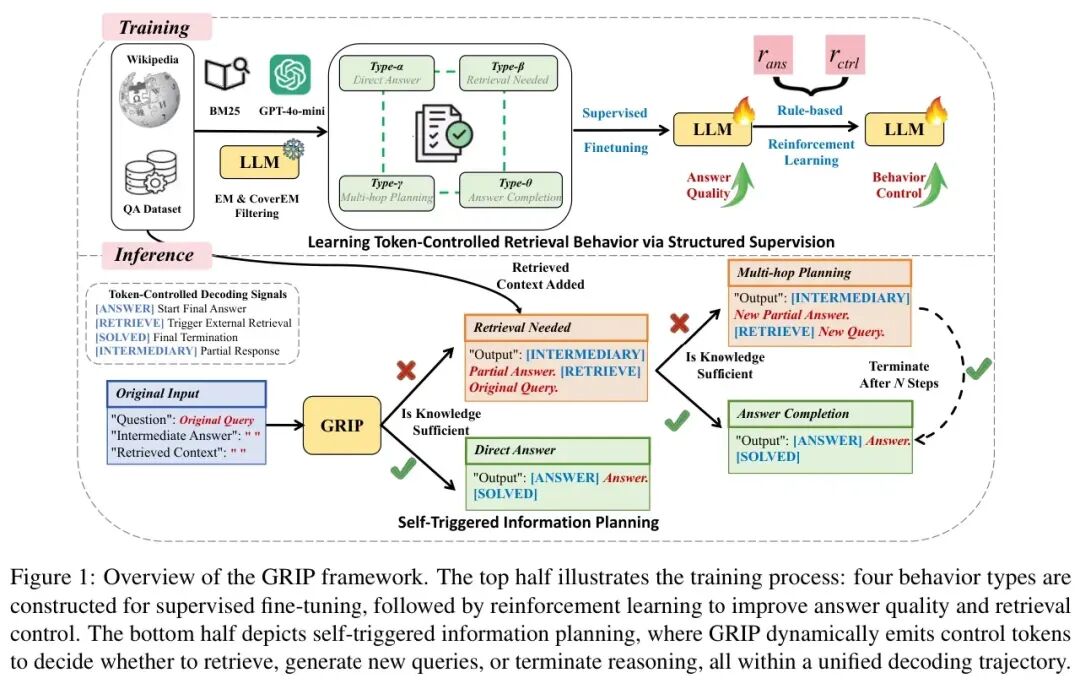
GRIP 的核心是把工具调用协议嵌入序列,而非让独立模块在模型外部读取置信度后做决定。它扩展了模型的输出空间,引入四个控制符:
[INTERMEDIARY]:开始生成当前已知的中间状态;[RETRIEVE]:请求外部检索,并在其后生成查询;[ANSWER]:开始生成最终答案;[SOLVED]:终止当前轨迹。
这样,模型在同一条自回归轨迹中自己决定何时检索、如何改写查询、何时终止,构成"自触发信息规划"循环。外部检索器仍然存在并负责从语料库返回文档,模型只负责生成调用时机与调用参数——所谓"检索即生成",指的是检索控制成为生成动作,而非把检索器内化进语言模型。
2.2 四类结构化训练轨迹
为了让模型学会"信息是否充分"这一判断,论文没有只训练最终答案,而是根据内部知识与外部证据是否充分,构造了四类行为轨迹:
类型 | 信息状态 | 目标轨迹 | 教授的能力 |
|---|---|---|---|
Type-α | 内部知识足够 | [ANSWER] → [SOLVED] | 不检索即可直接回答 |
Type-β | 只有部分或含噪答案 | [INTERMEDIARY] → [RETRIEVE] | 识别信息不足并发起检索 |
Type-γ | 内部知识与基础检索都不足 | 多轮中间状态与新查询 | 面向剩余缺口改写查询 |
Type-θ | 检索材料覆盖答案但仍需筛选 | 从中间状态转向最终回答 | 在噪声证据中完成答案压缩 |
其中 Type-γ 使用 GPT-4o-mini 根据当前问题、中间答案和已有文档生成更有针对性的后续查询,属于有监督的行为轨迹合成。
2.3 两阶段训练
训练分两阶段:
监督微调(SFT):用 4 万条样本全参数微调,标准自回归交叉熵,学习同时包含自然语言与控制符的目标序列,建立基本控制语法。
规则奖励强化学习(RL):用 5000 条样本基于 DAPO 训练,总奖励为答案忠实度奖励与控制准确度奖励之和。答案奖励用 BLEU 衡量,控制奖励奖励正确的控制符模式。
实验显示,强化学习的主要作用不是创造问答能力,而是减少获得充分证据后的冗余检索——去掉 RL 后平均检索次数从 1.24 升至 1.60,而最终分数仅微降。
3 实验设计与主要结果
3.1 数据集与主结果
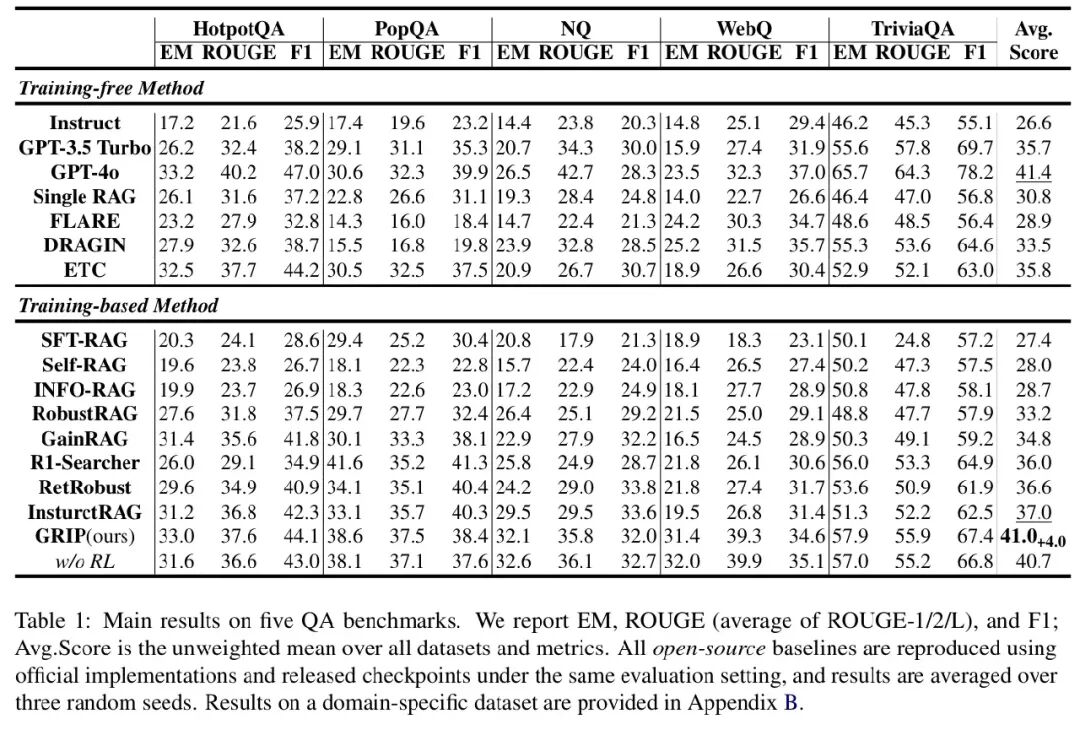
论文在五个知识密集型问答基准上评测:HotpotQA(多跳推理)、PopQA(长尾实体)、Natural Questions 与 WebQuestions(开放域事实问答)、TriviaQA(复杂事实问题),另有附录的 BioASQ 用于领域迁移。开放模型统一使用 LLaMA3-8B 骨干、维基百科语料、BM25 检索器与 top-3 段落。
主结果显示,GRIP 取得平均分 41.0,比最佳开放基线 InstructRAG 的 37.0 高 4.0 分,与 GPT-4o 的 41.4 仅差 0.4 分。
方法 | 类型 | 平均分 |
|---|---|---|
单次检索基线 | 免训练 | 30.8 |
GainRAG | 训练式动态检索 | 34.8 |
R1-Searcher | 深度搜索 | 36.0 |
RetRobust | 鲁棒检索增强 | 36.6 |
InstructRAG | 显式去噪推理 | 37.0 |
GRIP | 控制符规划 | 41.0 |
GPT-4o | 闭源参考 | 41.4 |
不过"接近 GPT-4o"只适用于这组问答协议与论文定义的等权平均指标,不等于通用能力、推理成本或服务体验已经等价。
3.2 动态检索与查询改写
GRIP 的检索深度具有样本与任务自适应性:多跳或长尾问题上检索更多,可内部回答的问题上检索更少。规则奖励强化学习把平均检索次数从 1.60 降至 1.24(约 22.5%),主要体现为"学会更早停止"。
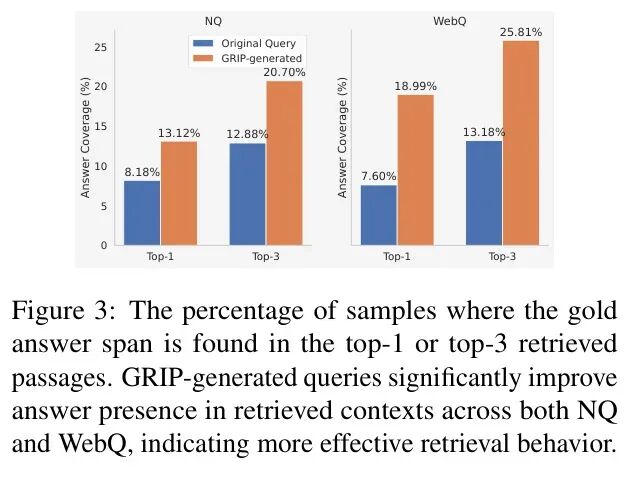
查询改写实验提供了机制层面的证据:在 NQ 与 WebQ 上,GRIP 生成的查询显著提升了答案覆盖率——NQ 的 top-1 覆盖率从 8.18% 升至 13.12%,WebQ 的 top-1 覆盖率从 7.60% 升至 18.99%。这说明中间推理驱动的查询改写确实让 BM25 更容易找到包含答案的段落。
3.3 预算外推与消融
推理时允许的最大检索预算从 3 增至 10,平均分从 41.0 增至 41.8,而实际平均检索次数仅从 1.24 增至 1.62,说明模型没有完全记住固定步数,但收益明显递减。
消融实验进一步验证了方法的稳健性:教师替换(GPT-4o-mini 换 Qwen3-32B 仍有 40.3)、检索器替换(BM25/DPR/混合均稳定领先)、骨干替换(Qwen2.5-7B 上趋势一致)都表明框架不依赖闭源教师或特定检索器;领域测试在 BioASQ 上取得 54.8 的 ROUGE 与 84.4 的 F1。
4 总结
本文把大语言模型调用外部检索器的三个关键决策——何时调用、用什么查询调用、何时停止调用——压缩成统一的生成语法,用四类行为轨迹监督"信息充分性判断",再用规则奖励强化学习细化停止行为。实验表明 GRIP 在五个问答基准上以 41.0 的平均分超越最强开放基线、逼近 GPT-4o,同时把平均检索次数压到 1.24。
论文的主要局限在于任务范围仍集中在维基百科上的短答案问答,行为标签依赖人工规则与标准答案信息,奖励偏向表面匹配(BLEU)而非事实一致性。但这些问题并未削弱核心价值。本文最重要的启示是:让模型训练时看到的序列语法与系统运行时执行的工具协议一致,工具使用才能从提示约定变成模型策略的一部分。
5 主要贡献
提出"检索即生成"范式:将检索触发、查询改写与停止判断统一为单条自回归轨迹中的可训练生成动作,消除外部控制器与模型解码状态的割裂。
用四类行为轨迹监督信息充分性判断:把样本组织为直接回答、需要检索、多跳规划和答案完成四类,使"何时调用工具"本身获得明确监督。
分离答案质量与行为控制优化:SFT 先建立控制语法,规则奖励强化学习再同时优化答案忠实度与控制符准确度,实验证明 RL 的主要作用在于减少冗余检索而非创造问答能力。
从行为层面验证动态检索:除主结果外,通过检索次数、查询覆盖率、预算外推、教师/检索器/骨干替换等分析,证明性能增益确实来自可适应的检索规划。
相关资源:
GRIP 代码仓库:https://github.com/WisdomShell/GRIP
GRIP 项目主页:https://wisdomshell.github.io/GRIP/
GRIP 数据集与模型:https://huggingface.co/collections/WisdomShell/grip
安全学术圈招募队友-ing
有兴趣加入学术圈的请联系 secdr#qq.com