苹果Webkit安全机制分析
原创 wzt 2024-03-13 20:58 上海
本文详细分析了苹果Webkit使用到的6个安全功能:
- Jit write protection- Jit pac- Gigacage- JitCage- Isolate Heap- StructureID Protection
1 JIT WRITE Protection
Webkit中的JavaScriptCore(JSC)引擎在使用JIT技术时,将jit存放的内存做了写和执行权限分离的保护,用到了两个技术:APRR和Separated WX Heap。
1.1 APRR
Apple自研芯片新增了一个快速权限映射机制APRR,它将arm公版中的页表中原本的8个权限组合扩展为了16个,并提供了一些列新的寄存器来配合这个机制,可以让应用程序不用使用Mmap/mprotect系统调用,就能设置页表的权限,不仅提高了访问页表的速度,还能将一个页表设置为只执行权限,这使得基于这一技术的webkit从性能和安全都得到了极大的提升。关于APRR可以参考博主ios系列中关于PPL技术的分析。
苹果公司将APRR做了一些封装提供给app使用,JSC在初始化中会有如下的一些调用:
JavaScriptCore/jit/ExecutableAllocator.cppfastJITPermissionsIsSupported = !!pthread_jit_write_protect_supported_np();fastJITPermissionsIsSupported = !!os_thread_self_restrict_rwx_is_supported();
苹果公司在pthread中提供封装了对jit操作的一些辅助函数,pthread_jit_write_protect_*系列函数最终会通过msr指令调用aprr机制。
系统在启动时会自动将每个进程的每个线程内存设置为不可写只执行状态,注意是每个线程都能独立的设置只执行权限, 如果一个线程与另一个线程共享一块内存,其中一个线程打开了写权限,对另一个线程来讲仍然是只执行的。对于JIT来讲,需要先调用pthread_jit_write_protect_np(false)关闭只执行,打开写权限,写入JIT code后,在调用pthread_jit_write_protect_np(true)恢复执行权限。
我们看下libpthread的相关代码:
voidpthread_jit_write_protect_np(int enable){if (!os_thread_self_restrict_rwx_is_supported()) {return;}if (enable) {os_thread_self_restrict_rwx_to_rx();} else {os_thread_self_restrict_rwx_to_rw();}// Validate _after_ toggling.union _pthread_jit_config_u *config = &_pthread_jit_config;if (config->allowlist_enabled) {if (!enable) {os_thread_self_restrict_rwx_to_rx();}PTHREAD_CLIENT_CRASH(0,"pthread_jit_write_protect_np() disallowed by allowlist");}}
实际上还是使用了os_thread_self_restrict_rwx_to_rx系统库提供的c接口。
可以看到使用pthread_jit_write_protect_np接口可以关闭只执行内存,会带来一些安全问题,苹果的做法是增加了一些entitlement,只对特定的app进行授权。
com.apple.security.cs.allow-jitcom.apple.security.cs.jit-write-allowlistcom.apple.security.cs.jit-write-allowlist-freeze-late
请参考:
Porting Just-In-Time Compilers to Apple Silicon | Apple Developer Documentation
PTHREAD_JIT_WRITE_PROTECT_NP(3) (keith.github.io)
pthread.c (apple.com)
1.2 Separated WX Heap
当硬件不支持APRR时, JSC使用了一种叫做Separated wx heap的技术,首先我们得看下JSC是如何初始化JIT用到的内存的:
computeCanUseJIT->canUseAssembler->enableAssembler->ExecutableAllocator::initializeUnderlyingAllocator->initializeJITPageReservationJavaScriptCore/jit/ExecutableAllocator.cpp:static ALWAYS_INLINE JITReservation initializeJITPageReservation(){reservation.size = fixedExecutableMemoryPoolSize;
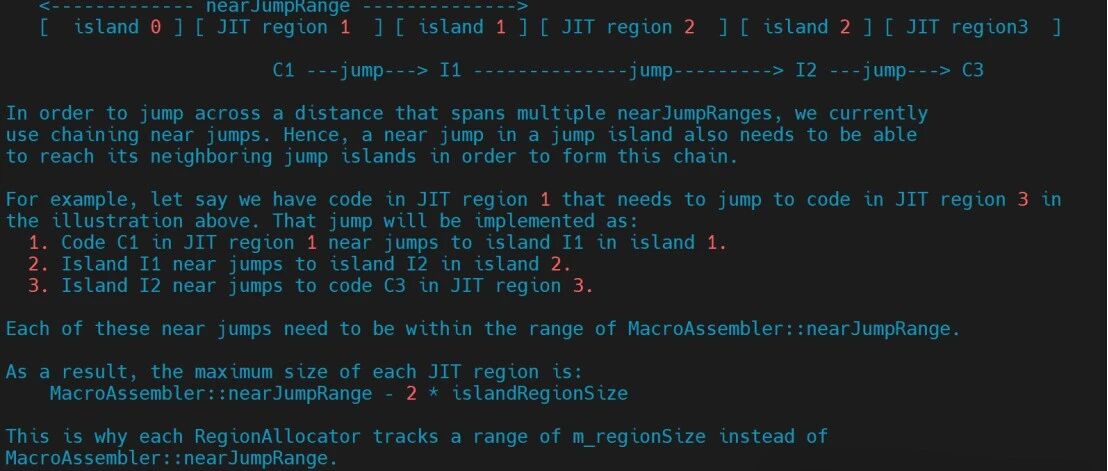
首先设置jit的内存大小,对于arm64默认使用128M内存,因为arm Near jump指令最大的寻址范围即为128M,但是JSC还使用了一种叫做ISLAND的技术,可以寻址512M内存,这个后续在展开讲。
auto tryCreatePageReservation = [] (size_t reservationSize) {if (Options::useJITCage() && JSC_ALLOW_JIT_CAGE_SPECIFIC_RESERVATION)return PageReservation::tryReserve(reservationSize, OSAllocator::JSJITCodePages, EXECUTABLE_POOL_WRITABLE, true, Options::useJITCage());return PageReservation::tryReserveWithGuardPages(reservationSize, OSAllocator::JSJITCodePages, EXECUTABLE_POOL_WRITABLE, true, false);};reservation.pageReservation = tryCreatePageReservation(reservation.size);
调用PageReservation::tryReserve进一步调用OSAllocator::tryReserveUncommitted,而后调用mmap传递MAP_JIT参数分配内存。MAP_JIT是苹果公司给mmap系统调用新增的一个参数,用来服务JIT。
xnu-xnu-8020.140.41\bsd\sys\mman.h:#define MAP_JIT 0x0800 /* Allocate a region that will be used for JIT purposes */
对于JIT内存,xnu内核限制住每个进程仅有一块内存用来存放JIT代码。
Osfmk\vm\vm_map.ckern_return_tvm_map_locate_space(vm_map_t map,vm_map_size_t size,vm_map_offset_t mask,vm_map_kernel_flags_t vmk_flags,vm_map_offset_t *start_inout,vm_map_entry_t *entry_out){if (vmk_flags.vmkf_map_jit) {if (map->jit_entry_exists &&!VM_MAP_POLICY_ALLOW_MULTIPLE_JIT(map)) {return KERN_INVALID_ARGUMENT;}}
回到initializeJITPageReservation:
if (!g_jscConfig.useFastJITPermissions) {// First page of our JIT allocation is reserved.ASSERT(reservation.size >= executablePageSize() * 2);reservation.base = (void*)((uintptr_t)(reservation.base) + executablePageSize());reservation.size -= executablePageSize();initializeSeparatedWXHeaps(reservation.pageReservation.base(), executablePageSize(), reservation.base, reservation.size);}
如果不支持APRR,就调用initializeSeparatedWXHeaps初始化刚申请过的JIT内存。在这之前JIT内存最开始的一个PAGE保留,后面设置为只执行权限。
static ALWAYS_INLINE void initializeSeparatedWXHeaps(void* stubBase, size_t stubSize, void* jitBase, size_t jitSize){kern_return_t ret = mach_vm_remap(mach_task_self(), &writableAddr, jitSize, 0,remapFlags,mach_task_self(), (mach_vm_address_t)jitBase, FALSE,&cur, &max, VM_INHERIT_DEFAULT);
使用mach_vm_remap函数将jit内存重映射到一块新的内存中,地址由writeableAddr指向,注意原来的jit内存仍旧是保留的,这样就会有两块虚拟内存指向了同一块物理内存。
MacroAssemblerCodeRef<JITThunkPtrTag> writeThunk = jitWriteThunkGenerator(reinterpret_cast<void*>(writableAddr), stubBase, stubSize); 调用jitWriteThunkGenerator函数用来设置一个优化过的memcpy函数:
static ALWAYS_INLINE MacroAssemblerCodeRef<JITThunkPtrTag> jitWriteThunkGenerator(void* writableAddr, void* stubBase, size_t stubSize){MacroAssembler jit;jit.tagReturnAddress();jit.move(MacroAssembler::TrustedImmPtr(writableAddr), x7);jit.addPtr(x7, x0);
这段jit code是把writableAddr传递给x7寄存器,然后与x0相加,这迫使memcpy函数的目的地址始终在writableAddr内存范围内。
jit.move(x0, x3);MacroAssembler::Jump smallCopy = jit.branch64(MacroAssembler::Below, x2, MacroAssembler::TrustedImm64(64));jit.add64(TrustedImm32(32), x3);jit.and64(TrustedImm32(-32), x3);jit.loadPair64(x1, x12, x13);jit.loadPair64(x1, TrustedImm32(16), x14, x15);jit.sub64(x3, x0, x5);jit.addPtr(x5, x1);jit.loadPair64(x1, x8, x9);jit.loadPair64(x1, TrustedImm32(16), x10, x11);jit.add64(TrustedImm32(32), x1);jit.sub64(x5, x2);jit.storePair64(x12, x13, x0);jit.storePair64(x14, x15, x0, TrustedImm32(16));MacroAssembler::Jump cleanup = jit.branchSub64(MacroAssembler::BelowOrEqual, TrustedImm32(64), x2);MacroAssembler::Label copyLoop = jit.label();jit.storePair64WithNonTemporalAccess(x8, x9, x3);jit.storePair64WithNonTemporalAccess(x10, x11, x3, TrustedImm32(16));jit.add64(TrustedImm32(32), x3);jit.loadPair64WithNonTemporalAccess(x1, x8, x9);jit.loadPair64WithNonTemporalAccess(x1, TrustedImm32(16), x10, x11);jit.add64(TrustedImm32(32), x1);jit.branchSub64(MacroAssembler::Above, TrustedImm32(32), x2).linkTo(copyLoop, &jit);cleanup.link(&jit);jit.add64(x2, x1);jit.loadPair64(x1, x12, x13);jit.loadPair64(x1, TrustedImm32(16), x14, x15);jit.storePair64(x8, x9, x3);jit.storePair64(x10, x11, x3, TrustedImm32(16));jit.addPtr(x2, x3);jit.storePair64(x12, x13, x3, TrustedImm32(32));jit.storePair64(x14, x15, x3, TrustedImm32(48));jit.ret();MacroAssembler::Label local0 = jit.label();jit.load64(MacroAssembler::PostIndexAddress(x1, 8), x6);jit.store64(x6, MacroAssembler::PostIndexAddress(x3, 8));smallCopy.link(&jit);jit.branchSub64(MacroAssembler::AboveOrEqual, TrustedImm32(8), x2).linkTo(local0, &jit);MacroAssembler::Jump local2 = jit.branchAdd64(MacroAssembler::Equal, TrustedImm32(8), x2);MacroAssembler::Label local1 = jit.label();jit.load8(x1, PostIndex(1), x6);jit.store8(x6, x3, PostIndex(1));jit.branchSub64(MacroAssembler::NotEqual, TrustedImm32(1), x2).linkTo(local1, &jit);local2.link(&jit);jit.ret();
上面代码生成了memcpy函数其他的代码。
auto stubBaseCodePtr = CodePtr<LinkBufferPtrTag>(tagCodePtr<LinkBufferPtrTag>(stubBase));LinkBuffer linkBuffer(jit, stubBaseCodePtr, stubSize, LinkBuffer::Profile::Thunk);
将这段jit code链接到原始jit内存中保留的第一个只执行PAGE内存内。
回到initializeSeparatedWXHeaps:
// Prevent reading the write thunk code.result = vm_protect(mach_task_self(), reinterpret_cast<vm_address_t>(stubBase), stubSize, true, VM_PROT_EXECUTE);RELEASE_ASSERT(!result);
对原始jit内存的第一个PAGE设置为只执行权限。
// Prevent writing into the executable JIT mapping.result = vm_protect(mach_task_self(), reinterpret_cast<vm_address_t>(jitBase), jitSize, true, VM_PROT_READ | VM_PROT_EXECUTE);RELEASE_ASSERT(!result);
对原始jit只保留读和执行权限。
// Prevent execution in the writable JIT mapping.result = vm_protect(mach_task_self(), static_cast<vm_address_t>(writableAddr), jitSize, true, VM_PROT_READ | VM_PROT_WRITE);RELEASE_ASSERT(!result);
对第二块jit内存设置为读和写权限,当jit要生成jit code时会调用performJITMemcpy将jit code写入这个内存区域。而jit返回给浏览器的那个jit内存是原始的jit只执行内存,这样攻击者实际就猜不出来可写的jit code内存在哪,因为那块内存是随机化生成的,并没有暴露给浏览器。
前面提到jit内存默认设置为128M,这是arm near jump的最大范围,如何让jit使用更多的内存,JSC使用了一种叫做ISLAND的技术,JSC的注释中很清晰的表达了它的架构:
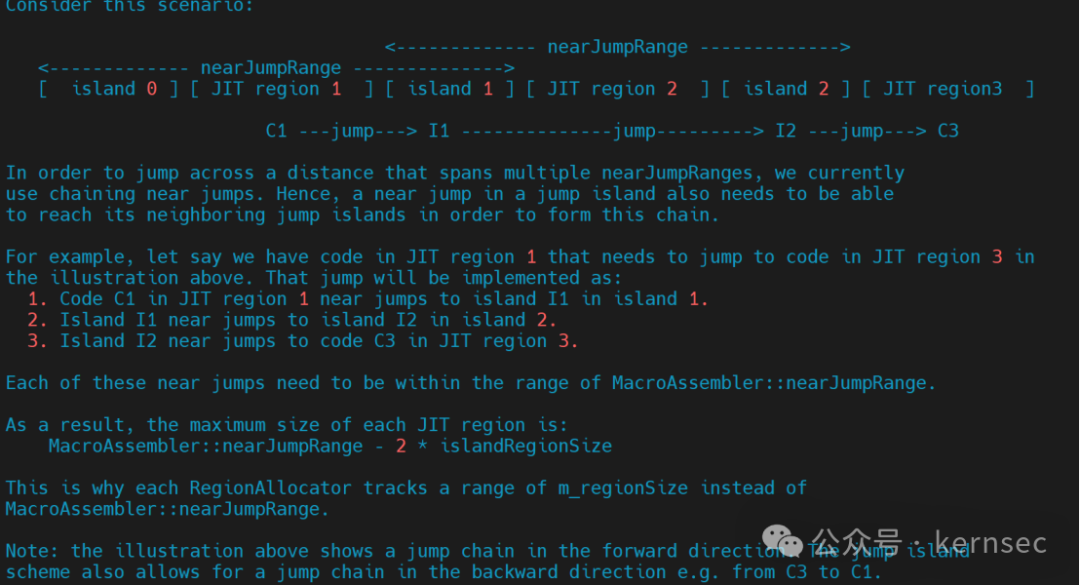
通过一个个“小岛”间接的跳转到更远的地址去,使得jit能支持512M的内存。
2 JIT PAC支持
Webkit不仅二进制本身使用了pac技术,还对JIT code也使能了pac技术。
./WTF/wtf/PtrTag.htemplate<PtrTag tag, typename PtrType>ALWAYS_INLINE static PtrType tagNativeCodePtrImpl(PtrType ptr){if constexpr (tag == NoPtrTag)return ptr;if constexpr (tag == CFunctionPtrTag)return ptrauth_sign_unauthenticated(ptr, ptrauth_key_function_pointer, 0);return ptrauth_sign_unauthenticated(ptr, ptrauth_key_process_dependent_code, tag);return ptr;}
wekit对指针做了标签分类:
enum PtrTag : uintptr_t {NoPtrTag,CFunctionPtrTag,};
可以看到只对函数指针进行pac签名。
template<PtrTag tag, typename PtrType>ALWAYS_INLINE static PtrType untagNativeCodePtrImpl(PtrType ptr){if constexpr (tag == NoPtrTag)return ptr;if constexpr (tag == CFunctionPtrTag)return __builtin_ptrauth_auth(ptr, ptrauth_key_function_pointer, 0);return __builtin_ptrauth_auth(ptr, ptrauth_key_process_dependent_code, tag);return ptr;}
函数指针使用IA key。
JavaScriptCore/assembler/MacroAssemblerARM64E.hclass MacroAssemblerARM64E : public MacroAssemblerARM64 {public:static constexpr unsigned numberOfPointerBits = sizeof(void*) * CHAR_BIT;static constexpr unsigned maxNumberOfAllowedPACBits = numberOfPointerBits - OS_CONSTANT(EFFECTIVE_ADDRESS_WIDTH);static constexpr uintptr_t nonPACBitsMask = (1ull << (numberOfPointerBits - maxNumberOfAllowedPACBits)) - 1;
定义了pac使用的bit数。
ALWAYS_INLINE void tagPtr(RegisterID tag, RegisterID target){if (target == ARM64Registers::lr && tag == ARM64Registers::sp) {m_assembler.pacibsp();return;}m_assembler.pacib(target, tag);}ALWAYS_INLINE void untagPtr(PtrTag tag, RegisterID target){auto tagGPR = getCachedDataTempRegisterIDAndInvalidate();move(TrustedImm64(tag), tagGPR);m_assembler.autib(target, tagGPR);}
JSC使用了以下pac指令:pac*、aut*、xpac*、reta*、bra*/blra*。
同时苹果公司为了防止pac被绕过的问题,对webkit以及xnu内核都使用了-fptrauth-auth-traps编译选项,以下代码选自ios16 kernelcache:
AUTIA X16, X17PACIZA X16MOV X11, X16XPACI X11CMP X11, X9loc_FFFFFFF007D3E824B loc_FFFFFFF007D3E83C
autia检查完毕后,会把pac去掉,然后使用xpaci和cmp指令在一次做了对比,防止autia出错。
3 GigaCage
JS语言中的变量会在JS引擎中抽象为特定的c语言对象,如果引擎出现漏洞,那么就可通过js语言操纵这些c语言对象,是常见的JS引擎漏洞来源。Webkit为了缓解这种漏洞攻击,对Webkit使用的Heap做了很多安全加固,GigaCage就是其中一个,用来将c语言对象限制在一个4G大小的cage中,cage中的对象使用32位bit的索引来引用。GigaCage依附于bmalloc内存分配器,webkit中的各种组件都可以使用。它
它对对象做了如下区分:
enum Kind {Primitive,JSValue,NumberOfKinds};
当前只分为Primitive和JSValue两大类,未来最多会支持21个cage。
下面看下它是如何初始化建立Cage区域的:
bmalloc/bmalloc/Gigacage.cppvoid ensureGigacage(){Kind shuffledKinds[NumberOfKinds];for (unsigned i = 0; i < NumberOfKinds; ++i)shuffledKinds[i] = static_cast<Kind>(i);
初始化每个种类的cage数组。
uint64_t random;cryptoRandom(reinterpret_cast<unsigned char*>(&random), sizeof(random));for (unsigned i = NumberOfKinds; i--;) {unsigned limit = i + 1;unsigned j = static_cast<unsigned>(random % limit);random /= limit;std::swap(shuffledKinds[i], shuffledKinds[j]);}
将cage数组打乱处理,防止黑客猜测到特定种类cage的索引。
for (Kind kind : shuffledKinds) {totalSize = bump(kind, alignTo(kind, totalSize));totalSize += runwaySize(kind);maxAlignment = std::max(maxAlignment, alignment(kind));}
计算所有cage需要的内存大小,每个cage后面加一个32G的guard,因为对象采用32位大小做索引,每位共8个bit,因此最大寻址范围就位4G*8=32G, 即使利用漏洞也只能读取到guard范围的内存。
void* base = tryVMAllocate(maxAlignment, totalSize, VMTag::JSGigacage);
分配cage内存。
size_t nextCage = 0;
接着从这块大内存中继续划分每个cage的内存范围。
for (Kind kind : shuffledKinds) {nextCage = alignTo(kind, nextCage);void* gigacageBasePtr = reinterpret_cast<char*>(base) + nextCage;g_gigacageConfig.setBasePtr(kind, gigacageBasePtr);nextCage = bump(kind, nextCage);uint64_t random[2];cryptoRandom(reinterpret_cast<unsigned char*>(random), sizeof(random));
随机产生了两个64bit随机数。
size_t gigacageSize = maxSize(kind);size_t size = roundDownToMultipleOf(vmPageSize(), gigacageSize - (random[0] % maximumCageSizeReductionForSlide));
第一个随机数用来生成cage的大小。maximumCageSizeReductionForSlide被设置为1G或4G大小。
g_gigacageConfig.setAllocSize(kind, size);
g_gigacageConfig.basePtrs数组保存了每个cage的起始地址。
ptrdiff_t offset = roundDownToMultipleOf(vmPageSize(), random[1] % (gigacageSize - size));void* thisBase = reinterpret_cast<unsigned char*>(gigacageBasePtr) + offset;g_gigacageConfig.setAllocBasePtr(kind, thisBase);
第二个随机数用于计算cage的起始地址,可以看到两个cage之间除了32G的guard内存,还有一个随机化过的起始地址,这样猜测使猜测一个cage的地址更加困难。
GigaCage定义了caged接口用于访问一个指针:
bmalloc/bmalloc/Gigacage.htemplate<typename T>BINLINE T* caged(Kind kind, T* ptr){BASSERT(ptr);if (!isEnabled(kind))return ptr;void* gigacageBasePtr = basePtr(kind);return reinterpret_cast<T*>(reinterpret_cast<uintptr_t>(gigacageBasePtr) + (reinterpret_cast<uintptr_t>(ptr) & mask(kind)));}
根据kind提取cage基地址,在加上一个mask后的32位索引。
以下对象都使用了cage进行防护:
./JavaScriptCore/runtime/ArrayBuffer.h: using DataType = CagedPtr<Gigacage::Primitive, void, tagCagedPtr>;./JavaScriptCore/runtime/JSBigInt.h: CagedBarrierPtr<Gigacage::Primitive, Digit, tagCagedPtr> m_data;./JavaScriptCore/runtime/BufferMemoryHandle.h: using CagedMemory = CagedPtr<Gigacage::Primitive, void, tagCagedPtr>;./JavaScriptCore/runtime/ArrayBufferView.h: using BaseAddress = CagedPtr<Gigacage::Primitive, void, tagCagedPtr>;./JavaScriptCore/runtime/JSArrayBufferView.h: using VectorPtr = CagedBarrierPtr<Gigacage::Primitive, void, tagCagedPtr>;
4 jitcage
苹果为了增强JIT的安全防护能力,又增加了一个叫做jitcage的防护技术,目前能google到的关于它的分析,只有synacktiv的安全研究员在2022年的一篇paper中有相对详细的介绍《attacking safari in 2022》。
类似于aprr,苹果公司又增加了新的硬件安全机制来保护特定的jit区域,按照synacktiv的paper,在此区域里的jit code不能执行以下指令:ret、br/blr/bl、svc、mrs/msr。由于笔者只通过webkit的源码和部分二进制做了静态分析,以上synacktiv给出的结论应该是动态调试的推论,笔者无法验证。
Jitcage需要苹果公司授权一个特殊的entitlement:"com.apple.private.verified-jit",这是一个未公开的entitlement,我们可以在javascriptcore的源码中看到有对它的引用:
./JavaScriptCore/runtime/Options.cppSUPPRESS_ASAN bool canUseJITCage(){if (JSC_FORCE_USE_JIT_CAGE)return true;return JSC_JIT_CAGE_VERSION() && WTF::processHasEntitlement("com.apple.private.verified-jit"_s);}
4.1 jitcage内存初始化
Jitcage的一个功能是修改了kernel中的mmap接口,当在某一条件下,它会申请一块特殊的内存,这块特殊的内存如上所述,会得到硬件的保护。
__int64 __fastcall mmap(proc *a1, __int64 a2, _QWORD *a3){if ( !(unsigned int)IOTaskHasEntitlement(0, "com.apple.private.verified-jit") )goto LABEL_196;v73 = sub_FFFFFFF007EC3B64(v5, &v102, (__int64)ctxa, v66, v89, v42, v70, v101);}
首先要判断当前进程是否有"com.apple.private.verified-jit"这个entitlement。
__int64 __fastcall sub_FFFFFFF007EC3B64(__int64 a1,__int64 *a2,__int64 a3,__int64 a4,int a5,__int64 a6,int a7,unsigned int a8){v10 = vm_map_enter_mem_object( // kern_return_t// vm_map_enter_mem_object(// vm_map_t target_map,// vm_map_offset_t *address,// vm_map_size_t initial_size,// vm_map_offset_t mask,// int flags,// vm_map_kernel_flags_t vmk_flags,// vm_tag_t tag,// ipc_port_t port,// vm_object_offset_t offset,// boolean_t copy,// vm_prot_t cur_protection,// vm_prot_t max_protection,// vm_inherit_t inheritance)a1,&v31,v9,0LL,a4 & 0xFFFFBFFE | 0x4000,a5 & 0xFFFFFEEE | 0x111LL,a6,0LL,0LL,v28,a8 | 0x100000000LL,0LL,0);if ( !(_DWORD)v10 ){v26 = v31;*(_QWORD *)(v30 + 0x348) = v31 & 0x1FFFFFE000000LL | (7 - (unsigned __int8)__clz(v9 - 1)) & 0xF;*(_QWORD *)(v30 + 0x350) = 0x100C5BLL; // 1maddress[2] = v30;v33 = 0LL;address[1] = (mach_vm_address_t)enable_jitbox;sub_FFFFFFF007EA4720(4, &v33);*a2 = v26;return v10;}
首先调用vm_map_enter_mem_object分配一块内存,然后将地址存入current thread的0x348地址,0x350限制了这块内存的大小为1M。内核会在某一时刻调用enable_jitbox函数。
void __fastcall enable_jitbox(__int64 a1){__int64 v2; // x0__int64 v3; // x8unsigned __int64 StatusReg; // x9v2 = current_task();if ( v2 == a1 ){v3 = *(_QWORD *)(v2 + 848);StatusReg = _ReadStatusReg(ARM64_SYSREG(3, 0, 13, 0, 4));*)(*(_QWORD *)(StatusReg + 336) + 536LL) = v3;*)(*(_QWORD *)(StatusReg + 336) + 528LL) = *(_QWORD *)(v2 + 840);4, 15, 15, 4), *(_QWORD *)(v2 + 848));4, 15, 15, 1), *(_QWORD *)(v2 + 840));__isb(0xFu);}}
LDR X8, [X0,#0x350]MSR #4, c15, c15, #4, X8LDR X8, [X0,#0x348]MSR #4, c15, c15, #1, X8
0x348代表jitcage内存地址,0x350代表其大小,分别写入两个不同的寄存器中。
4.2 jitcage对bytecode表保护
苹果公司只公开了部分的jitcage源码,通过关键字JIT_CAGE搜寻webkit的源码,可以看到在jsc初始化bytecode操作表的时候引用了jitcage的另一个功能。
./JavaScriptCore/assembler/JITOperationList.cppSUPPRESS_ASAN ALWAYS_INLINE void JITOperationList::addPointers(const JITOperationAnnotation* begin, const JITOperationAnnotation* end){auto& map = m_validatedOperations;if (Options::useJITCage()) {JSC_JIT_CAGED_POINTER_REGISTRATION();return;}if constexpr (JIT_OPERATION_VALIDATION_ASSERT_ENABLED) {for (const auto* current = begin; current != end; ++current) {void* operation = removeCodePtrTag(current->operation);if (operation) {void* validator = removeCodePtrTag(Options::useJITCage() ? current->operationWithValidation : current->operation);validator = WTF::tagNativeCodePtrImpl<OperationPtrTag>(validator);map.add(operation, validator);JSC_REGISTER_INVERSE_JIT_CAGED_POINTER_FOR_DEBUG(validator, operation);}}}}void JITOperationList::populatePointersInJavaScriptCore(){static std::once_flag onceKey;std::call_once(onceKey, [] {if (Options::useJIT())jitOperationList->addPointers(&startOfJITOperationsInJSC, &endOfJITOperationsInJSC);#if ENABLE(JIT_OPERATION_DISASSEMBLY)if (UNLIKELY(Options::needDisassemblySupport()))populateDisassemblyLabelsInJavaScriptCore();#endif});}
JSC_JIT_CAGED_POINTER_REGISTRATION()在源码中被抹掉了,通过分析二进制可以看到它的实现:
__int64 __fastcall JSC::initialize(void)::$_7::operator()(WTF *a1){v11 = (JSC *)JSC::JITOperationList::populatePointersInJavaScriptCore(v7, v8, v9, v10);}void __fastcall std::__call_once_proxy<std::tuple<JSC::JITOperationList::populatePointersInJavaScriptCore(void)::$_3 &&(__int64 a1,unsigned __int64 a2){v4 = (WTF *)WTF::fastMalloc((WTF *)0x2980, a2);
为操作表分配内存。
_WriteStatusReg(ARM64_SYSREG(3, 4, 15, 15, 6), _ReadStatusReg(ARM64_SYSREG(3, 4, 15, 15, 6)) | 0x8000); 将特殊寄存器第15bit置1。
__isb(0xFu);if ( useJIT )__break(0xC471u);v5 = 0;v6 = &JSC::_JITTargetID_ctiMasmProbeTrampoline;do{if ( *v6 ){v7 = v6[1];v8 = (__int64 *)((char *)v4 + 16 * v5);= *v6;= v7;++v5;}v6 += 2;}while ( v6 != (__int64 *)&`vtable for'CrashLogPrintStream );
对操作表进行赋值。
if ( useJIT )__break(0xC471u);_WriteStatusReg(ARM64_SYSREG(3, 4, 15, 15, 6), _ReadStatusReg(ARM64_SYSREG(3, 4, 15, 15, 6)) & 0xFFFFFFFFFFFF7FFFLL);
将特殊寄存器第15bit清0。
可以推测出这个寄存器实现了上锁与解锁的功能。这个__break(0xC471u)指令有特殊的功效,它防止jitcode中调用和修改这个寄存器,如果有以上行为就会触发一个断点操作被内核捕获。
4.3 PAC key的保护
这里的key指的是brab指令的第一个参数,在挑战到目标地址时,利用pac的b key以及这个特殊的参数做指针完整性判断。我们可以在webkit生成machine code时看到对它的一些引用:
JavaScriptCore/assembler/MacroAssemblerARM64E.hALWAYS_INLINE Jump jump() { return MacroAssemblerARM64::jump(); }template<JumpSignatureType type>ALWAYS_INLINE void farJumpRegister(RegisterID targetGPR, RegisterID tagGPR = InvalidGPR){UNUSED_PARAM(type);ASSERT(tagGPR != targetGPR);#if ENABLE(JIT_CAGE)if (Options::useJITCage()) {JSC_JIT_CAGED_FAR_JUMP(type, targetGPR, tagGPR);} else#endifm_assembler.brab(targetGPR, tagGPR);}void farJump(RegisterID targetGPR, PtrTag tag){ASSERT(tag != CFunctionPtrTag && tag != NoPtrTag);ASSERT(!Options::useJITCage() || callerType(tag) == PtrTagCallerType::JIT);ASSERT(tag != CFunctionPtrTag);RegisterID diversityGPR = getCachedDataTempRegisterIDAndInvalidate();move(TrustedImm64(tag), diversityGPR);if (calleeType(tag) == PtrTagCalleeType::JIT)farJumpRegister<JumpSignatureType::JITJump>(targetGPR, diversityGPR);elsefarJumpRegister<JumpSignatureType::NativeJump>(targetGPR, diversityGPR);}
JSC_JIT_CAGED_FAR_JUMP函数在源码中被抹掉了,通过查看反汇编代码:
_int64 __fastcall JSC::MacroAssemblerARM64E::farJump(__int64 a1, int a2, JSC::ARM64LogicalImmediate *a3){if ( (__int64)a3 > 0xC344 ){if ( (__int64)a3 > 0xE015 ){if ( a3 == (JSC::ARM64LogicalImmediate *)0xE016 || a3 == (JSC::ARM64LogicalImmediate *)0xED60 )goto LABEL_17;v8 = 0xE314LL;}else{v8 = 0xC345LL;}}else if ( (__int64)a3 <= 0x94D0 ){if ( (__int64)a3 <= 0xDA8 ){if ( a3 != (JSC::ARM64LogicalImmediate *)0x593 )goto LABEL_10;goto LABEL_17;}if ( (__int64)a3 > 0x47E9 ){if ( (__int64)a3 <= 0x6F9A ){if ( (__int64)a3 <= 0x5CAC ){if ( a3 == (JSC::ARM64LogicalImmediate *)0x4D56 || a3 == (JSC::ARM64LogicalImmediate *)0x47EA )goto LABEL_17;v8 = 0x5689LL;}else{if ( a3 == (JSC::ARM64LogicalImmediate *)0x5D3F || a3 == (JSC::ARM64LogicalImmediate *)0x5CAD )goto LABEL_17;v8 = 0x6813LL;}}else if ( (__int64)a3 > 0x7F71 ){if ( a3 == (JSC::ARM64LogicalImmediate *)0x7F72 || a3 == (JSC::ARM64LogicalImmediate *)0x8763 )goto LABEL_17;v8 = 0x90C4LL;}else{v8 = 0x6F9BLL;}}else{if ( a3 == (JSC::ARM64LogicalImmediate *)0xDA9 || a3 == (JSC::ARM64LogicalImmediate *)0x24AD )goto LABEL_17;v8 = 0x1DDDLL;}}else{if ( a3 == (JSC::ARM64LogicalImmediate *)0xBA68 || a3 == (JSC::ARM64LogicalImmediate *)0x94D1 )goto LABEL_17;v8 = 0x96FDLL;}}
a3代表brab的第一个参数,可以看到jitcage的意图是限制了brab这个参数的范围,根据不同的汇编指令只允许使用对应的值。通过对整个jsc binary进行搜寻可以证明:
__text:000000018B991760 ADRL X7, _g_config__text:000000018B991768 ADD X7, X7, #0xC28__text:000000018B99176C MOV X17, #0xE016__text:000000018B991770 LDR X13, [X7]__text:000000018B991774 BRAB X13, X17__text:000000018B9919C0__text:000000018B9919C0 PACIBSP__text:000000018B9919C4 STP X29, X30, [SP,#-0x10+var_s0]!__text:000000018B9919C8 MOV X29, SP__text:000000018B9919CC MOV X13, #0x8763__text:000000018B9919D0 BRAB X5, X13__text:000000018B9919DC MOV X13, #0x153F__text:000000018B9919E0 BRAB X3, X13__text:000000018B9919EC MOV X13, #0x4911__text:000000018B9919F0 BRAB X2, X13__text:000000018B991A00 MOV X13, #0x90C4__text:000000018B991A04 BRAB X3, X13
4.4 jitCagePtr
JavaScriptCore/llint/LLIntData.cppvoid initialize(){if (Options::useJITCage())g_jscConfig.llint.gateMap[static_cast<unsigned>(Gate::jitCagePtr)] = jitCagePtrThunk().code().taggedPtr();}
__text:000000018C2A8F70 loc_18C2A8F70 ; CODE XREF: JSC::LLInt::initialize(void)+C0↑j__text:000000018C2A8F70 ADRL X9, unk_1D95A1030__text:000000018C2A8F78 LDP X8, X0, [X9] ; this__text:000000018C2A8F7C CBZ X0, loc_18C2ABEB0__text:000000018C2A8F80 MOV W9, #1__text:000000018C2A8F84 LDADDAL W9, W10, [X0]__text:000000018C2A8F88 STR X8, [X19,#(qword_1D9598BC0 - 0x1D9598000)]
static_cast<unsigned>(Gate::jitCagePtr)]对应#(qword_1D9598BC0 - 0x1D9598000),它是将unk_1D95A1030内存处写入。而unk_1D95A1030保存的值是另一个函数设置的:
__text:000000018C2E03C8 __ZNSt3__117__call_once_proxyINS_5tupleIJOZN3JSC5LLInt15jitCagePtrThunkEvE4$_32EEEEEvPv__text:000000018C2E03C8 ; DATA XREF: JSC::LLInt::initialize(void)+DC↑oext:000000018C2E0528 MOV W1, #0xDAC10420__text:000000018C2E0530 BL __ZN3JSC15AssemblerBuffer20putIntegralUncheckedIiEEvT_ ; JSC::AssemblerBuffer::putIntegralUnchecked<int>(int)__text:000000018C2E0534 ADRL X16, _jitCagePtrGateAfter__text:000000018C2E053C PACIZA X16__text:000000018C2E0540 MOV X0, X16__text:000000018C2E0544 BL __ZN3WTF12retagCodePtrIPvLNS_6PtrTagE1ELS2_45961EPFvvEvEET_T2_ ; WTF::retagCodePtr<void *,(WTF::PtrTag)1,(WTF::PtrTag)45961,void (*)(void),void>(void (*)(void))__text:000000018C2E0548 MOV X1, X0 ; this__text:000000018C2E054C ADD X0, SP, #0x3B0+var_218 ; int__text:000000018C2E0550 MOV W2, #1__text:000000018C2E0554 BL __ZN3JSC19MacroAssemblerARM6412moveInternalINS_22AbstractMacroAssemblerINS_15ARM64EAssemblerEE13TrustedImmPtrElEEvT_NS_14ARM64Registers10RegisterIDE ; JSC::MacroAssemblerARM64::moveInternal<JSC::AbstractMacroAssembler<JSC::ARM64EAssembler>::TrustedImmPtr,long>(JSC::AbstractMacroAssembler<JSC::ARM64EAssembler>::TrustedImmPtr,JSC::ARM64Registers::RegisterID)__text:000000018C2E0558 ADD X0, SP, #0x3B0+var_218__text:000000018C2E055C MOV W1, #1__text:000000018C2E0560 MOV W2, #0xB389__text:000000018C2E0564 BL __ZN3JSC20MacroAssemblerARM64E7farJumpENS_14ARM64Registers10RegisterIDEN3WTF6PtrTagE ;
unk_1D95A1030内存处填充的是一段machine code,大致类似:
Mov xx, jitCagePtrGateAfterBrab xx, 0xB389
0xB389使用上一小节介绍的技术限制了它的取值范围,然后校验jitCagePtrGateAfter指针并跳转到此处去执行。
__text:000000018B991A84 _jitCagePtrGateAfter ; DATA XREF: std::__call_once_proxy<std::tuple<JSC::LLInt::jitCagePtrThunk(void)::$_32 &&>>(void *)+16C↓o__text:000000018B991A84 RETAB
使用b key验证栈中的返回地址。
接下来看下jitCagePtr
__text:000000018B991A68 EXPORT _jitCagePtr__text:000000018B991A68 _jitCagePtr ; CODE XREF: JSC::LinkBuffer::getLinkerAddress<(WTF::PtrTag)47720,JSC::AssemblerLabel>(JSC::AssemblerLabel)+A0↑p__text:000000018B991A68 ; JSC::LinkBuffer::getLinkerAddress<(WTF::PtrTag)47720,JSC::AssemblerLabel>(JSC::AssemblerLabel)+C4↑p ...__text:000000018B991A68 PACIBSP__text:000000018B991A6C ADRL X2, _g_config__text:000000018B991A74 ADD X2, X2, #0xBC0__text:000000018B991A78 MOV X13, #0xE016__text:000000018B991A7C LDR X17, [X2]__text:000000018B991A80 BRAB X17, X13
JitCagePtr函数作为一个跳板函数,g_config[0xBC0]处的函数地址已经在前面被赋值过了,然后使用#0xE016作为brab的第一个参数,在前一小节已经介绍过了。
Jsc中有很多地方调用了jitCagePtr:
__text:000000018C839068 MOV X21, X22__text:000000018C83906C XPACI X21__text:000000018C839070 MOV X0, X21__text:000000018C839074 MOV W1, #0x24AD__text:000000018C839078 BL _jitCagePtr__text:000000018C83907C CMP X0, X22__text:000000018C839080 B.NE loc_18C8392F4__text:000000018C839084 CBNZ X21, loc_18C8390C0
X22为即将调用的某个函数指针,首先使用xpaci清除掉它的pac code,将其传入x0,x1传入#0x24AD,不同的函数可以传递不同的值,在前面讲过,brab时会用到这个值校验它的完整性。
5 Isolate Heap
5.1 简述
GigaCage解决了OOB(out of bounds)的问题, 同样在bmalloc里实现了一个叫做IsoHeap(Isolate heap)的功能,它使每个类型的数据结构都在同一个类型的内存区域分配,形成一个类似隔离区的功能,这使得UAF(Use After Free)的利用变得非常困难。
在wtf中有如何宏定义:
WTF/wtf/IsoMallocInlines.h#include <bmalloc/IsoHeapInlines.h>#define WTF_MAKE_ISO_ALLOCATED_INLINE(name) MAKE_BISO_MALLOCED_INLINE(name)#define WTF_MAKE_ISO_ALLOCATED_IMPL(name) MAKE_BISO_MALLOCED_IMPL(name)#define WTF_MAKE_ISO_ALLOCATED_IMPL_TEMPLATE(name) MAKE_BISO_MALLOCED_IMPL_TEMPLATE(name)WTF_MAKE_ISO_ALLOCATED_IMPL包装了MAKE_BISO_MALLOCED_IMPL宏:bmalloc/bmalloc/IsoHeapInlines.h#define MAKE_BISO_MALLOCED_IMPL(isoType) \::bmalloc::api::IsoHeap<isoType>& isoType::bisoHeap() \{ \static ::bmalloc::api::IsoHeap<isoType> heap("WebKit "#isoType); \return heap; \} \\void* isoType::operator new(size_t size) \{ \RELEASE_BASSERT(size == sizeof(isoType)); \return bisoHeap().allocate(); \} \\void isoType::operator delete(void* p) \{ \bisoHeap().deallocate(p); \} \\void isoType::freeAfterDestruction(void* p) \{ \bisoHeap().deallocate(p); \} \
IsoHeap模板根据不同的类型生成了一些函数,比如重载了new和delete运算符,当对这个类型的数据进行new和delete时,就会使用IsoHeap的接口。
在webkit的代码中,存在大量的使用IsoHeap的代码,比如:
WebCore/rendering/RenderTableRow.cppWTF_MAKE_ISO_ALLOCATED_IMPL(RenderTableRow);RenderTableRow::RenderTableRow(Element& element, RenderStyle&& style): RenderBox(element, WTFMove(style), 0), m_rowIndex(unsetRowIndex){setInline(false);setIsTableRow();}RenderTableRow::RenderTableRow(Document& document, RenderStyle&& style): RenderBox(document, WTFMove(style), 0), m_rowIndex(unsetRowIndex){setInline(false);setIsTableRow();}
5.2 实现
IsoHeap定义了一个名为Directory的内存块,它包含若干Page。
bmalloc/bmalloc/IsoDirectory.htemplate<typename Config, unsigned passedNumPages>class IsoDirectory : public IsoDirectoryBase<Config> {public:static constexpr unsigned numPages = passedNumPages;private:void scavengePage(const LockHolder&, size_t, Vector<DeferredDecommit>&);std::array<PackedAlignedPtr<IsoPage<Config>, IsoPage<Config>::pageSize>, numPages> m_pages { };Bits<numPages> m_eligible;Bits<numPages> m_empty;Bits<numPages> m_committed;}
这些Directory内存块通过单链表链接起来。
bmalloc/bmalloc/IsoHeapImplInlines.htemplate<typename Config>EligibilityResult<Config> IsoHeapImpl<Config>::takeFirstEligible(const LockHolder& locker){auto* newDirectory = new IsoDirectoryPage<Config>(*this, m_nextDirectoryPageIndex++);if (m_headDirectory.get()) {m_tailDirectory->next = newDirectory;m_tailDirectory = newDirectory;}
每个Page包含若干chunk,chunk大小由Config::objectSize定义。
bmalloc/bmalloc/IsoPage.htemplate<typename Config>class IsoPage : public IsoPageBase {public:static constexpr unsigned numObjects = pageSize / Config::objectSize;unsigned index() const { return m_index; }void free(const LockHolder&, void*);// Called after this page is already selected for allocation.FreeList startAllocating(const LockHolder&);DeferredTrigger<IsoPageTrigger::Eligible> m_eligibilityTrigger;DeferredTrigger<IsoPageTrigger::Empty> m_emptyTrigger;uint8_t m_numNonEmptyWords { 0 };static_assert(bitsArrayLength(numObjects) <= UINT8_MAX);unsigned m_index { UINT_MAX };IsoDirectoryBase<Config>& m_directory;unsigned m_allocBits[bitsArrayLength(numObjects)];}
每个page的状态由如下定义:空、全满、半满,这跟slab的算法类似,内存分配器算法也就那么几种。
Page中的每个chunk放到一个叫做Freelist的链表中:
bmalloc/bmalloc/FreeList.hclass FreeList {public:BEXPORT void initializeList(FreeCell* head, uintptr_t secret, unsigned bytes);BEXPORT void initializeBump(char* payloadEnd, unsigned remaining);private:FreeCell* head() const { return FreeCell::descramble(m_scrambledHead, m_secret); }uintptr_t m_scrambledHead { 0 };uintptr_t m_secret { 0 };}
FreeList中的每个节点指向的下一个节点地址都做了混淆保护:
struct FreeCell {static uintptr_t scramble(FreeCell* cell, uintptr_t secret){return reinterpret_cast<uintptr_t>(cell) ^ secret;}static FreeCell* descramble(uintptr_t cell, uintptr_t secret){return reinterpret_cast<FreeCell*>(cell ^ secret);}void setNext(FreeCell* next, uintptr_t secret){scrambledNext = scramble(next, secret);}FreeCell* next(uintptr_t secret) const{return descramble(scrambledNext, secret);}uintptr_t scrambledNext;};
secret是一个运行时产生的随机数。
bmalloc/bmalloc/IsoPageInlines.htemplate<typename Config>FreeList IsoPage<Config>::startAllocating(const LockHolder&){uintptr_t secret;cryptoRandom(&secret, sizeof(secret));
产生一个随机数。
FreeCell* head = nullptr;unsigned bytes = 0;for (unsigned index = indexOfFirstObject(); index < numObjects; ++index) {unsigned wordIndex = index >> 5;unsigned word = m_allocBits[wordIndex];unsigned bitMask = 1 << (index & 31);if (word & bitMask)continue;if (!word)m_numNonEmptyWords++;m_allocBits[wordIndex] = word | bitMask;char* cellByte = reinterpret_cast<char*>(this) + index * Config::objectSize;if (verbose)fprintf(stderr, "%p: putting %p on free list.\n", this, cellByte);FreeCell* cell = bitwise_cast<FreeCell*>(cellByte);cell->setNext(head, secret);
下一个cell的地址加密存储。
head = cell;bytes += Config::objectSize;}
我们看到虽然cell的地址使用了加密存储,但是每个cell在初始化时是顺序存储的,没有像linux slub和ios zone一样使用洗牌算法将cell顺序打乱。
6 StructureID Protection
webkit在2019年时使用随机化技术对StructureID进行了保护:
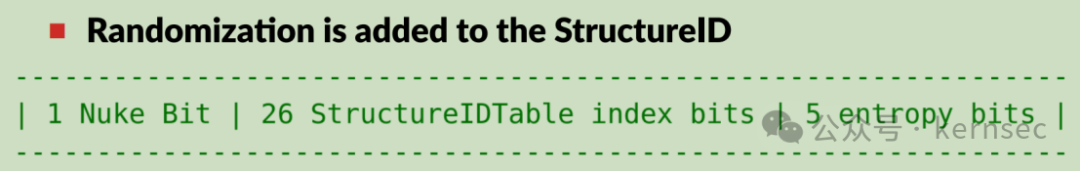
即使使用了随机化,由于entropy bits较少,已经出现很多绕过方法,因此webkit在最新的版本中去掉了随机化功能,使用了新的保护技术。
JavaScriptCore/runtime/StructureID.hclass StructureID {public:static constexpr uint32_t nukedStructureIDBit = 1;static constexpr unsigned encodeShiftAmount = 4;static constexpr CPURegister structureIDMask = structureHeapAddressSize - 1;}
最低位还是一个bit的Nuke Bit。
STRUCTURE_ID_WITH_SHIFT宏用在64bit地址,但是cpu仅使用了36bit有效地址的情景下,它将StructureID的地址进行移位编码存储。
ALWAYS_INLINE StructureID StructureID::encode(const Structure* structure){ASSERT(structure);auto result = StructureID(reinterpret_cast<uintptr_t>(structure) >> encodeShiftAmount);ASSERT(result.decode() == structure);return result;}
编码时右移了4位,因此它只能编码36bit的内存地址。
ALWAYS_INLINE Structure* StructureID::decode() const{ASSERT(decontaminate());return reinterpret_cast<Structure*>(static_cast<uintptr_t>(decontaminate().m_bits) << encodeShiftAmount);}
解码时在左移4位。
如果cpu使用更大的寻址能力,webkit使用以下编码方式:
ALWAYS_INLINE StructureID StructureID::encode(const Structure* structure){ASSERT(structure);ASSERT(g_jscConfig.startOfStructureHeap <= reinterpret_cast<uintptr_t>(structure) && reinterpret_cast<uintptr_t>(structure) < g_jscConfig.startOfStructureHeap + structureHeapAddressSize);auto result = StructureID(reinterpret_cast<uintptr_t>(structure) & structureIDMask);ASSERT(result.decode() == structure);return result;}
编码时使用structure的地址与上structureIDMask, 然后调用StructureID构造函数对m_bits进行赋值,它是32bit。
class StructureID {public:static constexpr uint32_t nukedStructureIDBit = 1;private:explicit StructureID(uint32_t bits) : m_bits(bits) { }uint32_t m_bits { 0 };};
structureIDMask可以选取以下值:
constexpr uintptr_t structureHeapAddressSize = STRUCTURE_HEAP_ADDRESS_SIZE_IN_MB * MB;constexpr uintptr_t structureHeapAddressSize = 128 * MB;constexpr uintptr_t structureHeapAddressSize = 512 * MB;constexpr uintptr_t structureHeapAddressSize = 4 * GB;static constexpr CPURegister structureIDMask = structureHeapAddressSize - 1;
可以看到如果structureHeapAddressSize为4G,m_bits可以代表全部的32bit,它是一个在StructureHeap的索引,这使得猜测StructureID的值比随机化5bit更加困难。
ALWAYS_INLINE Structure* StructureID::decode() const{// Take care to only use the bits from m_bits in the structure's address reservation.ASSERT(decontaminate());return reinterpret_cast<Structure*>((static_cast<uintptr_t>(decontaminate().m_bits) & structureIDMask) + g_jscConfig.startOfStructureHeap);}
解码时m_bits在与上structureIDMask, 它是一个32bit的索引,因此要在加上sturctureID的基地址g_jscConfig.startOfStructureHeap。