论不靠谱的融合 IP 库~
原创 高春辉 2025-12-19 11:35 天津
我们跟朋友讲,IP 库五字诀,数据变化快,应用场景多,维护成本高,保护起来难,IPv6 难上难。
最近有一点点的焦虑,因为凭我的直觉,IP 库数据的后续推进工作可能又要进入瓶颈期了,除了对内给团队更高的要求之外,持续不断的寻找更多的数据源,和如何通过各种方法把数据源更好的利用起来,是我在工作中除了维护 IP 数据库以外占用时间最多的事情。
既然到年底了,那就先在文章里稍微盘点一下今年至今的进展吧,目前 IPv4 和 IPv6 的数据库条目数加一起,已经超过 2000 万行。
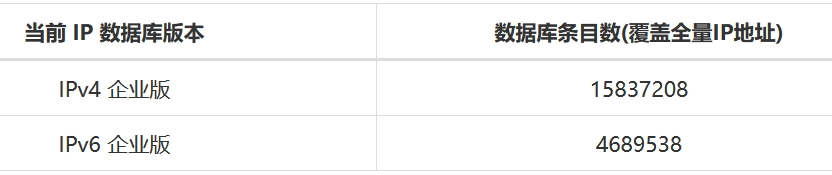
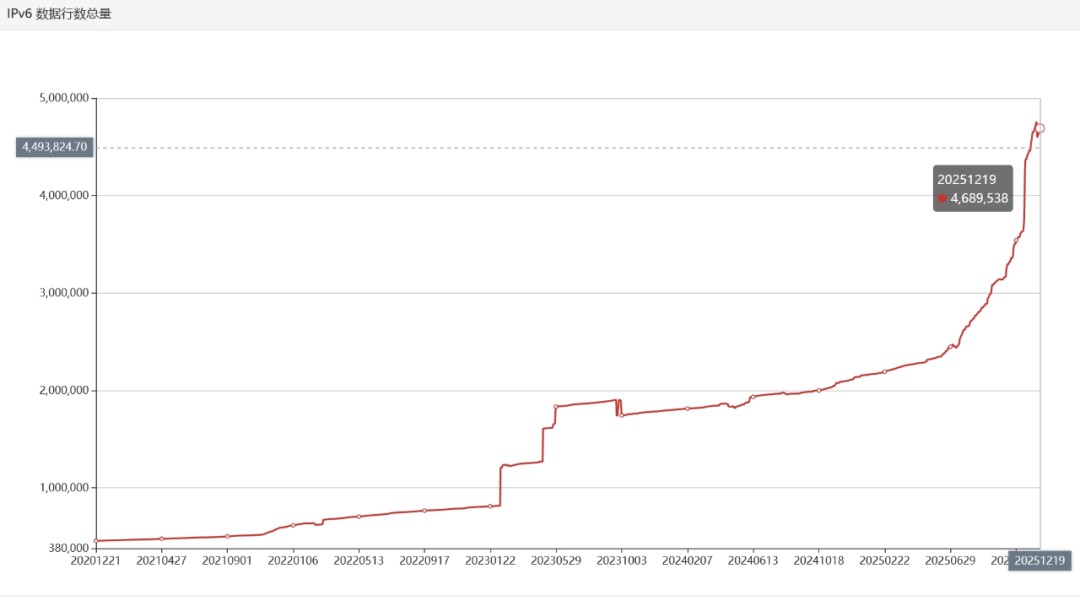
如前所说,今年也相比之前明显加强了 IPv6 数据的制作,条目数从年初的 213 万行,上次提到的还是 3 打头,现在已经持续增长到最近的 468 万行(CIDR 紧凑化后)。
尤其是 IPv6 下的中国以及全球骨干网络的数据,也在大力推进中,不会像之前一样,用我们的 BestTrace 工具跟踪 IPv6 地址所看到的地理路径清晰度不如 IPv4 下的质量那么好。我们的目标是一样好。
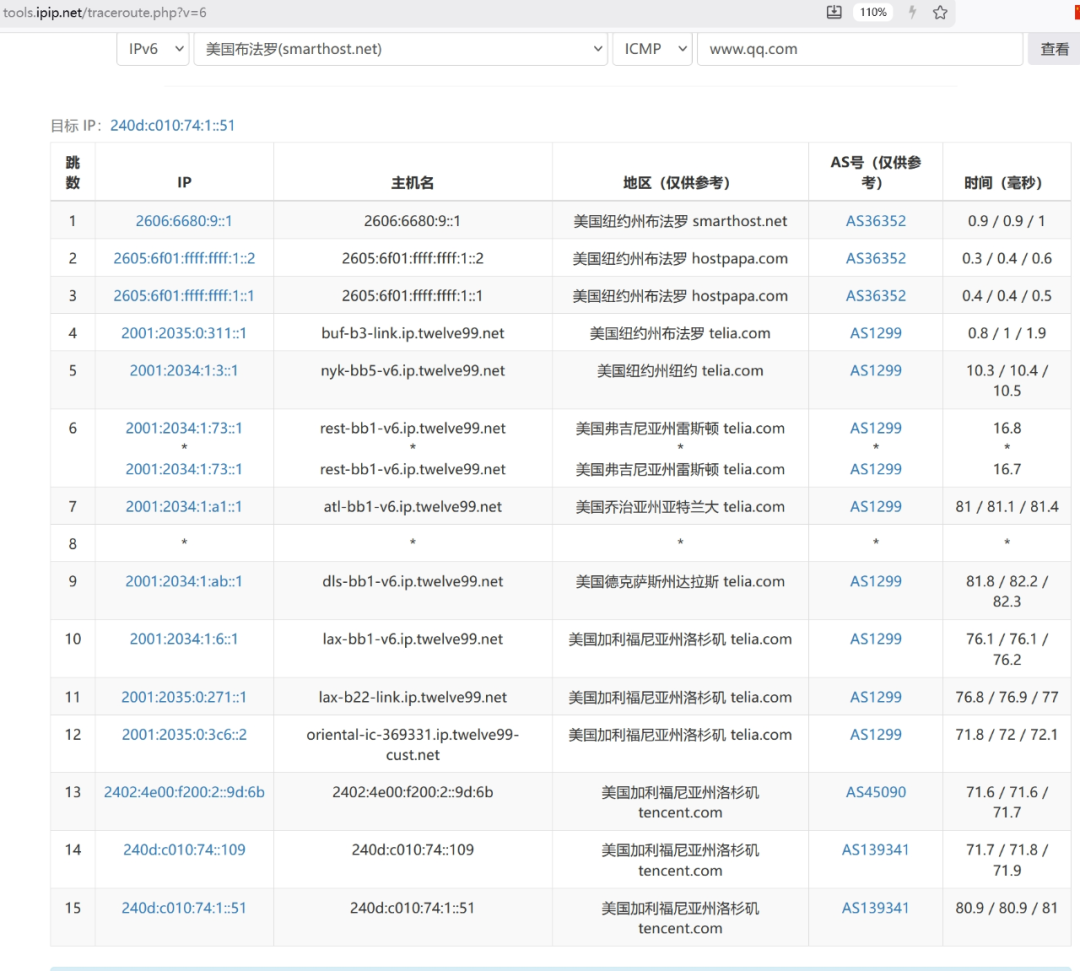
一时找不到更好的例子,欢迎自行来测试。
数据在不断的推进,我们也在到处翻论文以期有所收获,上月底去长沙见老朋友,回来的路上无意中看到年底有个网络某领域的年度会议,有 IP 库的相关内容,于是就赶紧缴纳参会费定机票酒店,不怕路上无网来回飞行 7、8 个小时,只希望能够学习一下学术界的先进思路。
结果开会之后,正如老话说越期望往往越失望,听完挺失望的,甚至需要写篇文章吐槽一下。。。
首先是我们在这个领域里已经耕耘了十多年,我相信抛开新进入行的年轻同鞋可能会不知道我们以外,凡是经验丰富一点的行业老同志,不管对我们评价是好是坏,说完全不知道是不太可能的。
但是在大屏幕上,我看到了国外的同行,也看到了国内的同行,愣是没看到我们。😳
我也确实不理解,即使是我们从 2020 年开始走所谓的高端路线之后,你们学术圈研究经费有限确实买不起也可以找我们来说要做学术评估希望配合一下,我相信还是愿意参与的,毕竟夸奖我们会高兴,批评我们也会继续更加努力,但还是担心怕跟我们说了要做学术评述以后,给你们定向输出数据造假吗?
行吧,一定程度上可以理解你们学术圈的难处,虽然有一点点不舒服,但我们其实也不太在乎这个,毕竟客户是聪明的,这么多年下来,愿意既顶着同行们 1/N 的价格压力,还要顶着主要包括采购部门的各种内部压力来买我们的数据,我在疲惫之余其实还是有那么一点点骄傲的。
当然也有不太聪明的,比如今年又有一个大公司,年中要续约时各种 PUA,采购对接人最后给了个地下室价,说你们看着办爱续不续,我们当然没惯着他们,不续就不续,WHO CARE YOU。我就跟我同事说,看看是他们需要我们,还是我们需要他们,而凭我们这么多年对各种客户以及具体业务的了解,我猜大概率还得来找我们,因为同行的数据必然满足不了,一旦所依赖服务的品质下降,客户怒怼过来,估计还得硬着头皮上门找我们来。果不其然、不出意料的这个年都没过得去,他们的某个业务部门又不情不愿的主动找过来了,又是几轮的嫌贵 PUA,最终我们又一次成功的扛住了压力,正在走流程中。
回到正题。
当然,国外有一个还比较进取的同行,同样也没在列表里,可能也是因为卖的贵吧。
说到整个 ppt 里让我感觉问题最大的是居然把融合库作为一个研究方式。
就是他拿着几个业界的 IP 库,还都不是业界里顶尖水平的,按照他的所谓方法论,融合了一个 IP 库出来,然后再拿一堆所谓的可信任的数据源去做验证,最后号称这个库提高了多少的正确率。
当时我就震惊了。😱
话说十多年前,我在刚入此行的时候,和一些互联网公司具体负责 IP 库这方面工作的人交流这方面话题的时候,他们也直言不讳的跟我说,要么单纯依靠一个库,错就错了,要么多买几个库,然后用投票的方案,比如 N 个库都说某个 IP 在某个城市那就信任这个结果,如果有分歧,再根据一些方法或者信任权重进行处理,当然也会基于自己的一些数据来源,比如运营商,客户反馈的数据,等等,融合出一个自己的版本,当然也明知道这就是一个无奈的方法,公司不会给更多的支持和投入,自己也知道做不好的前提下,只是无奈的选择而已。
至少十年时间过去了,无论叫拼凑还是融合,本质上没有区别。
可能你们会说我鸡蛋里挑骨头,那么我具体说说这种方法的问题根源所在:
1、用来证明数据对与错的验证数据集过少,自己都发现不了错了多少,那结论又能有多客观?
我现场算了一下,屏幕上明确显示的验证数据集加总也就是 10 万都不到(我有拍照),IPv4/IPv6 ,公开的私有的,算在一起。
各位可以思考一下 ,先单独看 IPv4,可用于公网 IP 的数量在 36 亿左右,那么评估数据集要有多少合适呢?拿着不到 10 万的数据集去证明 36 亿的数据集的正确率,恐怕过于有失偏颇。而且说句不好听的话,公开数据集部分,这个量级非常容易被针对性优化。至少我们对于市面上能看到的公开数据集都会跟进更新的。不是为了评估好看,而这就是本职工作。而私有数据集只有一点点,那又能证明什么呢?
更别说 IPv6 的那个 2 的 128 次方的数据量了。即使切掉一半按照 /64 去评估,也是 2 的 64 次方了。然而就一万多一些的评估数据,够用吗?即使再把 IPv6 里没启用的也去掉,只计算启用的部分,也是 V4 数据量的 NNN 倍啊。
再进一步讲,IP 在具体使用中层次用途有别,简单来说,有用于家庭/单位网络的,有用于数据中心的,也有用于骨干网络的,有做基站网络的,有做卫星网络的,拿来做评估的数据能够覆盖到足够的场景情况吗?
更别说我在大部分学术圈的相关论文里都看不到的基站网络、ANYCAST(任播)情况了。
多说一句,会议上的第二个 ppt 里就涉及到了一些网络的分析,比如中国以及全球 DNS 服务相关的分析,我也依然并不太认同其结论。原因大概率就是对全球网络基础设施和架构的不够熟悉以及没用到足够好的 IP 库导致被带歪了吧。这也是一直我们在强调的,如果你依赖的数据有问题,那结论有问题的可能性就会大很多。
2、如果所有的 IP 库都把一个 IP 的位置标注错了,那么是不是你融合的库也不会对?另外还有一个问题,我们很早就在工作中经常遇到我们标注的位置在所有可以看到的同行数据里,我们是唯一的不一样的结果的,但是可以通过相关数据证明,我们就是正确的结果。这种少数派报告又怎么算?但是评估数据里却没有我们,对了又如何?
更别说现在的国家之间有相邻很近的位置,比如新加坡和相邻的马来西亚和印度尼西亚都有很靠近的行政区划衔接,如何正确的区分?其他地区比如欧美也有不少城市因为距离本国的城市比较远,建设网络成本比较高,但是因为在国境附近离邻国城市反而很近,结果直接就近接入邻国网络的例子。这种阁下又如何应对?
可以举的例外例子太多了。。。
我们一直有愿望希望可以和学术圈合作,如果有哪位学术圈大佬(愿意对这领域感兴趣的都算,有相关依赖也可以的)看到这篇文章,有兴趣在这个领域交流一些真实有意义的话题,互惠互利,欢迎与我联系。我们的各种基础数据,应该比你在各种论文里看到的大的多。😈
比如:

我们之前也发过有关同行数据评估的文章,比如
这一篇
高春辉,公众号:老高的互联网杂谈首次!让我们出一个基于延迟的同行 IP 库数据评估来打个样~
这一篇
高春辉,公众号:老高的互联网杂谈深入!让我们再出一个基于延迟的同行 IP 库数据评估来打个样,这次是上海~
后来觉得是王婆卖瓜,也就没再继续下去,不过现在既然看不到有人愿意在数据评估上用心和下真功夫,我觉得我也别自我限制了,上了再说。评估方法没问题就行了。我近期会花点时间在这个事情上,如果做出来就公开在网站上,大家都可以来看。
演讲之后有一个学生举手提问,是和 GEOCAM 数据集相关的,我希望他不会被那些不仔细研究就水论文然后宣称解决了某某问题的内容带歪。其实他问问题的时候应该是意识到了。我们也经常看论文,有真实有价值的,比例很低,不然也不会有水论文这一说法了。
IP 库这个东西,有足够的数据做起来都很难,更别说就靠一点数据一点人力就宣称如何如何的,千万别信。我们跟朋友讲,IP 库五字诀,数据变化快,应用场景多,维护成本高,保护起来难,IPv6 难上难。请不要低估它的难度与价值,无论是制作,还是评估。
说到评估,其实客户们也会各种评估,要么以价格评估,要么以质量评估,买我们的数据的客户都以质量为最高要求,我们也几乎每天都会被客户发数据过来挑战,但是能挑战成功的极少极少,不然怎么走高端路线?
至于建议的每周更新,我就无力吐槽了,我们从开始提供这个数据给客户就坚持每日更新,并且一直建议客户们跟我们一样每日更新数据,只有我们清楚的知道每天的数据更新量有多大。有时候遇到客户来反馈说你们数据可能错了的时候,可能有一半原因是因为没及时更新,怒气冲冲的来,自找台阶的走。多说一句,现在我们的海外同行也开始加快更新周期了,我自己相信也是跟我们的坚持有那么一点点关系。
好啦,继续啃硬骨头去了。
本文章主体在回北京的飞机上离线写就。一直忙于研究收集新数据的事情,新数据收集主体工作完成了才找了点时间润色一下发出来。
文章配图为 IETF 在月初组织的一个 IP 库相关的会议,我们也参与了一下。也许下一篇文章是我这个公众号以来学术含量最高的文章,敬请期待。
最后送大家一首歌,杀不死我的只会让我更强大。周末快乐!