ECCV 2026 PhyGDPO: 增强视频生成模型物理一致性的强化学习新框架
phantom 2026-09-01 23:40 江苏
本文为粉丝投稿。
这篇工作提出了一个新的 offline 强化学习框架 PhyGDPO 来提升文生视频模型的物理动态一致性。文章首先提出了一种筛选物理密集场景的视频数据管线 PhyAugPipe,然后从数学上推导出一种新的成组概率强化学习框架。目前代码和数据已经开源,欢迎来用。
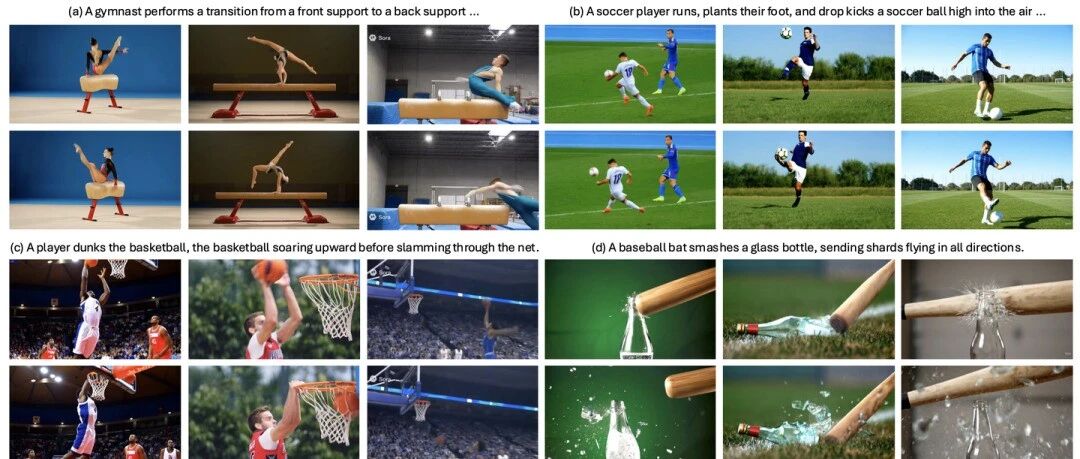
一些包含复杂物理动态的场景(如体操、足球、篮球、网球等)视频生成效果:

图1. PhyGDPO 高难度场景视频生成展示
由于上传 gif 会被压缩,高清视频对比结果请参考我们的项目主页:
1. 任务介绍
首先我们来介绍一下我们研究的任务 —— 文本生成视频(Text-to-Video Generation)。即用户输入一段文本,模型根据文本生成对应的视频场景。当前的很多闭源视频生成模型已经能将视频画面质量生成得非常好了。然而,生成视频中的物理动态比较差。如动图2所示,即便是当前最强的视频生成模型 Seedance 2.0,在一些高难度的场景中,比如体操,经常会生成变形的人体或是人体直接穿过双杆等不符合物理定律的现象。

图2. Seedance 2.0 在体操运动场景中生成畸变人体违反物理定律
因此,本文致力于研究如何使用后训练(Post-training)的方式提升视频生成模型的物理一致性。那么应该使用哪种 Post-training 的方式呢?我首先想到的是简单有监督微调(Supervised Finetuning,SFT),但是根据观察,当前市面上的大部分模型都经过了 SFT 却依旧没有学到好的物理,因此便排除了这种方式,转而考虑强化学习(Reinforcement Learning)的后训练方法。
我先考虑的是 Online RL 的方法,即 GRPO (Group Relative Policy Optimization)一类。但这类方法需要在每一次 rollout 时采样多条轨迹然后在 x0 处算奖励,速度缓慢并且用于计算奖励的多模态大模型(Vision-Language Model,VLM)对视频中的物理估计也不准确。因此也排除了这类 Online RL的方法。接着,我重点考虑了 Offline RL 算法,即 DPO (Direct Preference Optimization) 类算法,因为这类算法不需要在线采样计算奖励,训练迅速并且数据质量容易把控。Kling 的视频生成模型也是使用了 DPO 来作为其 RL post-training 的策略。
确定了大概的技术路线,在开展烟酒钱,我们主要面临三个问题。第一个问题就是缺少物理交互和现象比较密集的文本-视频训练数据。第二个问题是常规的 DPO 基于成对的(pairwise)概率模型,即一个正样本加一个负样本,同时正负样本都由模型自己生成得到。
这种模式存在两个局限,首先是模型本身生成的物理动态比较差,即便精挑细选,在一些高难度的场景中总是没法生成正确的物理,使用这类生成数据作为正样本没法保证让模型学到正确的物理。另一方面,这种 pairwise 的比较只能让模型学到比较单一的物理偏好,但是模型生成的物理错误可能是多种多样的。第三个问题是常规的 DPO 需要复制一整个模型作为 reference model,然后再训练另一整个模型作为 actor model 来计算优势。这种方式需要 GPU 同时加载两份完整的模型,显存占用高并且训练不稳定。
本文针对这些问题展开研究,主要做了以下四点贡献:
我们推导了一个基于组级 Plackett–Luce 概率模型的系统化 DPO 数学框架 PhyGDPO,用于捕捉全面的物理优势信号,从而提升文本生成视频的物理一致性。
我们设计了物理引导奖励机制(Physics-Guided Rewarding,PGR),指引数据采样和偏好优化更加关注具有挑战性的物理现象。同时,我们提出一种新的优势计算机制 —— Low-Rank Adaptation Switch Reference (LoRA-SR) 方案,以降低 GPU 显存占用,实现更加高效、稳定的 DPO 训练。
我们提出了一种构造物理密集场景的数据管线,PhyAugPipe。基于该流程,我们收集了训练数据集 PhyVidGen-135K,其中包含超过 13.5 万组数据对,用于研究物理一致的文本生成视频。
实验结果表明,PhyGDPO 在 PhyGenBench 和 VideoPhy2 数据集上均优于现有最先进方法;在针对物理真实性开展的用户研究中,我们的方法也获得了更高的人类偏好。
2. 方法设计
2.1 物理密集文本-视频数据构造流程 PhyAugPipe
我们提出的数据管线 PhyAugPipe 如图3所示,我们从一个非常随机的文本-视频数据池出发,目标是筛选出其中物理交互和现象比较密集的数据。
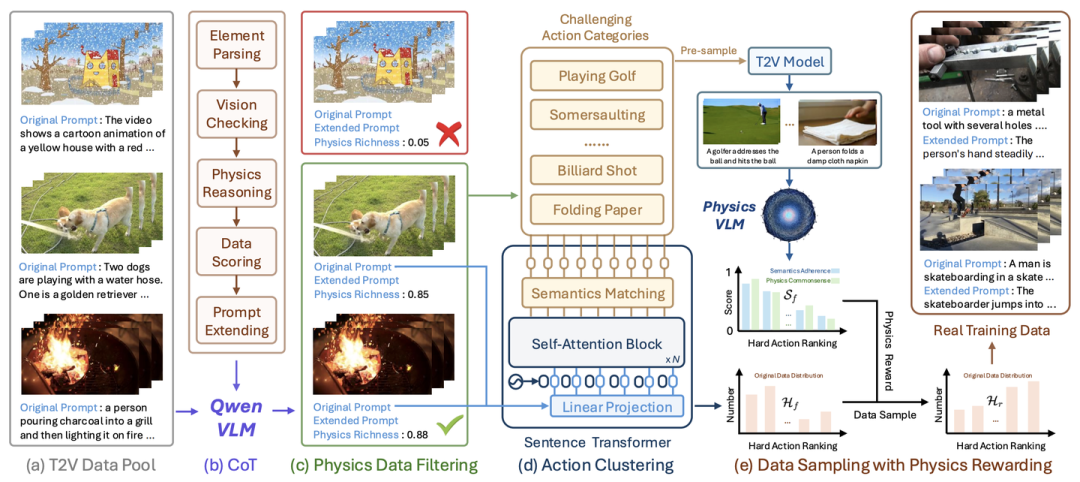
图3. PhyAugPipe 构造物理密集文本-视频数据对流程
为此,我们选用一个 VLM,Qwen2.5-Instruct-72B,装载我们设计的思维链(Chain-of-Thoughts, CoT)来对这个大数据池进行初筛。我们设计的 CoT 大致流程如图4所示。
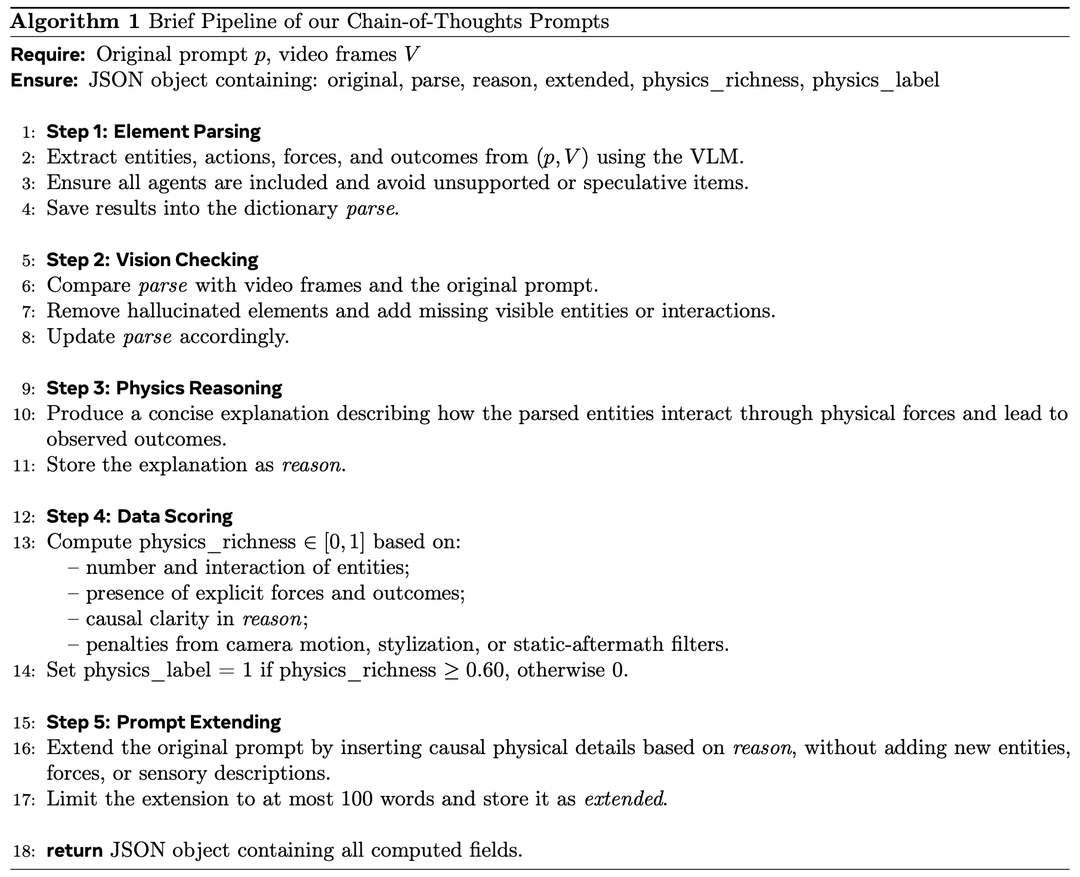
图4. 初筛使用的思维链算法流程
这个思维链首先从文本中解析出视频中的各个主体,然后通过 VLM 来检查这些主体在视频中的状态并引入更多的视觉细节,接着分析这些主体之间的物理交互作用以及可能导致的结果,然后给这个数据打一个值域为 [0, 1] 的物理丰富度分数,同时还会扩写出另一段长文本,里面包含了显式的物理。但请注意,本文训练使用的是原先的短文本,因为我们不希望将扩展的显示物理直接告诉 T2V 模型,而是希望通过训练提升模型自我推断隐式物理的能力。这里扩写出的长文本仅仅只是完善我们的数据以支持其他相关的研究,比如由 LLM 引导的视频生成。
我们回看图3,在完成了初筛之后,虽然数据已经包含了丰富的物理,但是他们没有类别,有可能存在分布不均衡的问题。为了更好地管理他们,我把他们的文本和一个预先总结好的高难度物理场景列表通过一个 Sentence Transformer 来做模糊语义匹配并选择匹配分数最高的类别来作为该数据的物理类别。对于每一个类别,我们选择匹配分数最高的数据来作为代表,把文本喂入我们即将 Post-train 的模型中生成视频代表,然后采用一个可感知物理的 VLM —— VideoCon-Physics 来打分得到基模在各个物理类别上的得分分布。分数越低,说明该类别越难,我们也就相应地多采样该类别的数据来训练以针对性地提高。
2.2 可感知物理的组式直接偏好优化框架 PhyGDPO
现有的 DPO 算法大多基于 Bradley–Terry(BT)概率模型,通过对数据样本进行成对比较来学习偏好,因此在捕捉全局性和整体性的偏好信号、以及与人类反馈对齐方面存在一定局限。此外,原始 DPO 通常将生成视频作为偏好样本中的胜者,但生成视频的物理真实感仍然有限,且一些具有挑战性的物理动作本身也较难生成。为解决这些问题,我们设计了可感知物理的组式直接偏好优化框架 PhyGDPO,如图5所示。
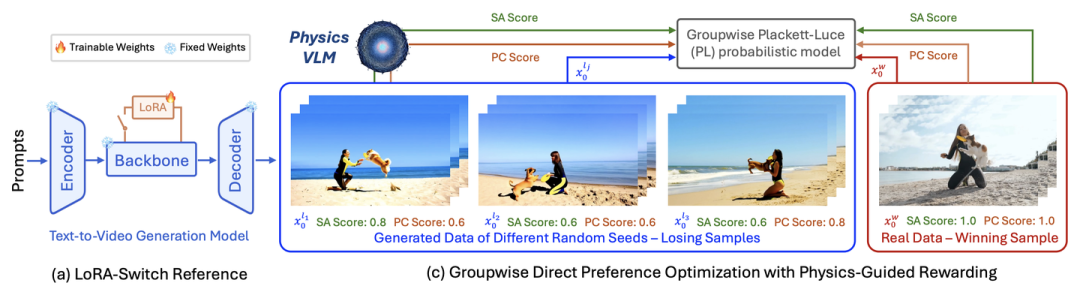
图5. PhyGDPO 算法流程
我们把生成结果 和条件 为输入的奖励函数记为 。不同于标准 DPO,我们从组级 Plackett–Luce(PL)概率模型出发,如图5所示。由于真实视频始终遵循物理规律,我们将其作为优选样本 ,并将一组生成视频作为非优选样本,记为 。PL 模型下的偏好概率可表示为:
奖励函数 可以由神经网络 进行参数化,并通过最大似然估计进行训练:
在 DPO 推导中,可将奖励函数 用视频生成模型本身来表示成:
其中, 和 分别表示训练模型 和参考模型 的条件概率, 和 分别表示唯一的全局最优解和配分函数。将其带入回 ,并舍去不会影响优化方向的组内常数项 ,即可得到组级 DPO(Groupwise DPO,GDPO)损失函数:
其中,我们将函数 定义为如下对数似然比:
根据扩散模型或流匹配模型的定义,终端分布本质上可表示为跨多个时间步 的联合转移过程。随后,我们将 代入到 中,并利用 Jensen 不等式将其上界估计转化为单个时间步上的形式,从而实现更高效的训练:
尽管该不等式中的上界支持单时间步训练,但对于每个样本组,都需要对模型执行 次推理,因此会带来较长的训练时间和较大的 GPU 显存开销。为解决这一问题,我们利用如下不等式:
来进一步将 的上界转化为每个组内每次训练仅使用一个样本的形式,从而实现高效训练:
该上界使得在每次迭代中,仅需在单个时间步采样一对数据即可实现高效训练。
为进一步提升物理偏好优化效果,我们设计了一种物理引导奖励机制(Physics-Guided Rewarding,PGR),以引导 DPO 训练更加关注具有挑战性的物理场景。具体而言,我们利用物理感知视觉语言模型 VideoCon-Physics 预测的归一化语义一致性得分 和物理常识得分 ,对 中的 和 进行参数化,具体如下:
其中, 用于衡量物理难度,并主要调节 和 ; 用于设置下界,以避免梯度消失;Sigmoid 函数 则确保对 的调整是有界且平滑的,从而提升优化过程的稳定性。 自适应地调节偏好比较的锐度,而 则会增强物理合理性较低样本的物理引导奖励。它们由超参数 、、 和 共同控制。
我们设计的物理奖励 在训练稳定性与自适应性之间取得平衡,使违反物理规律的样本能够在优化过程中产生更强的影响。需要指出的是,VLM 奖励仅影响不同样本的重要性,而物理监督的正确性仍由核心目标保证,即优选样本(体现正确物理规律的真实世界视频)相对于非优选样本的 DPO 优势。
我们的方法基于标准的整流流匹配(rectified flow matching),其形式如下:
这将诱导得到理想速度场 。采用步长 对时间进行离散化,即 ,其反向更新过程为 。由于整流流的单步反向转移过程中不存在中间噪声,我们采用趋于零的噪声正则化,并将 和 近似为:
随后令 ,并结合恒等式 ,计算两个高斯分布之间的对数似然比,可得:
并进一步将 的上界重新表述为最终的整体训练目标:
其中,公式中的任意全局常数缩放因子(例如 )均可吸收到超参数 中。为简化表示,我们记 、、,以及 。
以往的 DPO 方法通常会完整复制一份模型并将其固定为参考模型,这会占用额外且冗余的 GPU 显存,降低计算效率,并限制模型规模的进一步扩展。此外,这种完整复制的策略通常还会导致 DPO 训练不稳定且效果较差,因为其需要更新模型的全部权重,可能使当前策略模型迅速且大幅偏离参考模型。
为解决上述问题,我们设计了一种 LoRA 切换参考机制(LoRA-Switch Reference,LoRA-SR)。如图5所示,我们将冻结的主干网络作为参考模型 ,并在其上附加可训练的 LoRA 模块,从而构成策略模型 。具体而言,我们在 T2V 模型 Transformer 主干网络中每个自注意力模块的查询、键、值和输出线性投影层上加入 LoRA,并实现了一个环境管理器作为切换开关,以灵活地在参考模式与策略模式之间进行切换。
设 LoRA 所附着的线性投影层的输入 token 为 ,则在 LoRA-SR 机制下,输出 token 可表示为:
其中, 表示线性层的冻结权重; 是由环境管理器控制的二值指示变量,用于在参考模式()与策略模式()之间进行切换; 表示缩放因子; 表示秩; 和 则表示可学习的 LoRA 参数。
LoRA-SR 使参考模型和可训练模型能够共享同一个参数量较大的主干网络,同时通过灵活启用或禁用轻量级 LoRA 参数,在策略模型与参考模型之间进行切换。因此,我们无需额外存储或加载一个完整模型,即可计算 DPO 优势。这不仅显著提升了计算效率和模型规模的可扩展性,还能够防止策略模型过度偏离参考模型,从而稳定训练过程。
3. 实验结果
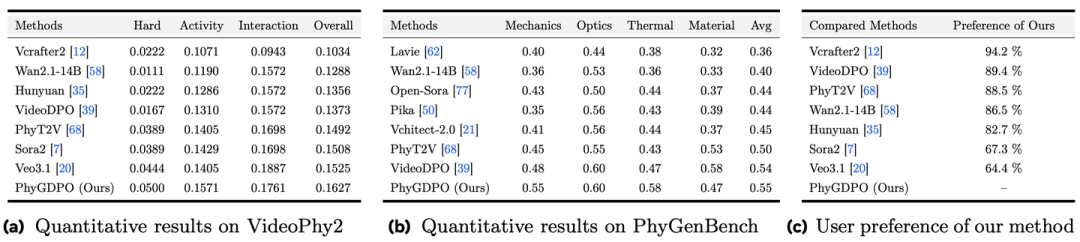
表1. 定量实验对比结果
我们选取 Wan2.1-14B 作为我们的基模,定量实验结果对比如表1所示。我们的 PhyGDPO 可以大幅提升 Wan2.1-14B 的物理动态一致性,显著超越当前最好方法。在人类主观偏好研究中,我们的方法也显著更多地被用户选择。
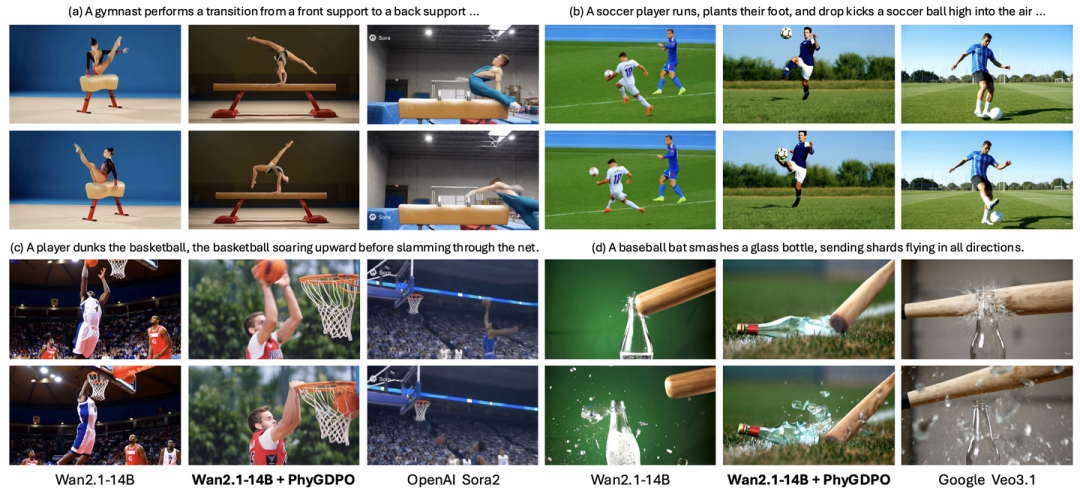
图6. 视觉结果对比 — 第一部分
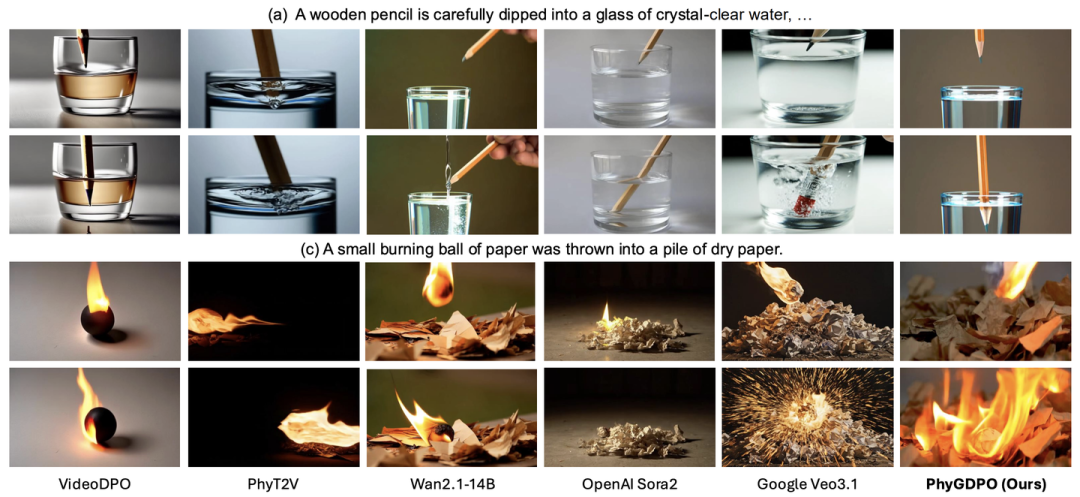
图7. 视觉结果对比 — 第二部分
视觉结果对比如图6和图7所示,在一些高难度的场景如体操、足球、篮球、玻璃破碎、光的折射和燃烧等中,我们的方法能够生成具有更真实物理动力学、无形变人体运动以及准确物体交互的视频,并能有效刻画力的传递、材料形变、光的折射和火焰传播等物理现象。
与现有的开源和闭源模型相比,PhyGDPO 在从人体活动泛化到复杂物理事件方面表现出更强的能力。更多视频结果请参见我们的项目主页。
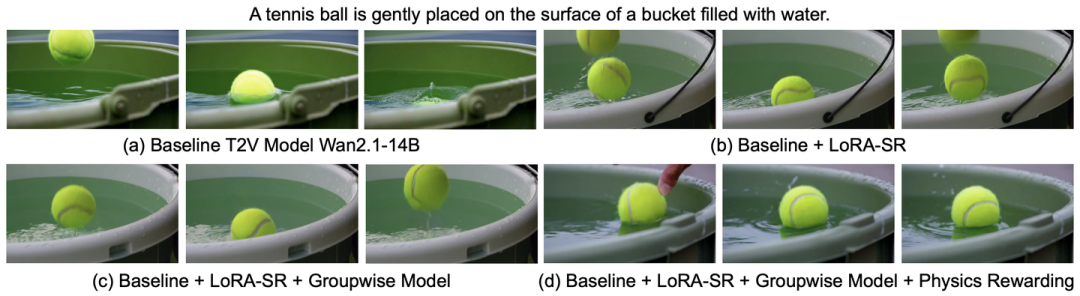
图8. PhyAugPipe 消融实验
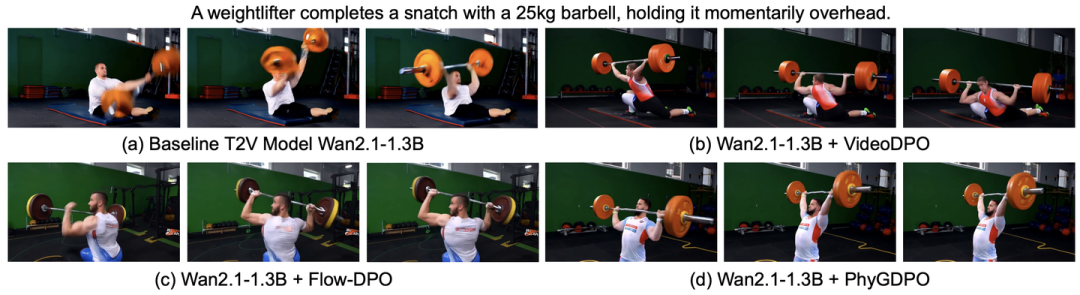
图9. PhyGDPO 消融实验
PhyAugPipe 和 PhyGDPO 的消融实验如图 8 和 图 9 所示。当我们逐渐将我们设计的方法应用上去时,生成的视频的物理合理性及一致性都相应地增强了。
4. 结语
本文聚焦于一个具有挑战性的问题,即物理一致的文本生成视频(T2V)任务。我们不使用大语言模型对提示词进行扩展,因为我们的目标是开发视频生成模型自身的隐式物理推理能力。
为此,我们首先提出了一种数据构建方法 PhyAugPipe,用于收集训练数据集 PhyVidGen-135K。该数据集包含超过 13.5 万个文本—视频数据对,涵盖丰富的物理交互与物理现象。随后,我们构建了一个具有理论依据的组级 DPO 框架 PhyGDPO,并引入了 PGR 和 LoRA-SR 两项技术设计。PhyGDPO 在 PhyVidGen-135K 上对 Wan2.1-T2V-14B 模型进行高效后训练,从而提升视频生成结果的物理合理性。
实验表明,我们的方法在定量和定性评估中均优于当前最先进的方法,并在用户研究中获得了更高的人类偏好投票。