分久必合:统一伪造图像检测 | Unified Fake Image Detection
周吉喆 2026-08-31 23:27 江苏
本文作者:周吉喆
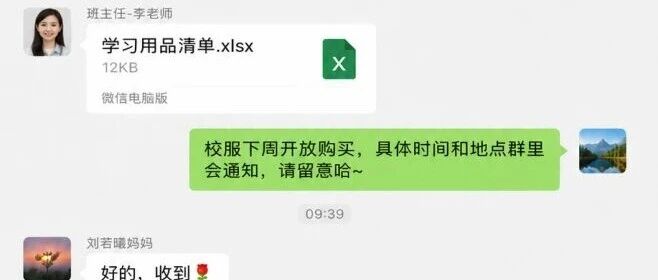
大家猜猜看下面这张聊天截图用了什么伪造手法:
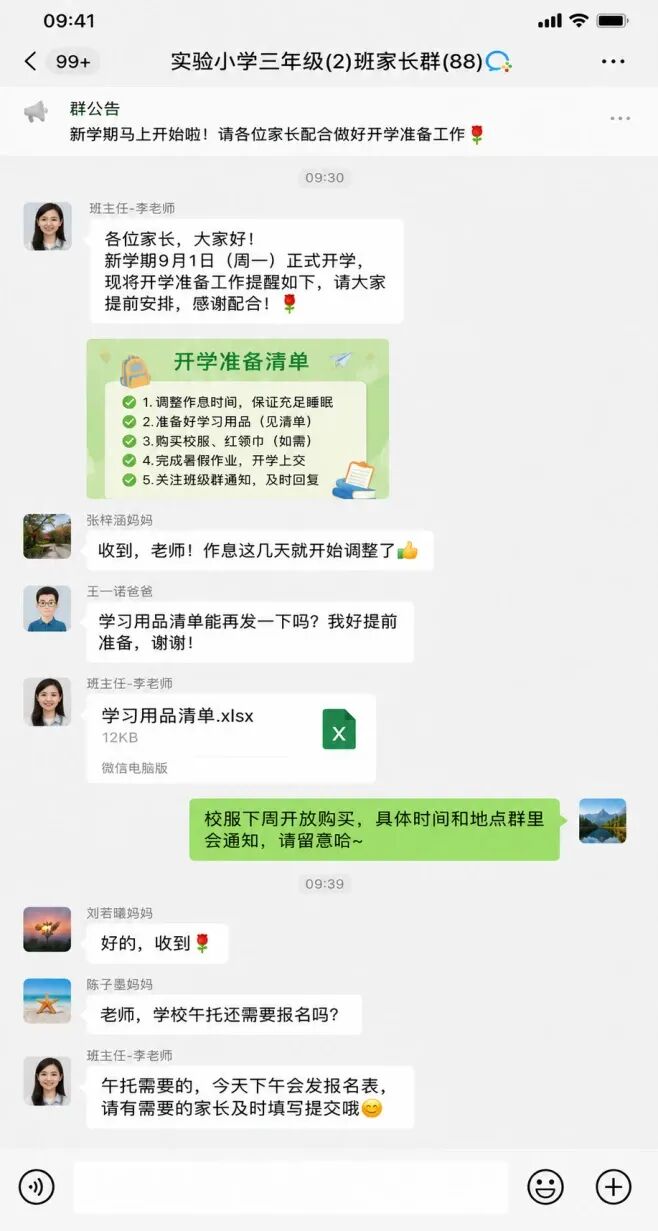
选项:
两张聊天截图(真图)进行了拼接(把 A 班级群的信息嫁接到了 B 班级群上)
PS 了部分家长的聊天内容(文档篡改)
更换了老师的头像(Deepfake)
直接 AI 模型生成了一张图(AIGC)【正确答案】
A+D/B+D/C+D……即模型生成一张图之后,又进行了各类手动 / 半自动 PS 修正内容
(应该)有点小难选的吧~~~
需要说明的是,你的答案对应了你需要调用什么样的伪造图像检测模型,因为现有的图像被动取证研究基本拆分为了多个独立的赛道,这些赛道主要包括但不限于 AIGC 检测(整图生成),(自然)图像(部分)篡改检测,(纯)文档(图像)篡改检测,Deepfake(伪造人脸)检测等[1]。而且这些赛道的模型是不互通的,也就是一个图像篡改检测模型不能检测文档篡改图像,一个 Deepfake 检测器也对 AIGC 的人脸不起效,以此类推[1]。当然你可以硬用 deepfake 检测器检测 AIGC 图像,只不过结果是类似随机猜测,没有参考价值而已。
一、悖论的出现
那么在实际中,对这张聊天截图进行真伪的检测就陷入了一个「预判悖论」:
用户需要对图像的伪造手段进行判断,以调用正确取证模型得到结果;但,如果用户都能预判图像的伪造手段了,那用户还何必需要取证模型呢?
这个悖论的解决方案也极其直接:
构建一个统一伪造图像检测(Unified Fake Image Detection,下称 Unified FID)模型,也就是不预设图像的伪造手段,对任意方法伪造的图像都可进行检测。那么实际中用户也只需将需要检测的图像输入一个 Unified FID 检测器,就能得到相应的结果。
其实我认为「伪造图像」这个词本身就有统一的意思——它代表对伪造类型不设限,此前在学术上也没有人定义过伪造图像。但经过和吕建成老师的讨论,我还是把「统一」单独强调出来,作为这个任务的核心思想。
二、图像被动取证赛道的分与合
在我们继续深入 Unified FID 之前,有一个必要讲的问题是,为什么图像被动取证领域或者叫内容安全领域发展成了(至少)四条完全独立的赛道呢,难道研究者们没有考虑实际应用情况?
然,天下大势,分久必合,合久必分。
正如实际场景将所有检测方案推向必然统一一样,对不同伪造手法发展出完全独立的检测方案也是技术发展的必然。
内容安全 / 被动取证 / 图像伪造检测技术的发展趋势归因于伪造手段的边界从明确到模糊的变化。或者简而言之,是大模型能力快速发展所导致的拟像效应:伪造手段逐渐走向黑盒化和统一化,都变成由大模型代劳的模式。
2.1分:伪造手段边界明确的年代
只需要将时钟回拨一两年,其实大家就能看到,对应不同内容的伪造图像,基本要采取不同的伪造方式。比如人脸伪造,除了 Deepfake 的效果以外,如果你采用 PS 等方法,基本都是一眼假的效果,根本没有检测的必要,人眼就能分辨。而对于文档图像,则必须要逐字手动 PS,保证字体、大小、色号等的一致性,如果简单使用生成模型,那么一定是连基本的字形都生成不对的状态。
因此,这时的需求也很明确,对应不同的图像,其实伪造的手法是相对固定的,针对这一系列伪造手法构建对应模型不仅效果好(专用性强),而且成本低。于是慢慢科研上就对不同的伪造手法发展出了独立的四条赛道,虽然有部分重复的地方(比如图像篡改的 inpainting 也包含了 AI 模型直接生成),但基本都互相独立:训练数据独立,模型方案独立,测评数据和方式也独立,而且在使用中也不会导致任何困扰。
2.2合:大模型抹平了伪造手段的边界
然而随着以 GPT-Image-2 为代表的生成与理解统一模型以及大量 harness 工具的上线,大模型直接根据用户需求完成图像伪造的能力得到了质变。以香港保险行业的数据为例,今天绝大部分用于骗保的高质量(肉眼难以分辨的)伪造图像都是由大模型直接完成的(伪造就医证明、伪造索赔金额、伪造保险记录等)。这以前是手动 PS 的活,而 PS 的学习和时间成本都很高,且不是所有场景都适用,但是现在都直接大模型代劳了,而且完成的很出色。导致了现有伪造图像 低大高强 的典型特征:门槛低,数量大,定制化程度高,欺骗性强。
大模型时代下伪造图像的总体特点 ·「低大高强」:门槛低,数量大,定制化程度高,欺骗性强。
大模型的能力基本覆盖或者模糊了以前图像伪造手段的处理边界,就是对任意内容的图像,其实都大模型代劳即可。
当伪造手段走向统一的时候,伪造检测手段也必然走向统一。
三、统一伪造图像检测任务的BP定义
3.1统一伪造图像检测 = AIGC 检测吗
既然都是大模型伪造,那么 Unified FID 是不是就是一个 AIGC 检测模型呢?
答案是否定的:
大模型伪造能力主要得益于 harness 工具而非简单的 diffusion 生成。大模型借助理解能力,会在生成的过程中不断监测图像内容是否完美符合用户需求,并且通过 harness 层不断自主调用各类工具修正图像内容,包括抠图,重绘,deepfake 换脸等工具。绝大部分大模型会为此调用数十项工具对图像内容进行精修,比如 codex 的单图生成往往花费数分钟之久,就是各类工具不断调用对生成过程进行约束的结果。而 AIGC 图像往往被限定为大模型一次性生成的整张图像。这里包含两个要素:一是整图,不包含大模型在真实图像上的二次或者局部伪造;二是一次性,不考虑大模型调用工具基于生成—理解循环对图像的各类逐步修正。
因此,现有的大模型伪造图像并不简单 = AIGC 图像,而是完全包含了 AIGC 图像。其次,在很长时间范围内,我们在互联网上面对的都是一个混合环境,也就是有很多大模型伪造的图像,也有很多是手工、小模型伪造的图像。其一,历史上已经积攒了大量非大模型时代的伪造图像;其二,不能有关于图像伪造手法等的其他信息标注在训练数据中。此外,虽然大模型能力不断强化,但至今仍不能完全取代手工、特定模型等的篡改方案。比如,目前最强的文档伪造手段依然是手工抠图 + PS 的方案。如果只能处理大模型伪造的图像也并不能实现 Unified FID。
那么 Unified FID 任务到底是什么呢(BP 定义):
3.2B:Binary Classification
首先,从任务范式上(B: Binary Classification):
Unified FID 是一个图像二分类任务,输入图像,输出该图像对应的 0/1 分类标签。
也就是 f(x) = y, x = image, y = 0/1 的范式
这个范式里面代表:
标准训练数据集的构成为(图像,标签)/ (x, y) pair,即:
模型只读入图像,然后直接预测该图像对应的 0/1(真/伪)标签。
不能有关于图像伪造手法等的其他信息标注在训练数据中。
但是自监督 / 半监督 / 无监督的方法辅助获取伪造手法等额外信息用于辅助提升分类准确是完全合理也可行的。
利用预训练大模型获取其他相关信息也是合理且可行的,只要保证训练集 / 测试集输入均只有图像本身,额外构建 prompt engineering、post-training 等方法利用基座大模型攫取额外图像信息不会对任务范式造成任何影响。这相当于是基于大模型强化了
f(·)函数,使其可以从x中获取额外信息。
3.3P:Polymath
其次,从模型性能上(P: Polymath):
Unified FID 要求一个通才模型同时超越多个专才模型,也就是一个统一的模型要在各个子领域上,比如典型的我们前面说的四个子领域:Deepfake、AIGC,篡改和文档篡改,同时超越各自子领域的 SOTA 模型。这样一个模型才是真正在实际中有应用价值的模型。
在有了定义之后,Unified FID 任务貌似有很多简单直接的实现方式,比如直接选一个基础模型在拉通的数据集上进行 fine tuning / post training 好像就行了。
但迄今为止,专才打败通才是常态,构建一个能超越多个专才的通才模型,是很难也很罕见的。
四、统一伪造图像检测任务的研究蓝图
那 Unified FID 到底难在哪里,我们下面将梳理研究蓝图(blueprint)并逐点分析:
技术路线可以比较清晰的分为三条:
单体小模型路线、大模型路线、大小模型协同路线
4.1单体小模型路线
这是目前我们研究最深入的一个路线,因为这个路线首先有一个非常强的领域直觉,就是图像被动取证这些子领域都在学习同一个东西 :artifacts,也就是伪造手法在图像上留下的痕迹。既然大家学的东西都是相通的,那么每个子领域现在都有这么多非常 work 的专用小模型,是不是可以通过将数据集和训练设定对齐拉通的方式,筛选出一个最强小模型,然后在 Unified FID 的数据集上训练就解决问题了呢?
这个思路非常有直觉,而且也很有意义,因为筛选最强单体小模型的过程能帮助我们提炼大量 insights,这对未来如何构建 Unified FID 专用的基座大模型是非常有帮助的。
但是通过我们从 ForensicHub 的测试来看,基本上没有任何一个子领域 SOTA 模型能实现我们 P 的要求。哪怕将所有子领域数据和训练设定打通,也没有任何一个子领域模型能强到通吃其他子领域的模型。简而言之,就是即便用 B 子领域数据训练 A 子领域的模型之后,A 子领域的模型也打不过 B 子领域的原有模型。甚至经过我们大量实验,把 ABCD 所有子领域数据都喂给某一(A)子领域模型后,他们性能却发生了明显下降,尤其在该(A)子领域本身下降极其明显。我们在 ForensicHub 上就发现了这一现象,然后在 SICA 中管这一发现叫做领域负迁移,也就是只要混入了其他域的训练数据,模型性能必然会下降。领域负迁移现象的存在说明,依靠现有模型和数据拉通训练的方案是注定无法实现 Unified FID 的[2]。
但是等等,这个思路至少在一开始我们直觉上是非常正确的啊~所以,应该是直觉错了么?
为此,我们在 SICA 中做了大量实验摸索:
首先,我们 linear probe 了子领域模型在拉通数据集训练后的特征空间,发现所有这样训练后的模型特征矩阵都存在比较明显的秩问题,SVD 分解后前 20 维特征共线性都较强(特征冗余太多,表征能力不足),表示模型其实没学到太多有用的 artifacts 特征。
其次,我们探查了上述模型在拉通数据训练过程中的梯度情况,发现了明显的梯度冲突,不同子领域数据对模型的梯度更新方向完全相反,导致模型梯度在训练过程中基本沿着妥协方向缓慢下降,表示模型在训练过程中梯度更新是混乱且并未真正 converge 或者达到 optimal 的。
最后,我们探查了各个子领域非常有效也常用的手工特征,他们不仅不相同,甚至互相不能迁移,比如 deepfake 的 rPPG 人脸生理特征就根本无法迁移到自然图像或者文档篡改领域上,表示不同子领域中,各种 artifacts 本质上确实就是有特异性的。
综上三点,我们得出结论:
是的,我们的直觉确实错了——
图像被动取证这些子领域都在学习同一个东西:artifacts——虽然在不同子领域他们都叫同一个名字,但是其实特征表达上完全不相同,也就是 artifacts 在各子领域其实非常异构。
吉喆现象(Ji-Zhe Phenomenon)
我们在 ICML26[2] 中首次明确了 artifacts 的异构问题,并管这种 artifacts 在各子领域异构的这个现象叫吉喆现象(Ji-Zhe Phenomenon)。
吉喆现象在单体小模型中必然会导致一个结果——特征坍塌,也就是模型基本只会学习各个子领域共同的特征表达,放弃学习每个子领域独特的 artifacts 表征(特异性),最终学到的 artifacts 特征是一个平均/退化后的表达,导致 artifacts 特征坍塌(到平凡解 trivial solution),不再对各种篡改手法均有效(没有区分度)。简单说就是模型只能尝试为异构的 artifacts 建立一个公共/共享表征,那么结果就是对所有 artifacts 都有点效果,但是也都没有特别好的效果。
科学问题所以,单体小模型的核心难点不在于数据对齐和训练模式拉通,而在于如何构建一个模型能在一个单体 / 统一的特征空间中,有效表征这些完全异构的 artifacts 特征(即统一表征又不丢失差异/异构性)。这是一个典型的特征坍塌科学问题,从避免坍塌、检测坍塌和解除坍塌三方面都有很多可能的解决方案(比如梯度手术、特征亲和、坍塌恢复等)可以研究,我们在 SICA 中对此提出了一个避免坍塌的假设并进行了实现和验证\[2]。大家有兴趣可以移步论文详细阅读,我就不再赘述。我个人感觉这是未来
Unified FID研究会集中涌现的关键问题点。
4.2大模型路线
这是目前我们投入最多的方向,因为:
首先,大模型本身良好的 OOD 泛化能力是解决被动取证领域长期泛化性难点的关键。
并且,大模型有着超大的特征空间,可以有效解决吉喆现象。也就是可以将特征划分到各个正交或者完全不相交的子空间中去,这样就不会导致模型在统一性和特异性中做两难选择了,有效绕过了特征空间坍塌问题。
此外,大模型本身良好的对话、用户意图理解和 agent 调用能力,所以在对检测结果的迭代、解释、审计和外部工具协作上都潜力非常好,非常具备使用价值。比如可以让大模型做了检测之后自动给出对这个检测结果的解释以及调用外部物理 agent 或工具去审计核验这个解释是否正确,然后继续修正检测结果,这样构成一个 agent-base model 的 harness 环,非常完美。
目前我们上线的 DeFakerOne 大模型也就是根据这套思路做的[3]。
然而大模型除了训练成本问题以外,大家可以看看我们的 tech report,主要可以继续深入的科学问题在于如下两方面:
科学问题
模型坍塌(能力退化):大模型在
Unified FID中存在模型能力退化问题,我们叫他模型坍塌。也就是从一个 MLLM 基座大模型开始,我们使用大量数据进行 post-training 或者 sft 之后,由于Unified FID是一个纯粹的 B(图像二分类)任务,这个基座大模型逐步会丧失包括 next token prediction,prompt understanding,in-context learning 在内的一系列的核心能力,退化为一个只会二分类模型,也就是退化了一个参数空间极大的小模型。
这种能力退化或者模型坍塌会导致极其严重的后果,比如大模型的 OOD 数据的泛化能力、大模型对检测结果的自动解释能力、大模型根据用户上下文对检测结果的修正能力、大模型调度 agent 对检测结果进行审计等的可能性都完全丧失了。或者更简而言之,这个模型就不会说话,也不能理解用户指令了,只会机械地对图像做二分类了,完全偏离了我们使用大模型的核心初衷。
在 post-training 阶段这个模型坍塌问题的本质机理我们目前还在探索中,这个问题应该不仅会存在在取证方向上,很多垂直领域随着训练数据量的积攒应该都会有类似问题慢慢出现。这是一个非常有价值也比较难的研究方向,欢迎大家一起讨论。
科学问题
推理效率:大模型的处理效率至今难以提升。在实际场景中,对伪造图像的检测业务会存在明显的波动,有明显波峰波谷。比如,一些生活服务平台在特定日期的优惠活动(比如教师节老师吃饭打折),这就会在短时间(1-2 天)内涌入海量(百万量级)的检测需求(因为需要上传教师证核验资格,而教师证的伪造基本各类大模型都能帮你做)。大模型检测图像基本在秒级响应,以 5 秒检测一副图像计算,100W 数据需要 500W 秒也就大概 58 天时间。
因此,如何对大模型路线下的 Unified FID 模型做推理加速也是一个核心问题。剪枝、并行、硬件尤其国产硬件加速等都是这个问题下的高潜力研究方向。
4.3大小模型协同路线
这是一个最直接、最不绕弯子的路线——反正我们各个子领域都有 sota 了,那就通过大模型路由调度一次吧,把小模型检测结果综合反馈给大模型判断即可(MoE 思想)。目前 Unified FID 除我们组外,很多强组(包括但不限于港中深吴保元老师、中科大谢洪涛老师、北邮张继威老师、北大深张健老师等)都走了这条路线,大家可以多follow他们的工作。
这条路线是目前发展最迅速的方向,也是最快能出成果的方向。需要继续深入研究的两个科学问题在于:
科学问题
短板 / 木桶效应问题:大小模型协同的上限天然受制于单个领域小模型的天花板和大模型的路由能力。导致现有方案很难满足 Unified FID 的 P 需求。所以如何让大模型以更优的方式调度小模型以及综合各个模型结果,使其可以超越单个 sota 模型的性能上限,成为了要解决的核心科学问题。后续研究应该会在大模型对小模型的多轮调度、优先级调度,以及大模型对小模型返回结果的自回归、冗余、可信判定等方向集中涌现。
科学问题
协作框架生长 / 兼容问题:被动取证各个领域最近疯狂发展,小模型快速迭代更新,如何让大小模型协作框架能够不断生长,兼容新出现或更新后的 sota 小模型以及新的 agent 是一个迫切需要研究的核心科学问题。或者更直白一点就是,大模型应如何持续学习以了解新的小模型或 agent 的能力范围,保证自己的路由策略和综合判断始终最优。这是一个非常有意义的研究方向,这个问题也适用于目前如火如荼的 agent 领域,有非常巨大的研究潜力和应用前景。
五、写在最后
综上我们大概梳理了 Unified FID 这个任务的背景、定义、三条技术路线、各个路线对应的科学问题以及潜在的解决方案。这相当于为我们组过去 1-2 年的关键研究工作做了一个快速总结和对 Unified FID 问题的阐述做了一个简单的开场。关于 Unified FID 一些具体技术路线的可行性分析和潜力研判我会放到后一篇博文继续深入分析。
因为最近收到了很多邮件询问相关问题,所以我的第一篇博客比较长,对目前 30 多封邮件中的几乎所有问题都做了解答,可能有所遗漏和谬误,也欢迎大家联系我进行指正和修改。
后续有时间我会写一个英文博客,目前海外也有很多研究者对 Unified FID 方向有一定兴趣。不过最近应该写不出来了~希望他们就将就下,直接大模型翻译吧~
Last but not least,感谢冯文韬、吴保元、杜侠、潘治文老师对博文的建议和帮助。感谢杜博、杨哲、朱学康对博文的校对和补充。
感谢大家的耐心阅读,欢迎批评指正。
参考文献
[1] Bo Du, Xuekang Zhu, Xiaochen Ma, Chenfan Qu, Kaiwen Feng, Zhe Yang, Chi-Man Pun, Jian Liu, Jizhe Zhou. ForensicHub: A Unified Benchmark & Codebase for All-Domain Fake Image Detection and Localization. NeurIPS 2025, Datasets and Benchmarks Track. arXiv:2505.11003. github.com/scu-zjz/ForensicHub.
[2] Bo Du, Xiaochen Ma, Xuekang Zhu, Zhe Yang, Chaoqun Niu, Jian Liu, Ji-Zhe Zhou. Can We Build a Monolithic Model for Fake Image Detection? SICA: Semantic-Induced Constrained Adaptation for Unified-Yet-Discriminative Artifact Feature Space Reconstruction. ICML 2026. arXiv:2602.06676. github.com/venus-guangjian/SICA_OpenMMSec.
[3] Venus-DeFakerOne: Unified Fake Image Detection & Localization. arXiv:2605.14091, 2026. github.com/venus-guangjian/Venus-DeFakerOne.