当大模型用于灾害遥感:谷歌GeBDA实现端到端密集建筑物定位与毁损定级,F1接近SOTA专用模型
原创 CV君 2026-08-31 23:27 江苏
最近吉隆口岸的地质灾害引发全球关注,本文介绍一篇最新的VLM用于灾害遥感的谷歌的新作。
自然灾害救援“兵贵神速”,利用卫星遥感影像迅速绘制建筑物毁损地图关乎生死竞速。然而,传统遥感方案高度依赖单一任务的专用密集预测网络(如 UNet、ChangeMamba 等),虽精于像素分割,却缺乏通用大模型的语义推理与交互扩展能力;而现有的地理空间多模态大模型(GeoVLM)在面对成百上千个微小建筑物时,极易陷入自回归长序列带来的“空间漂移与幻觉”,往往不得不退化为场景级粗略计数或依赖外部检测模块。
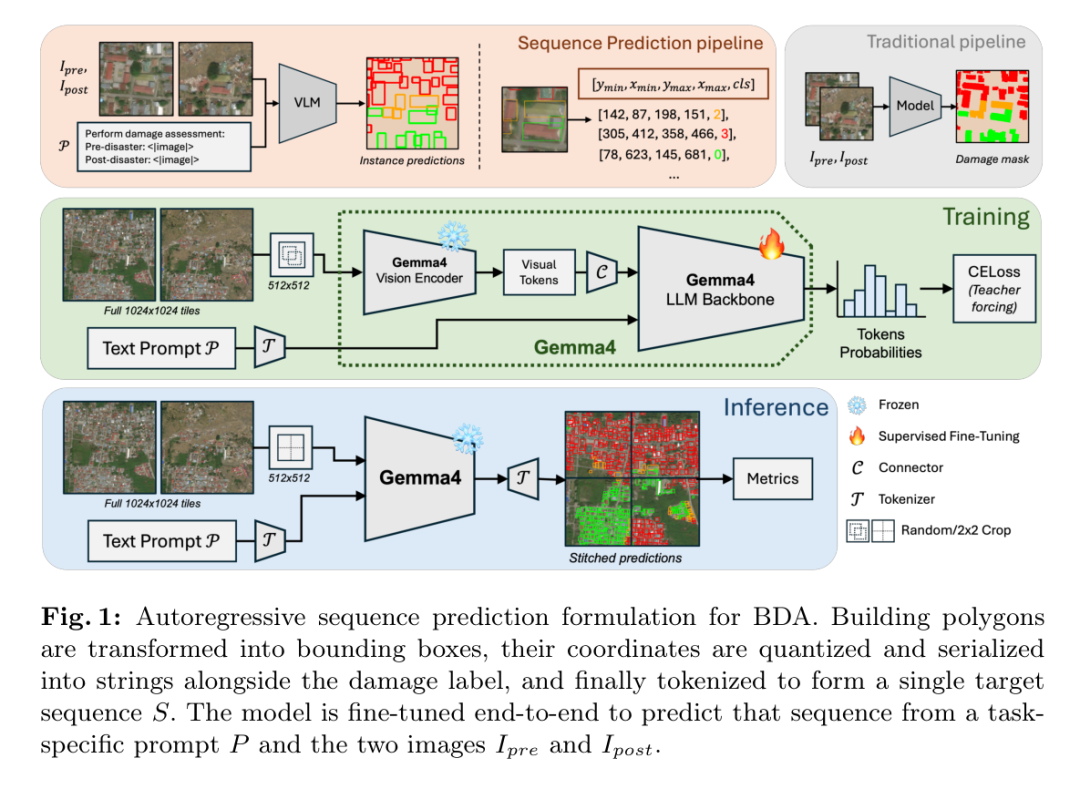
为此,苏黎世联邦理工学院与谷歌联合提出了 GeBDA(Gemma + Building Damage Assessment)。该研究彻底颠覆了挂载“专用检测/分割头”的传统思路,将双时相密集建筑物定位与多级毁损判定完全重构为单一的纯文本自回归序列预测任务。
在权威光学基准 xBD 上,GeBDA 取得了高达 72.49 的栅格化像素级毁损分类 F1 得分,不仅显著超越了经典密集网络 UNet(66.50)与 ChangeOS(71.34),紧密逼近当前 SOTA 专用模型 ChangeMamba(73.58),其定位指标(78.34)更逼近了外接矩形表示下的几何理论上限(Oracle 82.60),展现出通用多模态大模型直接胜任密集空间遥感任务的巨大潜力。
背景与动机:密集空间感知中的长序列困境
在遥感图像解译中,建筑物毁损评估(BDA)通常需要模型同时完成两项子任务:在灾前影像中准确定位每一个建筑物实例,并在灾后影像中判断该建筑物的破坏程度(如完好、轻度受损、重度受损、倒塌摧毁等)。
近年来,将视觉语言模型(VLM)引入地理空间观测领域已成为研究热点。然而,通用的自回归 VLM 在处理密集空间定位(Dense Grounding)时存在固有的技术瓶颈:
自回归误差累积与漂移:当一张遥感图像中包含成百上千个微小建筑物时,模型需要连续自回归生成数千个坐标 Token。长距离解码容易引发空间漂移、目标遗漏与重复预测等幻觉。
现有遥感 VLM 的妥协路线:现有工作通常退化任务设定,例如仅预测场景级受损统计、回答选择题,或者采用混合架构——由外部独立的检测模型先找出边界框,再交由 VLM 逐个判断毁损。
GeBDA 探索了一个核心问题:在不改变通用 VLM 自回归解码范式、不挂载外部分割/检测头的前提下,仅靠合理的文本序列化与端到端微调,通用多模态大模型能否直接胜任密集的端到端灾害评估?
方法详解:将几何与语义统一为纯文本序列
GeBDA 将传统的像素级密集分割任务重新表述为实例级的自回归序列生成任务。整个处理流程围绕坐标量化、文本序列化以及输入输出的 Token 预算管理展开。
1. 输入输出与数据序列化设计
输入(Input):配准后的灾前影像斑块 、灾后影像斑块 ,以及用于触发任务的文本提示词 。
多边形转换与网格量化:真实标注中的建筑物多边形首先转换为外接矩形边界框 。为映射到语言模型的词表空间,连续坐标被均匀量化到 的离散网格上()。
- 纯文本字符串序列化:每个建筑物 及其对应的离散毁损等级标签 被直接格式化为普通文本字符串:研究团队没有引入专用的坐标 Token(如
<loc_0>),而是直接复用文本中的数值字符表示,以充分利用 Gemma 原生预训练中的数值与空间先验。 - 输出(Output):将图像内所有 个建筑物的文本序列拼接,经由分词器 编码,并在末尾附加序列结束符(End-of-Sequence,
<EOS>),构成最终的目标预测序列 :
2. 模型架构与工程优化
GeBDA 基于开源多模态模型 Gemma 4(微调 Gemma4-E4B 变体)构建,包含一个 Transformer 语言模型主干与一个 150M 参数的 SigLIP 2 视觉编码器:
分块裁剪与分辨率平衡:单个建筑物的字符串表示最多占用 19 个文本 Token。为了防止密集区域发生 Token 爆炸并保持计算可行性,系统在训练时将 的大图裁剪为 的斑块。
视觉 Token 预算:视觉编码器设定 280 的 Token 预算,将斑块上采样至 并转换为 256 个视觉 Token,单图块最大可容纳 200 个建筑物的生成,兼顾局部细节与内存开销。
训练配置:保持视觉编码器参数冻结,使用 Adafactor 优化器对主干模型进行端到端监督微调(SFT),训练 25k 步,配合丢弃 95% 无建筑空白图块以及随机翻转、旋转等数据增强策略。推理阶段采用贪婪解码(Greedy Decoding)。
实验与结果:光学影像表现优异,跨模态联合增益显著
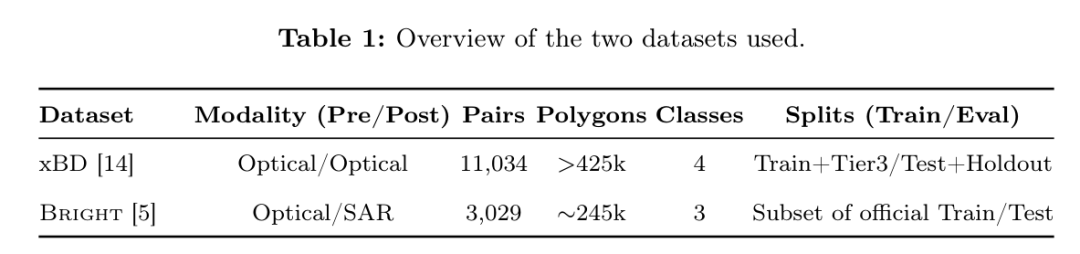
评测基于两个主流建筑物毁损评估数据集展开:xBD(双时相光学影像,4 类毁损定级)与 Bright(灾前光学/灾后合成孔径雷达 SAR 影像,3 类毁损定级)。
1. 定量性能与像素级对比
评测包含两种方式:一是实例级指标,使用匈牙利算法(Hungarian Algorithm,IoU 阈值 0.5)进行真值匹配并计算 与各类别的 ;二是将预测的矩形框栅格化为密集掩码,与专用分割模型进行像素级横向对比。
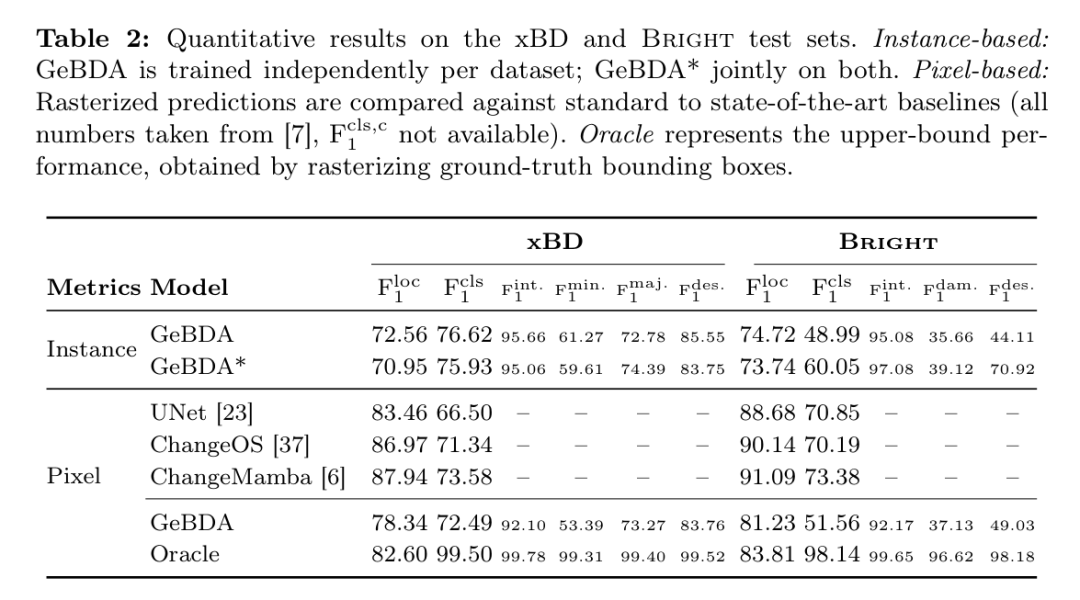
从 Table 2 的实验数据可以看出:
逼近专用网络性能:在 xBD 光学数据集上,GeBDA 栅格化后的像素级毁损分类指标达到 ,不仅显著超过了经典密集网络 UNet(66.50)和专用变化检测网络 ChangeOS(71.34),并紧密逼近前沿的专用模型 ChangeMamba(73.58)。
逼近外接框几何上限:在定位方面,由于将多边形转为矩形框存在固有的几何惩罚(Oracle 上限在 xBD 上为 82.60),GeBDA 的栅格化定位得分达到 ,已十分接近 Oracle 理论上限。
跨模态联合训练增益:在灾后采用 SAR 模态的 Bright 数据集上,由于冻结的 RGB 预训练视觉编码器对雷达散射特征表征不足,单数据集训练的 GeBDA 分类表现受限()。然而,当引入 xBD 与 Bright 进行联合训练后(即 GeBDA*),其在 Bright 上的分类得分大幅提升至 (相对提升达 22.6%),表明光学数据学到的空间聚集先验与定位能力能够有效跨模态迁移。
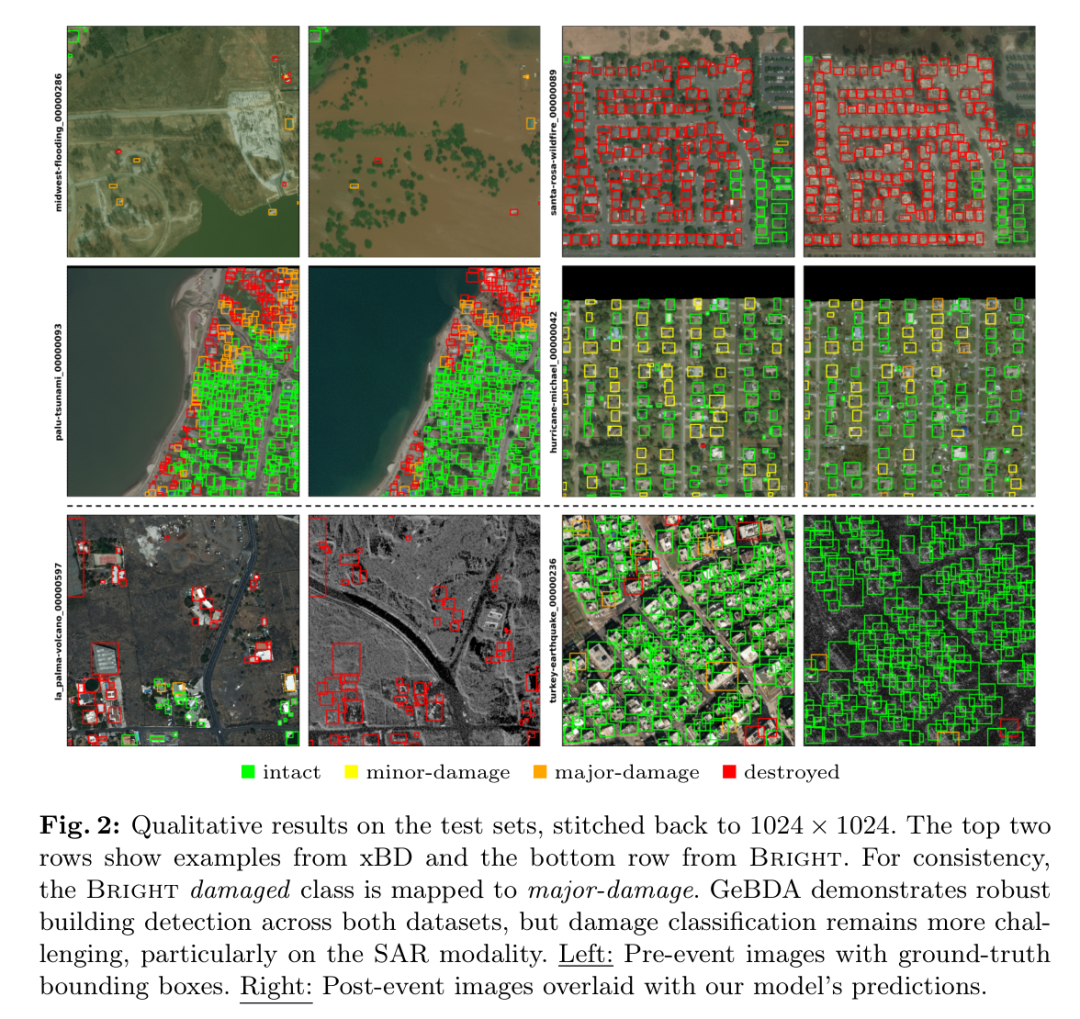
2. 宏观统计与两大失效模式分析
研究进一步对模型的预测行为进行了细致的诊断分析:
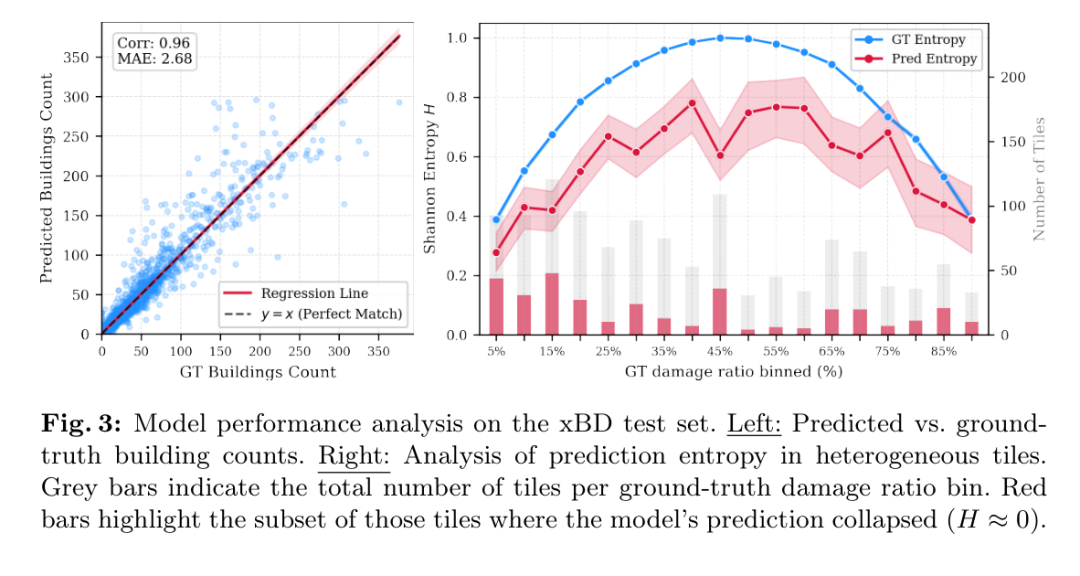
建筑物数量高度一致:Fig. 3 左侧散点图显示,模型预测的建筑物实例数量与真实标签之间呈现出高度一致的线性相关,说明模型具备稳健的实例级空间感知能力。
失效模式一:密集微小框循环生成:在个别建筑物极度密集的区域,自回归解码有时会陷入局部死循环,生成密集的小尺寸误报边界框。这与训练阶段设定的单图块 200 个建筑截断上限存在一定关联。
失效模式二:非均匀区域预测熵塌陷(Entropy Collapse):Fig. 3 右侧对非均匀图块的香农熵()进行了统计。当单个图块内同时包含完好与受损等多种不同状态的建筑时,模型倾向于低估毁损分布的熵,甚至在部分图块上预测熵直接塌陷为零(,图中红色柱状部分),即错误地将整张图块内的所有建筑物判定为同一种毁损等级。
3. 真实灾害场景的零样本泛化
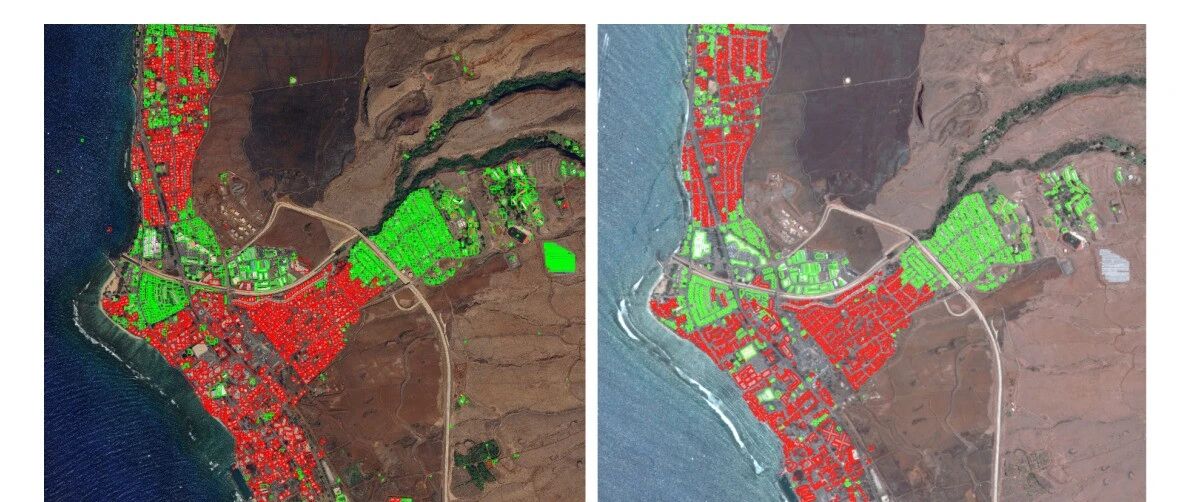
为检验模型在实际未知灾害中的实用价值,团队将 GeBDA 直接应用于 2023 年 8 月美国夏威夷毛伊岛山火的真实卫星影像(未包含在训练集内)。
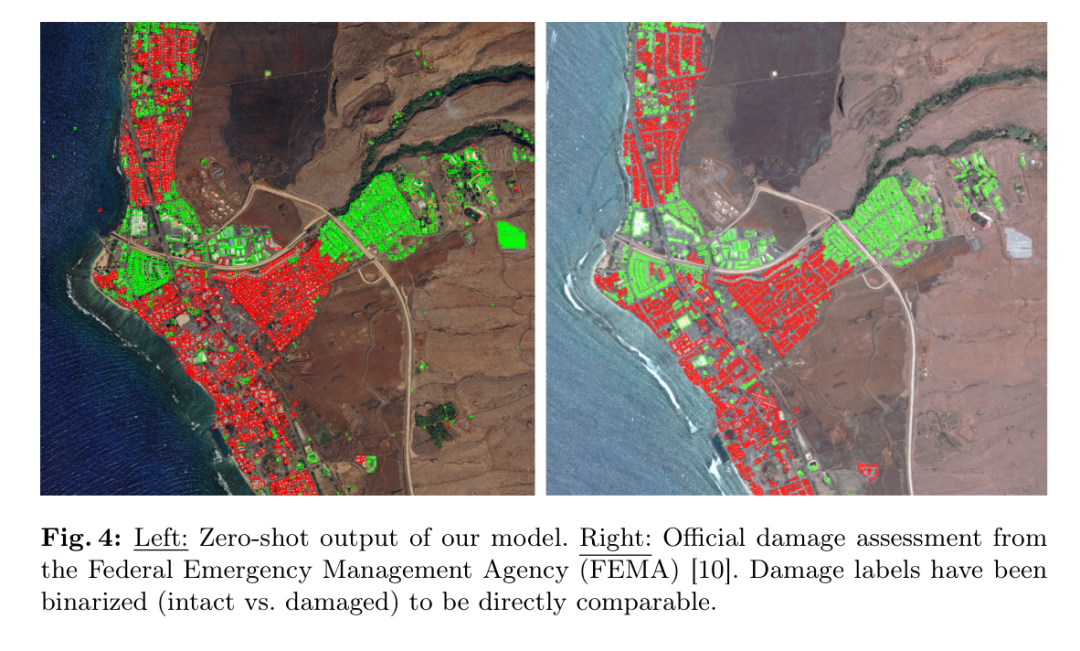
将预测标签二值化(完好 vs 受损)后与美国联邦紧急事务管理局(FEMA)发布的官方定级报告进行空间对照,GeBDA 在零样本条件下展现出了高度一致的灾害破坏区域边界与定级吻合度。
一点思考
GeBDA 为遥感大模型领域提供了一个简洁的技术参考:借助通用 VLM 原生的自回归序列生成能力,无需外挂复杂的检测头即可直接端到端解决密集建筑物的定位与灾害定级任务。
不过,从落地与工程角度来看,该方案仍面临若干有待改进的环节:
Token 编码效率:将坐标作为纯文本字符串序列化虽然保留了预训练先验,但单建筑占用最多 19 个 Token,对超大图推理和更密集的城区场景带来了显著的计算负担。
优化目标对齐:目前模型完全采用标准交叉熵损失,未来若能引入直接针对空间交并比(IoU)进行奖励建模的强化学习(RL)算法,有望进一步提升几何边界定位的精度。
参数高效微调扩展:结合 LoRA 等轻量微调方法,有望以更低算力将该范式扩展至更大体量的多模态基座(如 Gemma4-26B)并开放视觉编码器的全模态联合优化。
论文标题: GeBDA: Building Damage Assessment as Text-Based Sequence Prediction
所属机构: 苏黎世联邦理工学院、谷歌