阿里达摩院与清华浙大等提出ClinFusion:以视觉为中心的医疗多模态新范式,超越顶尖商业大模型
原创 CV君 2026-08-30 23:24 江苏
在现代临床中,从二维 X 光片、病理切片到三维 CT、MRI 序列,视觉证据承载了绝大部分关键诊疗决策。然而,现有医疗多模态大模型大多受制于单体编码器架构,在异构影像吸收与临床评估上面临严重失真。
为此,阿里巴巴达摩院、湖畔实验室、清华大学、浙江大学及宁波大学附属阳明医院等团队推出了以视觉为中心的全栈医疗多模态大模型系统——ClinFusion。该系统不仅在 24 项权威基准中斩获 20 项 SOTA,更在 16 项多模态评测中的 13 项超越 GPT-5.2 与 Gemini-3-Flash,并在 6 位资深放射科医生的 300 例盲态评审中综合得分位列第一,全面开源并树立了医疗 AI 临床落地的新标杆。
论文标题: ClinFusion: A Vision-Centric Multimodal LLM System for Holistic Medical Understanding
代码仓库: https://github.com/alibaba-damo-academy/ClinFusion(已开源)
项目主页: https://huggingface.co/collections/Alibaba-DAMO-Academy/clinfusion
背景与动机:医疗多模态的两大失真困局
在现有的医疗多模态大模型研究中,普遍存在两大关键瓶颈:
1. 异构视觉知识吸收不足
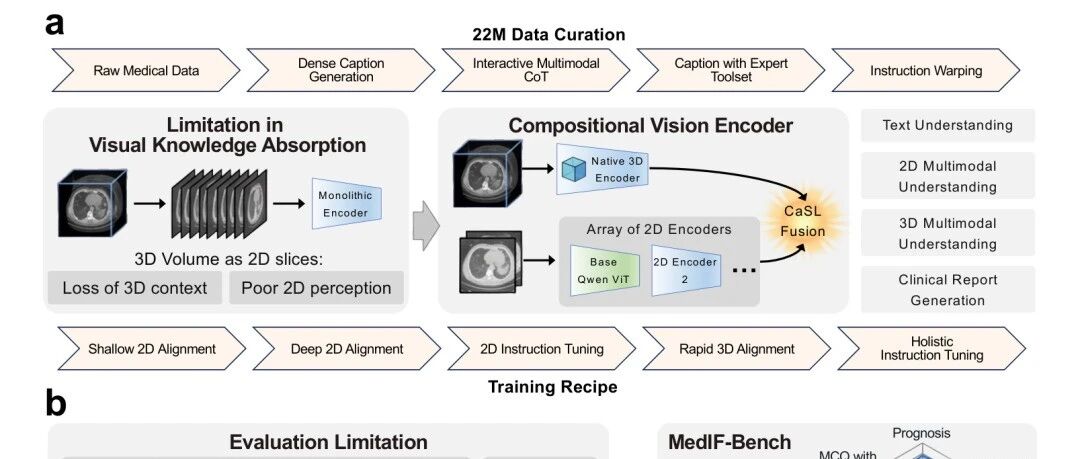
医学影像具有极高的异构性,既涵盖 2D 的 X 光片、皮肤病学图片、病理切片,也包含 3D 的体数据(CT、MRI)。现有的医疗大模型(如 Lingshu、Hulu-Med、LLaVA-Med 等)大多采用“数据中心”策略,即保持通用的单体视觉编码器(Monolithic Vision Encoder)不变,仅通过大量医疗图文对进行微调。
这种做法面临两难:若将 3D 体数据按 2D 切片打散处理,会丢失纵轴上的空间连续性与深度上下文;若直接强行压缩 3D 序列,又无法精准捕捉病理级别的细粒度纹理。
2. 评估体系与临床实操脱节
现有的评估方式存在两个致命盲区:
忽略指令遵循能力:许多模型在经过医疗领域微调后,指令遵循能力(Instruction Following, IF)严重坍塌,无法按照要求的格式(如结构化 JSON、特定报告 Header)输出,这极大限制了其在真实临床系统中的接入。
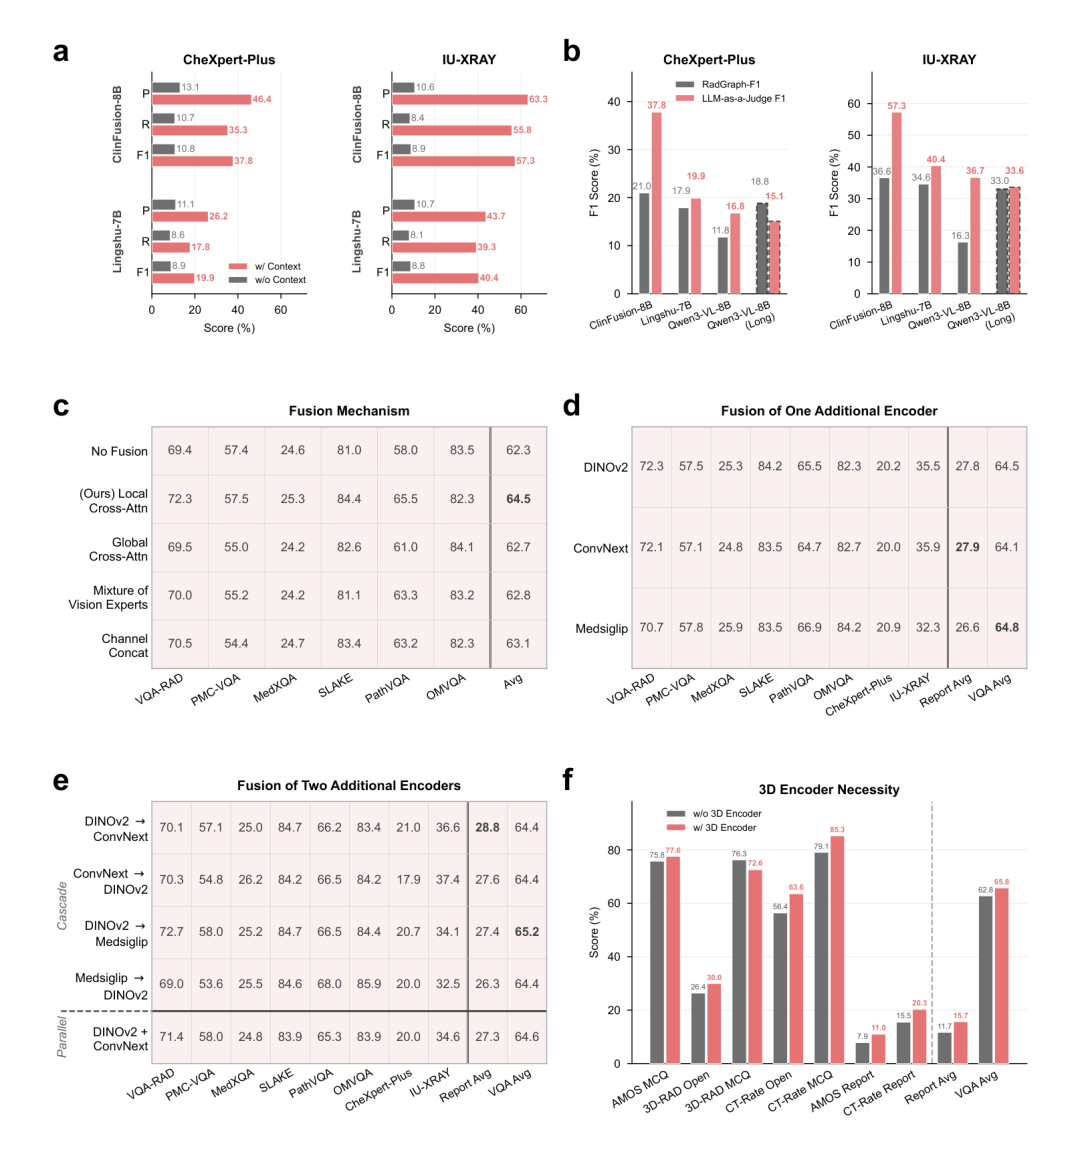
报告评估过于粗暴:传统评估让大模型在毫无患者背景信息的前提下“盲读”图像并生成整篇报告,再使用 BLEU、ROUGE 或 RadGraph-F1 等文本匹配指标进行打分。现实中,放射科医生阅片时必然会先查看申请单中的“临床适应症”(Clinical Indication),进而重点观察特定解剖区域。没有上下文约束的评估,会导致模型描述了参考报告未提及的区域时,被错误地惩罚为“假阳性(幻觉)”,无法真实反映诊断准确率。
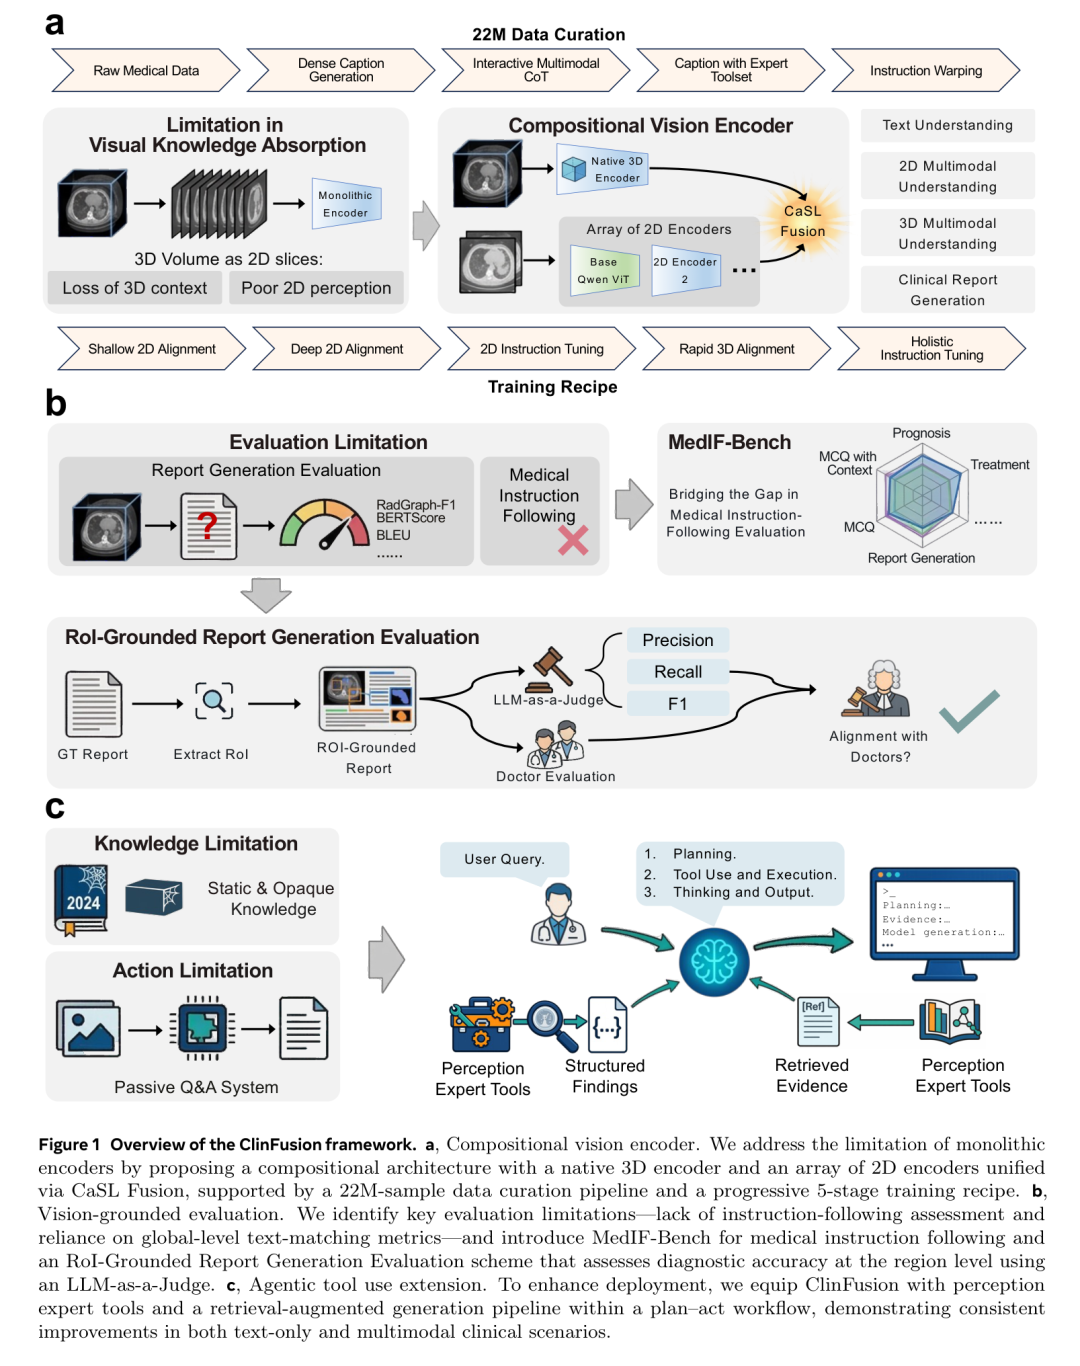
针对上述痛点,ClinFusion 提出了包含组合式视觉编码器、视觉锚定评估体系以及 Agentic 工具扩展的全栈解决方案。
方法详解:从组合架构到临床锚定评估
ClinFusion 的系统设计主要由三大核心模块构成:组合式视觉编码器、视觉锚定评估框架,以及 Agentic 工具扩展。
1. 组合式视觉编码器与 CaSL Fusion 算子
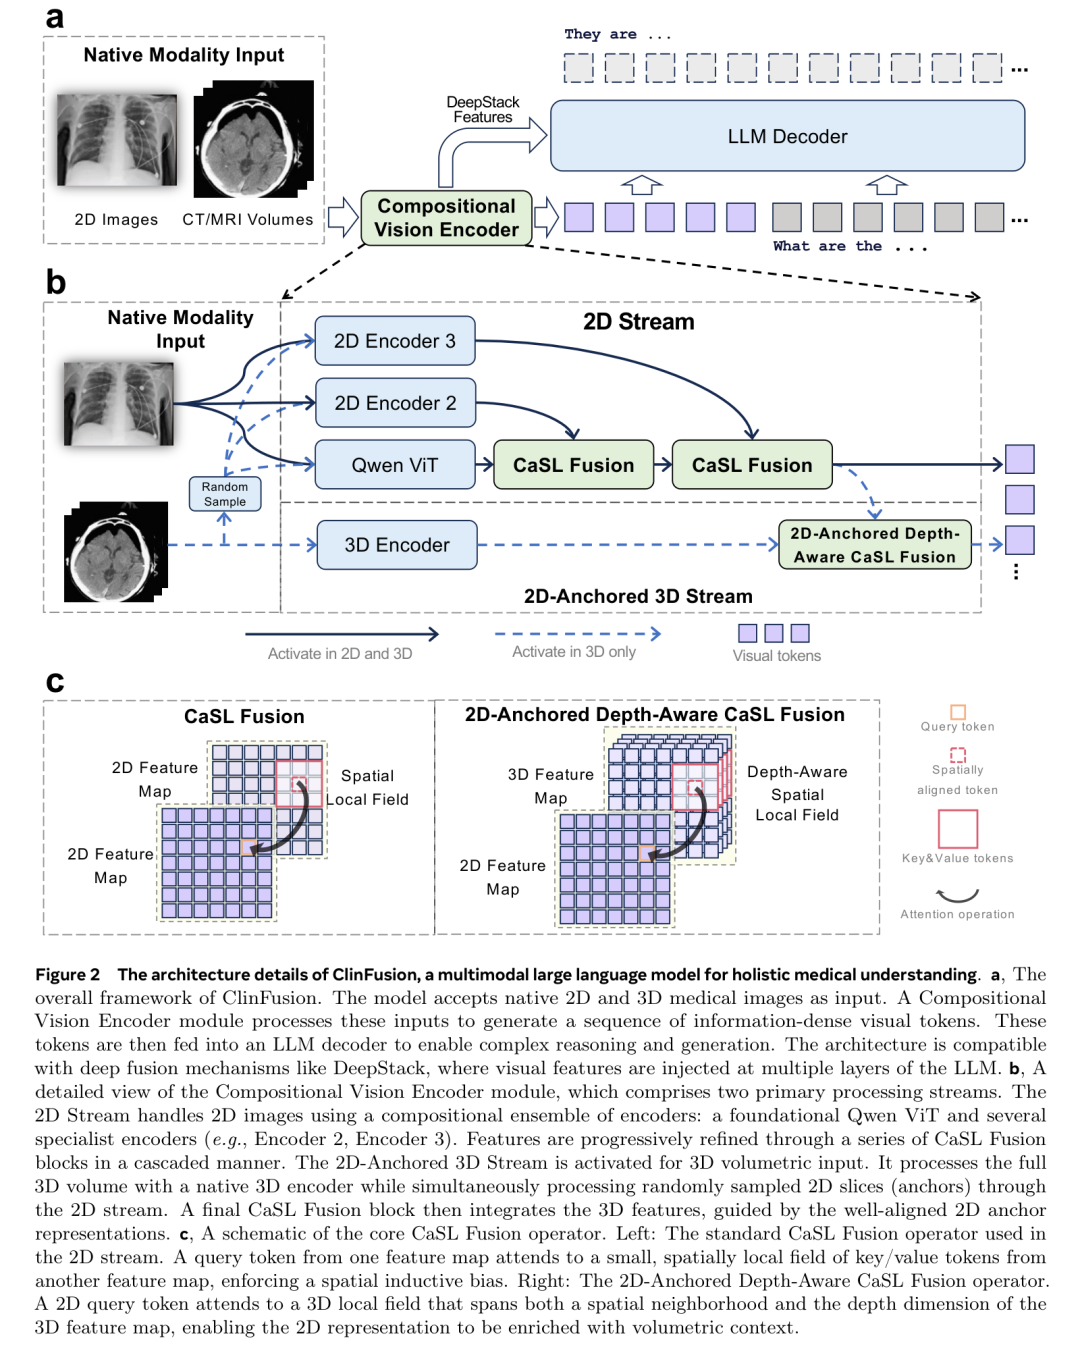
ClinFusion 摒弃了单体编码器方案,构建了一个由基础编码器与多个专家编码器协同工作的组合式架构。
输入与输出流程: 针对 2D 图像输入,系统同时将其送入基础编码器 Qwen ViT(提供全局对齐语义)、专家编码器 ConvNeXt(捕捉局部高频病理纹理)以及 DINOv2(提供无监督的稳健语义表达)。特征经线性投影和尺寸对齐后,通过 CaSL Fusion 算子进行级联融合,最终生成高信息密度的视觉 Token 序列,注入 LLM 解码器。
CaSL Fusion 算子机制: 不同于简单的特征拼接或全局交叉注意力,CaSL Fusion(记作算子 )采用了空间感知的局部交叉注意力(Local Cross-Attention)。设基础编码器特征映射为 ,专家编码器特征映射为 。对于 中的第 个 Token 作为 Query ,仅在 中以 为中心的 局部空间窗口内提取 Key 和 Value():
融合过程采用级联(Cascaded)方式顺次进行:为了防止模型过度依赖已对齐的 Qwen ViT 而忽视专家特征,训练过程中还引入了丢弃概率为 的随机残差正则化(Stochastic Residual Regularization)。2D 锚定的 3D 深度感知流: 针对 3D CT/MRI 体数据,ClinFusion 激活了“2D 锚定 3D 流”()。系统在全体数据中随机抽取 张 2D 切片作为“锚点”(Anchor),通过 2D 流提取已高水平对齐的 2D 锚点特征;同时,原生 3D 编码器(PE-3D)处理整个体数据生成 3D 特征体 。深度感知 CaSL Fusion 以 2D 锚点特征为 Query,在 的 3D 局部空间与深度窗口内提取 3D 特征。这种设计既继承了 2D 领域的丰富先验,又高效吸收了 3D 空间的纵向连续性。
2. 视觉锚定评估体系:MedIF-Bench 与 RoI-Grounded 报告评估
为了让评估结果贴近临床诊疗实操,ClinFusion 团队构建了全新的评估体系。
MedIF-Bench(医疗指令遵循基准): 包含 900 个精心设计的测试样本,覆盖选择题、上下文选择题、开放问答、预后评估、报告生成、SEER 分期和治疗方案推荐 7 大类别。基准采用严格的正则模式匹配(Regex Verification),专门评估模型对输出格式(如 JSON 嵌套结构、Markdown Header、置信度标注等)的遵循能力。
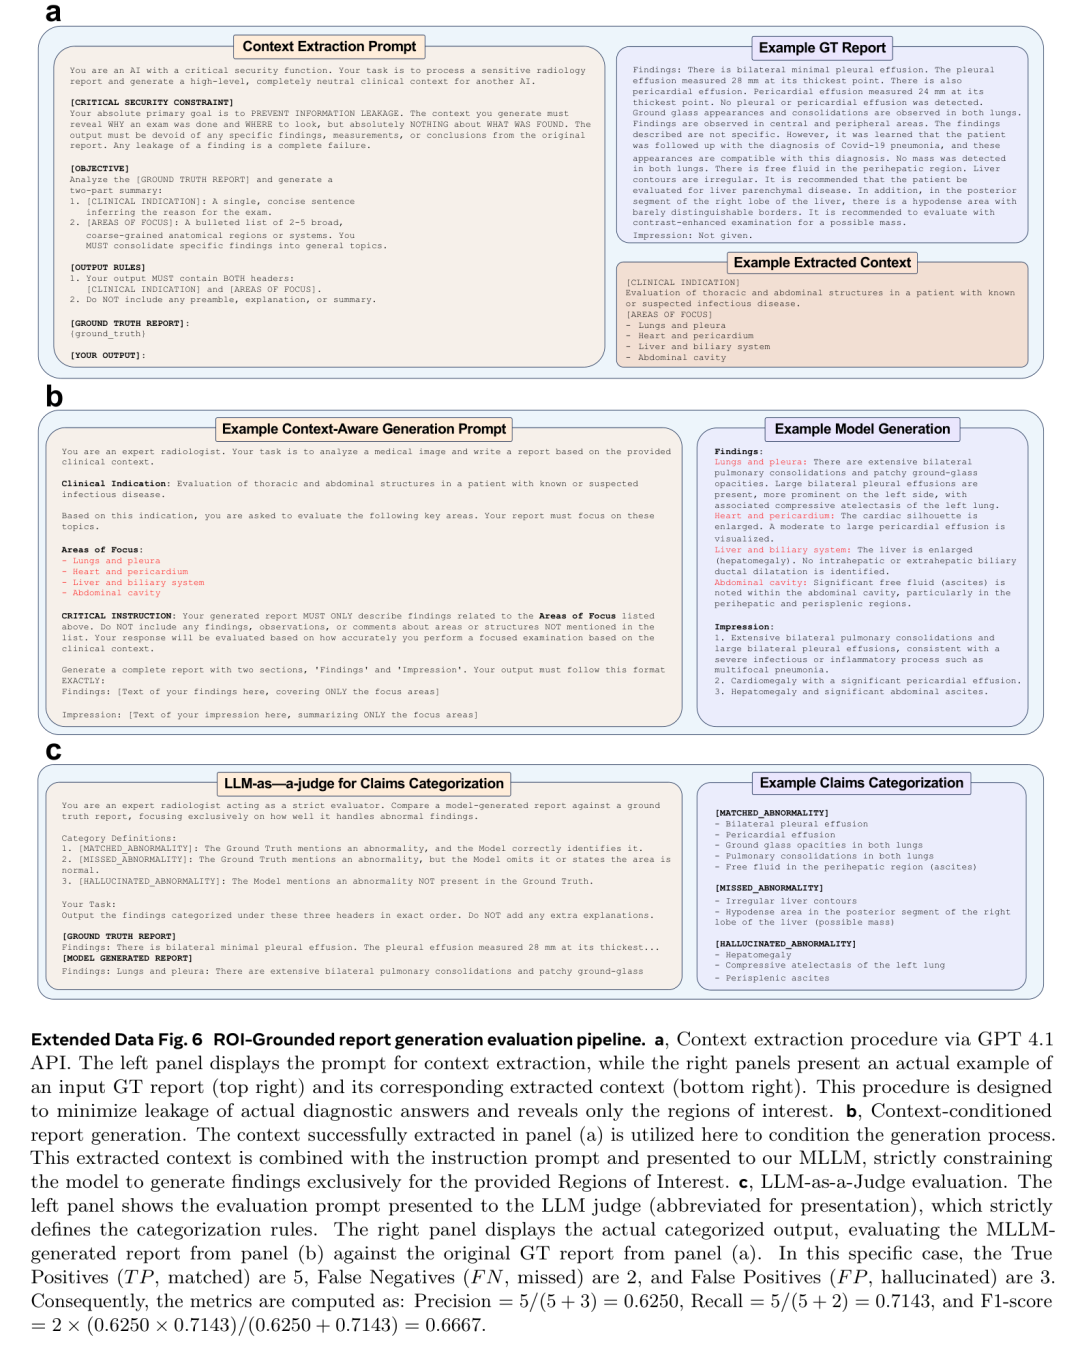
RoI-Grounded 报告评估框架: 评估流程分为三步:
上下文提取:利用大模型在严格防止泄露诊断结论的前提下,从标准参考报告(GT Report)中提取“临床适应症”(Clinical Indication)和“重点解剖区域”(Areas of Focus)。
条件化生成:将提取的 RoI 上下文作为 Prompt 前置条件输入给被测大模型,要求其仅针对指定的 RoI 生成 Findings 与 Impression。
细粒度裁判打分:由 LLM-as-a-Judge 逐条对比预测报告与 GT 报告中的异常描述,明确划分为匹配(True Positive, TP)、漏诊(False Negative, FN)与幻觉(False Positive, FP),进而计算出精准的临床 Precision、Recall 和 F1 值。
3. Agentic 工具扩展:RAG 与感知专家协同
在实际部署中,ClinFusion 扩展了基于 Plan-Act 工作流的 Agentic 工具系统。
知识检索工具(Retrieval-Augmented Generation, RAG):集成 UMLS 和 PrimeKG 知识图谱进行概念标准化,结合向量检索在 PubMed、权威医学教材、18k 份临床指南和 100k 篇顶刊文献中提取附有引用出处的证据链。
感知专家工具:集成 5 个专用视觉 AI 工具(包括多器官病变分割、腹部淋巴结分割、脂肪肝定量评估、胸片异常分类与描述生成),当遇到精准测量或小病灶计数问题时,ClinFusion 可主动调用专家工具获取定量结果后再进行综合推演。
实验与结果:刷新多项榜单,通过放射科医生盲审
ClinFusion 构建了包含 22.2M 训练样本的大型语料库,并采用 5 阶段渐进式训练策略(从浅层 2D 对齐到 2D/3D 全量指令微调)。团队在 2D 多模态、3D 多模态、纯文本医疗知识及指令遵循等多个维度进行了严格评测。
1. 2D 与 3D 多模态任务全线领先
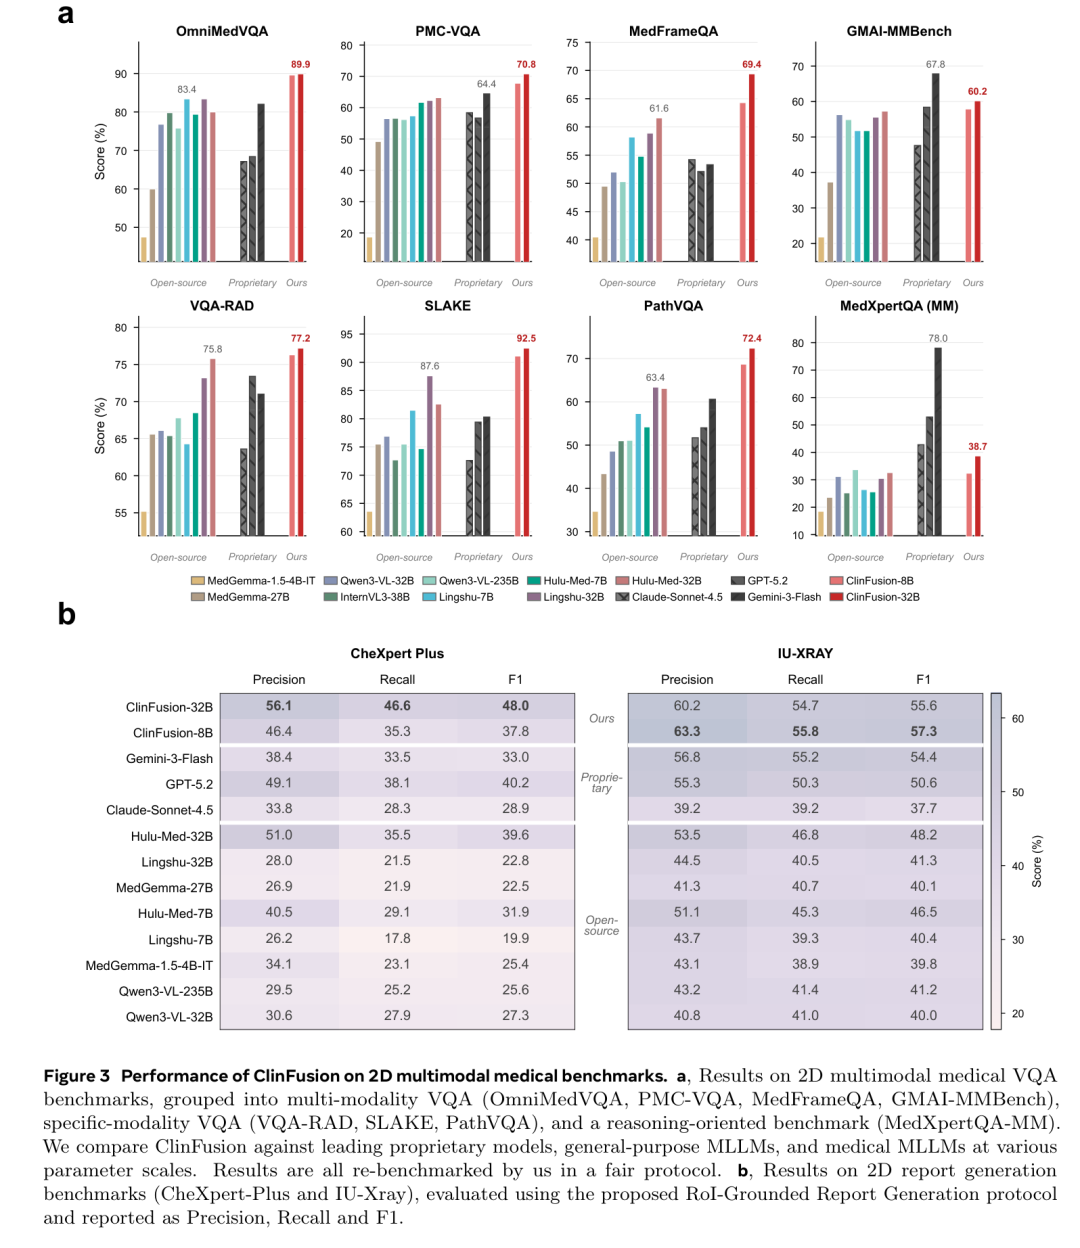
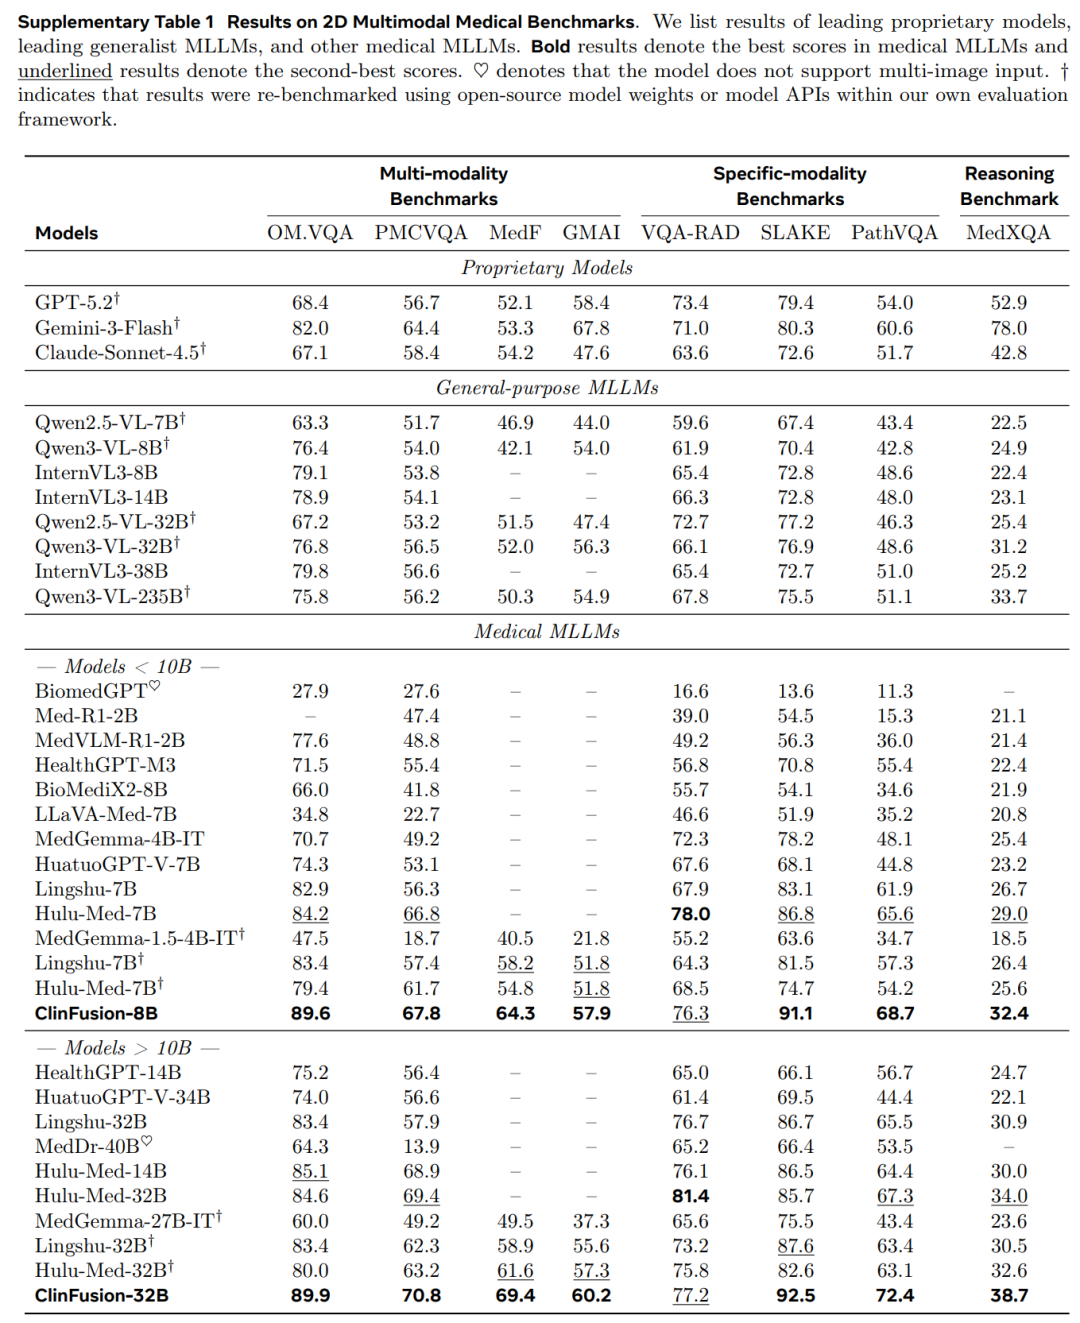
在 2D 多模态 VQA 评估中,ClinFusion 在开源医疗大模型中展现出突出优势。
在综合性基准 OmniMedVQA 上,ClinFusion-32B 取得了 89.9% 的高分(ClinFusion-8B 亦达到 89.6%),显著超越 Gemini-3-Flash(82.0%)和 Hulu-Med-32B(84.6%)。
在 PMC-VQA 上,ClinFusion-32B 达到 70.8%。
在 CheXpert-Plus 2D 报告生成评估中,ClinFusion-32B 的 F1 达到了 48.0%(Gemini-3-Flash 为 33.0%,Hulu-Med-32B 为 39.6%)。
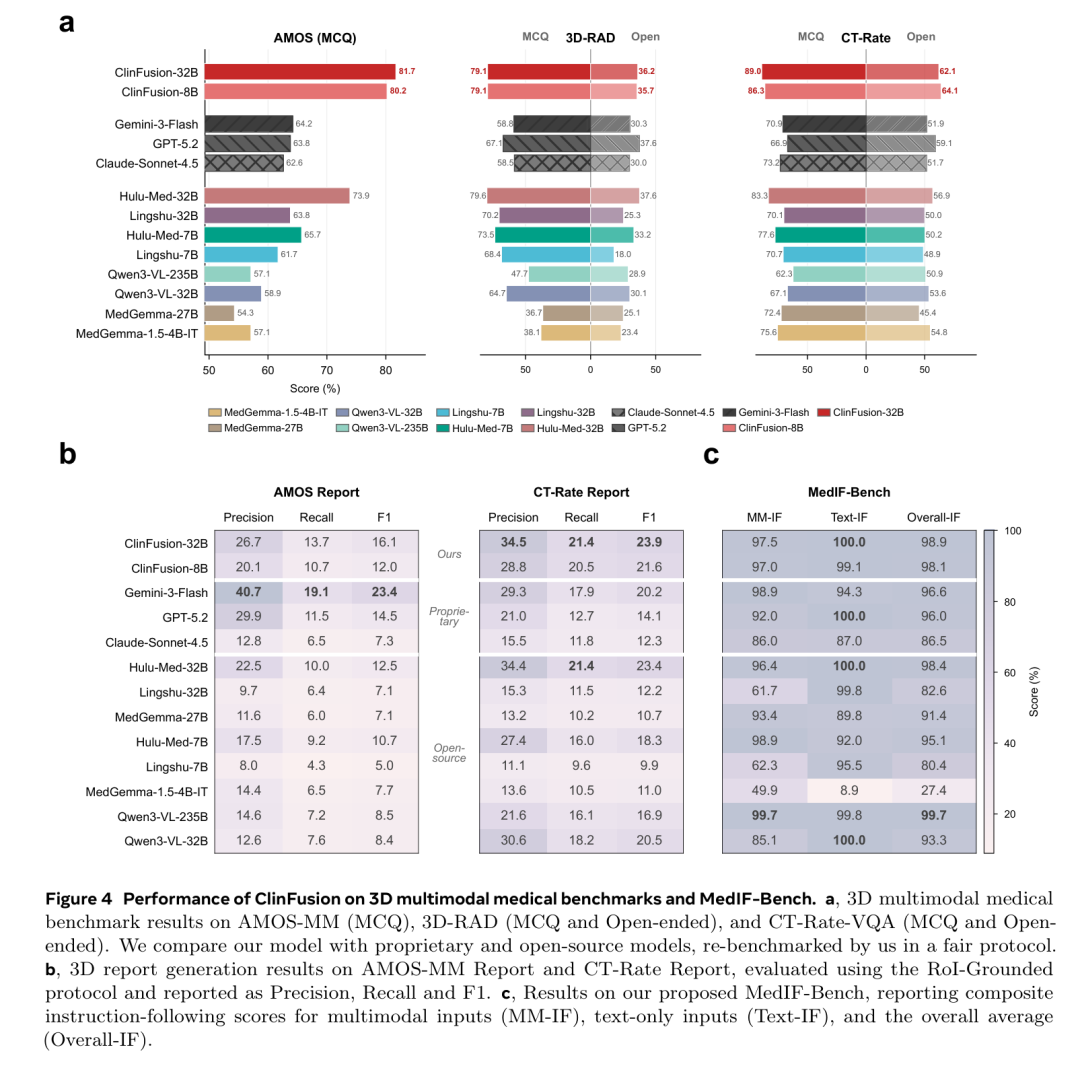
在 3D 体数据任务上,得益于原生 3D 编码器与 2D 锚定融合:
在 3D 腹部 CT 基准 AMOS-MCQ 上,ClinFusion-32B 斩获 81.7%,ClinFusion-8B 获得 80.2%(相比之下,Gemini-3-Flash 为 64.2%,Hulu-Med-32B 为 73.9%)。
在 CT-Rate 3D 报告生成上,ClinFusion-32B 取得了 23.9% 的 F1 最高分。
2. MedIF-Bench 验证强指令遵循能力
在 MedIF-Bench 测试中,ClinFusion-32B 与 ClinFusion-8B 的 Overall-IF 分别达到了 98.9% 和 98.1%,超越了 GPT-5.2(96.0%)和 Gemini-3-Flash(96.6%)。实验表明,传统医疗大模型(如 Lingshu-32B 的 Overall-IF 仅为 82.6%)在微调过程中指令遵循能力受损严重,而 ClinFusion 成功保留了底座的强指令遵循特性。
3. 资深放射科医生盲审评估
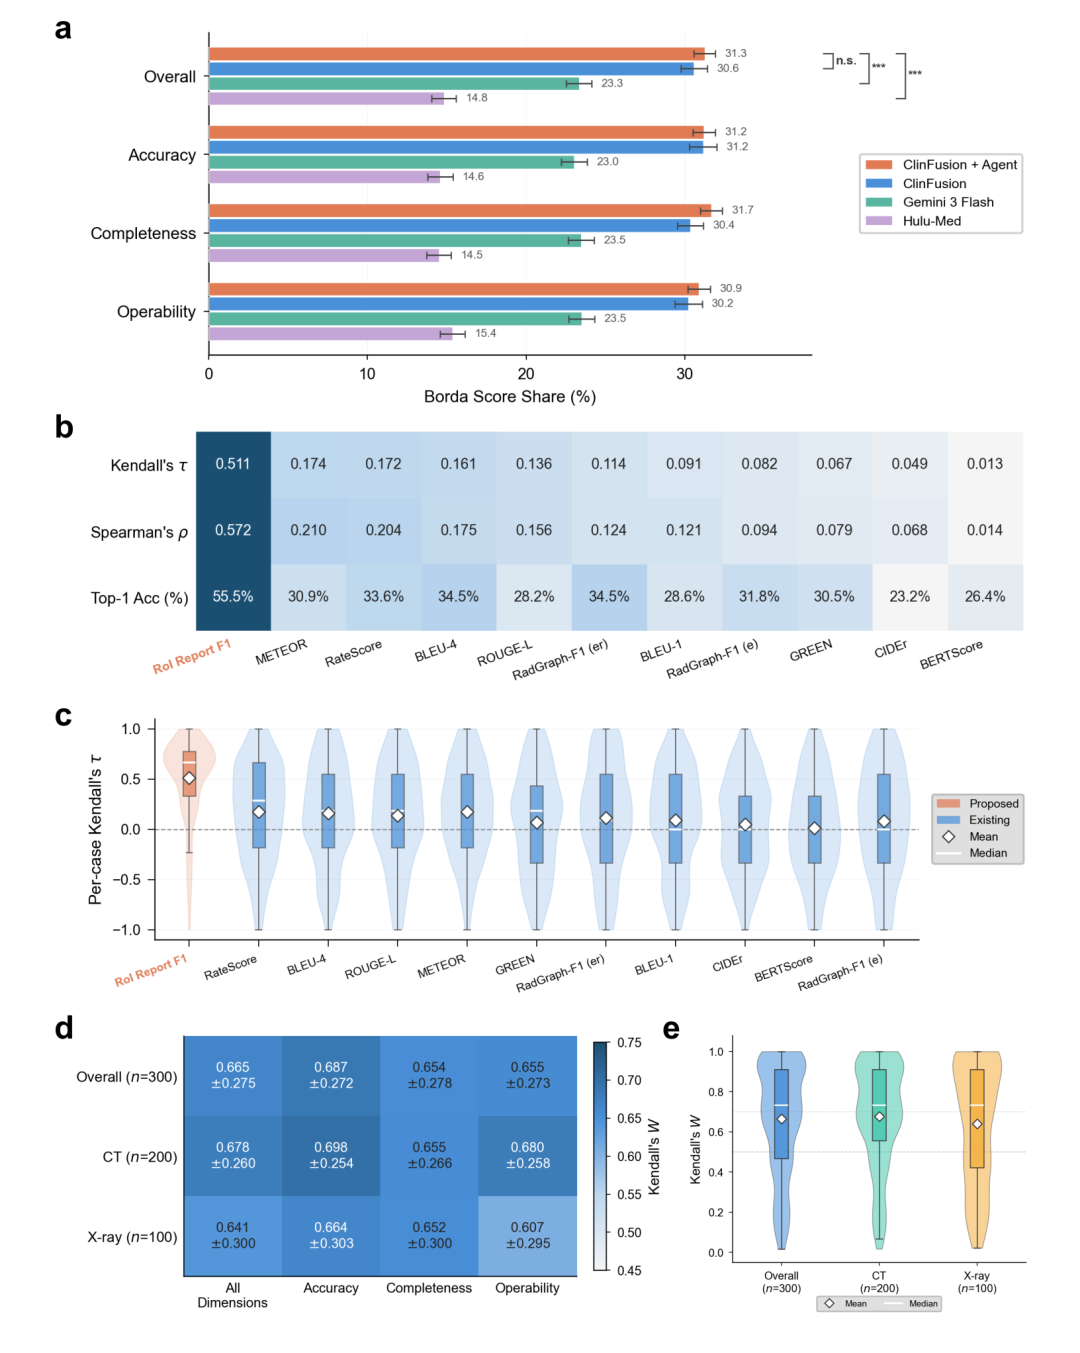
为了验证自动评估指标与真实临床评价的一致性,研究团队邀请了 6 位持有执业医师资格证的资深放射科医生,对 300 例涵盖胸片、胸部 CT 与腹部 CT 的随机抽样样本进行了盲态评审。
医生从“准确性”(Accuracy)、“完整性”(Completeness)和“临床实用性”(Operability)三个维度对 ClinFusion(带 Agent 工具)、ClinFusion(独立模型)、Gemini-3-Flash 和 Hulu-Med 生成的报告进行排序:
模型胜出率:ClinFusion + Agent 在各项维度上的 Borda 积分均排名第一,且相比 Hulu-Med 和 Gemini-3-Flash 具有统计学显著优势()。
评估指标相关性:在对 11 种自动评估指标(包括 BLEU-4、ROUGE-L、RadGraph-F1、BERTScore、GREEN 等)与医生排名一致性的对比中,ClinFusion 提出的 RoI-Grounded 评测指标 获得了最高的相关性(Kendall's , Spearman's , Top-1 准确率 ),远超传统的 RadGraph-F1()与 BLEU-4()。
4. Agent 工具扩展的额外收益
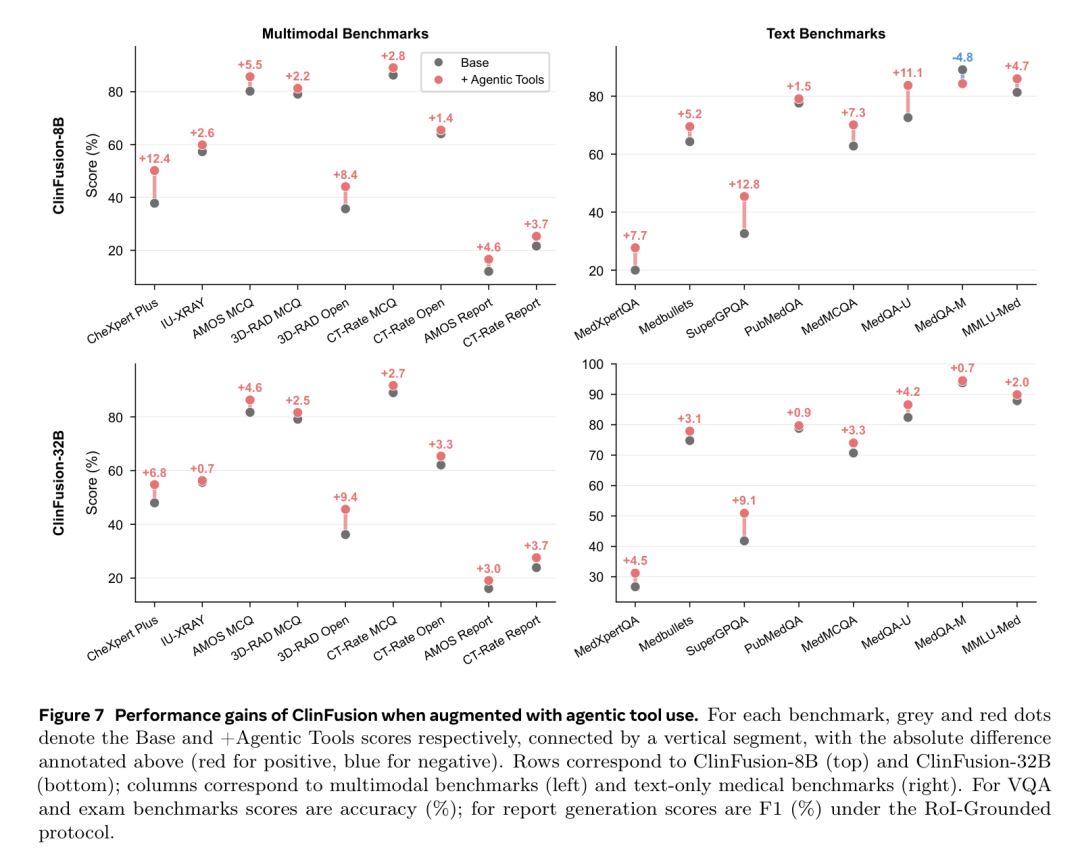
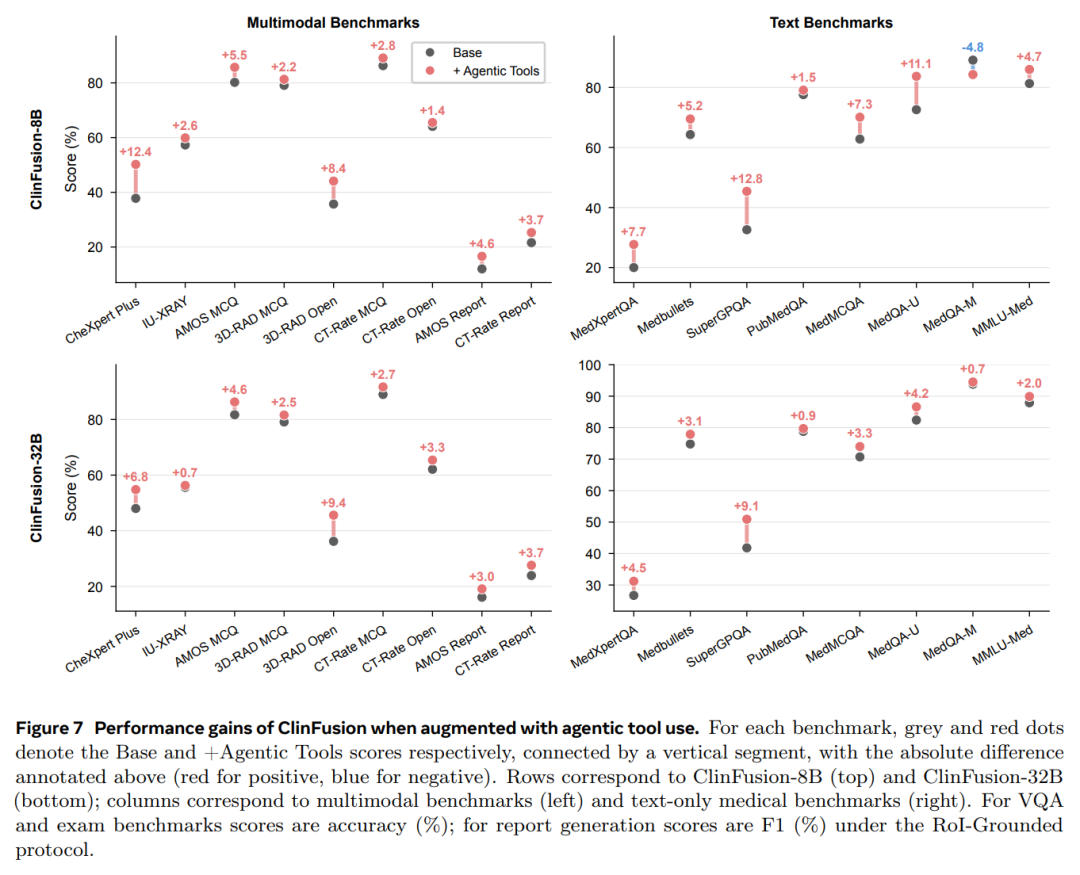
当接入 Agentic 工具后,ClinFusion 在复杂推理与描述性任务上展现出进一步的提升。ClinFusion-8B 在 SuperGPQA 上得分提升了 +12.8%,在 CheXpert-Plus 报告 F1 上提升了 +12.4%,在 3D-RAD 开放问答上提升了 +8.4%。
5. 关键消融实验结论
融合机制选择:局部交叉注意力(CaSL Fusion)在 2D VQA 上的平均得分(64.5%)明显优于全局交叉注意力(62.7%)和特征通道拼接(63.1%)。
专家编码器组合:DINOv2 与 ConvNeXt 的组合在 VQA 与报告生成上展现出较佳平衡,而级联融合(Cascade)的效果优于并行融合(Parallel)。
3D 编码器的必要性:若在推理时关闭原生 3D 编码器,仅依赖稀疏 2D 切片,3D VQA 平均分会下降 3.0 分(65.8% 62.8%),3D 报告 F1 会下降 4.0 分(15.7% 11.7%),证明了 dedicated 3D 模块不可替代。
写在最后
ClinFusion 的出现,为医疗多模态大模型的研究带来了一股清流。它没有盲目追求纯粹的数据堆砌,而是选择回到医疗场景的底层逻辑——用组合式架构解决异构视觉吸收,用贴合医生习惯的上下文约束重构评估体系。
从技术演进的角度看,组合式视觉编码器与 Agent 动态工具链的结合,展现了基础大模型与专业工具协同工作的巨大潜力。随着代码与权重的全面开源,ClinFusion 不仅为后续的医疗 AI 研究提供了一个扎实的基线,也为多模态大模型迈向安全、严谨、可解释的临床落地打下了一个坚实的基础。