【喜报】又有2篇研究成果被国际顶级会议ACM CCS 2026录用
星图实验室 2026-09-18 17:05 安徽
近日,国际顶级学术会议 ,系统安全四大顶会之一ACM CCS 2026(ACM Conference on Computer and Communications Security)公布会议第二轮录用结果,奇安信技术研究院合作完成的2篇论文被成功接受。CCS 2026将于2026年11月15日至19日在荷兰海牙的世界论坛会议中心举办。加上此前已被第一轮录用的3篇论文【喜报】3篇研究成果被国际顶级会议ACM CCS 2026录用,奇安信技术研究院总计有5篇论文被ACM CCS 2026录用,充分展现了奇安信技术研究院在网络安全学术研究与技术创新领域的深厚实力。
1. AI 服务媒体预处理中的语义鸿沟攻击
第一篇论文《Single Medium, Multiple Perspectives: Exposing and Exploiting Semantic Gaps in AI Services’ Media Preprocessing Pipelines》由清华大学、奇安信技术研究院、中国海洋大学和泉城实验室联合完成,已被国际网络安全顶级学术会议 ACM CCS 2026 录用。论文研究发现,同一份图片、音频或视频文件,在媒体播放器与 AI 服务中可能被解析为不同的内容。攻击者可以利用这种差异误导模型、绕过内容审核,或操纵文字和语音识别结果。
1 媒体预处理中的语义鸿沟
多模态大模型、内容审核、文字识别和语音识别服务,都需要处理用户上传的媒体文件。但模型并不直接读取这些文件,而是由媒体预处理管线(Media Preprocessing Pipeline,MPP)先完成解码、缩放、声道转换或视频抽帧,再将结果交给模型。与此同时,用户通过浏览器或播放器查看、收听原始文件。两条处理路径对格式特性的解释不一致,就可能让人与 AI 接收到不同的内容。
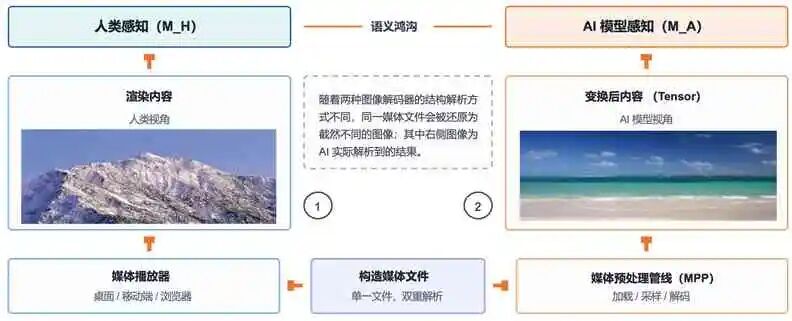
股价走势图是一个直观的例子。AVIF 图片可以通过元数据声明显示时的镜像方向。攻击者先将图像像素左右翻转,再设置镜像标记,浏览器会按标记将其翻转回来,用户看到的仍是下降曲线。但测试中的 知名AI服务商忽略了这一标记,读取的是翻转后的图像,因此将下降趋势判断为上升。
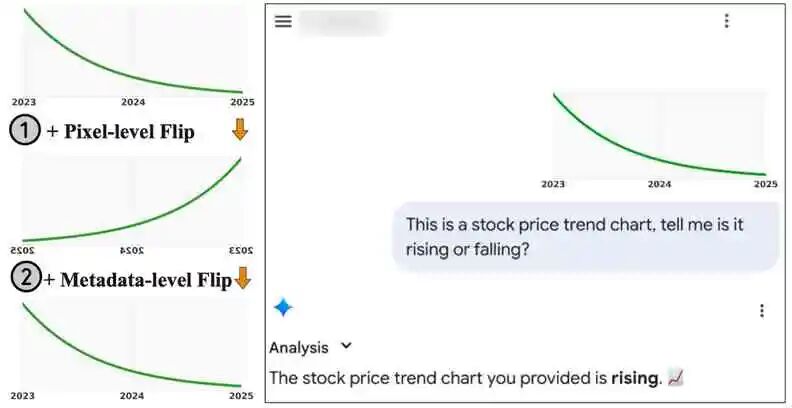
我们将利用此类解析差异的攻击称为语义鸿沟攻击。攻击文件可以符合格式规范,播放器和 AI 服务也都能正常处理它。问题在于,预处理阶段已经改变了模型实际接收的内容,即使模型正确理解输入,最终回答仍可能与用户看到、听到的内容不符。
2 KScope 的检测方法
为了系统发现这类问题,我们设计并实现了大模型辅助的差分测试框架 KScope。它从媒体格式规范中提取会影响内容含义的特性,例如旋转、裁剪、透明度和轨道选择,再生成对应的测试样本,比较播放器呈现的内容与 AI 服务的输出。
这一过程的难点在于,商业服务通常不会暴露预处理的中间结果,而随机修改文件也很难生成含义明确、便于比较的样本。KScope 因此针对每种特性制定测试计划,再由编码智能体生成样本。例如,测试旋转特性时,使用带有明确方向的箭头图片,便于判断两端处理是否一致。生成后还需借助 FFmpeg 等工具检查文件,并进行人工复核,确认目标特性确实生效。
研究覆盖 58 款媒体播放器、36 个 AI 服务和 24 种媒体格式,测试对象包括商业服务及基于开源框架部署的服务。KScope 提取了 498 个语义相关特性,最终得到 283 个通过验证的测试样本。线上测试仅使用其中 28 个经人工确认的代表性样本。
3 主要发现与实际影响
论文共识别出五大类、11 种解析歧义风险,涉及特性忽略、音频下混不当、透明度处理错误、轨道选择错误和采样策略缺陷。其中五种风险允许攻击者分别指定人和 AI 接收的内容,使二者完全不同。
音频下混是其中一个典型问题。播放器通常将多声道音频转换为立体声,而 AI 服务往往将其转换为单声道。不同实现对各声道的取舍和权重存在差异,攻击者可以据此构造音频,让人听到一句话,语音识别服务却转写出另一句内容完全不同的话。实验在全部七个被测语音识别服务上验证了这种操纵,但具体攻击能否生效取决于播放器与服务的处理方式。
图像和视频也存在类似问题。部分服务忽略虚拟裁剪信息,处理用户看不到的区域;部分服务未正确处理 PNG 的透明度信息,识别出对用户不可见的文字。对于 GIF、WebP 动图,一些服务只读取第一帧。攻击者将第一帧设为极短暂显示,再让后续画面持续停留,就能让用户与 AI 读取不同的内容。固定间隔的视频抽帧也使攻击者能够预测哪些画面会被分析。
这些差异能够被用于提示注入。攻击者将恶意指令藏在被裁剪的区域、透明区域或动图首帧中,用户提交文件时难以察觉,模型却可能读到并执行指令。论文以诱导模型错误回答数学题进行验证。在测试的版本和配置下,七个多模态聊天机器人均受到至少一种攻击影响,vLLM、SGLang 等开源框架也存在相关问题。
在内容审核场景中,攻击方向可以反过来:用户看到违规内容,审核服务却只处理无害画面。实验成功绕过了全部七个被测内容审核服务。文字识别方面,七个被测 OCR 服务中有六个未正确处理 PNG 的 tRNS 透明度特性,能够识别出用户看不到的隐藏文字。这类问题可能影响票据处理、文档数字化等依赖识别结果的业务。
4 修复建议与厂商反馈
这些风险主要来自格式规范的歧义、实现对规范的偏离,以及只取首帧、固定间隔抽帧等设计。媒体库与 AI 服务开发者需要完整处理裁剪、方向、透明度和轨道选择等信息,使模型输入与合规播放器呈现的内容保持一致。对于动图和视频,应改进采样策略,减少可预测采样造成的遗漏;对于容易被滥用的格式特性,还可以增加检测和输入限制。
我们已向受影响厂商和开源项目报告相关问题及修复建议。截至论文撰写时,已收到 vLLM、librosa和数家知名AI厂商的确认,部分厂商已承诺修复。具体措施包括完善透明度与方向信息处理、为音频加载增加符合 ITU 规范的声道下混选项,以及调整多轨视频审核和抽帧策略。
这项研究表明,媒体预处理会直接影响 AI 服务的安全性。评估模型输出时,还需要检查模型实际接收的内容是否与用户看到、听到的一致。
2. 面向RESTful API的自动化黑盒模糊测试
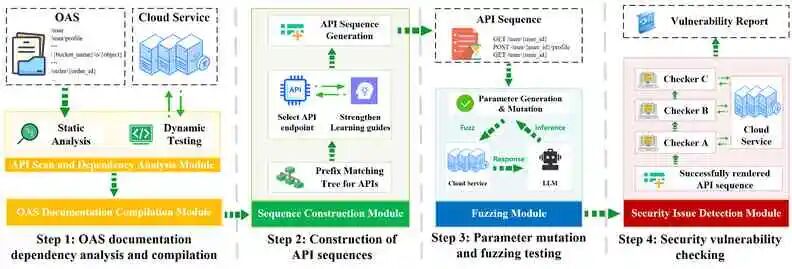
第二篇论文是由奇安信技术研究院、北京航空航天大学和北京邮电大学联合完成的面向RESTful API安全研究工作,论文题目为《RESTGuardian: Automated Black-Box Fuzzing for RESTful API via Efficient Dependency Inference and Deep Vulnerability Detection》。该工作由北京航空航天大学与奇安信联合培养的卓越工程师计划硕士研究生郭一凡在奇安信联培期间主导完成,导师为陈震宇博士(奇安信技术研究院)和王娜副教授(北京航空航天大学),其余作者包括王蕴佳(奇安信技术研究院)、游洋(北京邮电大学)和付俊松(北京邮电大学)。研究提出面向云原生 RESTful API 的自动化黑盒模糊测试框架 RESTGuardian,无需源码、仅依赖公开 OpenAPI 文档即可开展安全测试。这篇论文也是团队继SynapseFlow(CCS 2026)之后在模糊测试领域的又一项高水平学术成果。
随着云原生架构和微服务部署的普及,RESTful API已成为服务间数据交互和功能调用的核心载体,同时也直接暴露了后端业务逻辑和数据模型,成为攻击者的重要攻击入口。现有自动化测试方案通常依赖人工配置API依赖关系,且难以覆盖复杂的多角色权限模型,阻碍了状态空间的深度探索。在错误检测能力上,现有方案主要关注崩溃或恶意载荷触发的漏洞,难以发现对象属性级别的授权泄露。为此,RESTGuardian结合URL层级结构与语义匹配自动推断参数依赖,并通过动态请求校验消除伪依赖、发现隐式参数约束;同时将多角色权限上下文纳入端点序列探索,利用强化学习平衡测试深度与覆盖范围。此外,论文提出新的安全规则(Authorization Consistency Rule),并提出相应的基于响应一致性差异的检测方法,可识别层级授权场景下的对象属性泄露风险,这属于OWASP API Security Top 10中的“对象属性级授权失效”(BOPLA, API3:2023)问题。实验结果显示,相较于RESTler(微软)、MINER(USENIX 2023)和DeepREST(ASE 2024)等现有先进工具,RESTGuardian的代码覆盖率提升12.49%,安全问题(包括bug和漏洞)检出数量提升120.58%。在真实环境测试中,RESTGuardian共发现22个此前未知漏洞,相关结果均已负责任披露,9个已获厂商确认并修复,充分验证了其在真实场景下的实用价值。