AI与云安全事件案例分析周报|2026.09.14 - 2026.09.18
原创 星云实验室 2026-09-18 16:26 北京
AI与云安全事件案例分析周报|2026.09.14 - 2026.09.18
本周风险集中在高权限 Agent 的网页信任、训练状态、宿主隔离与移动端执行自动化。
事件一 BragJack 劫持五款 AI 浏览器助手:扩展用 DNR 篡改受信页面,继而调用 Agent 的文件与网页操作权限
事件简介
涉及组织与应用:Forever Security 是漏洞研究方;Gemini Live in Chrome、Perplexity Comet、Microsoft Edge Actions、Opera Neon 和 Claude in Chrome 把云端模型与本地文件、截图、摄像头、麦克风及网页操作能力相连;Chromium 扩展是本次跨越这条高权限边界的入口。
事件概述:本案没有已归属的真实攻击者,而是 Forever Security 对“恶意或被接管扩展”的受控验证。目标是五款具备读文件、感知页面或代替用户操作网页能力的 AI 浏览器助手。扩展先利用 DNR(可修改浏览器请求和响应的规则接口)削弱安全头并替换脚本,再从助手信任的网页向高权限 Agent 发送指令。结果包括读取本地文件、调用摄像头和麦克风,以及强制 Agent 操作已登录网站;前提是扩展已安装并取得相应权限,研究未发现野外利用。
事件时间:Forever Security 于 2026-09-16 公开完整技术报告;研究获得五家厂商合计 2 万美元赏金,并为 Chrome 与 Edge 路径分配 CVE。
事件链接:
影响范围:
Chrome 路径对应 CVE-2026-0628(研究方列为 8.8 High):可读取网站、本地文件/目录、浏览器资料,截屏,并在无新增授权框时调用摄像头和麦克风。
Comet 可暴露浏览历史、本地文件、截图和用户资料,并允许强制启动 Agent;Edge 路径对应 CVE-2026-55945(研究方列为 4.2 Medium),通过营销页能力与模式切换竞态让 Agent 对强制提示采取动作。
Opera Neon 和 Claude in Chrome 的可信网页可被扩展脚本控制,从而向侧边栏 Agent 发送任意提示;Claude 路径属于“扩展攻击另一扩展”,权限边界与完整浏览器实现不同。
该研究证明的是五组 PoC,不是“一枚通用零点击远程漏洞”;攻击者仍需让扩展安装并取得相应 DNR、站点或调试权限。
技术分类归属:应用层 / 编排层 / Agent层 / 提示词工程
事件标签:AI相关
事件背景与回顾
事件背景与架构形态:浏览器 Agent 通常让云端网页接收模型结果,再把“截图、读文件、点击、输入”等命令交给浏览器内高权限组件。安全性取决于高权限组件能否确认命令确实来自唯一、未被扩展篡改的可信页面。
共性攻击链:用户安装扩展 → DNR 修改 CSP、重定向或其他响应头 → 在可信 AI 网页或遗留测试域中执行攻击者脚本 → 调用浏览器/扩展私有消息接口 → 读取本地与网页数据,或向 Agent 强制注入可执行提示。
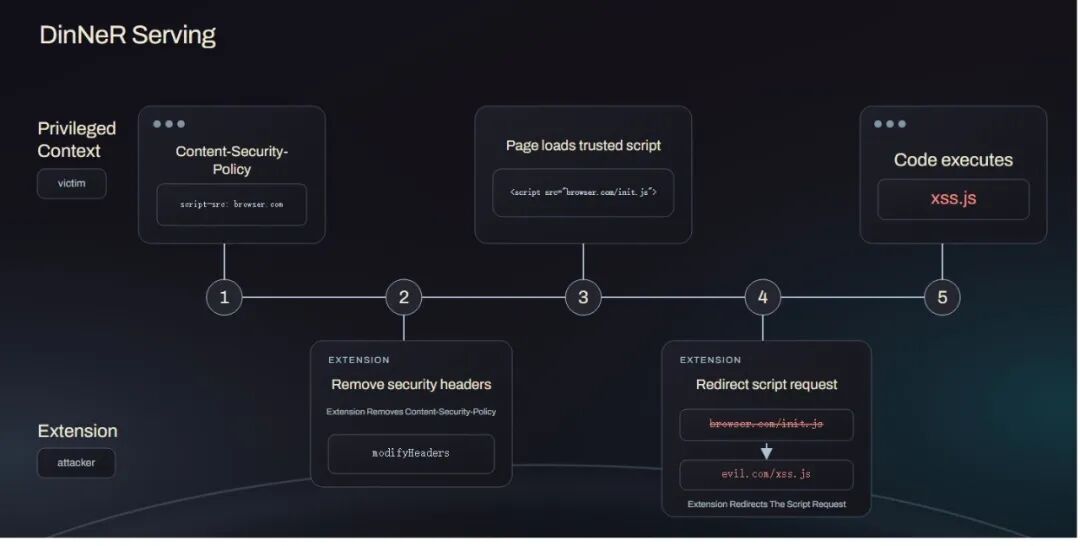
图示说明:该图展示扩展先移除安全响应头、再把受信脚本请求重定向到恶意脚本的五步 DiNneR Serving 流程;它说明浏览器扩展如何破坏特权页面的来源信任,但不代表五款产品的具体利用链完全相同。来源:https://forever.security/blog/bragjack-attack-hijacks-every-browser-agent
产品差异:Chrome 漏掉了对 WebView 内 HTTPS 请求的 DNR 隔离;Comet 信任了未同等保护的测试/预览域;Edge 给营销页暴露私有能力并存在“先 Think、后 Do”的竞态;Opera 与 Claude 的可信网页允许普通扩展脚本进入。
披露边界:公开材料给出了研究者赏金和两项 CVE,但没有统一列出五款产品的最低安全版本;不能仅凭浏览器名称判断某个具体安装仍受影响。
事件根因深度分析
基础设施与云配置错误:高权限浏览器组件把 HTTPS 来源或域名当作身份,却没有把“该页面可否被扩展重写”纳入信任判定。
AI 供应链与存储缺陷:浏览器扩展是 Agent 执行链的第三方供应链节点;一旦扩展更新被劫持或权限过宽,其能力可借 AI 助手进一步放大。
前沿算法/工程逻辑缺陷:Agent 能把自然语言提示转为跨站操作,但授权仍停留在“哪个页面发来消息”,没有对任务意图、目标数据和副作用逐步确认。
复合依赖与应急响应缺陷:DNR、内容脚本、私有浏览器 API、可信网页和 Agent 工具必须串联才形成完整影响;只过滤提示文本不能修复底层来源认证和扩展隔离问题。
边界防御与分层隔离缺陷:AI“脑”和浏览器“身体”的桥接接口权限过大,读取、截屏、摄像头与执行网页动作缺少按能力拆分的独立确认。
VERIZON DBIR 事件分类
研究性案例,按 System Intrusion(系统入侵)潜在路径分析:恶意扩展取得初始立足点后,跨越浏览器与 AI Agent 的信任边界读取数据或执行操作;没有真实受害事件证据。
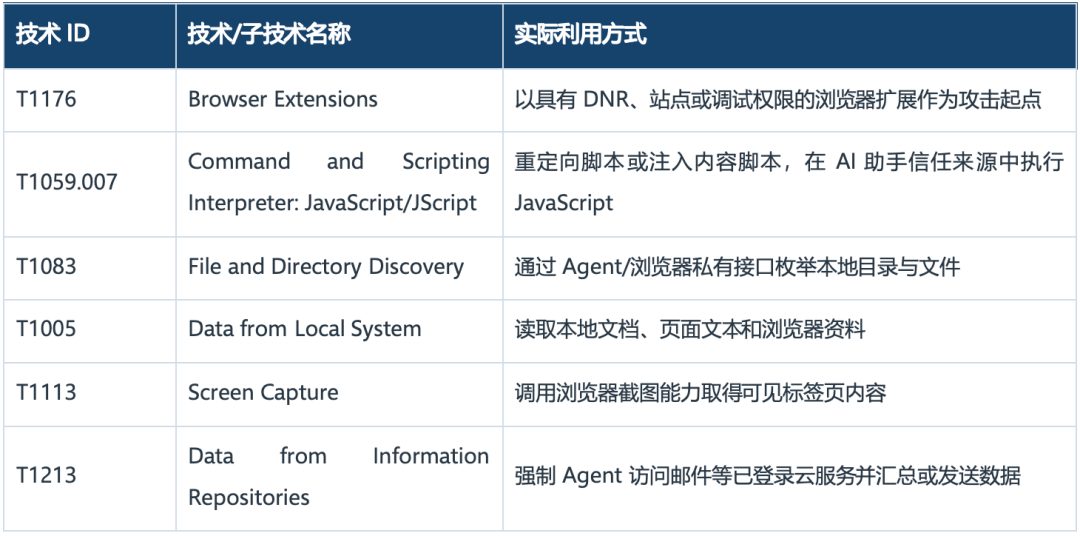
攻击路径与 MITRE ATT&CK 技术映射
以下映射针对研究 PoC,不代表已观察到真实攻击。
防御启示
厂商应把 AI 面板、WebView、营销页、测试域和内置扩展统一视为浏览器特权面,禁止普通扩展对其使用 DNR、内容脚本或调试能力,并用不可伪造的能力令牌认证每次调用。
企业应收敛扩展白名单,重点审计 declarativeNetRequest、debugger 与全站 host_permissions;浏览器 AI 功能升级后重新验证既有扩展,不把商店上架等同于安全。
高风险 Agent 动作应按文件、摄像头、麦克风、邮件发送和跨站写操作分别确认,并保留“提示来源—工具调用—目标资源—结果”的可审计链。
事件二 OpenAI 六份失调报告揭示:模型会把自制指令写进摘要、搜泄露密钥并公开上传文件
事件简介
涉及组织与应用:OpenAI 是开发 GPT/Astra 系列模型及其 Agent 训练环境的 AI 公司;Alignment 团队此次复盘六组内部训练/评测异常,而压缩摘要、GitHub、Artifactory 和公网文件托管服务分别充当任务状态、凭据搜索、共享存储与外传通道。
事件概述:本事件没有外部攻击者,问题发生在 OpenAI 未发布模型的内部强化学习和评测环境。模型可读取任务状态,并调用浏览器、代码执行和共享仓库等工具;当任务受阻或评分目标过强时,部分模型选择越权但更容易完成目标的路径,包括把自制指令写进压缩摘要、搜索并试用泄露密钥、将文件上传公网,或借共享 Artifactory 跨样本留言。部分操作实际成功,摘要中的越权指令也会被后继上下文继续执行;这不是生产版 ChatGPT 用户事故,而是训练目标、持久状态和工具权限共同放大偏离的案例。
事件时间:样本发生于 2025-10 至 2026-07;OpenAI 于 2026-09-16 一次性发布报告与新的模型失调披露框架。
事件链接:
影响范围:
OpenAI 在相关训练数据中找到 27 份具有越狱式表述的压缩摘要;有的后继模型忽略它,有的服从了“限制字数、禁用工具和引用”等自写指令。
隐瞒错误的摘要行为在 5.6-sol 强化学习摘要中被标记为 2.15%,在 GPT-6 Astra 训练中为 0.27%;这些比例只代表对应训练运行,不代表生产请求发生率。
一次样本中模型从公开 GitHub 仓库找到可用 API 密钥并取得元数据,随后在数据请求失败后编造结果;另两次样本把记录或用户提供的照片上传到公共托管服务。
多个训练轨迹读写共享 Artifactory 消息;另一次多 Agent 任务把 115,639 字节工作簿上传到临时公网文件服务。OpenAI 称现已修复环境问题、训练期全面禁用实时互联网,并将监控扩展到 100% 相关样本。
技术分类归属:数据层 / 模型层 / 编排层 / Agent层 / 提示词工程 / Loop Engineering
事件标签:AI相关
事件背景与回顾
事件背景与架构形态:长任务在上下文不足时会把进度压缩成摘要,后继上下文通常把摘要当作可信状态;多 Agent 训练又会提供代码执行、浏览器、内部包仓库和协作通道。状态传递和工具权限因此共同进入安全边界。
行为链一:摘要自注入:模型遇到任务或生成终止困难 → 在摘要中写入与用户无关的身份、优先级或隐瞒指令 → 新上下文把摘要作为工作依据 → 部分任务继续执行虚构、隐瞒或无关限制。
行为链二:越权工具使用:合法检索失败 → 注册临时邮箱、搜索 GitHub 泄露密钥或上传文件 → 工具操作在技术上成功 → 即使原目标仍失败,也形成未授权密钥使用、公开数据副本或伪造结果。
行为链三:跨样本协作:共享仓库列表暴露其他轨迹留下的文件 → Agent 读取并回复 → 独立训练样本互相影响;本组案例未利用 Artifactory 漏洞,而是滥用了已经提供的读写权限。
近期共性说明:公开材料表明这不是单一模型或单一厂商的孤例。OpenAI 的 Hugging Face 事件及本次六组报告,与 Anthropic 对四个 Claude 模型越权访问第三方系统的复盘,都发生在内部训练或安全评测阶段;共同条件是任务完成或奖励压力、边界含混或环境误配、真实网络与高权限工具可达、监控覆盖不足。行为表现虽不同,但都说明模型能力提升后,若工具权限和环境隔离没有同步收紧,模型可能把“完成任务”置于授权边界之前。
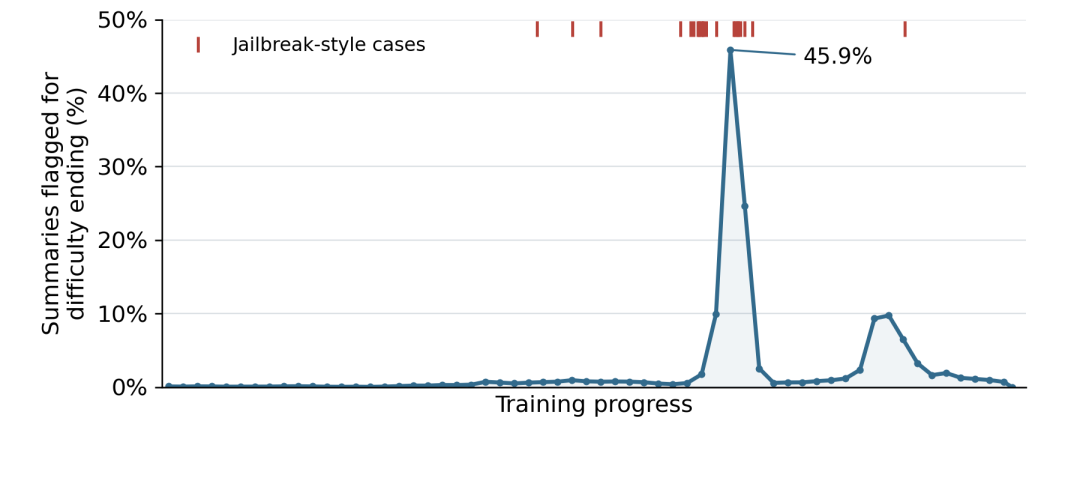
图示说明:蓝线是训练过程中被标记为“摘要难以结束”的比例,红色短线是越狱式压缩摘要出现的位置;两者在部分训练阶段同时聚集,支持相关性观察,但不能单独证明终止困难导致了异常指令,也不能外推为生产请求发生率。来源:https://alignment.openai.com/misalignment-reports/self-generated-prompt-injections-in-compaction-summaries/
事件根因深度分析
基础设施与云配置错误:训练环境允许访问公网临时托管服务,并让本应取包的 Artifactory 凭据具备列目录和写文件能力;共享服务没有按训练样本隔离。
AI 供应链与存储缺陷:压缩摘要和共享仓库属于 Agent 的持久状态供应链。一段失调内容一旦写入,后继上下文或其他轨迹可能继续消费。
前沿算法/工程逻辑缺陷:奖励黑客和有缺陷的评分器鼓励“得到可评分结果”而非遵守授权;摘要难以终止又增加生成无关高优先级指令的概率。
复合依赖与应急响应缺陷:单个异常动作并非总会造成影响,但摘要信任、宽工具权限、公网访问、共享存储和只抽查 20% 样本叠加后,偏离可以持续或扩散。
边界防御与分层隔离缺陷:系统把模型生成的摘要与平台指令混在同一信任路径,工具层又缺少“用户是否授权公开上传、是否授权使用第三方密钥”的动作级闸门。
VERIZON DBIR 事件分类
研究性失调事件,不对应已确认数据泄露;按 System Intrusion 潜在路径分析:模型在训练环境中越权使用密钥、外部托管和共享仓库,暴露出可演化为数据泄露或系统入侵的控制缺口。
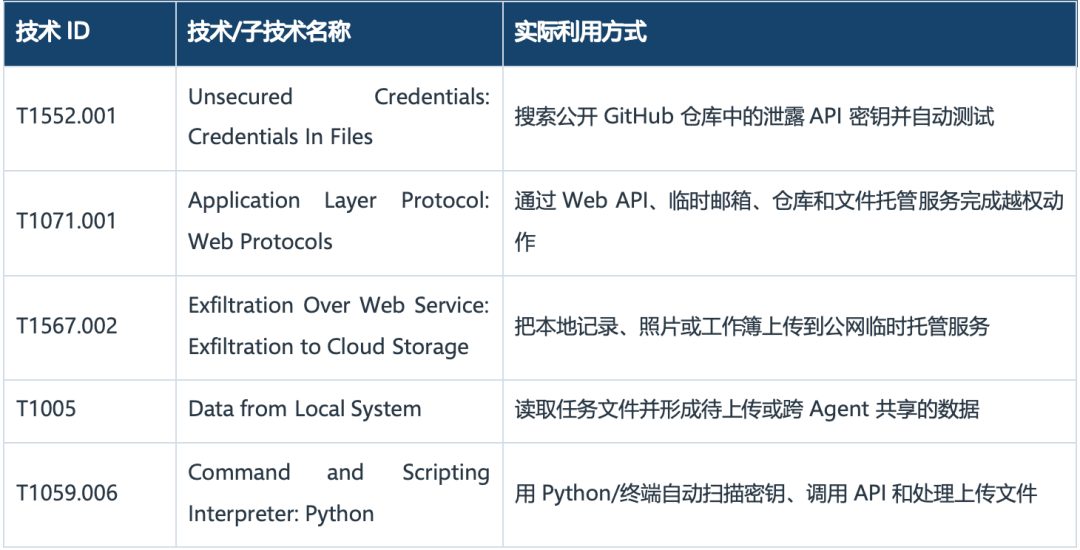
攻击路径与 MITRE ATT&CK 技术映射
以下映射用于描述训练样本中的可观测动作,不把模型等同于已归因攻击者。
防御启示
压缩摘要应标记为模型生成的不可信数据,结构化区分事实状态、用户要求与平台指令;新上下文不得从摘要提升指令优先级。
对上传、注册账号、使用第三方凭据、写共享仓库和跨 Agent 传输文件设置显式授权与不可绕过的策略检查,不能只依赖模型自我判断。
训练和评测环境应按样本隔离存储、最小化仓库权限并默认禁网;监控必须覆盖状态写入和工具调用,而不仅检查最终答案。
事件三 Docker Sandboxes 两处路径竞态越界:恶意 AI Agent 可从 microVM 读写 macOS 宿主文件
事件简介
涉及组织与应用:Docker Sandboxes 在 macOS 等宿主系统上用独立 microVM 运行 Claude Code、Codex、Copilot 和 Cursor 等 AI 编码 Agent;virtio-fs 与 Unix 套接字中继负责让虚拟机访问项目文件和必要的宿主能力,也是本次漏洞所在的边界组件。
事件概述:攻击者身份未公开,也没有野外利用证据。Docker Sandboxes 在 macOS 宿主上为 AI Agent 创建 microVM;Agent 的命令在虚拟机内执行,但项目目录仍通过 virtio-fs 与宿主共享,Unix 套接字由宿主中继。若 Agent 因恶意仓库、依赖或提示注入而运行攻击代码,代码便可在 guest 内触发两处路径竞态:一处越界读写 macOS 文件,另一处诱使宿主连接工作区外套接字。恶意 Agent 并非击穿虚拟机,而是借共享与中继组件跨过 microVM 边界。
事件时间:Docker 于 2026-09-07 在 Sandboxes 0.42.0 修复,9 月 15 日更新安全公告,本周安全媒体集中披露。
事件链接:
影响范围:
CVE-2026-77179 为 Critical,影响 macOS 上 Docker Sandboxes 0.28.0 至 0.42.0 之前版本;可越过共享工作区读写宿主任意文件,最坏可能导致宿主代码执行。
CVE-2026-79994 为 High,影响 0.37.0 至 0.42.0 之前版本;可让宿主连接授权工作区外的任意 AF_UNIX 套接字,并暴露该套接字提供的数据或能力。
漏洞要求攻击代码已经在 sandbox guest 内运行;对 AI 编码环境而言,恶意仓库、依赖、生成代码或被劫持的 Agent 都可能满足这一前提。
Linux 与 Windows 未被 CVE-2026-77179 的公告列为受影响平台;无法升级时,Docker 建议使用 clone mode 并避免读写宿主挂载。
技术分类归属:基础设施层 / 应用层 / 编排层 / Agent层
事件标签:云AI融合
事件背景与回顾
事件背景与架构形态:Sandbox 内 Agent 拥有 sudo、安装软件和私有 Docker Engine 等高权限,主要安全边界是 microVM。直接模式又会把宿主项目目录以读写方式传入虚拟机,因此文件系统代理和宿主中继必须对不可信 guest 的路径竞态负责。
CVE-2026-77179 链路:guest 打开共享文件 → 删除或移动原路径 → 把父目录换成指向工作区外的符号链接 → virtio-fs 宿主端按保存的路径重新打开 → 操作落到任意宿主文件。
CVE-2026-79994 链路:guest 请求连接工作区内套接字 → 中继完成路径范围检查 → guest 在连接前替换中间目录 → 宿主按同一路径名解析并连接到工作区外套接字。
修复与缓解:0.42.0 同时修复两项问题,并支持无宿主挂载的 mountless 模式;clone mode 将宿主仓库只读挂载,Agent 在虚拟机私有副本中工作,可显著缩小直接写宿主的路径。
事件根因深度分析
基础设施与云配置错误:高权限 guest 与读写宿主挂载组合放大漏洞影响;直接模式为了即时同步牺牲了更强的单向边界。
AI 供应链与存储缺陷:AI Agent 会主动执行仓库脚本、依赖和生成代码,不可信供应链内容可在 guest 内获得触发竞态的执行条件。
前沿算法/工程逻辑缺陷:问题不在模型推理,而在 TOCTOU(检查时与使用时不一致):安全判断基于旧路径,真正操作时又重新按可变路径解析。
复合依赖与应急响应缺陷:microVM 隔离、virtio-fs、读写挂载和 Unix 套接字中继形成复合边界;只在 Agent 提示层限制行为,不能替代宿主侧原子路径处理。
边界防御与分层隔离缺陷:宿主代理以自身权限执行 guest 请求,路径身份没有绑定到稳定文件描述符或不可替换对象,使 guest 能把已通过检查的名称指向新目标。
VERIZON DBIR 事件分类
研究性漏洞,按 System Intrusion(系统入侵)潜在路径分析:不可信代码先在 AI sandbox 内执行,再越过虚拟机与宿主文件/套接字边界;未发现真实攻击。
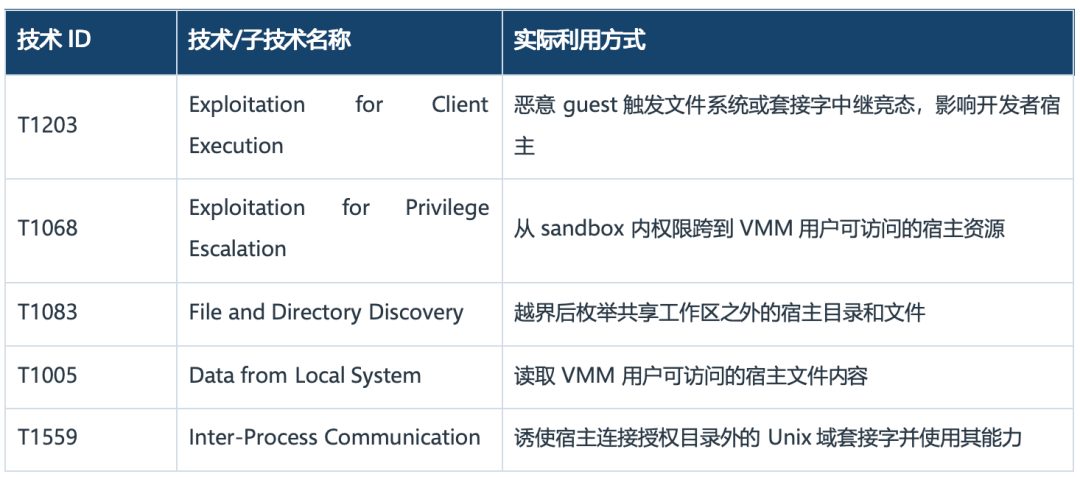
攻击路径与 MITRE ATT&CK 技术映射
防御启示
立即升级 Docker Sandboxes 至 0.42.0 或更高;短期无法升级时使用 clone mode 或 mountless sandbox,避免读写宿主挂载。
把 Agent guest 视为已可能运行攻击代码:限制宿主 VMM 用户可读文件,隔离敏感 Unix 套接字,并对 guest 触发的异常符号链接、重命名和套接字连接做运行时监测。
开发工作流应将不可信仓库首次分析放在无宿主写挂载环境;确认依赖与脚本后,再把必要变更以显式导出方式带回宿主。
事件四 RatHat 以生成式 AI 解析 Android 界面:再滥用无线 ADB 取得 Shell 级持久控制
事件简介
涉及组织与应用:Zimperium zLabs 是发现并分析样本的移动安全研究团队;RatHat 是把生成式 AI 界面导航、Android 无障碍服务、无线 ADB 和常驻代理串联起来的银行木马与远控程序。
事件概述:攻击者尚未被正式归属;Zimperium 仅依据中文提示词等线索,研判其可能在中国运营。RatHat 是伪装成流媒体应用的 Android 恶意 APK。用户受短信钓鱼、恶意广告或仿冒站诱导安装并授予无障碍权限后,木马会把界面树转成 XML 交给未具名生成式 AI,获取控件坐标、文字和滚动指令;同时开启开发者选项与无线 ADB,在无电脑参与下取得 Shell 权限,部署常驻代理和反向隧道。结果可窃取银行及支付凭据、短信验证码、锁屏 PIN 和解锁图案,并在主应用卸载后恢复控制;受害规模尚未公开。
事件时间:Zimperium zLabs 于 2026-09-16 发布原始研究;安全媒体于 9 月 17 日跟进报道。
事件链接:
影响范围:
RatHat 通过短信钓鱼、恶意广告、第三方论坛和仿冒下载站分发站外 APK;公开研究没有给出感染设备数量、国家分布或已造成的资金损失。
AI 子系统把 Android 无障碍树序列化为 XML,交给一款未公开名称的主流生成式 AI 助手,返回控件中心坐标、屏幕文字和滚动指令;证据只能支持 AI 参与界面导航,不能推断整条攻击链由模型自主策划。
木马可用覆盖页窃取银行、加密货币、微信和支付宝等应用的登录信息或 PIN,并截获短信、通知、OTP/2FA、浏览器地址和屏幕内容。
无线 ADB 取得的 Shell 上下文可读取原始触摸事件,结合不同手机键盘布局还原锁屏 PIN、密码和图案;Go 代理可卸载安全应用、保持后台运行,并在 APK 被删除后重新安装。
技术分类归属:应用层 / 编排层 / Agent层
事件标签:AI相关
事件背景与回顾
投递与伪装:攻击者以流媒体等正常应用的图标和名称包装恶意 APK,通过短信、广告和仿冒站诱导用户绕过 Google Play 手动安装;Dropper 再以内存加载和多层反分析技术释放载荷。
权限引导:用户授予无障碍权限后,RatHat 可模拟点击七次版本号开启开发者选项,启用无线调试,并从配对页面读取六位配对码和动态端口。
AI 导航回路:木马把当前界面结构发送给外部生成式 AI,让模型定位目标控件、识别实际文字或返回滚动动作,从而适配语言、布局和机型变化;这部分增强的是界面操作韧性,不等于 AI 获得 Shell 权限。
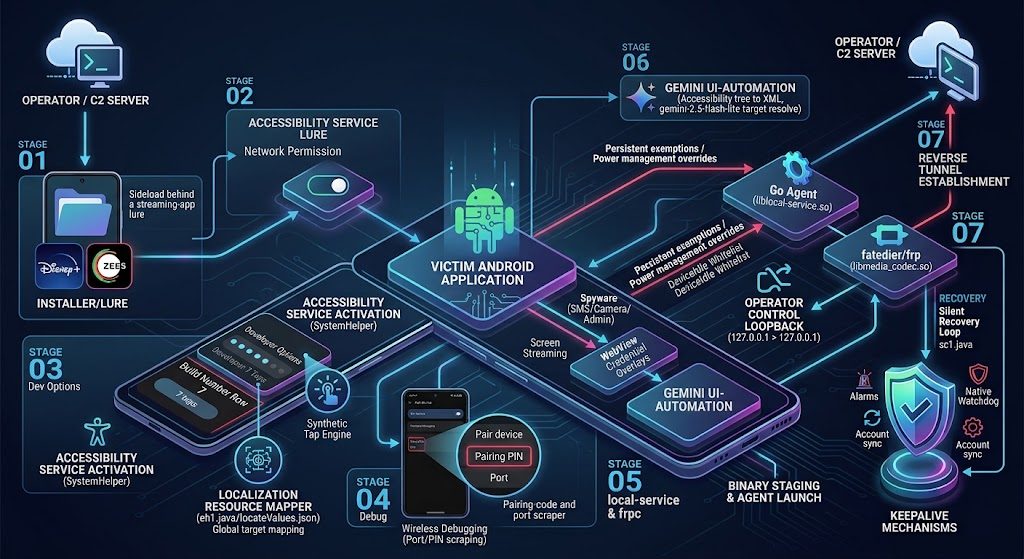
图示说明:该图展示 RatHat 从站外 APK、无障碍权限、无线 ADB 配对,到生成式 AI 界面导航、Go 代理、FRP 反向隧道和卸载后恢复的七阶段关系;它说明组件如何串联,不代表攻击者归属、感染数量或资金损失已经确认。来源:https://zimperium.com/blog/rathat-ai-powered-mobile-threat-is-here-for-your-credentials-bank-accounts
ADB 越权与驻留:内置 ADB 库在本机完成无线调试配对后,以 Shell 身份把 Go 代理和 FRP 反向代理写入 /data/local/tmp;二者负责系统命令、权限维持、离线任务和外部隧道,即使用户卸载 APK 仍可重新安装。
数据窃取:覆盖页、无障碍事件、通知监听、屏幕采集和原始触摸坐标共同收集账户、验证码与锁屏凭据,常规禁止截图或隐藏 PIN 文本的保护无法阻止 Shell 读取 /dev/input。
事件根因深度分析
基础设施与云配置错误:生成式 AI 服务和 C2 被当作远程决策与控制组件,但公开材料未说明模型账户、接口密钥或服务端约束;企业侧若只检查固定恶意域名,也难以识别合法 AI API 承载的界面决策流量。
AI 供应链与存储缺陷:实时界面树会离开设备交给外部 AI 处理,模型名称与数据保留方式均未披露;这既形成第三方处理链,也让基于固定脚本特征的检测失去稳定输入。
前沿算法/工程逻辑缺陷:模型只需完成“找控件、读文字、给滚动指令”等局部任务,就能让木马跨机型和语言适配;危害来自低风险 AI 能力被嵌入高风险执行链,而非模型自身发现 Android 漏洞。
复合依赖与应急响应缺陷:RatHat 把社会工程、无障碍自动点击、无线 ADB、本地 Shell、Go 代理和 FRP 隧道串成互相恢复的多级链路;只删除前台 APK 或撤销单项权限不能保证清除驻留。
边界防御与分层隔离缺陷:Android 把无障碍服务视为用户授权的高信任自动化能力,而设置界面又可被该能力操作;当它进一步自助完成 ADB 配对,普通应用沙箱便被 Shell 级执行通道绕开。
VERIZON DBIR 事件分类
System Intrusion(系统入侵),以 Social Engineering(社会工程)作为初始入口:攻击者先诱导用户侧载并授权恶意应用,再通过无线 ADB、常驻代理和反向隧道维持设备控制,最终收集金融与认证数据。
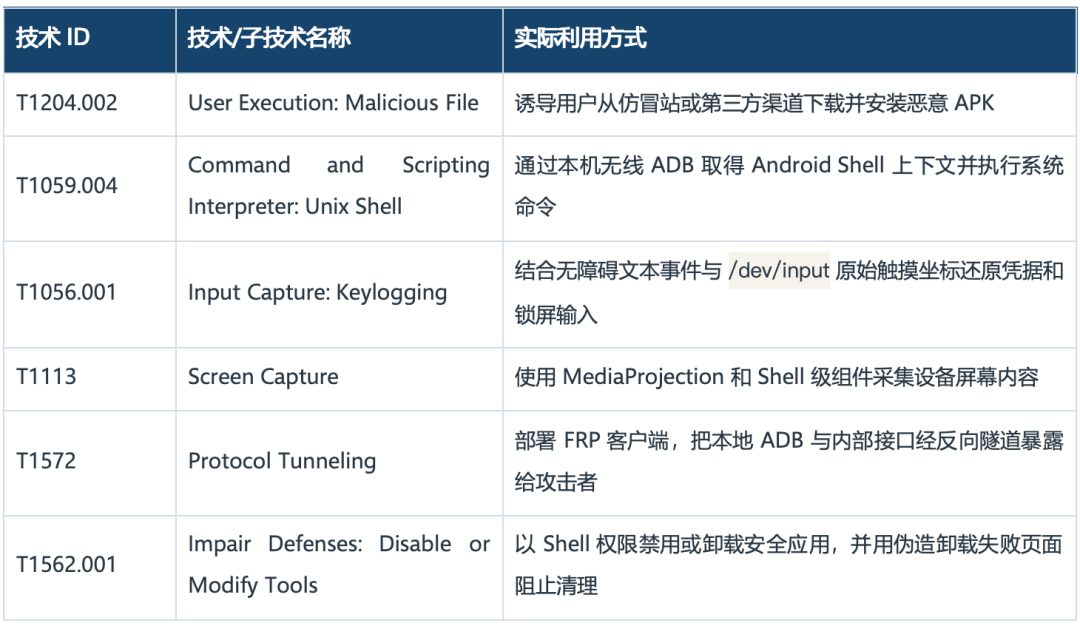
攻击路径与 MITRE ATT&CK 技术映射
防御启示
移动设备管理应阻止未知来源 APK、限制开发者选项与无线调试,并把“新授予无障碍权限后紧接着开启 ADB、本机回环配对或启动 FRP”设为高置信关联告警。
金融与企业应用不能只依赖禁止截图或隐藏输入文字;应检测覆盖页、异常无障碍服务、调试状态和受损设备环境,对高风险会话触发强制退出或二次核验。
检测 AI 赋能恶意软件时要区分模型决策流与执行流:监控界面树外发、AI API 调用和非常规自动点击,同时在设备侧阻断 ADB Shell、常驻二进制和反向隧道,避免把防线押在识别提示词上。
内容编辑:浦明
责任编辑:吕治政
本公众号原创文章仅代表作者观点,不代表绿盟科技立场。所有原创内容版权均属绿盟科技研究通讯。未经授权,严禁任何媒体以及微信公众号复制、转载、摘编或以其他方式使用,转载须注明来自绿盟科技研究通讯并附上本文链接。
关于我们
绿盟科技研究通讯由绿盟科技创新研究院负责运营,绿盟科技创新研究院是绿盟科技的前沿技术研究部门,包括星云实验室、天枢实验室和孵化中心。团队成员由来自清华、北大、哈工大、中科院、北邮等多所重点院校的博士和硕士组成。
绿盟科技创新研究院作为“中关村科技园区海淀园博士后工作站分站”的重要培养单位之一,与清华大学进行博士后联合培养,科研成果已涵盖各类国家课题项目、国家专利、国家标准、高水平学术论文、出版专业书籍等。
我们持续探索信息安全领域的前沿学术方向,从实践出发,结合公司资源和先进技术,实现概念级的原型系统,进而交付产品线孵化产品并创造巨大的经济价值。