OLLVM学姐攻略手册
北袅 2026-09-19 18:04 上海
看雪论坛作者ID:北袅
OLLVM 是一类实现的统称:凡在官方 LLVM 上叠加混淆 Pass 的都算。它源自瑞士 HEIG-VD 的 obfuscator-llvm,提出了指令替换(-sub)、虚假控制流(-bcf)、控制流平坦化(-fla)三种经典 Pass。原始项目停在 LLVM 4.0,后来的实现多是移植到新版 LLVM,或加上字符串加密、间接跳转等新手段。
本文不研究这些 Pass 怎么实现,本文以1万6千字详细记录了面对不同 Pass 时如何落地一套还原思路,据我所知对抗办法并非只有本文列出的内容,还有Triton、unidbg等工具,碍于篇幅没有将所有的工具都做实践记录。
OLLVM 的版本差异
OLLVM 是一类实现而非固定工具,差异主要有四处:
一是底座 LLVM 版本,从 4 到 17 不等,现在能用的多是移植到新版的社区分支;二是 Pass Manager,旧版 Legacy PM、新版 New PM,注册和开关传递方式不同;三是开关命名,同样是平坦化,有的叫 -fla,有的叫 -irobf-cff;四是 Pass 种类,除三件套外还可能带字符串加密、间接跳转等,比如上海交大 GoSSIP 的 Armariris 就去掉了 BCF、加了字符串加密。
本文选 LLVM 16.0.6 作底座,配 wwh1004 维护的 ollvm-16,能编现代代码,开关沿用经典的 -sub / -bcf / -fla。
编译混淆样本(可跳过 附件提供编译好的样本)
2.1 安装依赖
sudo apt update
sudo apt install -y build-essential cmake ninja-build git python3 zlib1g-dev
2.2 获取源码
获取LVM 16 底座与 ollvm-16 混淆 Pass
cd ~
git clone --depth 1 --branch llvmorg-16.0.6 https://github.com/llvm/llvm-project.git
git clone https://github.com/wwh1004/ollvm-16.git
2.3 合并 Pass 到 LLVM 源码树
将混淆 Pass 目录拷入 LLVM 的 lib 目录,并在构建系统中包含它
cp -r ~/ollvm-16/Obfuscation ~/llvm-project/llvm/lib/
echo 'add_subdirectory(Obfuscation)' >> ~/llvm-project/llvm/lib/CMakeLists.txt
确认文件与配置到位
ls ~/llvm-project/llvm/lib/Obfuscation/Plugin.cpp
grep -n "Obfuscation" ~/llvm-project/llvm/lib/CMakeLists.txt
2.4 编译带混淆的 clang
mkdir -p ~/llvm-project/build && cd ~/llvm-project/build
cmake -G Ninja -DCMAKE_BUILD_TYPE=Release \
  -DLLVM_ENABLE_PROJECTS="clang" \
  -DLLVM_TARGETS_TO_BUILD="AArch64;X86" \
  -DLLVM_OBFUSCATION_LINK_INTO_TOOLS=ON \
  -DLLVM_INCLUDE_TESTS=OFF \
  -DLLVM_INCLUDE_EXAMPLES=OFF \
  -DLLVM_INCLUDE_BENCHMARKS=OFF \
  ../llvm
ninja clang
不报 unknown argument 即为成功:
~/llvm-project/build/bin/clang -mllvm -sub -mllvm -fla -c rc4.c -o /dev/null2.5 安装 Android NDK
cd ~
wget https://dl.google.com/android/repository/android-ndk-r27d-linux.zip
unzip android-ndk-r27d-linux.zip
2.6 编译对照样本
写入 rc4.c:
mkdir -p ~/rc4_lab && cd ~/rc4_lab && cat > rc4.c << 'EOF'
#include<stddef.h>
void rc4_crypt(constunsignedchar *key, size_t key_len,
unsignedchar *data, size_t data_len) {
unsignedchar S[256];
int i, j;
// KSA
for (i = 0; i < 256; i++) S[i] = (unsignedchar)i;
    j = 0;
for (i = 0; i < 256; i++) {
        j = (j + S[i] + key[i % key_len]) & 0xFF;
unsignedchar tmp = S[i]; S[i] = S[j]; S[j] = tmp;
    }
// PRGA
    i = j = 0;
for (size_t k = 0; k < data_len; k++) {
        i = (i + 1) & 0xFF;
        j = (j + S[i]) & 0xFF;
unsignedchar tmp = S[i]; S[i] = S[j]; S[j] = tmp;
        data[k] ^= S[(S[i] + S[j]) & 0xFF];
    }
}
EOF
配置编译所需的环境变量
export CLANG=~/llvm-project/build/bin/clang
export SYSROOT=~/android-ndk-r27d/toolchains/llvm/prebuilt/linux-x86_64/sysroot
export NDK_BIN=~/android-ndk-r27d/toolchains/llvm/prebuilt/linux-x86_64/bin
export NDK_RES=$($NDK_BIN/clang -print-resource-dir)
export COMMON="--target=aarch64-linux-android21 --sysroot=$SYSROOT -fuse-ld=lld -B$NDK_BIN -resource-dir=$NDK_RES -O0 -shared -fPIC"
编译四个对照样本:
cd ~/rc4_lab
$CLANG$COMMON rc4.c -o librc4_base.so           # 基线,不混淆
$CLANG$COMMON -mllvm -sub rc4.c -o librc4_sub.so # 指令替换
$CLANG$COMMON -mllvm -bcf rc4.c -o librc4_bcf.so # 虚假控制流
$CLANG$COMMON -mllvm -fla rc4.c -o librc4_fla.so # 控制流平坦化
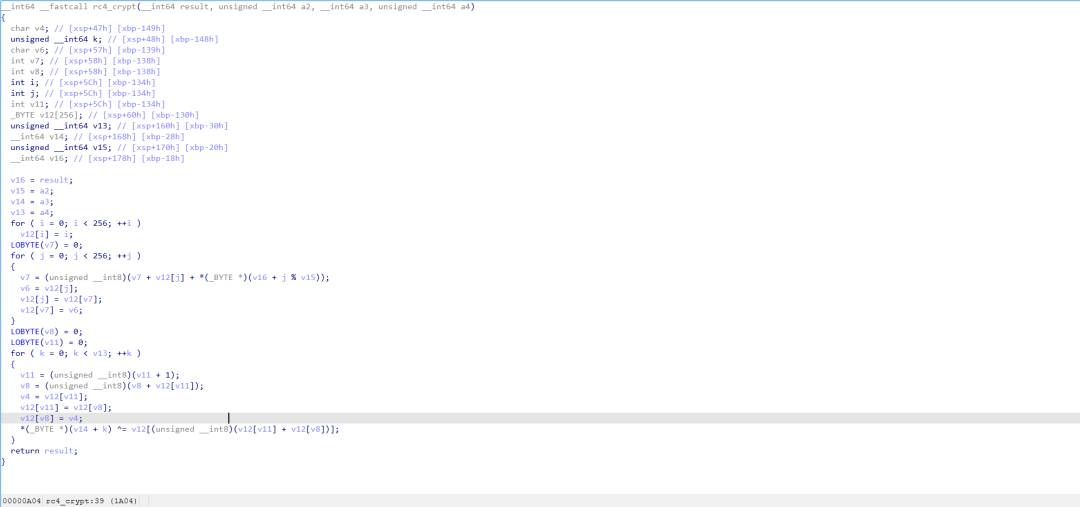
下面是伪代码图:
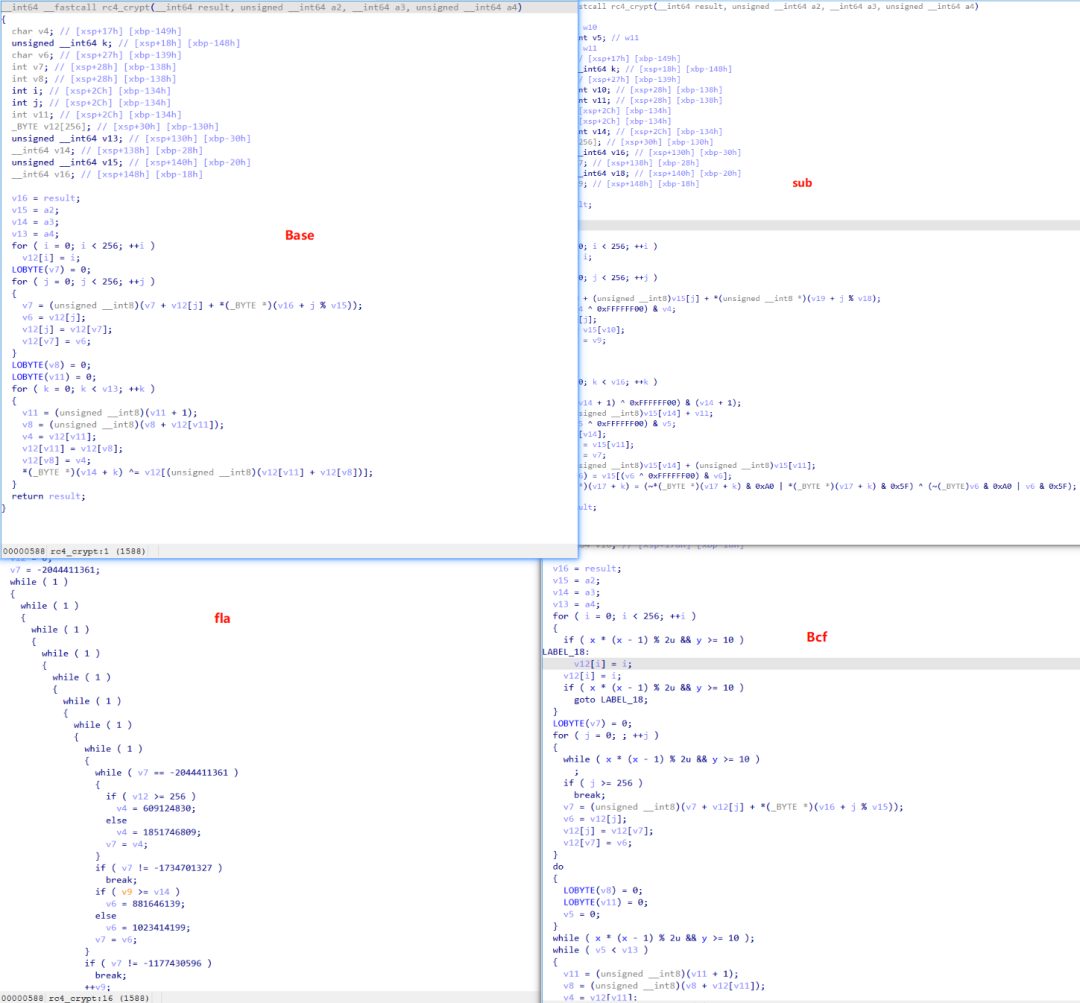
逆向工具链搭建
分析阶段使用两个工具:D-810 与 GAMBA。前者是 IDA 插件,在反编译时基于微码进行去混淆;后者是独立的命令行 MBA 简化工具,用于处理 D-810 无法覆盖的残留表达式。
3.1 安装 D-810
D-810 依赖 Hex-Rays 反编译器,要求 IDA 7.5 及以上;本文使用的 d810-ng 分支要求 IDA 9 与 Python 3.10 及以上。
首先安装 Z3 求解器:
python -m pip install z3-solver从 https://github.com/w00tzenheimer/d810-ng 获取源码,解压后将其放入 IDA 的 plugins 目录。
https://gitlab.com/eshard/d810原版
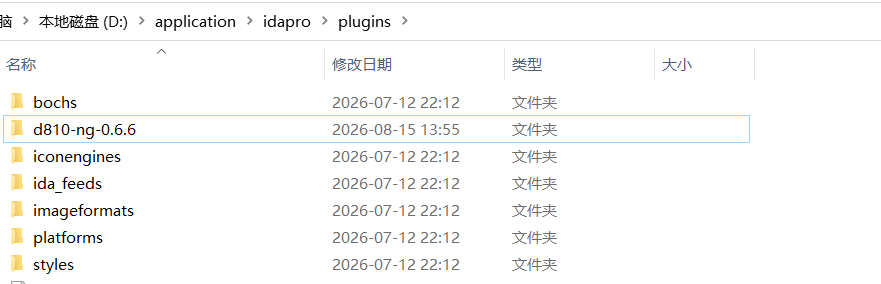
重启ida在插件内就可以找到D810了 打开后长这样
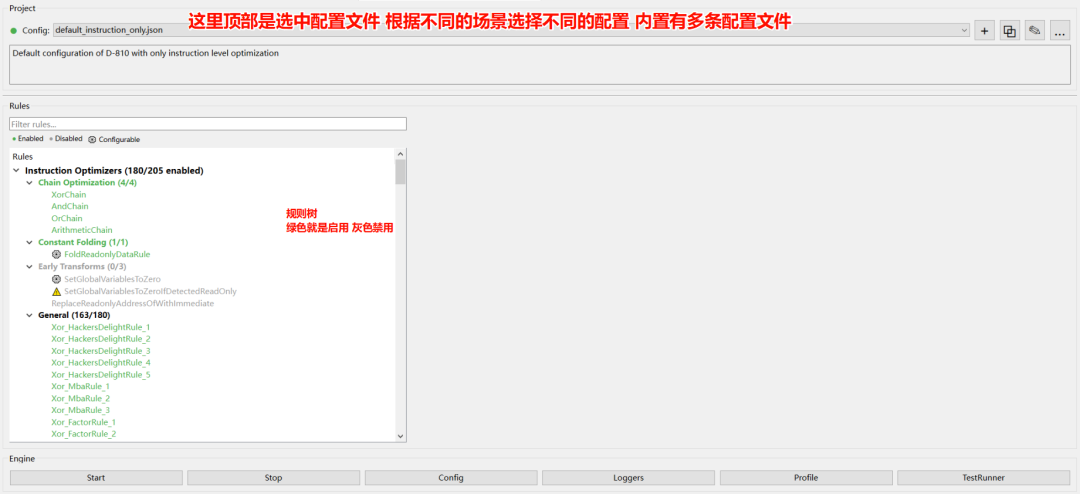
关于配置的介绍可以去看目录下的介绍
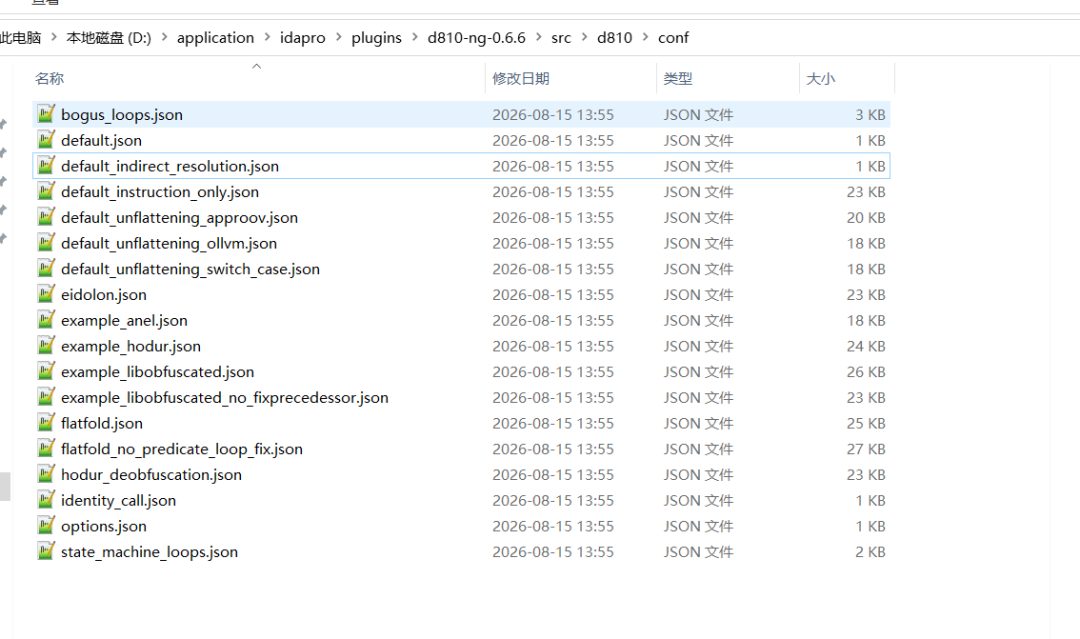
3.2 安装 GAMBA
GAMBA 为纯 Python 项目,从 https://github.com/DenuvoSoftwareSolutions/GAMBA 获取并解压。其依赖为 NumPy(必需)与 Z3(仅在使用等价性验证时需要,前一步已安装):
pip install numpy安装完成后执行冒烟测试:
"C:\Program Files\Python310\python.exe" src\simplify_general.py "x+x"
指令替换
指令替换(instruction substitution)的核心手法是:把简单的算术或逻辑运算 替换成一组在数值上完全等价、但形式更冗长晦涩的表达式 运算结果一模一样 只是写法被故意复杂化 让反编译结果难以一眼看懂原本的语义 替换出来的东西通常表现为 MBA(Mixed Boolean-Arithmetic,混合布尔-算术)表达式——即把普通算术和位运算混在一起。
下面是混淆前与混淆后的对比
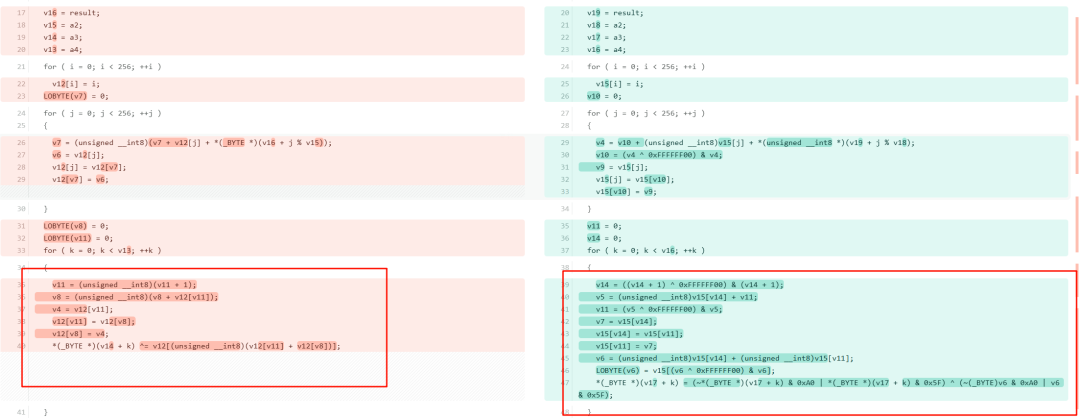
经 -sub 编译后,反编译结果的运算被替换为等价但晦涩的形式
D-810 批量还原
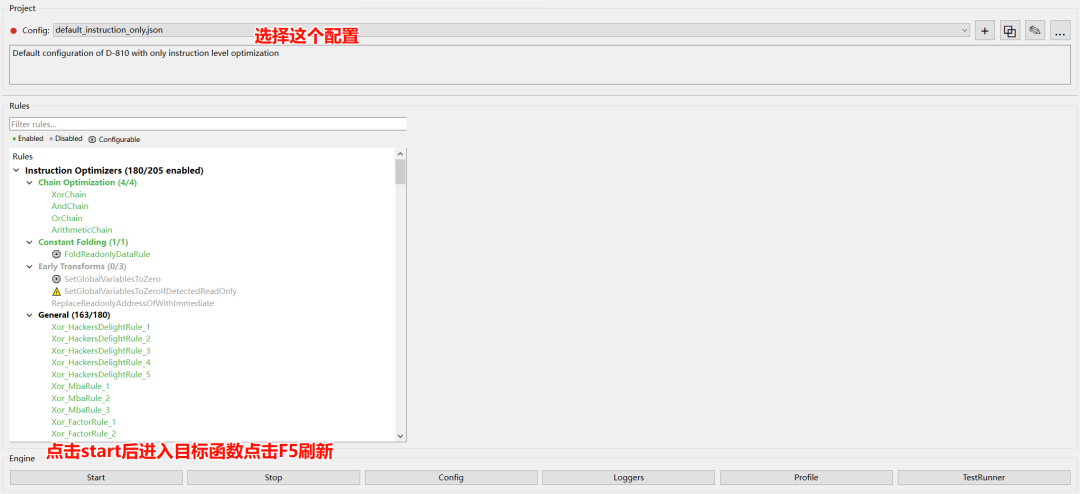
D-810 基于规则匹配工作,其能力取决于规则库的覆盖范围。本例中仍有两处表达式未被还原,分别位于反编译结果的第 44、45 行:
LOBYTE(v5) = v14[(v5 ^ 0xFFFFFF00) & v5];
*(_BYTE *)(v16 + k) = (~*(_BYTE *)(v16 + k) & 0xA0 | *(_BYTE *)(v16 + k) & 0x5F) ^ (~(_BYTE)v5 & 0xA0 | v5 & 0x5F);
前者是嵌入数组下标中的取字节操作,后者是加密行的 MBA 形式。这两处交由 GAMBA 处理。
GAMBA 处理残留表达式
我不想手工去拆 费力不讨好 还容易拆错 不如直接交给ai去做 将GAMBA 官方 README丢给ai 然后写入如下提示词。
【插入GAMBA 官方 README】
你的任务:根据下面的"变量类型"清单和规则,把"代码片段"中的每一条混淆表达式改写成 GAMBA 能处理的标准输入,并生成可直接运行的 CMD 命令。
输出要求:只输出每条表达式对应的 CMD 执行命令,一行一条。不要输出分析过程、不要输出推测的化简结果、不要解释。
改写规则:
GAMBA 的输入必须是单个右值表达式,不能包含赋值号(=)、语句、数组下标(arr[...])、指针解引用(*(...))、类型转换((_BYTE)、LOBYTE() 等)、函数调用等非算术/位运算结构。
按下面的顺序对每条代码做提取(这是强制步骤,逐步执行):
第一步,若有赋值号 =,删掉赋值号及其左边的一切,只保留右边。
第二步,若结果形如 数组名[EXPR](例如 v14[EXPR]),只保留方括号内部的 EXPR,把数组名和方括号整个删掉。改写后表达式里不允许再出现任何数组名或 [ ]。
示例:v14[(v5 ^ 0xFFFFFF00) & v5] 提取后应为 (v5 ^ 0xFFFFFF00) & v5,不是 v14[(v5 ^ 0xFFFFFF00) & v5]。
第三步,把所有内存访问 / 指针解引用替换成简单变量名(如 *(_BYTE*)(v16+k) → m)。同一个内存位置在一条表达式里多次出现时,必须替换成同一个变量名。
第四步,删掉所有类型转换记号((_BYTE)、LOBYTE() 等),只保留被转换的变量本身(在 8 位位宽下这样做语义等价,见位宽规则)。
除了上面第 2 条的"提取/替换"和下面第 4 条的"补全括号"外,严禁对表达式做任何数学化简、合并、消去(包括你认为显然的化简)。化简是 GAMBA 的职责,你只负责把原始表达式格式化后交给它。必须喂未化简的原始表达式。
补全括号:GAMBA 遵循 Python 运算符优先级(& 高于 ^ 高于 |,+/- 高于位运算)。C 代码里靠优先级隐式分组的地方,改写时必须显式加括号保持原语义。例如 ~x & 0xA0 | x & 0x5F 要写成 ((~x) & 0xA0) | (x & 0x5F)。对于 A ^ B 形式、且 A、B 各自是复合表达式时,要写成 (A) ^ (B),即每个操作数外各包一层括号。
位宽 -b 的确定方法(按下面顺序判断,取满足条件的最小位宽):
下限:位宽必须大到不会截断表达式中出现的最大常量。例如出现 0xFFFFFF00 就至少需要 32 位,否则常量被截断、语义改变。
运算域:
若表达式中某变量做的是完整宽度运算(存在超过 8 位的常量,或明显的宽位运算),只是最后才取低字节,则按该变量在"变量类型"清单里的声明类型定位宽(int/unsignedint/_DWORD→32,__int64/_QWORD/指针→64)。不要因为末尾取字节就降低位宽。
若表达式中所有操作数都在字节域内(内存访问是 _BYTE、变量被显式强转成 (_BYTE)/LOBYTE、常量都不超过 8 位),则整个表达式按 8 位处理;此时被强转的 (_BYTE)v 直接写作 v。
一句话:位宽 = 能容纳所有常量、且匹配表达式实际运算域的最小宽度。
类型映射参考:char/_BYTE/__int8→8,short/__int16→16,int/unsignedint/_DWORD→32,__int64/_QWORD/指针→64。
每条命令都要带验证参数 -z 1(本机 GAMBA 的 -z 必须带参数)。禁止自行口算或用恒等式推导简化结果、禁止声称某表达式"可能简化为"某形式——一切化简交给 GAMBA 运行得出。
命令格式:python3 src/simplify_general.py "改写后的表达式" -b 位宽 -z 1
输出前必须逐条自检,全部通过才能输出,任何一项不通过就修正后重查:
(a) 表达式里不得残留任何 [、]、*、=、(_BYTE)、LOBYTE、数组名等非 MBA 符号。
(b) 必须严格!!!从左到右数一遍:左括号 ( 的总数必须等于右括号 ) 的总数。
(c) 逐字符扫描,确认任意位置右括号的累计数不超过左括号的累计数(即括号正确嵌套、无提前闭合)。
(d) 喂进去的是未化简的原始表达式,不是你替它算出的结果。
变量类型:
int v4; // w10
unsignedint v5; // w11
int v6; // w11
char v7; // [xsp+17h] [xbp-149h]
unsigned __int64 k; // [xsp+18h] [xbp-148h]
char v9; // [xsp+27h] [xbp-139h]
unsignedint v10; // [xsp+28h] [xbp-138h]
unsignedint v11; // [xsp+28h] [xbp-138h]
int i; // [xsp+2Ch] [xbp-134h]
int j; // [xsp+2Ch] [xbp-134h]
unsignedint v14; // [xsp+2Ch] [xbp-134h]
  _BYTE v15[256]; // [xsp+30h] [xbp-130h]
unsigned __int64 v16; // [xsp+130h] [xbp-30h]
  __int64 v17; // [xsp+138h] [xbp-28h]
unsigned __int64 v18; // [xsp+140h] [xbp-20h]
  __int64 v19; // [xsp+148h] [xbp-18h]
代码片段:
LOBYTE(v5) = v14[(v5 ^ 0xFFFFFF00) & v5];
*(_BYTE *)(v16 + k) = (~*(_BYTE *)(v16 + k) & 0xA0 | *(_BYTE *)(v16 + k) & 0x5F) ^ (~(_BYTE)v5 & 0xA0 | v5 & 0x5F);
输入内容只需要代码的CMD执行命令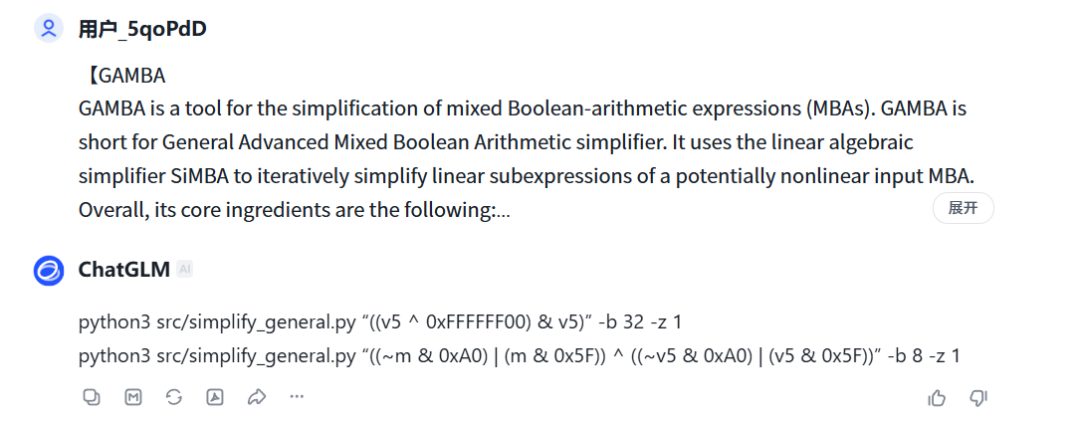
经简单测试 AI会出现位宽和括号数量不对等的情况 需要人工简单看一下 GLM和deepseek可以很好的遵循指令生成正确的命令 但是偶尔也需要自己看一下。
得到命令如下
python3 src/simplify_general.py "((v5 ^ 0xFFFFFF00) & v5)" -b 32 -z 1
python3 src/simplify_general.py "((~m & 0xA0) | (m & 0x5F)) ^ ((~v5 & 0xA0) | (v5 & 0x5F))" -b 8 -z 1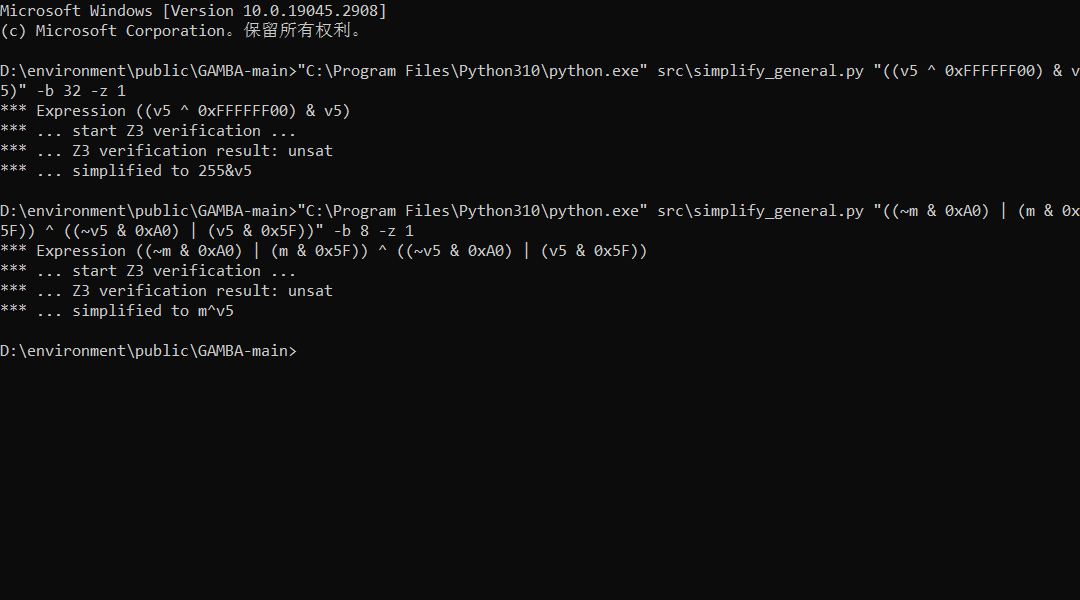
至此就得到了简化后的最终表达式 可以将规则写入d810中供其识别 也可以更简单直接打个注释就行 省的麻烦
(v5^0xFFFFFF00)&v5 == 255&v5 即 v5&0xFF(~m&0xA0|m&0x5F)^(~v5&0xA0|v5&0x5F) == m^v5虚假控制流
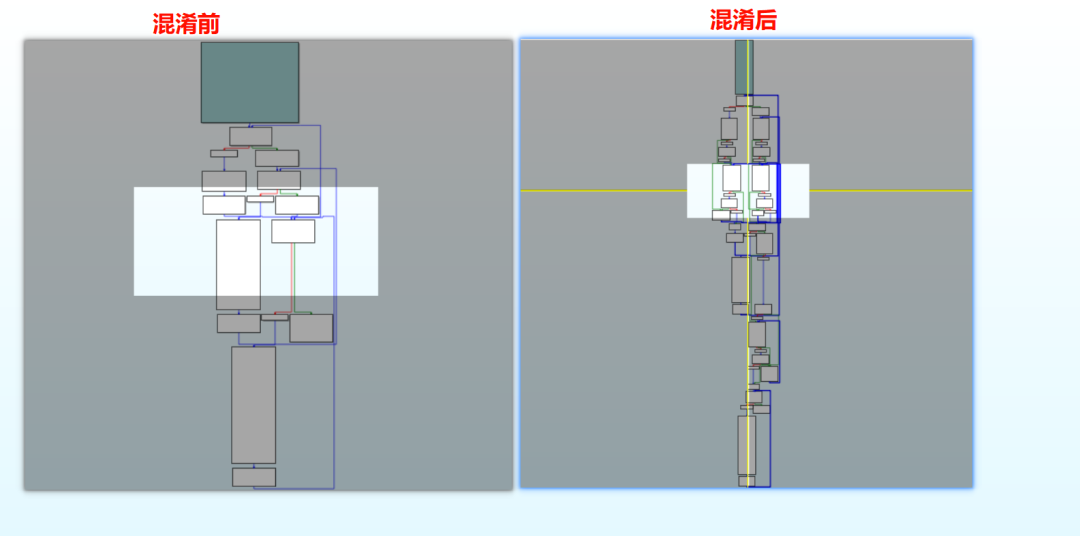
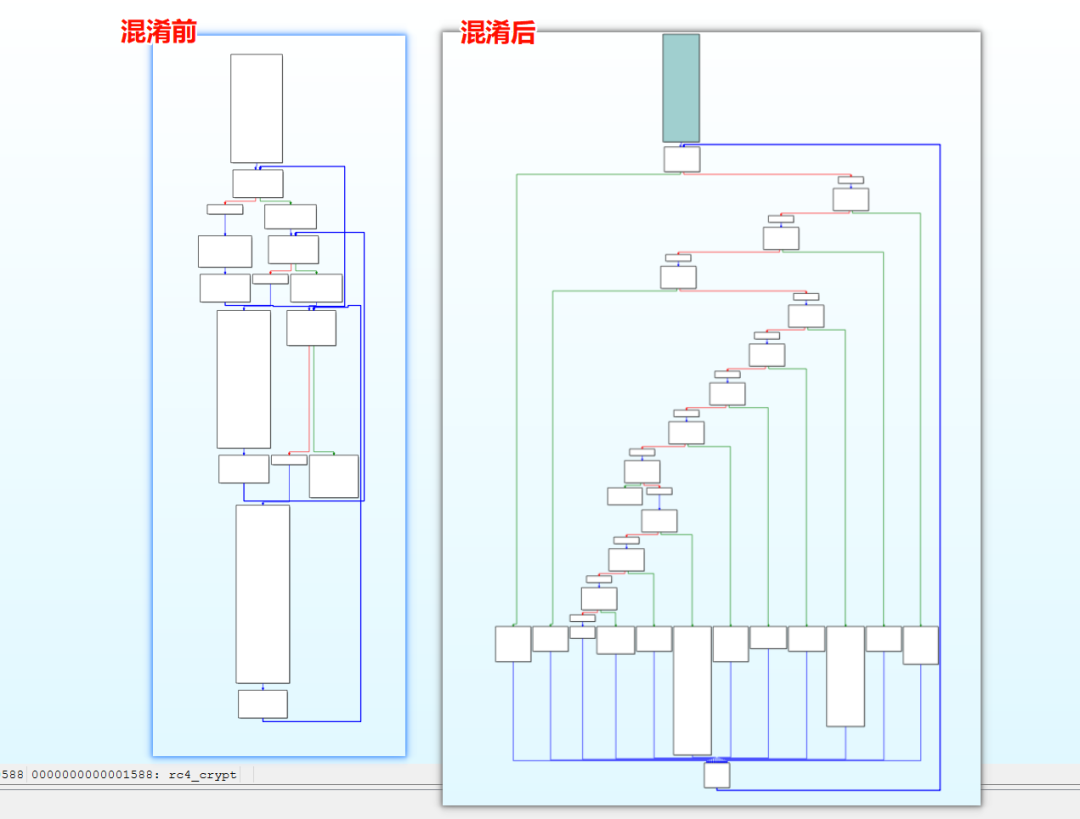
虚假控制流(bogus control flow)的核心手法是:用一个恒真或恒假的不透明谓词(opaque predicate),往原本线性的代码里塞进永远不会走(或永远会走)的虚假分支,让控制流图膨胀,人眼和反编译器都被迫去分析大量根本不影响结果的路径。
下面是混淆前后的对比,可以明显的看到相比原版的流程图新增了多条分支
那么面对bcf又该怎么处理呢?根据目前网上大佬们公开的方案有以下几种
思路一:D-810 插件
这个最简单粗暴 选择bogus_loops.json后F5刷新
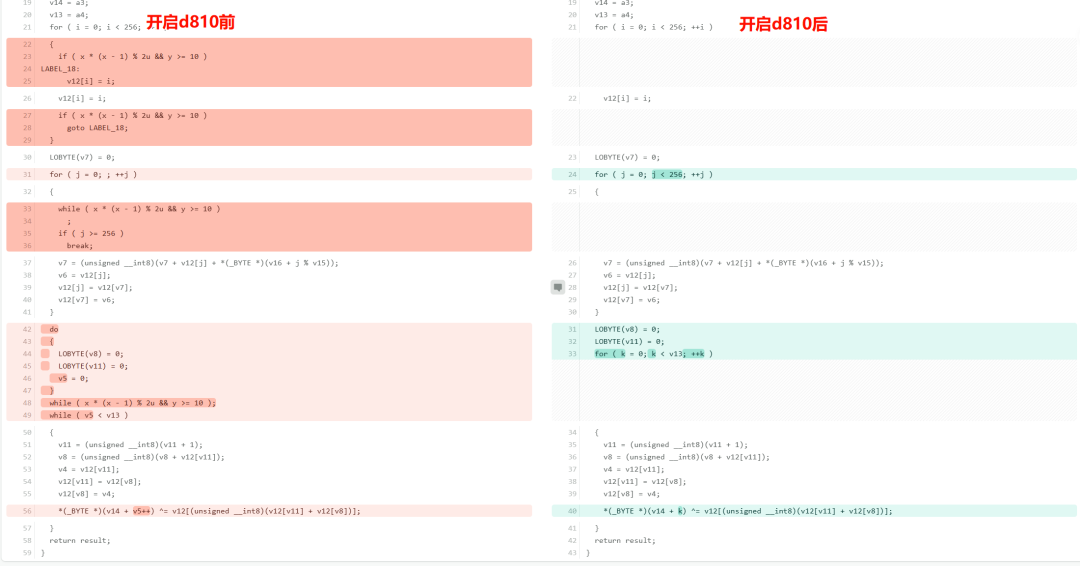
对照前后,D-810 精确地消除了三处 BCF 虚假结构
第一处,KSA 初始化循环。混淆前的 if (谓词) LABEL_18: v12[i]=i; 加 if (谓词) goto LABEL_18; 这一对不透明谓词分支,还原后彻底消失,坍缩回最干净的 for(i=0;i<256;++i) v12[i]=i;。
第二处,第二个循环里的空 while (谓词) ; 死循环被删除,for(j=0;;++j) 配 if(j>=256) break; 的畸形写法恢复成正常的 for(j=0; j<256; ++j)。
第三处,PRGA 前那个 do{...}while(谓词) 伪循环被展平成顺序的初始化语句,while(v5 < v13) 也恢复成标准的 for(k=0; k<v13; ++k)。
思路二:常量传播剪枝(改 .bss / 改指令)
改指令的适用场景是"谓词变量分布零散、或不在 .bss、不方便整段改数据"时才用。ARM64 下改指令成本高,一般优先改数据。
改 .bss 数据
**第一步:识别谓词变量
谓词 = 一个条件表达式 就是 if(...) 或 while(...) 括号里那坨判断真假的东西
BCF 往代码里插进去一个看起来像正常判断、实际上结果永远不变的条件 这个永远不变的条件叫不透明谓词
当前样本长这样
if ( x * (x - 1) % 2u && y >= 10 )括号里 x * (x - 1) % 2u && y >= 10 就是谓词。
怎么判断他是假 通过表达式代入值简单计算就可以知道
逻辑与得两边都成立才为真 看左边的表达式x * (x - 1) % 2u x设为5 带入式子中得到 5 * (5 - 1) % 2u 也就是5*4%2 = 0。
x 和 x-1 是连续两个整数 必有一个偶数 积必为偶 偶数%2 恒为 0 由此整个谓词恒为假
**第二步:定位 + 判断
双击x或y跳转过去看看他在哪个段
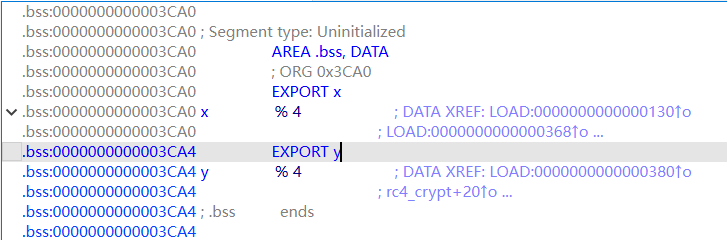
判断的标准是看当前段是否除了x、y还有第三个陌生的合法变量 如果没有就可以一刀切 全部patch为一个固定的值
当前段从开始到结束都没有第三个变量所以可以直接patch的
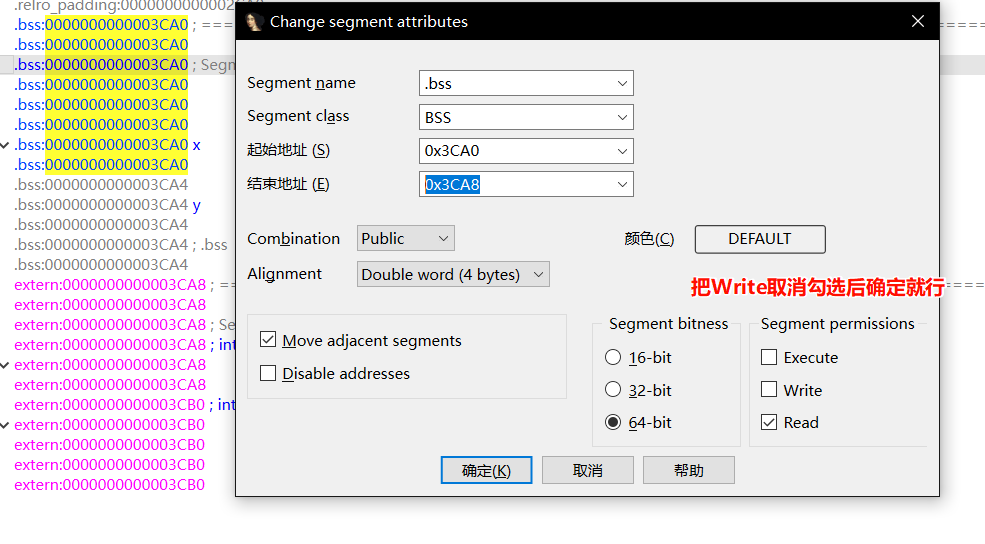
**第三步 设只读
鼠标选中段地址后打开菜单的编辑段
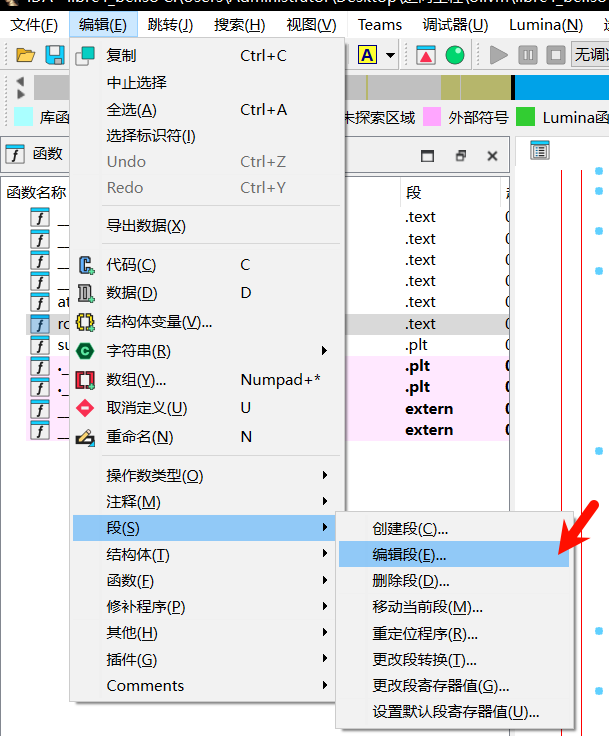
将权限设置为只读
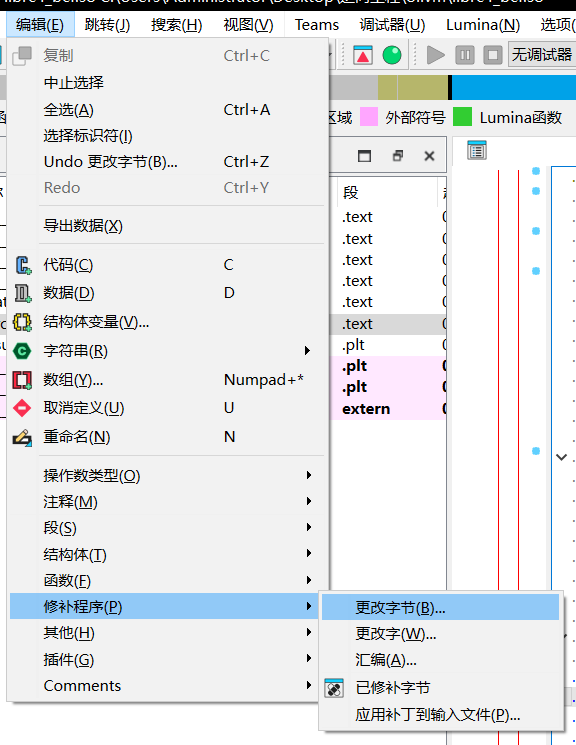
**第四步 patch
更改字节
写入
02 00 00 00 02 00 00 00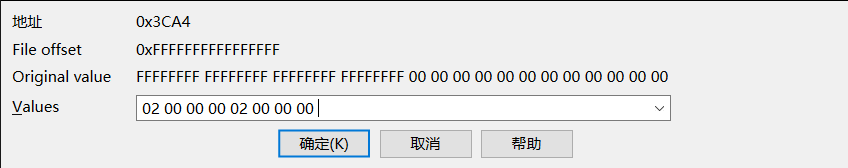
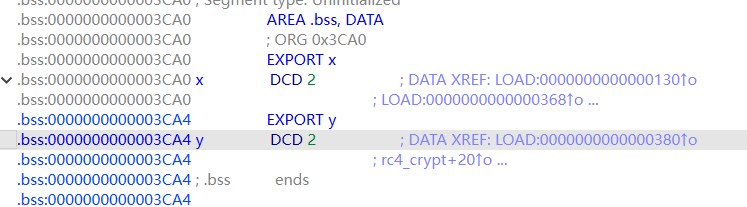
回到函数F5刷新一下就自动消除了 核心是依赖于IDA 的死代码消除 (DCE, Dead Code Elimination)
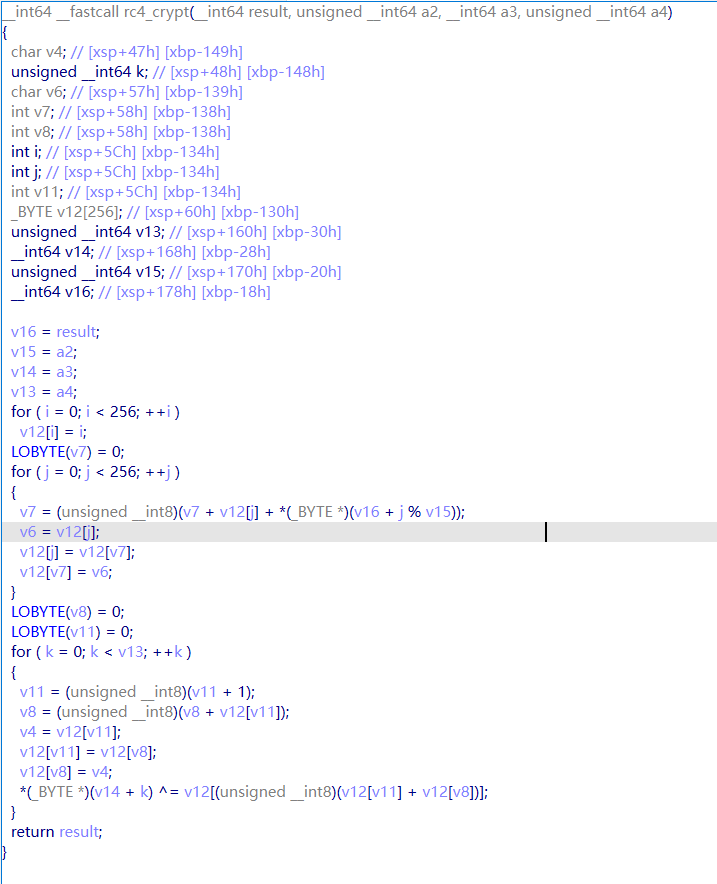
改指令
**第一步 分析哪些指令需要修改:
对x变量按下x快捷键查看其交叉引用
发现 x 是走 GOT,不是直接 LDR。逐条分析:
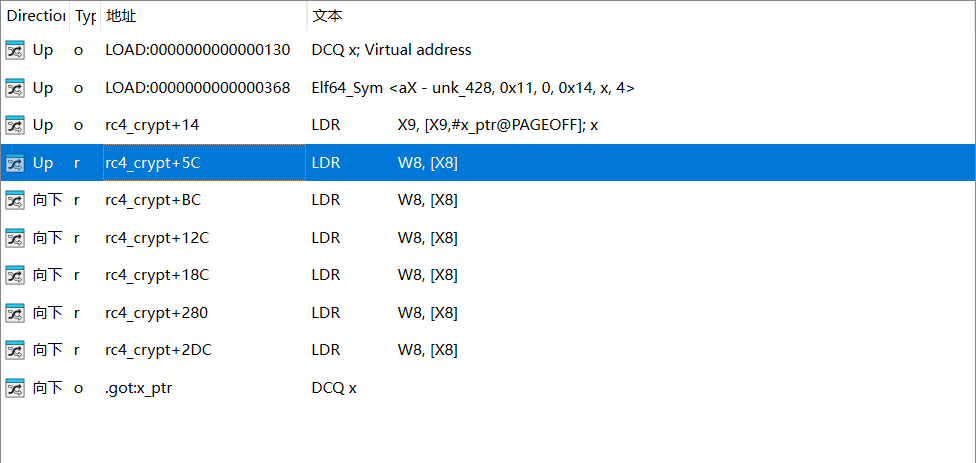
type列的o是offset r是read
o类的三条不用管
重点看r类 第一个 rc4_crypt+14 LDR X9, [X9,#x_ptr@PAGEOFF] ; x ← 第一级:从GOT取x的地址到X9
+14是先从GOT把x的地址装进寄存器,后面六条才是真正读x的值。把这六条改成MOV w8,#0,这样谓词独到的x就是恒为0了
脚本可以让ai帮写
import ida_xref, ida_segment, idc, idaapi
import keystone
ks = keystone.Ks(keystone.KS_ARCH_ARM64, keystone.KS_MODE_LITTLE_ENDIAN)
seg = ida_segment.get_segm_by_name('.bss')
for addr inrange(seg.start_ea, seg.end_ea, 4):
    ref = ida_xref.get_first_dref_to(addr)
while ref != idaapi.BADADDR:
if idc.print_insn_mnem(ref) == "LDR":
            dst = idc.print_operand(ref, 0)
            src = idc.print_operand(ref, 1)
if dst.startswith("W") and src.startswith("[") and"PAGEOFF"notin src and"#"notin src:
                enc, cnt = ks.asm(f"MOV {dst}, #0", ref)
if cnt:
for i inrange(4):
                        idc.patch_byte(ref + i, enc[i])
print(f"patched {hex(ref)}: MOV {dst}, #0")
else:
print(f"skip(addr-load) {hex(ref)}: {idc.GetDisasm(ref)}")
        ref = ida_xref.get_next_dref_to(addr, ref)
print("done")
运行结果
skip(addr-load)0x165c:LDRX9, [X9,#x_ptr@PAGEOFF]; x
patched 0x16a4:MOVW8, #0
patched 0x1704:MOVW8, #0
patched 0x1774:MOVW8, #0
patched 0x17d4:MOVW8, #0
patched 0x18c8:MOVW8, #0
patched 0x1924:MOVW8, #0
skip(addr-load)0x1668:LDRX9, [X9,#y_ptr@PAGEOFF]; y
patched 0x16a8:MOVW9, #0
patched 0x1708:MOVW9, #0
patched 0x1778:MOVW9, #0
patched 0x17d8:MOVW9, #0
patched 0x18cc:MOVW9, #0
patched 0x1928:MOVW9, #0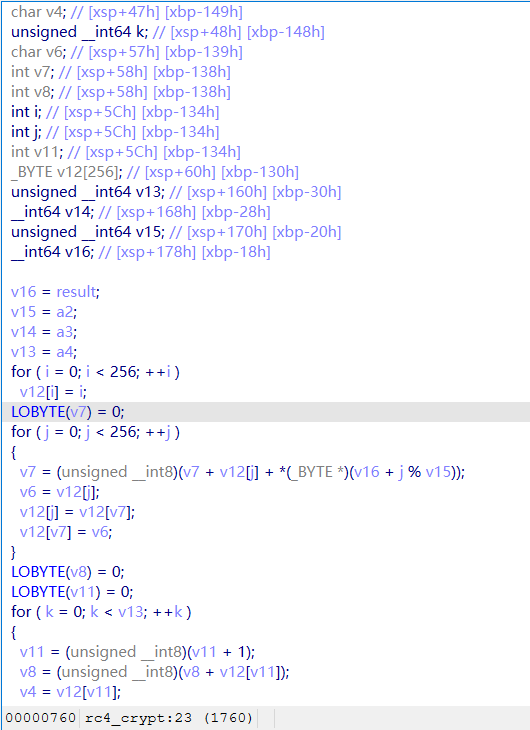
思路三:符号执行(deflat 踩坑&不推荐)
angr 是底层框架,deflat 是基于 angr 写的脚本。deflat 的作用是用符号执行去除 OLLVM 混淆,分两个脚本,一个去虚假控制流(BCF),一个去控制流平坦化(FLA);整体思路是用符号执行"跑一遍"程序,看它实际会走哪些路,再把没走到的混淆代码抹掉、把真实的跳转关系补回去。
下载地址:https://github.com/cq674350529/deflat
下载后安装一下依赖
pip install angr我们使用bogus_control_flow的debogus脚本来处理样本bcf
建议跑一下下面的脚本查一下angr 的加载基址 当前项目是0x400000
import angr
p = angr.Project("librc4_bcf.so", load_options={'auto_load_libs': False})
print(hex(p.loader.main_object.mapped_base))
在ida中找到函数的地址
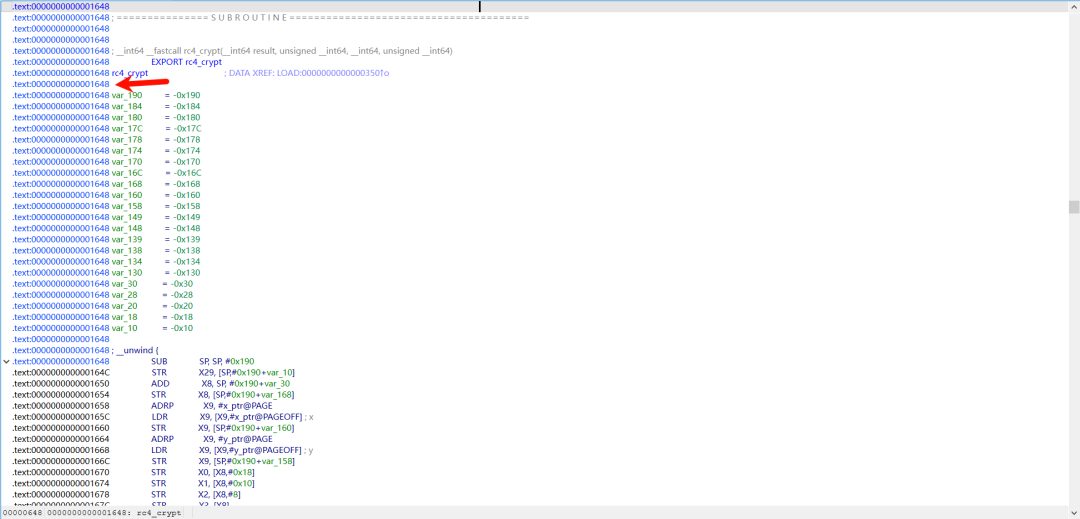
在bogus_control_flow目录下中运行命令
python debogus.py -f librc4_bcf.so--addr0x401648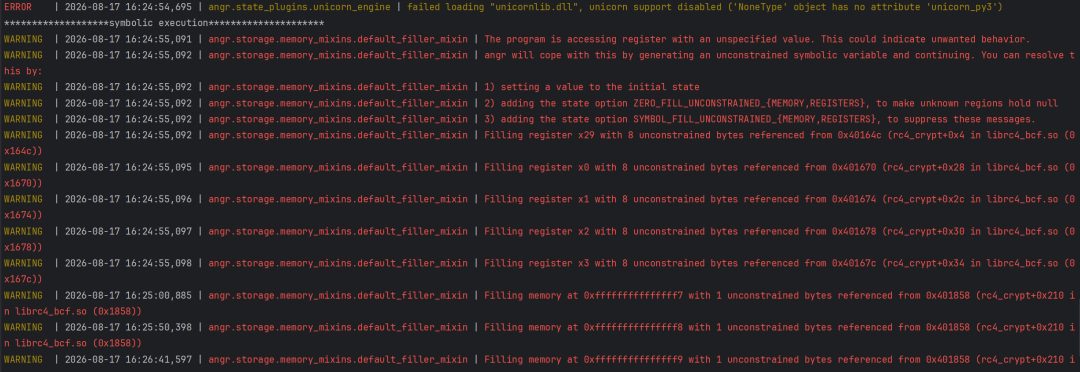
通过时间可以不难发现 跑的奇慢无比 主要原因是因为 这个函数里有循环 循环次数依赖一个符号值(比如 key 长度 data_len 或索引) angr 不知道这个值多大 只能把每种可能都当成一条路径去跑 路径数量指数级膨胀 越跑越慢 解决起来也简单
打开debogus 找到这段:
    state = project.factory.blank_state(addr=target_function.addr, remove_options={
                                        angr.sim_options.LAZY_SOLVES})
把它整段替换成:
    state = project.factory.blank_state(
        addr=target_function.addr,
        remove_options={angr.sim_options.LAZY_SOLVES},
        add_options={
            angr.sim_options.ZERO_FILL_UNCONSTRAINED_MEMORY,
            angr.sim_options.ZERO_FILL_UNCONSTRAINED_REGISTERS,
        },
    )
改的就是给 blank_state 多加一个 add_options 参数 里面放两个零填充选项 作用是:未初始化的内存和寄存器一律填 0 而不是用符号变量 这样那些 warning 会消失 循环里也不会因为符号值产生一堆分支导致卡死。
修改保存后再跑一遍
肥肠之快

效果如下
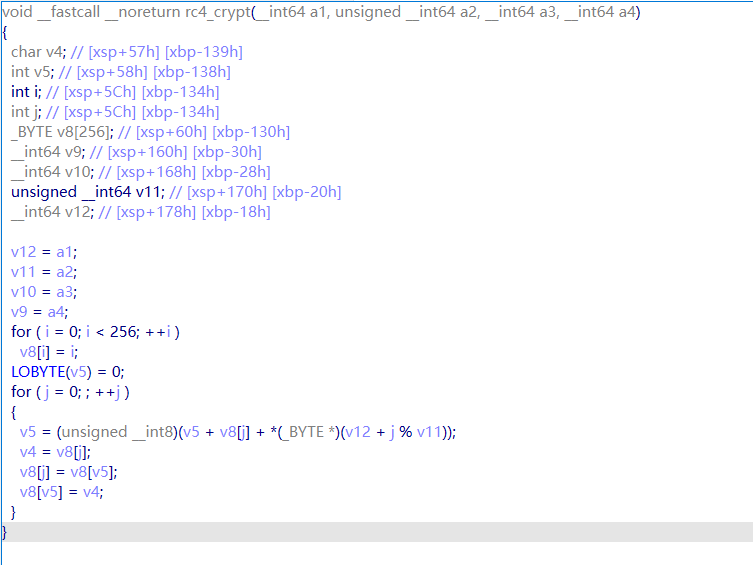
简单观察发现 少了一大截代码
for ( j = 0; ; ++j )变成了死循环 整个 PRGA 部分都没了 将前面的代码还原回去直接跑 静待结果(bushi 绕回来了 抄近路失败)
目前这条路我走不通 跑一整天可能都跑不完 感兴趣的兄弟可以去试试 欢迎大佬补充指点一下
思路四 qiling污点追踪
来源:https://www.arocmag.cn/abs/2022.04.0157
简单说说一下论文的核心思路
动态跑起来、hook 每条指令、识别不透明谓词、把恒真/恒假分支改成无条件跳转
不透明谓词简单分析
OLLVM的BCF用的经典不透明谓词是(x*(x-1)%2)==0(奇偶相乘必得偶数,恒等于0永真)当前样本这段模式反复出现。
LDR   W8, [X8]        ; W8 = x
LDR   W9, [X9]        ; W9 = y
SUBS  W9, W8, #1      ; W9 = x-1
MUL   W8, W8, W9      ; W8 = x*(x-1)
MOV   W10, #2
UDIV  W9, W8, #2
MUL   W9, W9, W10
SUBS  W8, W8, W9      ; W8 = x*(x-1) % 2   ← 恒为 0
SUBS  W8, W8, #0
CSET  W8, EQ          ; W8 = 1 (恒成立)
TBNZ  W8, #0, loc_16EC
关键特征就是x和y是两个全局变量 他们存在.bss里 程序运行期间从不被写入 这个就是污点源。
所以判定一个基本块是不是虚假块 最可靠的动态方式就是监控x/y全局内存的读取 凡是这条条件跳转的判定值直接或间接来自x/y内存 就是不透名谓词分支。
哪个地址在整个运行过程中 被读之前从没有被写过 他就是可疑的污点源。
安装环境
Qiling 基于 Unicorn 纯 Python装起来很简单
python -m venv qlenv
.\qlenv\Scripts\Activate.ps1
pip install qiling capstone
pip install pyelftools
Qiling 模拟 ELF 需要一个 rootfs(里面放对应架构的动态库) 官方仓库自带 arm64 的 rootfs
git clone https://github.com/qilingframework/qiling.git
git clone https://github.com/qilingframework/rootfs.git qiling/examples/rootfs
# arm64 rootfs 在 qiling/examples/rootfs/arm64_linux
Qiling 测试
API文档:https://docs.qiling.io/en/latest/howto/
from qiling import Qiling
from qiling.const import QL_VERBOSE
ql = Qiling([r"qiling\examples\rootfs\arm64_linux\bin\arm64_hello"],
r"qiling\examples\rootfs\arm64_linux",
            verbose=QL_VERBOSE.DEFAULT)
ql.run()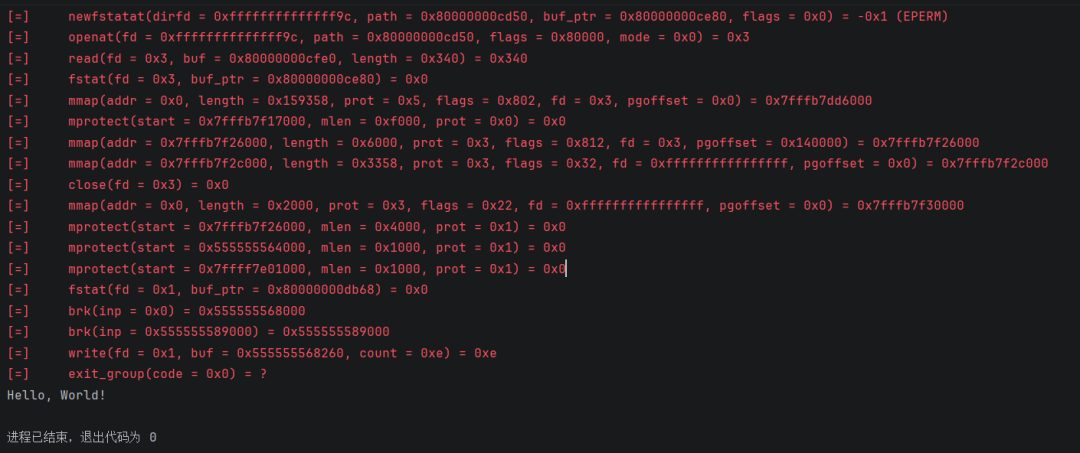
思路落地
第一步:让目标函数跑起来
只运行so的rc4_crypt一个函数 跑完得到正确的RC4密文
so没有入口 指定从哪个地址开始到哪个地址结束就行 开始非常好找
开始地址:0x1648
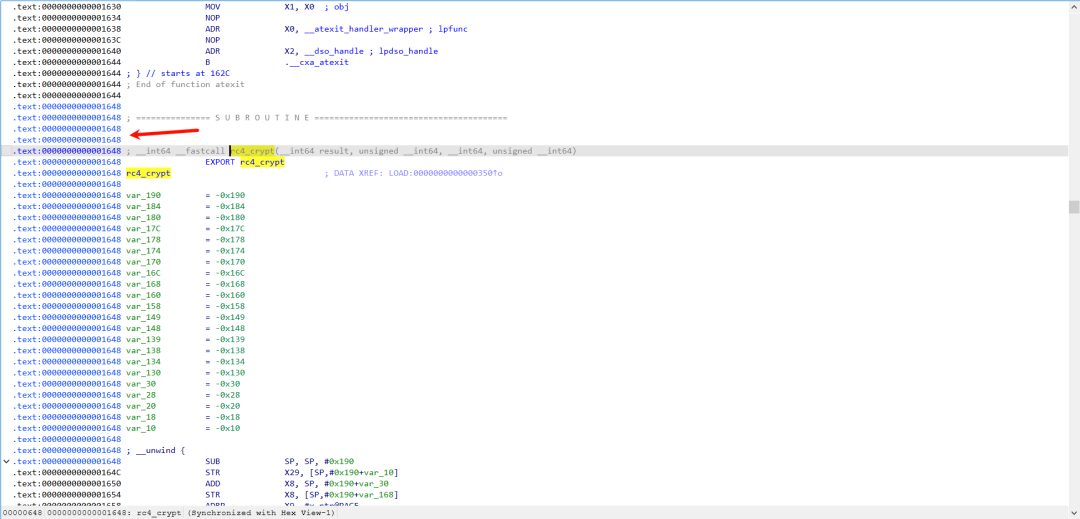
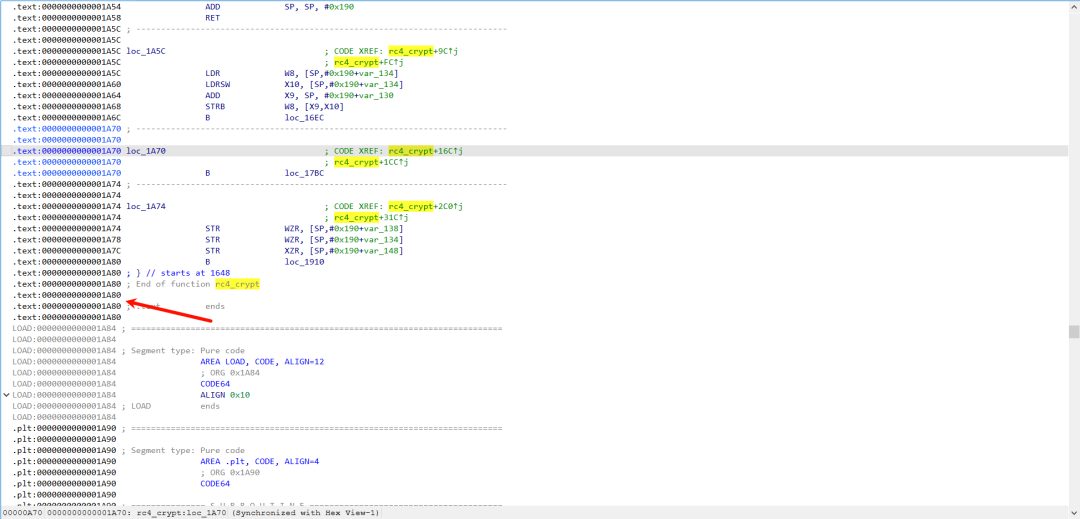
结束地址呢 1A80?这是 IDA 标注的函数字节范围终点
程序是顺着执行流跑的 不是从头顺着地址跑到尾
看返回块
0x1A50  LDR  X29, [SP,#var_10]
0x1A54  ADD  SP, SP, #0x190
0x1A58  RET                      执行到这里,函数返回,结束
RET 一执行 控制权就交回调用者 函数就结束了 0x1A58 就是运行意义上的终点
那么除了人肉去找有没有更加优雅的思路
有的有的 兄弟有的有的 既然都上动态调试了 那还说啥了 都是兄弟
用动态抓返回来自动确定结束地址
函数返回时会执行 RET RET 干的事是:把 X30(返回地址寄存器)里的值装进 PC 程序跳回调用者
x30里面的返回地址是可以设置成一个现实中不可能是代码的地址作为标记 比如说0x0 那么
函数正常跑 跑到任意一个RET PC就会跳到0x0
然后hook指令 一旦发现PC跳到了0x0 就可以知道函数刚返回了 而上一条执行的指令地址就是那个RET 也就是出口
这样不管函数有几个RET 出口在哪里 都不需要手动去找 程序从哪里返回 就抓到哪里
那么 怎么抓上一条指令
hook每条指令 回调里能拿到当前指令地址 用一个变量 last_addr 记住上一条指令的地址 当发现当前PC == 标记地址(0x0)的时候 last_addr就是ret的地址
但是这里有个小细节 PC跳到0x0的时候 0x0处压根没有合法代码 qiling会因取指失败停下或者报错
更干净的做法就是不等他跳过去 而是在ret指令本身执行之前就识别他
识别方法:反汇编当前指令 如果助记符是ret 那当前地址就是出口 记录下来并自动停止
这个方法更直接 不依赖标记地址 也不会触发非法取指
那么要是有多个RET呢?
这个套路其实也管用 因为程序一次运行只会经过其中一个ret 走到哪个ret就返回 其他的ret这次没有走到
所以 用当前这组输入跑一次 抓到的是这条路径的出口
换不同的输入再跑 可能抓到别的RET 抓到别的出口
把多次运行抓到的出口收集起来 就是这个函数的全部出口合集
代码
from qiling import Qiling
from qiling.const import QL_VERBOSE
SO_PATH = r"librc4_bcf.so"
ROOTFS  = r"qiling\examples\rootfs\arm64_linux"
FUNC_OFF = 0x1648
ql = Qiling([SO_PATH], ROOTFS, verbose=QL_VERBOSE.OFF)
base = ql.loader.images[0].base
func_addr = base + FUNC_OFF
key  = b"Key"
data = b"Plaintext"
buf = ql.mem.map_anywhere(0x1000)
key_addr  = buf
data_addr = buf + 0x100
ql.mem.write(key_addr, key)
ql.mem.write(data_addr, data)
ql.arch.regs.write("x0", key_addr)
ql.arch.regs.write("x1", len(key))
ql.arch.regs.write("x2", data_addr)
ql.arch.regs.write("x3", len(data))
ql.arch.regs.write("x30", func_addr)
md = ql.arch.disassembler
exits = []
def watch_ret(ql, address, size):
    insn = next(md.disasm(ql.mem.read(address, size), address))
if insn.mnemonic == "ret":
        off = address - base
print(f"[出口] 抓到 RET,偏移 {off:#x}")
        exits.append(address)
        ql.emu_stop()
ql.hook_code(watch_ret)
ql.run(begin=func_addr)
result = ql.mem.read(data_addr, len(data))
print("ciphertext =", result.hex().upper())
print("expected   = BBF316E8D940AF0AD3")
print("出口集合   =", [hex(e - base) for e in exits])
运行结果:
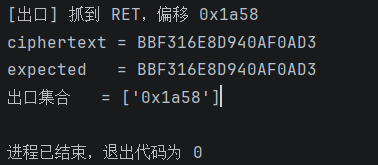
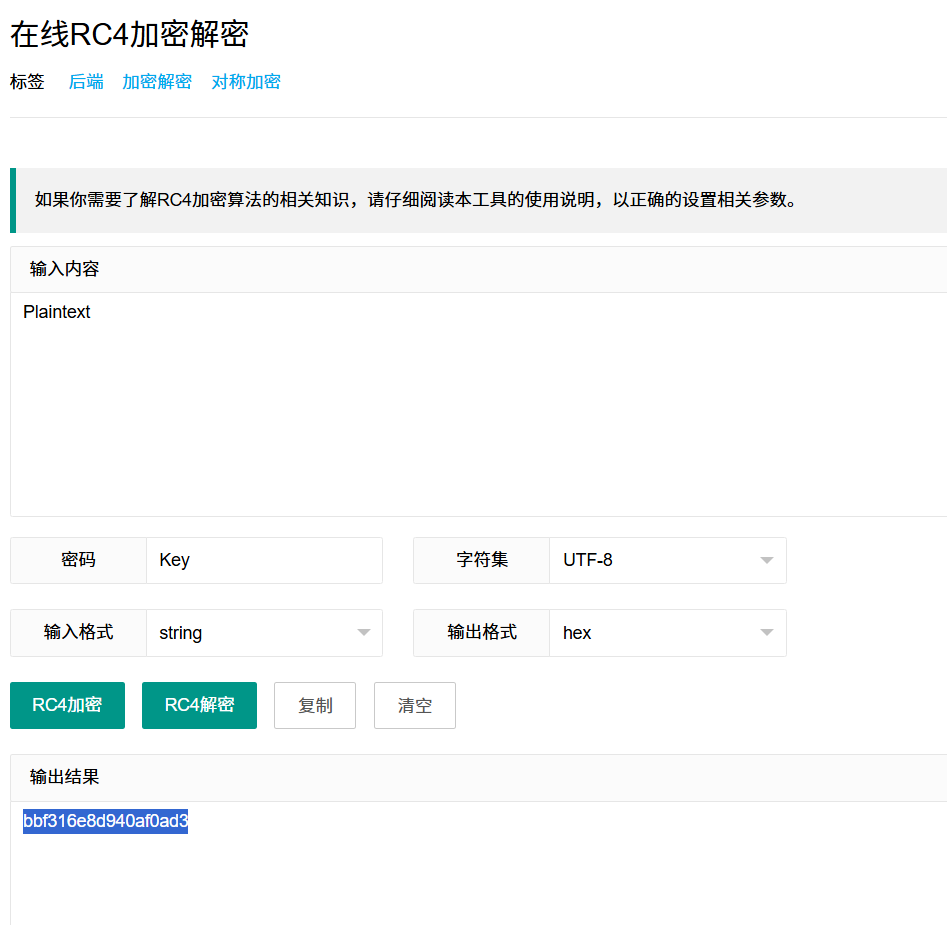
结果一模一样 函数成功运行 也得到了ret只有一个 地址是0x1a58
第二步:确定污点源
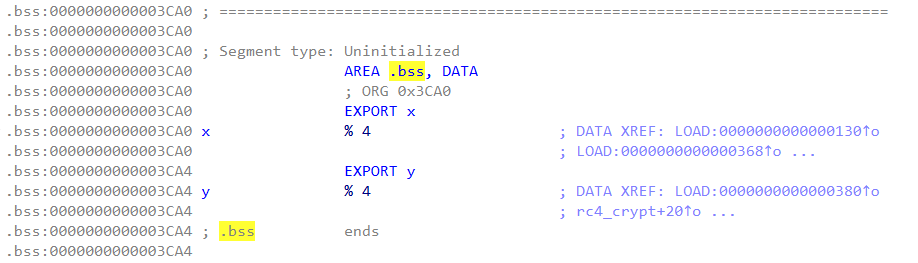
x 在偏移 0x3CA0 y 在 0x3CA4 各 4 字节 而且它们是 EXPORT(导出符号)名字就叫 x、y
这是最简单的情况:污点源地址 = base + 0x3CA0(x)和 base + 0x3CA4(y),直接从 IDA 抄偏移就行
当前样本比较简单 那么要是.bss有程序真正的全局变量(比如说某个计数器、缓冲区)
不能把整个.bss都当作污染源 否则会把真实变量也染脏导致真跳转被误判成假跳转
区分的办法有两个
其一 就是用符号去判断 当前这个样本就是个例子 x、y有导出符号 直接按照名字定位 其他的变量不管 适用于符号没有被去掉的情况
其二 靠只读不写的特征 对整个.bss都监控 跑一遍 凡是被读之前从没有被写过 且参与了条件跳转运算的 就是污染源
代码:
用只读特征验证它们确实是污点源 全程没被写
from qiling import Qiling
from qiling.const import QL_VERBOSE
SO_PATH = r"librc4_bcf.so"
ROOTFS  = r"qiling\examples\rootfs\arm64_linux"
FUNC_OFF = 0x1648
X_OFF    = 0x3CA0
Y_OFF    = 0x3CA4
ql = Qiling([SO_PATH], ROOTFS, verbose=QL_VERBOSE.OFF)
base = ql.loader.images[0].base
func_addr = base + FUNC_OFF
x_addr = base + X_OFF
y_addr = base + Y_OFF
print(f"x @ {x_addr:#x}, y @ {y_addr:#x}")
buf = ql.mem.map_anywhere(0x1000)
key_addr, data_addr = buf, buf + 0x100
ql.mem.write(key_addr, b"Key")
ql.mem.write(data_addr, b"Plaintext")
ql.arch.regs.write("x0", key_addr)
ql.arch.regs.write("x1", 3)
ql.arch.regs.write("x2", data_addr)
ql.arch.regs.write("x3", 9)
ql.arch.regs.write("x30", func_addr)
md = ql.arch.disassembler
written = set()
def watch_ret(ql, address, size):
    insn = next(md.disasm(ql.mem.read(address, size), address))
if insn.mnemonic == "ret":
        ql.emu_stop()
def on_write(ql, access, address, size, value):
if x_addr <= address < x_addr + 4:
        written.add("x")
if y_addr <= address < y_addr + 4:
        written.add("y")
ql.hook_code(watch_ret)
ql.hook_mem_write(on_write)
ql.run(begin=func_addr)
x_val = int.from_bytes(ql.mem.read(x_addr, 4), "little")
y_val = int.from_bytes(ql.mem.read(y_addr, 4), "little")
print(f"x = {x_val}, y = {y_val}")
print(f"被写过的源头: {written or '无(符合只读特征,确认是污点源)'}")
print("ciphertext =", ql.mem.read(data_addr, 9).hex().upper())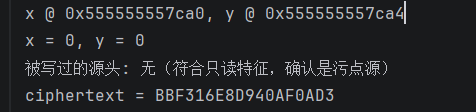
第三步:污点传播
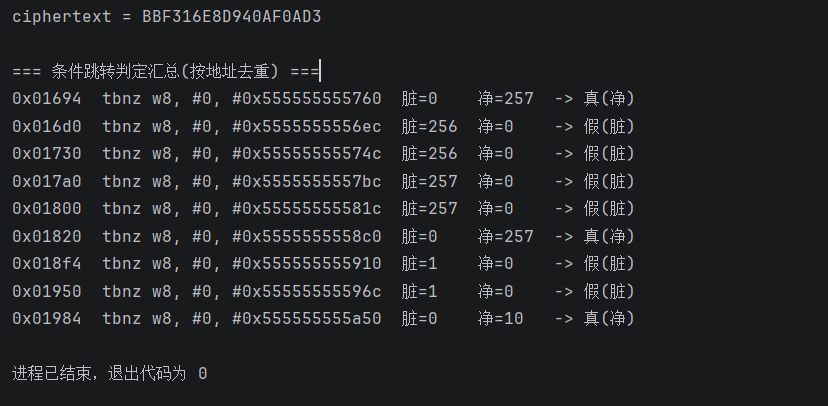
从x/y触发 追踪经过的寄存器和标志位 跑完后对每个条件跳转能判断 依据的值是脏(假跳转)还是净(真跳转)并且按照地址去重统计
这里踩了好几个坑
第一个 x/y通过GOT间接引用 qiling没做重定位 读取出来的地址是0
序言用ADPR+LDR从GOT槽中取出x/y的地址 而qiling加载so的时候没有取填这个槽 导致ldr w8,[x8]里 x8=0 最终污点注入失败 全程0脏
解决的方案就是在序言存入地址进栈的两条str x9,[sp,...]执行之前 直接把x9覆盖写成正确的x/y的地址 这样绕开GOT 在数据流关键点注入正确的地址
坑二:qiling自带的反汇编器 detail未开 insn.operands 为空 自己建 capstone 实例并显式 md.detail = True
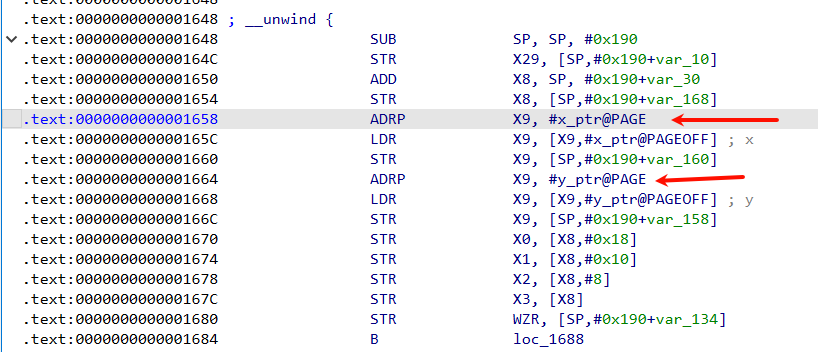
污点状态:维护两样 tainted_regs(脏寄存器集合)、tainted_flags(NZCV 是否脏)ARM64 条件跳转靠 NZCV
三条传播规则
规则一(注入):从x/y读值 目标寄存器变脏
规则二(传播/洗白):源有脏则目标脏 源全净则目标被洗白(干净值覆盖)
规则三(标志位):写 NZCV 的指令源脏则 NZCV 脏 读 NZCV 的指令(CSET 等)NZCV 脏则目标脏
w8 和 x8 是同一物理寄存器 归一化成 x8 判断 load 是否读 x/y:解析内存操作数 基址寄存器当前值加位移得实际地址 看是否落在 x/y 范围
from qiling import Qiling
from qiling.const import QL_VERBOSE
import capstone
SO_PATH = r"librc4_bcf.so"
ROOTFS  = r"qiling\examples\rootfs\arm64_linux"
FUNC_OFF = 0x1648
X_OFF, Y_OFF = 0x3CA0, 0x3CA4
X_STORE_OFF, Y_STORE_OFF = 0x1660, 0x166C
ql = Qiling([SO_PATH], ROOTFS, verbose=QL_VERBOSE.OFF)
base = ql.loader.images[0].base
func_addr = base + FUNC_OFF
x_addr, y_addr = base + X_OFF, base + Y_OFF
buf = ql.mem.map_anywhere(0x1000)
key_addr, data_addr = buf, buf + 0x100
ql.mem.write(key_addr, b"Key")
ql.mem.write(data_addr, b"Plaintext")
for r, v in [("x0",key_addr),("x1",3),("x2",data_addr),("x3",9),("x30",func_addr)]:
    ql.arch.regs.write(r, v)
md = capstone.Cs(capstone.CS_ARCH_ARM64, capstone.CS_MODE_ARM)
md.detail = True
tainted_regs  = set()
tainted_flags = False
jump_stat = {}   # off -> {"脏":n, "净":n, "insn":str}
def norm(name):
    name = name.lower()
return ("x" + name[1:]) if name.startswith("w") elsename
def writes_flags(insn):
    m = insn.mnemonic
return m in ("cmp","cmn","tst") or (m.endswith("s") and m notin ("bics",))
def reads_flags(insn):
return insn.mnemonic.startswith(("cset","csel","csinc","b."))
def load_reads_xy(ql, insn):
ifnot insn.mnemonic.startswith("ldr"):
return False
for op in insn.operands:
if op.type == capstone.CS_OP_MEM and op.mem.base != 0:
            addr = ql.arch.regs.read(insn.reg_name(op.mem.base)) + op.mem.disp
if x_addr <= addr < x_addr+4or y_addr <= addr < y_addr+4:
returnTrue
return False
def trace(ql, address, size):
global tainted_flags
    off = address - base
    insn = next(md.disasm(ql.mem.read(address, size), address))
if off == X_STORE_OFF:
        ql.arch.regs.write("x9", x_addr)
    elif off == Y_STORE_OFF:
        ql.arch.regs.write("x9", y_addr)
if insn.mnemonic == "ret":
        ql.emu_stop(); return
    regs_read, regs_write = insn.regs_access()
    read_names  = [norm(insn.reg_name(r)) for r in regs_read]
    write_names = [norm(insn.reg_name(r)) for r in regs_write]
    src_tainted = any(r in tainted_regs for r in read_names)
ifreads_flags(insn) and tainted_flags:
        src_tainted = True
ifload_reads_xy(ql, insn):
        src_tainted = True
for w in write_names:
if w in ("nzcv","cpsr","pc"):
continue
if src_tainted: tainted_regs.add(w)
else: tainted_regs.discard(w)
ifwrites_flags(insn):
        tainted_flags = src_tainted
if insn.mnemonic in ("tbnz","tbz","cbnz","cbz") or insn.mnemonic.startswith("b."):
if insn.mnemonic.startswith("b."):
            dirty = tainted_flags
else:
            first = norm(insn.reg_name(regs_read[0])) if regs_read else None
            dirty = first in tainted_regs
        st = jump_stat.setdefault(off, {"脏":0,"净":0,
"insn":f"{insn.mnemonic} {insn.op_str}"})
        st["脏"if dirty else"净"] += 1
ql.hook_code(trace)
ql.run(begin=func_addr)
print("ciphertext =", ql.mem.read(data_addr, 9).hex().upper())
print("\n=== 条件跳转判定汇总(按地址去重) ===")
for off insorted(jump_stat):
    s = jump_stat[off]
    verdict = "假(脏)"if s["脏"]>0and s["净"]==0else \
"真(净)"if s["脏"]==0else"混合"
    print(f"{off:#07x}  {s['insn']:24s}  脏={s['脏']:<4} 净={s['净']:<4} -> {verdict}")
输出如下:
6假3真
第四步:记录假跳转的固定去向
对每条判定为假的跳转 记录他实际总是跳到哪个地址 得到假跳地址->固定目标地址的映射表 作为patch的依据。
不透明谓词恒真或者恒假 所以一条假跳转每次执行都往同一个方向走 只需要观察他执行时的实际行为:跳了 就记录跳转目标 没跳 就记录顺序执行的下一条地址 多次执行验证方向唯一 确认后存进映射表。
具体 tbnz w8,#0, #target 如果这次判定条件成立(跳转发生) 下一条执行的指令地址就是target 不成立则是当前指令的下一条(off+4)
怎么拿到下一条实际执行的地址?
在指令hook里 记住上一条指令是不是待观察的假跳转 等下一条指令进hook的时候 他的地址就是假跳转的实际去向 用一个pending变量传递
from qiling import Qiling
from qiling.const import QL_VERBOSE
importcapstone
SO_PATH= r"librc4_bcf.so"
ROOTFS  = r"qiling\examples\rootfs\arm64_linux"
FUNC_OFF = 0x1648
X_OFF, Y_OFF = 0x3CA0, 0x3CA4
X_STORE_OFF, Y_STORE_OFF = 0x1660, 0x166C
ql = Qiling([SO_PATH], ROOTFS, verbose=QL_VERBOSE.OFF)
base = ql.loader.images[0].base
func_addr= base + FUNC_OFF
x_addr, y_addr = base + X_OFF, base + Y_OFF
buf= ql.mem.map_anywhere(0x1000)
key_addr, data_addr = buf, buf + 0x100
ql.mem.write(key_addr, b"Key")
ql.mem.write(data_addr, b"Plaintext")
for r, v in [("x0",key_addr),("x1",3),("x2",data_addr),("x3",9),("x30",func_addr)]:
    ql.arch.regs.write(r, v)
md = capstone.Cs(capstone.CS_ARCH_ARM64, capstone.CS_MODE_ARM)
md.detail = True
tainted_regs= set()
tainted_flags = False
jump_stat= {}
fake_targets = {}
pending_fake = {"off": None}
FAKE_JUMPS = {0x16D0, 0x1730, 0x17A0, 0x1800, 0x18F4, 0x1950}
def norm(name):
    name = name.lower()
return ("x" + name[1:]) if name.startswith("w") else name
def writes_flags(insn):
    m = insn.mnemonic
return m in("cmp","cmn","tst") or (m.endswith("s") and m not in("bics",))
def reads_flags(insn):
return insn.mnemonic.startswith(("cset","csel","csinc","b."))
def load_reads_xy(ql, insn):
if not insn.mnemonic.startswith("ldr"):
return False
for op in insn.operands:
if op.type == capstone.CS_OP_MEM and op.mem.base != 0:
            addr = ql.arch.regs.read(insn.reg_name(op.mem.base)) + op.mem.disp
if x_addr <= addr < x_addr+4 or y_addr <= addr < y_addr+4:
return True
return False
def trace(ql, address, size):
    global tainted_flags
off= address - base
insn= next(md.disasm(ql.mem.read(address, size), address))
if pending_fake["off"] is not None:
        prev = pending_fake["off"]
        fake_targets[prev] = off
        pending_fake["off"] = None
if off == X_STORE_OFF:
        ql.arch.regs.write("x9", x_addr)
    elif off == Y_STORE_OFF:
        ql.arch.regs.write("x9", y_addr)
if insn.mnemonic == "ret":
        ql.emu_stop(); return
    regs_read, regs_write = insn.regs_access()
    read_names  = [norm(insn.reg_name(r)) for r in regs_read]
    write_names = [norm(insn.reg_name(r)) for r in regs_write]
    src_tainted = any(r in tainted_regs for r in read_names)
ifreads_flags(insn) and tainted_flags:
        src_tainted = True
ifload_reads_xy(ql, insn):
        src_tainted = True
for w in write_names:
if w in("nzcv","cpsr","pc"):
continue
if src_tainted: tainted_regs.add(w)
else: tainted_regs.discard(w)
ifwrites_flags(insn):
        tainted_flags = src_tainted
if insn.mnemonic in("tbnz","tbz","cbnz","cbz") or insn.mnemonic.startswith("b."):
if insn.mnemonic.startswith("b."):
            dirty = tainted_flags
else:
            first = norm(insn.reg_name(regs_read[0])) if regs_read elseNone
dirty= first in tainted_regs
st= jump_stat.setdefault(off, {"脏":0,"净":0,
"insn":f"{insn.mnemonic} {insn.op_str}"})
        st["脏"if dirty else"净"] += 1
if dirty:
            pending_fake["off"] = off
ql.hook_code(trace)
ql.run(begin=func_addr)
print("ciphertext =", ql.mem.read(data_addr, 9).hex().upper())
print("\n=== 条件跳转判定汇总(按地址去重) ===")
for off in sorted(jump_stat):
    s = jump_stat[off]
    verdict = "假(脏)"if s["脏"]>0 and s["净"]==0else \
"真(净)"if s["脏"]==0else"混合(需注意)"
    print(f"{off:#07x}  {s['insn']:24s}  脏={s['脏']:<4} 净={s['净']:<4} -> {verdict}")
print("\n=== 假跳转的固定去向 ===")
for off in sorted(fake_targets):
    print(f"{off:#07x}  ->  {fake_targets[off]:#07x}")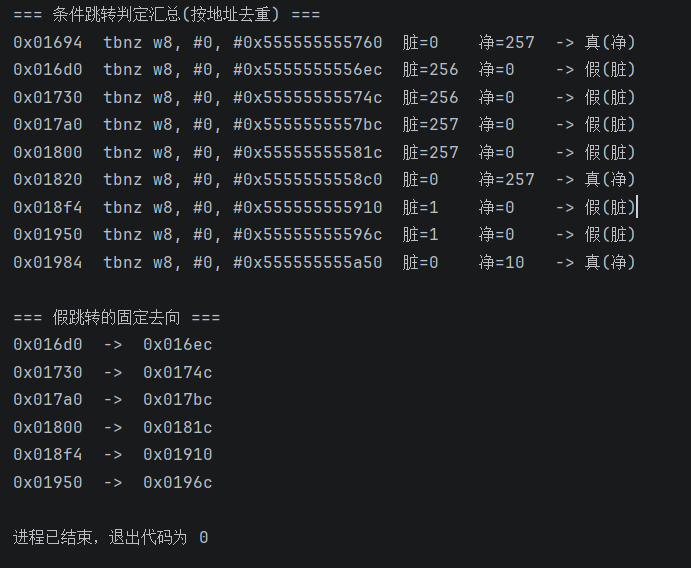
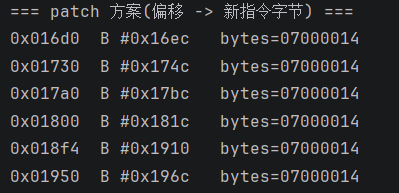
第五步: patch 方案
把假跳转->固定目标 翻译成具体的字节修改方案 每条假跳转指令改成无条件跳转到固定目标 只计算不写文件
一条假跳转 tbnz w8, #0, #target 已知他每次都会去real_target 那么就把他替换成B real_target 这样执行流直达真实后继
不再经过不透明谓词判断 死分支自然不可达
ARM64的B指令是相对跳转 编码规则:0x14000000 | ((offset/4) & 0x03FFFFFF) 其中offset=目标地址-当前指令地址(字节) 必须4字节对其
把假跳转原地转换成同长度的B 既保持布局又达到无条件跳到真实后继的效果 原来的死分支块无人跳转 成为不可达代码 可以再用NOP填充
新增函数:
def make_branch(cur_off, target_off):
    delta = target_off - cur_off
    assert delta % 4 == 0, "跳转目标未对齐"
    imm26 = (delta // 4) & 0x03FFFFFF
    insn = 0x14000000 | imm26
    return insn.to_bytes(4, "little")
def build_patch_plan(fake_targets):
    plan = {}
    for off, target in fake_targets.items():
        plan[off] = make_branch(off, target)
    return plan
# 演示
plan = build_patch_plan(fake_targets)
print("=== patch 方案(偏移 -> 新指令字节) ===")
for off in sorted(plan):
print(f"{off:#07x}  B #{fake_targets[off]:#x}   bytes={plan[off].hex()}")
make_branch 按 B 指令编码规则算出 4 字节 这里用的是函数内偏移(off、target 都是相对 base 的偏移) 因为 B 是相对跳转 偏移之差与 base 无关 算出来的编码可直接写进文件对应偏移。
build_patch_plan 把每条假跳转映射成新指令字节 得到的 plan 是文件偏移 → 4 字节的字典 后面patch的时候用得到。
第六步:写入 patch
首先就是文件偏移不等于RVA 运行时用的是RVA(base+偏移) 但是写入文件的时候必须要用文件偏移 两者通过ELF的PT_LOAD段换算 公式为: 文件偏移 = 段文件偏移+(RVA-段虚拟地址) 不换算直接拿RVA写入文件会导致字节写错位置(这个坑研究半天)
用 keystone 汇编 不手算机器码 b #{rel} 直接生成正确的 4 字节 负偏移(往回跳)的补码由它处理
patch_so.py:
from keystone import Ks, KS_ARCH_ARM64, KS_MODE_LITTLE_ENDIAN
from elftools.elf.elffile import ELFFile
SO_PATH  = r"librc4_bcf.so"
OUT_PATH = r"librc4_deob.so"
# 前面已经拿到的方案: 假跳转RVA -> 真实目标RVA
PLAN = {
0x16D0: 0x16EC,
0x1730: 0x174C,
0x17A0: 0x17BC,
0x1800: 0x181C,
0x18F4: 0x1910,
0x1950: 0x196C,
}
ks  = Ks(KS_ARCH_ARM64, KS_MODE_LITTLE_ENDIAN)
elf = ELFFile(open(SO_PATH, "rb"))
def rva_to_off(rva):
for seg in elf.iter_segments():
if seg['p_type'] == 'PT_LOAD':
            v, o, sz = seg['p_vaddr'], seg['p_offset'], seg['p_filesz']
if v <= rva < v + sz:
return o + (rva - v)
data = bytearray(open(SO_PATH, "rb").read())
for src, dst in PLAN.items():
    asm, _ = ks.asm(f"b #{dst - src}", addr=0)
    off = rva_to_off(src)
data[off:off+4] = bytes(asm)
    print(f"{src:#x} -> B {dst:#x}  @file {off:#x}")
open(OUT_PATH, "wb").write(data)
print("done:", OUT_PATH)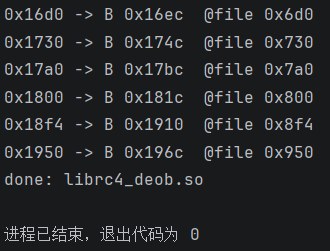
控制流平坦化
控制流平坦化(FLA)将函数原本有序的基本块打散,交由一个中央分发器根据状态变量的值逐个调度执行,从而摧毁原始控制流结构。
下面是混淆前后的对比图
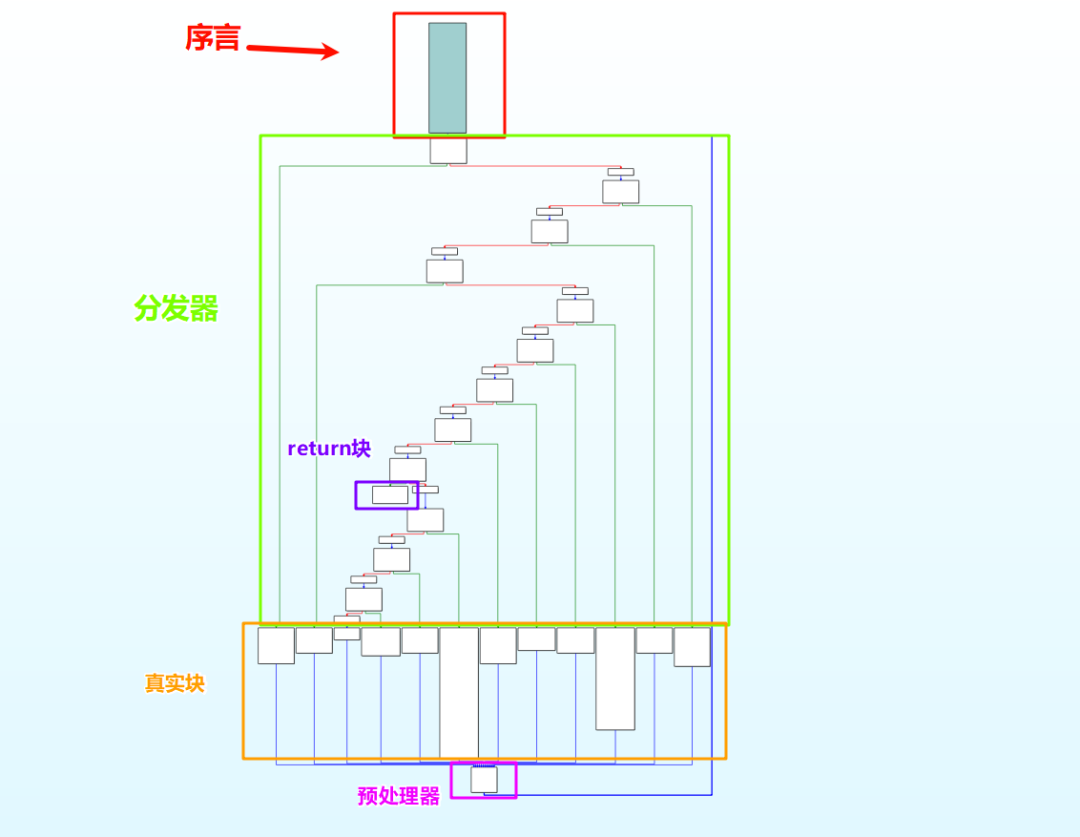
序言:函数唯一入口,执行原始的栈帧构建等准备工作,并把状态变量初始化为第一个真实块对应的值,然后进入分发器。
分发器:一个 while(true) 套 switch(state) 的循环,反复读状态变量,把执行权派发给对应真实块,原有块间跳转全被它接管。
真实块:程序真正的业务逻辑所在,被拆成互不相连的孤岛,末尾不跳向下一块,只负责算出下一个状态值并交回调度。
预处理器:真实块与分发器之间的汇聚点,收拢所有真实块出口,统一完成状态变量更新,再无条件跳回分发器,闭合循环。
return块:状态变量到达约定终止值时才被派发,负责恢复栈帧并返回,是唯一不跳回分发器、真正终结函数的出口。
思路一:D810
依旧“脚本小子”打法 没办法 太爽了 直接一把梭干净了

选中点击flatfold.json start后切换到伪代码窗口 会发现ida卡死 切换到default_unflattening_ollvm.json发现也是一样的
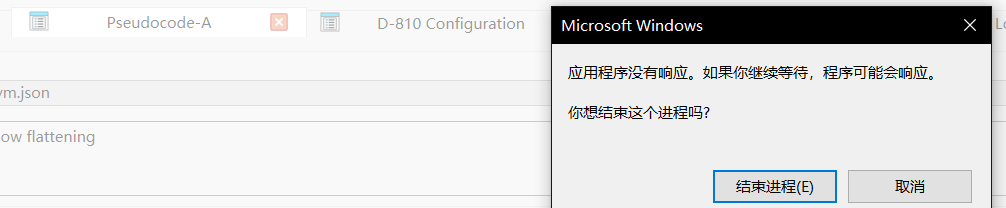
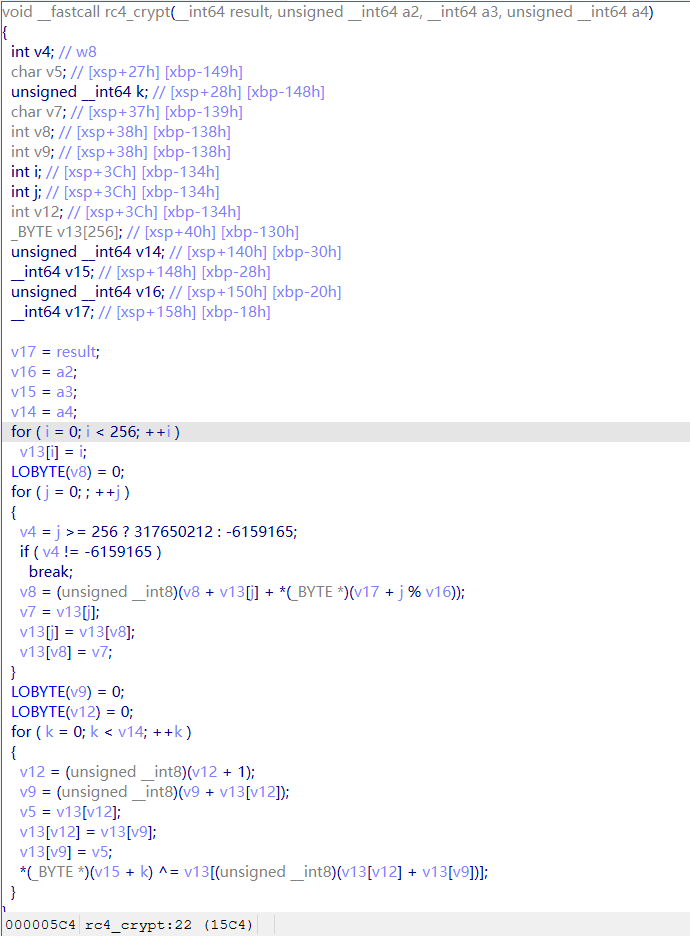
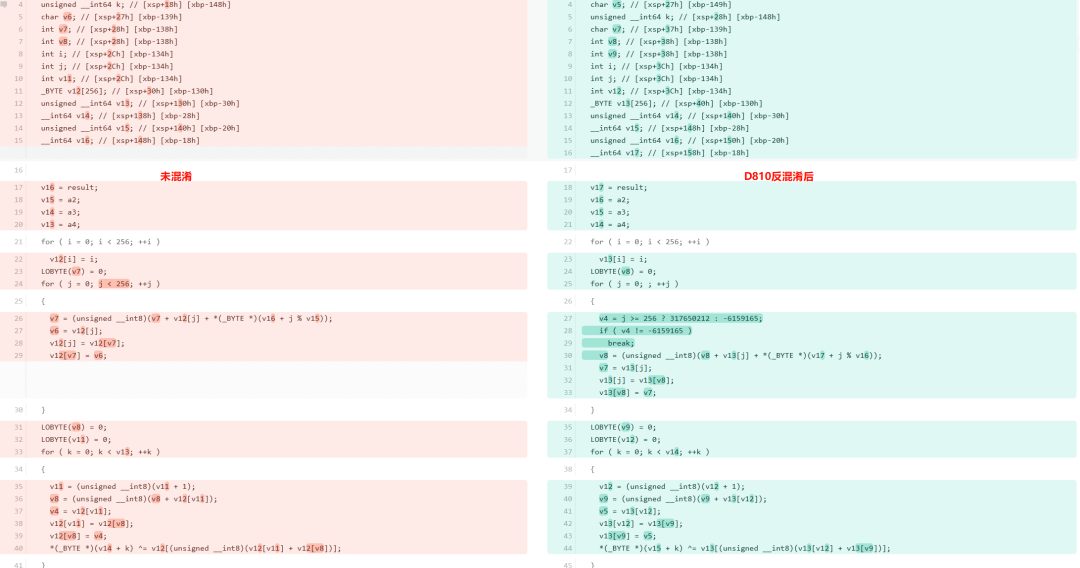
经过一顿排查可以确定是d810项目的问题 将项目克隆下来后针对这个问题做了修复
修复内容简单来说就是一句话 原项目遇到右操作数不是立即数的块没有推进迭代 导致遍历永远停留在这个块上形成了死循环 只要函数里面有这种块 就会单核满载 无响应
修复后:https://github.com/beiniao/d810-ng-main 下载这个新的项目再次运行
思路二:状态机
原文:https://bbs.kanxue.com/thread-288598.htm
简单介绍一下文章的思路:扁平化的本质就是原本A->B->C的直接跳转 被拆成了每一个块的结尾写入一个状态值 然后跳转回分发器 分发器根据状态值决定去哪个块 这就导致了块之间的真实关系被一个中间层(状态值)给隔断了 解决起来就一句话 去掉这个中间商
具体怎么做 首先得要两个表 这里叫他们表A和表B
其中表A的统计内容为 当前块执行完成后的状态值更新变化
表B记录的就是 当前状态值指向哪个块
有了这两张表就不难解决问题了 把这个修改状态值的步骤改成直接跳转到块 然后就靠IDA的F5大展神威
简单分析
分发器 分发器的特征就是每个块执行完毕都会跳回到这里 它被跳转的次数最多
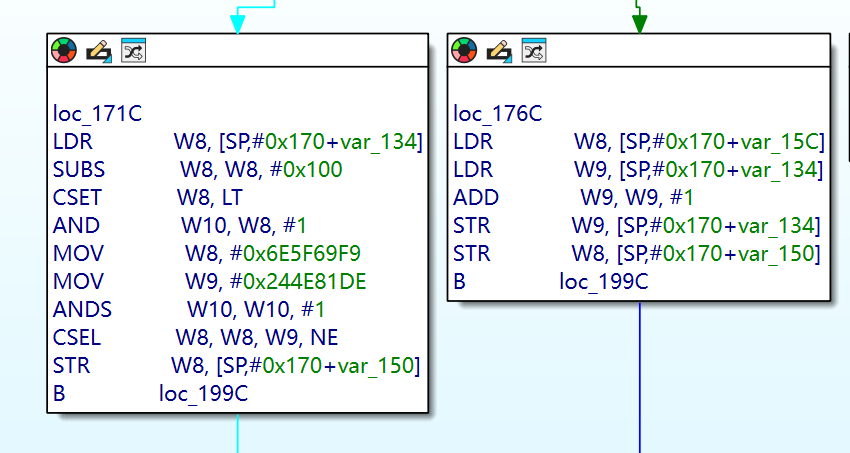
就隔这呢 代码抠出来看看 从栈针偏移处取值给w9和w8 完事又将w8的值存入到var_160 再将w8-w9的值赋值给w8并且更新标志位(因为sub加了一个s)接着将EQ的值赋值给w8 最后判断 如果w8的值为假就走loc_171C 如果为真就进入下条指令。
LDR             W9, [SP,#0x170+var_15C]
LDR             W8, [SP,#0x170+var_150]
STR             W8, [SP,#0x170+var_160]
SUBS            W8, W8, W9
CSET            W8, EQ
TBNZ            W8, #0, loc_171C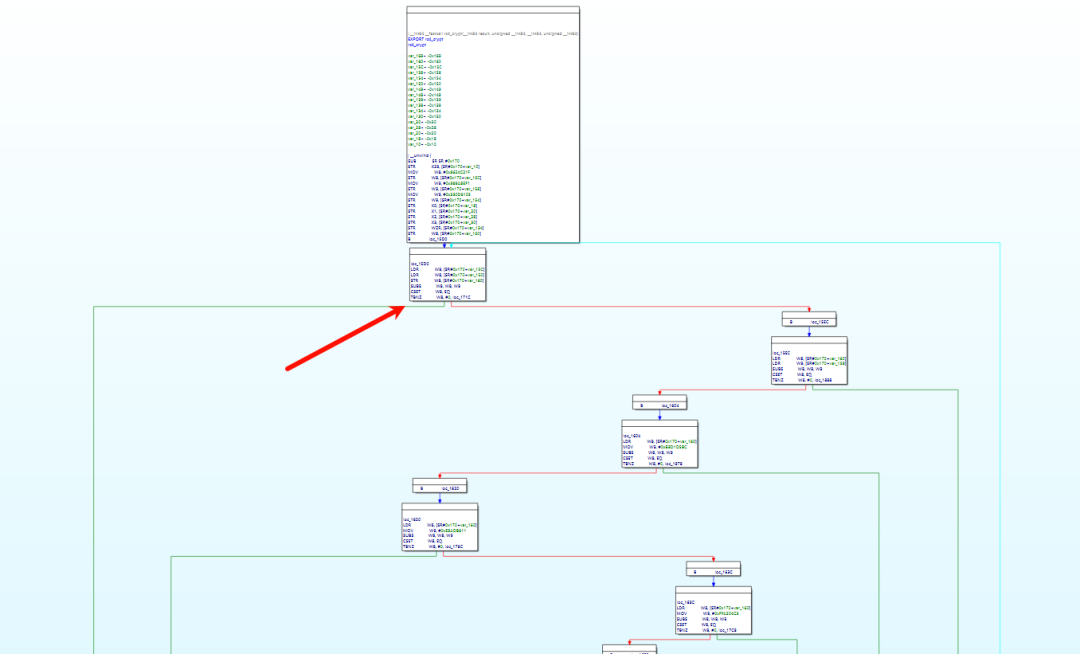
状态值 这个去看真实块的屁股 在前面提到了 状态值这玩意 每个块执行完毕了 就会更新然后跳转到分发器 那么不难看出这里跳转之前我们的var_150同学也是备受瞩目好吧 除此之外简单分析一波loc_171c的汇编代码。
LDR             W8, [SP,#0x170+var_134]
SUBS            W8, W8, #0x100
CSET            W8, LT
AND             W10, W8, #1
MOV             W8, #0x6E5F69F9
MOV             W9, #0x244E81DE
ANDS            W10, W10, #1
CSEL            W8, W8, W9, NE
STR             W8, [SP,#0x170+var_150]
B               loc_199C
从栈指中读取var_134偏移处的值赋值给w8寄存器
w8=w8-0x100并且更新标志位 如果结果为0 则标志位为1 如果结果非0 则标志位为0
w8-0x100<0成立 w8=1 否则w8=0
对w8和1进行逻辑与运算 将结果赋值给w10
0x6E5F69F9赋值给w8
0x244E81DE赋值给w9
对w10和1进行逻辑于并且将结果更新到标志位 如果结果为0 则标志位为1 如果结果为1 则标志位为0
w8=(NE)?W8:w9
将结果写入到var_150
跳转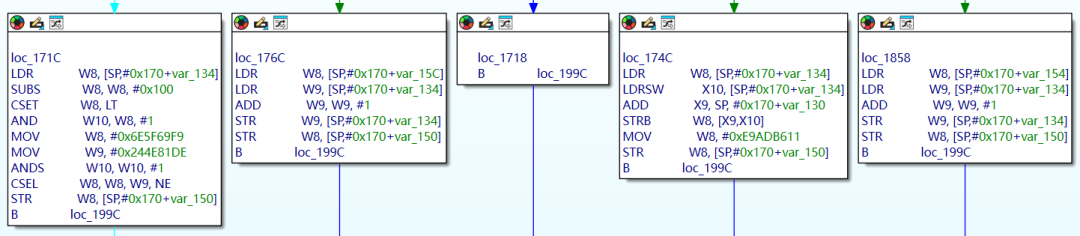
一句话总结就是 下一状态 = (var_134 < 256) ? 0x6E5F69F9 : 0x244E81DE
写脚本
API
动手写代码之前需要简单学习一下几个高频api
idc.print_insn_mnem(ea):给一个指令地址,返回助记符字符串。比如对 MOV W8, #1 返回 "MOV",对 B loc_15D0 返回 "B"。用来判断"这条是什么指令"。
idc.print_operand(ea, n):给指令地址和操作数序号(从 0 数),返回那个操作数的文本字符串。对 STR W8, [SP,#var_150],print_operand(ea,0) 返回 "W8",print_operand(ea,1) 返回 "[SP,#0x170+var_150]"。注意返回的是给人看的文本,不是数值。
idc.get_operand_value(ea, n):给指令地址和操作数序号,返回那个操作数的数值。对 MOV W9, #0x244E81DE,get_operand_value(ea,1) 返回 0x244E81DE 这个整数。对 B loc_15D0,get_operand_value(ea,0) 返回 loc_15D0 的地址整数。用来取立即数或跳转目标。
idc.get_operand_type(ea, n):给指令地址和操作数序号,返回该操作数的类型编号(一个整数)。我们只关心它是不是等于 idc.o_imm——相等就说明这个操作数是立即数(写死的常量),否则是寄存器或内存。为什么要它:取值时要先分清"是立即数直接读"还是"是寄存器得回溯来源"。
idc.next_head(ea):给当前指令地址,返回下一条指令的地址。遍历函数时用它一格一格往后挪。
idc.prev_head(ea):给当前指令地址,返回上一条指令的地址。回溯时用它往前找(比如"某寄存器是从前面哪条指令来的")。
idc.o_imm:一个常量,代表"立即数"这个操作数类型。配合上面的 get_operand_type 用,get_operand_type(ea,n) == idc.o_imm 就是"第 n 个操作数是不是立即数"。
ida_bytes.patch_dword(ea, val):给一个地址和一个 32 位数值,把该地址处的 4 字节改写成这个数值。AArch64 每条指令固定 4 字节,所以我们算好新指令的机器码,用它写进去,就完成 patch。注意它改的是数据库(和落盘的字节),是真正的修改。
定位分发器
这段代码思路很简单 就是遍历整个函数找“B” 然后将B后面的跳转去哪里给记录下来计数 最后返回一个得分最高的选手。
import idc
deffind_dispatcher(start,end):
    counts={}
    ea = start
while ea<end:
if idc.print_insn_mnem(ea)=="B":
            target=  idc.get_operand_value(ea,0)
            counts[target]=counts.get(target,0)+1
        ea = idc.next_head(ea)
returnmax(counts.items(),key=lambda x: x[1])[0]
d = find_dispatcher(0x1588, 0x199C + 4)
print("分发器地址: 0x%X" % d)
运行结果为:
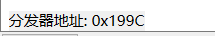
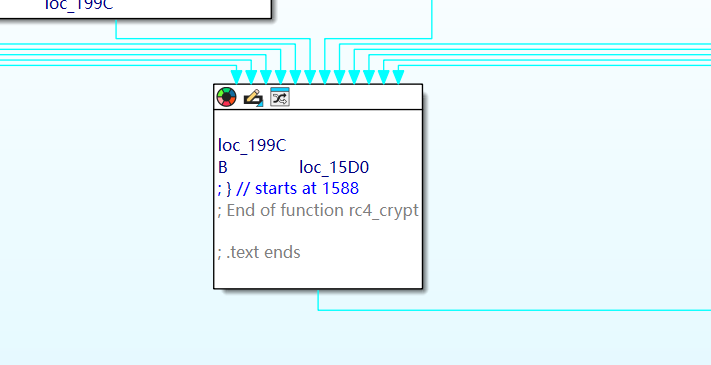
为什么拿到的是0x199c 而不是主分发器x015d0 通过前面的观察 那些块的结尾都是B loc_199c 而loc_199c里边只有一条 B loc_15d0 也就是说所有块不是直接跳回分发器 先到loc_199c这个中转站 再由它来统一跳转到主分发器0x15d0。
这个中转站其实不影响后面的逻辑 真正要用到分发器地址的地方 是在建表B时 扫描分发器主题的那一片比较链 那一片的比较链是0x15d0 是固定的 以find_dispatcher找出的0x199C 在这个样本里其实只起一个验证作用 真正扫描表B时我们用的边界是0x15D0到函数尾 手填即可。
建表B
表B要记录的是 当状态等于某个值时该去哪个块 这个答案全写在分发器主体那片比较链里
简单来说 每一段都在问一件事 当前状态 == 某个候选值吗?相等就跳去对应的块 所以每段能得到一对信息 这个候选状态值(比较用的常量) ->跳去的块地址 把所有段扫一遍 就集齐了整张表B。
LDR             W8, [SP,#0x170+var_160]
MOV             W9, #0x244E81DE
SUBS            W8, W8, W9
CSET            W8, EQ
TBNZ            W8, #0, loc_1784
例外是不会只出现在真实块中滴 经简单观察发现 w9的值也可能是从栈帧的偏移中取出与w8作比较的 并非全部都是一样的套路。
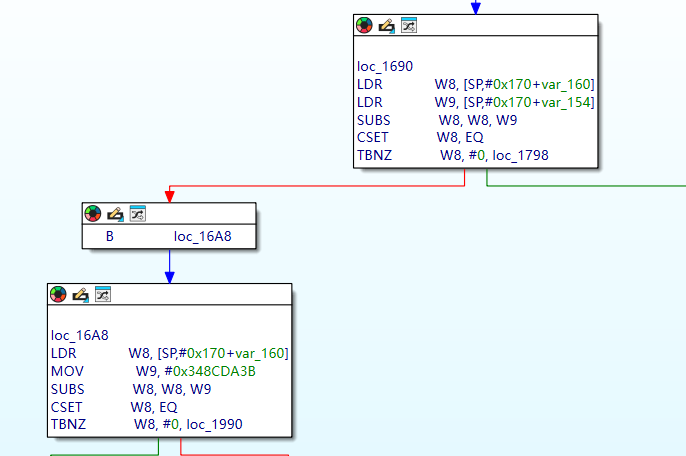
交叉引用看看怎么个事
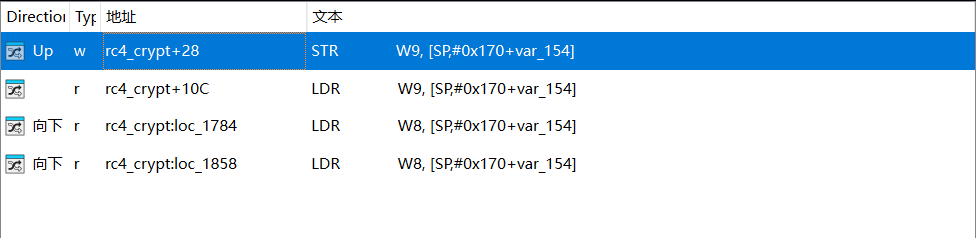
真相大白了 这一串的STR与MOV解释了其实还是一样的讨论 只不过套个娃给你看罢了
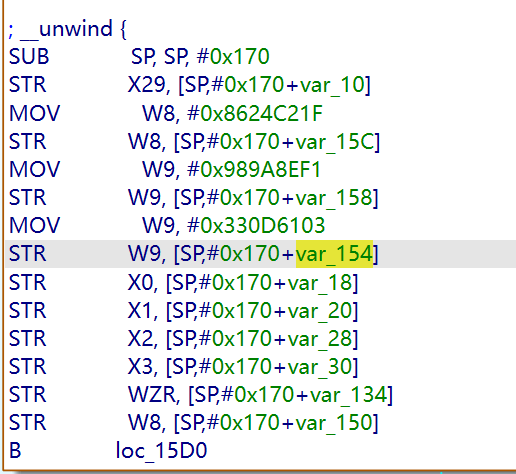
所以说写表B之前还得有一个前置依赖 就是这个序言常量表 不然当w9是LDR varxxx的时候就炸肛了
序言表
这里只需要从从函数头扫到分发器起点 只扫序言这一段 遇到STR指令时 去拿[SP,#0x170+var_154] 扣除var_154 存入dst 再去拿寄存器名 存入src 拿到dst后从这条STR往前推 找到给src赋值的MOV 根据判断是否符合MOV 第0操作数是否等于src 第一操作数是立即数 都满足就取出常量存入字典。
defstack_tag(text):
    i = text.find("var_")
if i < 0:
returnNone
    j = i + 4
while j < len(text) and text[j].isalnum():
        j += 1
return text[i:j]
defbuild_stack_const_map(func_start, disp_start):
    const_map = {}
    ea = func_start
while ea < disp_start:
if idc.print_insn_mnem(ea) == "STR":
            dst = stack_tag(idc.print_operand(ea, 1))
            src = idc.print_operand(ea, 0).strip().upper()
if dst isnotNone:
                p = ea
while p > func_start:
                    p = idc.prev_head(p)
if idc.print_insn_mnem(p) == "MOV"and idc.print_operand(p, 0).strip().upper() == src and idc.get_operand_type(p, 1) == idc.o_imm:
                        const_map[dst] = idc.get_operand_value(p, 1) & 0xFFFFFFFF
break
        ea = idc.next_head(ea)
return const_map
表B
外层去扫分发器 遇到每一条TBNZ 就干两件事 先将要跳的地址存入block 然后调用get_cmp_sonst去回溯这段比较用的状态常量存入const 这样就收集齐了 table_b[const]= block
get_cmp_const代码也不难 很简单 也是往前去找 直到遇到subs 看第二操作数是不是立即数 如果是就取值返回 如果不是说明它是寄存器 记下寄存器名 reg 往前找给reg赋值的那条 mov reg,#立即数 取立即数 是LDR reg,[var_xxx] 就抠栈变量名去const_map里查。
def get_cmp_const(tbnz_ea, start, const_map):
    ea = idc.prev_head(tbnz_ea)
while ea > start and idc.print_insn_mnem(ea) != "SUBS":
        ea = idc.prev_head(ea)
if idc.print_insn_mnem(ea) != "SUBS":
return None
if idc.get_operand_type(ea, 2) == idc.o_imm:
return idc.get_operand_value(ea, 2) & 0xFFFFFFFF
    reg = idc.print_operand(ea, 2).strip().upper()
    p = ea
while p > start:
        p = idc.prev_head(p)
if idc.print_operand(p, 0).strip().upper() != reg:
continue
        m = idc.print_insn_mnem(p)
if m == "MOV" and idc.get_operand_type(p, 1) == idc.o_imm:
return idc.get_operand_value(p, 1) & 0xFFFFFFFF
if m == "LDR":
            tag = stack_tag(idc.print_operand(p, 1))
return const_map.get(tag)
return None
return None
def build_table_b(disp_start, end, const_map):
    table_b = {}
    ea = disp_start
while ea < end:
if idc.print_insn_mnem(ea) == "TBNZ":
            block = idc.get_operand_value(ea, 2)
const = get_cmp_const(ea, disp_start, const_map)
ifconstis not None:
                table_b[const] = block
        ea = idc.next_head(ea)
return table_b
跑一下看看
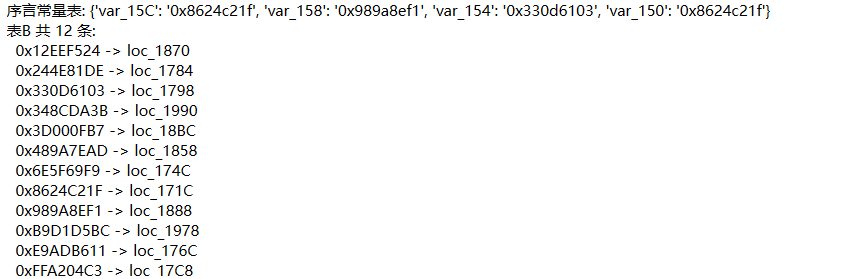
建表A
这里收集的就是块和下一状态 专门找STR 到 var_150的指令 找到之后 拿写进var_150的寄存器名 存入src 通过这个src去往前找给src赋值的指令 存入defn
在这里有两种情况
如果说defn是CSEL 说明状态时条件二选一来的 属于是分支块
否则的话 说明状态是写死的一个值 属于是普通块
def norm_reg(s):
return s.strip().upper()
def find_def(ea_use, reg, start):
    reg = norm_reg(reg)
    ea = ea_use
while ea > start:
        ea = idc.prev_head(ea)
if norm_reg(idc.print_operand(ea, 0)) == reg:
return ea
return idc.BADADDR
def resolve_const(ea_use, reg, start, const_map):
    reg = norm_reg(reg)
    ea = ea_use
while ea > start:
        ea = idc.prev_head(ea)
if norm_reg(idc.print_operand(ea, 0)) != reg:
continue
        m = idc.print_insn_mnem(ea)
if m == "MOV" and idc.get_operand_type(ea, 1) == idc.o_imm:
return idc.get_operand_value(ea, 1) & 0xFFFFFFFF
if m == "LDR":
return const_map.get(stack_tag(idc.print_operand(ea, 1)))
return None
return None
def build_table_a(disp_start, end, const_map):
    table_a = {}
    ea = disp_start
while ea < end:
if idc.print_insn_mnem(ea) == "STR" and stack_tag(idc.print_operand(ea, 1)) == "var_150":
            src = norm_reg(idc.print_operand(ea, 0))
            defn = find_def(ea, src, disp_start)
if defn != idc.BADADDR and idc.print_insn_mnem(defn) == "CSEL":
                t_reg = idc.print_operand(defn, 1)
                f_reg = idc.print_operand(defn, 2)
                cond  = norm_reg(idc.print_operand(defn, 3))
                t_val = resolve_const(defn, t_reg, disp_start, const_map)
                f_val = resolve_const(defn, f_reg, disp_start, const_map)
                table_a[ea] = {"type": "branch", "true": t_val,
"false": f_val, "cond": cond, "str_ea": ea}
else:
val = resolve_const(ea, src, disp_start, const_map)
                table_a[ea] = {"type": "single", "next": val, "str_ea": ea}
        ea = idc.next_head(ea)
return table_a
输出如下
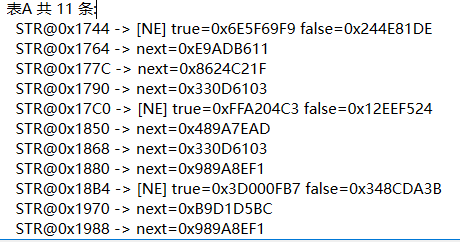
patch
现在所有的前置条件都已经准备好了 这一部分做的就是把每个块结尾的 B loc_199c(跳回分发器)改成B 目标块 中间的写状态、跳分发器 全部砍掉
Arm64每条指令固定四个字节 这里要写的是跳转指令 得算出他的机器码 然后再用da_bytes.patch_dword写进去
两种跳转的机器码格式:
无条件 B 目标:机器码 = 0x14000000 | (offset & 0x03FFFFFF) 其中 offset = (目标地址 - 当前指令地址) >> 2
条件 B.cond 目标:机器码 = 0x54000000 | ((offset & 0x7FFFF) << 5) | 条件码 其中 offset 算法同上 条件码是个查表得来的小整数(EQ=0、NE=1……)
ps:offset >>2 这里是因为arm指令都是4字节对其 跳转距离一定是4的倍数
_COND = {"EQ":0,"NE":1,"CS":2,"HS":2,"CC":3,"LO":3,"MI":4,"PL":5,
"VS":6,"VC":7,"HI":8,"LS":9,"GE":10,"LT":11,"GT":12,"LE":13,"AL":14}
defenc_b(cur, target):
    off = (target - cur) >> 2
return0x14000000 | (off & 0x03FFFFFF)
defenc_bcond(cur, target, cond):
    off = (target - cur) >> 2
return0x54000000 | ((off & 0x7FFFF) << 5) | _COND[cond]
defwrite32(ea, val):
    ida_bytes.patch_dword(ea, val & 0xFFFFFFFF)
遍历A表每一条 info里存放着当前块的下一个状态
idc_next_head拿到写状态的那条STR的下一条 也就是B loc199c 他的地址存b_ea
single 分支 : 用 table_b.get(info["next"]) 拿下一状态对应的真实块 target 然后 write32(b_ea, enc_b(b_ea, target)) 算出从 b_ea 跳到 target的 B 机器码 写进 b_ea 一条指令改完 这个块就直连目标了
branch 分支 : 要改三条 先查真假两个状态各自对应的块 t_block、f_block 再用 find_def 找到 CSEL 的位置(它定义了写进 var_150 的那个寄存器) 然后三连改:CSEL 那条改成 B.cond t_block(条件成立跳真块) STR 那条改成 NOP B 那条改成 B f_block
def unflatten(table_a, table_b):
    for str_ea, info in table_a.items():
        b_ea = idc.next_head(str_ea)
        if info["type"] == "single":
            target = table_b.get(info["next"])
            if target is None:
                continue
write32(b_ea, enc_b(b_ea, target))
print("[single] 0x%X  B 0x%X" % (b_ea, target))
        else:
            t_block = table_b.get(info["true"])
            f_block = table_b.get(info["false"])
            if t_block is None or f_block is None:
                continue
            csel_ea = find_def(str_ea, idc.print_operand(str_ea, 0), 0)
write32(csel_ea, enc_bcond(csel_ea, t_block, info["cond"]))
write32(str_ea, 0xD503201F)
write32(b_ea, enc_b(b_ea, f_block))
print("[branch] 0x%X B.%s 0x%X ; 0x%X NOP ; 0x%X B 0x%X"
                  % (csel_ea, info["cond"], t_block, str_ea, b_ea, f_block))
效果如下:
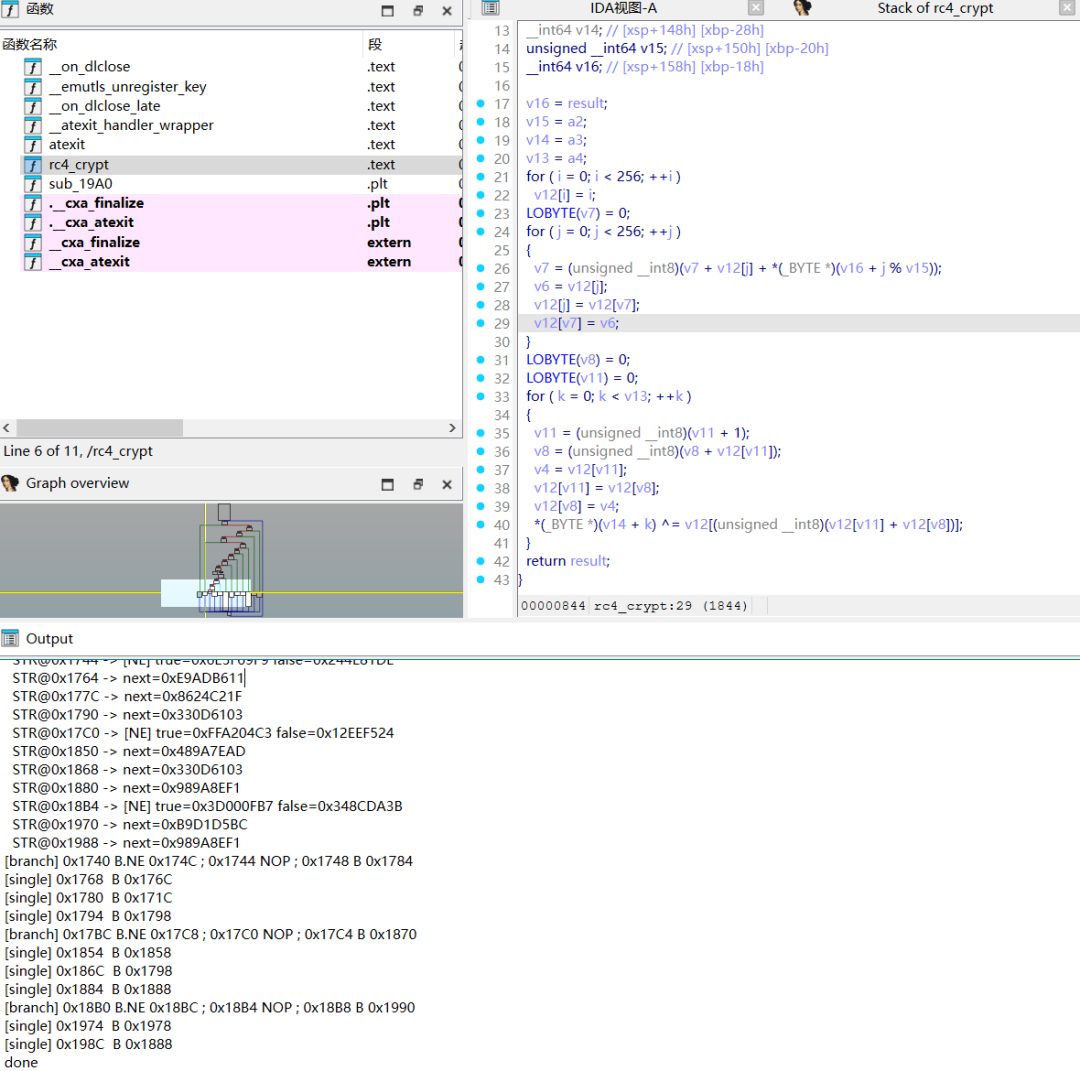
思路三:angr符号执行
参考文章:
思路二也并非完美的 要是混淆上点强度 比如说状态值不是简单的MOV立即数 用更复杂的传值过程 静态规则匹配可能回漏缺 导致出错
angr的思路是不去猜状态值是怎么计算的 直接跑程序 跑到哪个就是哪个 运算由符号执行引擎去做 看结果就行
目标依旧是不变的
1.找真实块 2.找真实块之间的连接关系 3.重建控制流
第一步和第三步跟思路二的方案完全一样 可以直接复用前面的idapython 唯一的不同就只有第二步 下文就只对第二步进行讲解 如何用angr进行处理
简单介绍一下符号执行:普通模拟执行(比如说qiling)需要传入具体的数值 比如说a=1、b=2 然后算出来3
符号执行不传值 他传入如符号 a、b 最后给出a+b
如果碰到了一个分支 他不会跟cpu一样根据寄存器的值来二选一 而是把两条路都记下来 然后各自带一个约束继续跑
而恰好也是用来找块连接关系的核心
整体的策略:
不能让angr从头到尾一次性跑完 这样会导致路径爆炸 函数里面带循环 循环里面带if 路径会尝试指数级的暴涨 最后卡死
所以这里采用的方案是
每次只取一个真实块A作为起点 让他跑 跑到下一个真实块B就立刻停 然后记录下A->B这条边 然后换下一个真实块重来 这样每次探索的路径极短 基本上永远不会爆炸 等他跑完所有真实块 整张图也就收集齐了
流程是这样的一条线:
主序言->hook 跳到正式块A ->从A往下跑->撞到下一个真实块B->停 记录A->B
有两个关键的东西
1.必须先执行主序言(初始化栈、初始化三个状态常量寄存器)否则后面的判断没有正确的处值
2.执行完序言后不让他走进分发器 而是hook序言的最后一条指令 把pc直接改成真实块A的地址 跳过分发器那一坨比较链
先把几个关键的地址梳理出来
主序言从 0x1588 到 0x15CC 最后一条是 0x15CC: B loc_15D0 这就是要 hook 的指令
主分发器 loc_15D0(0x15D0)它读 var_150(当前状态)存进 var_160 然后一路比较链往下派发
中转站 loc_199C(0x199C)所有真实块结尾统一 B loc_199C 它再 B loc_15D0 跳回分发器
返回块 loc_1990(0x1990)末尾是 RET 是真实块集合里唯一没有后继的块
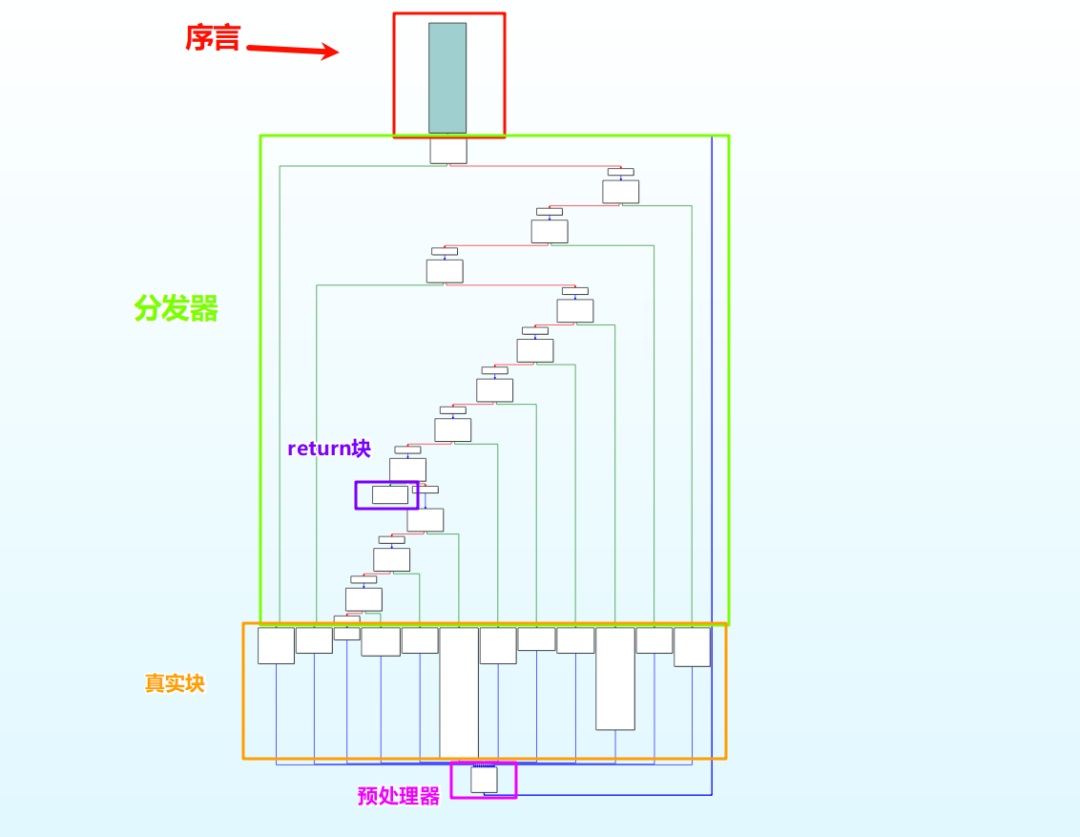
第一步:搭 angr
这一步就四件事情 加载so、拿基址、造初始状态、备好结果表 全部集中再angr_main的开头
def angr_main(real_blocks, func_offset, file_path):
    proj = angr.Project(file_path, auto_load_libs=False)
base = proj.loader.min_addr
    func_addr = base + func_offset
    init_state = proj.factory.blank_state(addr=func_addr)
    init_state.options.add(angr.options.CALLLESS)
    path = {addr: [] for addr in real_blocks}
    ret_addr = real_blocks[len(real_blocks) - 1]
简单解释一下代码
首先auto_load_libs 设置为false是必须要做的 不依赖加载库
base就是拿到基址 然后用基址加上传进来的函数偏移就得到了函数在angr的真实入口
init_state就是创造一个空白的初始状态 从函数入口开始 寄存器、内存大部分都没有初始化
blank_state 里未初始化的内存/寄存器在默认 symbolic 模式下访问时会返回无约束符号值 而不是像 qiling 那样是 0 或垃圾值
init_state.options.add的作用就是遇到了函数调用的时候不要真的进去执行 直接跳、给返回值一个符号
path就是建立结果表 key是每个真实块地址 value是他的后继列表
ret_addr取出真实块列表的最后一个 约定他是return块 后面遍历的时候要跳过他 因为终点没有后继
第二步:定位序言最后一条指令
这里就是定位序言的最后一条指令 好跳过分发器 直达真实块
first_block = proj.factory.block(func_addr)
first_block_insns = first_block.capstone.insns
first_block_last_ins = first_block_insns[len(first_block_insns) - 1]
first_block拿到函数的第一个基本块 因为函数入口就是序言 所以这里的块就是序言块
first_block_insns 是这个块用 capstone 反汇编出来的指令列表 capstone 是反汇编引擎 insns 是一条条指令对象
first_block_last_ins 取出列表的最后一个元素 就是序言块的最后一条指令 B loc_15D0
拿到这个first_block_last_ins对象后 在下一步的hook当作用得到
第三步:主循环 逐个真实块hook
这里对每一个真实块做同一个套路 复制干净状态、挂上hook 把pc指向这个块、调find_block_succ找他的后继
    for real_block_addr in tqdm(real_blocks):
        if ret_addr == real_block_addr:
            continue
        state = init_state.copy()
print("正在寻找:", hex(real_block_addr))
        def jump_to_address(state):
            state.regs.pc = base + real_block_addr - 4
        proj.hook(first_block_last_ins.address, jump_to_address,
                  first_block_last_ins.size)
        ret = find_block_succ(proj, base, func_offset, state,
                              real_block_addr, real_blocks, path)
        if ret == "erro":
            return
跳过return块 跳过分发器 直达真实块 proj.hook的三个参数 (地址,回调,长度) 这里写入的分别是 序言的最后一条、拦截后就跳过分发器、长度为四个字节
挂上之后state执行到0x15cc的时候 angr就不执行原本的B loc_15D0 转而去执行回调
这里回调里把 PC 写成的是 目标块地址 - 4 而不是目标块地址本身 原因是 angr 的 hook 在回调执行完之后 会按 hook 时传入的指令长度(这里是 4 字节)自动把 PC 向前推进一条 用来跳过被 hook 的那条指令 如果回调里直接写成目标块地址 回调返回后 angr 再自动 +4 PC 就会落到目标块 + 4 正好跳过目标块的第一条指令、导致起点错位 所以要先减 4 抵消掉这个自动步进 让 PC 最终精确停在目标块的第一条指令上
第四步:find_block_succ外层
这里就是把state往前推 直到确认他达到了指定的起点真实块
def find_block_succ(proj, base, func_offset, state, real_block_addr,
                    real_blocks, path):
    msm = proj.factory.simgr(state)
    while len(msm.active):
        for active_state in msm.active:
            offset = active_state.addr - base
            if offset == real_block_addr:
                mstate = active_state.copy()
                msm2 = proj.factory.simgr(mstate)
                msm2.step(num_inst=1)
                # todo 内层 while
                return
        msm.step(num_inst=1)
把传进来的state包成一个模拟管理器 simgr 这玩意维护了一个active列表 装着当前所有活跃的执行状态 只要还有活跃状态循环就不停 接着就是遍历当前所有活跃状态 一开始就只有前面copy的那一份 但是如果中途遇到了分支 angr可能会分裂多个
然后就是判断当前是不是已经到了指定的真实起点块 如果到了 就先复制一份当前的状态 用复制出来的状态另外起一个simgr 专门用来往下跑去找后继
第五步:无分支块
内层while干的事情就是:从起点块的第二条指令开始 逐指令往前跑 一边跑一边判断当前落到了哪里 落地又分为两种 无分支块和有分支块
这里无分支块就是真实块跑完只有一个去向 没有CSEL选择 他的特征就是一路跑下去 自然而然又踏进了某个real_blocks里的地址 那个地址就是他唯一的后继
whilelen(msm2.active):
for mactive_state in msm2.active:
                        ins_offset = mactive_state.addr - base
if ins_offset in real_blocks:
                            msm2_len = len(msm2.active)
if msm2_len > 1:
                                tmp_addrs = []
for s in msm2.active:
                                    moffset = s.addr - base
                                    tmp_value = path[real_block_addr]
if moffset in real_blocks and moffset notin tmp_value:
                                        tmp_addrs.append(moffset)
iflen(tmp_addrs) > 1:
                                    ret_addr = real_blocks[len(real_blocks) - 1]
if ret_addr in tmp_addrs:
                                        tmp_addrs.remove(ret_addr)
                                    ins_offset = tmp_addrs[0]
                            value = path[real_block_addr]
if ins_offset notin value:
                                value.append(ins_offset)
print(f"无条件跳转块关系:{hex(real_block_addr)}=>{hex(ins_offset)}")
return
只要msm2还有活跃状态就继续跑 从起点第二条指令往下跑、第一个撞到的 real_blocks 地址 正常就一个 直接记 万一 angr 分裂出多个候选 剔掉 return 块 取第一个 判断落点靠 ins_offset in real_blocks 记录前靠 not in value 去重
第六步:CSEL 分支块
无分支是状态一个就完事 CSEL块不一样 他有两个后继 靠CSEL指令在运行的时候二选一 而angr对CSEL不会自动分裂路径 所以得手动掰出来这两条路
                        ins = mactive_state.block().capstone.insns[0]
if ins.mnemonic == 'csel':
                            state_true = mactive_state.copy()
                            state_true_succ_addr = find_state_succ(
                                proj, base, state_true, True,
                                real_blocks, real_block_addr, path)
                            state_false = mactive_state.copy()
                            state_false_succ_addr = find_state_succ(
                                proj, base, state_false, False,
                                real_blocks, real_block_addr, path)
if state_true_succ_addr isNoneor state_false_succ_addr isNone:
print("csel错误指令地址:", hex(ins_offset))
print(f"csel后继有误:...")
return"erro"
print(f"csel分支跳转块关系:{hex(real_block_addr)}=>"
f"{hex(state_true_succ_addr)},{hex(state_false_succ_addr)}")
return
                        msm2.step(num_inst=1)
判断当前指令是不是CSEL 如果是的话进入手动分裂 state_true 和state_false分别复制一份 根据条件成立和条件不成立去跑 找他的后继
find_state_succ函数 就是这么手动掰方向了
def find_state_succ(proj, base, local_state, flag, real_blocks,
                    real_block_addr, path):
    ins = local_state.block().capstone.insns[0]
    dst_reg, reg1, reg2, condition = capstone_decode_csel(ins)
    val1 = local_state.regs.get(reg1)
    val2 = local_state.regs.get(reg2)
    sm = proj.factory.simgr(local_state)
    sm.step(num_inst=1)
    tmp_state = sm.active[0]
    if flag:
setattr(tmp_state.regs, dst_reg, val1)
    else:
setattr(tmp_state.regs, dst_reg, val2)
    while len(sm.active):
        for active_state in sm.active:
            ins_offset = active_state.addr - base
            if ins_offset in real_blocks:
                value = path[real_block_addr]
                if ins_offset not in value:
                    value.append(ins_offset)
                return ins_offset
        sm.step(num_inst=1)
    return None
取一次CSEL指令 解析出来四个操作数 在CSEL执行完毕后 不用angr填写结果 府改为dst:flag=true就把dst设为vall(reg1的值)否则就是设为val2(reg2的值)
把 CSEL 的操作数字符串去空格、按逗号切开,取出 dst、reg1、reg2、cond 四样
defcapstone_decode_csel(insn):
# CSEL dst, reg1, reg2, cond
    operands = insn.op_str.replace(' ', '').split(',')
    dst_reg = operands[0]
    reg1 = operands[1]
    reg2 = operands[2]
    condition = operands[3]
return dst_reg, reg1, reg2, condition
第七步:收尾
把填满的 path转成十六进制打印并返回 在angr_main的if ret == "erro": return后追加
    hex_dict = {
hex(key): [hex(v) for v in values]
for key, values in path.items()
    }
print("真实块控制流:")
for k in hex_dict:
print(f"{k}: {hex_dict[k]}")
return hex_dict
测试(all_real_blocks最后一个是return)
all_real_blocks = [0x171C, 0x174C, 0x176C, 0x1784, 0x1798, 0x17C8,
                   0x1858, 0x1870, 0x1888, 0x18BC, 0x1978, 0x1990]
angr_main(all_real_blocks, 0x1588, "librc4_fla.so")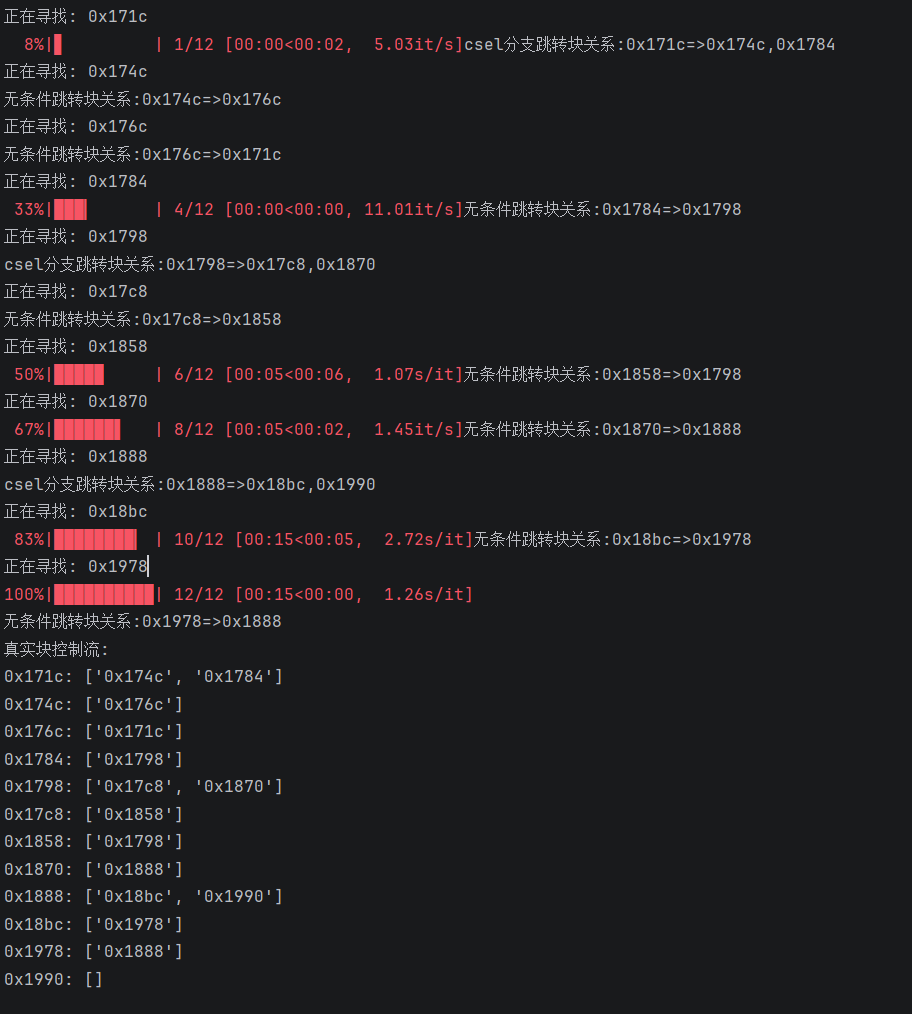
方案边界
虚假控制流(BCF)
思路一 D-810 最省事,规则命中就一键还原。边界在于它是规则驱动的,只认已知的不透明谓词形态,样本里的谓词若不在规则库覆盖范围内就还原不掉。优先试它,还原不干净再往下走。
思路二 常量传播剪枝,本质是把不透明谓词依赖的全局变量(x、y)固定成定值,让 IDA 的死代码消除自己把死分支抹掉。前提很硬:这些变量必须是只读的假谓词专用变量,且所在段没有混入程序真正用到的全局变量,否则一刀切会误伤真实逻辑。改数据比改指令省事,改指令用在变量零散、不在 .bss、不便整段改数据时。
思路三 符号执行(deflat),思路通用但在带循环的函数上极易路径爆炸,跑一天都跑不完。零填充未初始化内存/寄存器能压掉一部分分支,但对循环次数依赖符号值的情况仍然吃力,本文实测走不通,不推荐作为首选。
思路四 qiling 污点追踪,最通用也最重。核心是把不透明谓词依赖的全局变量当污点源,动态跑一遍,看哪个条件跳转的判定值来自污点,就是假跳转。适用于谓词形态未知、静态匹配失效的场景。前提是能识别出污点源:符号没被去掉时按名字定位,去了符号则靠"只读不写且参与条件跳转"的特征筛。它不依赖谓词长什么样,只认数据从哪来,所以抗变形能力最强,代价是要自己搭执行环境、处理 GOT 重定位这类工程细节。
一句话:先 D-810,不行看谓词变量是否干净能否常量剪枝,都不行再上 qiling 污点。
控制流平坦化(FLA)
思路一 D-810,同样最省事,flatfold / unflattening 规则一把梭。边界是它依赖规则实现的健壮性,本文就撞上原项目的死循环 bug(右操作数非立即数的块不推进迭代),得打补丁才能用。规则能覆盖就用它。
思路二 状态机(静态匹配),手动建表:表 A 记块到下一状态、表 B 记状态到块,再把写状态改成直连跳转。快、直观,但吃死"状态值是简单形态"这个前提——状态用 MOV 立即数直连时最好使,一旦状态值经过复杂运算传递、或同一状态值被复用,静态规则就会漏缺出错。适用于弱平坦化。
思路三 angr 符号执行,不猜状态值怎么算,分段跑、算到确定值为止,抗变形比思路二强。但前提是状态值最终能收敛成确定值:状态值都是自包含常量时没问题;一旦依赖外部输入、真实内存或被 CALLLESS 跳过的调用返回值,未初始化数据返回无约束符号,比较就没有唯一解,状态分裂、收不敛。此外还要手动处理 angr 不会自动分裂的 CSEL 分支,以及分段跑来防路径爆炸。适用于状态传值复杂、静态匹配已经漏缺的场景。
一句话:先 D-810,弱平坦化用状态机静态建表,状态传值复杂就上 angr 分段符号执行。
共通的一条线
BCF 和 FLA 的破解落到底是同一个动作:找到那个"决定走向的值",判断它是真是假,再把控制流接回去。BCF 里这个值是不透明谓词,FLA 里是状态变量。静态方案赌它形态固定、直接匹配;动态方案不赌,跑一遍看它实际取值。样本越简单越该用静态图省事,混淆越强越得退回动态换稳。
结语
OLLVM 反混淆到底是同一个动作:找到那个"决定走向的值",判断真假,再把控制流接回去。指令替换里是 MBA 表达式,虚假控制流里是不透明谓词,平坦化里是状态变量。工具只是手段:静态匹配赌它形态固定,图快;动态执行不赌,跑一遍看实际取值,图稳。样本越简单越该用静态,混淆越强越得退回动态。本文的方法并非原创,而是站在前人的肩膀上。特别感谢参考文献(左下角阅读原文查看)中各位前辈的公开记录,希望本文能够帮助到大家。
*本文为看雪论坛优秀文章,由 北袅原创,转载请注明来自看雪社区
1.25折门票限时抢购
球分享
球点赞
球在看
点击阅读原文查看更多