杰出论文、竞赛夺冠背后:美团工程师如何用 AI 解决物理世界真实问题?
美团技术团队 2026-09-17 18:00 北京
从真实业务中「长」出来的技术成果
点亮👆“☆”星标,不错过推送内容~
全文速读
近期,美团人在国际学术会议和技术竞赛中先后获得三项荣誉:
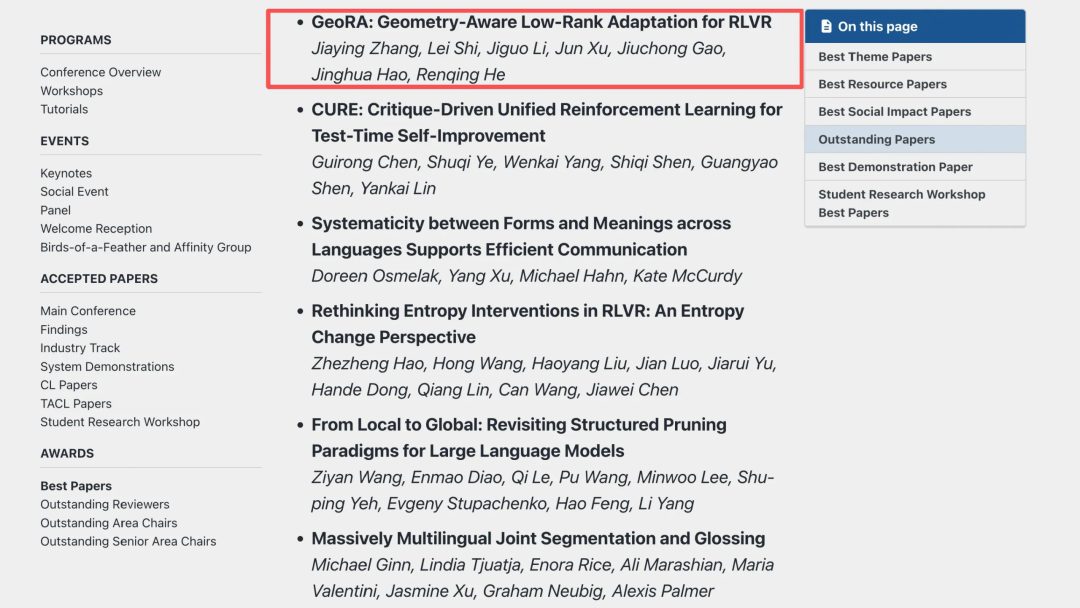
GeoRA:Geometry-Aware Low-Rank Adaptation for RLVR 获 ACL 2026 Outstanding Paper,全球仅 18 篇入选;
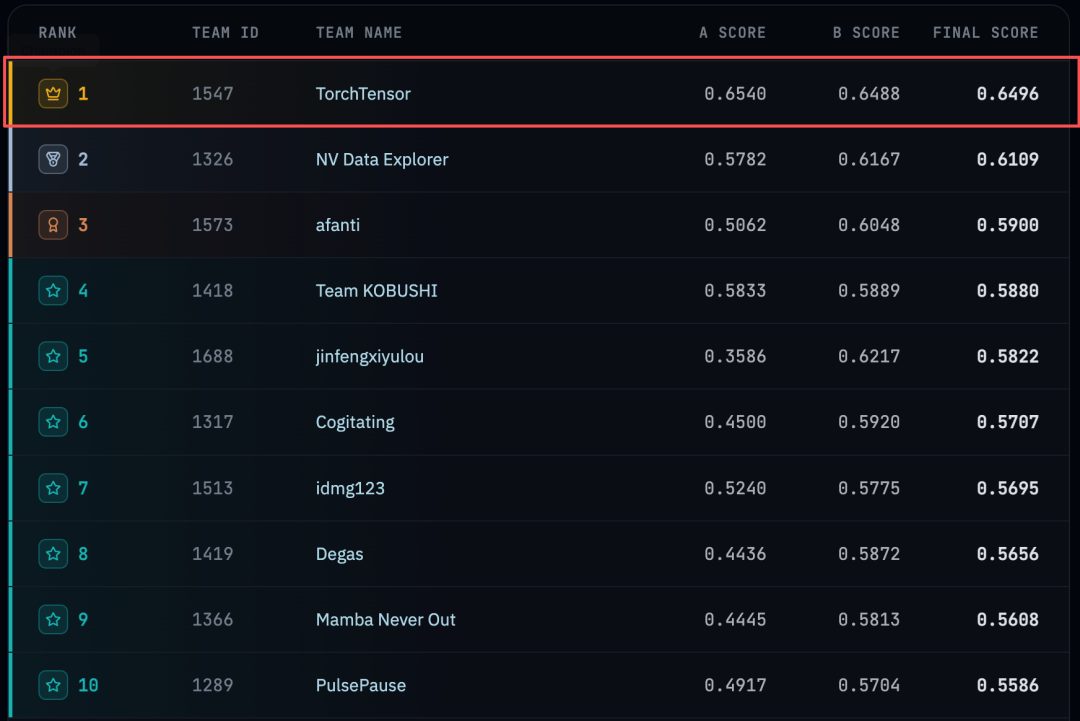
Data Agent 设计方案 TorchTensor获 2026 KDD Cup Data Agents for Complex Data Analysis 国际竞赛冠军;
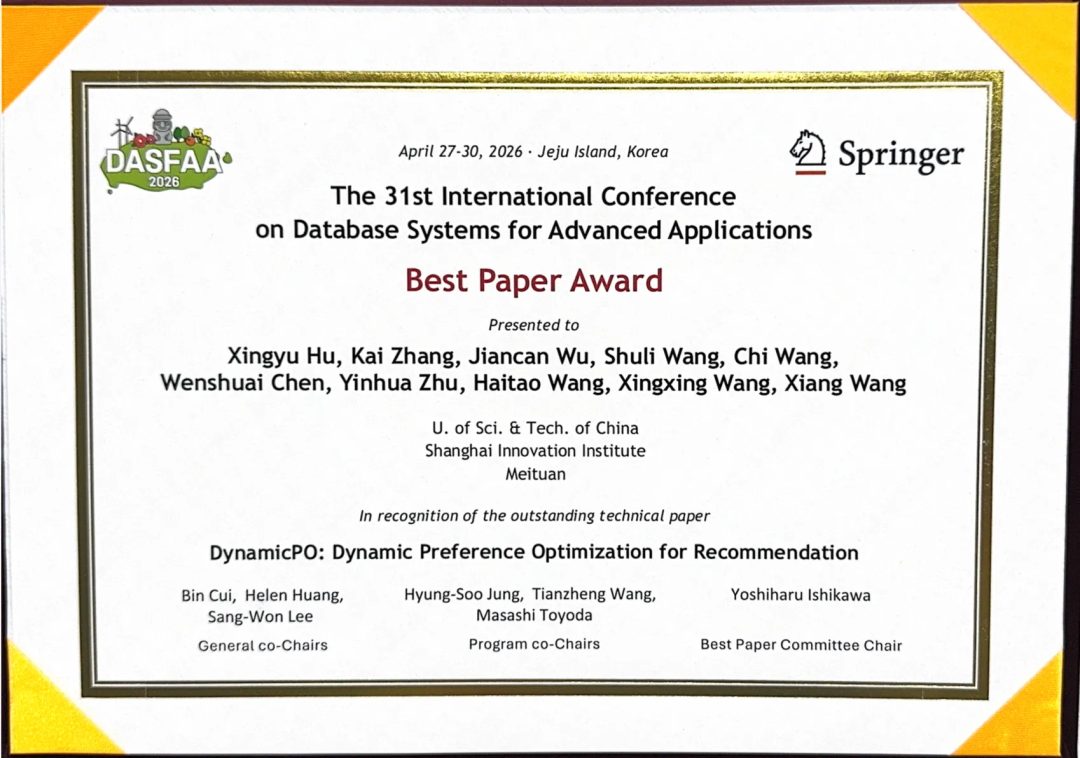
DynamicPO: Dynamic Preference Optimization for Recommendation 获 DASFAA 2026 Best Paper Award。
三项研究解决的问题各不相同,却有着相似的起点 —— 一个业务中“待解决”的问题。
如何实现高效强化学习?为什么负样本越来越多,模型实际准确率反而下降?当所有参赛者使用同一个开源模型时,系统设计如何拉开差距?
获奖者中,有人尝试过一些看起来更“优雅”的方法,但最终选择了更适合真实训练的路径;有人并不急于提交第一版方案,而是先想清楚整体技术方向;有人反复追问:究竟哪些样本才真正值得推荐模型学习?
我们和获奖者们聊了聊:一个日常工作里的实际问题,如何一步步变成一项扎实的研究成果;在业内通用的方法失效时,如何找到新颖的解题思路。
01 一篇 ACL Outstanding Paper 是如何诞生的?
🏆 奖项:2026 ACL Outstanding Paper,全球仅 18 篇入选
🔗 论文:https://arxiv.org/abs/2601.09361
🎙️ 讲述:美团业务研发平台-履约平台技术部 Shi Lei
我是 Shi Lei,来自美团履约平台技术部。GeoRA 这篇论文的研究起点,源于团队内部一次关于技术定位的讨论。
对于 AI 应用团队而言,一方面,Agent 模型需要大参数量和长上下文,这导致强化学习开销可观; 另一方面,业务的增量知识和能力规模不大,低秩适配容量足够承载。因此,团队关注了高效强化学习这一技术点。
换言之,我们想要解决的核心问题是 —— 如何更高效地做 RLVR(基于可验证奖励的强化学习)训练。
我们尝试过一些典型的低秩方法:比如 LoRA(低秩适配)、PiSSA(主成分低秩适配)……跑出来的方向效果都不一样,如果换一个学习率等超参,还可能训崩。
我们在尝试中拿到了一个关键认知:几何先验是问题的重要变量。
于是我们对 RLVR 做了一些机制上的调研和实验,发现 RLVR 和 SFT(监督微调)的训练动力学是不一样的:RLVR 更新的是稀疏区域,而不是像 SFT一样需要稠密、大规模更新。而此前的低秩方法,几乎都是在 SFT 场景下做设计和验证的。
从我们自身训练体感和调研交叉验证来看:在RLVR 的训练范式之下的低秩高效微调,还处于空白地带。
一个最直观的做法是:既然 RLVR 的有效更新在稀疏子空间,直接做稀疏微调最自然。但实验结果它的卡点在于硬件:现代 GPU 对非结构化稀疏计算并不高效,我们实测单步耗时甚至比全参数还要涨 10.8%。
于是问题被重新定义。一边是算得快但几何不对,一边是几何对但算不快。所以真正要回答的问题是:能不能把 RLVR 的稀疏特性转化为低秩特性?如果能用稠密的低秩矩阵去逼近子空间,就可以实现算得快、且几何对。
这就是论文呈现的核心方法:几何定位+低秩压缩。
过程中,我们还尝试过一些看似更优雅的做法,比如正交空间投影和残差SVD。但最终我们还是选择了 GeoRA 方案——因为它的掩码粒度更精细,它排斥的是主方向里的高幅值高曲率元素,保留的子空间还保留着预训练结构和低秩特性。
回顾去年,我们最初提出设想的时候,真的没有去想能否获奖,只是埋头去看哪一种技术路径是最优的、实验结果究竟如何。如今有两方面让我很有成就感:GeoRA 是第一个将 LoRA 和RLVR 结合起来的方法,有学术价值;二是高效训练的应用价值也很明确,我们在真实业务 Agentic RL 中应用 GeoRA,仅用不到全参训练一半的资源,取得了优于全参和 LoRA 的效果。
我常常会从实际创造的价值去回溯工作的价值,这是我喜欢的工作方式 —— 让技术长在真实的业务土壤上。
02 KDD Cup 冠军,是一次对日常工作的验证
🏆 奖项:2026 KDD Cup Data Agents for Complex Data Analysis 国际竞赛冠军
🔗 开源:https://github.com/zhezh/kddcup2026_champion
🎙️ 讲述:美团业务研发平台-点评技术部 Zhang Zhe
我是 Zhang Zhe,在美团工作 5 年了,目前负责大众点评“问点仔”的核心技术架构与算法能力建设。2026 KDD Cup Data Agents for Complex Data Analysis 是一个很垂直的竞赛,考验 Agent 在复杂场景下的数据分析能力。
换言之,这是一个“命题作文”。来自全球各地的参赛者都必须使用主办方指定的开源模型(有一定智能,但不是最强模型),在大量数据表、非结构化文档、视频中完成数据分析任务。在模型能力相同的情况下,参赛者比得是系统设计的能力。
当我第一次看到这个命题的时候,我的第一反应是“这题我会”。Data Agent 就像是一位数据侦探,它需要在庞杂的数据表、文档、视频信息中,判断哪些数据源是有用的,再选择合适的工具对数据进行分析,最终把零散的“信息证据” 导出完整、可信的结论。这与“问点仔”帮助用户整合多元数据、完成复杂消费决策的核心挑战是相通的。
还有一个很重要的参赛原因是,我想知道,平时埋头工作的我们,究竟如何评估我们的技术能力?是只是自己觉得不错,实际上并不好;还是我们的确挺厉害的?
这场比赛让来自世界各地的参赛者,都置身于同一个评估标准之下。
比赛开始时,我没有着急提交第一个版本,而是花了两天时间仔细研究题目和数据,理解其中真正的难点,再构思整体的工具体系和多模态处理方案。我提交第一版时,已经有参赛者迭代了四五轮。
但我认为,这是一个完整的 Agent 系统工程问题,最关键的是先想清楚、选对方向。
难点主要有三个方面:
Agent Harness 的设计和稳定性保障。比赛要求系统在离线环境中无人值守地连续处理数百个任务,稳定性差,就可能直接导致任务失败。
对视频信息的理解。视频通常包含大量重复画面,真正有效的信息可能只存在于少数关键帧中,直接全部输入给 Agent,会大量占用宝贵的上下文空间;此外还要综合考虑到语音和页面结构。
对非结构化文档的理解。如果只是简单的切分文档再逐块抽取,很容易遗漏实体或字段。
我的解题思路是:
主动缩小搜索空间,而不是给模型无限的自由,提高整个系统的稳定性。
利用视频编码信息识别画面变化并筛选关键帧,再通过任务上下文增强语音识别,降低同音字的识别错误率,最后将画面、页面布局和语音按时间对齐,让三个信息通道相互验证。
对于非结构化文档,我先确定文档中完整的实体集合,再按照属性分组并行抽取,通过程序校验和失败重试保证完整性,最后将结果合并、归一化成结构化表格,供 Agent 统一查询和分析。
对视频信息和非结构化文档的理解,后来成为了比赛拉开差距的关键因素。在实验中,我设计的这套定制流程比强模型(GPT-5.6-Sol)加通用流程的正确率高出 13.3%。
冠军奖杯背后,更重要的是通过和全球优秀团队的比赛,验证了我们的技术判断、技术品味以及解决复杂问题的能力。我们在这次比赛中验证了多模态信息理解与融合能力,可以复用在“问点仔”业务中,为用户提供更准确的消费决策建议。
03 一篇 BestPaper 的起点:模型为什么“越学越差”
🏆 奖项:DASFAA 2026 Best Paper Award
🔗 论文:https://arxiv.org/pdf/2605.00327
🎙️ 讲述:美团业务研发平台-商业增值技术部 Zhu Yinhua
举一个形象的例子,当用户在同一页面看到火锅和拉面,却选择了火锅时,这次选择会被模型识别为一组“正负训练样本” :
用户点击的“火锅”被归为正样本,没有被选择的“拉面”可能被归为负样本。
其中的偏差在于:用户不点击,不一定等于不喜欢。实际上,这些“相似但没有被用户选择”的样本,才真正刻画了用户“喜欢与不喜欢”的边界。
业界通常认为,负样本越多,模型就越能分清用户偏好。但我们在实验中观察到相反的现象:负样本越多,那些“易区分样本”主导了优化、而真正定义偏好边界的“困难样本”却被忽略了。于是推荐准确率不升反降——我们把这一现象称作“偏好优化坍塌”。
这是这篇 BestPaper 的研究起点。
我是 Zhu Yinhua,在美团已经 11 年了,主要做广告算法相关工作。广告算法需要解决的核心问题是,如何准确理解用户偏好。比如用户打开美团后会看到一系列商家,我们需要预测用户点击每家店的概率,再决定展示和排序。
这篇论文 DynamicPO: Dynamic Preference Optimization for Recommendation(面向推荐系统的动态偏好优化) 是美团业务研发平台商业增值技术部和中国科学技术大学的共同研究成果,我是其中的参与者之一。
这一次,我们想用大模型来理解用户偏好,从用户留下的海量隐式反馈里学会“喜欢什么、不喜欢什么”。
过去,负样本的数量和比例依赖于过往经验。算法工程师可能反复尝试1:3、1:5或者更高比例,再根据实验结果确定一个值。然而这个终于“试”出来的值,在当前场景有效,换到另一个场景却未必成立。基于这个现象,我们都觉得有必要深挖一下,在不同场景之下,如何判断哪些负样本真正有学习价值?
最常用的做法是 DPO(直接偏好优化)——拿一个用户选过的正样本,配上多个没选的负样本一起训练,但负样本里大多是“一眼就不相关”的易区分样本。比如用户想要点餐,在火锅、拉面、4S 店三个选项中,4S 店是那个易区分样本。
我们的解法是:让模型在训练过程中动态筛选更接近偏好边界、信息量更高的负样本,并根据样本难度调整训练力度。在一组公开数据实验中,当负样本增加到 15 个,DynamicPO 将推荐命中率从 58.47% 提升到 66.61%。
其实,大语言模型如何与广告算法结合,我们探索过很多方向,最终定位到“偏好优化坍塌”这一具体问题时,我有种豁然开朗的感觉。
我们还将 DynamicPO 设计成了一个轻量化的、即插即用的模块,可嵌入到后训练流程中,适用于更多预测用户偏好的场景。在我看来,对于实际业务场景而言,方法并不是越复杂越好,更重要的是务实地解决问题。
三位美团人的技术成果,回答了同一个问题:AI 能否真正进入真实工作流,解决真实问题。
美团一边连接着物理世界丰富的信息和场景,另一边在基座大模型、大模型应用、无人机、自动驾驶、具身智能、智能决策等方向有长期技术积累。如果你也希望用技术在真实世界中发挥影响力,让这个世界更美好,欢迎加入美团,和我们一起探索技术前沿,一起成长,一起更好。
这里我们也预告一下,在9月21日(下周一)清华大学与美团将联合举办一场学术论坛,ACL Outstanding Paper 的作者也将在线介绍他们的获奖论文(15:40 - 16:00),感兴趣的同学可以报名参考,具体信息如下:
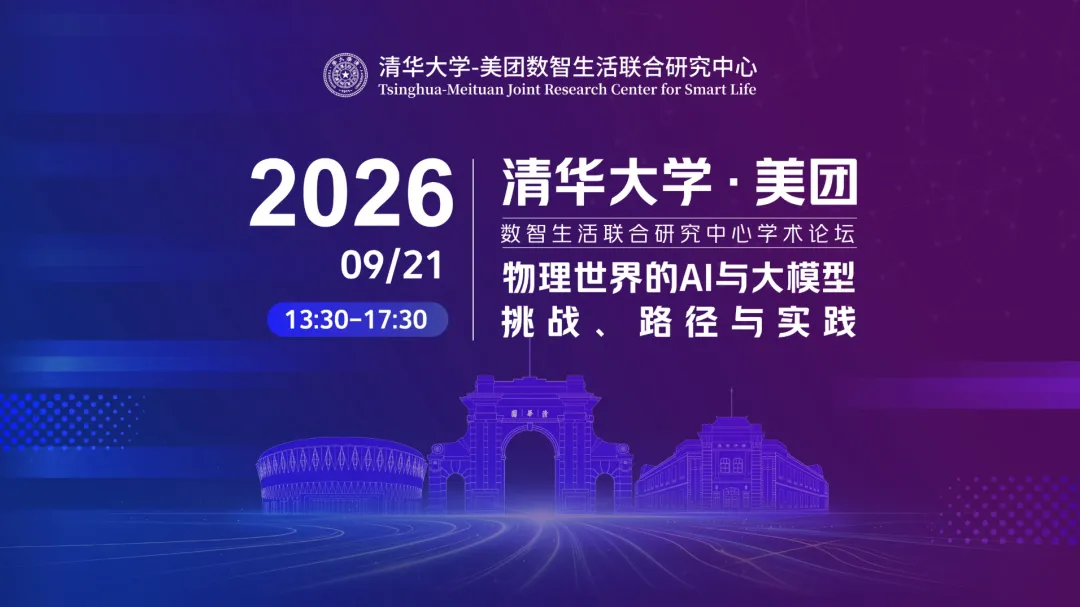
论坛主题:物理世界的AI与大模型:挑战、路径与实践
论坛时间:2026年9月21日(周一)13:30-17:30
论坛形式:线上直播(点击报名) + 清华线下(9 月 17 日周四 24:00 截止报名)
阅读更多详情:报名 | 清华大学-美团学术论坛:物理世界中的AI及大模型
🔽 清华线下参会报名 🔽
2026 年 9 月17 日(周四)24:00 截止报名
2026 年 9 月 18 日(周五) 20:00 前通知审核结果
🔽 线上参会报名 🔽
也可点击文末的「阅读原文」报名