研究人员利用Claude Opus模型及智能体,72小时攻破OpenAI公司安全防御系统
原创 BaizeSec 2026-09-20 17:25 北京
一、事件概述
近日,Hacktron AI安全研究团队发布专项技术研究报告,公开了基于Anthropic Claude Opus 5大模型开展的OpenAI官方授权安全测试完整成果。研究人员在72小时内,成功串联libheif堆缓冲区溢出漏洞与OpenAI单点登录身份校验漏洞,搭建出一条完整、可复现、可落地的闭环攻击链路。本次合规测试成功获取OpenAI员工ChatGPT、Codex业务账号权限,并以此为横向渗透跳板,成功触达企业内部GitHub私有代码仓库。
本次测试全程纳入OpenAI官方漏洞赏金计划,所有操作合规、可控、可追溯。研究团队完成权限有效性验证后,第一时间通过Bugcrowd平台向OpenAI提交了完整的漏洞细节、利用链路及针对性修复方案。OpenAI已于2026年7月25日完成全部相关漏洞的修复整改,并向研究团队发放6500美元安全赏金。Discourse官方也在2026年7月28日针对本次漏洞关联组件推送了专属安全补丁。2026年9月13日,Hacktron AI团队在官方博客公开了本次测试的完整技术复盘文章。
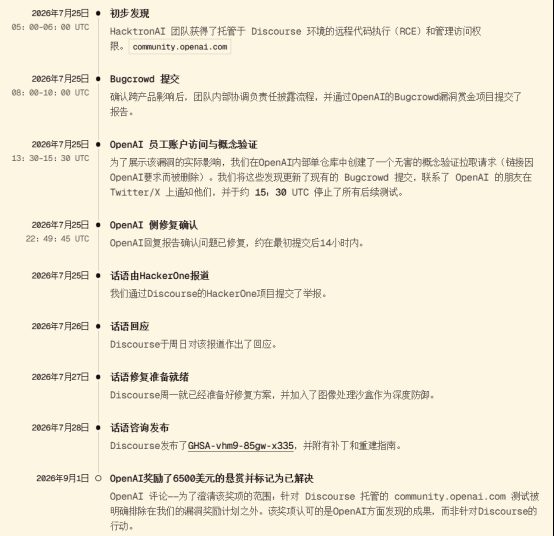
图 1 攻击测试时间线分析
本次事件是个首次公开的,依托AI大模型完成高级内存破坏漏洞全流程利用的典型攻防案例。本次研究仅由3人小型团队完成,全程依靠Claude Opus 5大模型自主实现漏洞利用代码编写、运行环境适配、攻击链路校验等核心工作,大幅降低了堆溢出这类高级内存破坏漏洞的利用门槛与技术落地成本。
本次攻击以OpenAI基于Discourse框架搭建的公开社区论坛为突破入口,利用平台开放的HEIC/HEIF图片上传解析常规业务功能,挖掘前端依赖的第三方组件漏洞并拿下论坛服务器控制权,再利用SSO单点登录体系的身份信任缺陷完成横向权限跳转,最终凭借员工账号绑定的GitHub OAuth授权权限,成功渗透至OpenAI核心研发私有代码仓库。
该攻击链路直观暴露了当前AI科创企业普遍存在的新型架构安全风险:公网外围业务站点、全局单点登录体系、第三方OAuth授权体系一旦出现任一安全短板,极易引发跨系统、跨层级的链式权限泄露,直接威胁企业核心代码资产、模型训练数据集、研发涉密资料的安全。本次测试仅开展无害的权限验证操作,通过创建测试拉取请求确认攻击链路有效性,未窃取、下载、篡改、导出任何敏感源代码与核心业务数据。
二、攻击过程分析
本次授权安全测试构建了两段式串联攻击链,核心分为Discourse论坛服务器远程代码执行、基于SSO身份缺陷的横向提权两个核心阶段,全程依托AI大模型实现高危漏洞的自动化武器化落地。
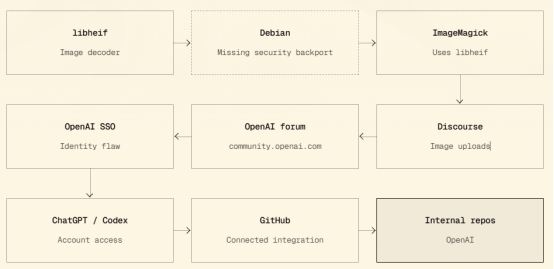
图 2 攻击链分析
本次攻击的初始突破点为OpenAI官方社区论坛community.openai.com。该站点基于Discourse开源框架搭建,对外提供HEIC、HEIF格式图片上传与解析服务,其图片解析功能依赖的开源libheif图像处理库,存在可远程利用的堆缓冲区溢出高危漏洞。研究人员首先搭建与OpenAI官方云端环境配置完全一致的本地仿真靶场,将Claude Opus 5配置为自动化循环执行智能代理,由大模型独立完成漏洞原理分析、验证POC编写、利用代码调试与优化等全流程工作。
Claude Opus 5在数小时内完成了ARM64架构下的漏洞利用程序开发,研究人员仅针对论坛服务器x86-64实际运行环境做轻量化适配优化等。随后智能体通过上传恶意构造的HEIF图片文件,成功触发libheif堆缓冲区溢出漏洞,在Discourse外网论坛服务器实现远程代码执行(RCE),完成外网边界突破,获取服务器最高系统控制权限。
拿下外围论坛服务器控制权后,研究人员启动第二阶段横向移动与权限提升作业。OpenAI社区论坛复用企业全局统一账号体系,部署了全域SSO单点登录机制,外网论坛服务与OpenAI内部核心业务系统存在默认身份信任绑定关系。研究人员利用其单点登录身份校验不严、会话信任过度授信的缺陷,通过已攻陷的外网服务器劫持并伪造合法用户会话,成功接管OpenAI内部员工账号,登录该账号绑定的ChatGPT、Codex核心研发业务系统。
由于该员工账号预先开通了OpenAI内部GitHub组织的OAuth授权对接权限,依托系统默认的跨平台权限联动规则,研究人员可直接访问企业内部私有代码仓库。为严格恪守合规测试准则,本次仅通过Codex工具在内部代码库创建无破坏性测试拉取请求,仅用于验证全攻击链路的连通性与权限有效性,未读取、篡改、下载任何涉密代码与核心数据,完整证实了整条攻击链路的可行性与危害性。
本次攻击测试的核心突破价值,在于验证了生成式AI可作为高级漏洞武器化的自动化核心引擎。传统堆缓冲区溢出等内存破坏漏洞,其EXP编写、跨架构适配、稳定性调优、落地利用全流程,高度依赖资深逆向安全工程师的长期经验积累,存在开发周期长、人力成本高、落地难度大的痛点。而Claude Opus 5可自主完成漏洞原理拆解、利用逻辑设计、攻击代码生成与迭代调试,极大缩短了高级漏洞从发现到武器化的周期,让以往高门槛的高级渗透攻击走向轻量化、普及化。
同时,本次攻击精准暴露了云原生AI企业的共性架构安全隐患:多数企业过度信任外围公网业务与核心内网系统的身份联动关系,未设置严格的权限隔离与身份校验机制。一旦低优先级的外网附属站点被攻陷,默认的身份信任链路会成为攻击者横向渗透的核心通道,彻底击穿传统内外网边界防护体系,实现从公网外围服务直达企业核心研发系统的越级渗透。
三、攻击事件总结与深度延伸分析
本次Hacktron AI团队针对OpenAI开展的授权安全测试,并非恶意网络入侵,而是一次具备行业里程碑意义的AI赋能攻防实证研究。过往堆缓冲区溢出等复杂高危内存破坏漏洞,从漏洞分析、POC验证、EXP武器化到环境适配落地,全程依赖顶尖安全人员的个人经验,落地门槛极高、研发周期漫长。而本次测试依托顶级大模型,高效完成全套高级漏洞利用开发工作,大幅降低了复杂攻击链路的搭建成本。这意味着高级网络攻击已不再高度依赖资深人工技术能力,黑灰产及国家级攻击力量可复用该模式快速迭代智能化攻击工具,全球网络攻防的整体格局已发生实质性变革。
从企业安全防护视角来看,本次测试暴露了云原生AI企业普遍存在的防护短板。多数企业存在明显的防护资源倾斜问题,重核心研发业务安全、轻外围公网业务防护,对社区站点、对外服务页面等低优先级业务的底层开源依赖组件,缺乏常态化漏洞监测、巡检与补丁更新机制。同时,SSO单点登录、跨平台OAuth授权的大规模应用,构建了复杂的跨系统身份信任网络,但多数企业未严格落实权限最小化、按需授权原则,身份边界管控松散、授信规则粗放。一旦外围边界出现单点失守,就会触发链式权限泄露,形成从公网到核心研发系统的越级渗透风险。事件发生后,OpenAI通过收紧令牌权限、吊销风险会话、修复SSO校验漏洞完成全面安全整改,为同类AI企业的漏洞修复与风险整改提供了实操参考,也为国内政企机构、关键基础设施运营单位提供了重要防护启示。传统边界拦截、恶意代码查杀、事后补丁修复的被动防御模式,已无法适配AI时代的高速攻防对抗节奏。
从国家级网络安全对抗维度分析,AI智能体的规模化落地应用,推动网络攻击从传统人工辅助对抗,迈入全自主智能化对抗的全新阶段。相较于传统人工攻击效率低、持续性弱、攻击策略固化、人力成本高的短板,AI智能体可实现7×24小时无人值守、规模化、持续性的漏洞探测与渗透测试,能够自主适配目标环境、迭代攻击策略、优化攻击载荷,大幅提升网络攻击的隐蔽性、成功率与覆盖范围,彻底颠覆了传统攻防对抗逻辑。这种智能化攻击能力的普及,将对我国能源、电力、交通、通信、金融、政务等关键基础设施体系构成严峻安全威胁。
除此之外,本次公开技术测试充分证明,美国凭借顶尖大模型与人工智能技术垄断优势,已经掌握7×24小时全自动化AI网络攻击能力。该能力可依托AI智能体完成全域漏洞扫描、链式攻击链路构建、跨域横向渗透、攻击策略自主迭代的全流程无人化作业,形成了常态化、规模化、智能化的网络攻击威慑。当前全球网络攻防已正式进入AI智能博弈时代,中美网络攻防不对称风险持续加剧。我国现有以被动防御、事后处置为主的安全体系,在智能化风险预警、动态对抗、主动防御等层面存在明显短板,亟需加快搭建适配AI时代的全域、主动、智能的新型网络安全防御体系,有效对冲外部智能化网络攻击威胁。
参考链接:
https://www.hacktron.ai/blog/hacking-openai
往期推荐
LockBit勒索组织发布声明并重建泄露网站——每周威胁情报动态第166期(2.23-2.29)
GoldFactory组织开发针对iOS系统的GoldPickaxe木马病毒——每周威胁情报动态第165期(2.9-2.22)
新APT组织APT-LY-1009针对亚美尼亚政府投递VenomRAT——每周威胁情报动态第164期(02.02-02.07)