G.O.S.S.I.P 阅读推荐 2026-08-28 CVE 仙人(工智能)
原创 G.O.S.S.I.P 2026-08-28 19:35 上海
能够复现实际的CVE的AI才是好AI
大家可能都听说过CyberGym,这个在2025年发布的漏洞数据集已经被很多人认为是“国际AI安全榜单”,因为大家都拿它来做测试(CVE版本的《5年高考3年模拟》),然后很快就被各种学霸们刷得差不多了:
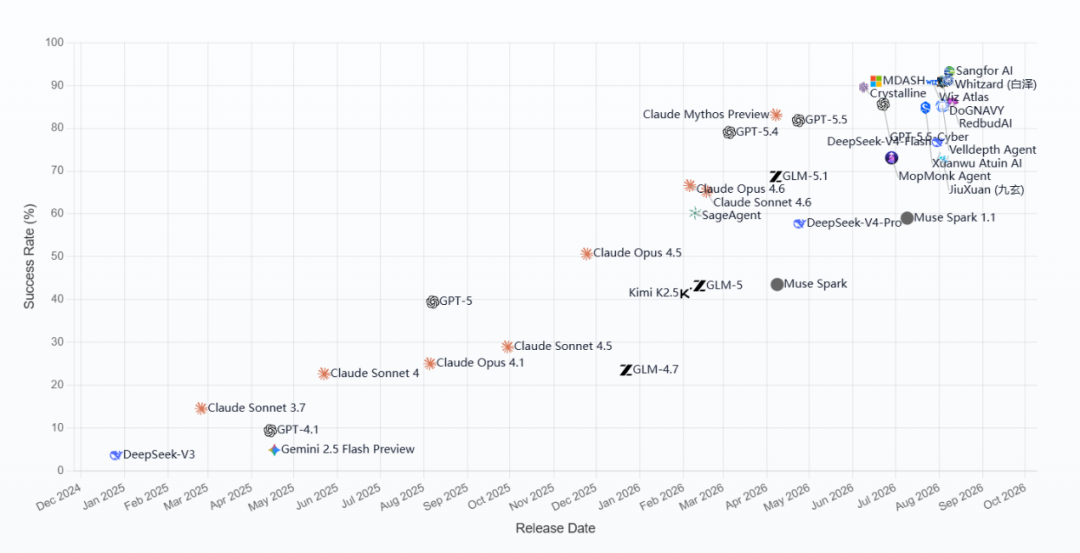
而今天我们要介绍的这篇CCS 2026论文 CVE-Genie:An LLM-Based Multi-Agent Framework for Reproducing CVEs 则并没有去加入到CyberGym赛道,而是自己开辟了一条新赛道:用实际的CVE来测试Agent系统,看到底有多少CVE能被复现:
本文作者开发了CVE-Genie系统,这是一个全自动的多agent框架(嗯现在人人都这么说),它的主要功能从论文标题就能看出来,能够根据CVE报告来重现漏洞。我们都知道现在的CVE很多都是闪烁其词,你光从漏洞描述上完全看不出来什么细节。作者对CVE-Genie是这样描述的:Given a CVE entry as input, CVE-Genie gathers the relevant resources of the CVE, automatically reconstructs the vulnerable environment, and (re)produces a verifiable exploit,这听上去就非常的人工智能是不是,只要给一个CVE编号,AI就能从零帮你复现漏洞攻击,这简直是黑客的美梦啊。
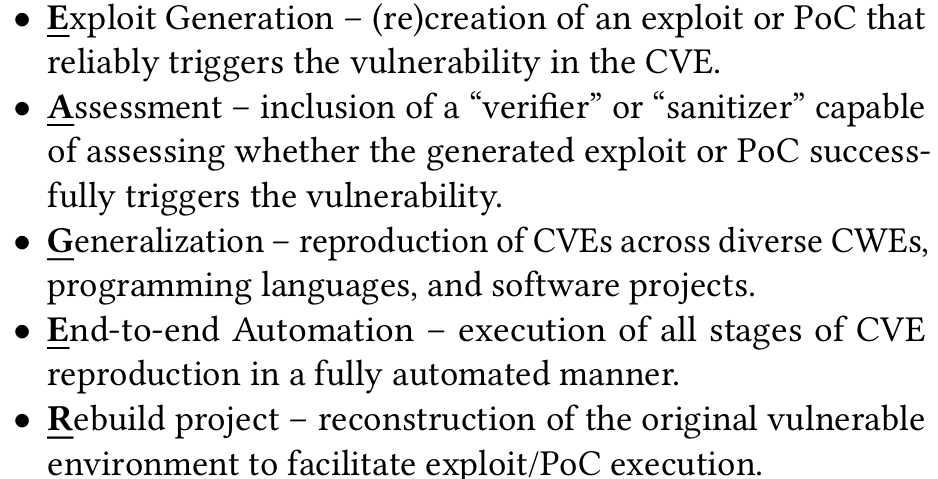
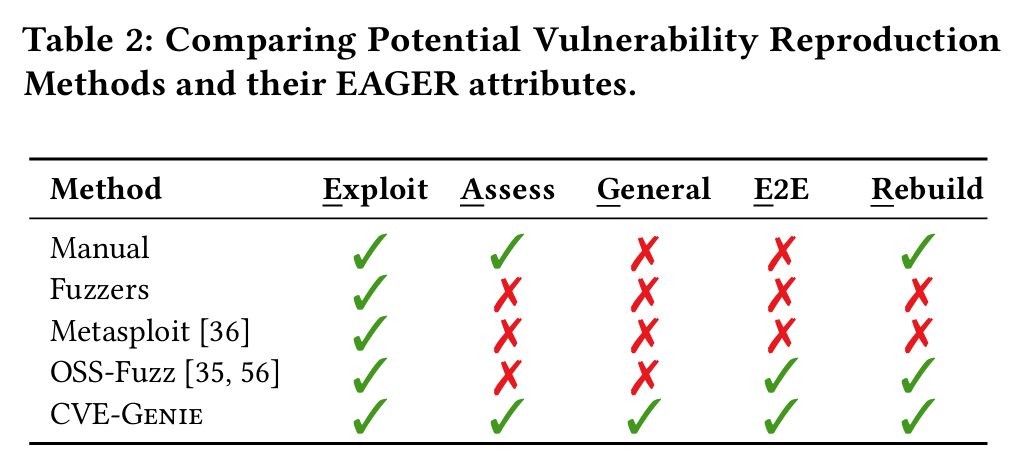
为了更为科学地评估AI的漏洞利用能力,作者在本文中首先引入了一个叫做EAGER的概念——其实是五个维度上的能力评估指标(下图):生成exploit的能力、验证exploit的能力,适应不同编程语言和漏洞类型的泛化能力、漏洞分析全过程的自动化能力、构建漏洞利用环境的能力。
作者表示,除了CVE-Genie系统,现有的工具在EAGER五维指标上都不是很行(当然这里缺乏了和其他一些AI系统的比较):
CVE-Genie系统的设计从整体上来说遵循三个重要的基本原则:
把整个漏洞分析利用和复现流程人为地拆分成不同的阶段,让LLMs分别去处理,杜绝那种让AI从头到尾自己做决策自己迭代的设计思路(虽然现在大家都觉得人不如AI聪明);
要求AI去主动寻找相关代码、补丁,确保能够精确的定位到分析对象以后再开展分析,不要在没有代码的情况下瞎猜;
对生成的exploit进行严格的验证,同时给每个环节都设计了一对agents(developer和critic)来进行“AI内卷”。
为了展示CVE-Genie系统的工作流程,作者基于CVE-2024-4340这个实际的例子来进行说明(嗯,经典的论文写作模式)。CVE-2024-4340 是一个与 Python 库 sqlparse 相关的漏洞,安全问题在于向 sqlparse.parse() 方法传递一个高度嵌套的列表时会导致递归深度超限,最终引发 Denial of Service 攻击。下面这个图是整体的流程,看起来不清楚,让我们把细节拆出来逐一介绍。
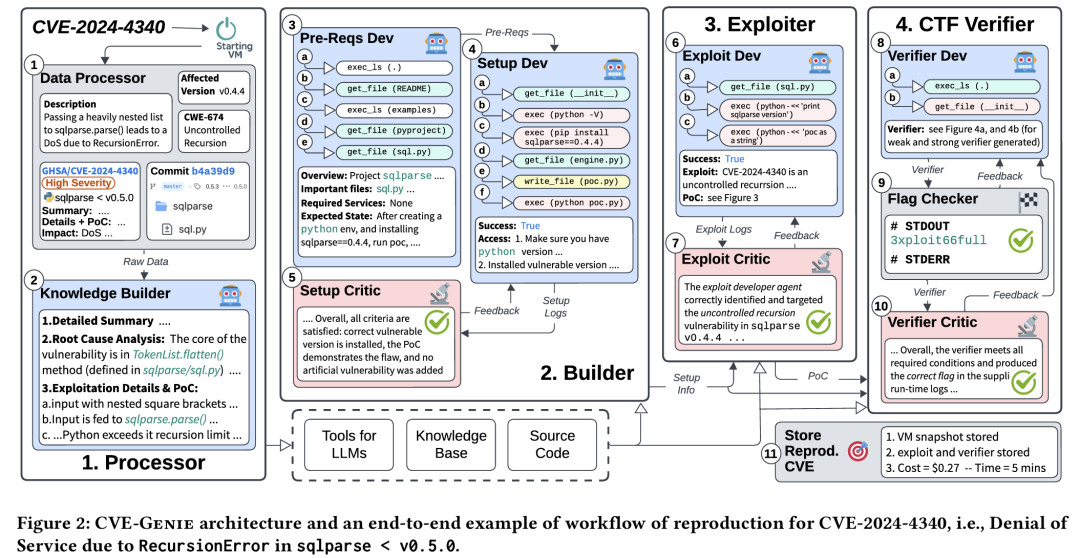
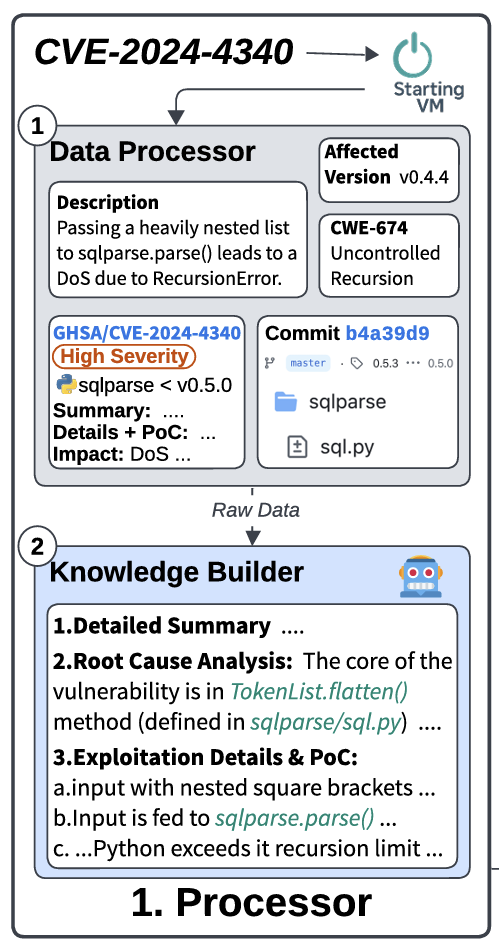
在实际的分析中,CVE-Genie系统使用的第一个组件叫做Processor,它包含了两个子模块,第一个子模块Data Processor会去收集和具体的CVE相关的描述信息和代码信息,而第二个子模块Knowledge Builder则是用来处理第一个子模块收集到的信息,对其进行整理,形成统一结构的知识(我们知道CVE的描述很多都是乱七八糟的)。
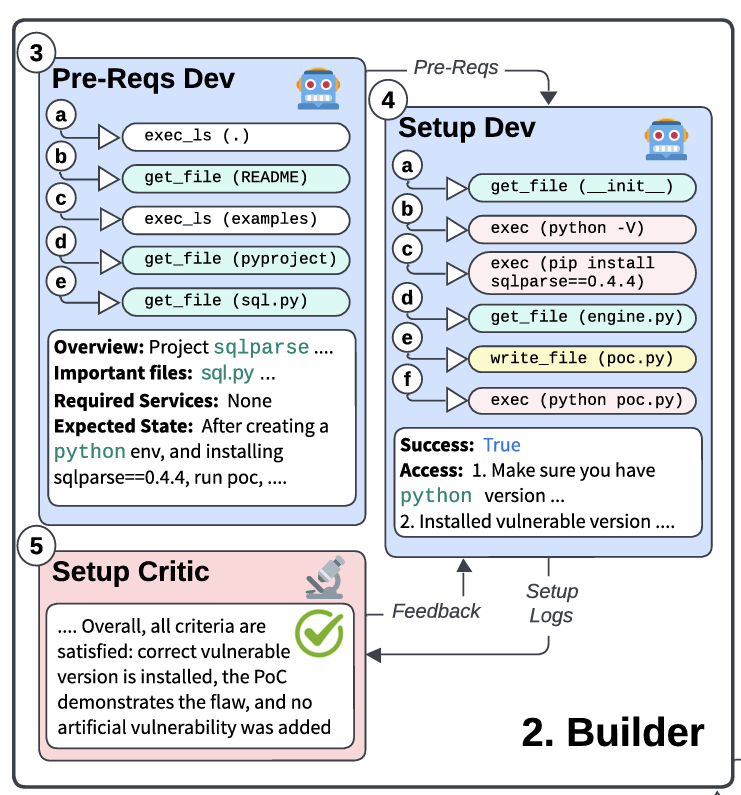
有了这些知识,CVE-Genie系统的第二个组件——Builder就要为漏洞构建一个运行环境来进行分析,这个组件包含了三个agent:Prerequisite Developer Agent、Setup Developer Agent和Setup Critic Agent,前两个agent负责干活(第一个agent分析代码,第二个agent根据分析结果来构建运行环境),最后一个agent负责“监工”:检查前面生成的环境是否满足项目的运行要求,而且会两个agent有没有作弊(比如虚假生成了一个不能用的环境)。
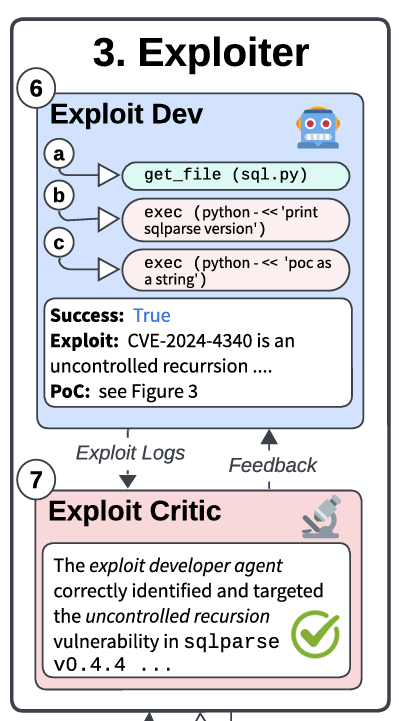
CVE-Genie系统的第三个组件叫做Exploiter,顾名思义就是生成exploit的组件了,这里面同样使用了两个agent:Exploit Developer Agent和Exploit Critic Agent,也是一个干活一个监工。注意,这里的监工并不是验证exploit是否真的触发了漏洞,只是验证它能否执行。
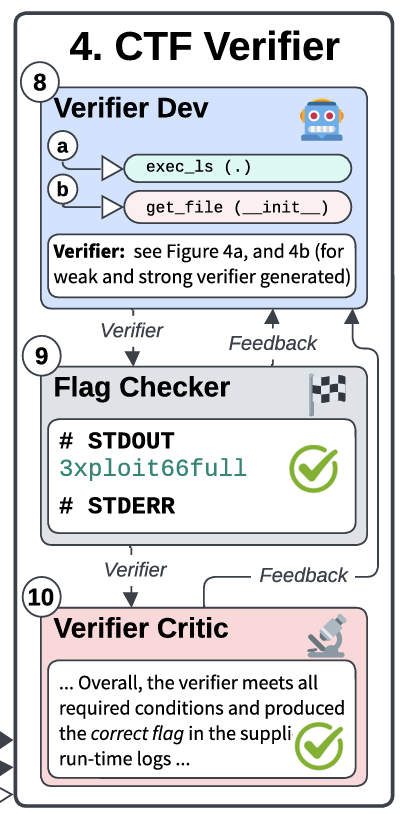
CVE-Genie系统的第四个组件让许多CTFer心酸,它的名字就叫CTF Verifier,它的工作是对Exploiter生成的exploit进行真正的验证,确认它能否触发漏洞。而这个验证的过程就采用了CTF机制:把漏洞利用转换成了一个“只有利用成功才能访问到特定的flag”的过程,然后看exploit能否获取到这个flag,是不是很有趣,这个“命题”的过程也是由一个Verifier Developer Agent来执行的。然后CTF Verifier使用一个Flag Checker子模块去检查AI的答题是否正确。当然这里还是少不了监工的存在~
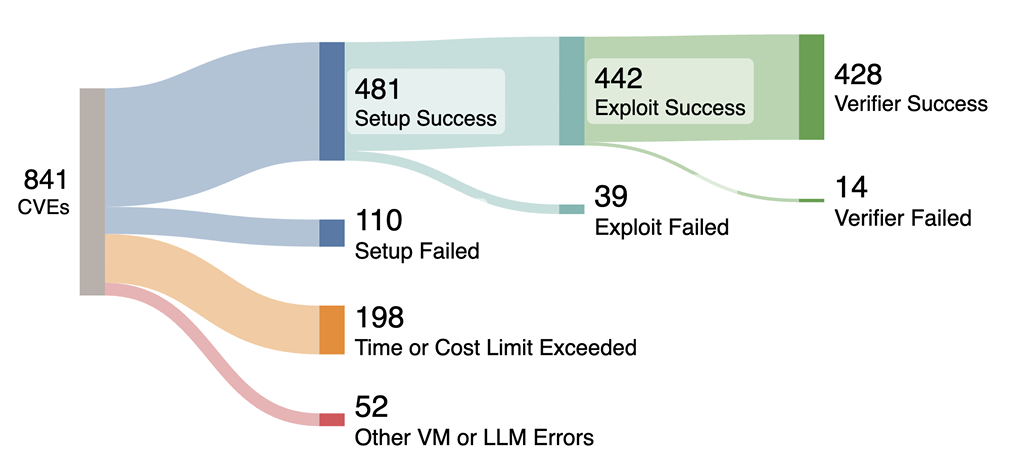
作者并没有用其他的漏洞数据集来评估CVE-Genie,而是直接建立了一个包含841个CVE的数据集,这些CVE漏洞覆盖了186类CWE和29种不同的编程语言,关联了了440个开源项目。经过验证,最后CVE-Genie系统完成了428个CVE的复现。下图展示了CVE-Genie系统除了成功利用之外,遇到的各种问题的数量:
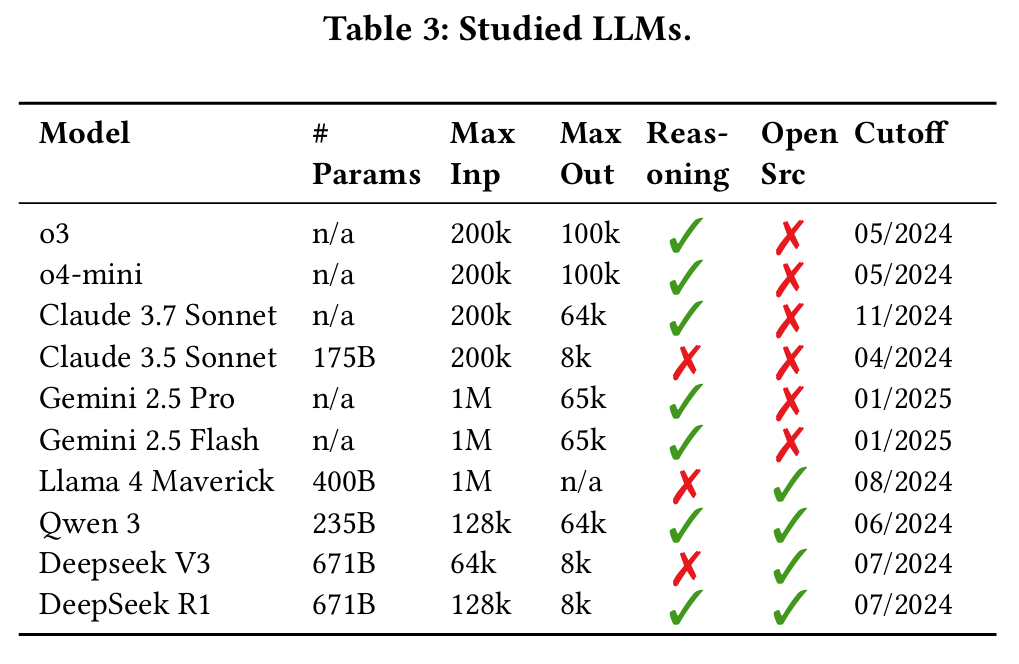
很有意思的是,这篇论文是在Anthropic推出Glasswing计划之前完成的(2025年初),作者评估的模型都是一些比较“老旧”的模型,不知道换成了最新的模型情况会怎么样?
但是(划重点)作者给出了完整的开源代码,大家完全可以把它接入最新的LLMs来看看威力如何?
论文:https://seclab.bu.edu/people/gianluca/papers/cvegenie-ccs2026.pdf
加长版:https://arxiv.org/pdf/2509.01835
数据集:https://osf.io/dcej4/overview