几亿Token白练了?微软实测:免训练滑动窗口,让线性注意力破防
原创 让你更懂AI的 2026-09-01 22:10 北京
复杂方法遇上简单基线
几千万、几亿乃至上百亿 token 的后训练投入之后,线性化模型遇到的最强对手,可能只是一个带 attention sinks 的滑动窗口。
20M、700M、20B、100B。
这是过去一些工作为了把现成 Transformer 改造成线性化模型,付出的额外训练量。
微软团队最近把这些数字放到了一张表里,然后在最后添了一行。
Sliding Window Attention: 0 token,0 个后训练阶段。
一个总窗口只有 64、保留 4 个 attention sinks 的滑动窗口注意力,不改模型权重、不做蒸馏,在六项知识与推理任务上平均恢复了原模型 99.0% 的性能。
与需要数亿 token 后训练的高性能线性化方案相比,平均性能恢复率几乎持平。到了长上下文,部分任务的准确率甚至能拉开 2 到 10 倍。
这组结果,也让一个原本看起来很顺理成章的选择多了一层疑问。
为了摆脱越来越大的 KV Cache,我们真的需要先把 Transformer 费力地“线性化”吗?
对已经训练好的大模型来说,一个无需额外后训练的滑动窗口方案,已经足以和这些后训练线性化方法正面对比。
论文标题:
Sliding-window beats linear attention
论文地址:
https://arxiv.org/abs/2608.28444
一个漏掉的强基线
全注意力的 KV Cache 会随上下文不断增长,线性注意力则把历史压缩进固定大小的循环状态,让这部分推理状态不再随序列一起膨胀。
由于从头训练成本高,近几年不少工作转而通过蒸馏、LoRA 或后训练,直接改造现成 Transformer。
论文指出,过去很多工作虽然也和 SWA 比过,但用的是不带 attention sinks 的普通版本。
一旦窗口向前滑动,开头几个 sink token 不再落在注意力范围内,性能就可能灾难性下降。这样的比较,很容易低估滑动窗口本身的能力。
本文采用 SWA(w,4)。总窗口为
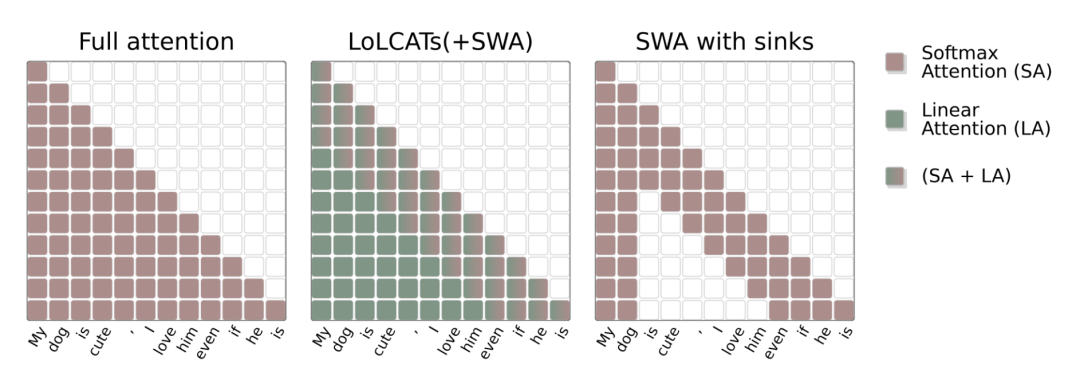
〓全注意力、线性注意力+SWA 与 SWA+sinks 的注意力范围对比
0 Token vs. 千亿 Token
这里的对手也不全是纯线性注意力,还包括 LoLCATs、Liger-GLA 这类线性注意力 + SWA 的线性化方案。
论文首页汇总的后训练量从 20M、40M 一路跨到数亿、数十 B,SUPRA 一栏甚至达到 100B。SWA(64,4) 则是 0 token、0 个后训练阶段。
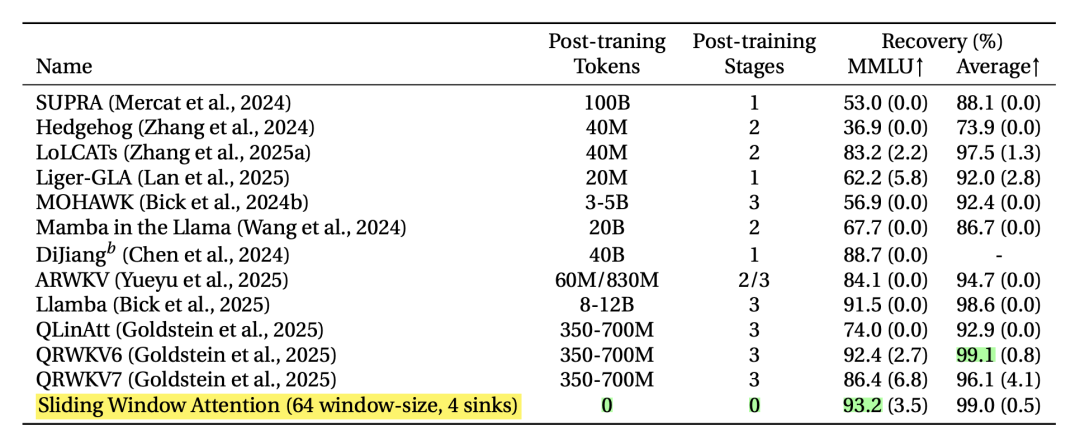
〓不同方案的后训练量与性能恢复率
这里的性能恢复率以各自的原始全注意力模型为基准,可以直接看出不同方案还保留了多少原模型能力。
SWA 在六项任务上的平均恢复率达到 99.0%,与需要 350M–700M token 后训练的 QRWKV6 的 99.1% 几乎持平。
MMLU 上,SWA 的恢复率为 93.2%,还略高于 QRWKV6 的 92.4%。
主实验覆盖 Phi、Mistral、Llama、Qwen、QwQ 等多个模型系列,参数规模从 1.3B 一直延伸到数十 B。
11 组比较里,SWA 有 9 组拿到除原始全注意力模型外的最高平均成绩。剩下两组差距也不大,分别只有 0.1 分和 0.7 分。
作者还在 Qwen3-8B 和两款 Phi-4 推理模型上自行做了一组线性化实验。
以 Qwen3-8B 为例,SWA 平均 71.6,而经过约 100M token 两阶段蒸馏的 Gated DeltaNet、GLA 和 QRWKV6 仍停留在 50 多分,两款 Phi-4 上也呈现类似趋势。
长上下文差距反而更大
线性注意力在推理时持续更新固定大小的状态:
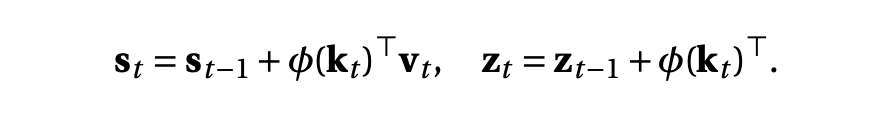
它的优势是状态大小不随序列增长,难点则是持续写入新信息时,还要决定哪些历史保留、哪些覆盖。
SWA 每层只能直接看到局部窗口,但窗口为 64,并不意味着整个模型只能利用最近 64 个 token。
论文指出,经过
在 Llama 3.1 8B 的 S-NIAH 测试中,作者设置了 128、256、512 三种窗口,上下文最长到 4K。
所有窗口和上下文长度下,SWA 在三个任务上都不低于 LoLCATs 和 Liger-GLA。
比如在窗口为 128、上下文长度为 4K 的 S-NIAH-3 上,SWA 准确率达到 17.2,LoLCATs 只有 1.6,相差约 10.8 倍。
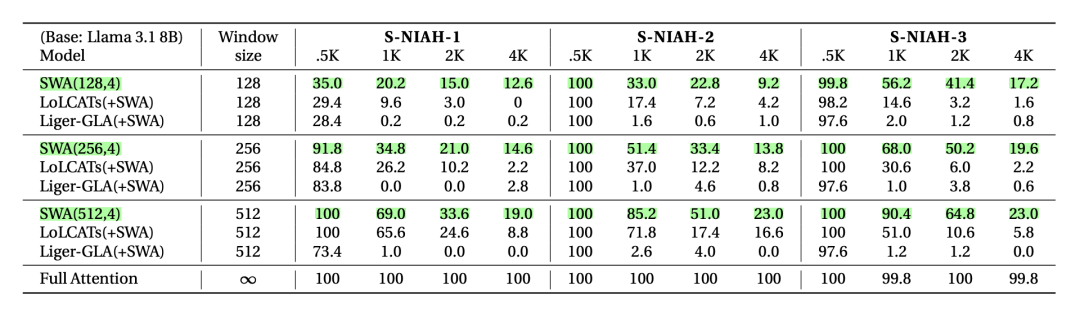
〓不同窗口和上下文长度下的 S-NIAH 准确率
BABILong 的变化更明显。短上下文时 LoLCATs 还略占优势,到了 2K 后 SWA 开始反超。4K 时,两者已经拉开到 15 对 3,而全注意力仍有 60。
随着上下文变长,SWA 与 LoLCATs 之间的差距被明显拉开。
小窗口也有工程优势
作者还把上下文长度从 128 一直扩展到 256K。
全注意力的 KV Cache 会持续增长,超过约 1K 后,解码吞吐开始明显下降。SWA 的 KV Cache 达到窗口上限后,状态内存保持固定,吞吐也基本稳定。
在这套测试中,SWA 的吞吐最高,其中窗口为 64 时速度最快,状态内存也最低。窗口越大,SWA 的状态内存开销也会随之增加,SWA-512 已高于线性注意力和 LoLCATs。
论文给出的整体结论是,当窗口小于 512 时,SWA 的状态内存与线性注意力相当或更低,同时速度更快。
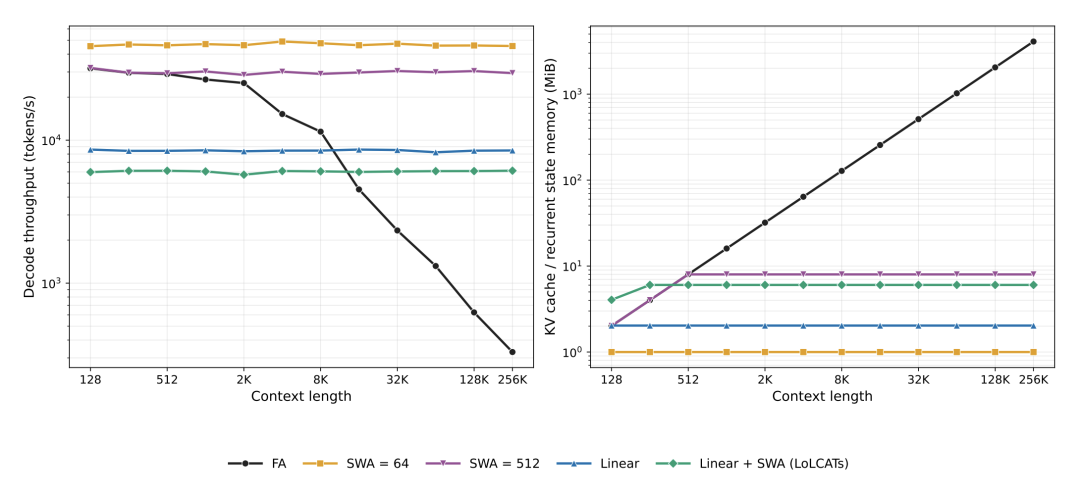
〓不同注意力机制的解码吞吐与推理状态内存变化
这组测速使用 4 层 Transformer、batch size 1 和 RTX PRO 6000 Blackwell Max-Q。
全注意力和 SWA 使用 FlashAttention,线性注意力使用 ThunderKittens,LoLCATs 则使用 ThunderKittens 提供的融合 kernel。
一个简单得过分的答案
SWA 和 attention sinks 都不是新概念。
过去的线性化工作却很少直接和带 sinks 的 SWA 比,这篇论文把两者放到了同一张比较表里:一边无需额外后训练,另一边则投入了数千万、数亿甚至更多 token 做线性化。
论文最后直接建议,如果目标是在固定、较小的推理状态内存下运行现成模型,可以优先尝试带 attention sinks 的 SWA,再考虑投入大量 token 做后训练线性化。
SWA + attention sinks,已经成了后续线性化工作很难绕开的 baseline。
更多阅读
#投 稿 通 道#
让你的文字被更多人看到
如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。
总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。
PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。
📝 稿件基本要求:
• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注
• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题
• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算
📬 投稿通道:
• 投稿邮箱:hr@paperweekly.site
• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者
• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿
△长按添加PaperWeekly小编
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·