ACM MM 2026 | 视频的声音,不只自动生成,还能按意图控制
原创 让你更懂AI的 2026-09-09 10:07 北京
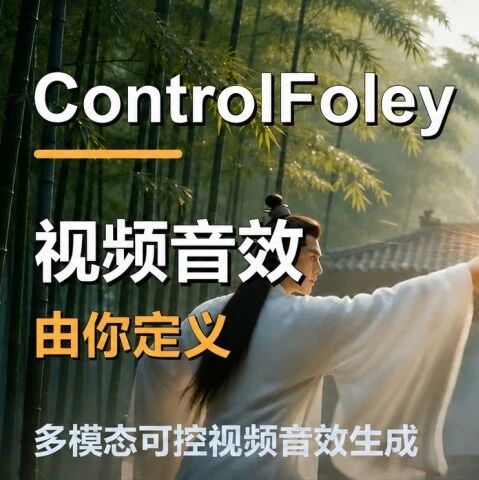
ControlFoley 让视频动作、文本提示和参考音频共同参与声音生成,官方 ComfyUI 工作流与多种体验入口已上线。
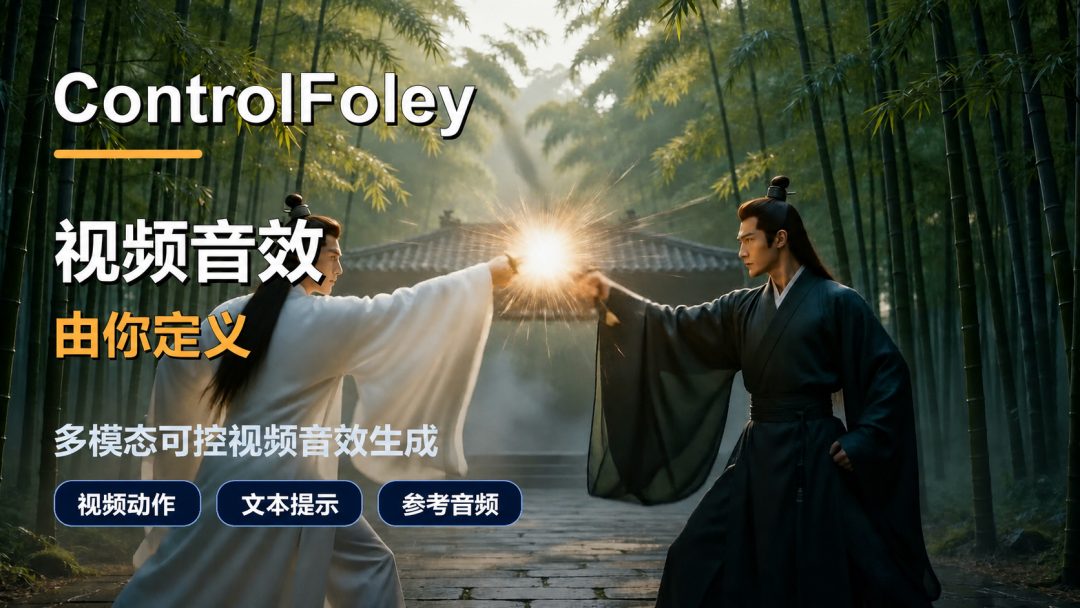
〓 图1:ControlFoley 多模态可控视频音效生成。
视频有了声音,为什么还不够?
无声视频、实拍空镜、短剧动画、AI 生成视频和游戏广告都可能遇到同一个问题:画面已经有了,但声音仍卡在最后一步。要么没有收音,要么现场收音不可用,要么自动配出的音效和创作意图差一截。
多数视频到音频模型只会根据画面推断声音,这已经能让视频“有声”,但在真实创作里,用户更常问的是:如果我不想要这个声音,能不能告诉模型换一种?
ControlFoley 关注的正是这一步。它不是只把画面翻译成声音,而是把视频动作、文本提示和参考音频都变成可使用的控制条件,让生成音效既跟得上画面,又能贴近创作者想要的声音内容和风格。
不只自动补音,还能按意图控制声音
无声或收音不理想的视频:根据动作和画面事件补出同步的碰撞声、运动声和环境声。
AI 视频、漫剧和动画:为奔跑、打斗、魔法、转场等画面生成更贴合的场景音效。
游戏和广告创意:用文本提示指定声音语义,或用参考音频迁移音色和风格。
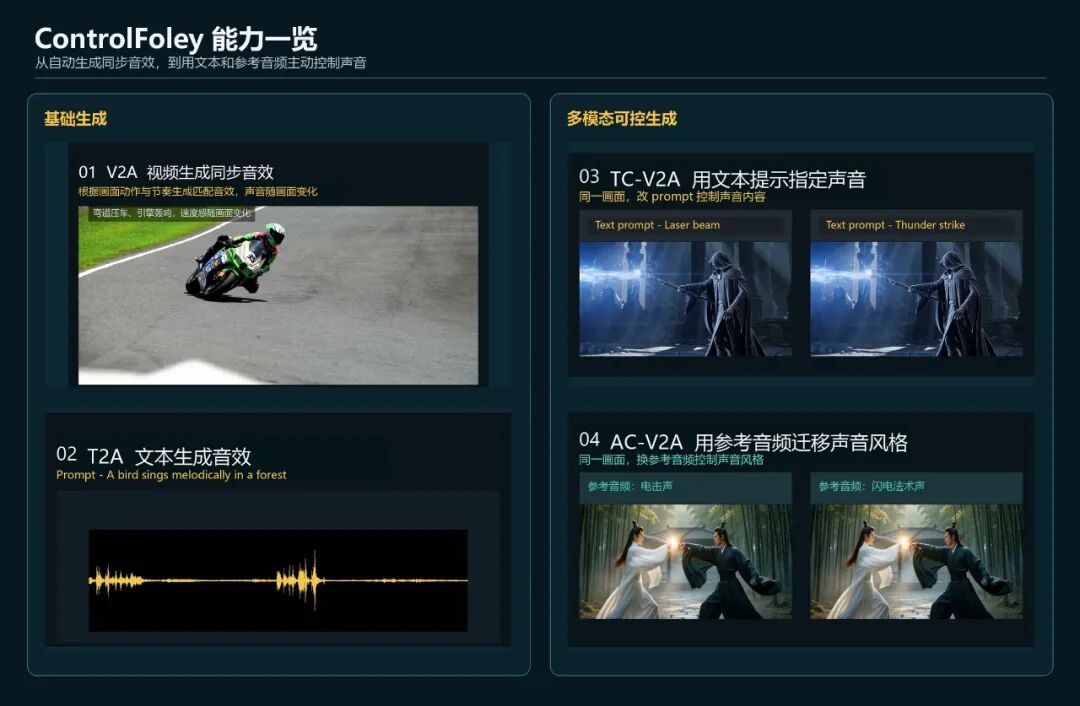
〓 图2:ControlFoley 同时支持基础生成与多模态可控生成。
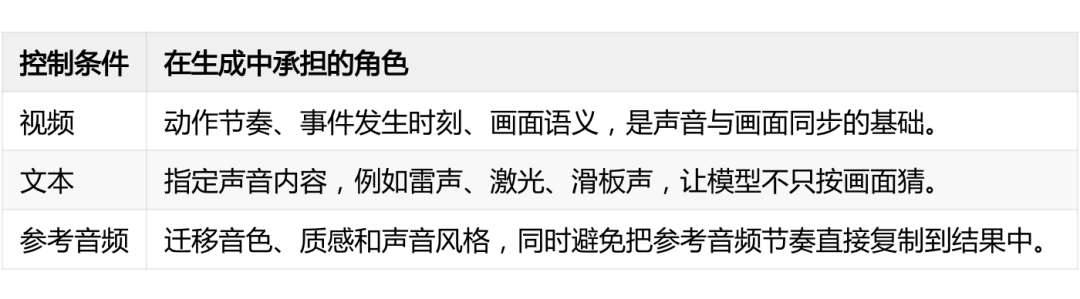
〓 表1:ControlFoley 将视频、文本和参考音频拆成不同控制角色。
多模态控制核心:让视频负责时间,让条件负责意图
在多模态控制视频音效生成中,最难的不是简单拼接条件,而是让不同条件各司其职。视频应该主要约束动作节奏和发声时刻;文本应该补充或改写声音语义;参考音频应该提供音色和质感,而不是把自己的时间节奏也复制过去。
ControlFoley 在统一框架中覆盖多种使用方式:既可以只根据视频生成同步音效,也可以加入文本提示细化声音语义、在文本与画面冲突时按提示词改写声音,或借助参考音频迁移音色与质感;此外还支持脱离视频、直接通过文本生成音效。
围绕这些能力,模型采用三项关键设计:联合视觉编码增强视觉语义与时序表征,并缓解文本控制中的文本视频语义冲突;参考音频解耦保留音色、质感等有效控制信息,同时抑制不应复制的时间结构;统一生成与鲁棒训练则用于兼容不同模态组合和多类任务。
换句话说,ControlFoley 让视频负责描述发生了什么以及何时发声,让文本提示或参考音频负责定义声音内容与风格,再在生成阶段将这些信息对齐起来。
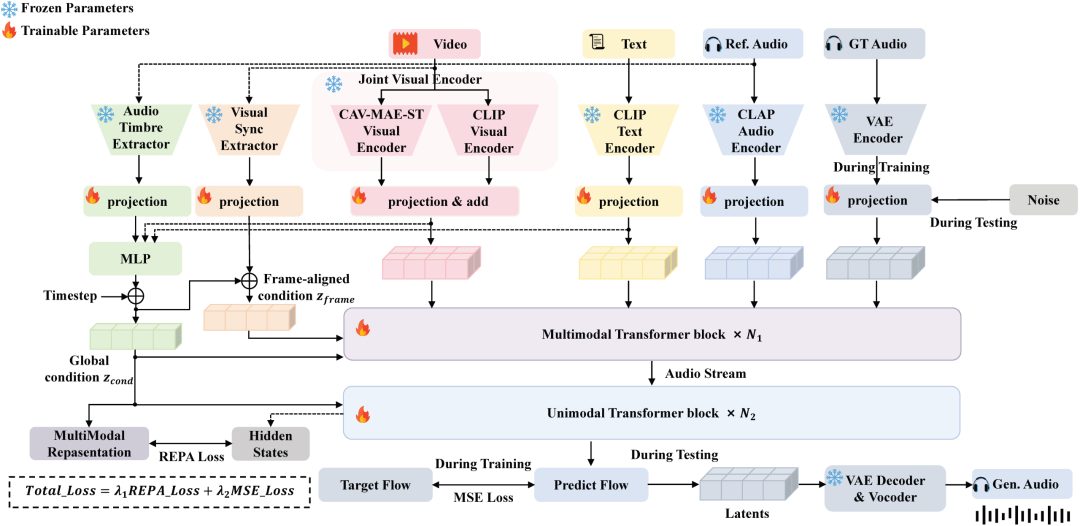
〓 图3:ControlFoley 多任务统一生成架构。
具体而言,ControlFoley 围绕三类相互并列的关键问题展开设计:一是增强视频特征的视觉语义与时序信息,并缓解文本控制生成中的模态冲突;二是解耦参考音频中的有效控制信息与不应迁移的时间结构;三是提升多模态控制任务之间的兼容性,使不同条件组合能够由同一模型稳定处理。
第一项是联合视觉编码与视文冲突处理。CLIP 提取与文本语义对齐的视觉信息,团队自研的时空音视频编码器 CAV-MAE-ST 强调动作变化和音画时序关系;二者共同增强视觉语义与时序表征。
针对文本控制生成中的视文语义冲突,模型进一步抑制视觉条件对文本指令的过度主导,使声音既贴合画面时序,也能按照文本意图改变语义。
第二项是参考音频有效信息与无关信息解耦。参考音频经过时间-音色解耦处理:模型保留音色、质感等有效控制信息,同时抑制节奏、发生时刻等不应复制的时间结构,避免把参考片段的事件节奏直接照搬到结果中。
第三项是多模态任务的统一生成与兼容训练。视频、文本和音色条件进入多模态 Transformer,并通过随机模态丢弃和 REPA 表征对齐共同训练,使同一套模型兼容基础视频配音、文本辅助、文本控制、参考音频控制和纯文本音效生成,在多种任务组合中均保持稳定。
性能评估:既要听从控制,也要保持同步
对创作者来说,可控并不意味着牺牲同步。如果文本要求“雷击声”,声音仍要跟随画面动作出现;如果参考音频提供“金属撞击”的质感,输出也不能直接照搬参考音频的撞击节奏。
ControlFoley 的结果评估也围绕这几类体验展开:声音是否符合语义、是否贴合画面、是否和动作同步,以及音频质量是否稳定。
其中,CLAP 相关指标用于衡量音频与文本描述之间的语义匹配;DeSync 关注音画时间偏移,数值越低说明同步越好;IS 侧重生成音频质量。
参考音频控制任务还额外比较音色相似度,用来观察模型是否能迁移参考声音的质感,而不是简单复制参考片段。
在基础视频配音评测中,ControlFoley 在 VGGSound-Test、Kling-Audio-Eval 和 MovieGen-Audio-Bench 三个测试集上,相对最佳开源基线同时提升语义对齐、音画同步和音频质量。
进一步看可控任务,它的优势在于同时保持“可控性”和“同步性”:当文本和视频出现冲突时,模型仍能更稳定地跟随文本意图;使用参考音频时,则能迁移声音风格,同时避免把参考音频的时间节奏照搬到输出里。
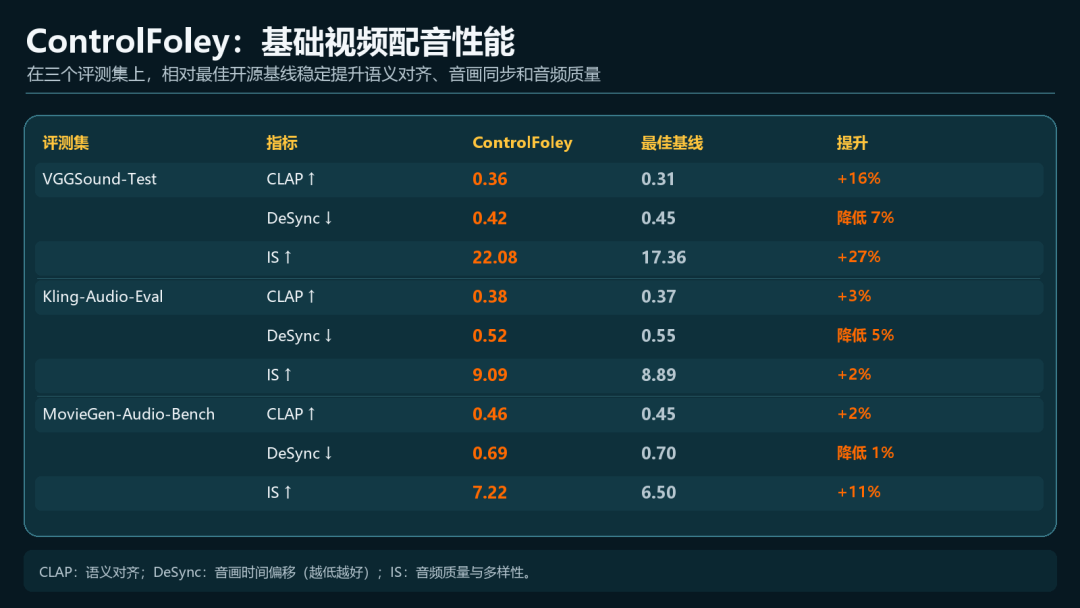
〓 图4:基础视频配音性能。ControlFoley 在三个评测集上,相对最佳开源基线同时提升语义对齐、音画同步和音频质量。
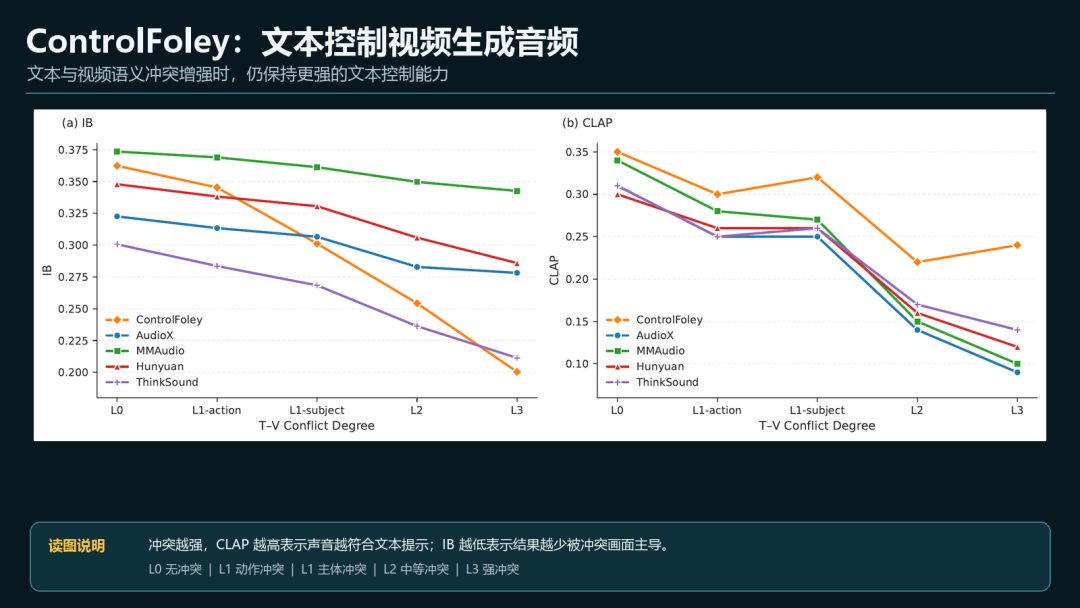
〓 图5:文本控制视频配音性能。随着文本与视频冲突增强,ControlFoley 仍保持更强的文本-音频对齐,并减少视频对声音语义的主导。
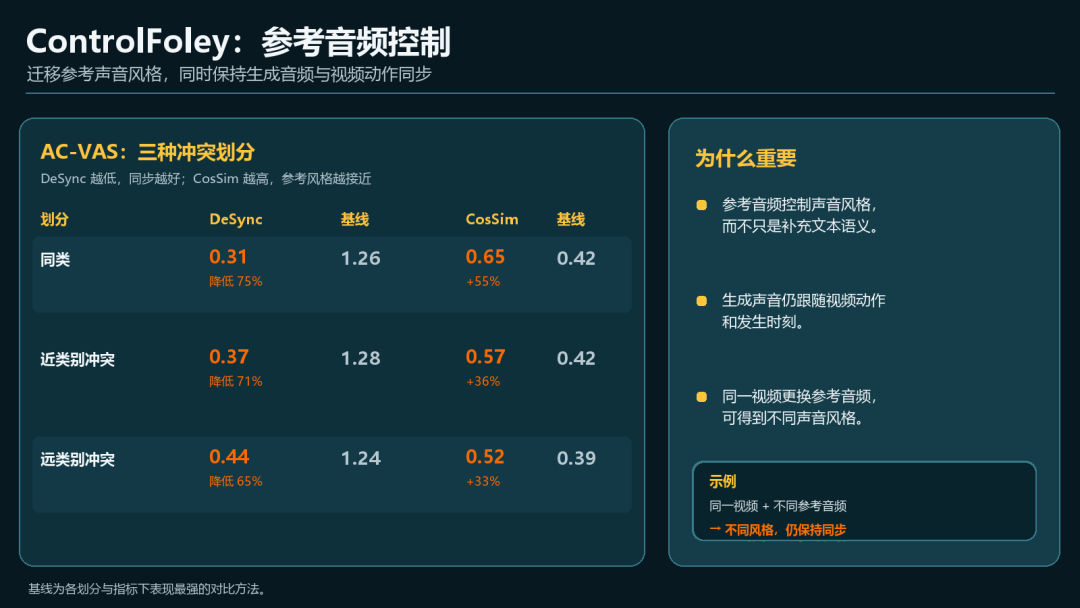
〓 图6:参考音频控制视频配音性能。参考音频可以迁移声音风格,同时保持生成音频与视频动作同步。
开源与体验:从在线试用到本地部署
ControlFoley 已被 ACM MM 2026 接收,论文、代码和模型权重均已开放。针对不同用户和使用场景,项目提供了多种体验与部署方式:
零部署在线体验:通过项目主页的在线 Demo 或 Hugging Face Space,直接上传视频并尝试文本、参考音频等控制方式;
创作者工作流:通过官方 ComfyUI 节点和全任务工作流,在可视化界面中完成视频配音、文本控制、参考音频控制和文本生成音频;
智能体快捷调用:通过 Skill 将 ControlFoley 接入智能体工作流;
开发者本地部署:使用 GitHub 与 Hugging Face 上的官方 Python 实现,或通过社区 audio.cpp 集成使用原生 C++ 推理和 GGUF 模型。
这些入口覆盖了从快速体验、可视化创作到研究复现和本地部署的不同需求,用户可以根据设备条件和使用习惯选择合适方式。
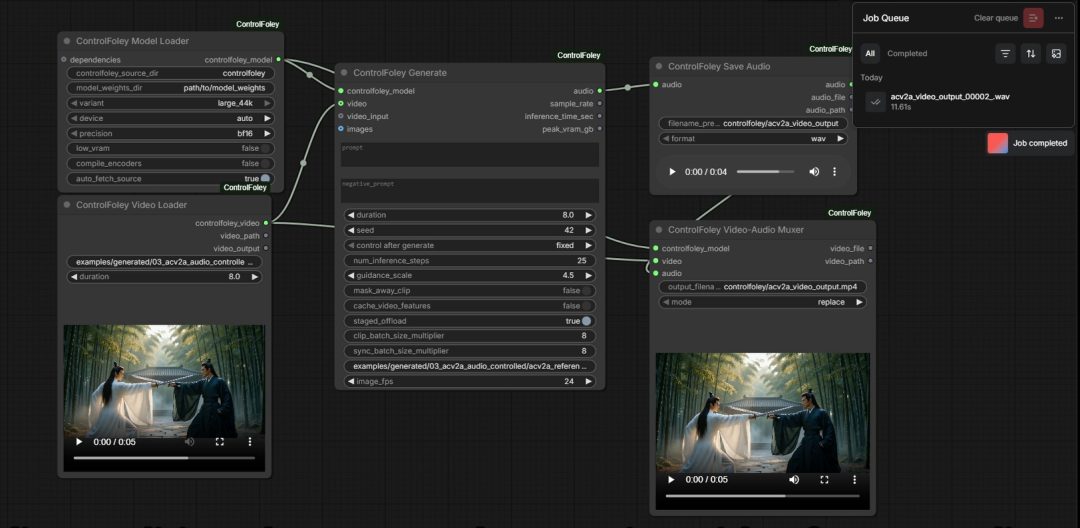
〓 图7:ControlFoley 官方 ComfyUI 工作流示例。
GitHub Repo:
https://github.com/xiaomi-research/controlfoley
项目主页:
https://yjx-research.github.io/ControlFoley_web_page/
技术报告:
https://arxiv.org/abs/2604.15086
ComfyUI Registry:
https://registry.comfy.org/publishers/yjx-research/nodes/ComfyUI-ControlFoley
Hugging Face Model:
https://huggingface.co/YJX-Xiaomi/ControlFoley
Hugging Face Space:
https://huggingface.co/spaces/YJX-Xiaomi/controlfoley
ControlFoley GGUF:
https://huggingface.co/audio-cpp/audio.cpp-gguf/tree/main/ControlFoley-GGUF
媒体素材来源说明:音频来自 Pixabay;视频来自 VGGSound、Pexels 和即梦生成内容。
更多阅读
#投 稿 通 道#
让你的文字被更多人看到
如何才能让更多的优质内容以更短路径到达读者群体,缩短读者寻找优质内容的成本呢?答案就是:你不认识的人。
总有一些你不认识的人,知道你想知道的东西。PaperWeekly 或许可以成为一座桥梁,促使不同背景、不同方向的学者和学术灵感相互碰撞,迸发出更多的可能性。
PaperWeekly 鼓励高校实验室或个人,在我们的平台上分享各类优质内容,可以是最新论文解读,也可以是学术热点剖析、科研心得或竞赛经验讲解等。我们的目的只有一个,让知识真正流动起来。
📝 稿件基本要求:
• 文章确系个人原创作品,未曾在公开渠道发表,如为其他平台已发表或待发表的文章,请明确标注
• 稿件建议以 markdown 格式撰写,文中配图以附件形式发送,要求图片清晰,无版权问题
• PaperWeekly 尊重原作者署名权,并将为每篇被采纳的原创首发稿件,提供业内具有竞争力稿酬,具体依据文章阅读量和文章质量阶梯制结算
📬 投稿通道:
• 投稿邮箱:hr@paperweekly.site
• 来稿请备注即时联系方式(微信),以便我们在稿件选用的第一时间联系作者
• 您也可以直接添加小编微信(pwbot02)快速投稿,备注:姓名-投稿
△长按添加PaperWeekly小编
🔍
现在,在「知乎」也能找到我们了
进入知乎首页搜索「PaperWeekly」
点击「关注」订阅我们的专栏吧
·