单线程CPU破局神经图像编解码,126ms解码1080p!微软亚研院&中科大开源极轻量图像编解码器PULSE
原创 CV君 2026-09-18 23:52 江苏
单核极速解码新范式
在神经图像压缩(LIC)领域,高压缩比与低算力消耗向来犹如“鱼与熊掌不可兼得”。近年学术界的前沿架构虽屡破率失真极限,但接收端动辄数百 kMAC/pixel 的庞大算力开销,使得解码在无独立加速卡的边缘端与普通 CPU 上举步维艰,单张高分辨率图像耗时动辄数秒甚至数十秒,沦为“实验室里的奇迹”。
为彻底打破这一工业落地桎梏,微软亚洲研究院与中国科学技术大学等机构重磅推出了超轻量端到端图像编解码系统 PULSE,首次将实用神经编解码推进到苛刻的单核 CPU 战场。
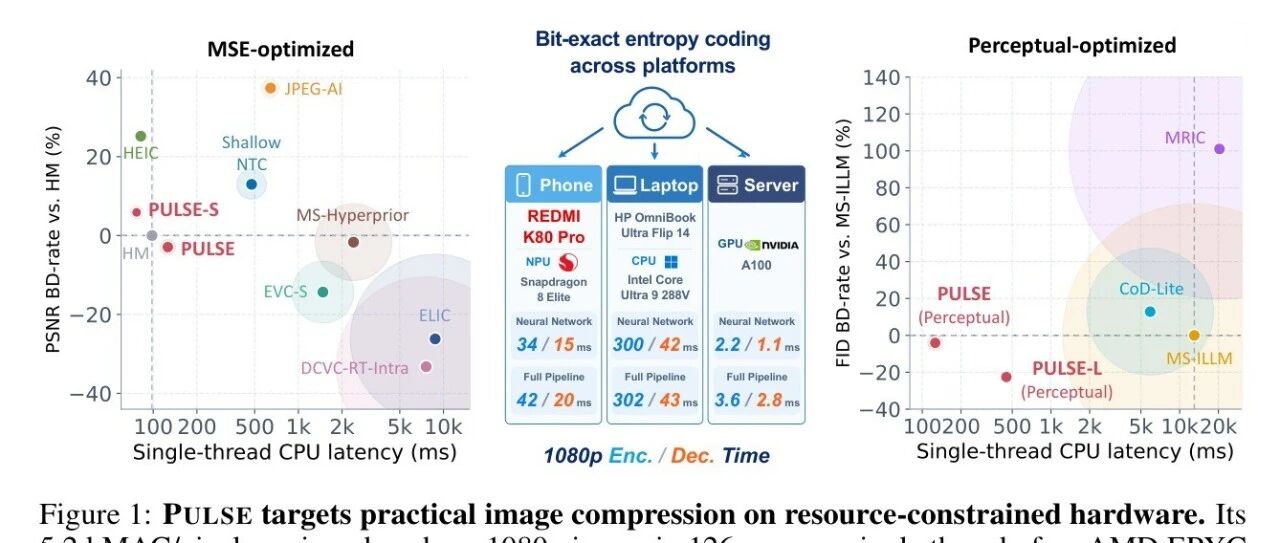
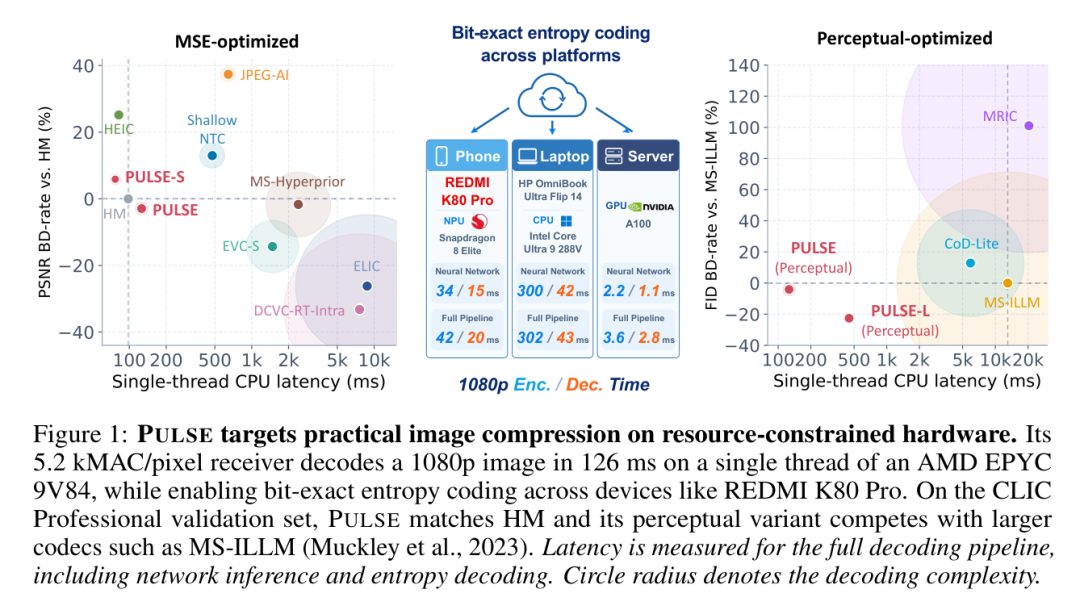
PULSE 的接收端算力开销被极限压缩至 5.2 kMAC/pixel(参数量仅 1.7 M)。在完全不依赖 GPU/NPU 的普通单线程 CPU(AMD EPYC 9V84)压力测试下,PULSE 解码 1080p 图像全流程仅需 126 ms,在专业基准 CLIC 上以快近 9 倍的编码速度实现了战平传统 HEVC 参考软件 HM-16.25 的率失真表现(-2.9% BD-rate);其轻量款 PULSE-S 更是将解码耗时进一步杀入 77 ms,单核软解速度超越传统 HEIC 解码器(libde265)。而在感知调优下,其旗舰版 PULSE-L 更以 30 倍以上的单核解码速度,在 FID 评价上反超参数量达 1.7 亿的前沿标杆 MS-ILLM 达 22.5%,展现出颠覆性的落地潜能。
目前,PULSE 的相关代码与预训练权重已在 GitHub 开源。
背景与动机:轻量端到端编解码的三大拦路虎
神经图像编解码系统若要真正在工业端侧及边缘计算中落地,必须攻克三大工程与算法矛盾:
计算预算极度收紧下的性能骤降:主流超分辨率式解码器在全分辨率特征图上堆叠卷积,计算量极大。当接收端复杂度被强行压制在 5 kMAC/pixel 这一极低区间时,每一个算子、每一个通道的冗余都会被剧烈放大,传统手工设计或暴力神经架构搜索(NAS)难以在可承受的搜索成本内找到最优结构。
跨设备浮点扰动引发的位流失步:算术熵编码(Arithmetic Coding)极度依赖概率累积分布函数(Cumulative Distribution Function, CDF)的绝对精确同步。由于手机、电脑、服务器等不同平台的底层浮点运算(Floating-Point Round-Off)存在不可避免的细微差异,概率表预测一旦发生 1 个离散阶跃的偏移,后续所有解码位流将彻底崩溃。既往方案多采用“全熵模型整数化”,但在极低计算预算下,这会在 CPU 上引入不可忽视的延迟和显著的量化率失真损失。
极低位率与感知失真的平衡:在计算容量被大幅削减后,仅靠均方误差(Mean Squared Error, MSE)优化的微型模型极易输出模糊画面,而生成式高保真纹理与低延迟推理往往存在天然冲突。
核心方法详解:软硬件协同的精细化重构
PULSE 针对上述难点,从模型拓扑、跨平台熵控制通路、人机协同架构设计三方面进行了系统性重构。
1. 非对称并行拓扑与渲染式解码
PULSE 采用了非对称且兼顾高并行度的架构设计:
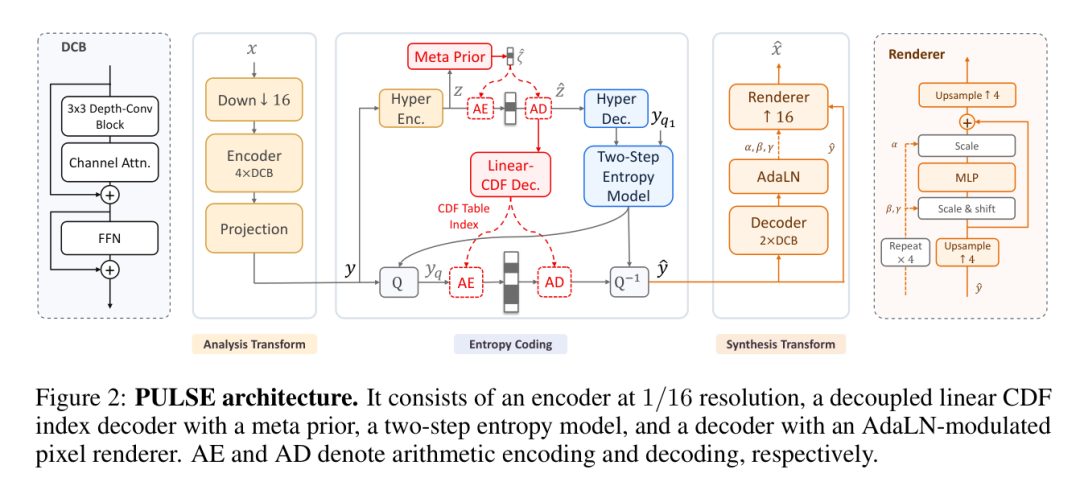
输入与分析变换(Analysis Transform):对于输入图像 ,编码端采用步长为 16 的 Patch Embedding 快速下采样至 空间分辨率,再通过 4 个带有通道注意力机制(Channel Attention)的深度卷积块(Depthwise Convolution Block, DCB)以及 投影,输出主潜变量 。编码端整体算力控制在约 45 kMAC/pixel。
- 双步棋盘格熵模型(Two-Step Entropy Model):超编码器(Hyper Encoder)将主潜变量进一步降采样至 得到超潜变量 。量化后的 由超解码器生成特征 。针对主潜变量 ,模型采用空间-通道双步棋盘格(Checkerboard)划分为 与 两个互补掩码:第一步由 预测量化步长 与均值 ;第二步则结合已解码的前半部分 和 联合更新后半部分的均值 :值得注意的是,PULSE 将尺度(Scale)预测完全从非线性均值生成路径中解耦出来,两步解码均直接共享由 映射出的尺度坐标,大幅简化了熵模型的计算依赖。
解耦式像素渲染合成(Synthesis Transform):接收端仅使用两个低分辨率 DCB 提取空间特征,同时通过内容分支将 上采样 4 倍至 分辨率的渲染网格。低分辨率分支生成的自适应层归一化(Adaptive Layer Normalization, AdaLN)参数 负责调制该网格上的逐点多层感知机(Pointwise MLP),最终经由像素洗牌(PixelShuffle)一次性还原为原始分辨率图像 。计算密集型的主体网络在低分辨率运行,全分辨率仅保留无参数的通道重排,显著降低了乘加开销。
2. 整型线性 CDF 解码与 Meta Prior
为在不破坏跨平台位流同步的前提下最大化压榨解码速度,PULSE 抛弃了传统“整数化整个超先验网络”的高开销路径,提出了基于整数线性投影的直接 CDF 索引预测机制。
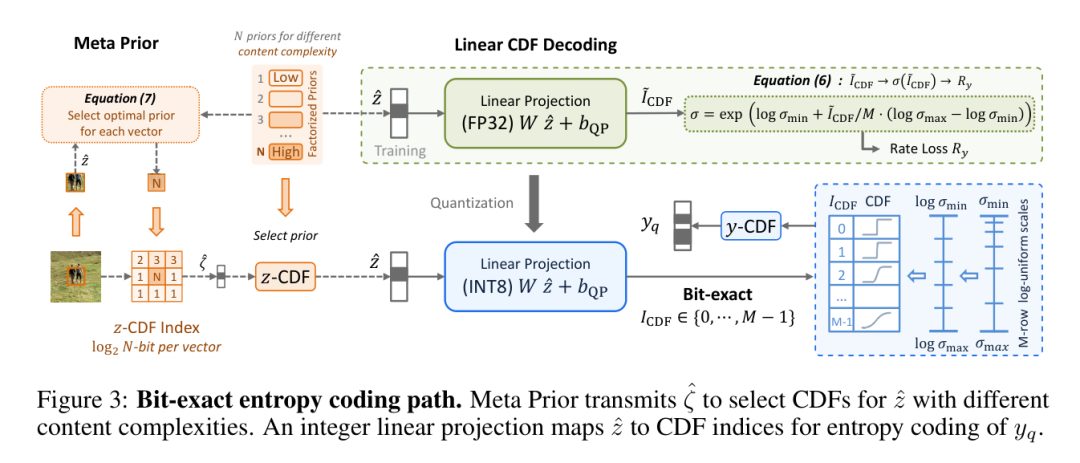
- 线性 CDF 索引直出:在经典高斯熵模型中,先验网络往往预测高斯分布标准差 ,再转换为对数域并查找 CDF 表,这一转换在 CPU 端执行需耗费较多算力。PULSE 发现,超潜变量 与离散高斯 CDF 表索引之间存在近似线性关系。模型直接使用单层整型线性投影预测共享对数均匀高斯 CDF 表的行坐标 :在训练期间通过可微分公式映射回连续方差;而在推理部署阶段,CPU 仅需执行单层 INT8 矩阵乘法并取整(UINT8),彻底免除运行时的指数和对数计算。在 1080p 分辨率下,单线程 CPU 耗时从传统超先验整型解码器的 29.2 ms 锐减至 1.6 ms。
Meta Prior 空间自适应先验库:线性 CDF 简化在平坦图像或纹理稀疏区域会导致超潜变量 码字占比飙升。PULSE 引入了 Meta Prior 机制:在主干模型训练完成后,将其因式分解先验扩展为包含 个先验模型的先验库(Prior Bank),通过期望最大化(EM)算法在不同空间位置自适应选择与内容复杂度最契合的先验分布。每个空间网格仅需附加 位的固定元索引,解码端无需任何额外神经网络计算,直接查表即可实现概率分布校正,在平坦子集上实现了 9.8% 的码率节省。
在具体部署时,该控制流模块可直接交给 CPU 保证全平台位流绝对一致(Bit-exact),其余高并行模块则放行至 GPU 或 NPU 加速运行。
3. 基于启发式探针的人机协同演化(Agentic Evolution)
在 5 kMAC/pixel 这类超紧凑算力区间内,微观算子和通道参数配置呈现非线性敏感性。研究人员引入了大语言模型(LLM)协同的架构演进框架,通过设计两项无监督启发式探针评估网络瓶颈:
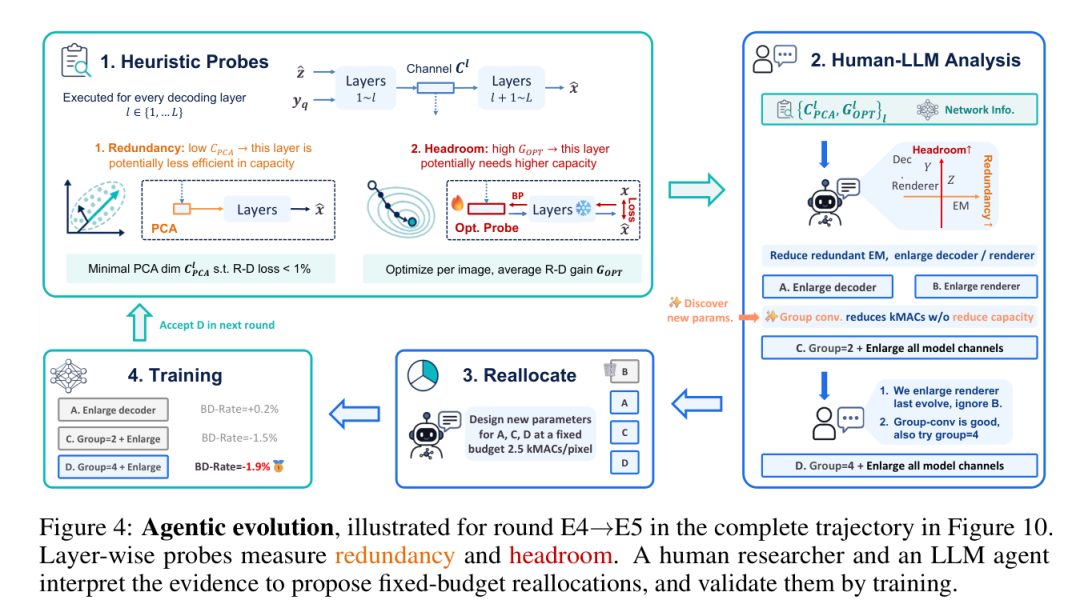
冗余度探针(Redundancy Probe):对某一层潜变量进行全局 PCA 降维重构,计算在率失真损失上升 时的最小保留维度 。比值 越小,说明该层通道利用率偏低,存在可压缩冗余。
上界空间探针(Headroom Probe):冻结下游网络,在单张图像上独立反向优化该层特征,测定下游模块能获取的理论最高重建增益 。增益越大,代表下游结构亟需更具表达力的输入表征。
LLM 智能体读取探针数据、计算图与严格算力账本后,提出通道再分配或引入新算子机制(例如将密集卷积替换为分组卷积、调节渲染网格分辨率);人类专家审核计算合理性并下发全流程训练。经过 7 轮循环、仅耗费 22 次端到端训练,PULSE 相比初始基线模型实现了 -10.2% 的 BD-rate 增益,其探索效率显著优于耗费 1280 次训练的传统硬件感知 NAS(-7.5%)。
实验与结果:打破单线程 CPU 性能下限
针对端侧与普通服务器的无加速场景,实验选用 AMD EPYC 9V84 单线程 CPU 进行严苛的基准端到端耗时评测(包含网络推理与熵解码全部管线),测试输入为 分辨率图像,测试基准采用 CLIC Professional 验证集。
1. 复杂度与率失真表现
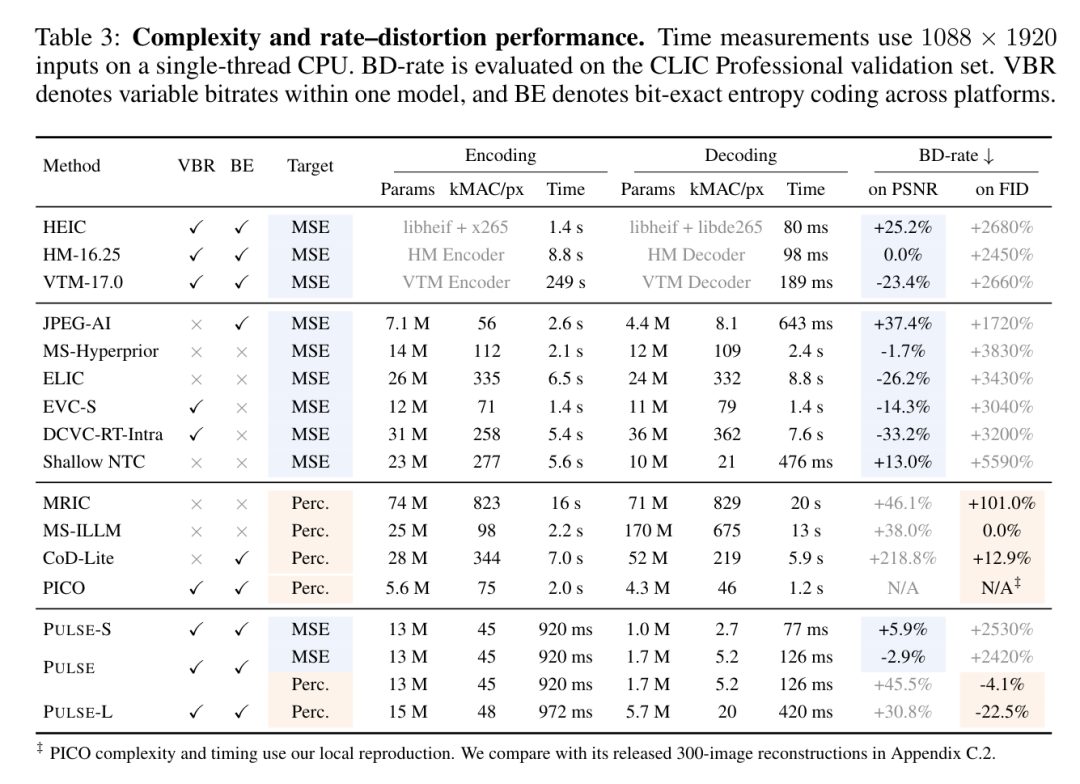
从实测数据中可以看到:
对标传统编码标准:PULSE 解码复杂度仅为 5.2 kMAC/pixel,单线程 CPU 解码耗时为 126 ms。在 PSNR 指标上,PULSE 相比 HEVC 官方参考软件 HM-16.25 取得了 -2.9% 的 BD-rate,同时编码速度快了近 9 倍;相比软解实现 HEIC(libheif + libde265,+25.2% BD-rate),PULSE 具备显著的压缩率优势。
极速轻量模型 PULSE-S:将解码复杂度压缩至 2.7 kMAC/pixel(参数量 1.0 M),单线程解码延迟压至 77 ms,不仅比同条件下的 HEIC(80 ms)更迅捷,且 PSNR 指标依然优于同复杂度的轻量神经编解码器 JPEG-AI(+37.4%)与 Shallow NTC(+13.0%)。
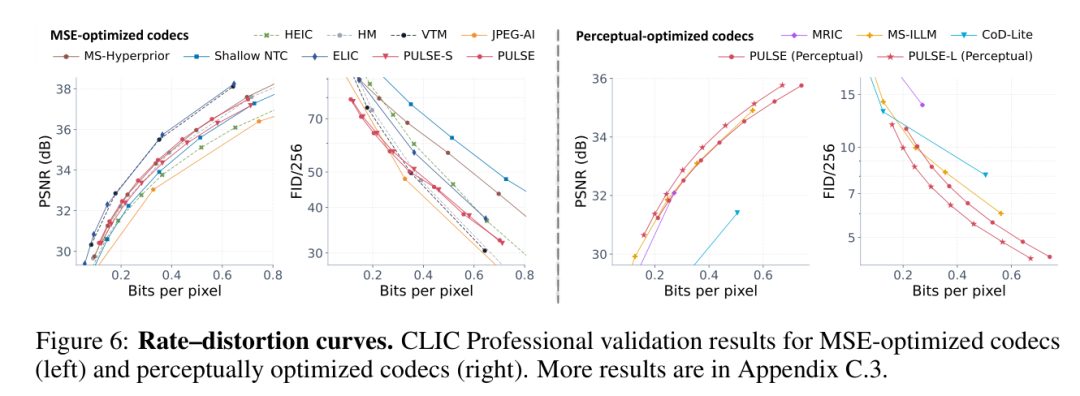
感知优化表现:引入两阶段感知调优(Stage I 强 LPIPS 预训练;Stage II DINOv2 鉴别器对抗训练 + 人脸/文本局部 ROI 特征对齐)后,PULSE 在仅 1.7 M 参数量下,相比 170 M 巨量参数的感知编码标杆 MS-ILLM 取得了 -4.1% 的 FID BD-rate 优势。其大号版本 PULSE-L(解码端 5.7 M 参数,20 kMAC/pixel)更是取得了 -22.5% FID BD-rate 和 -47.5% LPIPS-VGG BD-rate 的提升,而单线程解码耗时(420 ms)比 MS-ILLM(13 s)快了 30 倍以上。
2. 定性视觉效果
在定性重构表现方面,得益于针对文字和人脸区域引入的轻量 ROI 特征约束,PULSE 在极低位率下能够有效规避常规神经模型常见的边缘伪影与字符扭曲。
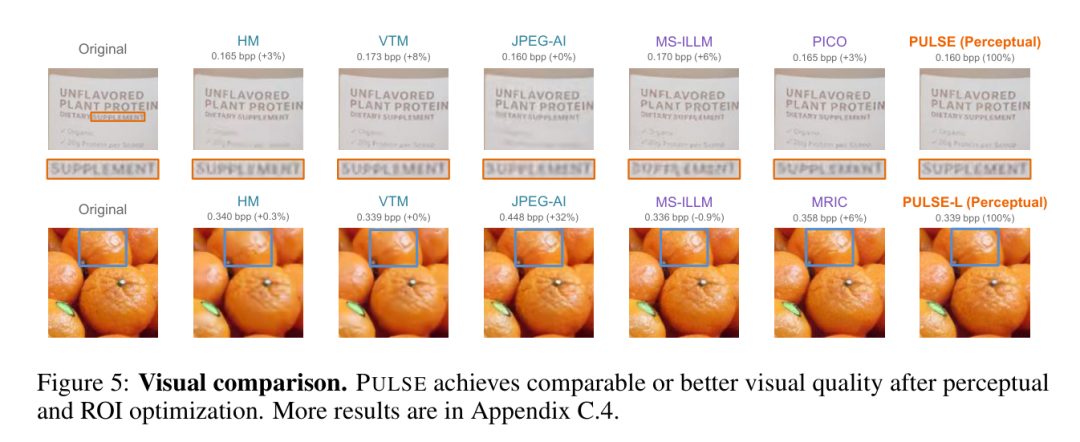
在与 VTM、JPEG-AI 以及 MS-ILLM 的横向主观对比中,PULSE 能够在相近或更低 bpp 码率下,清晰保留字符笔画的锐度与自然边缘走向,避免了均方误差模型过度平滑与生成式扩散模型容易生造结构的问题。
3. 多端部署与零误差验证
为了验证跨架构位流一致性,研究团队在三类截然不同的计算设备上进行了交叉部署实测:
搭载高通骁龙 8 至尊版的红米 K80 Pro 手机(Snapdragon NPU + CPU);
搭载 Intel Core Ultra 9 288V 的轻薄笔记本(纯 CPU 环境);
配备 NVIDIA A100 GPU 与 AMD EPYC CPU 的服务器。
各平台分别执行整型线性 CDF 预测与算术解码,统计显示所有设备间的 CDF 索引与解出符号不匹配次数(Mismatch)严格为 0,首次在超低复杂度神经图像编解码范畴内完成了跨手机、PC 与服务器的端到端完全确定性校验。在硬件加速下,红米 K80 Pro 处理 1080p 图像的编码全流程耗时仅为 42 ms,解码耗时仅需 20 ms。
结语与思考
长期以来,端到端神经图像编解码的高算力需求制约了其向广大无专用加速芯片的端侧设备渗透。PULSE 的探索表明,合理的架构降采样策略、解耦式的像素渲染机制,配合直接映射的整数线性 CDF 索引控制流,能够使神经编解码模型在保持竞争性压缩率的同时,稳健运行在单线程 CPU 严苛的算力边界内。这种兼顾“极低算力消耗”与“跨芯片确定性位流”的工程实现,为轻量化神经网络在多媒体编解码工业标准的演进提供了务实的参考范例。
论文标题: PULSE: Unlocking Practical Image Compression on Single-Thread CPU
机构: 中国科学技术大学、微软亚洲研究院
代码仓库: https://github.com/microsoft/GenCodec/tree/main/PULSE [已开源]