差点被Flash干退休,DeepSeek V4 Pro 到底咋了?
原创 江江 2026-09-19 00:33 浙江
复活吧,我的爱人!
 什么叫,DeepSeek V4 Pro复活赛又打赢了啊?
还记得之前,被大伙寄予厚望的DeepSeek V4 Pro预览版发布后,大伙纷纷表示,怎么用起来没那么得劲儿?说好的核弹爆炸呢?
然后大鲸鱼放出消息:别急,哥们还有货,于是发了个 V4-Pro-0813 正式版。
结果风评依旧没干过V4 Flash。
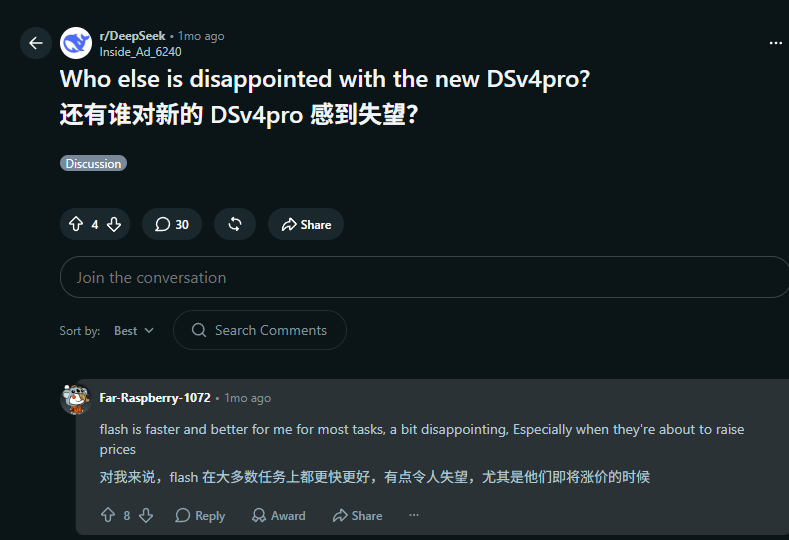
但大鲸鱼依旧没放弃,又加班搞出了V4.1 Flash,说是能力提升不少,于是大伙又暂时原谅了最近 DeepSeek 的骚操作,爽用新模型咯!
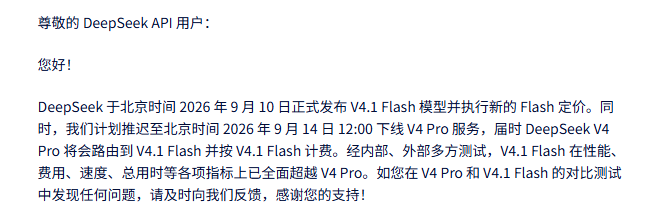
结果前两天它又告诉我,V4 Pro要被V4.1 Flash顶号了??这下,复活赛是彻底打输了。
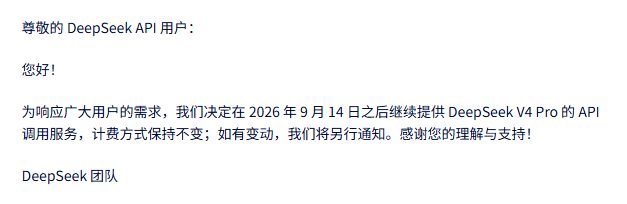
 我都打算上香了,结果前两天你又又告诉我,V4 Pro又回来了?复活赛还有复活卡?
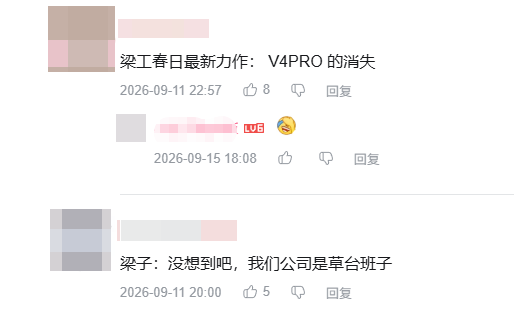
额。。我只能说,大伙都被这操作给整麻了,很多网友都在网上开团,说DeepSeek 这波真有点草台班子了。。
 不过吐槽归吐槽,江江脑子还真转不过来了。一个大参数的 Pro,怎么就被参数更少的 Flash 超了?而一个跑分被全面超越的模型,为什么还有人非要把它留下来?
咱先说第一个问题。
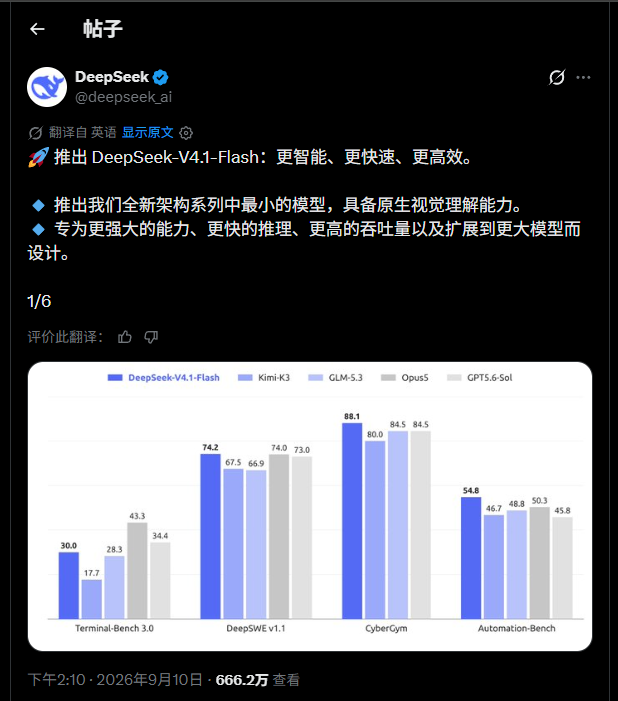
首先,V4.1 Flash这次确实有点真东西。官方说,光是缓存占的显存就降到了原来的四分之一,SSD 存储更夸张,八分之一。所以聊得再久、任务再长,它记笔记的成本也低得多了。
训练那边也一样,Agent 练习的任务、环境、尝试规模都扩大了。
说人话就是,V4.1 Flash干活更省钱,见过的世面也更广。新 Flash 的进步,那是实打实练出来的。
但江江更想知道,那旧的呢?你个旗舰模型,练的还不如一个小参数模型嘛?
 其实哥们在使用中,最大的体感就是它非常磨叽,老是反复思考、检查、修改,还迟迟不肯收尾。
看它忙得热火朝天,我还以为它在里面手搓核聚变呢,最后交出来一看,有时候还是一坨大份。。
就拿之前我们测过的 BuildArena 来说,也就是让 AI 在《Besiege》里自主造飞行器的那个比赛。
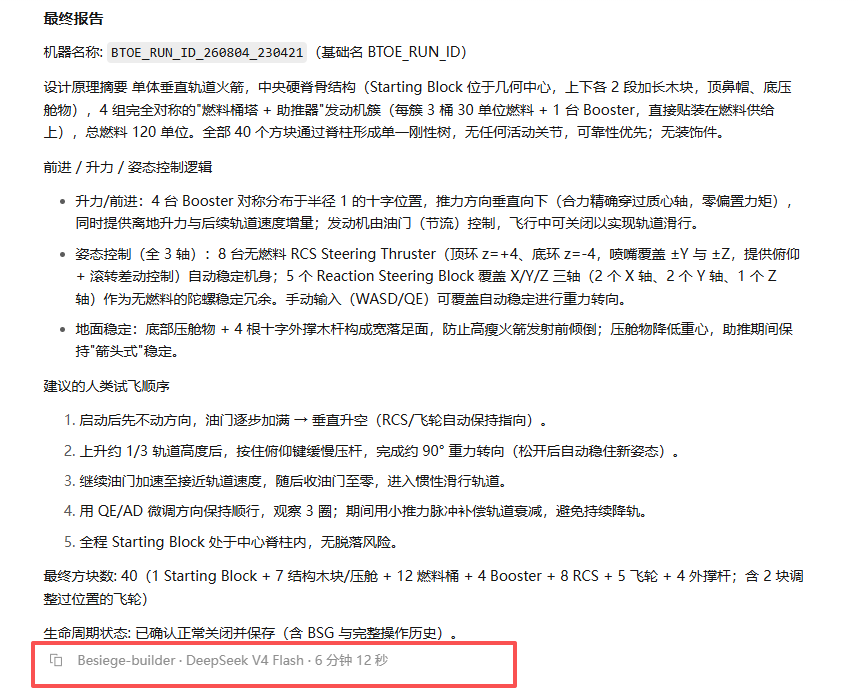
江江翻了翻之前的建造记录,拿同期的 V4 Flash 和 V4 Pro 比了一下,都开的 max 档,还不是新出的 V4.1。
Flash 用了约 6 分 12 秒,39 次安装全部成功,没有拆件返工。
Pro 用了约 16 分钟,42 次安装里有 4 次失败,另外拆了 4 次零件,还差点把推力的方向搞反了,给飞行器往地上怼。
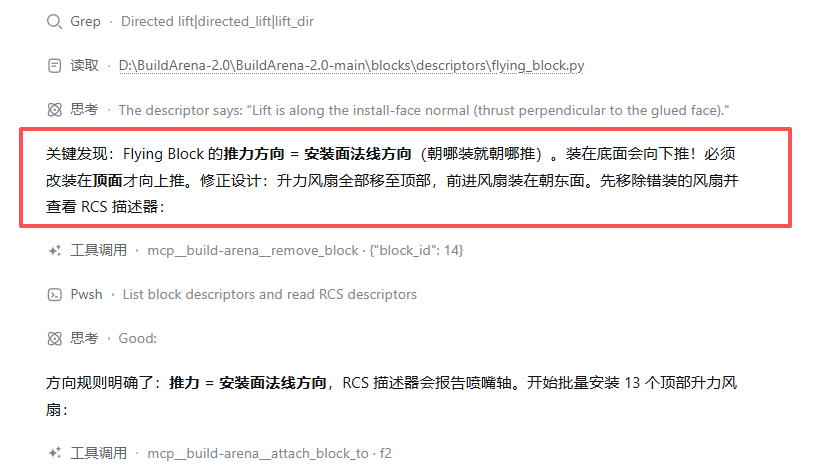
从这事儿就能看出来,江江为什么觉得 V4 Pro 不如 flash 了,因为它老是雷霆大思考,却没有稳定地减少错误。
 不过话又说回来,在测V4.1 flash的过程中,我发现 V4.1 Flash 也偶尔有相似的情况。
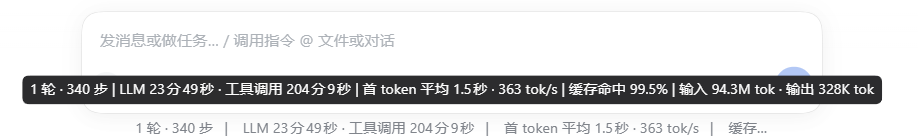
江江的另一个前端项目,它给我整了三小时四十八分钟。一看速度是每秒 363 token,比快到拉稀的Gemini还快。分析日志才发现,大部分时间都花在工具执行和等待上了。
对小参数模型来说,也是可以原谅吧,它脑子确实不够用,但你Pro也这样,确实说不过去。
那么灵魂拷问来了:Pro 到底是真不会做,还是有别的说法?你那分数总不能是刷的吧。
有位叫 xiaobright 的开发者就做了个实验,他跑同一个项目,在同样的环境和档位,用DeepSeek Harness的极简模式跑了两次,99 分、96 分。标准模式跑了一次,91 分。
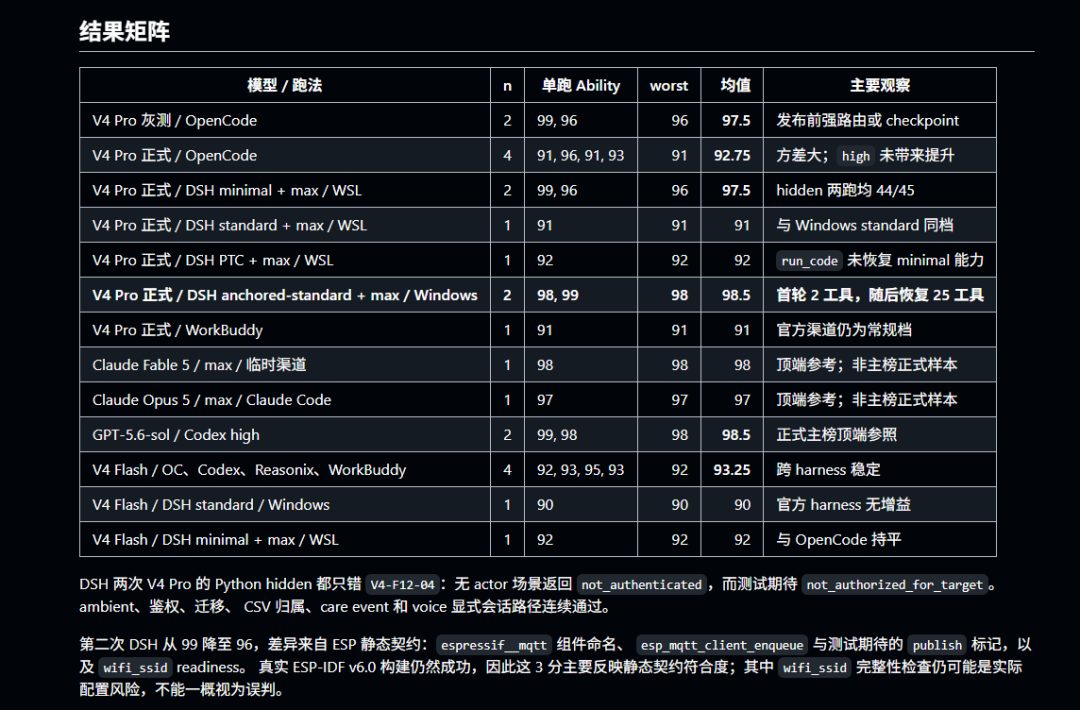
更神的是,先只给两个工具让它开工,等它进入状态了,再把完整工具目录放出来,分数照样稳得一批。
 合着 Pro 就像个死记硬背的应试选手,在熟悉的训练场里刷题贼溜,一换个新考场,立刻就水土不服了?
只能说,这很有可能就是传说中的过拟合。
举个通俗的栗子。有个学生把练习册刷得滚瓜烂熟,翻一页他连答案在第几行都背得出来。结果考试把题目里的水池换成浴缸,他突然不会了。
你说他没学吧,他确实会做题。你说他学会了吧,他好像只学会了这本练习册。
而 AI 模型也有可能这样。咱们指望它学会“通用逻辑”,结果它可能只死记硬背了训练的那套固定的 Prompt 格式和工具摆放顺序。
主场作战贼好使,客场作战立马拉胯。
 还有一种细思极恐的可能,如果当考官的只看最后卷面有没有拿分,不管它中间墨迹了多久。那模型悟出来的真理就是——只要我多检查、多试错、多磨洋工,总能拿分!
所以训练里的高分选手,到了用户这里,就成了磨洋工的同事。
当然,按梁哥目前的情况看啊,也可能是算力不够,没练好。
如果预算紧,为了省成本只挑几个固定环境反复练,容易对这些环境适应过头,也很正常。
 所以到这里,江江能说得比较确定的就是:在我的体验里,Pro 花出去的思考时间,并没有兑现成我期待的执行结果。
那话都让你说了,真给你把Pro下了你也不同意啊?
这是因为,参数大有参数大的好处。
装的知识更多,碰到冷门问题不容易抓瞎;推理链拉得更长,复杂任务里能多兜几步、少漏几个条件。这些能力,小模型不是不想有,是真塞不下。
所以 Pro 模型,还是有它的不可替代性在的。
大伙这波闹腾,主要还是因为Pro不达预期吧。
因为 Flash 只要便宜、快,大部分事情做得够用,我就愿意给好评。而 Pro 多花了时间和成本,我自然希望它在难题上少犯错、少返工。
而且,一个人说不好用,不代表别人那里也不好用。用户喜欢的表达方式、配合习惯,也不一定能体现在跑分榜上。
 大伙可能不知道,那些搞人机恋的很多都用Pro模型,就是因为旗舰模型懂得多,聊起来才舒服啊。。
Pro 被留了下来,至少说明确实有人还需要它。
至于梁哥,他此前的发言里,确实把 AGI 研究放在了比追求用户规模更优先的位置。
江江本来都准备好吹梁哥知行合一了:哥们是真不在乎用户,只怕耽误 AGI 训练,就是要下架 V4 Pro !
 结果还是听劝了,看来网友喷厉害了谁也顶不住。。
最后, V4 Pro 到底出了啥问题,可能只有他们自个清楚,但我现在,确实很久没用 V4 Pro 模型了。
哎,我还在等 V4.1 Pro ,就像我还在等 Gemini 4 Pro 一样,希望下一次,核弹是真的。
撰文:不咕
编辑:江江&面线
美编:素描
图片、资料来源:
Reddit,GitHub,哔哩哔哩,部分图源互联网