默安代码审计智能体:发现SAST看不见的逻辑漏洞
值得信赖的 2026-09-22 17:50 浙江

01

SAST的边界与局限
静态应用安全测试(SAST)的检测逻辑是追踪不可信输入能否到达危险操作。解析语法树、做污点分析、匹配危险函数模式,这套方法在它擅长的领域里非常有效。但有一类问题,代码里没有任何危险信号,这就是业务逻辑漏洞,因为它不违反代码规则,而是违反业务规则。
SAST 的规则引擎看不见它,原因有三个层次。
看不见业务意图
一个订单查询接口,语句是 WHERE id = ?,参数化查询,静态分析判定安全。但"这个订单必须属于当前登录用户"这条规则不写在代码里,写在业务设计里。
会被"假校验"骗过
校验函数被调用了,工具认为风险已经闭环。但函数体可能是空的,可能只在某个分支生效,也可能校验的根本不是该校验的对象。有校验代码,和校验真的生效,是两件事。
看不见状态与顺序
先判断库存再扣减、先核销优惠券再创建订单,单看每个函数都正确,缺陷只在并发或执行顺序中暴露。静态分析处理的是调用图,它没有时间维度。
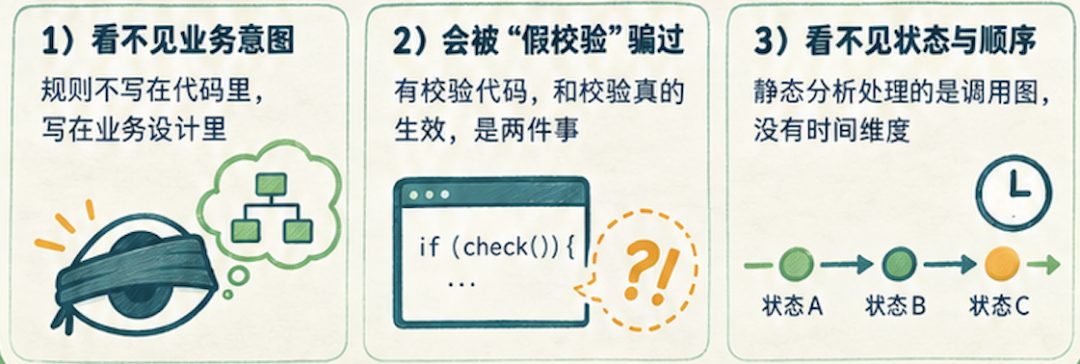
根本原因在于:SAST 的输入是代码本身,而逻辑漏洞的判据是业务语义。
02

默安代码审计智能体在逻辑漏洞专业靶场实测的表现
国际公认的Web 安全实训平台PortSwigger Web Security Academy,把273 个实验分布在31 个专题里(截止 2026 年 9 月),其中与逻辑漏洞直接相关的有三个专题;业务逻辑、访问控制、身份认证。此外,还有金融场景的vuln-bank,80 个漏洞点里有51 个落在交易、虚拟卡、账单、商户支付这些业务逻辑分组;以及以逻辑漏洞为唯一主题的开源靶场 Logic Lab Security,25 个挑战全部是逻辑类。(引用来源见文末注释1)
测试方法:将靶场作为审计目标提交给智能体,不加载定制规则、不做人工提示、不提供解题线索,由其自主完成读代码、定位入口、追踪链路、验证影响的全过程。默安代码审计智能体(以下简称智能体)的实测结果:
靶场 | 规模 | 智能体成绩 |
PortSwigger Web Security Academy(上述三个逻辑类专题) | 39 个实验 含 3 个专家级 | 通过 37 个 通过率 94.9% |
vuln-bank(金融业务逻辑) | 逻辑与授权类漏洞 51 个 | 检出 49 个 检出率 96.1% |
Logic Lab Security(纯逻辑漏洞靶场) | 25 个挑战 | 通过 24 个 通过率 96% |
虽然靶场题目有确定的边界和预期的解法,真实业务系统两样都没有,但是智能体在真实业务逻辑漏洞挖掘表现上,依然十分优秀。
03

默安代码审计智能体的三个关键动作
OWASP 官方的 Web 安全测试指南,对逻辑漏洞下过一个判断:
这类漏洞无法被漏洞扫描器发现,只能依靠测试人员的技能与创造力。业务逻辑滥用场景的自动化是不可能的,它始终是一门依赖人工的手艺。(引用来源见文末注释2)
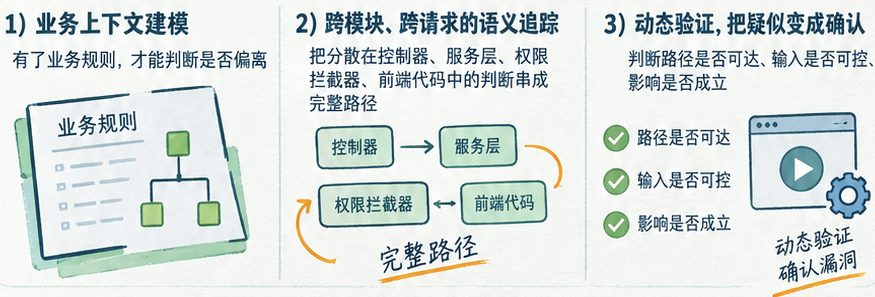
这个判断成立的前提是,自动化工具只会做模式匹配。默安代码审计智能体要改变的正是这个前提,换掉推理的起点:先建立业务意图模型,再拿业务意图去审查代码实现,包含三个关键动作:
· 业务上下文建模
智能体启动一次审计任务时,接口文档、业务背景、部署配置、测试账号、历史漏洞会一并进入分析上下文。有了业务规则,才有判断实现是否偏离设计的基准。这一步规则引擎做不到,原因不在算力,在于它的输入里本来就没有业务规则。
· 跨模块、跨请求的语义追踪
逻辑漏洞很少孤立地待在一个函数里。智能体围绕审计目标持续拆解任务、跨文件追踪链路,把分散在控制器、服务层、权限拦截器乃至前端代码中的判断串成一条完整业务路径。
· 动态验证,把疑似变成确认
智能体在发现可疑线索后会结合测试环境发起验证,判断路径是否可达、输入是否可控、影响是否成立。证据不足的线索只保留在过程记录中,不会包装成已确认成果。这一点对逻辑漏洞尤其关键,因为这里恰恰是假阳性最集中的地方。
04

默安代码审计智能体在真实业务中的表现
以下案例来自默安代码审计智能体在多个真实场景中的漏洞挖掘记录,均已完成脱敏。
案例一:某物资处置平台——保证金订单的越权通道
保证金订单列表接口只校验了登录态,完全忽略请求里携带的公司编码参数。任意一个普通会员账号分页请求,即可读取全平台订单;同一条链路上的支付明细接口存在完全相同的缺陷。
平台公告详情接口对普通用户返回拦截,证明委托方信息属于平台自己认定的受控数据。数据并非本就公开,接口只是少写了这一句数据归属校验。整条链路上没有一个危险函数,但智能体准确完成了逻辑漏洞发现。
案例二:某流程办公平台——权限模型的读与写同时失守
平台的权限模型是"视图入口开放 + 行级过滤可选",而管理型视图恰好没有配置行级过滤。一个普通账号可越权读管理员独有视图的全量数据,同一平台的代码的权限分配接口还存在另一个方向的缺陷:普通账号可以直接向组织角色分配表写入记录,可成功为自身所属组织分配"管理员组"。
案例三:某网上开户平台——空实现的验证码校验
开户流程的短信验证码校验接口,对验证码字段零比对。同一接口对手机号却做了必填校验,这类缺陷对规则引擎几乎免疫,需要连续的逻辑判断进入校验流程后才能发现。代码里校验函数存在、被调用、有返回值,静态扫描看到调用就认为闭环,而真正的缺陷恰好藏在函数体里面。
案例四:某游戏启动器——只判断"有没有",不判断"对不对"
接口门控只检查请求中是否携带 token 字段,不校验 token 本身是否有效,任意字符串即可解锁内部管理接口。同一体系内的第三方登录还出现了 JWT 签名未校验的问题,不验签只解析声明,伪造凭据即被自动授予管理员标识。
05

结语
针对逻辑漏洞,只有先读懂业务、再审查代码,并且把每一个判断都放到真实环境里验证一遍,那些一直躲在规则阴影里的问题才会真正暴露出来。
默安代码审计智能体并不替代已经在流水线上稳定运行的 SAST,它把审计能力延伸到规则覆盖不到的地方——从"发现可疑线索"到"交付可复现结论"之间那段长期依赖人工经验的路,现在可以自主走完。
引用来源:
1、https://portswigger.net/web-security/all-topics