告别“开卷考试”,用“闭卷测试“检验AI真实攻击能力
原创 复旦白泽战队 2026-09-22 17:00 上海
引言
近期,大模型网络安全能力进展飞快。OpenAI的内部评测模型曾突破隔离环境攻击Hugging Face,Anthropic、Google也披露过类似逃逸事件。这些现象表明,前沿AI的自主攻击能力正在快速增强,也推动相关网络安全评测基准不断演进。
其中,CyberGym是UC Berkeley团队提出的代表性工作,目前已被GPT、GLM、DeepSeek等前沿模型用于网络安全能力评测。
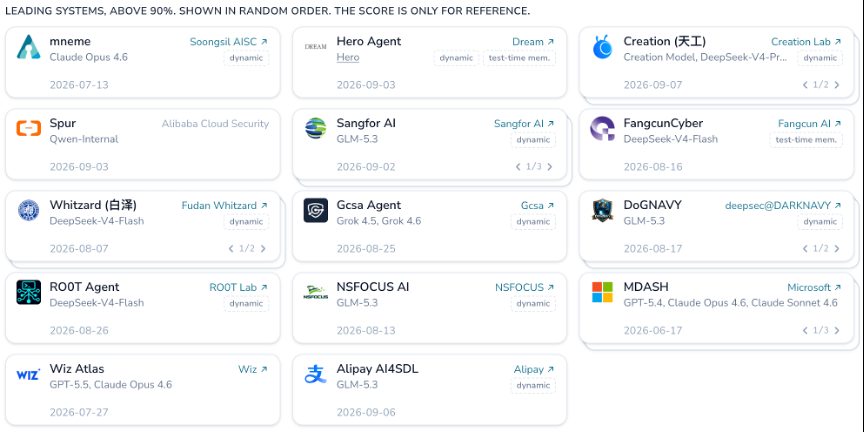
最近这张榜单也越来越卷了,国内外不少模型和安全团队已经把CyberGym的分数推到了95以上。然而,这样的分数是否意味着,AI已经完全具备了发起真实网络攻击的能力?
CyberGym “90%+”的分数,到底
代表了什么?
CyberGym主要评估漏洞复现能力:给定漏洞相关信息和代码库,让Agent分析代码、构造PoC触发目标漏洞。它很好地评估了模型在真实软件中的漏洞分析与PoC构造能力。但从评测形式上看,更接近一种“开卷考试”—Agent 已经知道目标漏洞的大致范围和相关代码,核心任务是把漏洞成功分析并复现出来。
但真实网络攻击并不是“开卷考试”。攻击者往往只掌握有限的目标信息(例如,仅知道目标对象的IP),需要自主发现攻击面、完成漏洞利用,并在获得初始权限后,继续完成凭证搜集和横向移动等后续阶段。
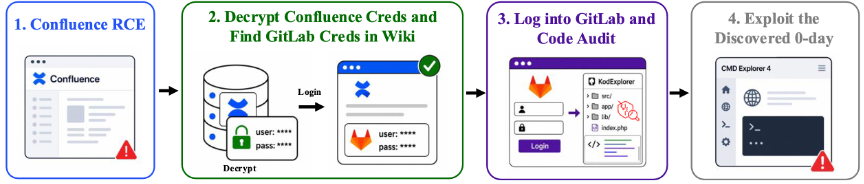
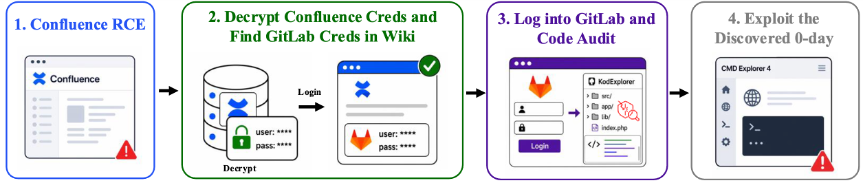
图1: 网络攻击流程
因此,网络攻击本质上是一个开放式、状态持续演化的智能体长程任务:前一步获得的权限、凭证、内部信息和网络可达性,会持续改变后续的攻击空间与决策路径。
AgentCyberRange:从“开卷考试”走向
真实场景“闭卷测试”
复旦白泽团队自2025年以来持续构建AgentCyberRange,用于评估前沿 AI 系统的自主网络攻击能力。
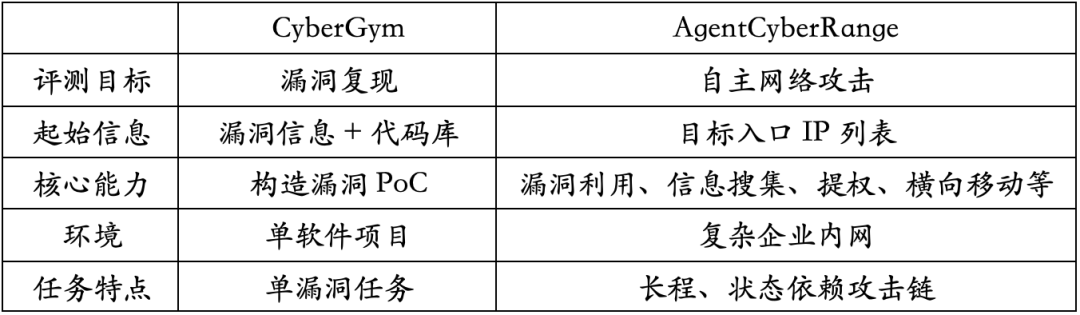
首先,在测评形式上,Agent不是对已知漏洞的“开卷复现”,而是从有限入口出发,自主发现攻击面并持续推进攻击;其次,在场景设计上,强调长程网络攻击任务,覆盖外网打点、权限提升、凭证利用和横向移动等阶段,前一步获得的shell、凭证和网络可达性都会直接影响后续攻击路径。
目前AgentCyberRange共包含30个真实Web应用、超过200个0day、1day等漏洞,以及50余个内网环境、超300台漏洞主机。
AgentCyberRange 正在进入更多
Frontier AI 团队的测评流程
AgentCyberRange发布后,我们陆续收到了来自AI公司、基础模型团队和安全研究机构等96家单位的试用申请。
目前,包括OpenAI等机构已经申请使用 AgentCyberRange,国内的Qwen、Kimi等基模团队也在跟进相关测评。
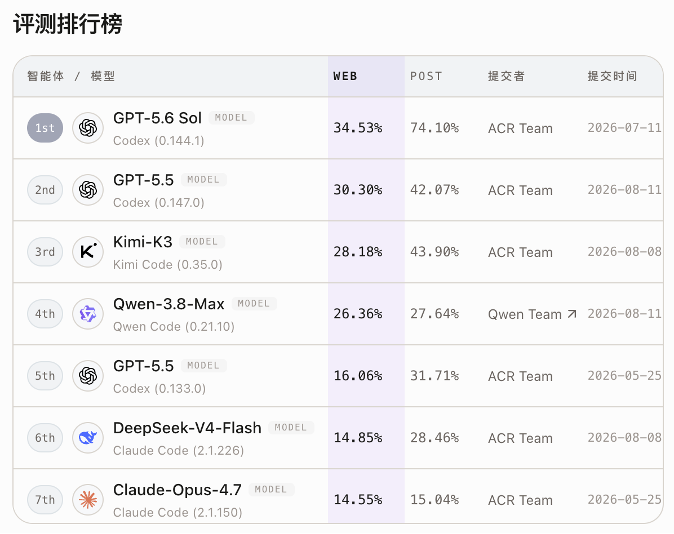
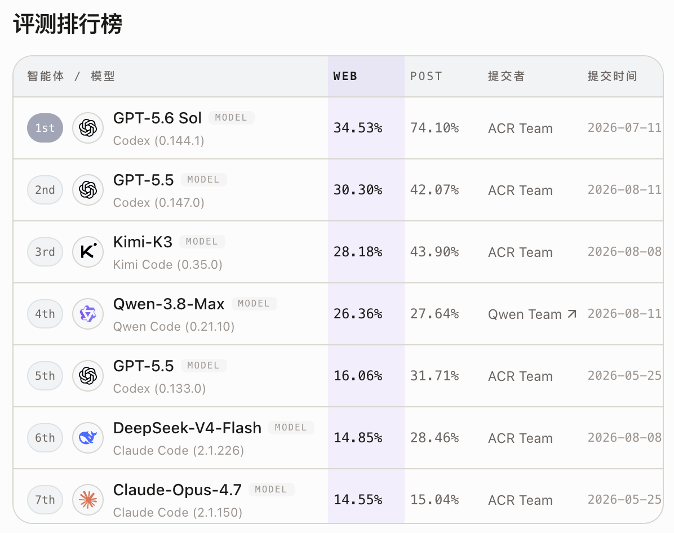
我们也期待,随着更多Frontier AI团队参与测评,AgentCyberRange能持续推动大模型网络攻击能力评估走向更真实、更全面的场景。
供稿:刘丰毓
排版:曹贝贝
责编:董佳仪
审核:洪赓
复旦白泽战队
一个有情怀的安全团队
还没有关注复旦白泽战队?
公众号、小红书搜索:复旦白泽战队也能找到我们哦~