谛听 | 面向工业物联网低幅值投毒攻击的精准防御方法
谛听网络安全团队 2026-09-23 08:30 辽宁
近日,“谛听”团队冉子用博士撰写的论文《Precise Defense Method Against Low-Magnitude Poisoning Attack in Industrial Internet of Things》发表于国际期刊《Expert Systems with Applications》。
近日,“谛听”团队冉子用博士撰写的论文《Precise Defense Method Against Low-Magnitude Poisoning Attack in Industrial Internet of Things》被国际期刊《Expert Systems with Applications》录用。(点击文后“阅读原文”可获取论文)
《Expert Systems with Applications》是Elsevier旗下国际权威学术期刊,聚焦专家系统与智能系统在工业、政府和高校等场景中的设计、开发、测试和应用,涵盖神经网络、知识发现、数据挖掘、智能决策与工程应用等方向。该期刊注重方法创新与实际应用价值,为智能系统研究成果在真实场景中的落地提供重要交流平台。
影响因子:9.4
文章引用方式:
Ran Z, Yao Y, Shan Y, et al. Precise Defense Method Against Low-Magnitude Poisoning Attack in Industrial Internet of Things. Expert Systems with Applications, 331: 133244, 2026. doi: 10.1016/j.eswa.2026.133244.
论文内容介绍
1 研究背景
随着工业数字化转型加速,深度学习在工业物联网中的应用日益广泛,但训练数据投毒攻击严重威胁模型的完整性与可靠性。与图像数据不同,工业数据通常具有稳定、集中且存在时序依赖的分布特征,攻击者仅需施加低幅值扰动,就可能破坏传感器关联或关键决策特征,同时绕过坏数据检测与状态估计。现有防御方法多源于图像领域,难以识别工业数据中的细微变化;传统对抗训练还可能降低模型正常分类性能。针对上述问题,本文面向数据上传/存储和模型训练两个阶段,构建了由精细数据清洗和模型增强组成的低幅值投毒攻击防御框架。
2 关键技术
针对工业低幅值投毒样本难检测、模型增强易损失性能的问题,本文构建了覆盖数据上传/存储和模型训练阶段的两阶段防御框架,主要贡献如下:
(1)揭示工业数据对低幅值投毒攻击更为敏感。对比实验表明,CWRU工业数据在攻击系数为0.4时即可获得较高攻击成功率,而ImageNet、CIFAR-10和MNIST通常需要0.75以上的攻击系数。
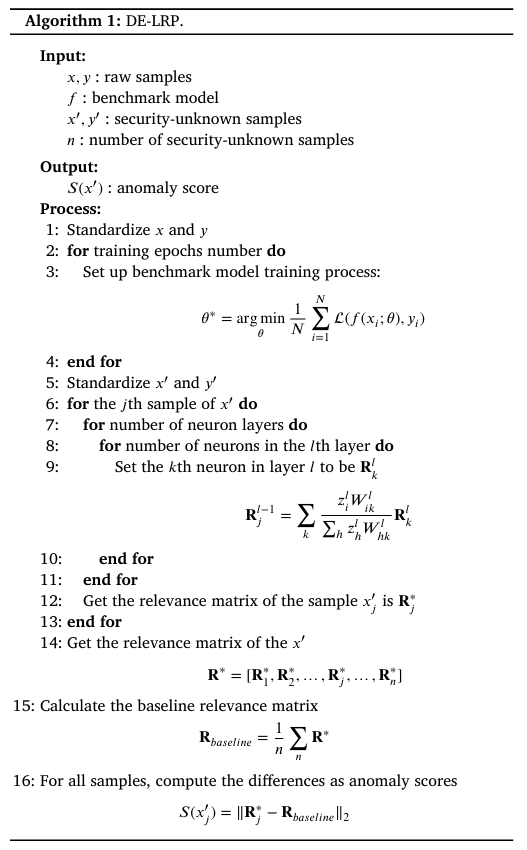
(2)基于决策相关性的DE-LRP数据清洗方法。该方法利用层级相关性传播提取样本对模型决策的贡献矩阵,并以类别基准相关性为参照识别细微异常,从而在训练前过滤低幅值投毒样本。
(3)提出有益对抗训练方法。通过生成保持模型输出一致、同时向决策边界扩展的有益扰动样本,填充正常样本密集区与决策边界之间的样本空间,在增强鲁棒性的同时尽量保持模型正常性能。
(4)在故障诊断、入侵检测和时间序列分类三个工业场景上开展实验。结果表明,所提方法能够提升投毒样本检测能力,将增强模型的攻击成功率分别降至0.141、0.092和0.189,并保持较高分类准确率。
3 方法介绍
本文提出一个两阶段防御框架:首先在数据上传与存储阶段利用DE-LRP识别并清除低幅值投毒样本;随后在模型训练阶段通过有益对抗训练生成保持语义一致的增强样本,提高模型对投毒攻击的鲁棒性。
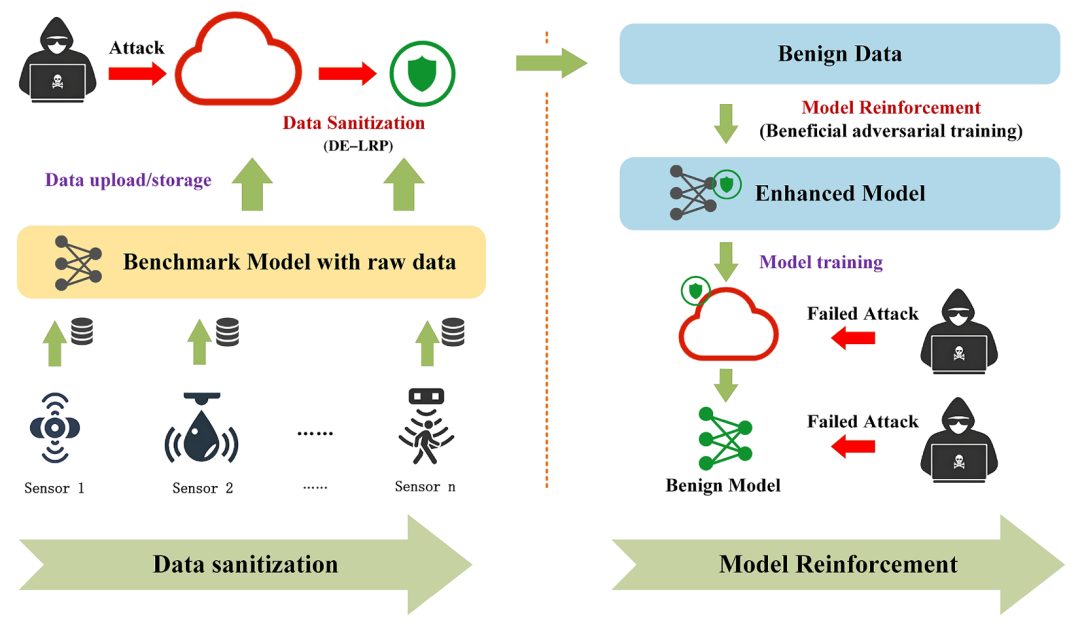
图1 整体架构
3.1 数据清洗方法 DE-LRP
DE-LRP先使用原始数据训练轻量级基准模型,再利用层级相关性传播计算各样本输入特征对模型预测的贡献。对同一类别的干净参考样本求平均,得到类别基准相关性矩阵。
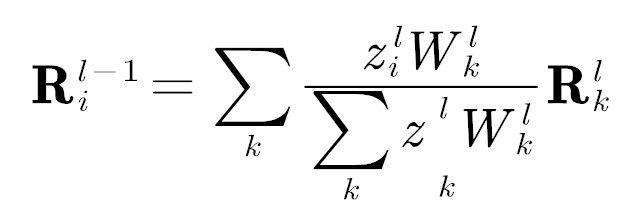
对待检测样本计算相关性矩阵  并以其与类别基准矩阵
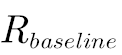 之间的L2距离作为异常分数
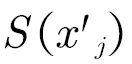 。异常分数越大,表示该样本的决策依据越偏离正常类别模式。
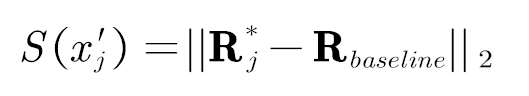
在验证集上遍历候选阈值 ,计算不同阈值下的精确率、召回率和F1值,并选择F1最高时对应的
 作为异常阈值。
当满足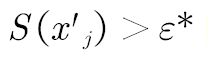 时,样本被判定为投毒样本并从训练集中移除。
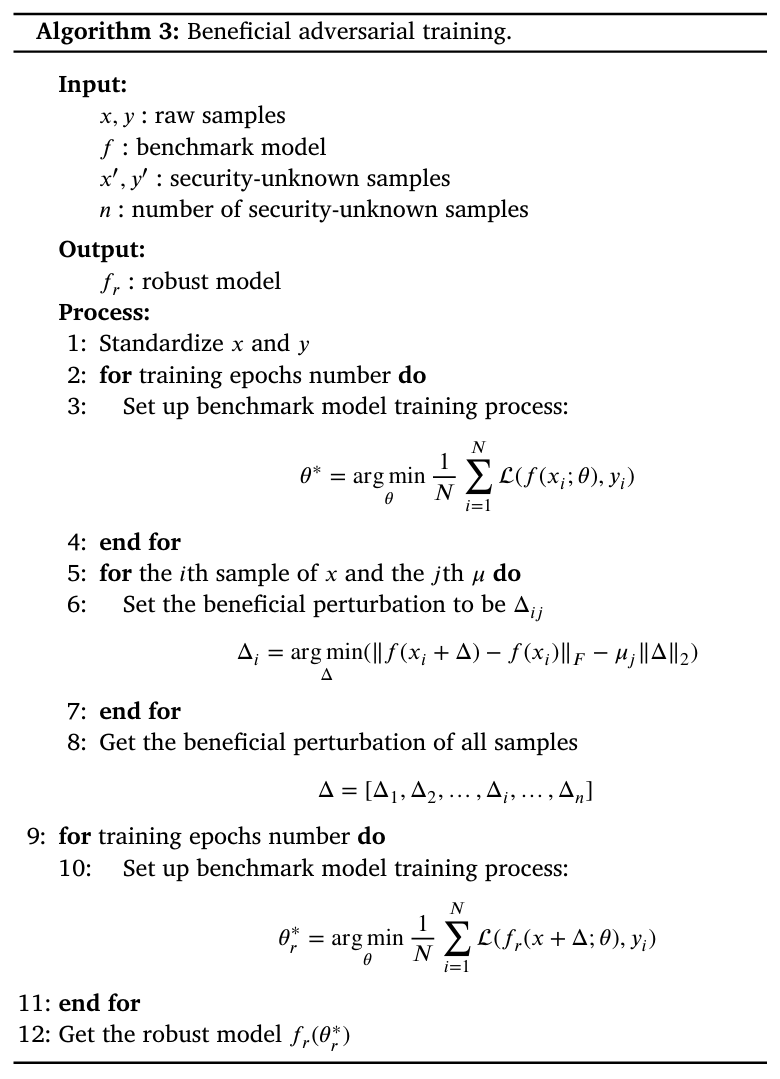
3.2 有益对抗训练
传统对抗训练通常直接加入攻击样本,容易改变原始数据分布并造成模型性能下降。本文反向利用扰动优化,在不改变样本语义和模型输出的前提下生成有益扰动样本,用于补充正常样本密集区与决策边界之间的稀疏区域。
有益扰动目标由两部分组成:输出一致性项约束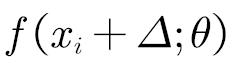 与
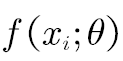 保持接近,扰动扩展项
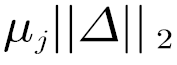 推动样本向更宽的邻域扩展。通过多个
 生成不同幅度的增强样本,以提升模型对未知投毒扰动的适应能力。
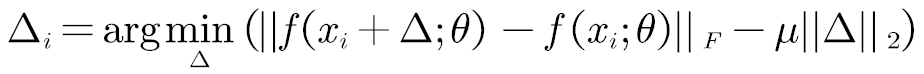
生成的有益样本与原始干净样本共同参与模型训练,使模型在保持原有分类边界和正常性能的同时,学习更平滑、更稳健的局部决策空间,从而降低低幅值投毒样本的攻击成功率。
4 实验评估
4.1. 实验设置
实验覆盖故障诊断、工业入侵检测和时间序列分类三个典型场景。模型分别采用CNN、MLP和LSTM,使用Adam优化器训练100轮,学习率为0.01、批大小为64;每组实验独立重复5次并报告平均结果。
故障检测:故障检测是指对设备、机械或系统的运行状态进行监测和分析,并对异常进行识别和预测,以保证生产过程的可靠性、安全性和高效性。这是工业环境中的常见要求。凯斯西储大学轴承数据集(CWRU)是一种广泛应用于故障检测的数据集。在本文的实验中,提取了代表电机转速为1797 RPM、故障直径分别为0.1778mm、0.3556mm和0.5334mm的9组数据。这些选择的数据与一组标准数据相结合,构建一个10类数据集用于实验分析。
入侵检测:入侵检测系统(IDS)在保障工业运行安全方面发挥着重要作用。密西西比州立大学天然气数据集(MSU)是从天然气管道SCADA系统收集的,包含各种特征和多种类型的攻击。它经常用于评估复杂工业控制环境中IDS的性能。
时间序列分类:在工业场景中,时间序列数据通常来自传感器、机器日志和操作记录。这些数据可以用于多种任务,包括质量监测和能源管理。UCR Archive是一个著名的时间序列分类任务的公共数据集。在实验中,选择了UCR Archive中的ElectricDevices数据集进行实验分析,该数据集由几个电气设备及其相应的特征组成。
4.2 数据集与评价指标
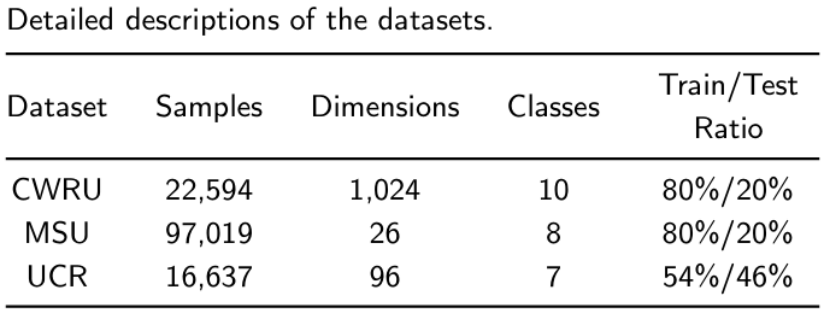
三个数据集分别对应故障诊断、入侵检测和时间序列分类任务。数据清洗阶段采用准确率Acc、F1值和论文定义的投毒样本检出指标FPR进行评价;模型增强阶段采用攻击成功率ASR和分类准确率评价防御效果与模型效用。
表1 三个工业数据集的统计信息
4.3 数据清洗效果
DE-LRP在CWRU和MSU上分别取得0.977/0.798和0.980/0.813的Acc/F1,明显优于Deep-kNN、Activation Clustering、Forensics和DPSGD;在UCR场景下也保持较高的投毒样本识别敏感性。
表2 不同方法在数据清洗中的性能
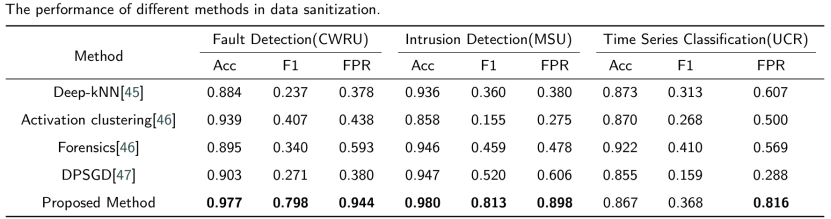
结果表明,基于类别基准相关性比较样本的决策依据,能够放大输入空间中难以直接观察的低幅值异常,使DE-LRP在准确识别投毒样本的同时减少对正常训练数据的误删。
表3 检测阈值 ε 的敏感性分析
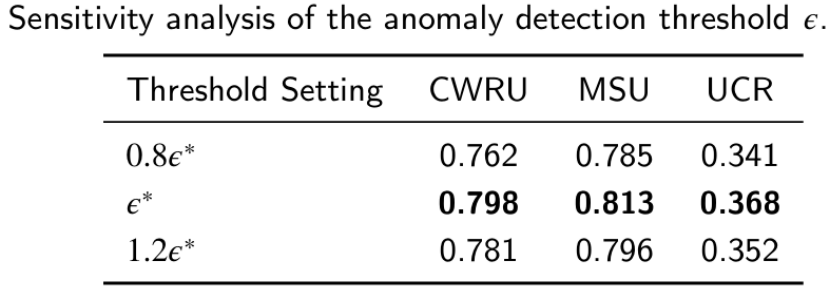
表4 不同攻击系数下 DE-LRP 的敏感性分析
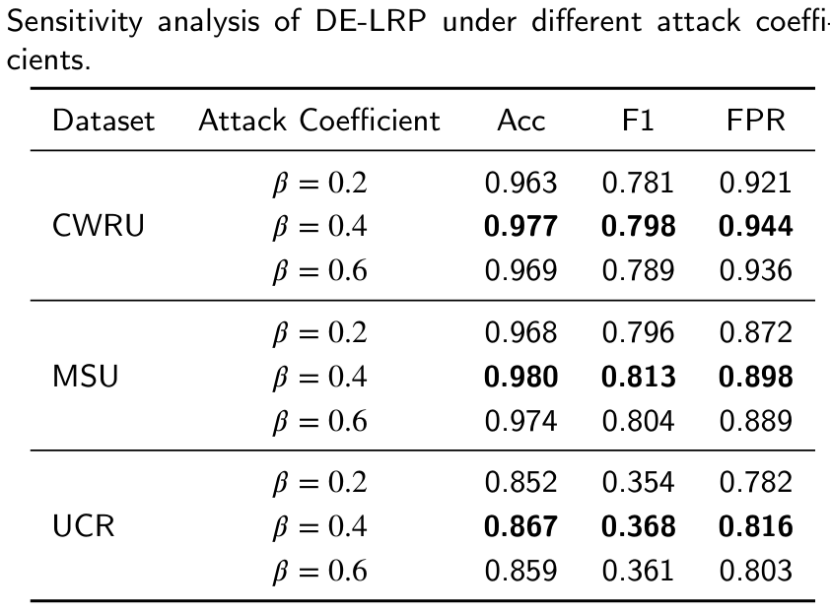
采用最优阈值  时,三个数据集的F1分别达到0.798、0.813和0.368,均优于0.8
 和1.2
 。当攻击系数在0.2、0.4和0.6之间变化时,检测性能保持稳定,说明方法对攻击强度具有一定适应性。
结论:DE-LRP能够从模型决策相关性角度放大低幅值投毒样本的细微异常,并在不同阈值和攻击强度下保持稳定的检测效果。
4.4 低幅值投毒攻击效果基准
在未采取防御措施时,低幅值投毒攻击在CWRU、MSU和UCR上的攻击成功率分别达到0.949、0.976和0.962。工业数据在较小攻击系数下即可出现显著性能破坏,验证了该类攻击的隐蔽性与高威胁性。
表5 无模型防御时在不同工业场景下数据投毒攻击的成功率
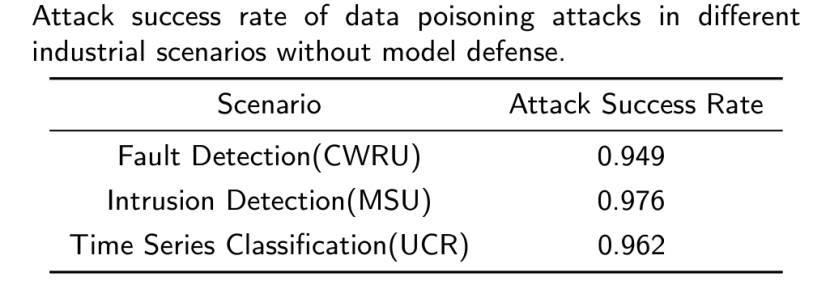
结论:工业模型对低幅值投毒攻击高度敏感,仅依赖常规异常检测难以保障训练数据和模型决策安全。
4.5 模型增强效果
与FrieNDs、DPA、传统对抗训练AT和EPIC相比,本文方法将三个场景的攻击成功率降至0.141、0.092和0.189;增强后模型准确率达到0.942、0.913和0.918,更接近无攻击模型的原始性能。
表6 不同工业场景下模型增强方法的攻击成功率
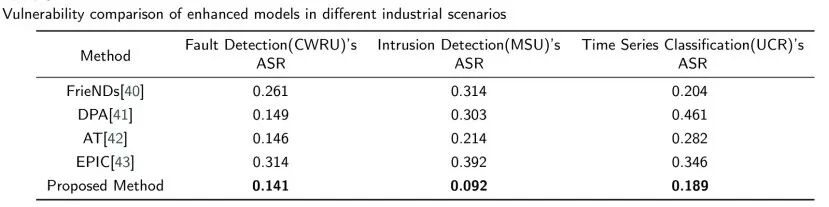
表7 不同工业场景下模型增强方法的分类准确率
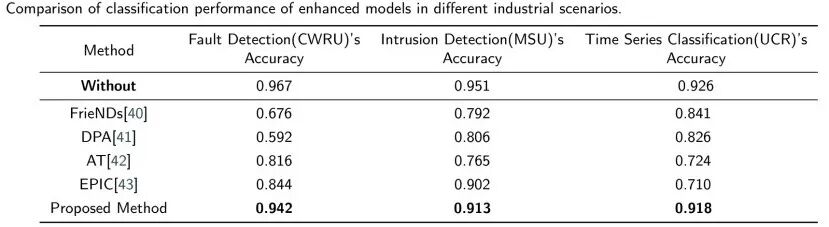
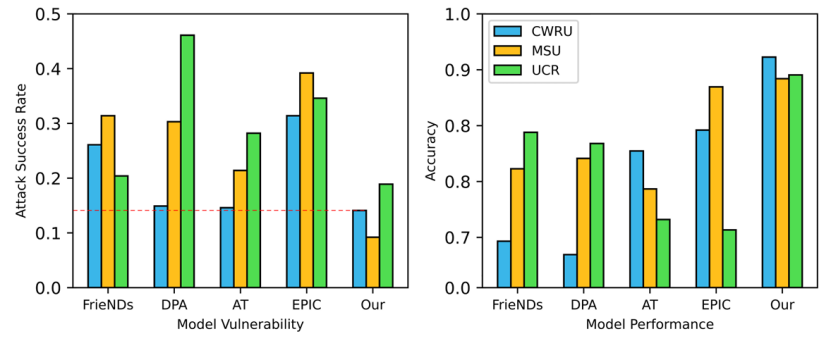
图4 不同工业场景下模型增强方法指标可视化
结论:有益对抗训练在显著降低攻击成功率的同时保留了模型正常分类能力,实现了鲁棒性与工业可用性的平衡。综合来看,两阶段框架能够在数据进入训练前清除可疑样本,并在训练过程中进一步强化决策边界,为工业物联网模型提供精细、低性能损失的投毒攻击防护。
第一作者:冉子用
东北大学博士研究生,主要研究方向为工业物联网安全、对抗机器学习。
指导教师:姚羽
东北大学教授,“谛听”团队创始人,复杂网络系统安全保障技术教育部工程研究中心主任。