重磅!开源版Jev本地部署教程来了!
原创 Datawhale 2026-09-23 22:58 浙江
Datawhale干货
开源版Jev:Laya模型
平时我们搭 Agent 工作流或者客服系统,经常会遇到这类需求:判断用户想干嘛、工单分到哪个部门、该调哪个具体工具。这类事情没有开放式创作的要求,可如果每次都扔给几十亿参数的自回归大模型,哪怕只吐一个词,也得干等几百毫秒,输出偶尔还夹带解释废话或者残缺的 JSON。
前段时间 TypeSafe 推出 Jev 专门做这类判断,单次前向几毫秒就能搞定,但目前只有云端付费 API,权重没有开放。开源社区很快做出了完整复刻,Laya 用 Apache-2.0 协议放出了全部模型权重,可以拉回本地自己跑。
这篇文章给大家简单介绍 Laya 是什么,然后介绍四步流程把它的部署跑通。指定模型、显存优化、实验仓库这些内容统一放在教程后面,不打断上手过程。文中的延迟和显存数据,都在 aarch64 架构的 GB10 算力卡(20 核 CPU,121 GB 统一内存,PyTorch 2.14.0+cu130)上测出。
文中用到的安装命令、最小脚本和全部实测日志都放在这个仓库里,可以直接 clone 下来跟着跑,如果显存不足的读者,想要看看运行结果可以去下面的地址,直接看执行日志,这样就不用下载模型运行了:https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/test_jev_open_source/laya(https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/test_jev_open_source/laya)
01
Laya 是什么
Laya 做决策,不生成文本。Qwen、Claude、ChatGPT 属于自回归解码器,推理时逐 token 串行生成,哪怕只输出一个类别名称,也得走完整个生成周期。
Laya 走的是判别式路线,骨干是 ModernBERT 这类双向编码器。输入文本(State)和待判定的问题(Questions)一起输入到模型,末层直接输出各个选项的概率分布。实测单题前向 p50 在 8.31 毫秒(中文 multilingual 分支)到 16.41 毫秒(英文 english 分支)之间,三套权重全量常驻的 CUDA 占用在 4 到 6 GB,单卡即可承载。
它不适合写文章或长文本总结,适合意图识别、路由分流、安全护栏这类确定性判定任务,作为大模型的前置组件降低流水线延迟。
02
保姆级部署跑通教程
第一步,环境配置与依赖安装
跑 Laya 建议准备一张 6 GB 以上显存的显卡,系统内存 16 GB 以上。Linux 和 macOS 都支持(x86_64 与 aarch64 架构均可),Python 要求 3.10 或更高(实测环境为 Python 3.12)。
建议单独建一个干净的虚拟环境,避免和其他项目的依赖版本冲突。在终端敲下面几行(Windows 把第二行替换成 ~/laya-env/Scripts/activate)。
# 创建并激活虚拟环境python -m venv ~/laya-envsource ~/laya-env/bin/activate# 安装 laya 核心库pip install laya
装完看一下版本。
pip show laya版本在 0.3.5 以上即可。国内服务器从 HuggingFace 拉权重时,先配置镜像环境,避免下载卡住。
export HF_ENDPOINT=https://hf-mirror.comexport HF_HUB_DISABLE_XET=1
第二步,权重与自动分流
官方目前放出三个预训练权重,分工如下。
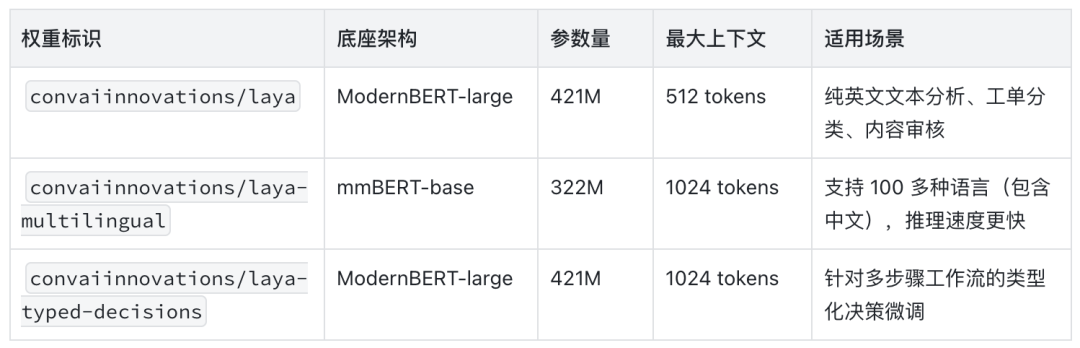
日常使用不需要手动挑权重。官方封装的 Router 接口会识别输入语种并调度对应分支,输入以中文为主时自动走 laya-multilingual,直接初始化 Router 即可,具体写法就在下一步的脚本里。
第三步,编写最小运行脚本
我们先跑一个最简单的验证脚本 test_laya.py,看看它怎么接收输入并给出结果。
from laya import Router# 初始化路由器,指定使用 GPU 并预加载权重router = Router(device="cuda", preload=True, max_loaded=3)# 1. 待分析的输入文本state = {"from": "user@acme.com","subject": "Duplicate charge on invoice #4411","body": "Hi, we were billed twice for March. Please refund the duplicate today or we will cancel your plan."}# 2. 定义判定问题与候选选项描述questions = {"department": {"type": "choice","instructions": "Which department should handle this request?","criteria": {"billing": "invoices, payments, refunds","technical": "bugs, outages, system errors","sales": "pricing, new contracts","other": "everything else"}}}# 3. 执行前向推理result = router.predict(state, questions)# 4. 打印路由去向与判定结果print("路由到:", result["routing"]["model"])print("判定结果:", result["answers"]["department"]["choice"],"置信度:", round(result["answers"]["department"]["confidence"], 4))
在终端执行,第一次跑会自动把权重下载到本地缓存。
python test_laya.py第四步,看懂返回结果
执行完后,result 是一个标准 Python 字典,不需要用正则抠答案,也不用担心 JSON 缺括号。下面是在 GB10 上跑完 test_laya.py 拿到的完整真实返回结构。
{"model": "laya-rl-agent","answers": {"department": {"type": "choice","choice": "billing","probabilities": {"billing": 0.9582,"technical": 0.017,"sales": 0.0134,"other": 0.0114},"confidence": 0.8419,"action": {"act_probability": 1.0}}},"usage": {"input_tokens": 96,"output_tokens": 0},"routing": {"model": "english","repo": "convaiinnovations/laya","reason": "English Latin text","detection": {"script": "latin","script_profile": {"latin": 1.0},"language": "en","is_english": true,"language_undecided": false,"diacritic_rate": 0.0,"non_latin_fraction": 0.0},"workflow": null}}
把这个返回体落到业务代码里,看三个核心字段。
1. 胜出选项(choice):直接读 choice 拿到结果 billing。答案里还有一个 action.act_probability 字段,官方在 Honest limits 说明里提过,它目前读出来几乎恒为 1.0,和准确率反向,做门控用 confidence,不要读这个字段。
2. 置信度与概率分布(probabilities / confidence):probabilities 给出各个候选标签的概率分布(和为 1),confidence 是校准后的综合置信度。可以按它设流转门槛,得分太低就转人工或者召回大模型兜底。
3. 路由详情(routing):routing 记录本次请求走了哪条分支以及判定理由。换成中文输入时,reason 会变成类似 non-Latin script (han, 95% of letters); the English checkpoint cannot read it 的描述(比例随输入的中文占比变化),并自动切到 multilingual。顶层的 model 字段固定显示为 laya-rl-agent,那是底层运行标识,判断实际分支要读 routing.model。
除了单选题(choice),Laya 还支持打分题(score,输出各档位分布)和是非题(boolean,输出真值概率),在 questions 里改 type 指定。同一个 state 下可以放多个问题,单次前向一起算出。
03
指定模型与显存优化
默认流程跑通之后,如果业务只涉及单一语种,或者显存比较紧张,可以手动指定模型分支。这里集中给出三种方式和它们的实测代价。
第一种,Agent 直调锁定单个分支,绕过 Router,只加载一套权重。
from laya import Agent# 只加载 multilingual 分支,不加载 english 和 typed-decisionsagent = Agent("convaiinnovations/laya", device="cuda", subfolder="multilingual")result = agent.predict(state, questions)
第二种和第三种都基于 Router。构造时传 default 设全局兜底,它只在语言检测失效时生效,日常请求仍走自动检测;predict 时传 model 做单次覆盖,优先级最高,语种检测整个跳过。
# 全局兜底:检测不到语言时走 multilingualrouter = Router(device="cuda", default="multilingual")# 单次覆盖:这一批请求固定走某个分支result = router.predict(state, questions, model="multilingual")
手动指定拿掉了路由保护,指定错分支的代价会直接体现在置信度上。我们用同一句中文输入把四种模式完整跑了一遍。
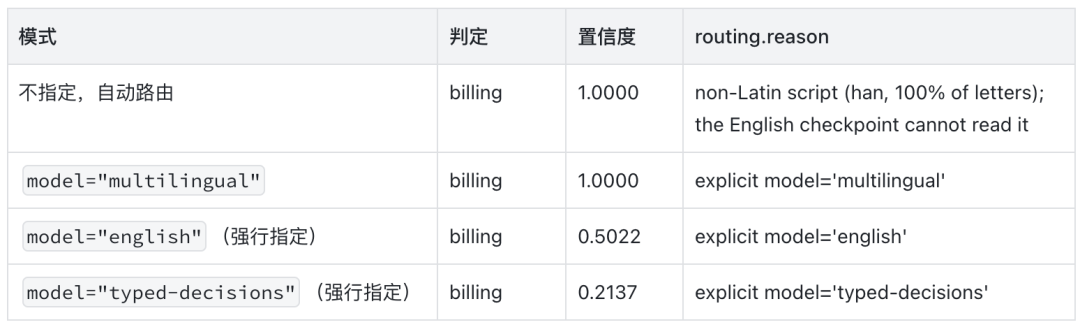
后两行说明问题。同一句中文送给只见过英文的 english 分支,置信度从 1.0 掉到 0.50;送给没做过该场景微调的 typed-decisions 分支,只剩 0.21。中文场景下手动指定分支要用 multilingual,其余情况交给 Router 自动分流。
三种调用方式的开销对比如下(中文输入,p50)。
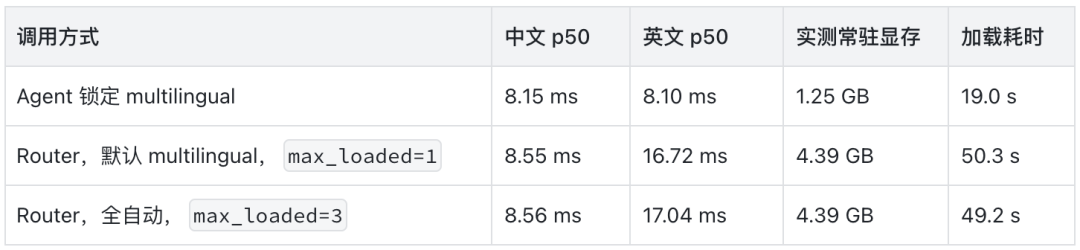
两个结论。延迟上三者持平,Router 做一次语种判定只多花 0.2 毫秒左右。显存差别大,Router 为了随时切换会把权重留在显存里,实测驻留 4.39 GB;Agent 锁定单分支只占 1.25 GB,单语言业务显存吃紧时用它最省。
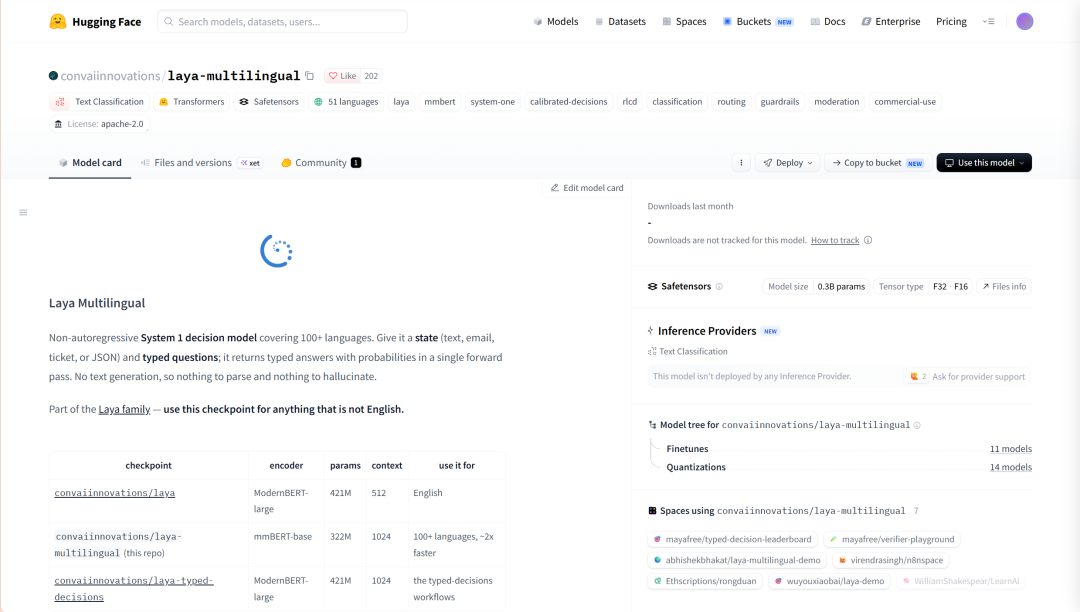
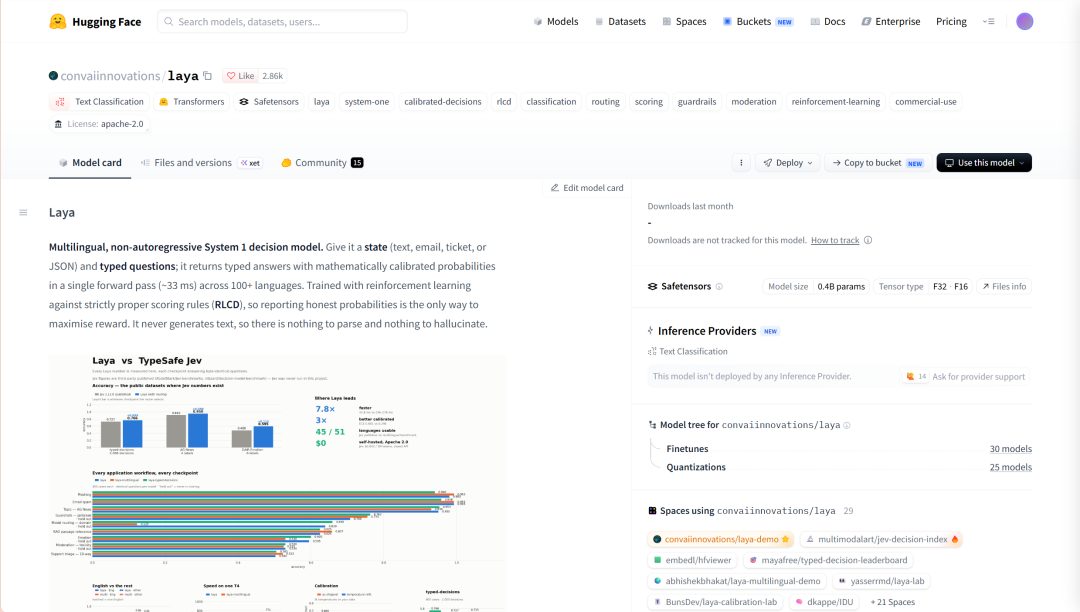
三个权重在 HuggingFace 上的主页如下,参数规模和定位都写在卡片里。
convaiinnovations/laya 的 HuggingFace 卡片。卡片写明单次前向约 33 毫秒返回带概率的判定结果,且不做文本生成。
convaiinnovations/laya-multilingual 的 HuggingFace 卡片。底座换成 mmBERT-base,卡片明确写着除英文之外的场景都用这个权重。
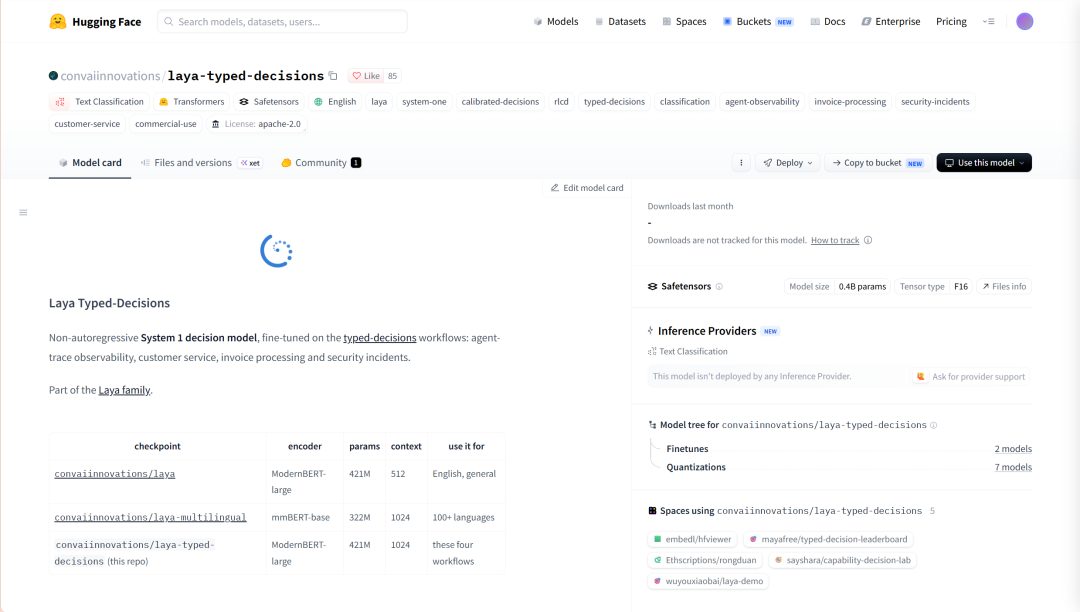
convaiinnovations/laya-typed-decisions 的 HuggingFace 卡片。它在主模型基础上针对工作流可观测性、客服、发票处理和安全事件四类场景微调。
04
实验仓库与源码
文中的安装命令、验证脚本和测试过程都收录在开源实验仓库,直接 clone 就能跟着跑,不用逐段复制。
git clone https://github.com/li-xiu-qi/XiaokeAILabs.gitcd XiaokeAILabs/experiments/test_jev_open_source/laya目录里除了最小脚本 test_laya.py,还有几个专用脚本:laya-verify.py 导出四种题型的完整协议结构,laya-latency.py 记录冷启动、多题合并与显存占用基准,laya-direct.py 和 laya-pin.py 对应上一节的两组实测,laya-zh-en.py 跑 20 组双语平行对照,laya-scale.py 是 1 到 256 题的合并扩展基准,laya-common.py 是模型架构与置信度算法的本地复刻。脚本的原始终端输出都在 docs/logs/ 下,文中每个数字都能回溯到日志。
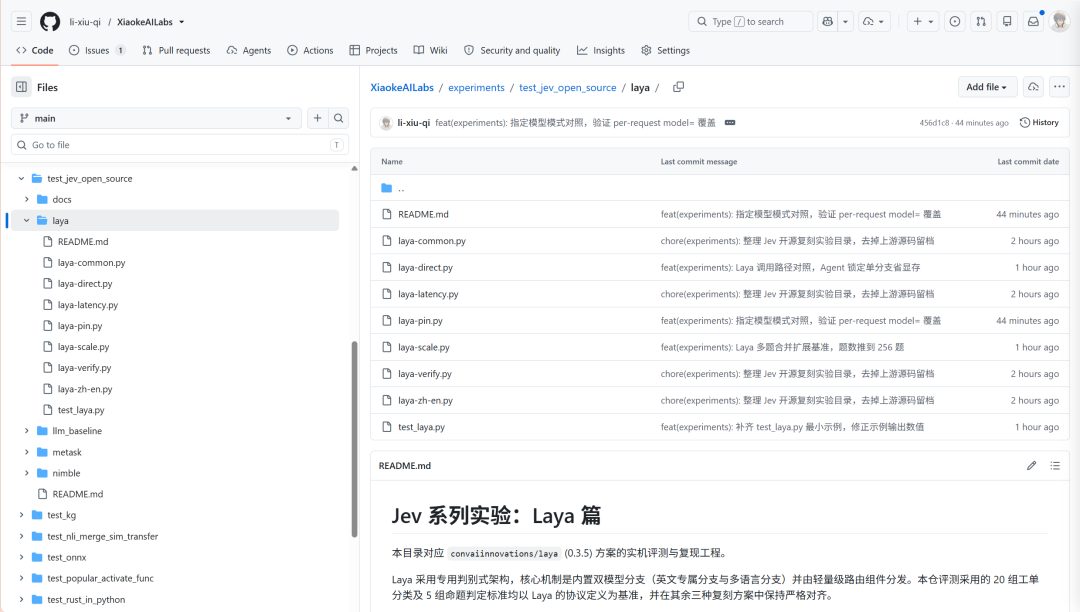
不想 clone 整个仓库、只想跑最小脚本的,可以直接打开单文件页面复制。
https://github.com/li-xiu-qi/XiaokeAILabs/blob/main/experiments/test_jev_open_source/laya/test_laya.py(https://github.com/li-xiu-qi/XiaokeAILabs/blob/main/experiments/test_jev_open_source/laya/test_laya.py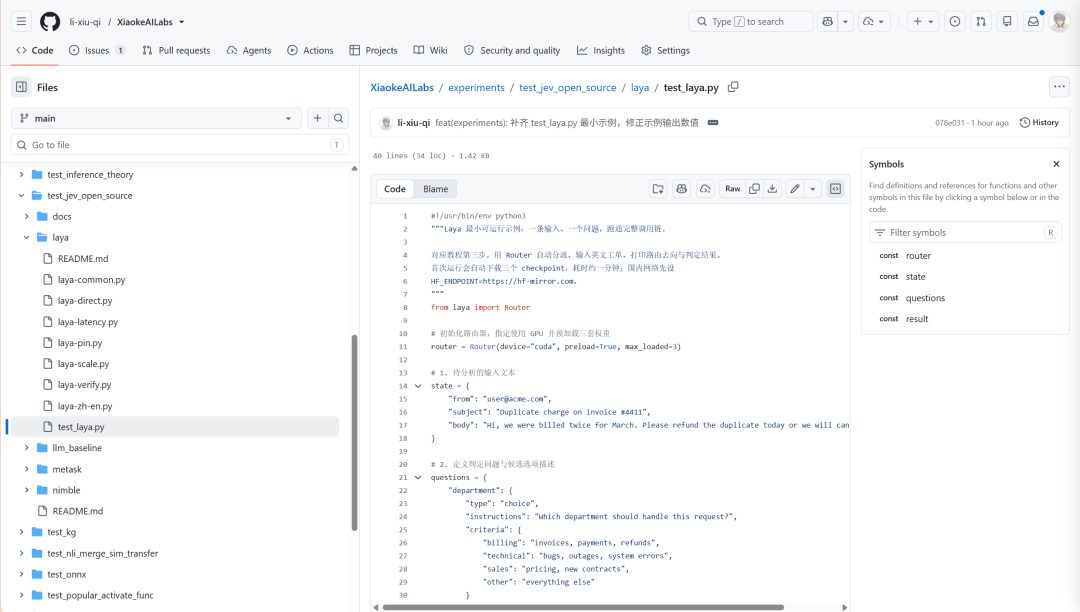
05
中文场景的注意事项
整理中文测试集并做中英双语对照时,有四点经验可以在落地时参考。
1. 分类准确度基本过关:客服场景的 20 组中英双语平行测试中,多语言版本的中文分类准确率为 95%,和英文主模型持平,日常工单分发能够胜任。
2. 多语言版本置信度容易偏高:实测中文样本的平均置信度为 0.866,高于英文样本的 0.506,个别分类错误的样本也给出 0.90 以上的高分。设计自动放行逻辑时,中文场景的拦截阈值建议提到 0.95 以上。
3. 是非题建议改成单选题:当前版本的 boolean 题型处理中文时,概率值会向中间压缩,容易漏判。二元判定需求可以直接定义成提供正反两个选项的单选题(choice),判定更稳健。
4. 服务启动后先预热:模型刚载入显存后的第一次前向受底层 CUDA 初始化影响,首条耗时可能达到 1.9 秒。业务接流量前先传一条测试文本空跑,后续请求就进入毫秒级。
06
写在最后
搭 Agent 流水线时,不是每个节点都需要自回归大模型。意图分类、参数分流、输入合规这类标准明确的判断,交给判别式轻量模型,可以把局部响应压到十几毫秒,也能省下 Token 开销。先把环境搭好、最小脚本跑通,再回头看它和大模型的分工边界,会清楚很多。
一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。