世界模型:应用与展望|世界模型读书会第八期
集智俱乐部 2026-10-08 10:00 浙江
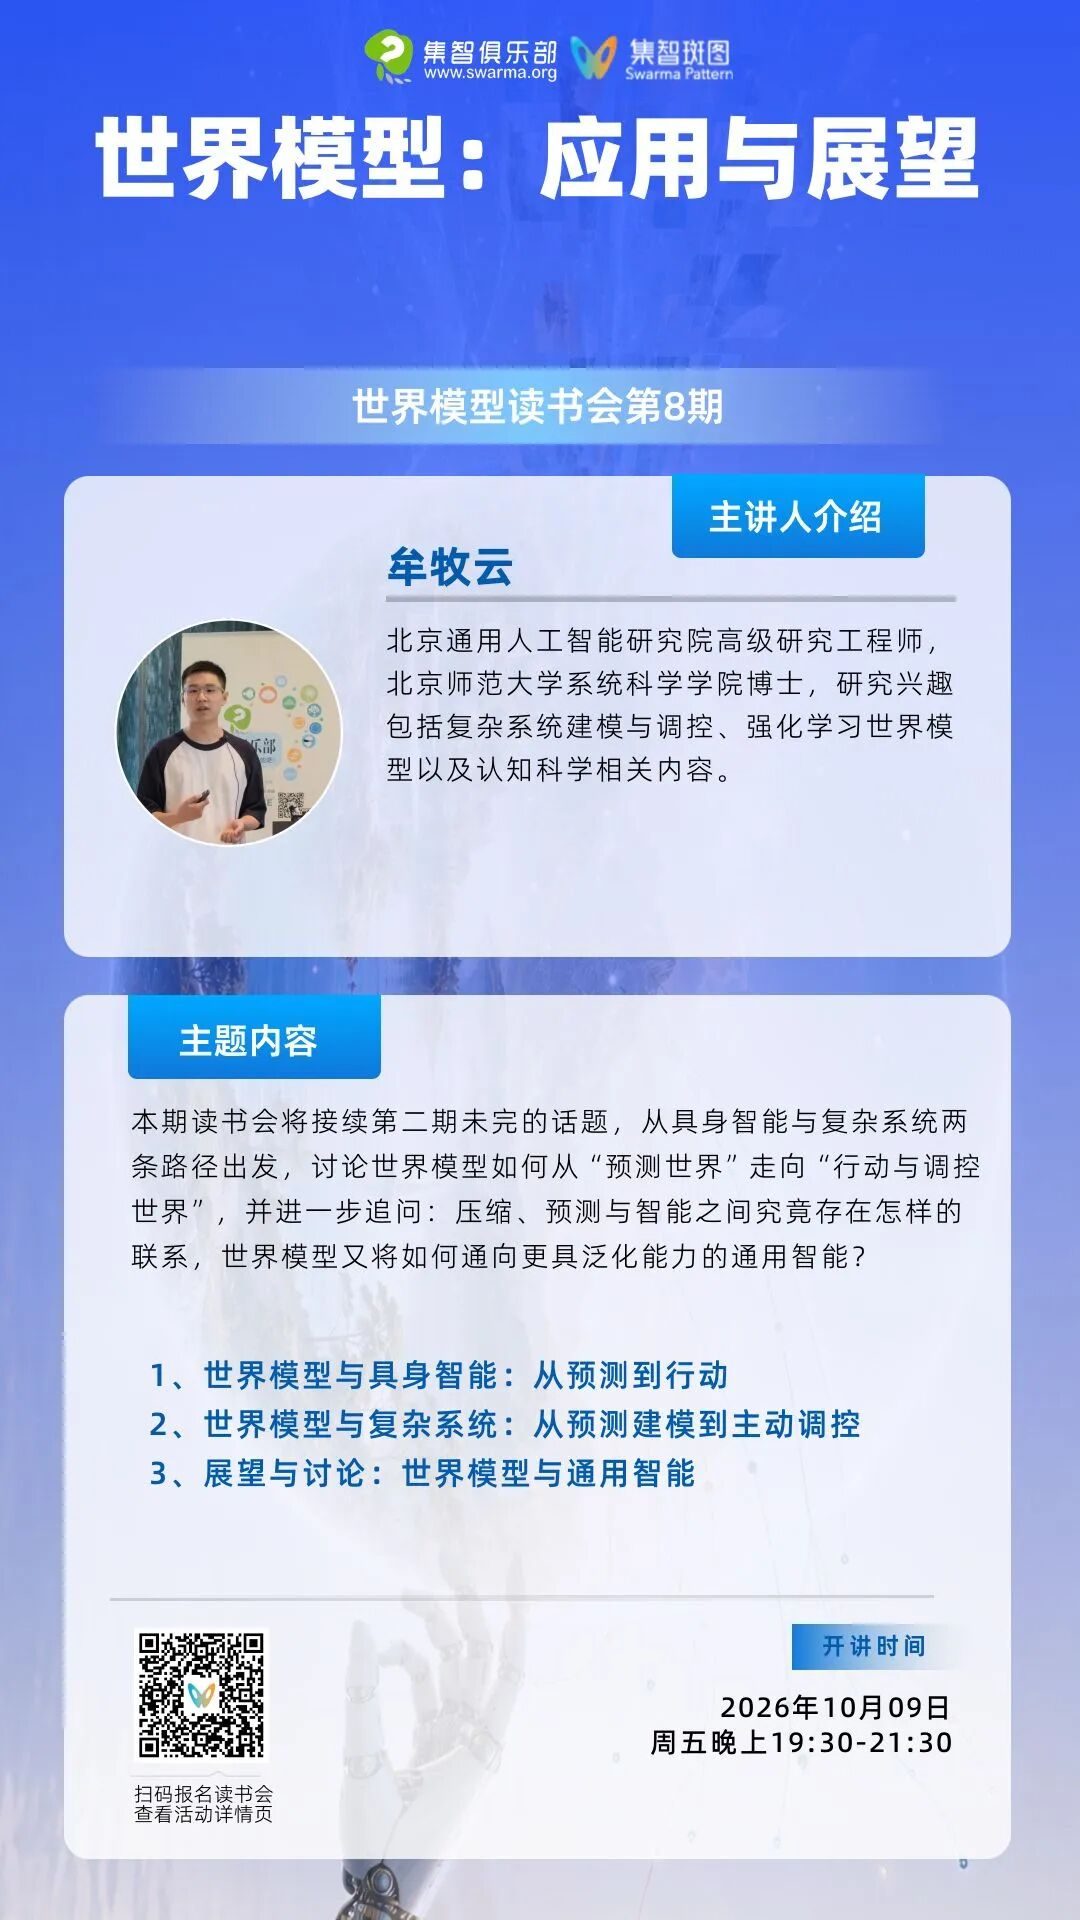
2026年10月8日(周五)晚上19:30-21:30分享
导语
世界模型的意义,不只是让智能体“预测接下来会发生什么”,更在于利用预测指导行动、干预并调控世界。当这一思路进入机器人、自动驾驶与复杂系统,世界模型也开始从内部表征走向真实世界中的决策与控制。
本期读书会为世界模型读书会读书会第8期,将接续第二期未完的话题,从具身智能与复杂系统两条路径出发,讨论世界模型如何从“预测世界”走向“行动与调控世界”,并进一步追问:压缩、预测与智能之间究竟存在怎样的联系,世界模型又将如何通向更具泛化能力的通用智能?
集智俱乐部联合认知科学、具身智能、AI Agent、复杂系统与高阶网络等领域的研究者发起「世界模型」读书会,围绕世界模型的思想源流、理论基础、技术路线与应用边界展开专题分享和讨论。读书会自2026年8月7日起,每周五晚19:30-21:30,将以“世界如何被表征、其动力学如何被建模、内部模型如何服务于智能体”为主线,尝试讨论整理世界模型统一框架。

报告简介
报告简介
在之前第二期的分享中,我们追溯了世界模型的思想源流——从亥姆霍兹的"无意识推理"、Craik 的"小尺度模型"到 Ashby 的"好调节器定理",并梳理了世界模型的计算范式——从 Dyna、PlaNet 到 Dreamer 系列,从生成式世界模拟器到 JEPA 潜空间预测路线。由于时间所限,第二期分享的后半部分未能展开:世界模型究竟如何在真实世界中落地?它如何与具身智能、复杂系统相结合?又将走向何方?本次分享将接续这一未完的话题,把目光从"思想与范式"转向"应用与展望"。
在具身智能领域,世界模型正在改变智能体学习与环境交互的方式。DayDreamer 让四足机器人无需仿真器、直接在真实世界中用一小时学会行走;GAIA-1 与 DriveDreamer 等生成式世界模型为自动驾驶构建了可控的"想象引擎",能够根据动作和文本条件生成多样化的驾驶场景。与此同时,RT-2 等视觉-语言-动作模型(VLA)将互联网规模的知识迁移到机器人控制。世界模型与 VLA 的合流,正在催生统一状态预测与动作生成的"世界动作模型"(World Action Models)这一新兴范式。
在复杂系统领域,世界模型的思想同样展现出独特价值。脑网络、交通流、传染病传播等真实复杂系统普遍面临三大挑战:动力学机制未知、干预实验成本高昂、状态与干预空间维度巨大。本次分享将介绍主讲人博士期间的三项递进式工作:其一,在已知网络结构下,基于图神经网络学习系统动力学,结合分层干预动作空间与模型预测控制实现高效调控;其二,在网络结构未知时,通过基于信息增益的主动干预探索,同时发现系统的网络结构与动力学方程,并结合符号回归还原可解释的数学形式;其三,针对高维系统,构建潜在状态-动作空间世界模型,通过状态与动作的粗粒化降低模型复合误差,在大脑神经网络调控、集群行为引导等任务上验证了方法的有效性。
面向未来,世界模型仍面临诸多根本性挑战:高维感知与部分可观测性、因果推理与相关性学习的鸿沟、长期依赖与记忆架构、组合泛化与抽象表征、系统性评估基准的缺失等。围绕这些挑战,本次分享最后将探讨四个话题:表征抽象的三层阶梯、世界模型与语言的结合、压缩、预测与智能之间的内在联系,以及仿真与 AI 深度融合所开启的科学研究新范式。
本次分享将尝试回答:
世界模型如何从"预测世界"走向"行动与调控世界"?它在具身智能与复杂系统中的应用面临怎样的挑战?预测、压缩与智能之间的关系,又将如何指引下一代通用智能系统的发展?
分享大纲
分享大纲
1. 世界模型与具身智能:从预测到行动
DayDreamer:让机器人直接在真实世界学习
自动驾驶中的生成式世界模型:GAIA-1 与 DriveDreamer
视觉-语言-动作模型(VLA)
从世界模型到世界动作模型(WAM):状态预测与动作生成的统一
2. 世界模型与复杂系统:从预测建模到主动调控
工作一:已知结构下基于观测与干预数据的复杂系统调控
工作二:基于主动探索的网络结构与动力学发现
工作三:基于潜在状态-动作空间世界模型的高维复杂系统调控
3. 展望与讨论:世界模型与通用智能
世界模型的九大挑战
表征抽象的三层阶梯:image-centric → object-centric → task/value-driven
语言与世界模型:用语言更好地预测未来
压缩、预测与智能:最小描述长度视角
仿真智能:科学计算 × 仿真 × AI 的融合路线图
核心概念
核心概念
世界模型(World Model):智能体对世界结构、状态变化和因果关系的内部建模,用于预测、规划和行动。
视觉-语言-动作模型(Vision-Language-Action Model, VLA):将机器人动作表示为 token,与视觉-语言数据联合训练,实现互联网知识向机器人控制的迁移。
世界动作模型(World Action Models, WAM):统一预测性状态建模与动作生成的具身基础模型,对未来状态与动作的联合分布建模。
图神经网络动力学模型(GNN Dynamics Model):利用网络结构归纳偏置学习复杂系统的状态转移规律。
主动探索与信息增益(Active Exploration & Information Gain):通过主动设计干预实验最大化模型不确定性约减,加速科学发现。
潜在状态-动作空间世界模型(Latent State-Action World Model):在粗粒化的潜在空间中学习世界演化与干预效果,应对高维复杂系统。
主讲人介绍
主讲人介绍
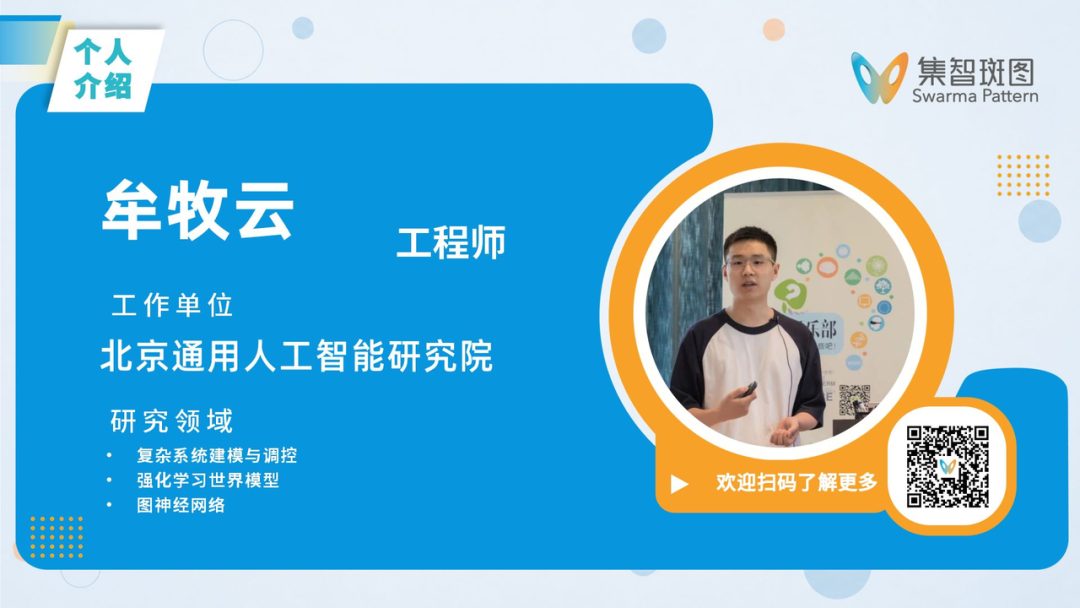
主讲人:牟牧云,北京通用人工智能研究院高级研究工程师,北京师范大学系统科学学院博士,研究兴趣涵盖复杂系统建模与调控、强化学习与世界模型、具身智能以及认知科学等领域。
参考文献
参考文献
Yu X, Zhang Y, Wang M, et al. From Seeing to Knowing the World: A Survey of Vision World Models[J]. 2026.
Wang S, Shi J, Fu Z, et al. World action models: The next frontier in embodied ai[J]. arXiv preprint arXiv:2605.12090, 2026.
Mou M, Guo Y, Luo F, et al. Model predictive complex system control from observational and interventional data[J]. Chaos: An Interdisciplinary Journal of Nonlinear Science, 2024, 34(9).
Wu P, Escontrela A, Hafner D, et al. DayDreamer: World models for physical robot learning[C]//Conference on Robot Learning (CoRL). PMLR, 2023.
Hu A, Russell L, Yeo H, et al. GAIA-1: A generative world model for autonomous driving[J]. arXiv preprint arXiv:2309.17080, 2023.
Wang X, Zhu Z, Huang G, et al. DriveDreamer: Towards real-world-driven world models for autonomous driving[C]//European Conference on Computer Vision (ECCV). Springer, 2024.
Brohan A, Brown N, Carbajal J, et al. RT-2: Vision-language-action models transfer web knowledge to robotic control[J]. arXiv preprint arXiv:2307.15818, 2023.
Wang S, Shi J, Fu Z, et al. World action models: The next frontier in embodied AI[J]. arXiv preprint, 2025.
Lin J, Du Y, Watkins O, et al. Learning to model the world with language (Dynalang)[C]//International Conference on Machine Learning (ICML). PMLR, 2024.
Lavin A, Zenil H, Paige B, et al. Simulation intelligence: Towards a new generation of scientific methods[J]. arXiv preprint arXiv:2112.03235, 2021.
时间信息
时间信息
2026年10月8日(周五)晚上19:30-21:30,腾讯会议线上进行。
感兴趣的朋友扫码报名加入世界模型读书会后,可进入学员群进行交流。
报名读书会:「世界模型」
报名读书会:「世界模型」
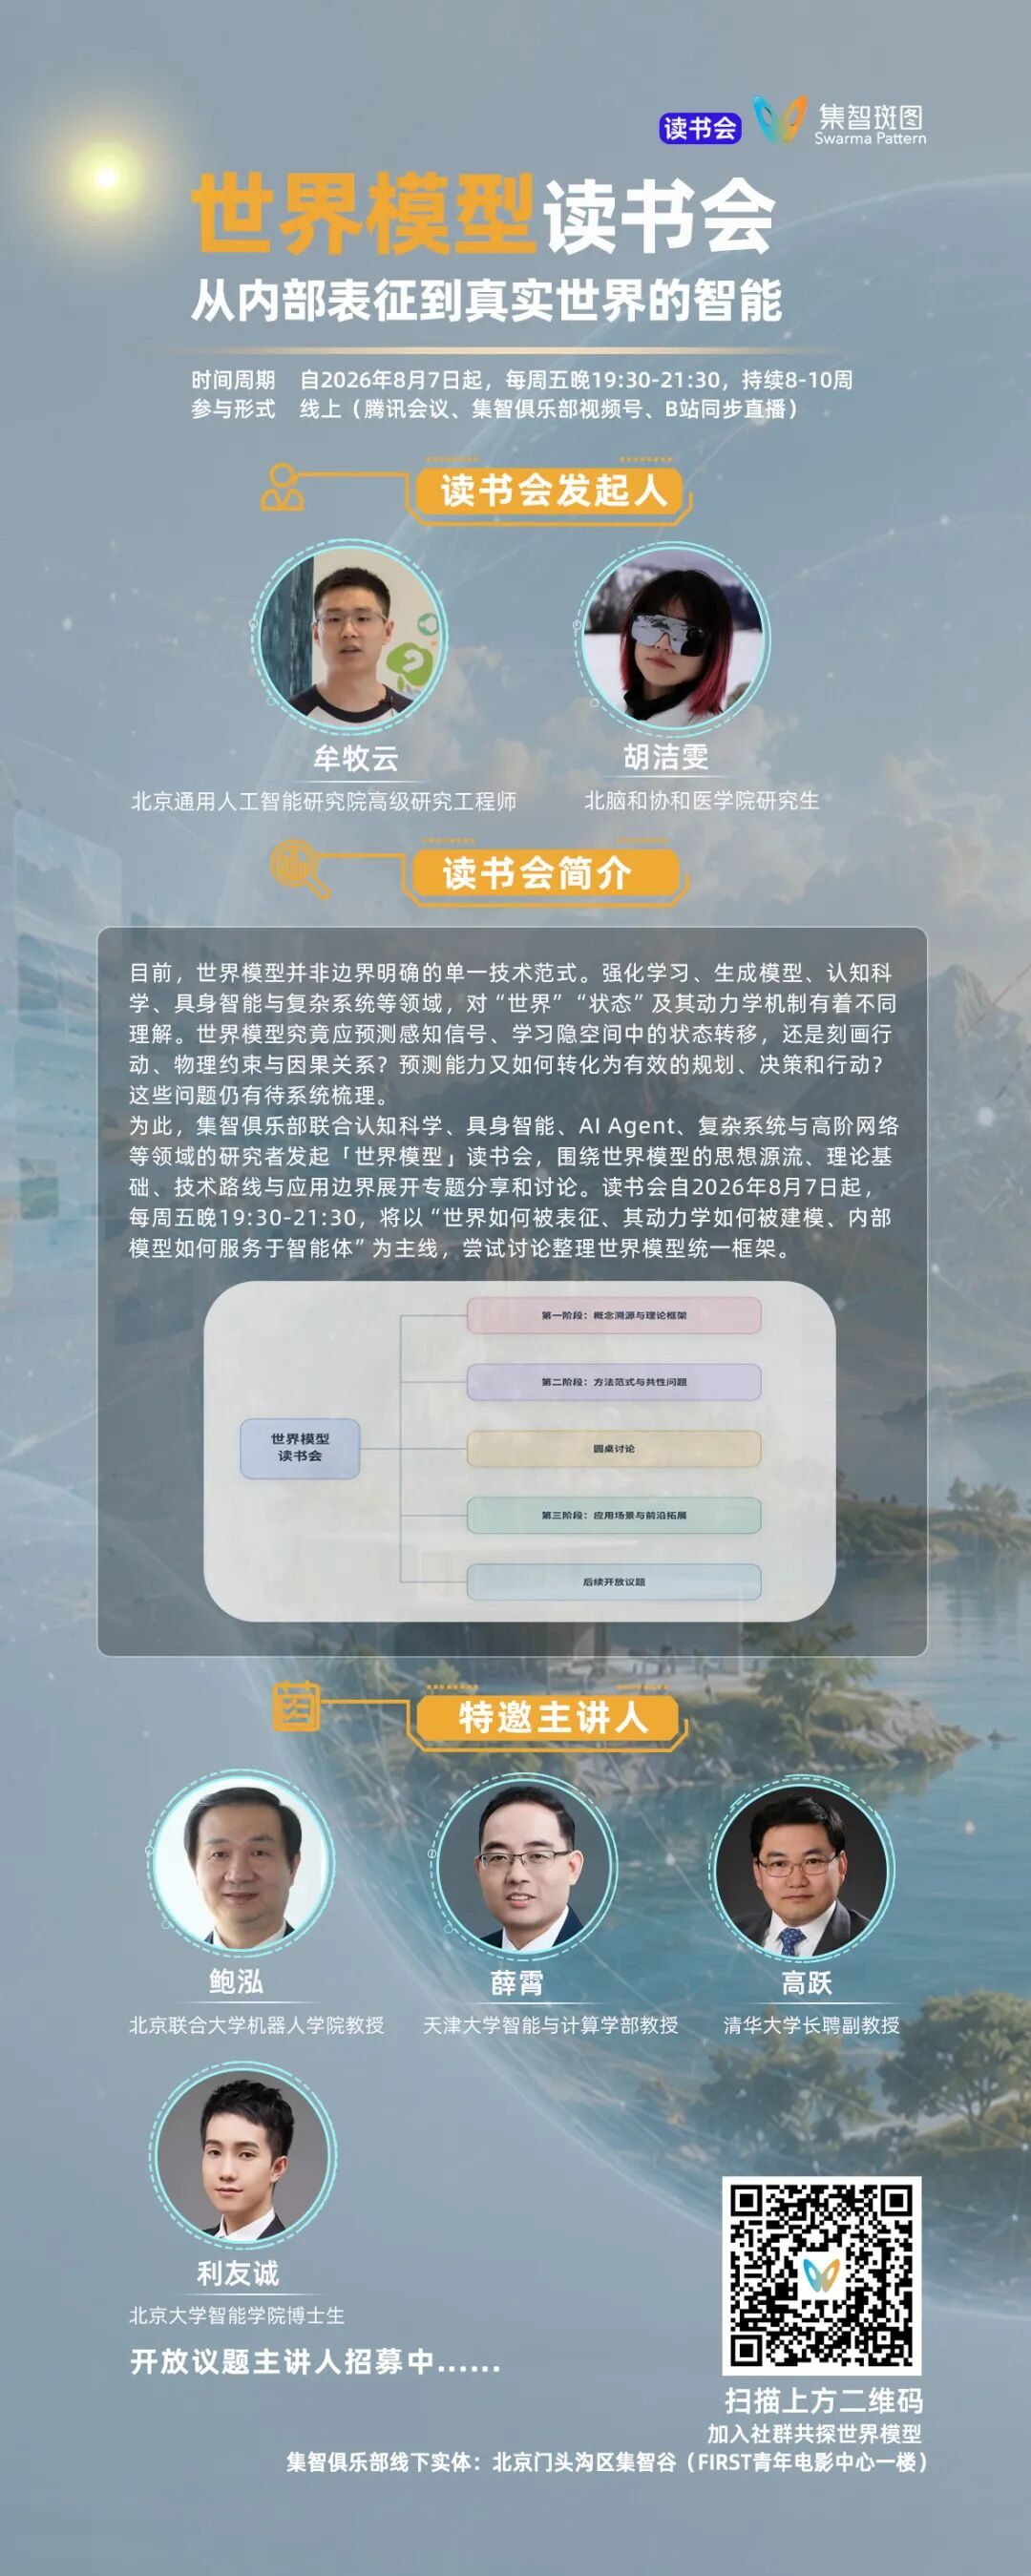
集智俱乐部联合北京通用人工智能研究院高级研究工程师牟牧云、北脑和协和医学院研究生胡洁雯共同发起「世界模型:从内部表征到真实世界的智能」读书会,围绕世界模型的思想源流、理论基础、技术路线与应用边界展开专题分享和讨论。
读书会自2026年8月7日起,每周五晚19:30-21:30线上开展,持续8-10周,包含主讲分享与讨论交流,并提供会后视频回放,诚邀相关领域研究者及跨学科兴趣者参与。
扫描海报中二维码报名参加读书会
报名方式
第一步:微信扫码填写报名信息。
扫码报名
第二步:填写信息后,付费报名。如需用支付宝支付,请在PC端进入读书会页面报名支付:
第三步:添加运营助理微信,拉入对应主题的读书会社区(微信群)。
PS:
我们鼓励围绕复杂系统、人工智能及相关具体问题的深入探讨。为保证讨论质量,请避免发表脱离本期读书会主题、缺乏实证基础或过于空泛的哲学思辨类内容。
若讨论内容明显偏离主题,经主持人提醒后仍未调整,为维护整体学习环境,我们将不得不将该成员请出讨论群,并根据其实际参与进度,对未参与部分按比例办理退费。
感谢您的理解与配合,让我们共同营造一个专注、深入、有收获的共学空间。
加入社区可享核心资源
成为会员即可解锁完整学习生态,包括:线上实时问答、全部课程录播回看、独家资料共享、高质量社群交流、第一手信息同步,以及通过参与共创任务获取积分等权益。
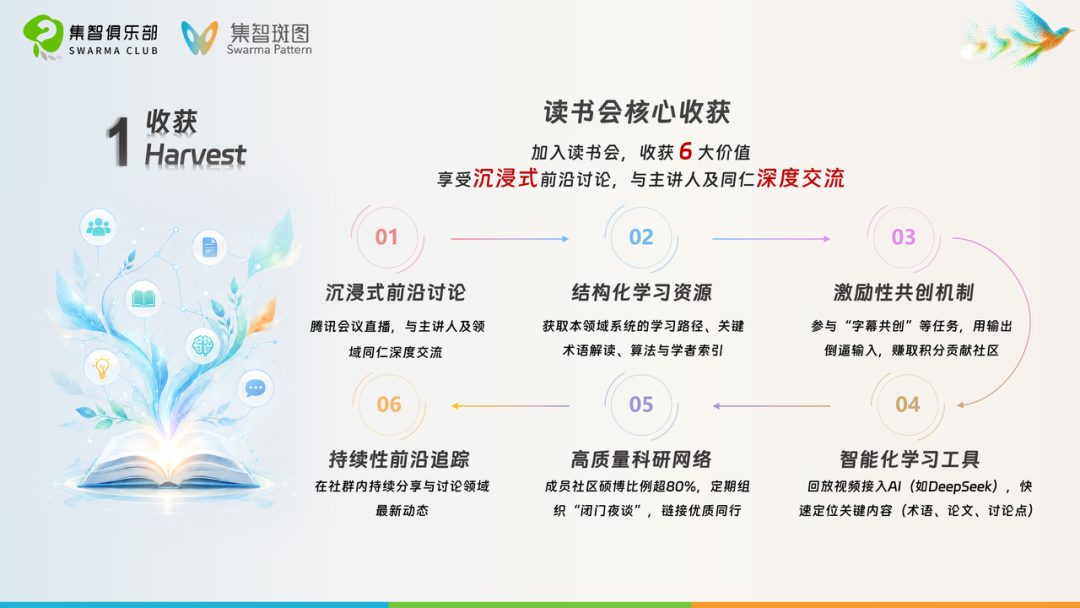
特色退费与激励机制
我们提供以下两种途径,让您的投入获得实际回馈:
任务达标退费路径
认领并合格完成任意两期字幕任务,即可退还全额报名费,并额外获得集智专属周边奖励。
运营成长激励路径
合格完成一个字幕任务后,可申请成为运营助理。在读书会项目顺利结项后,将退还学费。表现优异者,还有机会获得额外的奖学金。
相关内容推荐
相关内容推荐
「世界模型」读书会推荐阅读材料
扫描下方二维码可跳转至集智斑图网站阅读文章:《世界模型》读书会推荐阅读材料。
往期公众号相关内容推荐
什么是世界模型?为什么Sora不是 world simulator?
arXiv:OpenLife——开放世界人工生命的互动,如何驱动社会科学
点击“阅读原文”,报名读书
本文转载自微信公众号「集智俱乐部」,查看原文。版权归原作者所有,如有侵权请联系删除。