8GB显存就够,Strata 让普通电脑也能运行千亿参数大模型
原创 青小蛙 2026-10-10 16:03 四川
青小蛙帮你们试过了,可行!
RTX 5070、RTX 3060、RTX 4060 Ti、RX 9070 XT、RX 9060 XT、RX 7800 XT、RTX 3090,甚至多年前的 Quadro RTX 4000 和 TITAN RTX...
以上这些常见的显卡,只要有 8GB 显存、16GB 内存(极限测试,最低推荐32GB内存),一台普通电脑,就有机会在本地运行拥有 1250 亿参数的大模型 Qwen3.8-Flash-Next。
这就是最近几天,开源项目 Strata 带来的震撼:
https://github.com/Niko1221/Strata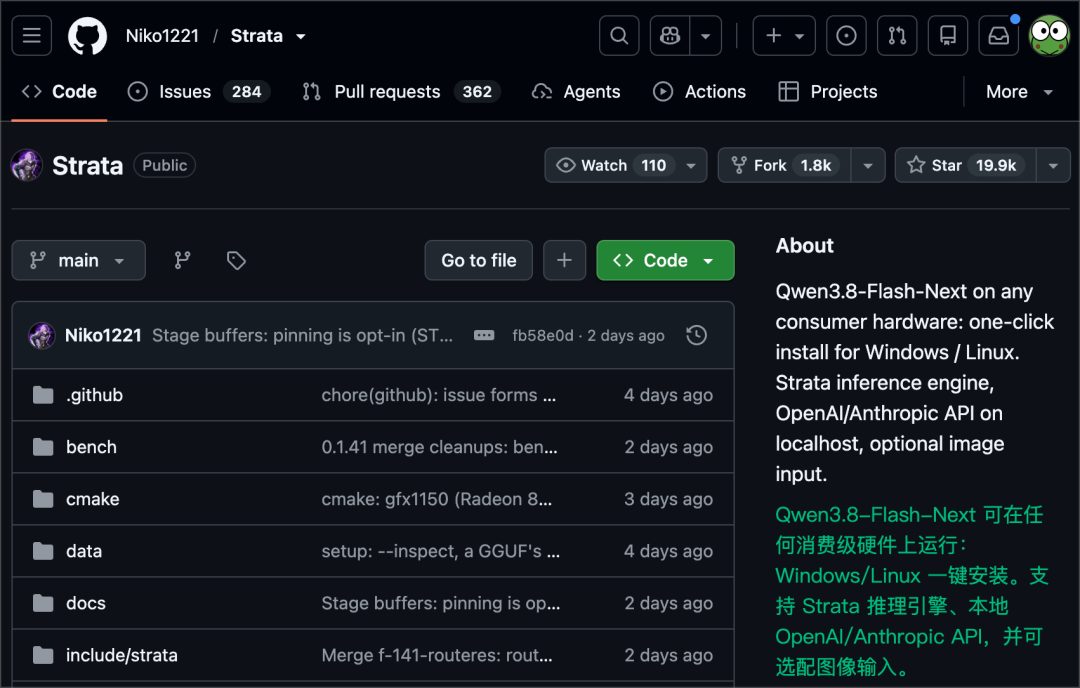
甚至,青小蛙觉得,这可能是普通人,第一次能够在普通电脑上,以如此低的硬件门槛,运行一个真正「能用起来」的千亿参数大模型。
8GB 显存,究竟能运行多强的大模型?
Qwen3.8-Flash-Next 是 Qwen 在 2026年8月发布的开源模型,1250 亿参数,在部分编程和推理测试中,成绩已经超过 Claude Opus 4.6。
不过,8GB 显存显然无法运行完整的 Qwen3.8-Flash-Next,即使经过压缩,模型仍然需要几十 GB 的存储空间。
Strata 将模型的一部分放到系统内存之中,甚至还有一部分放到 SSD 中,这样显卡内存的需求量就没那么大了。
于是普通电脑才有了机会。
Strata 的用户反馈了非常多的测试结果:
显存 | 显卡型号 | 系统内存 | 模型版本 | 生成速度 |
|---|---|---|---|---|
| 8GB | RTX 4060 Ti | 32GB | Coder IQ1_M | 19~21 tok/s |
| 8GB × 2 | Quadro RTX 4000 × 2 | 96GB | Swift IQ2_XS | 18~23 tok/s |
| 12GB | RTX 3060 | 64GB | IQ3_XXS | 30 tok/s |
| 12GB | RTX 5070 | 64GB | Q2_0 | 94 tok/s |
| 12GB | RTX 5070 | 64GB | IQ3_S | 53 tok/s |
| 16GB | RX 7800 XT | 约 121GiB | Coder IQ1_M | 38~44 tok/s |
| 16GB | RX 9060 XT | 64GiB | Coder IQ1_M | 27.1 tok/s |
| 16GB | RX 9070 XT | 47GB | Q2_0 | 60 tok/s |
| 16GB | RTX 4060 Ti | 96GB DDR3 | Q2_0 | 48.1~55.8 tok/s |
| 16GB | RTX 4060 Ti | 96GB DDR3 | IQ3_S | 30.5~35.1 tok/s |
| 24GB | RTX 3090 | 64GB | IQ3_XXS | 50~60 tok/s |
| 24GB | RTX 3090 | 64GB DDR4 | IQ3_S | 60~77.9 tok/s |
| 24GB × 2 | TITAN RTX × 2 | 125GiB | IQ3_S | 70.9~77.3 tok/s |
在本地运行大模型,最重要的体验就是生成速度了,青小蛙觉得能达到40tok/s就可以用了,60tok/s以上则非常流畅。
但是!
Strata 虽然对显卡要求不高,但是对内存要求极高。
三个门槛:
1. 32GB 内存:入门级。适合运行经过大幅压缩的 Coder 等精简模型,需要牺牲部分模型能力。
2. 48GB 内存:进阶级。可以尝试 Q2_0、IQ2_XS 等低精度量化版本,保留完整的专家结构。
3. 64GB 内存:推荐级。可以运行 IQ3_XXS、IQ3_S 等更高精度的量化版本,更适合日常使用。
4. 96GB 内存:高配级。可以尝试 IQ4 等更高精度的模型,进一步减少量化带来的能力损失。
而需要360GB显存的原始 Qwen3.8-Flash-Next 模型,在部分编程测试中已经超过 DeepSeek-V4-Flash,甚至在部分项目中领先 Claude Opus 4.6。
虽然没办法直接比较模型能力,青小蛙觉得入门级的 Strata 也足够一般家庭的大模型使用了,比如跑个龙虾在家运行小任务、智能家居、智能问答、处理文档、识别图片等等。
最重要的是,只需要电费,完全不需要任何 API 费用,并且不限量。
推荐给有显卡的各位试试。
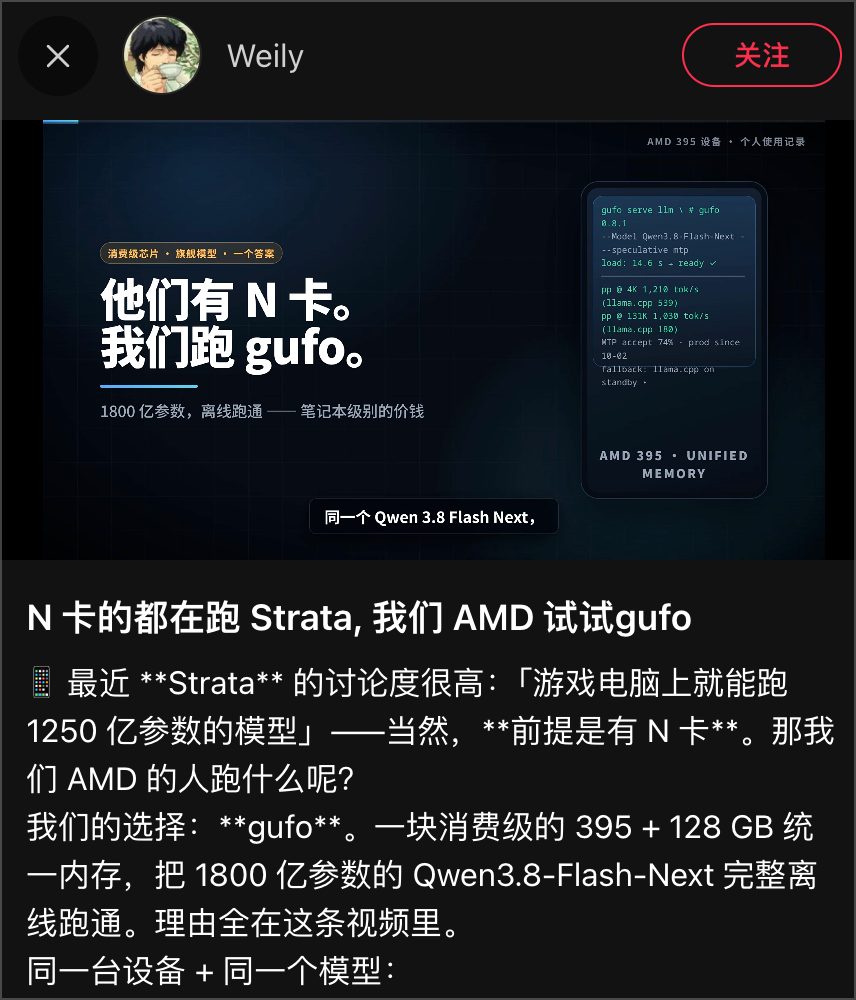
N卡的都在跑 Strata,我们 AMD 试试gufo
是的了,AMD 也有自己的 Strata:
本文转载自微信公众号「小众软件」,查看原文。版权归原作者所有,如有侵权请联系删除。