RSI全景综述来了!从Prompt到自动科研,四大技术路线全梳理
原创 让你更懂AI的 2026-10-09 12:11 北京
一文搞懂RSI的定义、闭环与研究版图
Iteration ≠ RSI。真正的关键不是“改过”,而是被验证的改进能否跨轮次继承,并成为下一次改进的起点。
大语言模型正在从回答问题走向自主执行任务。Agent 已经能够调用工具、执行代码、运行实验,并根据反馈修改 Prompt、Memory、Workflow,甚至自身代码。
AI 系统开始参与自身的优化过程,人工智能自我改进正在从理论设想走向可实现的工程系统。但单次修改带来的性能提升,并不足以说明系统已经实现递归自我改进。
Recursive Self-Improvement(RSI)关注的是:一次改进能否被验证和保留,并被后续的改进循环继续继承。
论文标题:
Towards AI That Improves Itself: A Survey of Recursive Self-Improvement
作者机构:
哈尔滨工业大学(深圳)、香港大学、新加坡国立大学、上海创智学院
论文地址:
https://openreview.net/forum?id=I3fKQbRUGy¬eId=I3fKQbRUGy
项目地址:
https://lee1003-lee.github.io/Awesome-RSI-Research/
针对这一问题,本文系统梳理了递归自我改进的定义、系统结构与现有方法。
现代 RSI 的关键已经不只是生成更好的修改,而是判断哪些修改值得被保留。被接受的改进还需要进入后续循环,并在新的任务和评测条件下继续有效。
RSI 是什么?
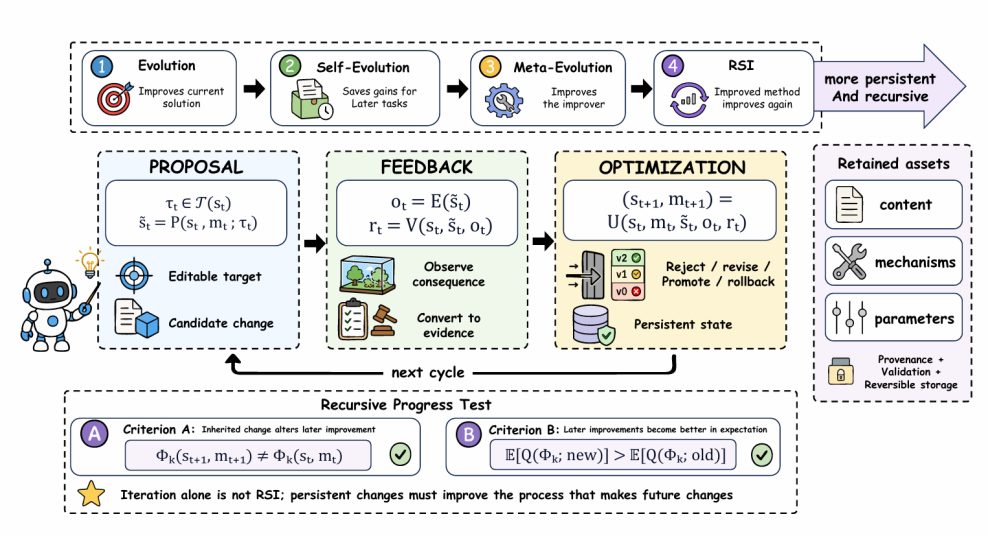
首先,作者将RSI相关系统区分为 Evolution、Self-Evolution、Meta-Evolution 和 Recursive Self-Improvement 四类。
Evolution:只改当前结果。系统通过反思、搜索、重写或重规划,让当前答案、轨迹或任务产物变得更好,但修改不会作为持久状态进入后续任务。Self-Refine、局部搜索等机制通常属于这一层。
Self-Evolution:改进被保留并复用。一次被接受的改进会进入记忆、技能、规则、Prompt、工作流或版本状态,并影响后续任务。
Meta-Evolution:连“如何改进”也发生变化。被接受的修改作用于 proposer、verifier、updater、harness、搜索规则或 curriculum 等改进机制本身。
RSI:后续改进循环从上一轮已接受的改进状态继续出发。
本文把跨循环的 state inheritance(状态继承)作为 RSI 的可审计边界:后一轮 Proposal–Feedback–Optimization 不再从同一个 base state 重新开始,而是显式加载并建立在上一轮被验证、被保留的改进之上。
在此基础上,论文进一步区分了 minimal RSI 与 recursive progress。
前者只要求“被接受的改进被后续改进循环继承”;后者则提出更强的证据要求:继承下来的变化,不仅让后续任务表现更好,还应当让后续的“改进过程本身”变得更有效。
也就是说,真正强意义上的递归进步,不只是 AI 变强,而是 AI 变得更擅长让自己继续变强。
统一闭环:Proposal → Feedback → Optimization
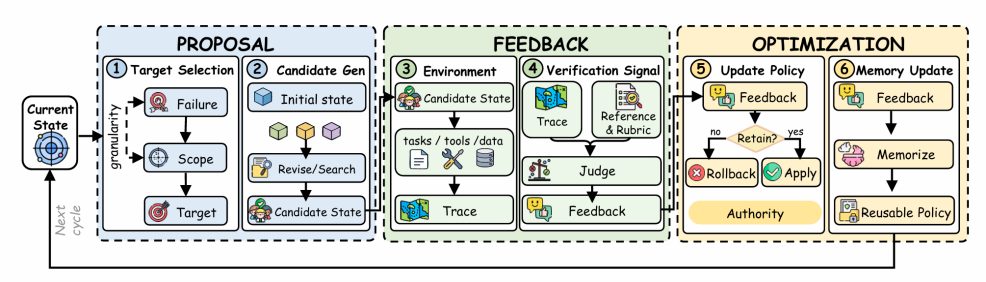
论文提出 Proposal → Feedback → Optimization(PFO)三阶段闭环。
Proposal:确定优化目标与改进方式
Proposal 阶段由 Target Selection 与 Candidate Generation 组成。
前者负责确定可编辑目标及其粒度,例如 Prompt、记忆条目、技能、工具策略、源代码模块、数据策略或研究决策;后者负责生成候选修改,可以来自文本修订、搜索、进化、程序合成、学习或自动实验。
Feedback:执行结果不等于证据
Feedback 阶段把 Execution Environment 与 Verification Signal 明确分开。
环境负责让候选修改真正运行起来,产生轨迹、测试结果、训练结果、资源消耗或副作用;验证器再根据 reference、rubric 与 judge 判断这些结果是否构成“改进证据”。
Optimization:决定什么能留下来
Optimization 阶段包含 Update Policy 与 Memory Update。
验证器只负责提供证据,真正决定候选是 retain、revise、reject、promote 还是 rollback 的,是更新策略;而 Memory / Versioning 则负责把经过验证的内容、机制或参数带入下一轮。
四条技术路线
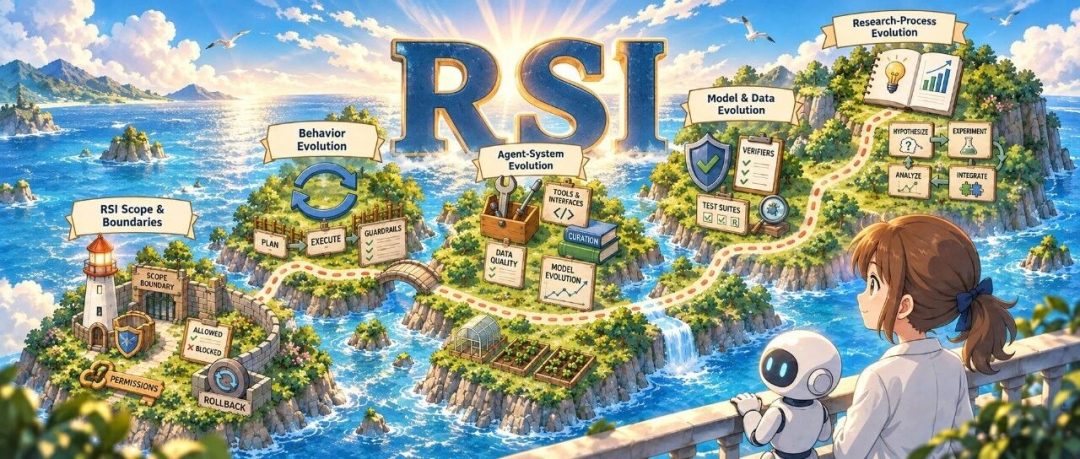
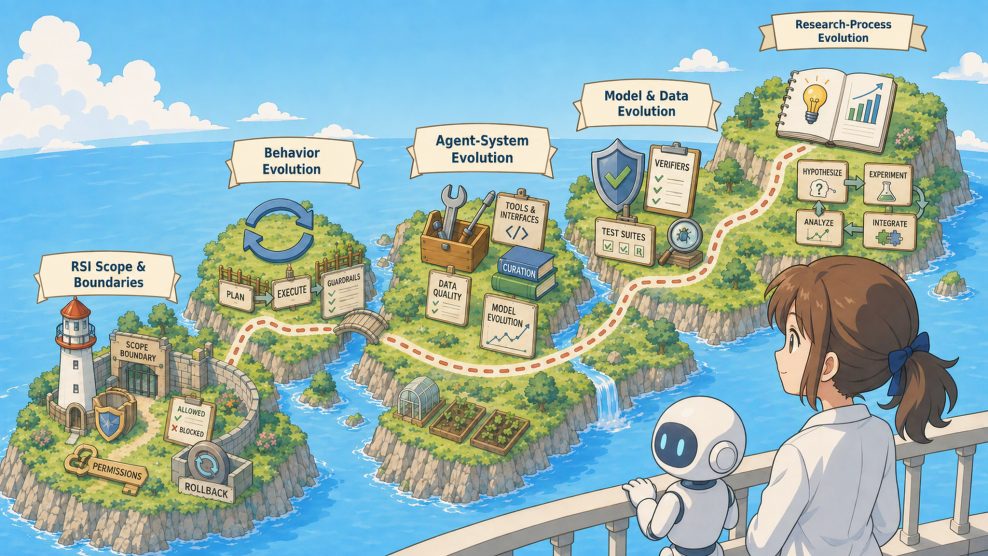
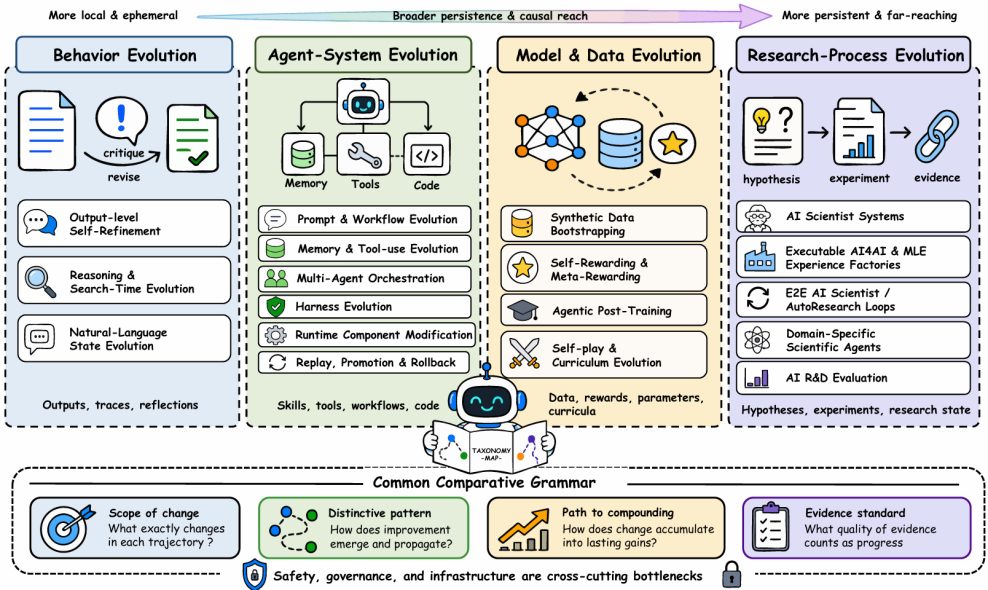
论文进一步按照改进对象梳理现有工作,形成 Behavior、Agent-System、Model & Data、Research-Process 四类演化目标。
这四类演化目标从局部、短暂的行为修正,逐步扩展到更持久、影响范围更广的系统级变化。
Behavior Evolution
行为演化主要包括输出级 self-refinement、reasoning / search-time evolution 和 natural-language state evolution。
Self-Refine、Tree of Thoughts、LATS、Reflexion 等工作通过反馈、搜索和反思改进当前行为。当这些经验进一步转化为可复用的规则、记忆或技能,并在后续任务中继续发挥作用时,局部优化开始走向持久改进。
Agent-System Evolution
Agent-System Evolution 将修改范围扩展到 Prompt、Workflow、Memory、Tool-use、Multi-Agent Orchestration 和 Harness 等系统组件。
相比直接修改模型权重,这类方法可以在模型保持不变的情况下持续优化 Agent 的工作流、工具和记忆机制,同时更容易验证和回滚。
Model & Data Evolution
Model & Data Evolution 将改进进一步写入 synthetic data、reward、model parameters 和 curriculum,使局部经验能够转化为更持久的模型能力。
但一旦 verifier 错误、奖励漏洞或污染数据进入训练,也可能被模型继承并传播,因此需要独立验证和 held-out evaluation。
Research-Process Evolution
Research-Process Evolution 将改进对象扩展到科研流程。系统可以提出假设、设计和执行实验、分析结果,并根据反馈调整下一步研究方向,关键仍在于一次研究循环中的有效改进,能否被后续循环继承并继续产生作用。
更严格的证据协议
当系统可以持续修改自己时,传统的单次 benchmark score 很容易失去解释力。一个更高的分数,可能来自更多 compute、更宽的 search、更强的 base model,甚至来自 evaluator 被“学会了”。
因此,本文给出了 Operational RSI Claim Protocol,试图把“RSI 声明”变成可以审计的实验记录。
1. 状态与干预:明确旧状态、新状态、具体修改组件、允许的 mutation scope,以及为什么这个修改被接受;后一轮必须能够证明自己确实加载或依赖了这份被保留状态。
2. 反事实对照:与 frozen incumbent、no-retention ablation 或 best-so-far ancestor 比较;除非某项资源本身就是研究变量,否则模型、工具、数据、搜索宽度、时间预算与人工审核预算应尽量匹配。
3. Replay 与 Transfer:跨循环重放已成功和已失败案例,检查持久性与回归;再在 held-out task、environment、seed 或 judge 上测试是否真正迁移。
4. 统计证据:随机性显著时应报告多次运行、方差或置信区间;单次成功更适合作为 demonstration,而不是 recursive progress 的充分证据。
5. 失败标准:如果所谓增益在 matched compute 下消失、依赖更强基础模型、仅来自更多搜索,或只提升了用于 admission 的 evaluator,就不能据此声称改进器本身获得了递归增益。
对于动态环境和会变化的 evaluator,论文建议把评测拆成三部分:frozen replay slice 用于跨轮次可比性,adaptive slice 用于持续发现新弱点,delayed held-out slice 用于检验迁移。
七个前沿问题
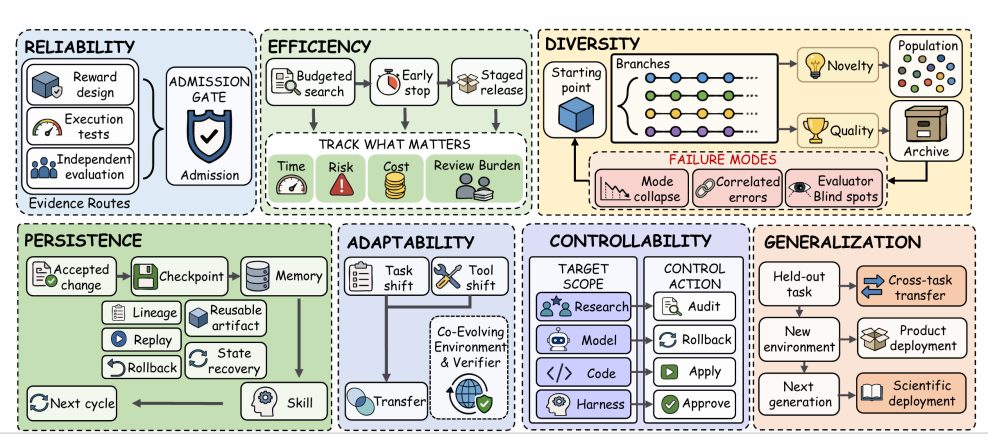
在未来方向部分,论文给出七个彼此关联的维度:Reliability、Efficiency、Diversity、Persistence、Adaptability、Controllability 与 Generalization。
Reliability|可靠性。RSI 需要区分真实改进与对 reward、rubric 或 judge 的投机。False positive 可能被写入 memory、skill library 或 training data,并在后续循环中持续传播和强化。
Efficiency|效率。递归改进需要在有限的计算、时间和人工审核预算下进行。除了最终性能,还需要关注运行时间、失败尝试和单位资源带来的实际收益。
Diversity|多样性。候选方案需要保持足够的差异,避免搜索长期集中在相似思路上。多智能体、种群搜索等机制可以扩大探索范围,同时需要避免表面多样但实际同质。
Persistence|持久性。有效改进需要跨任务、跨版本持续保留,同时避免过期记忆、错误技能和状态污染。版本记录、replay、rollback 和 best-so-far recovery 是实现持久改进的重要机制。
Adaptability|适应性。RSI 需要适应不断变化的环境和 verifier,同时保持不同改进轮次之间的可比性。稳定评测与自适应评测需要承担不同作用。
Controllability|可控性。不同层级的修改需要对应不同的权限和验证强度。系统需要通过 sandbox、release gate、monitoring 和 rollback 等机制限制高影响修改,并保持关键验证与安全边界的独立性。
Generalization|泛化。可信的改进需要迁移到产生它的任务和 evaluator 之外。除了任务内和跨领域迁移,更强的目标是让改进后的系统在新环境中仍然能够产生更好的后续改进。
这篇工作在回答什么问题
这篇综述试图回答一个正在快速变得现实的问题:当 AI 已经能够参与代码修改、工具调用、模型训练和科研实验时,我们应该如何区分反复尝试与真正的递归自我改进?
本文给出的答案可以概括为三层:
第一,用 Evolution → Self-Evolution → Meta-Evolution → RSI 划清概念边界,并把 state inheritance 作为 RSI 的最低结构条件;
第二,用 Proposal → Feedback → Optimization 统一描述不同自我改进系统的闭环机制;
第三,用 behavior、agent system、model & data、research process 四类目标和七个前沿维度,重新组织现有研究并提高 RSI 声明所需的证据门槛。
其中最重要的转变,是将关注点从系统是否发生自我修改,转向修改为何被接受、能否被可靠保留和跨循环继承、能否迁移到新任务,以及是否真正提升后续的改进能力。
过去的 RSI 更多停留在机器能否持续提升能力的理论讨论,而今天,研究重点正在走向如何构建能够可靠验证、持续继承并不断积累有效改进的系统,让自我改进真正变得可验证、可持续、可迁移、可控制。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。