让 AI 既“看懂”又“画好”:Visual Tokenizer 如何走向统一?
原创 52CV 2026-10-12 23:37 江苏
让 AI 描述一张图片,或者根据一句话生成图片,已经越来越常见。
但如果给它一张照片,再说一句“把桌上的红色杯子改成蓝色,其他地方保持不变”,问题就变得复杂了。
它需要知道哪个物体是杯子,也需要保留杯子的形状、桌面的纹理、背景的光照。
这时,语义理解与视觉细节必须同时发挥作用。
在这些能力背后,有一个基础问题:
图像进入模型时,究竟被转换成了怎样的表示?
这正是 Visual Tokenizer 研究的核心。它将图像、视频乃至三维内容,转化为模型能够处理的 token。这个过程影响着模型能够获得哪些视觉信息,也影响着后续理解与生成的难度。
论文标题: Visual Tokenizers: A Comprehensive Survey
GitHub:https://github.com/Shi-qingyu/Awesome-Visual-Tokenizer
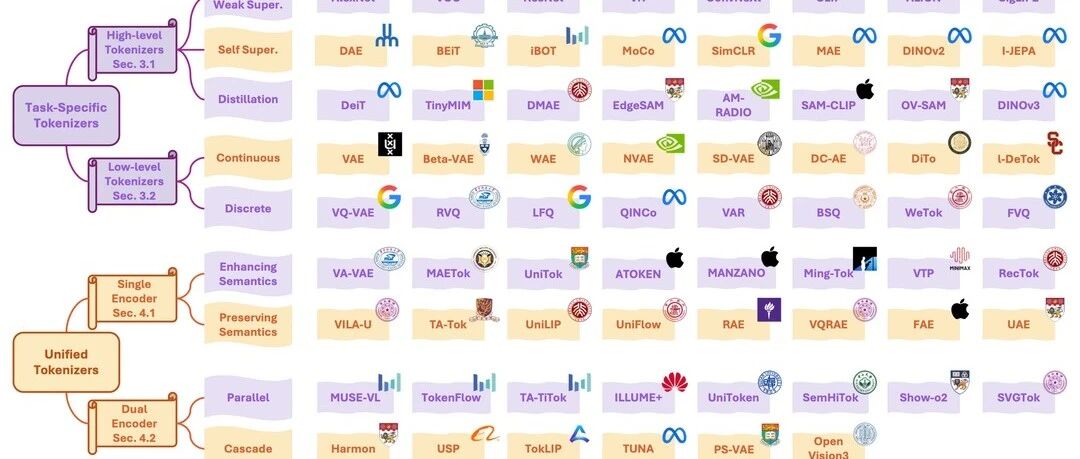
围绕这一方向,我们的综述系统梳理了视觉 tokenizer 的发展,尝试回答:语义理解与视觉重建为什么需要不同的表示?两条技术路线如何走向统一?怎样评价一套视觉 token 是否足够好?
整篇综述围绕一个核心问题展开:
如何让同一套视觉 token,在有限的表示容量里,同时保留“这是什么”和“它具体长什么样”?
为什么视觉模型需要 Tokenizer?
一张图片包含大量像素;视频还增加了时间维度;三维内容则涉及空间位置与几何结构。
要让这些信息进入基于 token 的模型,需要先决定:用什么作为基本单元,怎样组织它们,以及怎样将它们转换为可处理的特征。
可以把 tokenizer 理解为视觉信息进入模型时的一道表示接口:
视觉输入 → 编码信息 → Bottleneck约束 → 视觉 token → 下游理解或生成任务
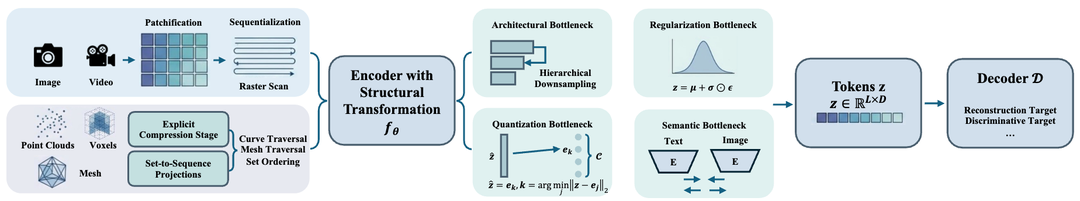
论文从编码器、信息瓶颈,以及解码或监督端三个角度分析这一过程。
编码器负责提取信息;信息瓶颈决定表示容量及其约束;解码或监督目标则影响 token 最终保留什么。
这里的视觉 token 可以是连续向量,也可以是离散符号。对于理解型模型,监督端可以是分类头或图文投影头;对于重建型模型,它则需要将表示恢复为图像。
不同设计,由此走向了不同的能力侧重。
Tokenizer 不只是把图像切成小块
视觉 tokenization 同时包含两个决定:把视觉信号转换成什么表示,以及如何把这些表示组织成序列或索引。输入可以是像素、图像 patch、视频片段、点云或体素;输出可以是连续向量,也可以是有限词表中的离散索引。因而,Tokenizer 的设计不能只用“把图像切成多少块”来概括。
对连续表示,可以把输出记为 z ∈ R^(L×D):L 是 token 数量,D 是每个 token 的特征维度。L 影响后续模型处理的序列长度,D 与数值精度影响每个位置的表示容量和存储开销。对离散表示,还需要说明词表大小 K、每个位置是否使用多个码,以及如何解码。减少 L、降低 D 和缩小 K 是不同的压缩操作,不能直接等同。
若每个位置只输出一个来自 K 个类别的索引,则定长编码的理论容量上界为 L·log₂K bit。实际有效信息还取决于码的使用分布、位置之间的依赖和编码方式;这不是模型实际保留了多少语义的直接度量。多码本或残差量化还要计入每个位置的多个索引。
序列组织本身也包含归纳偏置。图像通常使用二维网格,视频增加时间轴;三维点云则稀疏、无规则,并且可能具有排列不变性。将这些输入变成序列时,空间邻接、时间顺序与几何关系是否保留,会影响后续理解与生成。
四类信息瓶颈,控制四种信息取舍
架构瓶颈:通过下采样、池化、步幅卷积或层次化结构压缩空间与时间分辨率。它首先限制“有多少位置可以表达”,高频纹理、小目标和快速运动容易在压缩过程中丢失。
连续瓶颈:VAE 等方法用连续潜变量及分布约束组织表示。KL 正则帮助塑造潜空间,但过强的分布约束可能削弱输入信息,极端情况下出现 posterior collapse;因此需要同时考虑表示的可生成性和重建保真。
离散瓶颈:把连续特征映射到有限码本或量化空间,使表示可以作为离散符号建模。代价包括量化误差、码本使用不均或坍塌,以及搜索与优化开销。扩大词表并不自动提高有效容量。
语义瓶颈:由类别标签、图文对齐或教师特征决定保留哪些信息。它有利于建立对任务有用的不变性,却可能弱化监督目标没有明确要求的颜色、文字、空间关系或其他局部细节。
四类瓶颈可以同时存在:例如先通过网络下采样形成架构瓶颈,再进行离散量化,并使用语义教师监督。分析一个方法时,需要分别说明每种压缩来自哪里、损失约束什么,以及哪些信息通过解码器或下游模型补偿。
依据:survey 第 2 节,特别是 2.1.1–2.1.3。L·log₂K 为基于单索引离散表示的补充推导,并非论文原式;它说明编码容量上界,不直接衡量语义保留程度。
发现一:理解与重建,对视觉信息有不同要求
仍然以桌上的杯子为例。
要回答“桌上有什么”,模型主要需要识别物体及其关系。换一种光照、换一点纹理,答案通常仍然成立。
要还原这张照片,模型则需要保留更多具体信息:杯柄的轮廓、杯口的反光、木桌上的细纹,以及背景中的细节。
前一种目标鼓励模型提炼语义;后一种目标要求表示保留可恢复的视觉内容。
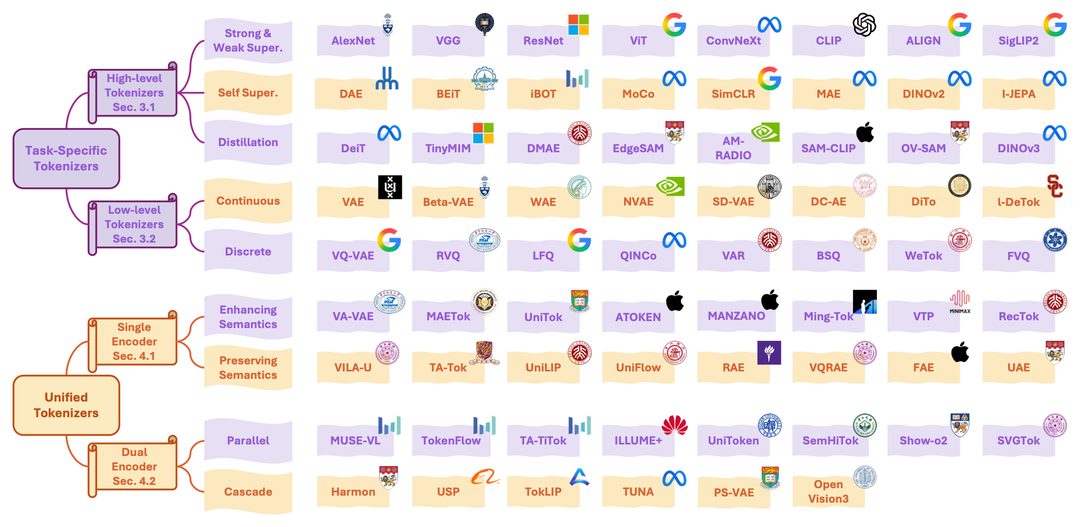
因此,视觉 tokenizer 长期沿着两条路线发展。
高层语义路线关注分类、检索、检测、分割和多模态理解。CLIP、SigLIP、DINO 等方法,通过图文对齐、自监督学习或其他训练策略,学习可迁移的视觉表示。
低层重建路线关注压缩与恢复。VAE、VQ-VAE、VQGAN 等方法,将视觉信号映射到潜在空间,为重建和生成提供基础。
当同一个模型需要处理问答、生成和编辑时,两类目标便需要在表示层面相遇。
语义路线:CLIP、SigLIP 和 DINO 提供的语义并不相同
高层语义表示包含不同学习路线。分类监督利用明确标签,适合学习已知类别,但类别空间与标注成本限制其扩展。图文弱监督从网络图像及文本描述中学习开放词汇语义,同时受描述遗漏、噪声和数据分布影响。
CLIP 通过图文对比学习,把匹配的图像与文本表示拉近,并与不匹配样本区分。CLIP 类 softmax 目标依赖候选之间的归一化竞争,SigLIP 则使用图文对的 sigmoid 目标,直接监督配对是否匹配;SigLIP 2 进一步结合 caption 相关训练与自蒸馏等策略。改变的是语义对齐目标与训练组织,不能仅凭图文检索能力推断输入中的每个局部细节都被保留。
DINO 系列通过视觉自监督和教师—学生学习建立表征,不依赖图文对齐作为核心训练目标。预测式自监督的预测目标也并不相同:BEiT 预测离散视觉码,MAE 恢复被遮蔽的像素,I-JEPA 预测潜空间中的缺失区域;MoCo、SimCLR、BYOL、DINO 等则通过不同的对比或自蒸馏机制学习跨视图表示。具体训练目标与数据决定了表示对全局语义、局部结构和变化不变性的侧重。
进一步的趋势是多教师蒸馏。RADIO 等工作把 CLIP、DINO、SAM 等教师的互补能力聚合到一个学生表示中,尝试同时保留语言语义、稠密对应和区域结构。不过,多教师输出尺度、监督权重与分辨率适配仍需处理,叠加教师数量并不自动保证所有能力共同提高。
数据也会塑造 token 保留的信息。Survey 单独讨论了数据过滤、聚类平衡、采样与合成数据:常见对象大量重复,并不能补足稀有概念、小文字或复杂空间关系。对统一 tokenizer 而言,训练数据应同时覆盖描述可表达的语义与描述可能遗漏的视觉细节。
重建路线:连续与离散表示有不同的失败机制
连续低层 tokenizer 的关键问题,是在“容易建模的潜空间”与“忠实恢复输入”之间取得平衡。VAE 用重建项保留输入信息,用 KL 正则约束潜空间;若正则过强或训练条件不合适,可能出现后验坍缩,潜变量对输入的依赖减弱,解码器不能充分利用它。论文讨论了放松分布约束、减小 KL 权重、使用更灵活先验与层次潜变量等路线。
重建损失的选择同样重要。仅依靠逐像素误差,可能得到平均意义上接近输入却较模糊的结果。感知损失在预训练网络的特征空间比较输入和重建图像,对抗监督则帮助恢复自然图像的纹理与局部统计。VQGAN 将感知与对抗监督引入量化框架。但视觉上更锐利,仍不等于小字、纹理或局部结构被精确恢复,需要像素、结构与感知指标共同检查。
离散 tokenizer 多了一步:把连续特征映射到有限的代码集合。传统向量量化寻找最近的码本向量。增大码本可以提供更多候选表示,但可能出现码本坍缩,即多数条目很少被使用;这与 VAE 的后验坍缩是不同问题。前者关心离散词汇是否被充分利用,后者关心连续潜变量是否仍有效依赖输入。
Survey 梳理了 EMA 更新、失活代码重启、随机量化与改善梯度传播等策略。其中,IBQ 和 FVQ 等工作关注码本学习与梯度路径;优化目标不仅是扩充条目数量,更是让可用容量得到有效训练。
从查找码本到隐式量化
机制 | 如何得到离散表示 | 主要设计动机 |
|---|---|---|
传统 VQ | 将特征映射到最近的可学习码本向量 | 用有限视觉词汇近似连续特征 |
FSQ | 将少量标量维度量化到预设等级,组合成离散代码 | 避免学习和搜索完整向量码本 |
LFQ | 以潜变量各维度的符号形成二进制代码 | 避免显式最近邻搜索;MAGVIT-v2 是代表例子 |
BSQ | 先对特征施加球面约束,再二值化 | 改善二值量化的几何与误差性质 |
分组 LFQ | 将通道分组后分别量化,再组合代码 | 在代码表达能力与建模成本之间取得平衡;WeTok 采用此类思路 |
隐式码本避免了逐个存储与搜索全部码向量,但量化、熵约束和下游 token 预测仍有计算成本。更大的组合词汇也不意味着模型一定能充分利用它,因此仍需检查代码分布、重建结果和下游训练稳定性。
依据:survey 第 3.1–3.2.2 节。
发现二:统一理解与生成,需要进一步考虑表示如何共享
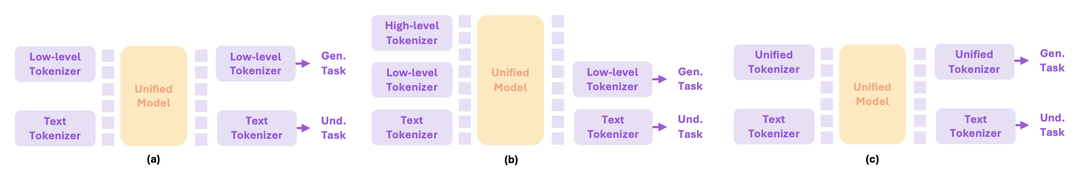
一种直接的方案,是让不同任务使用各自擅长的 tokenizer。
理解任务使用语义特征,生成任务使用重建特征,再由下游模型学习两种表示之间的关系。
这样的设计能够发挥不同模块的优势,也带来了新的问题:两类特征怎样对齐?编辑任务如何同时调用语义和细节?模型需要付出多少额外学习成本?
统一 tokenizer 因而成为重要研究方向。
它希望得到一套共享的视觉表示,同时承载理解所需的语义与生成所需的细节。
判断是否采用统一 tokenizer,需要看表示如何组织和使用。一个系统能够同时完成理解与生成,仍可能为两种任务使用独立的 tokenizer;而包含两个编码器的设计,也可以通过特征融合形成统一表示。
关键在于:两类能力能否从共享的视觉 token 中获得所需信息。
发现三:通向统一表示,目前有两条主要路线
论文按照编码器架构,将统一 tokenizer 分为单编码器和双编码器两大类,并进一步梳理出两条路线。
第一条:从重建出发,增强语义。
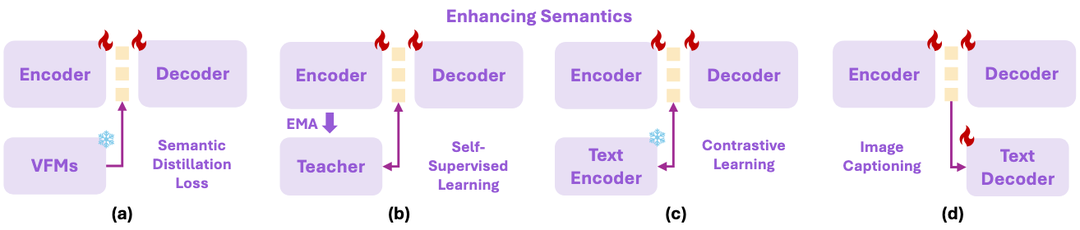
先建立能够保留视觉细节的表示,再引入语义蒸馏、图文对齐或自监督学习,让 token 获得更强的语义能力。
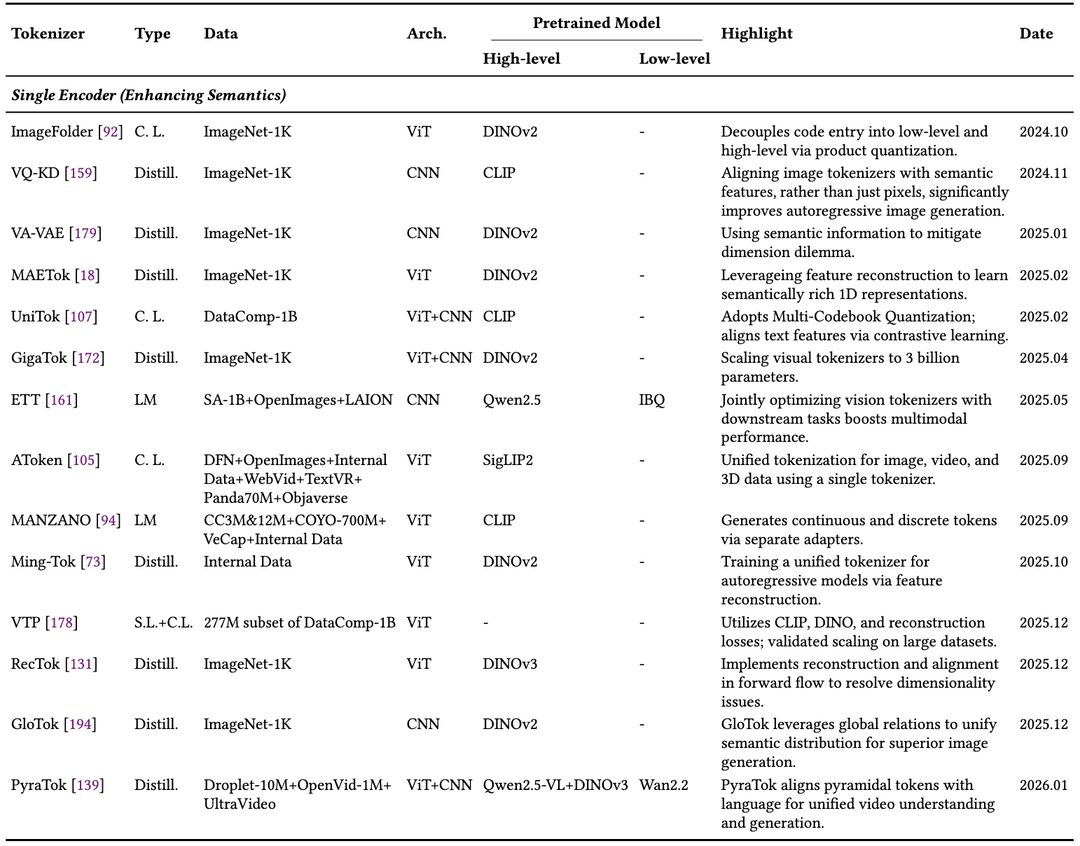
这一方向需要回答:怎样在图像可恢复的基础上,让表示更适合理解和下游生成?
第二条:从语义出发,补充重建能力。
从已经具备较强语义能力的视觉基础模型出发,为它增加图像解码能力。
这条路线的挑战是:
在增加细节表达能力时,怎样保住预训练模型已经学到的语义结构?
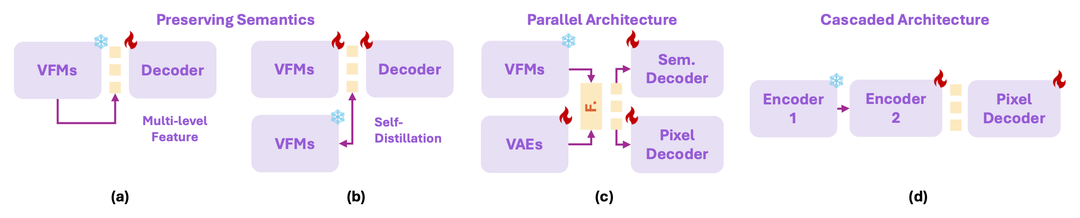
一种思路是采用single encoder平衡high-level语义和low-level细节,图 5 (a)为冻结编码器,依靠更强的解码器或多层特征恢复图像;图 5 (b)为微调编码器,同时通过对比学习、自蒸馏等方式保持语义能力。
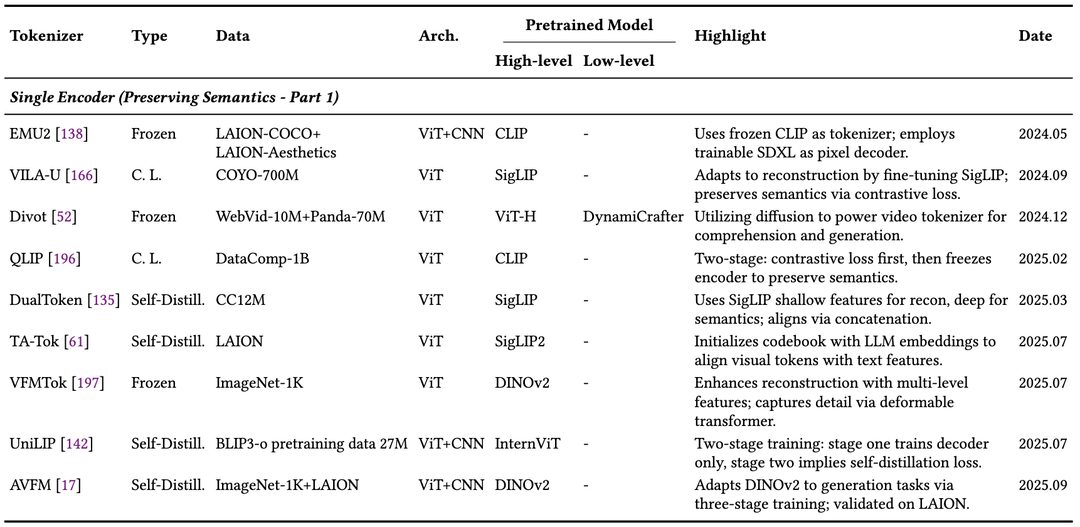
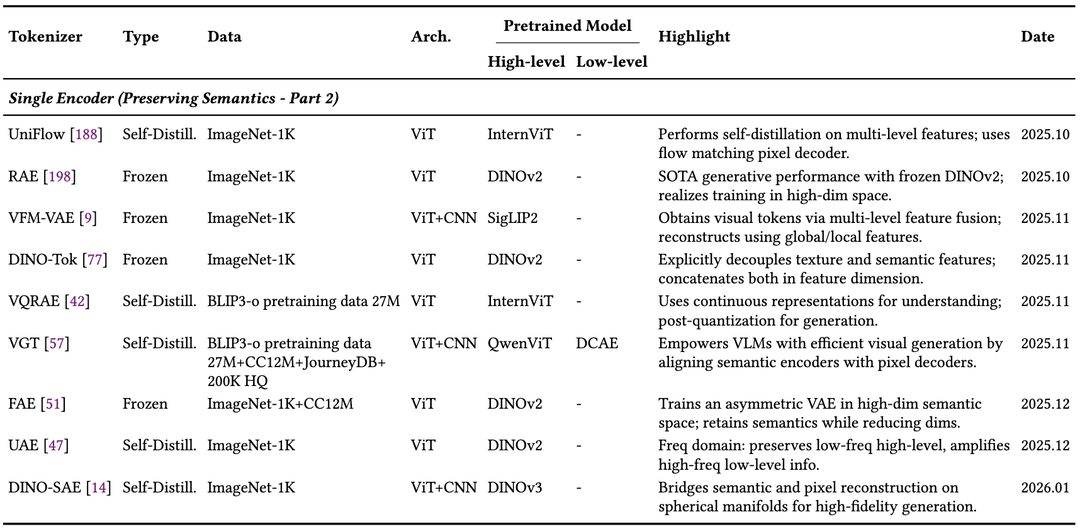
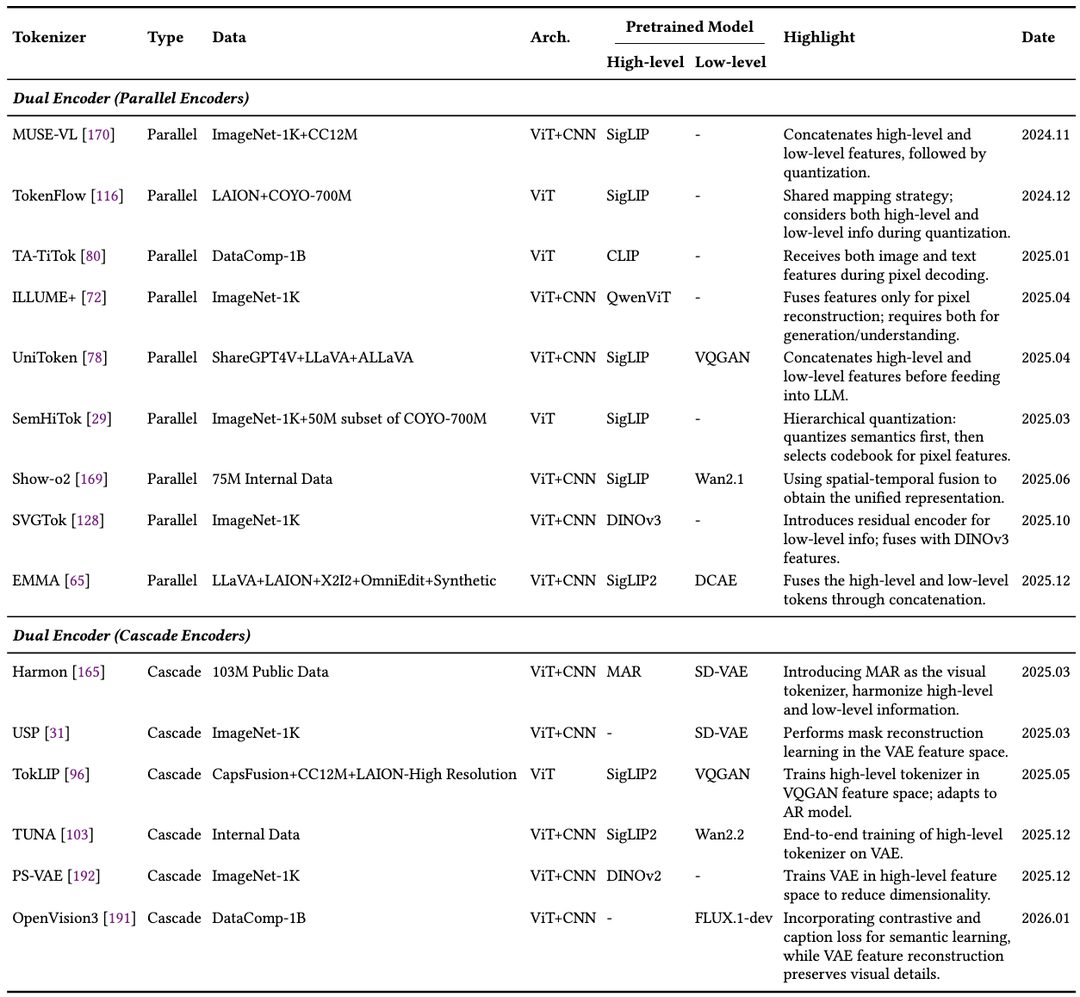
另一种思路如图 5 (c)和(d)所示,采用dual encoder的设计,根据模型结构的不同可大致分为两类:第一类分别提取语义与细节,再进行融合。并行架构让不同编码器各自提取信息,再通过拼接、加权或层次化机制形成统一 token。第二类采用逐级编码,让细节与语义逐步衔接。级联架构在已有视觉特征之上继续编码,逐步引入语义抽象与任务监督。TokLIP、TUNA 等工作探索了不同的级联结构和训练方式。
两条路线的出发点不同,却都需要处理同一个取舍:
在有限的 token 容量里,让语义信息与视觉细节更有效地共存。
读懂统一方法:架构、监督与读出接口
Survey 先按单编码器与双编码器划分架构,再将单编码器分为增强语义与保留语义,将双编码器分为并行与级联。比较具体机制时,还可以分别考察训练起点、监督目标与表示形态,但论文没有给出所有组合的二维交叉分类。连续/离散、一维/二维/多尺度描述的是 token 形态与组织,应与架构标签分开理解。
从重建出发:语义监督约束什么?
语义蒸馏把视觉基础模型的特征作为教师,让 token 在保留恢复能力的同时学习语义结构。VA-VAE、GigaTok 等属于论文讨论的代表路线。图文监督则通过对比学习或 caption 目标建立语言关联,例如 UniTok 结合多码本量化与对比学习。MAETok 结合掩码图像建模与紧凑一维表示,体现了自监督和压缩共同设计的思路。
这些方法的差异,不只是多加一项损失,还包括监督哪些层、语义和重建是否共用特征、采用何种瓶颈,以及训练时如何平衡不同目标。概念上可以同时考虑重建、语义、语言对齐和容量约束,但各方法实际使用的目标与阶段不同,不能假定所有方法都采用相同的联合损失。
从语义出发:冻结与微调带来不同取舍
冻结基础模型,可以保留已有语义,重建能力则更多依赖解码器和中间层特征。RAE 等工作探索从语义特征恢复图像;VFMTok、DINO-Tok 等利用多层或不同层次的特征提供细节。冻结最终层特征无法凭空恢复已丢失信息,强解码器可能借助先验补出合理外观,因此重建感知质量与输入忠实度需要分别评价。
微调能够让编码器适应细节恢复,但需要防止语义漂移。VILA-U 在适应重建时保留图文对比监督;QLIP 采用分阶段训练,先进行对比学习,再冻结编码器以保持语义。UniLIP、UniFlow 等则使用自蒸馏或分阶段策略。这一路线的重要问题,是获得重建能力之后,原有分类、检索和空间理解能力是否仍被保留。
双编码器:融合位置与级联方向需要说明
并行架构分别提取语义与细节,再通过拼接、加权、层次量化或时空融合形成共享表示。MUSE-VL 将高层与低层特征拼接后量化,UniToken 在进入语言模型前拼接,SemHiTok 先量化语义再引导像素特征的码本选择,Show-o2 则采用时空融合。相同的并行架构标签,可能对应不同的监督路径与下游可见信息。
级联架构在已有潜变量或特征之上继续编码。USP 在 VAE 特征空间进行掩码学习;TokLIP 在 VQGAN 特征上构建因果表示编码器并加入语义对齐,下游模型使用这些 token 并预测重建所需代码;TUNA 探索端到端联合优化。级联也不固定为先细节后语义:PS-VAE 在高层特征之后增加自编码器压缩表示,与在 VAE 特征之上学习语义的路线不同。
共享编码基础,可以对应不同的任务读出
Survey 表 1 对 MANZANO 的介绍指出,它基于共享编码器,通过不同适配器产生连续和离散 token;VQRAE 在理解时使用连续表示,在生成时使用量化后的表示。因此,共享视觉编码基础不要求所有任务采用完全相同的输出接口。读者需要检查共享发生在哪一层、量化前后的语义如何变化,以及生成骨干最终预测的是共享表示还是恢复图像的代码。
比较统一方法时,至少需要说明四项:表示从哪里起步,语义与重建监督约束哪些层,融合发生在量化之前还是之后,以及理解与生成各自读取或预测什么。编码器数量少不自动代表统一程度更高,两路融合也不自动证明语义与细节已有效协同。
依据:survey 第 4 节、表 1–2。少数方法在论文不同表格中存在归类差异,这里按具体机制理解,不据此作架构排名。
发现四:评价一套视觉 Token,需要多张“成绩单”
一张重建图像看起来清晰,并不能回答这套表示是否适合视觉问答;分类准确率,也无法直接说明它能否保留编辑所需的局部细节。
因此,综述从多个维度整理了已有工作的评价方式。
语义能力: 能否识别物体、完成图文检索,并准确定位图像中的区域?
重建质量: 恢复后的图像,在像素、结构和感知层面与输入有多接近?
表示效率: 使用多少 token、压缩到什么程度,离散码本是否得到有效利用?
下游理解: 进入多模态模型后,能否支持问答、综合理解,并减少幻觉?
下游生成: 生成结果是否具有较好的质量,是否符合文本中的对象、属性与关系要求?
论文据此汇总了 ImageNet、视觉问答和多模态理解基准,以及 GenEval、DPG-Bench 等生成评测中的代表性结果。
阅读这些结果时,还需要区分重建与生成:rFID 评价输入图像与重建图像之间的分布差异,gFID 评价生成图像的分布质量。两项指标对应不同任务。
评价协议:先区分表征能力与整个系统能力
同一个 ImageNet 准确率,也可能来自不同评价协议。零样本分类利用已有图文对齐直接匹配类别;线性探针固定编码器,仅训练简单读出层;微调则允许模型适应目标数据。这三种设置回答不同问题,不能把它们混成一个分类成绩。检索通常报告 Recall@1,检测与分割则使用 mAP、mIoU,检验空间结构而非只有全局语义。
重建 rFID 衡量原图与重建图像的特征分布差异,PSNR 和 SSIM 更关注像素与结构一致性。FID 是分布指标,低 rFID 不能直接证明每张图中的小文字或局部纹理被完整保留。离散模型还应报告码本使用率及代码分布,不过高利用率本身也不保证语义或保真。
生成 gFID 评价整个生成流程,受 tokenizer、生成骨干、训练数据和采样策略共同影响。GenEval 等基准进一步检验对象、属性与关系是否遵循指令;VQA、OCR、综合理解与幻觉评估,则检验下游模型如何使用视觉信息。这些属于系统表现,需要与 tokenizer 自身的诊断分开看。
论文的结果表展示了不同路线的潜力,但未控制所有工作的数据、骨干和计算预算。例如表 6 中 VQRAE、UniLIP 与 TUNA 的 GenEval 为 0.96、0.90 与 0.90,只能说明对应配置取得了这些结果,不能证明某类架构在所有条件下更优。
更有解释力的实验应同时匹配输入分辨率、训练数据、下游骨干及总计算,并分别比较固定 token 数和固定端到端成本。还应报告 token 维度与精度:同样长度的表示,容量并不相同。结果最好呈现质量—成本曲线,让读者看到能力提升的具体代价。
依据:survey 第 5 节、表 3–6。最后一段为基于比较限制提出的评价建议。
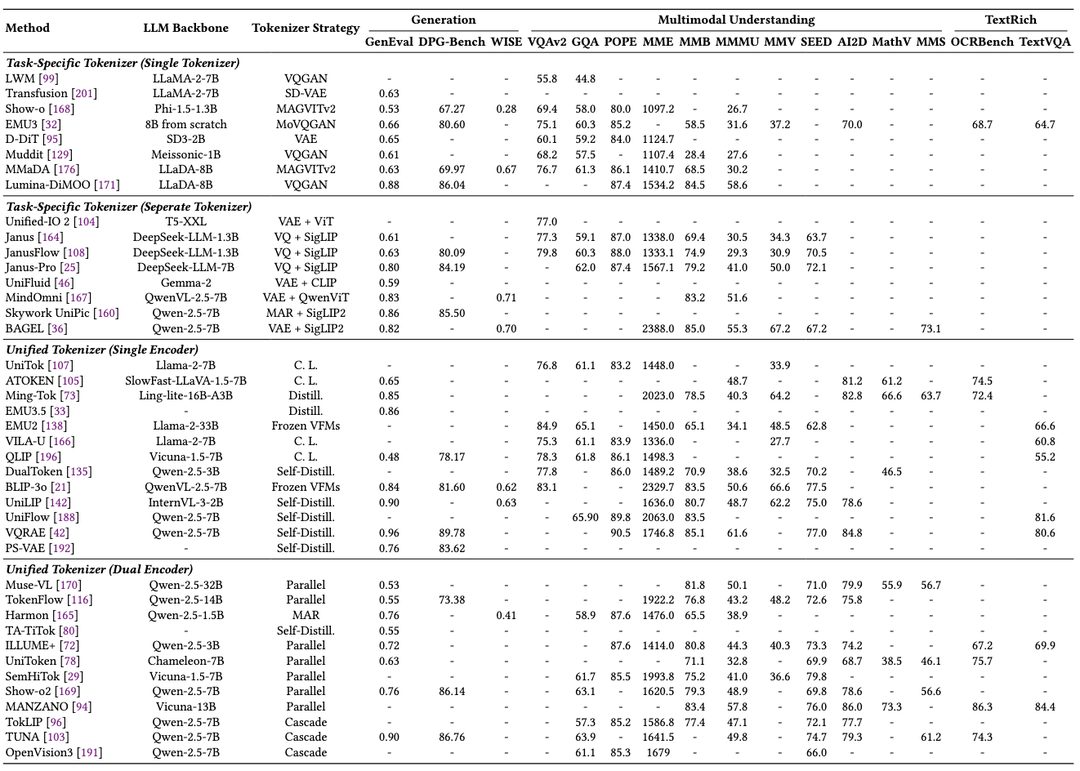
不同工作的数据、模型规模与训练配置也存在差异。综述中的比较有助于观察趋势、理解取舍;具体收益仍需要结合实验设置判断。
发现五:更少的 Token,意味着更精细的信息分配问题
高分辨率图像和长视频,对计算和存储提出了更高要求。
减少 token 数量,可以降低后续序列建模的开销。但压缩越强,哪些信息被保留下来就越重要。
对于一张包含大片天空和一个小路牌的图片,平均分配表示容量,可能无法充分照顾路牌上的细小文字。
这个例子说明了自适应 token 分配的价值:根据内容和任务需求,为关键区域保留更多信息。
现有的一维 tokenizer 已经为紧凑表示提供了探索空间,但如何兼顾压缩、空间结构和细节恢复,仍然是重要问题。
面向视频,这个问题还会延伸到时间维度:哪些变化值得保留,哪些重复信息可以压缩?
四种压缩思路:容量、残差、尺度与全局聚合
减少 token 数量与增加每个 token 的表达能力,是两个互补方向。
乘积量化(PQ)将高维特征分成多个子空间,分别量化后组合表示。它用多个较小码本形成更丰富的组合空间。残差向量量化(RVQ)则逐步量化前一步尚未表达的误差,构建由粗到细的代码。两者可能增加每个位置所需的代码数量,因此不能只凭空间位置数推断压缩率。加性量化(AQ)同样用多个码字之和近似向量,但不要求严格的残差逐层顺序。
多尺度量化改变表示的组织方式。VAR 使用从粗到细的 token 金字塔,让下游模型预测下一尺度,而不是在单一尺度上逐 token 展开。它提供了生成顺序的结构,但多尺度自身不等于更少的总代码或更低的总开销。RVQ 的层对应残差细化,VAR 的层对应空间尺度,两者需要区分。
全局压缩关注整张图片需要多少潜变量。DC-AE 探索较高空间下采样率,并通过残差自编码与高分辨率适配缓解强压缩的信息损失。TiTok 使用可学习潜查询与图像特征交互,把图像压缩为紧凑的一维序列,使 token 数量不再直接绑定原始空间网格。
一维 token 仍可承载空间信息,“一维”描述序列组织而非图像变成没有空间结构。它的难点是:在少量潜变量中如何保留位置、局部文字与细节,使解码器及下游模型能够重新使用这些信息。固定长度的一维表示也不自动具有自适应 token 分配,需要额外的长度或区域预算机制。
表示解耦:压缩之后,哪些因素还能被分别操作?
Survey 还讨论了表示解耦这一容易被忽略的维度。β-VAE 增强潜空间约束,尝试让不同维度更独立;ControlVAE、DynamicVAE 动态调节约束;FactorVAE 与 β-TCVAE 则分解 KL 项,重点约束潜变量维度之间的总相关性。更独立的维度可能有利于可解释表示,但需要与重建质量共同权衡。
沿这一问题进一步看,局部编辑和世界模型不只需要总信息量充足,还需要对象、位置、外观与变化以可使用的结构存在。可以通过受控干预检查修改某类表示是否只影响相应因素。这是研究建议:统计独立性并不能直接证明获得了人类命名的语义因素,也不能直接证明因果解耦。
依据:survey 第 3.2.3–3.2.4 节。
接下来会走向哪里?
论文讨论了统一 tokenizer 的规模化、全模态扩展、Tokenizer-free 架构、三维感知、自适应表示,以及世界模型等方向。
首先,统一表示需要接受更大规模的验证。随着模型、数据和计算预算增加,语义与重建能力能否持续共同提升,仍值得系统研究。
其次,视觉 token 需要承载更丰富的信息。视频要求时间一致性,三维任务要求几何结构,全模态系统还需要处理不同模态之间的语义关联与时空对齐。
与此同时,Tokenizer-free 路线也在探索更紧密的端到端学习,让视觉表示与下游任务共同优化,减少对独立预训练模块的依赖。
当研究进一步走向世界模型,表示还需要支持对变化与行动结果的建模。一只杯子在哪里、长什么样,只是其中一部分;它被推动后如何移动、被遮挡后如何保持状态,都对表示提出了更高要求。视觉 token 因此有望从图像的紧凑表示,进一步发展为连接感知、生成与行动的共享状态表示。
六个未来方向的关键问题
Survey 第 6 节提出了六个未来方向。它们共同指向一个变化:tokenizer 不再只回答“如何压缩一张图片”,还要回答“哪些信息值得保留,以及这些信息怎样被理解、生成和行动共同使用”。以下六个方向来自论文;其中具体表示设计与验证方式,是沿着论文问题进一步提出的研究建议。
1.规模化:同时追踪语义、保真和计算
论文指出,语义蒸馏、频域分解等方法已经尝试缓解语义抽象与视觉细节之间的冲突,但系统性的 tokenizer 规模研究仍然不足。扩大下游模型并不能直接证明表示变得更好:编码器可能提取了更多信息,固定 token 瓶颈却无法承载;解码器可能生成更逼真的纹理,但并未忠实恢复输入。
值得分别考察编码器、解码器、token 数量、特征维度和数据规模的影响,记录语义与重建质量随预算变化的曲线,并在相同计算成本下与任务专用表示比较。真正需要回答的是:规模增长能否持续改善两类能力,还是只是把某个任务的代价转移给另一个模块?
2.全模态统一:共享事件语义,保留模态差异
论文提出,图像、视频、音频与语言之间的统一 tokenization,需要共同语义落地、时空对齐和高效交互。AToken 是早期探索之一,但 survey 对其已有能力的介绍覆盖图像、视频与三维;音频、语言仍应作为未来扩展目标理解。
“共享潜空间”不要求所有模态采用完全相同的编码方式:音频有音色与节奏,视频有空间结构与运动,语言则以符号组织信息。一种可探索的设计是,以共享 token 表达对象或事件,以模态专属部分保留纹理、声音等细节,并显式记录时间与位置。评估应从“语义相似”扩展到“是否描述同一时刻、同一事件”:当声音缺失、音画错位或线索冲突时,系统能否保持一致判断,比正常样本上的平均成绩更有解释力。
3.Tokenizer-free:检验端到端信息流的收益
论文讨论了移除独立视觉编码器的理解路线,以及 JiT 直接进行像素空间生成的探索。这并不意味着模型内部没有视觉表示,而是减少对单独预训练 tokenizer 的依赖,让表示随下游目标共同学习。它可能缓解模块接口造成的信息限制,也可能增加高分辨率输入的计算和优化成本。
更有意义的比较,是在匹配数据与总计算预算下,对照冻结 tokenizer、可联合微调 tokenizer 和直接处理像素或 patch 的模型,同时计入独立模块的预训练成本。视觉注意力占比可以帮助诊断信息流,但只有改变输入细节后任务结果也随之合理变化,才能更有力地说明模型在使用视觉证据。
4.三维感知:让语义与几何共同落地
论文指出,现有三维理解方法往往擅长语义推理,而几何重建方法擅长恢复形状,两者仍存在分离。仅把不同视角的物体都识别为“杯子”,并不代表 token 已经理解它的三维位置、姿态与遮挡关系。
未来可以将相机条件、深度或多视角对应纳入表示学习,也可以探索对象级或三维锚点 token,让不同视角的外观从共同结构中恢复。检验这类表示时,既要看新视角图像是否自然,也要看几何误差、跨视角对应与编辑一致性:从一个视角修改物体之后,其他视角是否同步变化,能够直接暴露二维外观与三维结构之间的脱节。
5.自适应分配:学习哪里值得花 token 预算
论文指出,固定压缩率容易产生冗余,一维表示虽更灵活,却可能损失空间或时间结构,因此需要可学习的重要性估计。视觉显著性也不完全等于任务价值:路牌上的小字面积很小,却可能决定答案;视频中短暂的接触动作,比长时间静止背景更重要。
可以探索用少量基础 token 保存整体结构,再向细小文字、局部边缘或运动变化分配补充 token,并保留位置与时间索引。还应区分通用分配与任务条件分配:后者更容易节省预算,却可能在压缩之后无法回答新的问题。质量—预算曲线、小目标与短事件召回,以及分配器自身的开销,应该共同决定它是否真正更高效。
6.世界模型:表示可预测、受动作影响的状态
论文以 V-JEPA2 的潜空间时间建模和 LAPA 的动作 token 为线索,提出用共享状态表示连接感知、生成与行动。相比恢复当前画面,这要求 tokenizer 保留更长时间的信息:物体被遮挡后在哪里,运动如何延续,同一状态下不同动作会产生什么变化。
沿此方向,可以探索带记忆的对象或场景状态、动作条件潜状态预测,以及不同时间尺度的更新机制;这些是研究建议,并非论文给出的统一算法。验证时应让同一初始状态接受不同动作,观察预测是否随动作变化,再检查遮挡后的身份保持、多步误差和闭环任务表现。短期视频逼真度不能替代长期状态一致性,观察数据中的相关性也不能直接证明因果能力。
贯穿各方向:让评估能够定位表示失败
进一步的评估可以区分三种情况:信息在编码时已经丢失,信息仍在 token 中但解码器未能恢复,信息可用但下游模型没有正确使用。特征探针、解码器替换、局部输入干预与分支消融可以提供不同证据,任何单一检查都不宜被当作最终证明。
最终应同时报告语义、重建、生成与成本,并检验同一表示能否复用于新的任务。这样,“更统一”才从架构名称变成可验证的能力。
依据:survey 第 6 节。具体表示设计、干预实验及失败诊断方式为基于论文问题提出的研究建议。
让同一套视觉表示支撑更多能力
从识别图片里的杯子,到重建它的外观,再到按指令修改颜色,这些任务共同追问着视觉表示的能力边界。Visual Tokenizer 的设计,决定着模型以怎样的形式接触视觉信息。语义、细节和效率之间的取舍,也会延续到后续的理解与生成过程。
这篇综述希望为研究者提供一张连贯的技术地图:从任务专用 tokenizer 的发展脉络,到统一 tokenizer 的架构设计、评价方式与开放问题。
如何让同一套视觉 token 更好地支持理解与生成,仍是多模态模型值得深入探索的基础问题。
欢迎阅读 《Visual Tokenizers: A Comprehensive Survey》,并关注repo: https://github.com/Shi-qingyu/Awesome-Visual-Tokenizer。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。