你正在使用的电脑,已经可以运行本地 AI 大模型了
原创 青小蛙 2026-10-16 17:46 四川
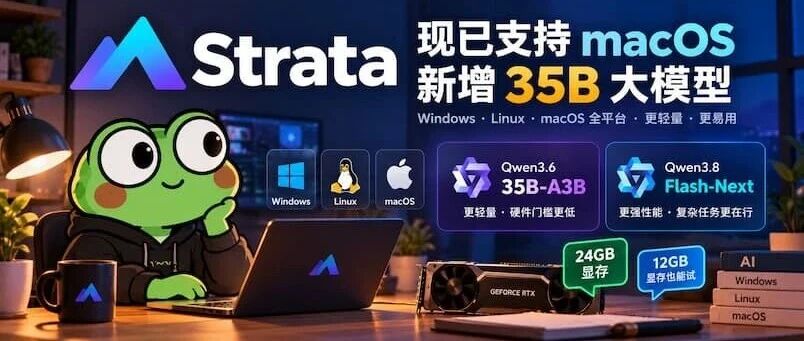
几天前,小众软件介绍过 Strata,一款可以让家用普通显卡运行本地 AI 大模型的本地推理工具:8GB显存就够,Strata 让普通电脑也能运行千亿参数大模型
最近 Strata 连续更新,不仅支持了三大系统:Windows、Linux、macOS,还新增了体积更小的 Qwen3.6-35B-A3B 模型。再次降低了硬件准入门槛。
青小蛙多说一句:所谓「可以运行」的意思,就是响应速度已经能正常使用了,而不是等半天吐出半句话。
目录
• 哪些显卡能用?
• 需要多大内存
• Qwen3.6-35B-A3B 与 Flash-Next 性能对比
• Strata 现在也支持 Mac 了
• 存储空间需求
• 获取 & 安装
哪些显卡能用?
目前 Strata 支持 NVIDIA、AMD 显卡,同时也为 Intel Arc 和 Apple Silicon 提供了实验性支持。
显卡 | 支持情况 |
|---|---|
NVIDIA RTX 20 系列 | 支持 |
NVIDIA RTX 30 系列 | 支持 |
NVIDIA RTX 40 系列 | 支持 |
NVIDIA RTX 50 系列 | 支持 |
AMD RX 6000 系列部分型号 | 支持 |
AMD RX 7000 系列部分型号 | 支持 |
AMD RX 9000 系列部分型号 | 支持 |
Intel Arc | 实验性支持 |
Apple Silicon M1~M5 | 实验性支持 |
官方建议使用至少 12GB 显存的 NVIDIA 或 AMD 显卡。更老的也不是不行,比如最低测过 8GB 可以用,但…很卡那种。
另外,新增的 Qwen3.6-35B-A3B 目前仅支持 NVIDIA 和 AMD,不支持 Intel Arc 和 Mac 上的 Strata。
需要多大内存
Strata 把显卡的门槛降低了,但实际上需求还在,所以需要至少32GB内存才可以运行,青小蛙也是刚刚新增了8GB显存,才用了起来。
有两个案例:
1. RTX 4070 笔记本 8GB + 64GB 内存 通过测试运行 Flash-Next IQ3_XXS。
2. RTX 3070 8GB + 64GB 内存 也有用户确认能够运行 Strata,不过曾经遇到图像编码器占用显存导致的启动问题。
Strata 推荐至少使用 12GB 显存、32GB 系统内存。显存越大,能够缓存的模型参数越多,通常运行速度也越快。对于只有 12GB 显存的用户,推荐尝试 35B 模型的低量化版本。
根据 Strata 官方发布说明,两款模型不同量化版本需要的内存及性能对比:
模型 | 量化版本 | 内存需求或推荐配置 | 模型特点 |
|---|---|---|---|
| 35B-A3B | UD-Q4_K_XL | 32GB | 体积小,推荐入门 |
35B-A3B | UD-Q6_K_XL | 44GB | 精度更高 |
35B-A3B | Q8_0 | 52GB | 精度最高,资源需求较大 |
| Flash-Next | Q2_0 | 48GB | 速度最快 |
Flash-Next | IQ2_XS | 48GB | 官方推荐,速度与质量均衡 |
Flash-Next | IQ3_XXS | 64GB | 质量更好,速度稍慢 |
Flash-Next | IQ3_S | 64GB | 质量最好,运行较慢 |
Flash-Next | UD-IQ4_XS | 96GB 及以上更合适 | 约 4-bit,更接近原始模型 |
Qwen3.6-35B-A3B 与 Flash-Next 性能对比
两款模型均采用 MoE(混合专家)架构,但参数规模存在较大差异。
对比 | Qwen3.6-35B-A3B | Qwen3.8-Flash-Next |
|---|---|---|
总参数量 | 约 35B | 125B |
激活参数量 | 3B | 6B |
模型规模 | 较小 | 较大 |
复杂推理 | 相对较弱 | 更强 |
编程能力 | 适合日常编程 | 更适合复杂任务 |
系统资源占用 | 较低 | 较高 |
MTP 推测解码 | 支持 | 支持 |
尽管 35B 模型规模更小,它仍然具备较强的日常对话、文字处理和编程能力。
而且,Strata 为它提供了 MTP(多 Token 预测)加速。在官方使用 AMD Radeon AI PRO R9700 的测试中:
推理模式 | 生成速度 |
|---|---|
普通推理 | 83 tokens/s |
开启 MTP 2 | 161 tokens/s |
开启 MTP 2 后,生成速度提高了约 94%。
Strata 现在也支持 Mac 了
从 Strata v0.1.44 版本开始, 加入原生 Metal 后端,支持 Apple Silicon M1~M5 芯片,要求 macOS 15 或更新版本。
目前属于实验性支持,需要在 Mac 上克隆代码后,运行 ./setup.sh,由安装程序从源码编译推理引擎。
现阶段 Mac 版本还有一些限制:只支持单个并发请求、官方仅验证了最高 32K 上下文,Qwen3.6-35B-A3B 暂未适配。
官方提供了两组值得参考的测试数据:
设备 | 模型 | 生成速度 |
|---|---|---|
Mac mini M4,32GB | Flash-Next Q2_0 | 8~14 tokens/s |
Mac M5 Max,128GB | Flash-Next IQ3_S | 95~103 tokens/s |
依旧,最低档内存限制是 32GB。
存储空间需求
最后,还需要准备不小的硬盘空间,用来存储模型文件本身:
模型 | 量化版本 | 模型大小 | 推荐系统内存 |
|---|---|---|---|
| Qwen3.6-35B-A3B | UD-Q4_K_XL | 22.4GB | 32GB |
35B-A3B | UD-Q6_K_XL | 31.8GB | 44GB |
35B-A3B | Q8_0 | 36.9GB | 52GB |
| Flash-Next 125B | Q2_0 | 66.4GB | 48GB |
Flash-Next | IQ2_XS | 68.0GB | 48GB |
Flash-Next | IQ3_XXS | 75.8GB | 64GB |
Flash-Next | IQ3_S | 83.6GB | 64GB |
Flash-Next | UD-IQ4_XS | 93.7GB | 96GB |
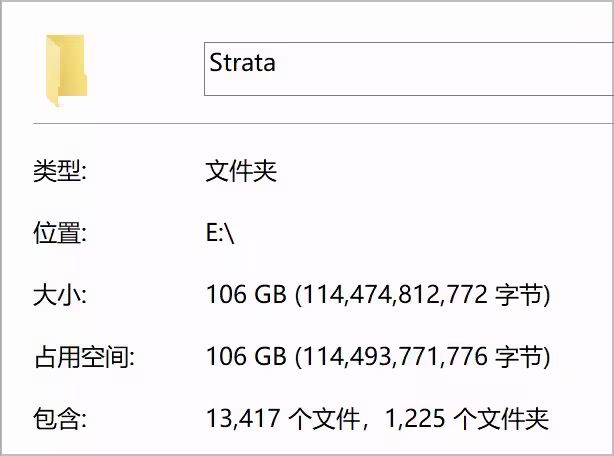
青小蛙运行了 IQ2_XS 量化版本,使用了大概100GB的 SSD 存储空间:
获取 & 安装
• GitHub https://github.com/Niko1221/Strata
Strata 除了降低硬件门槛,也降低了使用门槛,你可以将安装交给 AI:
为我在这台 PC 上设置 Strata:https://github.com/Niko1221/Strata - 关注该存储库中的 docs/AI_SETUP.md。或者直接下载源码:
https://github.com/Niko1221/Strata/archive/refs/heads/main.zip
然后运行:
• Windows: 双击
START-HERE.bat• Linux / macOS: 运行
./setup.sh
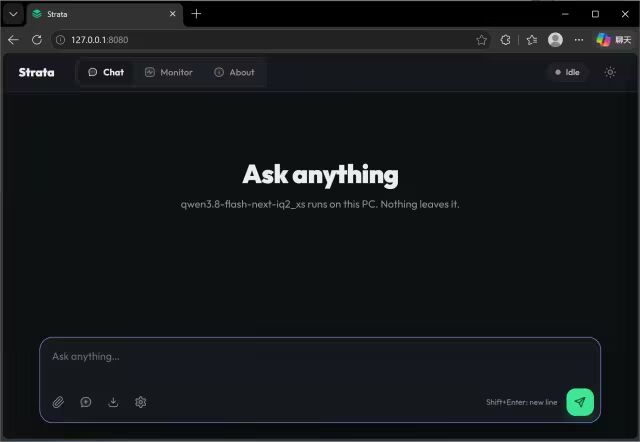
根据页面提示就行了,成功之后,会自动弹出浏览器,可以对话:
还可以把模型拿给其他第三方应用使用:
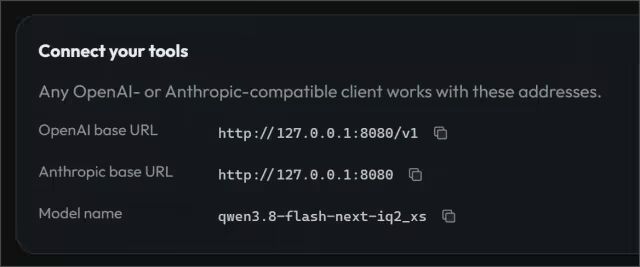
青小蛙测试在 ChatGPT 桌面版中成功调用本地模型,让他帮我清理了 C 盘(是的,就是这么猛!把电脑交给AI吧 😂)
快去试试吧,有问题可以来留言讨论。
不过,当运行成功之后,系统内存也消耗殆尽了,所以需要买更多的内存。
本文转载自微信公众号「小众软件」,查看原文。版权归原作者所有,如有侵权请联系删除。