腾讯光子 x NUS | Orbia 视频世界模型评测
原创 52CV 2026-10-16 23:38 江苏
腾讯光子 x NUS | Orbia 视频世界模型评测
论文: Orbia: Do Generated Videos Form a Consistent 3D World?
代码、适配与提交指南:https://github.com/worldbench/Orbia
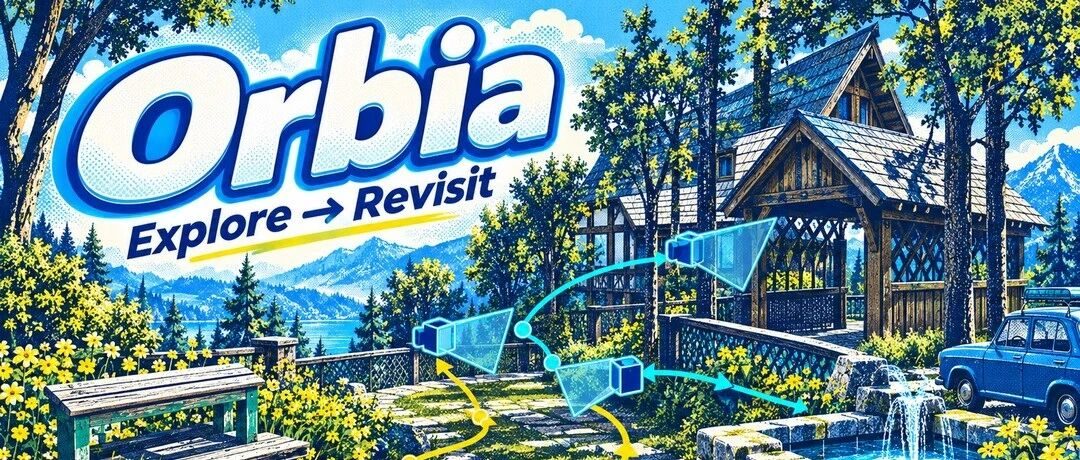
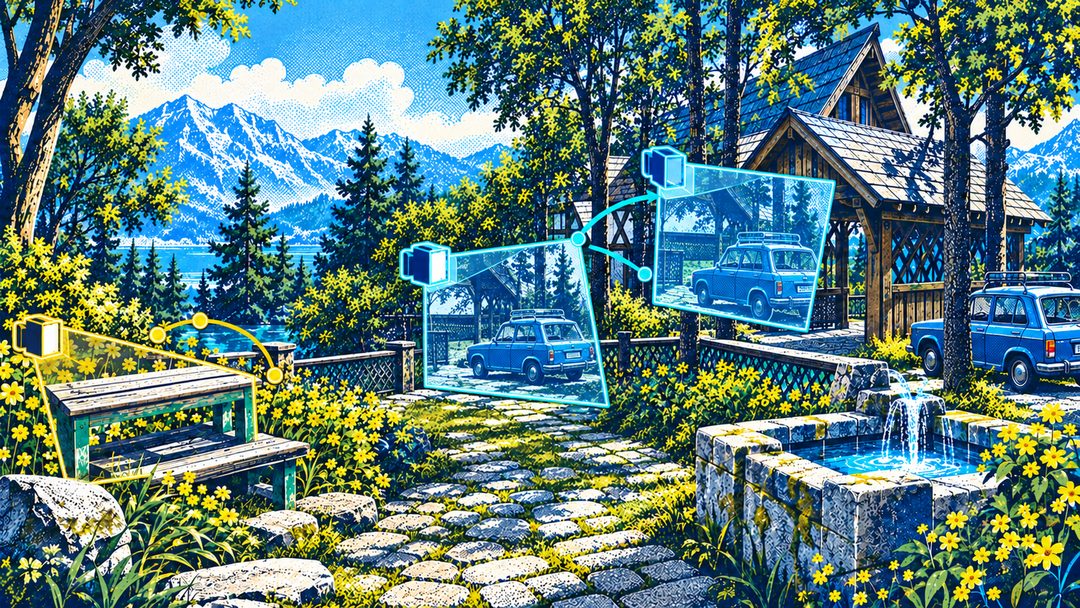
沿着石板路向前走,经过一座木屋,再转身回到刚才的位置。如果木屋换了样子,停在路边的车也不见了,这段视频即使清晰流畅,仍很难被当作一个可以反复探索的世界。
视频生成模型逐渐支持相机移动和交互控制之后,“离开再回来”成了一项很具体的考验。模型不仅要生成眼前的新画面,还需要保留此前出现过的物体、布局和空间关系。否则,过去的观察就无法继续为后面的探索提供依据。
Orbia 围绕这个问题,在 720 个探索与回访案例上测试 27 个模型,分别检查已知场景是否保留、新生成内容能否持续存在,以及不同视角能否对应同一个三维空间。研究同时报告相机控制、画质和时序稳定性,观察这些能力是否总能一起改善。
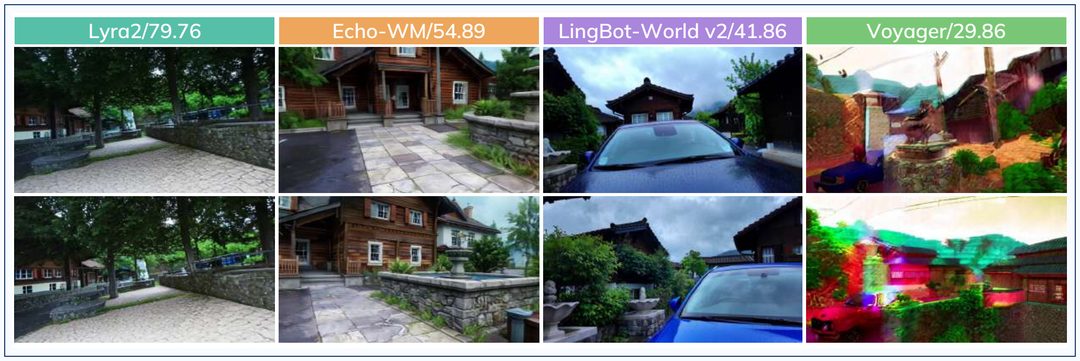
在这组回访对照中,上方是首次生成的观察,下方是之后返回对应位置的结果,四列依次对应 Lyra2、Echo-WM、LingBot-World v2 和 Voyager。Lyra2 较好保留了场景,其他结果存在不同程度的变化,Voyager 的颜色与空间结构变化尤其明显。79.76、54.89、41.86 和 29.86 是这一案例的生成内容持久性 (Generated-content Persistence) 分数,整体表现还需要结合其他案例一起看。
这里观察的是输入图像之外的新区域。不同模型可以生成各自合理的街道,但首次生成之后,再次返回就应当延续先前的内容。外观仍然像一条街,与找回此前那条街,是两个不同的要求。
场景仍然像原来的场景,细节却未必保留下来

“看上去还是一条街”与“回到了之前那条街的同一位置”,所需证据并不相同。前者可以依赖建筑、树木和路面等大类内容;后者还涉及物体的身份、外观与位置。如果原先的汽车被替换、灯具移了位置或墙面纹理改变,语义上相近的画面依然可能描述了不同的空间。
Orbia 的持久性指标结合像素、感知特征和语义特征,并通过深度与相机估计对齐回访中的共同表面。这些指标有不同的敏感性,论文也给出了它们出现分歧的例子。MiniMax-H3 在不同视角的 DINO 比较上获得 77.27,但同视角 LPIPS 的归一化分数只有 17.32。这说明高语义相似度可以与较弱的感知细节保持同时出现。
这里的两个数字对应不同的指标分项,不能互相替换。它们的价值在于帮助定位失败:模型可能保留了大致的场景类别,却没有保留足够一致的物体细节。进一步查看视频和回访对照,才能判断变化集中在哪些内容上。
画质排名与内容保持排名,为什么会分开

在总体结果中,MiniMax-H3 的视觉质量为 78.09,位居全部模型第二,但生成内容持久性为 55.79。LongCat 的对应得分为 77.30与 47.77。丰富的纹理、较好的清晰度与观感,并没有使这两项能力获得相同排序。
论文进一步按模型组分析排名关系。世界模型组的视觉质量与三个一致性维度平均分之间,Spearman 排名相关系数只有 0.33;图像与文本条件视频模型组为 0.21。这些相关性描述当前测试中的排序关系,不能据此判断画质与几何之间的因果关系;比较生成结果时,两类指标需要分别观察。
有些结果的差异还体现在具体任务侧重上。Gen3C 在世界模型组中,视觉质量排名较后,却在输入保持上领先;LingBot-World v2 的视觉质量较强,输入保持和新区域持久性则没有取得相同优势。若只筛选画面最清晰的生成片段,很容易遗漏这些不同的能力分布。
开发者可以据此设计更有针对性的对照:调整生成细节的方法是否也保留了地标?提升画质的设置是否改变了相机响应?同一段生成结果在离开与回访之间保留了什么?这些问题需要结合对应的分项和案例作答。
运镜按要求完成,三维结构仍可能不一致
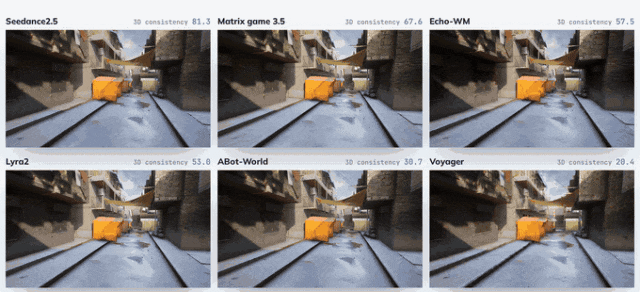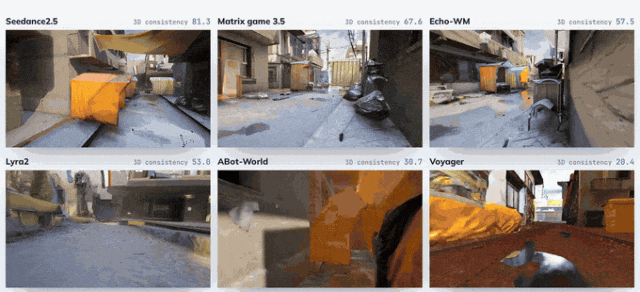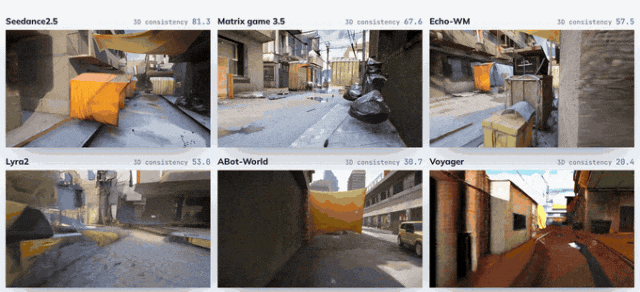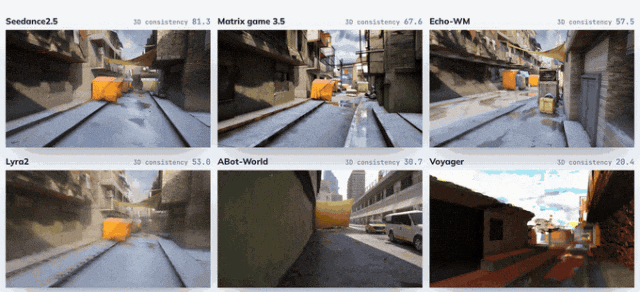
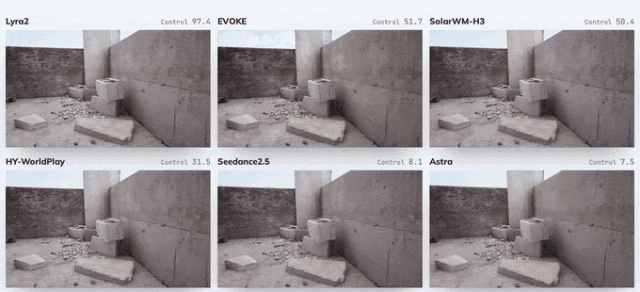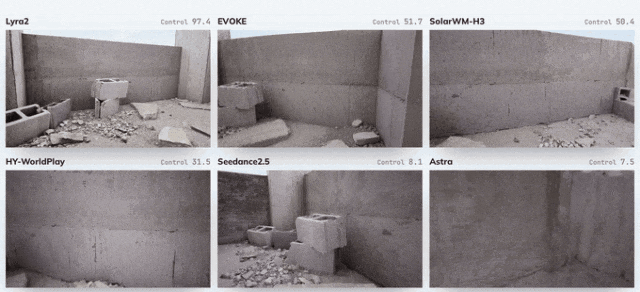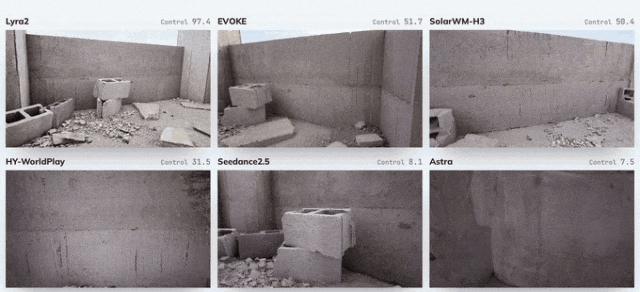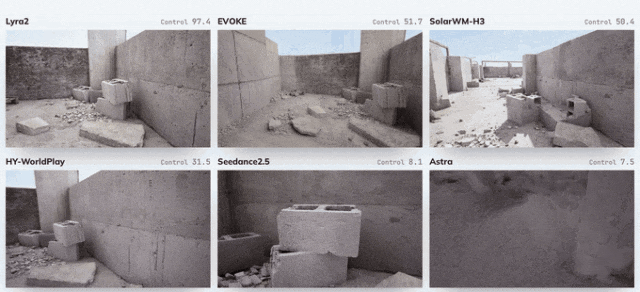
Lyra2 的控制得分为 81.64,3D 自洽 (3D Self-consistency) 为 61.51;Seedance2.5 的对应得分是 43.23与 72.54。这组数字显示,相机运动与几何自洽具有不同的模型排序。
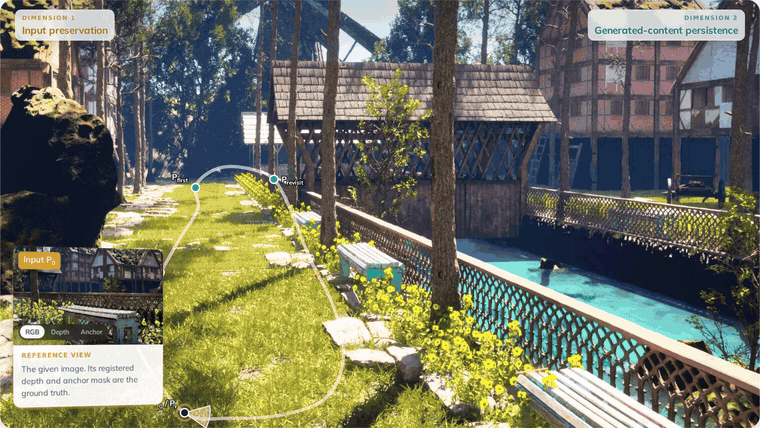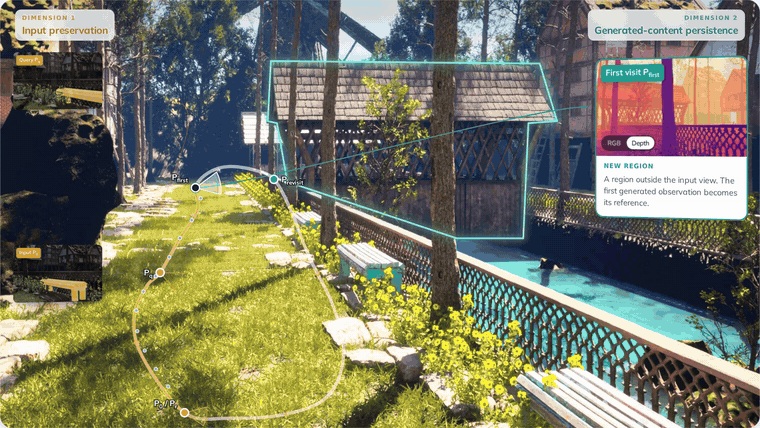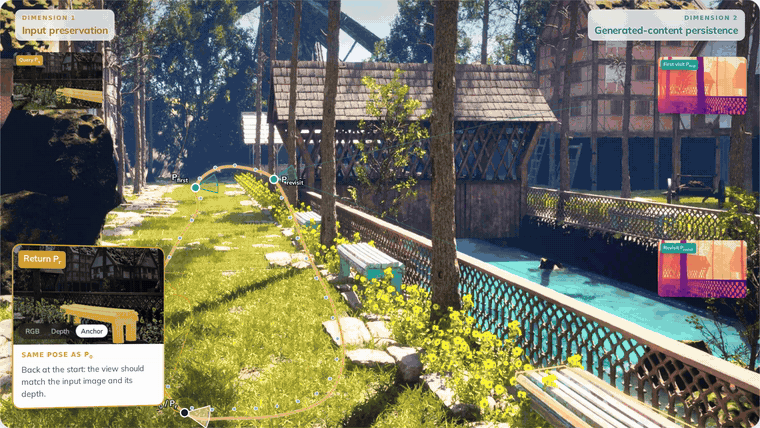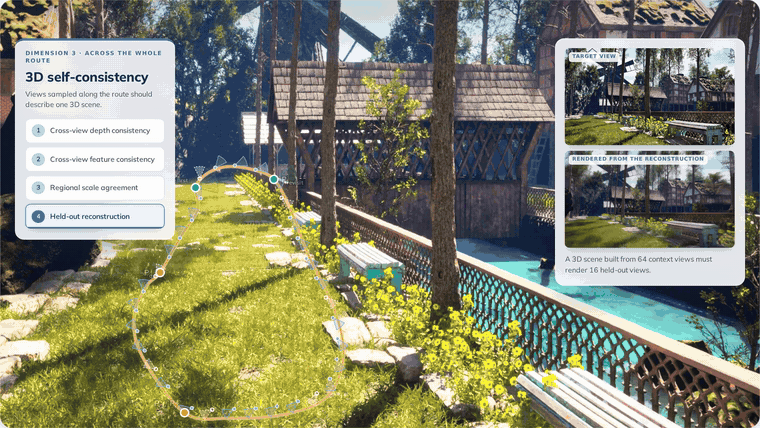
控制评测把恢复出的相机运动与目标轨迹对应,检查镜头是否按照要求移动。3D 自洽则使用生成视频恢复出的相机和深度,判断各视角中的表面是否兼容。镜头走错了路线,也可能生成一组内部相对连贯的画面;反过来,路径执行较好时,墙面、物体和尺度仍可能变化。
论文中的几何测试也没有依赖一个单独的指标。跨视角深度和特征比较检查局部对应,区域尺度检查不同部分的比例关系,而高斯场景的留出视角渲染考察更多画面能否由共享场景解释。它们对应的错误形式有所不同。
一个值得注意的例子是 FantasyWorld:它在世界模型组的两种时间间隔跨视角特征一致性上均排名第二,但重建 PSNR 接近组内末尾。局部画面能建立较好的对应,仍可能无法支持一致的整体重建。这使“几何表现好”也需要进一步说明究竟是哪种测试表现好。
外观对齐 ≠ 几何对齐,局部一致 ≠ 全局一致。 前面的对照说明,恢复了相似外观不代表物体仍处在相同的三维位置,局部对应较好也不代表能够重建出连贯的整体场景。因此,只看局部或外观一致性,往往会高估模型的 3D 一致性。
返回输入视角,与记住新区域是两项测试
Orbia 的输入保持 (Input Preservation) 测试使用配准 RGB-D 参考和地标;对新生成区域,则以该模型自己的首次输出为依据。前者考察输入约束是否得到保留,后者考察后来创建的内容能否持续存在。
世界模型组在短视频中,两项能力的模型级排名相关系数为 0.87,但在单个模型内部比较不同案例时,平均相关系数只有 0.35。较强的模型往往在两项任务上都有优势,并不代表某次成功恢复了输入图,就一定记住了其他新区域。
这种差别对案例分析很重要。如果一个模型回到起点时效果很好,测试也应查看它中途探索过的区域。仅挑选返回输入画面的结果,可能漏掉新生成内容的变化;仅看某个新区域的回访,也无法判断原始地标是否始终得到保持。
从 22 秒延长到一分钟,最先变化的可能是控制

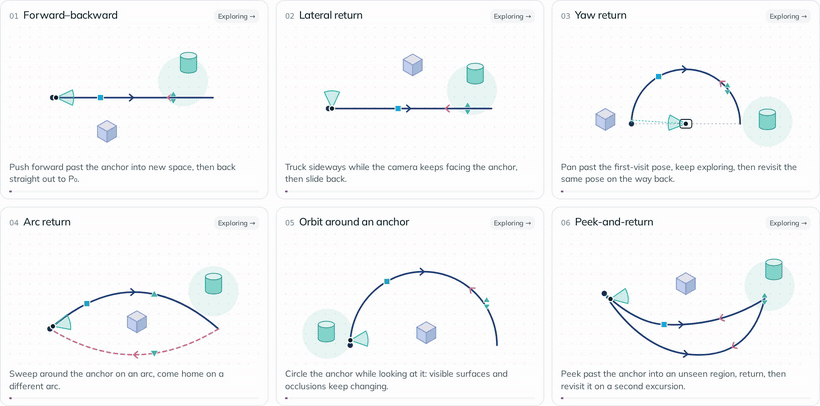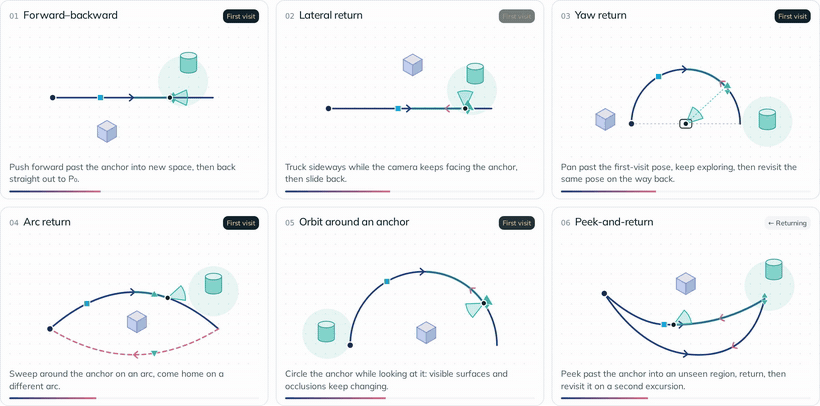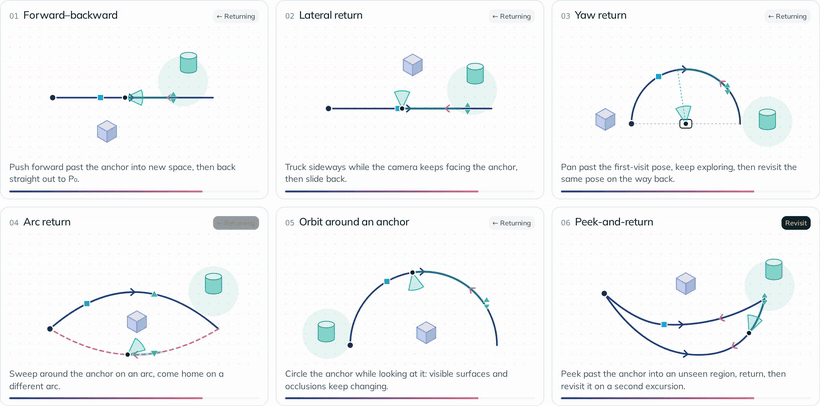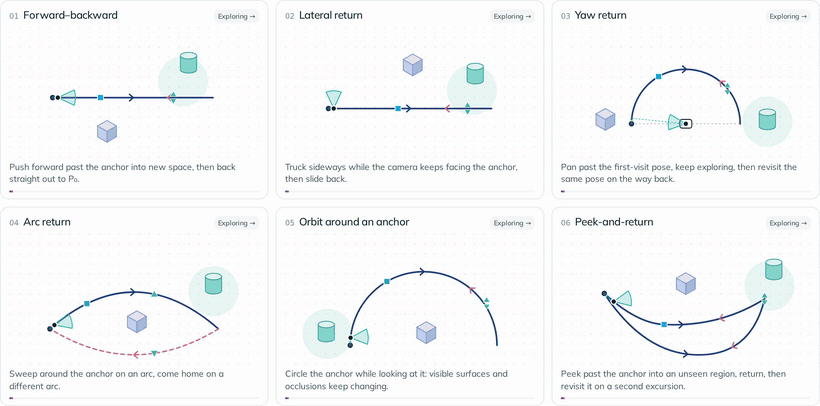
短视频与长视频并非两批完全无关的场景。基准包含 480 个约 22 秒短案例以及 240 个配对的一分钟扩展,长案例保留对应的输入、地标和参考视角,并增加运动距离与回访。这样可以检查探索历史增长时的内容保持。
在两组模型、六类轨迹中,长视频的生成内容持久性都低于短视频。世界模型组的前进后退轨迹平均分从 66.21降到 40.96,探出后返回从 64.29降到 37.32。难点并不只存在于复杂环绕;延长一个简单的往返过程,也会暴露此前不明显的遗忘。
逐五秒窗口的分析还发现,在部分领先模型中,相机控制是下降最明显的能力。八个图像与文本条件视频模型有七个的局部几何下降大于画质下降。一个视频可能仍然清晰、风格稳定,镜头执行和空间关系却已不如开始时可靠。
这类变化适合结合时间位置检查。问题从哪一段运动开始出现,是否在某次转向或回访之后加重,以及最后的图像是否还对应要求的位置,都比给整段视频一个“稳定”或“不稳定”的标签更有解释力。
变化发生在什么时间,值得进一步拆开看
长视频的分析使用连续五秒窗口,既观察每一段的表现,也比较相对开始时的变化。在 SolarWM-H3、Lyra2、EVOKE、Echo-WM 和 Gen3C 这五个世界模型中,控制从第一个到最后一个窗口平均下降 26.98 分;Seedance2.5、Kling3.0 和 Cosmos3-Super 三个视频模型的对应平均下降为 23.25 分。这些数字对应论文选择的领先模型子集,不能直接当作所有模型的平均值。
对于图像与文本条件视频模型组,局部几何的平均下降为 7.13 分,画质仅下降 2.08 分。其中,Wan2.7 的几何下降 16.26 分、质量下降 3.11 分;Cosmos3-Super 的画质略有改善,几何仍下降 5.34 分。这些结果把“视频仍然好看”与“空间是否继续稳定”的差异具体到了时间变化上。
分段结果也帮助安排后续检查。某个模型最后一次回访失败,可以继续寻找较早的控制偏差和几何变化;另一个模型可能在整体外观保持时逐渐失去局部结构。论文的窗口指标描述了这种演变,但无法仅据此确定失效机制,还需要结合生成配置与更有针对性的实验。
输入保持的分项,有时也会给出不同答案

输入保持内部包含返回、查询和身份检查。返回检查完整探索结束后是否恢复了初始场景;查询使用另一视角的参考,分析输入中可见表面;身份检查则跟踪探索途中地标是否保持一致。
论文中,Gen3C 在返回项领先,SolarWM-H3 在查询项领先,Cosmos3-Nano 在身份项领先。一个模型在起点恢复上较强,不代表它在不同视角下同样保留了所有地标。查看这几项差异,可以进一步区分探索途中发生的变化与结束后恢复的情况。
因此,案例筛选也会影响读者对模型的直观认识。某个特别成功的返回画面、某件保留完整的地标或某个新视角,都只展示其中一部分表现。用多种事件位置作对照,能够减少对少量精选结果的依赖。
排名差异之后,还能从案例里查到什么
控制与几何的差异还体现在组内排序。论文在世界模型组中报告,两项能力的 Spearman 排名相关系数在短视频中为 0.09,长视频中为 −0.04。这组结果说明,在当前测试里,两项排序几乎没有同步变化。它与前面的模型对照相互补充,也提醒结果分析需要分别回答“镜头是否走对了”与“生成视角是否彼此相容”。
对一次回访失败,可以先查看恢复出的相机轨迹:模型是否到达了对应区域,是否完成了要求的转向。如果路线已经明显偏离,观察差异中就可能包含控制执行的影响;如果位置和朝向基本对应,物体外观、地标身份与周围几何的变化则值得继续检查。Orbia 提供的分项和视频能够支持这种分析,但仅凭几个分数仍无法确定模型内部的失效原因。
同样,比较一个新模块时,可以把总体变化与固定案例中的变化联系起来。记忆改进后,首次访问和后续回访之间哪些内容保留得更好?几何约束加入后,局部对应与留出视角重建是否同时改善?再按轨迹与探索时长整理这些结果,能够使“总分提高”对应到更明确的能力变化,也便于识别仍然存在的失败。
分组结果与综合得分应该怎样读
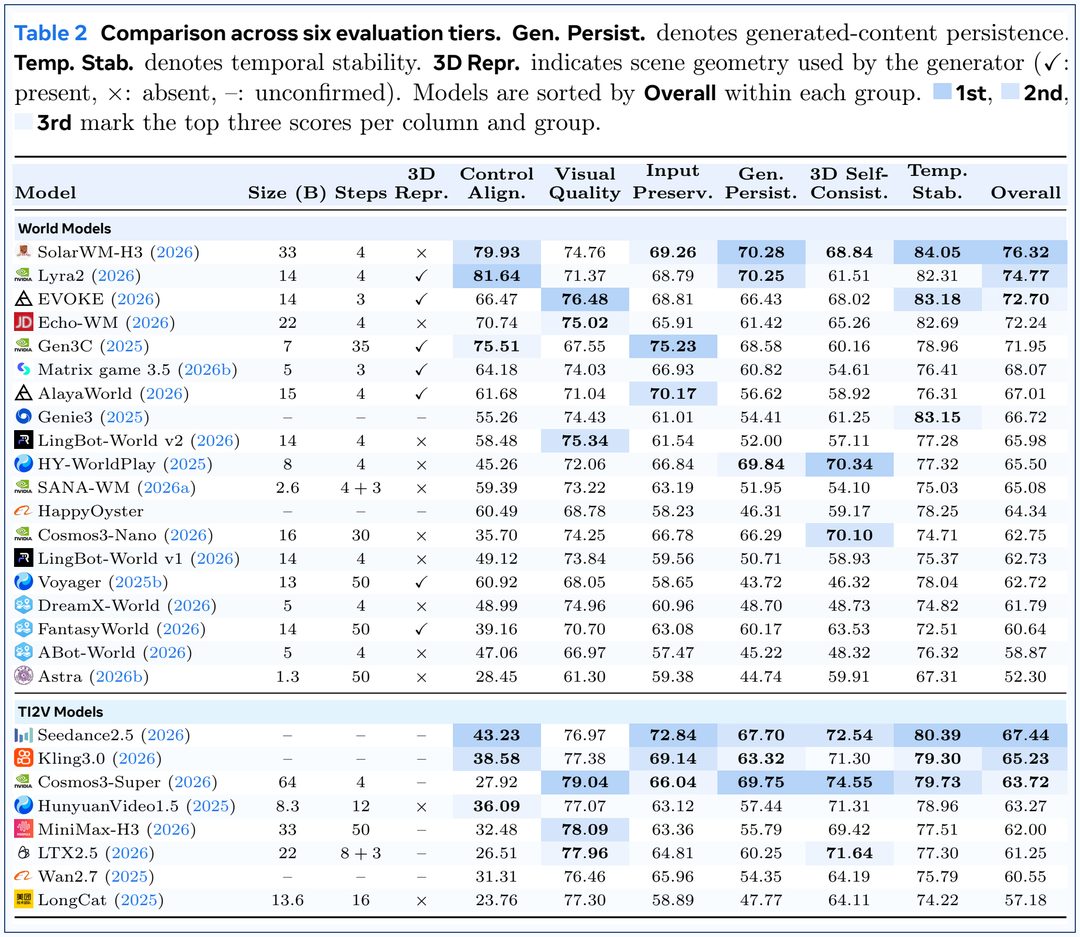
SolarWM-H3 在本次评测中以 76.32居于综合第一,Lyra2、EVOKE 分别位于第二与第三。最高分的分布则更加分散:Lyra2 领先控制,Gen3C 领先输入保持,Cosmos3-Super 在视觉质量和 3D 自洽上领先,SolarWM-H3 领先生成内容持久性和时序稳定性。
综合得分中,控制与视觉质量各占 25%,三项一致性各占 10%,时序稳定性占 20%。这个排序是既定协议与权重下的结果。关心回访的应用、关心重建的研究和关心精确运镜的系统,可以分别查看相应列,而不必把综合名次当作所有用途的统一选择。
另外,27 个模型包括 19 个相机或动作条件世界模型及 8 个图像与文本条件视频模型。轨迹经过不同接口适配,几何则依赖相机和深度恢复。论文分组结果、模型配置与具体案例能帮助解释这些影响,也为后续复现实验提供依据。
Orbia 的结果把生成中的失败具体分为内容缺失、输入地标变化、跨视角几何分歧和长时间控制下降。希望改进世界模型的团队,可以先选择与自己的方法相关的一项,再用案例和分项结果检验设计效果。
欢迎把模型带到 Orbia 上测试
这些结果也为后续模型提供了具体的比较方向:外观是否保持,物体的空间位置是否稳定,局部视角能否共同支持全局重建。Orbia 欢迎世界模型和普通视频生成模型参与评测,查看各自的优势与仍然存在的问题。
支持相机或动作等控制接口的世界模型,可以按基准的探索与回访设置完成全部六个维度的评测。普通视频生成模型即使没有相机控制接口,也能参与 3D 自洽评测;这一项依据生成视频恢复出的相机和几何,检查深度、特征、尺度及重建结果,无须先证明模型能够跟随指定镜头路线。
希望提交结果的团队,可以通过代码库查看适配、评测和排行榜提交说明。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。