从监控平台到智能运维平台,中间它究竟差了什么?
爱分享的喵手 2026-10-21 07:15 广东
以下文章来源于:程序员喵手
程序员喵手全网10W+程序员粉丝,专注于编程、算法、AI、副业、个人成长的分享。
我们拥有越来越多的监控数据,却不一定拥有越来越强的故障处理能力!
凌晨 2 点 17 分,手机开始震。
第一条告警:
order-service 接口 P99 延迟超过 2s。
还没点开监控平台,第二条、第三条紧跟着来了。
数据库连接池使用率 90%。 Redis 请求耗时升高。 某两个 Pod CPU 超过 85%。 网关 5xx 比例上涨。 Kafka 消费延迟增加。
不到五分钟,告警群里已经刷了二十多条消息。
值班同事问:“是不是数据库有问题?”
开发说:“我这边刚看了代码,应该不是应用。”
DBA 回了一句:“数据库 CPU 正常。”
领导也进群了:
“现在影响多大?根因找到了没有?多久恢复?”
说实话,做过几年运维的人,对这个场景都不会陌生。
真正让人头疼的,从来不是“没有监控”。
恰恰相反,很多公司的监控已经做得非常多了:Prometheus、Zabbix、Grafana、ELK、APM、调用链、日志平台,一个都不少。
但事故来了以后,大家还是要开着七八个页面,在几十条告警、几百个指标和几万行日志里来回切。
我们拥有越来越多的监控数据,却不一定拥有越来越强的故障处理能力。
这也是我后来越来越明确的一个判断:
从监控平台到智能运维平台,中间真正差的,不是一块“AI大屏”,而是从数据采集、异常识别、关联分析,到辅助决策和执行闭环的一整套能力。
一、传统监控平台其实已经做了很多,只是停在了“告诉你出事了”
先说一个容易被忽略的问题。
很多团队一聊 AIOps,就觉得以前的监控平台落后了,要推翻重做。
其实完全没必要。
传统监控平台仍然是智能运维的地基。
我们平时最常见的监控能力,大致可以分成几类:
基础设施监控:CPU、内存、磁盘、网络
Kubernetes 监控:Pod、Node、Deployment、容器重启
中间件监控:Redis、MySQL、Kafka、ES
应用监控:QPS、响应时间、错误率
APM:Trace、Span、调用链
日志监控:异常日志、关键字、日志量
业务监控:订单成功率、支付成功率、用户登录率
这些东西有没有价值?
当然有。
问题在于,传统监控平台通常解决的是:
“哪里发生了异常?”
但真正处理故障时,我们更关心的是:
为什么异常? 哪几个告警其实是一件事? 是应用问题、数据库问题,还是刚才那次发布造成的? 接下来应该先看哪里? 能不能快速止损?
而传统监控在这些问题上,大多只能把球重新踢给工程师。
所以你会发现一个很典型的现象:
监控建设越完善,告警反而越多。
以前没有监控的时候,是“不知道哪里坏了”。
后来监控多了以后,变成了“不知道这一堆红色里面,哪个才是真正的问题”。
二、为什么传统运维越来越吃力?问题不只是“人手不够”?
以前我们也干过这种事情。
每个系统配几十条告警规则。
CPU 超过 80%,报警。 内存超过 85%,报警。 接口耗时超过 1 秒,报警。 错误率超过 5%,报警。
一开始感觉很安心。
后来系统规模起来以后,就完全不是那么回事了。
一个底层网络抖动,可能同时触发诸多问题,具体如下图所示:
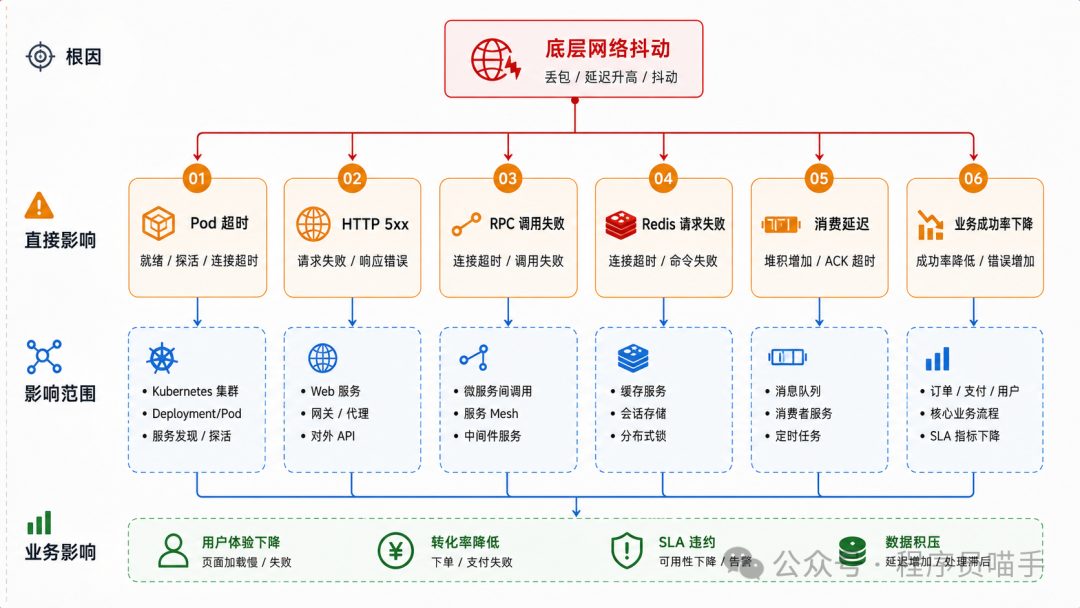
实际上只有一个故障,却能炸出来几十条告警。
值班同事最怕的,就是这种“告警风暴”。
1、数据很多,但彼此是割裂的
指标在 Prometheus。
日志在 Loki 或 ELK。
Trace 在 SkyWalking、Jaeger。
发布记录在 Jenkins、GitLab CI。
工单在另外一个平台。
CMDB 又是一套系统。
真正排障时,人脑负责把这些信息拼起来。
比如接口突然变慢,你通常会这么查:
先看 Grafana。
发现订单接口延迟升高。
再去 APM。
发现调用 inventory-service 花了 2.3 秒。
继续点进去。
发现 inventory-service 在访问 Redis 时变慢。
再去 Redis 监控。
发现节点负载并不高。
这时候再查日志。
发现大量 timeout。
最后问了一圈,才知道 10 分钟前刚做过一次网络策略变更。
整个过程,问题不一定难。
难的是信息散落在不同地方。
2、很多能力依赖“老人脑子里的经验”
以前我们经常遇到一种情况:
同一个故障,老运维十分钟解决。
新人查两个小时。
为什么?
因为老同事知道:
“这个错误去年出现过,大概率是连接池。”
“如果 QPS 没涨但 RT 暴增,先别看 CPU,看下游。”
“这个服务只要出现某个日志,十有八九是配置中心推送异常。”
这些经验如果没有沉淀下来,本质上就是“个人缓存”。
人离职了,经验也跟着清空。
3、规则太死,阈值并不懂业务
固定阈值还有一个很大的问题。
例如 CPU > 80% 就报警。
但对于某些计算任务,CPU 长期 90% 都是正常的。
反过来,一些核心服务 CPU 从 20% 突然涨到 55%,虽然没超过 80%,但可能已经明显异常。
传统规则关注的是:
“有没有超过阈值?”
更有价值的问题应该是:
“当前行为是不是偏离了它自己的正常模式?”
这就是异常检测开始有价值的地方。
三、真正的智能运维,不是多一个AI聊天框
我见过一些所谓的“AIOps平台”。
首页做得很漂亮。
右下角放一个聊天机器人。
你问:
“为什么订单服务异常?”
它回答:
“可能是网络、数据库、应用代码或资源不足导致,建议进一步排查。”
这种东西,说实话,对值班工程师帮助非常有限。
因为真正有价值的 AIOps,必须建立在已有运维数据和系统关系之上。
我通常把它理解成四层。
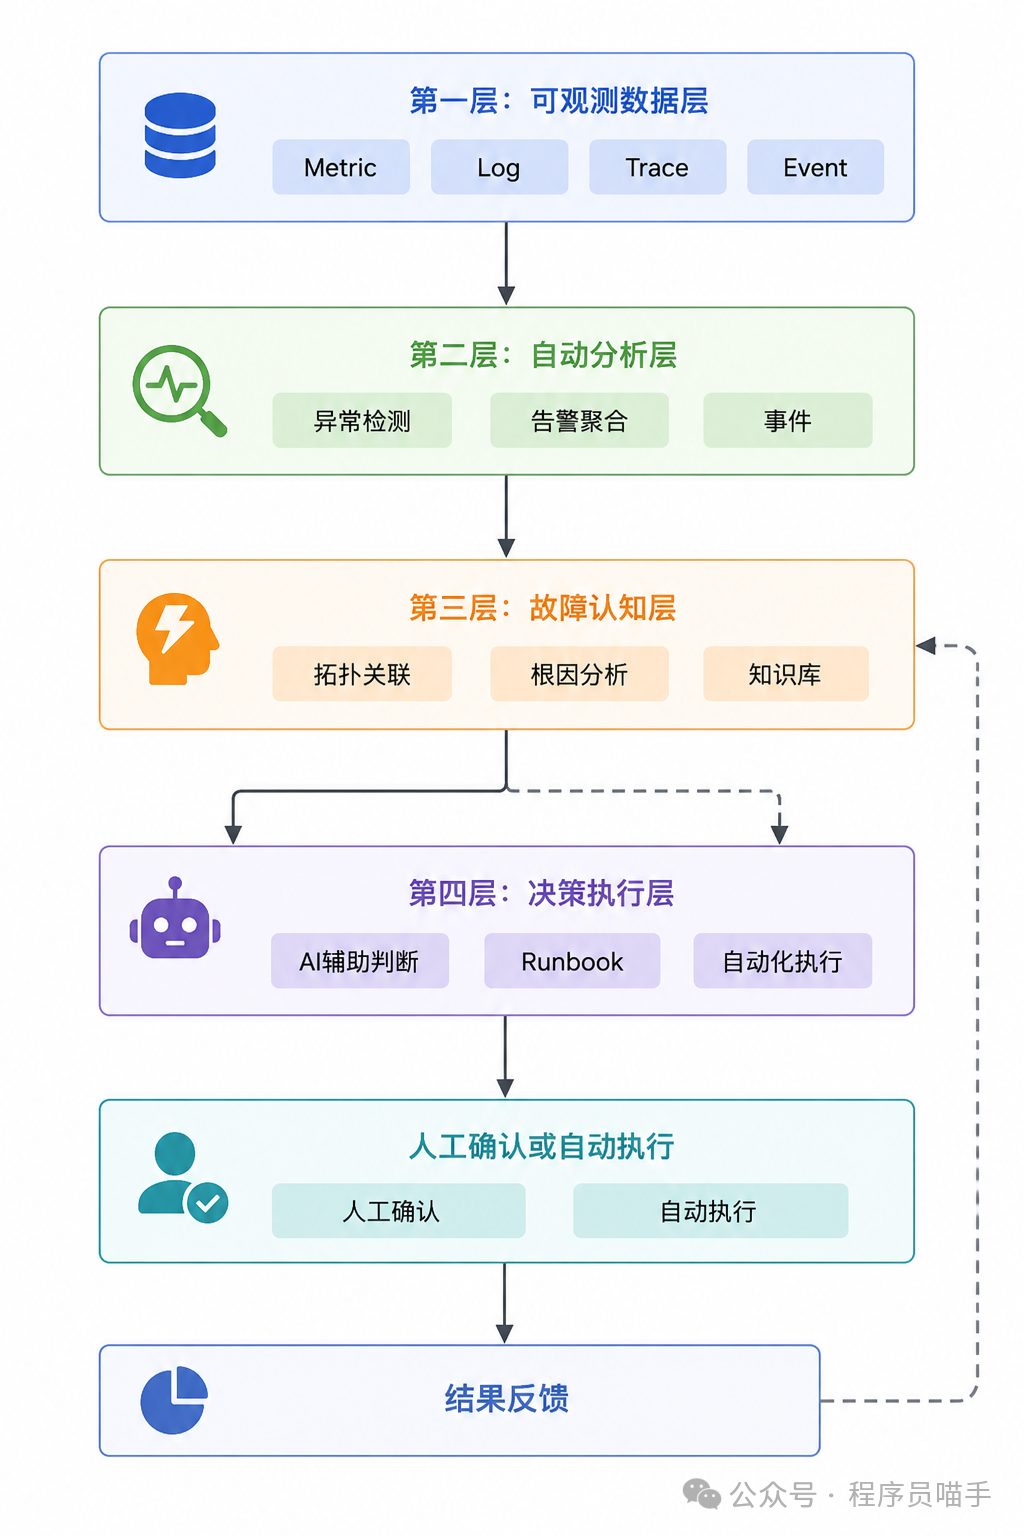
传统监控平台大部分停留在第一层。
成熟一点的平台能做到第二层。
真正开始有“智能运维味道”的,是第三层和第四层。
四、AIOps到底可以在哪些地方真正帮上忙?
第一类:把几十条告警压缩成一个事件
假设一次 Redis 故障引发:
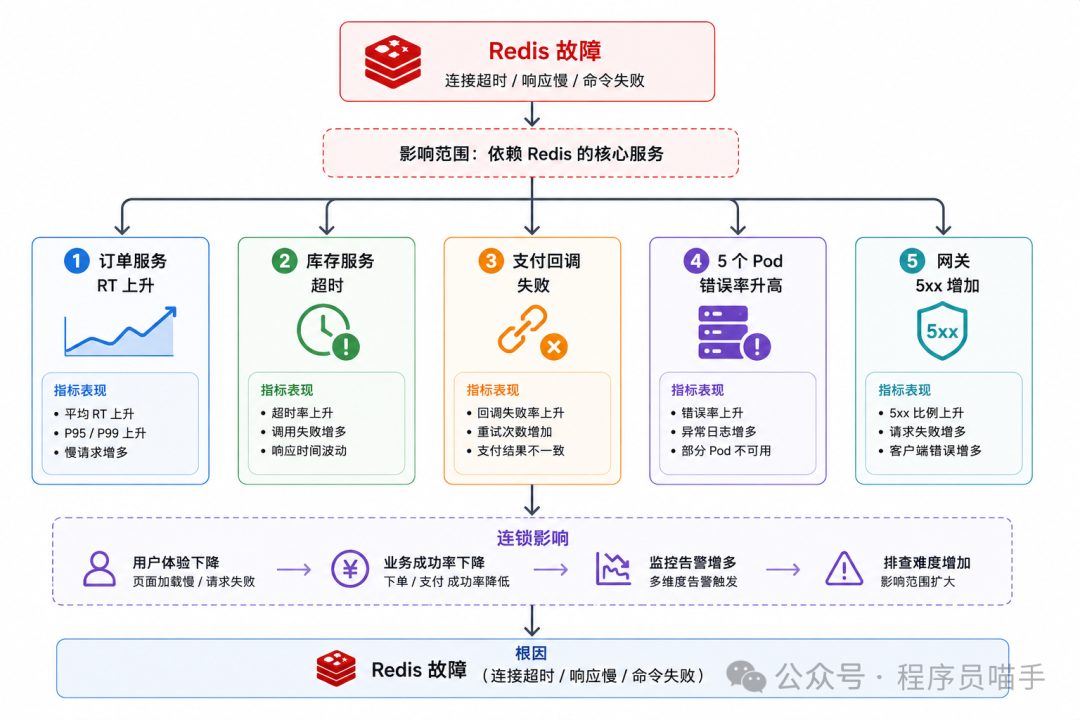
传统平台可能发送 30 条告警。
AIOps 更合理的处理方式是:
先按时间窗口聚合。
比如 3 分钟以内出现的相关告警进入同一个事件池。
然后再根据:
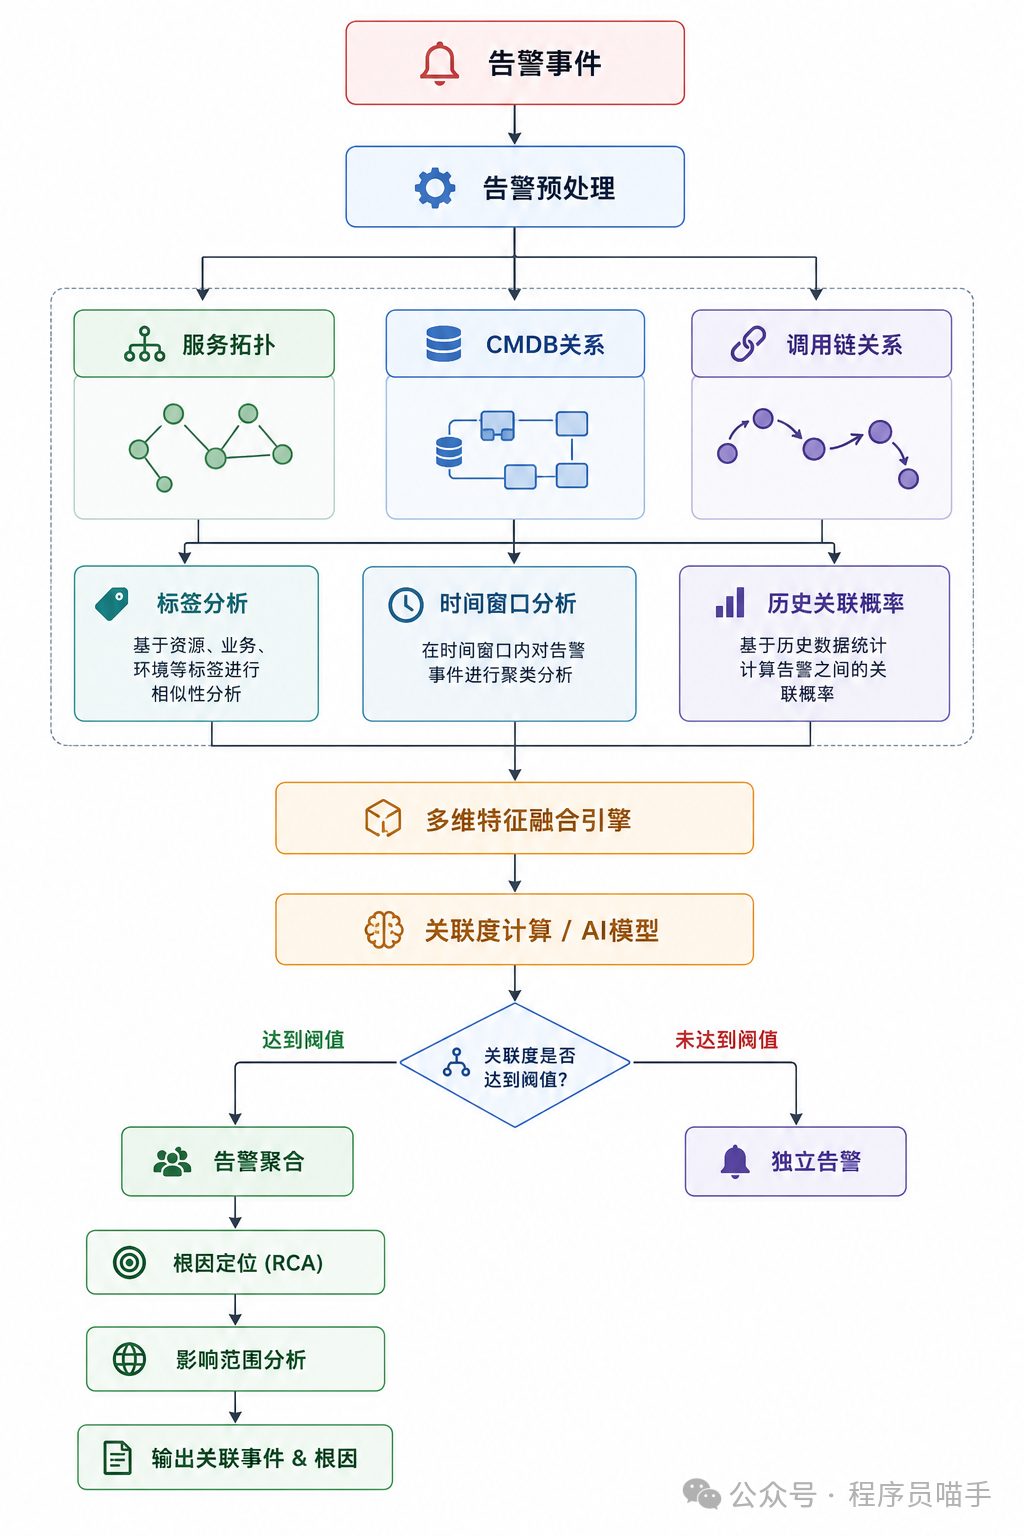
判断这些告警是不是同一个事故。
最后值班同事看到的可能不是 30 条报警,而是一条:
订单链路异常事件影响服务:order、inventory、payment 首个异常节点:Redis Cluster 相关告警:27 条 发生时间:02:17 可能影响:订单提交。
这一层就已经能明显降低值班压力。
第二类:发现“还没达到阈值,但已经不正常”的问题
异常检测特别适合一些周期性明显的指标。
比如某个接口每天中午 QPS 都会达到 8000。
你不能简单设置:
QPS > 5000 报警否则天天报警。
但如果这个接口每天中午正常应该是 8000 左右,今天突然只有 3000,那反而应该关注。
一个比较实用的思路是建立动态基线:
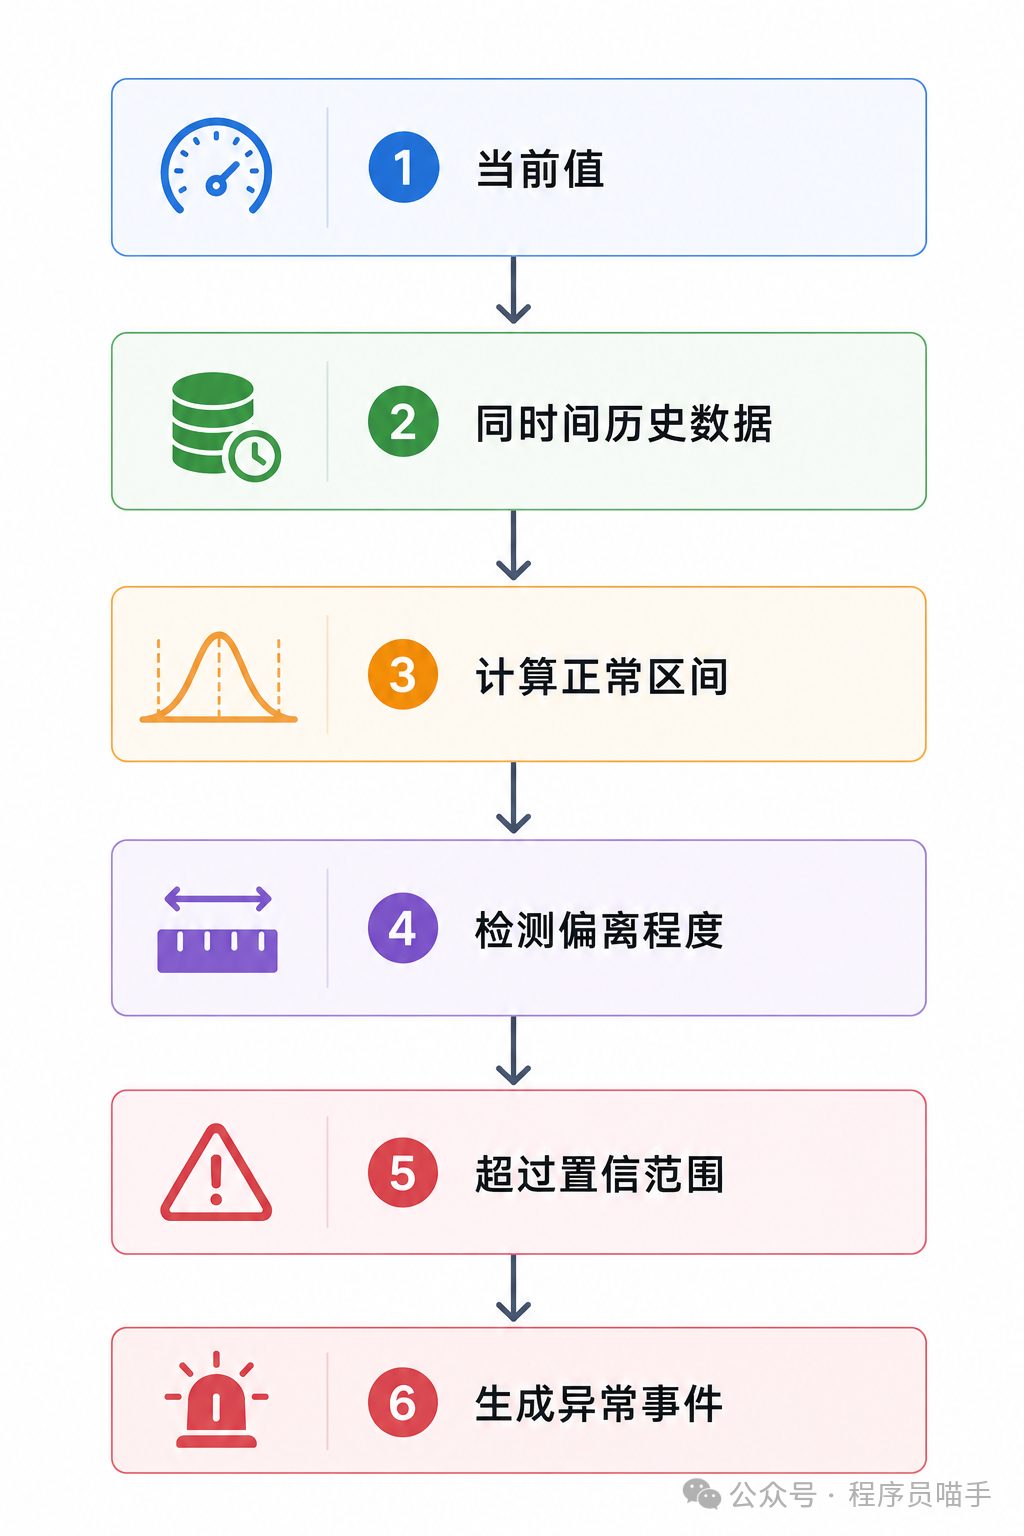
这里不一定非得上什么复杂模型。
很多场景用:
滑动平均
同比
环比
标准差
EWMA
季节性基线
就已经很好用。
AIOps不是算法越复杂越高级。
能稳定减少误报,才是高级。
第三类:日志不用再从头翻到尾
线上事故的时候,最浪费时间的一件事情就是翻日志。
特别是微服务系统。
一个请求可能穿过七八个服务。
每个服务几百行日志。
以前大家常干的事情就是:
grep ERROR app.log然后继续 grep traceId。
最后在几千行里面找那句真正关键的异常。
现在比较实用的一种方式,是先让平台做日志聚类。
把高度相似的日志归到一起。
例如:
Connection timeout to redis 10.1.1.*虽然 IP 不同,但本质是同一类错误。
平台可以进一步统计:
异常模板:Connection timeout to Redis5分钟出现次数:2389首次出现:02:17:06涉及实例:inventory-service-01inventory-service-02order-service-05关联变更:02:10 网络策略发布
再让大模型生成摘要。
这时候 AI 就开始真正有用了。
因为它不是“凭空猜”。
它是在已经整理过的数据上做总结。
五、从监控平台升级到智能运维平台,我建议分四步走
很多团队踩过一个坑:
一开始就立项建设“全自动AIOps平台”。
目标特别大:
自动发现、自动诊断、自动修复、无人值守。
最后搞了一年,做了个大屏。
我的经验反而是:
先解决最痛的一个问题。
第一步:先把数据统一起来
AIOps最怕什么?
不是模型不够强。
是数据乱。
至少要先统一这些数据:
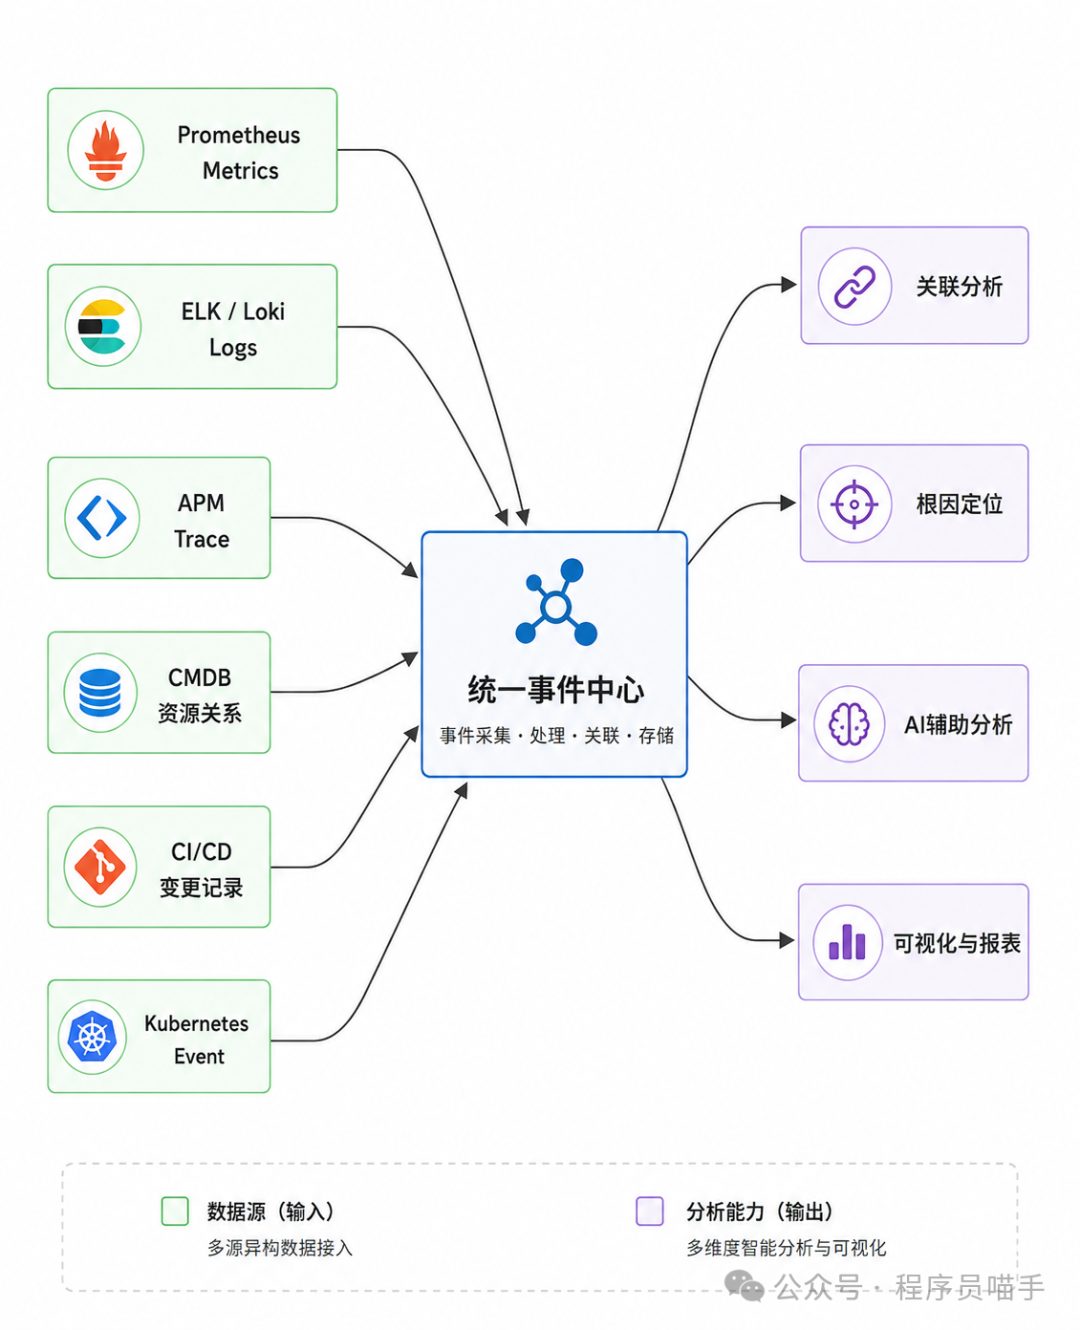
这里最重要的不是“全部数据导入一个数据库”。
而是统一关键字段。
例如:
service_nameclusternamespaceinstancehostapplicationenvtrace_idchange_id
如果 Prometheus 里面叫:
service=orderCMDB 里面叫:
app_name=order-service日志平台里面又叫:
application=order-prod后面的关联分析基本没法做。
所以第一阶段,宁可少接几个数据源,也要把服务身份统一好。
第二步:先做告警治理,不要急着做AI
这是我非常建议先做的一步。
统计最近一个月的告警。
重点看:
总告警量
重复告警比例
无效告警比例
Top 20 告警
高频夜间告警
自动恢复告警
长期无人处理告警
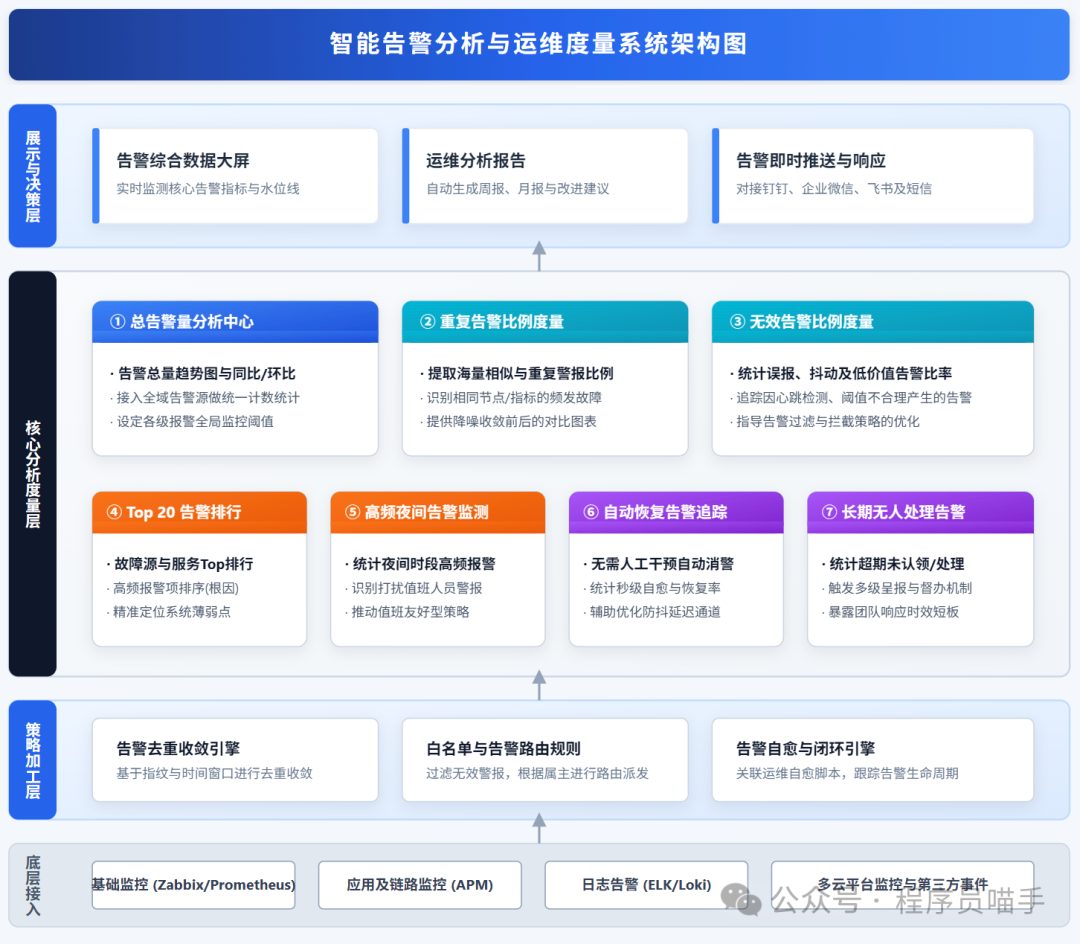
你会很惊讶。
很多公司的告警里,至少有相当一部分根本没人看。
典型的:
CPU 80%,一分钟以后恢复。
某个 Pod 重启一次,但业务无影响。
测试环境磁盘报警。
一个已经下线的服务还在报警。
这些告警如果不治理,直接拿去做AIOps,模型只会更乱。
建议先完成:
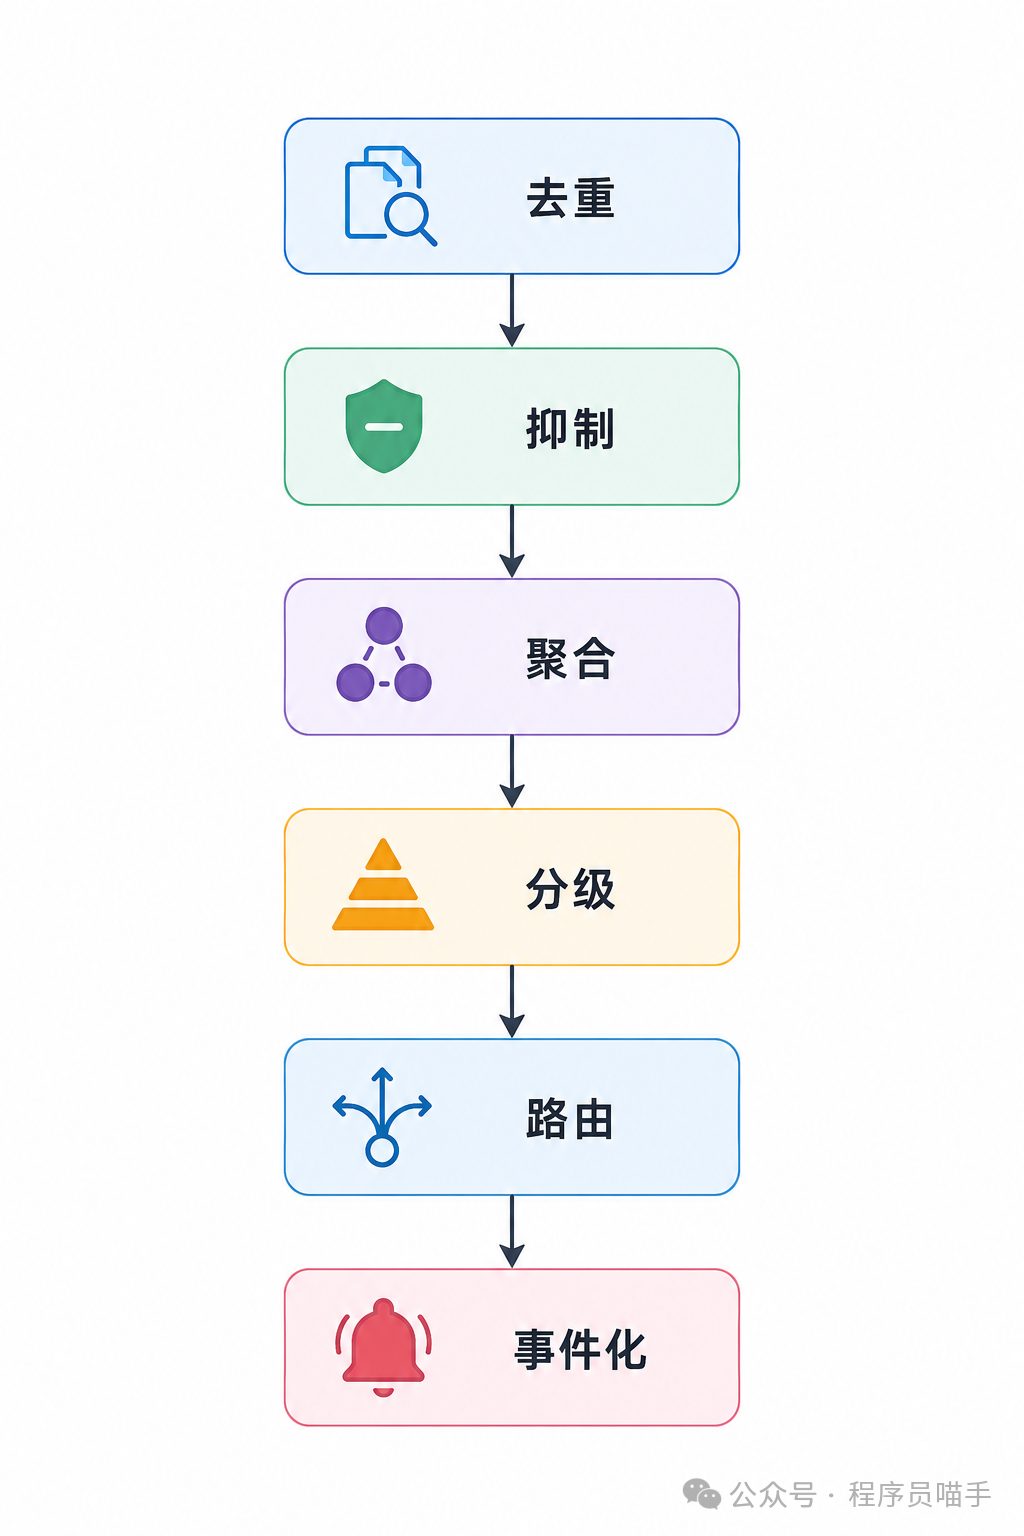
比如同一个服务 1 分钟内出现 20 条相同告警,只保留一条。
下游已经明确故障,上游衍生告警可以降级。
同一个业务链路异常,合并成一个事件。
做到这一步,哪怕没有AI,值班体验都会明显改善。
第三步:加入关联分析和根因候选
这一步开始真正往智能运维走。
核心是建立服务关系图。
比如:
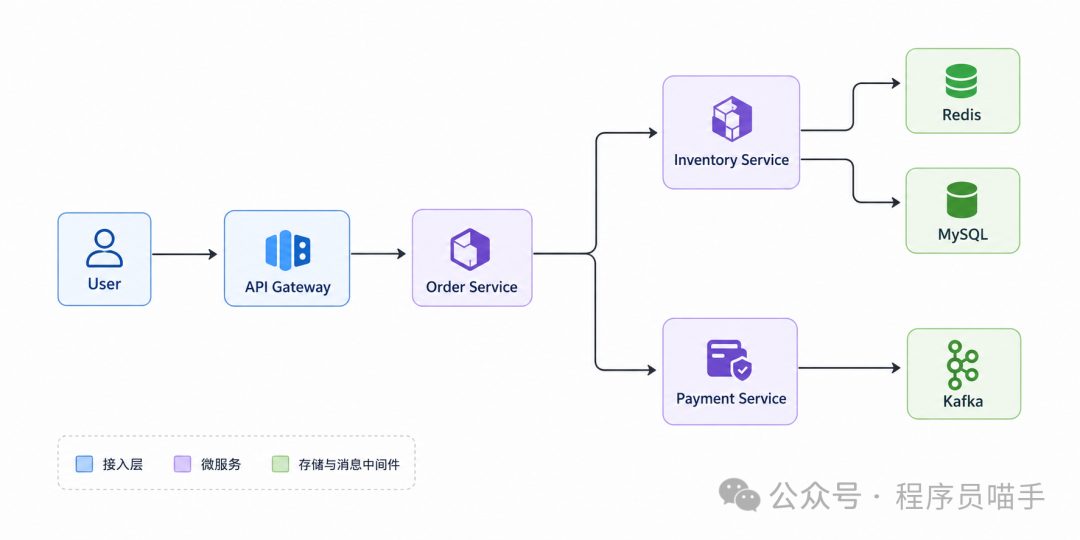
假设现在:
Order RT 上升
Inventory 出现超时
Redis 延迟上升
Payment 正常
Kafka 正常
平台就可以根据调用链判断:
Order异常↓Inventory异常↓Redis异常
再结合异常发生顺序:
02:17:03 Redis延迟02:17:08 Inventory超时02:17:11 Order P99升高
那么 Redis 的根因权重自然更高。
这并不意味着平台能百分之百确认 Redis 就是根因。
更合理的输出应该是:
根因候选 1:Redis 访问延迟异常,置信度 78% 根因候选 2:Inventory 服务线程池阻塞,置信度 46% 建议优先检查 Redis 节点连接状态。
我反而不太喜欢平台直接告诉你:
“根因已确定。”
线上故障这么复杂,过度自信很危险。
第四步:再让AI参与判断和执行
到这一步,大模型和运维 Agent 才真正有比较好的发挥空间。
一次故障来了以后,可以自动收集:
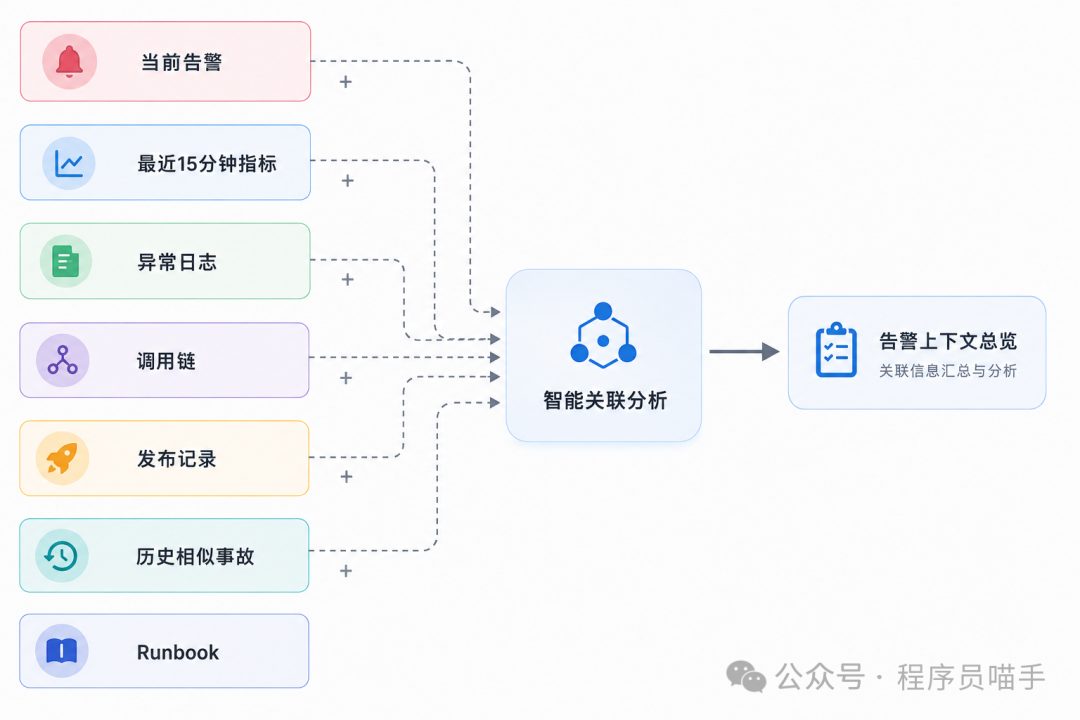
然后交给运维 Agent。
它可以生成:
事故分析摘要
02:17 Redis 请求延迟开始异常。 02:18 inventory-service 出现大量 Redis timeout。 随后 order-service P99 从 300ms 升至 2.4s。
02:10 存在一次网络策略变更,与异常时间接近。
历史事故 INC-2024-0812 出现过类似现象,当时原因为 NetworkPolicy 配置错误。
建议操作:
1)检查 Redis 节点连通性;
2)对比 02:10 NetworkPolicy 变更;
3)必要时回滚网络策略。
这类输出对值班人员就很有价值。
因为工程师不用再花二十分钟收集上下文。
AI先把材料准备好了。
六、自动修复千万别一上来就“全自动”
我对自动修复一直比较保守。
原因很简单。
判断错了,最多定位慢一点。
执行错了,可能直接扩大事故。
所以我更建议分三级。
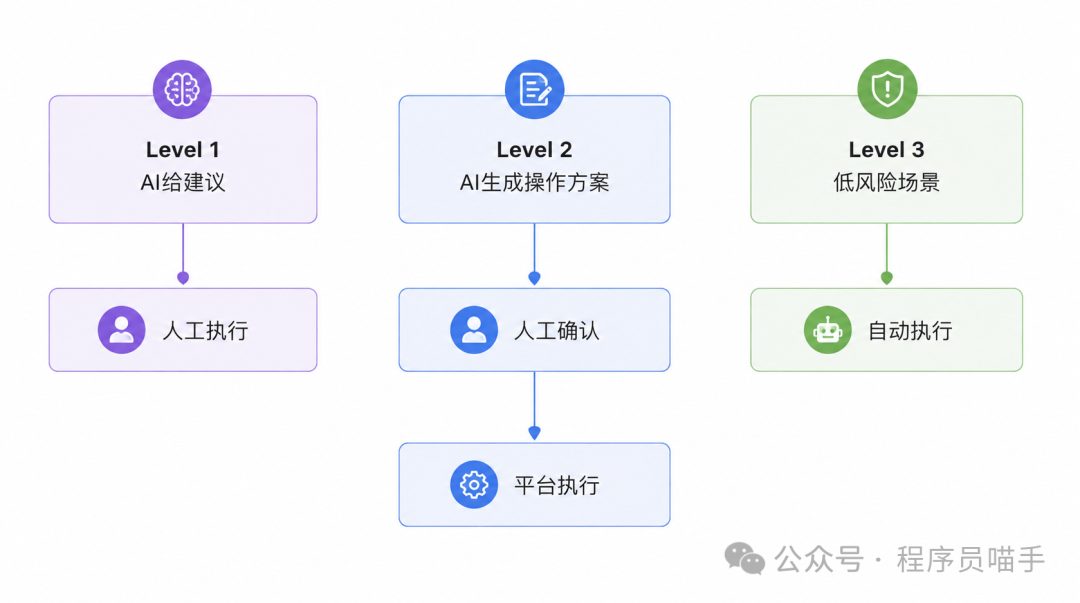
Level 1
AI只负责判断。
例如:
建议扩容 Pod。
工程师自己执行。
Level 2
AI生成操作计划。
比如:
kubectl scale deployment order-service --replicas=10但必须人工确认。
Level 3
只有充分验证过的低风险场景才自动化。
例如:
重启无状态异常 Pod
清理临时磁盘
扩容 worker
切换只读流量
执行标准化故障转移
而且自动执行必须有:
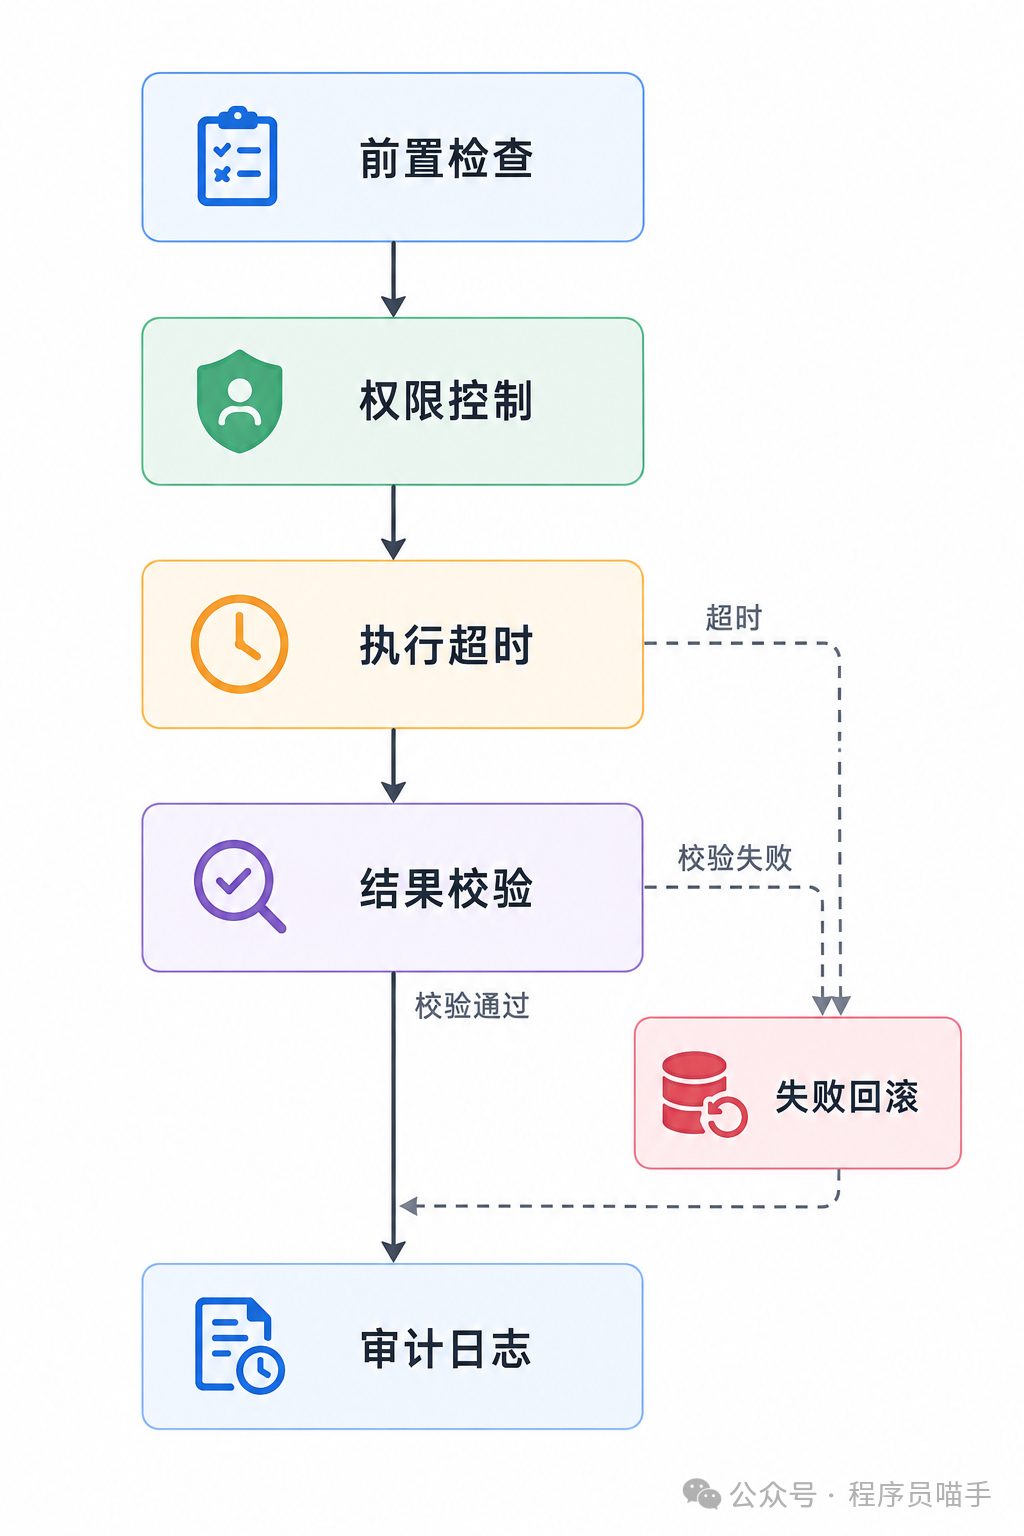
没有这些东西,所谓自动修复就是自动制造事故。
七、AIOps落地最容易踩的几个坑
坑一:数据不准,却一直调模型
这个问题特别常见。
CMDB里面服务关系都错了。
实例早就下线了还存在。
日志标签也不统一。
然后团队一直调模型参数。
其实方向完全错了。
垃圾数据进入,再好的模型出来也是垃圾结果。
坑二:知识库什么都往里面塞?
有团队做运维知识库。
把:
Wiki
聊天记录
故障报告
PDF
操作文档
过期方案
全部丢进去。
最后问:
“Redis故障怎么处理?”
AI给你返回三年前的操作步骤。
甚至里面的集群名称早就不存在了。
运维知识库一定要做版本管理。
至少标记:
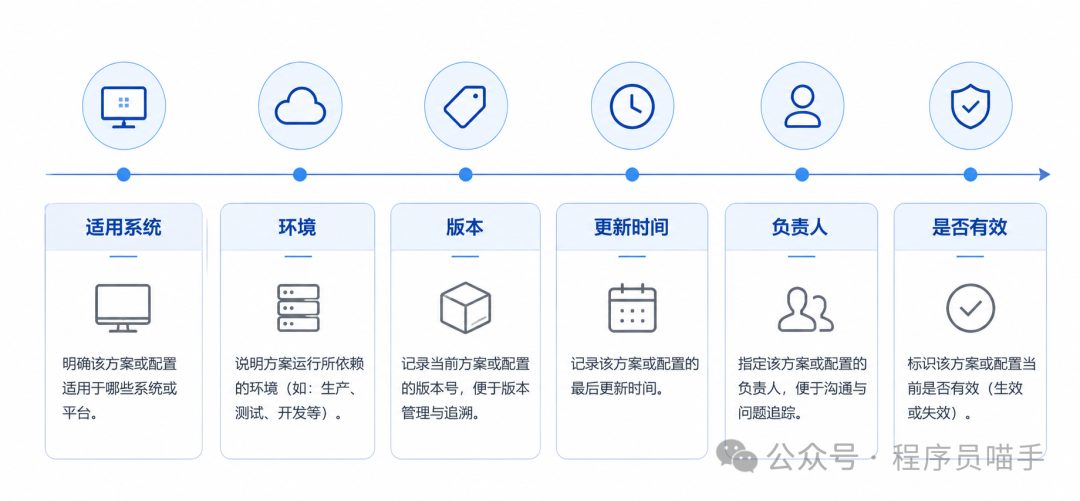
过期知识必须下线。
坑三:太迷信大模型,不做规则和算法
AIOps不等于LLM。
实际生产里,很多问题:
告警去重,用规则更稳定。
异常检测,用统计方法更合适。
调用链分析,用拓扑算法更靠谱。
大模型最擅长的是:
信息总结
自然语言交互
知识检索
运维报告生成
多来源信息解释
辅助生成处置方案
别什么事情都让大模型干。
合适的工具解决合适的问题。
坑四:一开始场景铺太大
我见过比较成功的AIOps项目,一般都不是从“智能运维平台”开始。
而是从一个具体问题开始。
例如:
“把夜间告警减少50%。”
或者:
“把数据库类故障定位时间从30分钟降低到10分钟。”
再或者:
“先实现发布异常和监控指标自动关联。”
目标越具体,越容易验证价值。若你还要学习更多系统性专业性的AIOPs,建议直接订阅如下全套课程体系,零基础手把手教学!
八、最后说点我的真实感受
做运维这些年,我越来越觉得:
真正折磨人的不是系统复杂。
而是大量重复判断。
凌晨收到几十条告警。
打开监控。
查日志。
找 Trace。
问开发有没有发布。
问 DBA 有没有异常。
搜索以前的事故报告。
这些事情我们做了一遍又一遍。
而AIOps真正应该解决的,恰恰就是这些重复劳动。
它不应该取代工程师判断。
而应该先替工程师完成:
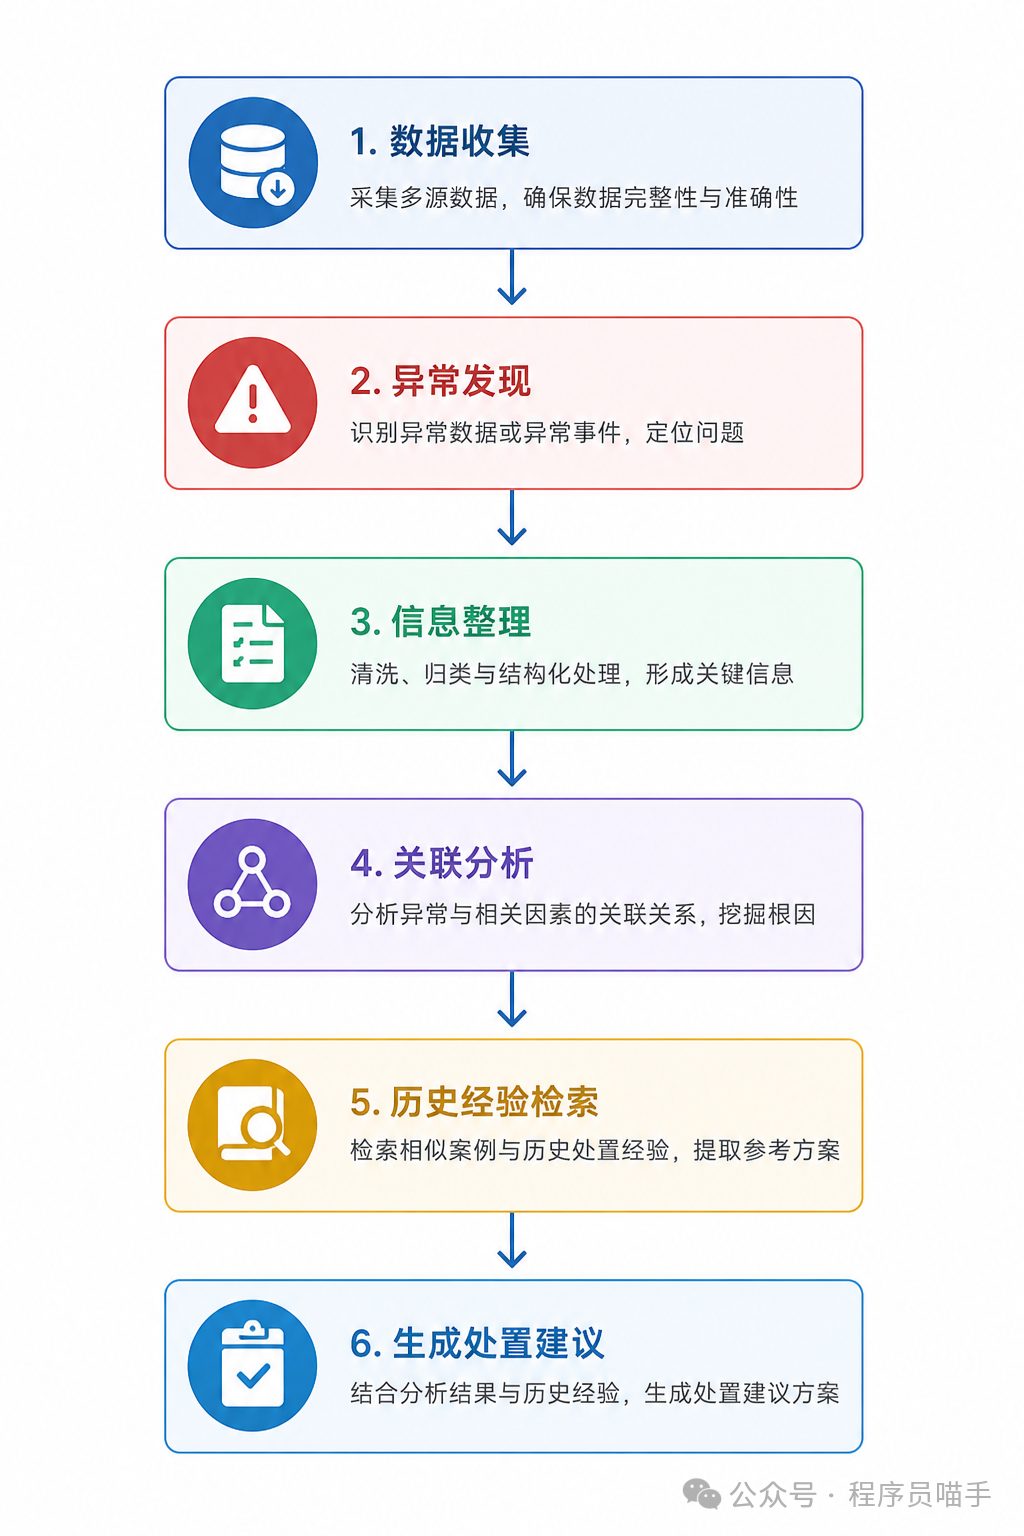
最后再让人做关键决策。
所以从监控平台到智能运维平台,我认为真正差的是三种能力:
第一,自动发现问题。
不只是超过阈值,而是识别真正异常。
第二,自动理解问题。
把指标、日志、调用链、拓扑和变更串起来。
第三,辅助处理问题。
给出有依据的根因候选、操作建议,甚至在安全边界内自动执行。
做到这里,AIOps才算真正开始产生价值。
它不会让运维从此没有故障。
也不会让值班同事彻底告别凌晨两点。
但它至少能让我们从:
“几十个人围着事故群一起猜。”
慢慢变成:
“平台先把问题缩小到两三个方向,人来做最后判断。”
我觉得,这才是智能运维真正值得期待的地方。
不是让AI替代运维。
而是让运维工程师少一点重复救火,把更多时间花在容量规划、稳定性治理、架构优化和自动化建设上。
毕竟一个成熟的SRE团队,真正应该追求的从来不是:
“故障来了以后处理得有多快。”
而是:
“同样的故障,下一次还能不能发生。”
作者丨爱分享的喵手
来源丨公众号:程序员喵手(ID:gh_31e225ac4b67)
dbaplus社群欢迎广大技术人员投稿,投稿邮箱:editor@dbaplus.cn

本文转载自微信公众号「dbaplus社群」,查看原文。版权归原作者所有,如有侵权请联系删除。