RSI不再烧钱!唐杰署名开源HarnessPro,Agent越进化越便宜
原创 让你更懂AI的 2026-10-22 19:55 北京
RSI也开始算性价比
清华、智谱团队的这项新研究,让 Harness 在复盘中学会了算账,分数更高,花钱更少。
唐杰的名字,又出现在一篇 Agent 论文的共同通讯作者名单里。
这一次,来自清华大学、智谱、上海交大、华威大学和可灵 AI 的研究团队,把执行成本也纳入了 Harness 的自我进化。
现有的 Harness RSI 方法已经能够从执行轨迹中总结经验、自动改进运行规则。但更充分的探索和验证往往伴随着更多 token 消耗,agent 的成绩涨了,账单也跟着涨。
研究团队提出的 HarnessPro,会同时复盘任务失败和多余开销,再用 AI 生成的测试筛选候选方案,兼顾性能与成本。
在 GPT-5.5 搭配 Codex 的三个基准上,Heavy 方案相较 RHO 的平均任务通过率提高 2.0 个百分点,单任务执行成本平均下降 26.1%。
除了追求性能的 Heavy,它还提供兼顾两端的 Medium 和省钱优先的 Lite。三档方案面向不同预算需求,代码已经开源。
论文标题:
HarnessPro: Recursive Harness Self-Improvement with Pareto Optimization for Performance-Cost Trade-offs
论文地址:
https://arxiv.org/abs/2610.26770
代码地址:
https://github.com/pzs19/HarnessPro
项目主页:
https://pzs19.github.io/HarnessPro/
RSI 的成本困境
以 RHO 为例,在 GPT-5.5 搭配 Codex 的 SWE-Bench Pro 实验中,通过率从原版 Harness 的 59.0% 提高到 80.0%,单题成本却从 1.88 美元涨到 2.68 美元,增幅达 42.6%。
直接减少推理和工具调用固然省钱,却可能牺牲任务通过率。
Harness 涉及代码、指令和工具配置的离散组合,难以直接通过梯度优化,想同时提高成绩、压低成本并不容易。
HarnessPro 将提高通过率、降低执行成本设为两个优化目标,以初始 Harness 的通过率作为候选筛选底线,在庞大的配置空间里寻找更合适的性能—成本组合。
论文中的执行成本根据模型输入、缓存输入和输出 token 的用量,以及对应单价折算。
此前,SkillMOO 已将成本纳入 skill 优化,RHO 也已实现无标签的 harness 组件改进。
HarnessPro 进一步将无标签反馈、整套 Harness 的递归修改与 Pareto 多目标优化结合起来,一次进化保留多种方案。
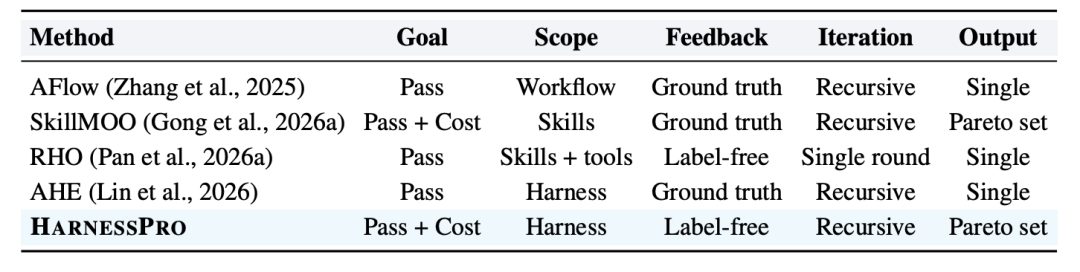
〓 HarnessPro 与已有 Harness 自我改进方法的对比
四个智能体协作进化
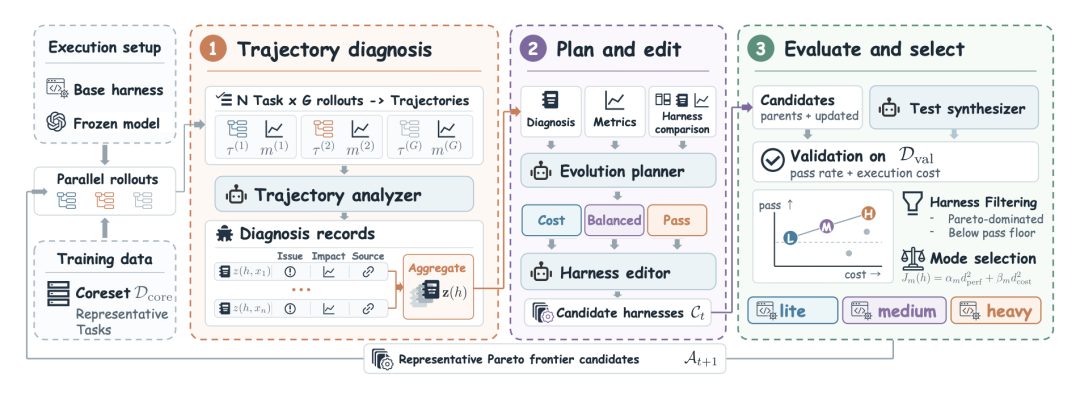
HarnessPro 设置了四类智能体:轨迹分析器、进化规划器、Harness 编辑器和测试生成智能体。
每个基准先通过行列式点过程(DPP)选取 10 项训练任务,兼顾任务难度与多样性。候选方案再由独立验证集筛选,最终使用保留测试集评估。
〓 HarnessPro 整体框架图
每轮进化时,系统让当前保留的每套 harness 在每项训练任务上独立运行 3 次。
轨迹分析器汇总失败原因、冗余开销和对应的执行记录。规划器结合这些诊断以及其他候选的代码差异,分别提出省钱优先、均衡、性能优先三类改进方案。
编辑器在独立工作区落实修改,新版本与上一代 harness 一起参评。所有改动都要面向通用任务,不能靠跳过必要验证来压低账单。
〓 HarnessPro 的递归自我改进算法
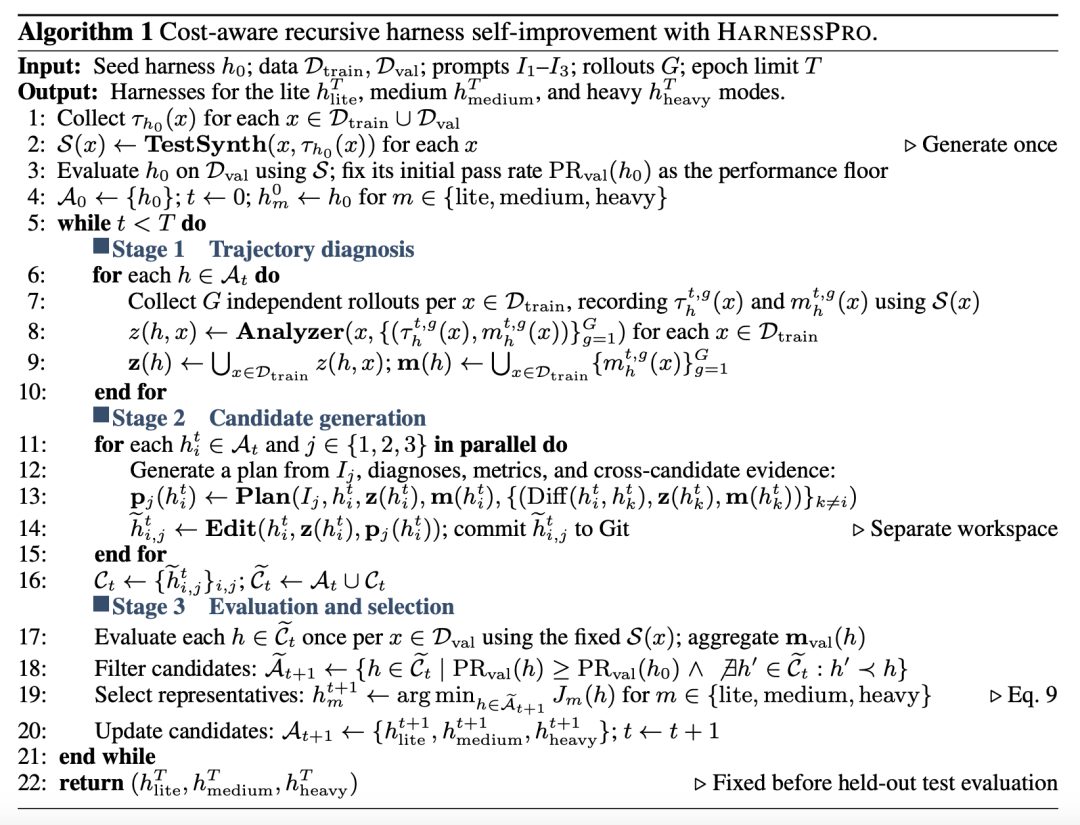
筛选依据验证集上的生成测试结果和执行成本,先淘汰通过率低于初始 harness 的候选方案。
如果另一候选的通过率不低、成本不高,而且至少一项指标更好,当前方案也会被淘汰,这就是帕累托支配。
剩余候选按归一化加权平方距离选出三档代表:
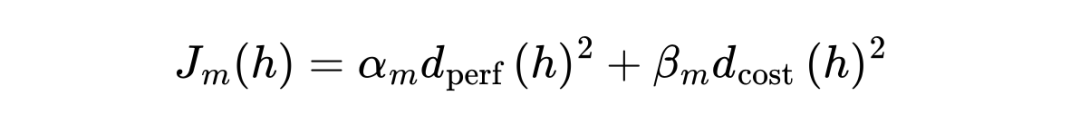
其中,两项距离分别衡量候选与当前最高通过率、最低成本之间的差距。Lite、Medium、Heavy 的性能与成本权重分别为(1,2)、(1,1)、(2,1)。
每轮最多保留三个不同的 harness。进入下一轮后,每套保留方案都会重新尝试三种优化方向,再统一筛选。
让 AI 自己出考卷
候选筛选还有一道难题:进化阶段无法使用官方测试和标准答案,怎么判断修改是否有效?
RHO 依赖大模型比较执行轨迹、判断候选优劣。研究团队发现,这类模型裁判往往过于乐观,有缺陷的实现也可能被判为成功。
HarnessPro 改由测试生成智能体出题。
它根据任务要求和初始执行轨迹,为每项训练、验证任务编写 10 个可执行测试。
初始程序可以帮助理解接口、排查运行问题,却不能充当标准答案。测试本身出现缺陷可以修复,但不能为了让初始程序过关而放宽断言。
考卷生成一次后冻结,所有候选同卷比较。
预实验中,12 个实际失败的样本,大模型直接判断只检出 5 个,生成测试检出 10 个,失败召回率从 41.7% 提高到 83.3%。
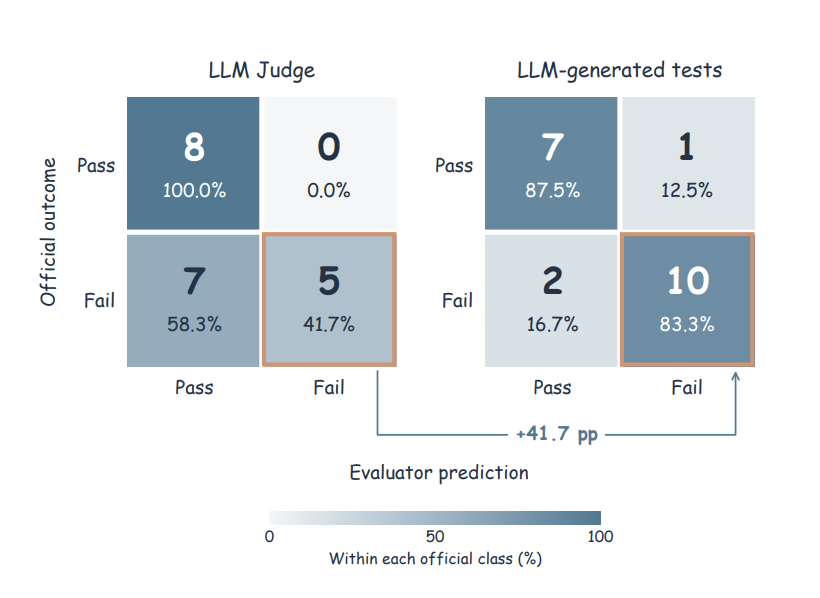
〓 与大模型直接判断相比,生成测试检出了更多实际失败样本
去掉测试生成模块后,两个基准、三个档位的通过率下降 3.4—10.0 个百分点。
进化期间,生成测试负责候选筛选;全部迭代结束后,最终成绩仍由保留测试集上的官方评测给出。
三档方案三种取舍
研究团队在 Terminal-Bench 2、SWE-Bench Pro 和 ProgramBench 三类任务上开展实验,分别使用 GPT-5.5 搭配 Codex、GLM-5.2 搭配 Claude Code。
对比方法包括 RHO、Dynamic Cheatsheet 等,还设置了加入成本优化要求、并运行相同进化轮数的 RHO+Iteration。
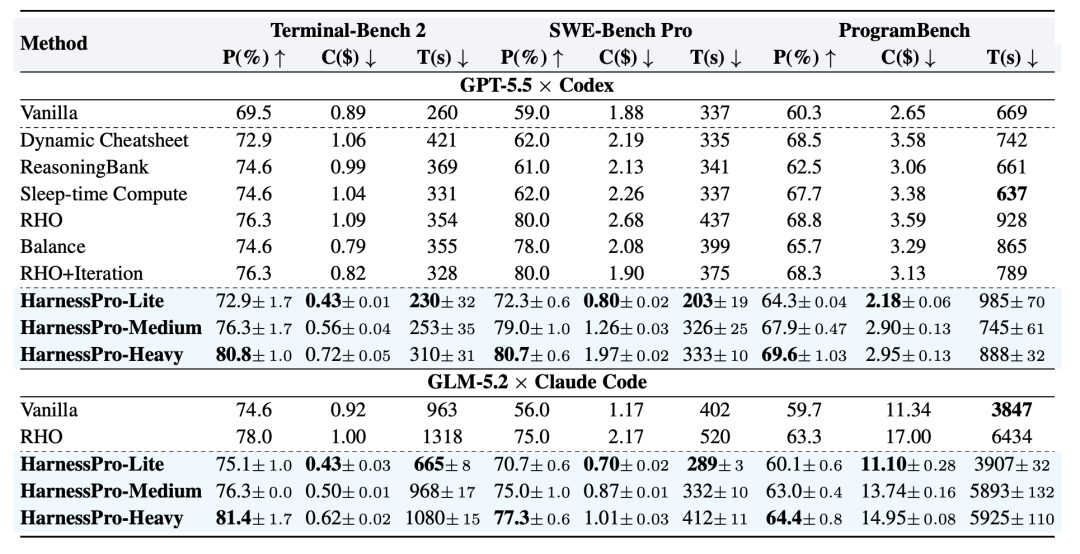
〓 三个基准上的任务通过率、单题成本与执行时间
在 GPT-5.5 搭配 Codex 的对比中,Heavy 在三个基准上均取得本组最高通过率,单题成本也都低于 RHO。
Terminal-Bench 2 上,通过率从76.3% 提高到 80.8%,成本从 1.09 美元降至 0.72 美元。
ProgramBench 上,通过率从 68.8% 提高到 69.6%,成本从 3.59 美元降至 2.95 美元。
Medium 更看重性能与成本的平衡。
SWE-Bench Pro 上,它的通过率为 79.0%,仅比 RHO 低 1 个百分点,单题成本却从 2.68 美元降至 1.26 美元,减少 53.0%。
Lite 进一步压低开销,在三个基准上的通过率均超过原版 Harness,单题成本降低 17.7%—57.4%。
面对进化轮数相同的 RHO+Iteration,Medium 在 Terminal-Bench 2 上以低 31.7% 的成本取得相同通过率。
换成 GLM-5.2 搭配 Claude Code,Heavy 同样在三个基准上以更低成本超过 RHO。
执行时间也有所缩短:在 SWE-Bench Pro 上,Heavy 的平均执行时间从 RHO 的 520 秒降至 412 秒。
提分和降本,有时要经过多轮调整。
SWE-Bench Pro 的 Medium 方案从第一轮到第二轮,通过率由 70.0% 升至 77.0%,成本也从 1.57 美元涨到 1.66 美元。
直到第三轮,通过率进一步升至 79.0%,成本才降至 1.26 美元。
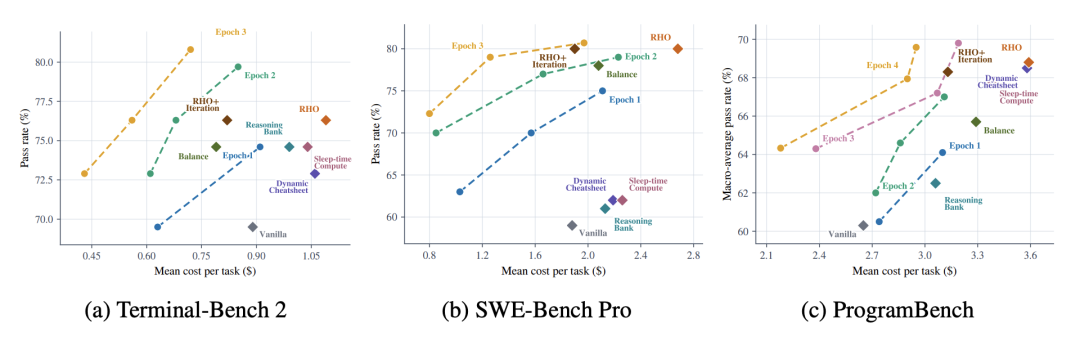
〓 GPT-5.5 搭配 Codex 时的性能—成本演化轨迹
进化出的省钱规则
论文公开的 harness 产物显示,降本并不只是缩短提示词或统一降低推理强度。
在 Terminal-Bench 2 和 SWE-Bench Pro 中,harness 会根据任务描述选择不同的执行配置,分别控制推理强度和工具调用预算。
以 Terminal-Bench 2 的 Medium 方案为例,选中 standard 配置后,工具调用累计到 14 次,运行时 Hook 提醒批量调用、减少重复检查。
达到 26 次,要求转向完成任务与最终验证;超过 44 次,直接阻止继续调用工具。
这些提醒被追加到工具结果中,保留原有提示词前缀,便于复用缓存。按论文采用的计价,GPT-5.5 缓存输入的单价为未缓存输入的十分之一。
同时,harness 还通过 RTK 压缩重复日志、缩短长输出,减少冗余上下文。
ProgramBench 的 Medium 方案则采用固定的 high 推理强度,将预算用于参考程序比对和最终离线重建。不同任务最终形成的省钱规则并不相同。
研究团队还试过直接给 RHO 加动态路由或预算 Hook。
两种做法确实能省钱,但在 SWE-Bench Pro 上,通过率分别降至 76.0% 和 75.0%;全程使用 low 推理强度,则进一步降至 59.0%。
单独叠加这些机制,还达不到完整 HarnessPro 的性能—成本表现。
如果把失败任务的开销也算进去,按每成功完成一道题分摊的成本(CoP),SWE-Bench Pro 上 Lite 仅为1.11 美元,RHO 则达到 3.35 美元。
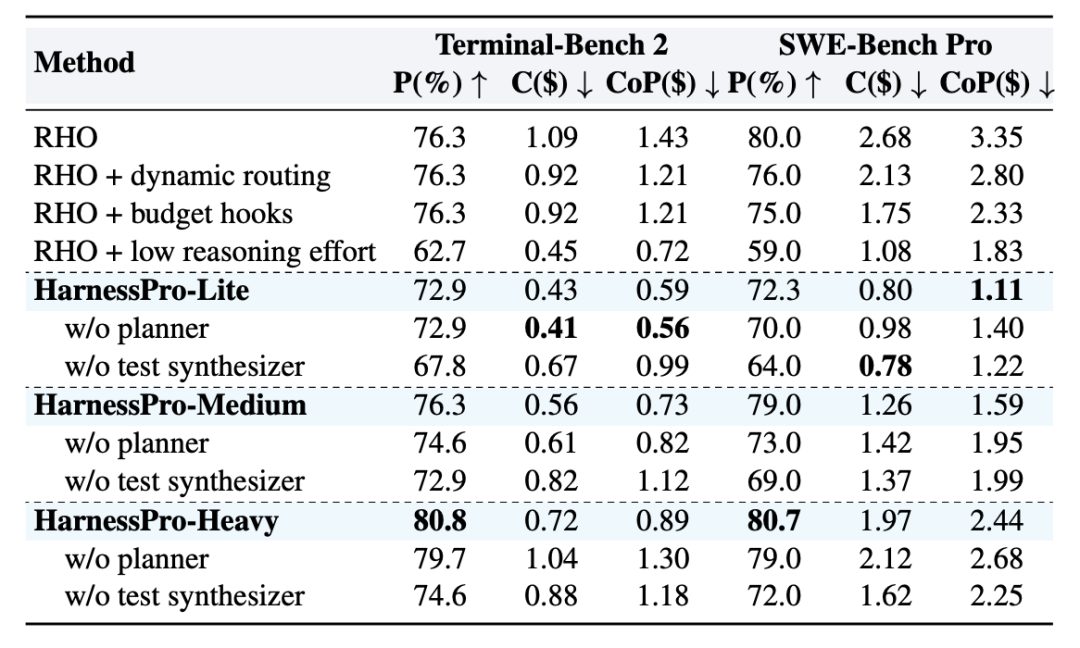
〓 移除关键模块或单独采用动态路由、预算 Hook 等策略后的性能与成本变化
结语
HarnessPro 把账单也摆上了计分板。
研究团队为规划器设定了不同的优化方向,具体的路由规则和预算阈值则在后续迭代中形成。
最终进化出的 Harness,在执行配置的选择规则里写下了一条很务实的原则:
每花一美元,尽可能多完成一些任务。
这条规则,由智能体在反复复盘和修改中写进了 Harness。
跑得起的 RSI,才能一直跑下去。
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。