Strata 连更:多显卡、自动压缩|低门槛本地大模型
原创 青小蛙 2026-10-23 17:42 四川
本地大模型推理工具 Strata 连续发布了 0.2.2 和 0.2.3 两个版本。
本地大模型推理工具 Strata 连续发布了 0.2.2 和 0.2.3 两个版本。这次不仅支持多显卡协同运行,还改善了推理性能,以及长对话容易耗尽上下文的问题。
Strata 是一款免费、开源的本地 AI 工具,可以利用显卡、内存和 CPU,在普通电脑上运行大型 AI 模型,例如拥有 128B 参数的 Qwen3.8-Flash-Next。
Strata 硬件门槛与支持模型
Strata 的一大特点,是能够结合显存与系统内存,在普通电脑上运行参数规模较大的本地模型。
就是把原本需要全部放到显存中的大模型,分开放到内存、SSD 中,所以显卡门槛降低了好多,但内存门槛...依旧挺高的。
硬件要求
硬件 | 要求 |
|---|---|
内存 + 显存 | 最低约 32GB,推荐 48GB~64GB |
NVIDIA 显卡 | RTX 20/30/40/50 系列,建议 12GB 以上显存 |
AMD 显卡 | RX 6800 及更新的受支持型号、Ryzen AI Max |
Intel 显卡 | Arc,Linux SYCL 引擎 |
Mac | Apple Silicon M1 及更新,macOS 15 以上 |
硬盘 | 建议预留 80GB 左右,部分模型需要更多空间 |
CPU | 推荐支持 AVX2 的 x86-64 处理器 |
官方也提醒,8GB 显存的显卡可以尝试,但速度可能明显下降。
支持模型与推荐配置
Strata 主要围绕 Qwen3.8-Flash-Next(128B) 提供不同量化版本,同时支持体积更小的 Qwen3.6-35B-A3B。
内存 + 显存档位 | 推荐模型 | 模型体积或特点 |
|---|---|---|
32GB | Gyro-S / Coder | 低内存配置 |
40GB | Swift 1.5 IQ2_XS / Gyro-M | 约 39.2GB / 35GB |
48GB | IQ3_XXS | 约 47GB |
64GB | IQ3_S | 约 54.8GB |
96GB 以上 | UD-IQ4_XS 至 Q8_0 | 更高精度,内存需求更大 |
此外,较小的 Qwen3.6-35B-A3B 支持以下量化版本:
• UD-Q4_K_XL:约 32GB
• UD-Q6_K_XL:约 44GB
• Q8_0:约 52GB
这些是模型体积或官方推荐档位,并非所有配置下都能获得流畅速度。实际还需要为操作系统、上下文缓存和推测解码组件预留资源。
对于普通用户,48GB~64GB 的内存与显存总量是比较值得考虑的配置。 如果只有 32GB,也可以从 Gyro-S 或 Coder 开始尝试。
0.2.2:支持多显卡
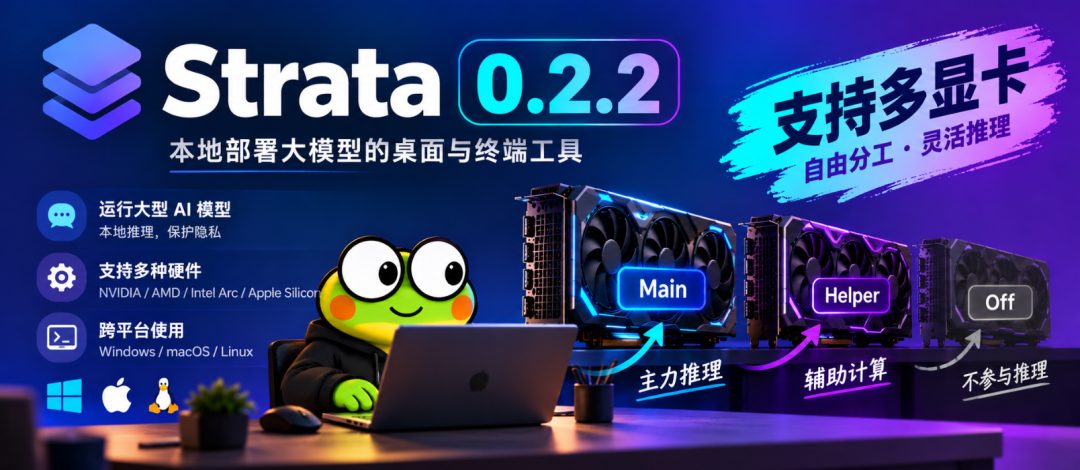
0.2.2 最值得关注的新功能是 多显卡支持。
对于拥有多张显卡的电脑,可以利用多 GPU 资源运行大型模型,进一步扩展本地推理的硬件选择。
此外,该版本还继续改进了 Gyro 系列模型的推理支持和相关兼容性。
0.2.3:长对话自动压缩,推理性能提升
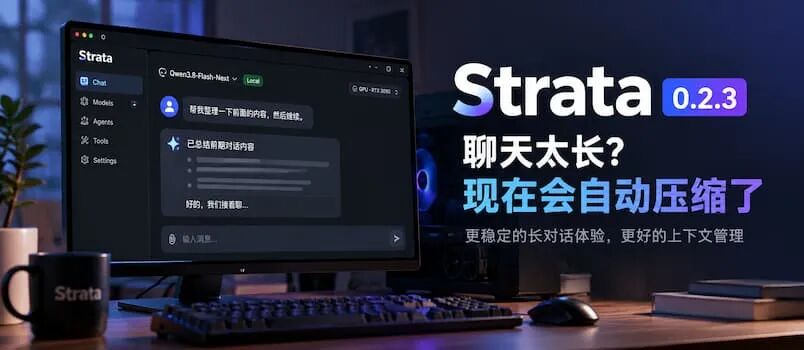 紧接着发布的 0.2.3,重点解决了几个实际使用中的问题:
• 长对话自动压缩:当聊天记录接近上下文限制时,可以总结较早的消息,再继续对话;也支持
/compact命令。• AMD 推理提速:Ryzen AI Max(Strix Halo)设备的回答速度提升 6%~19%。
• NVIDIA 性能优化:改进 CPU 线程和显存分配。RTX 5070 测试中,Gyro-S 模型从 31 提升至 45 tokens/s(对比 0.2.1)。
• 新增 DFlash2 推测解码:实验性加速功能,目前需要通过终端手动开启。
• Intel Arc 支持:正式提供 Linux SYCL 推理引擎安装包。
• 稳定性修复:解决 macOS 长提示词可能导致 Metal 引擎中止的问题,并改善终端启动、更新和模型缓存管理。
对于已经在使用 Strata 的用户,这两次更新值得关注,尤其是多显卡支持和长对话上下文管理。
升级方式:在桌面应用的 Settings → Update 中更新,或通过终端执行 strata update。较早版本可能需要重新运行安装程序。
本文转载自微信公众号「小众软件」,查看原文。版权归原作者所有,如有侵权请联系删除。