同样的 GQA 推理结构,为何会学出不同模型?北大 × 百度提出 VHA
52CV 2026-10-23 17:33 江苏
北京大学与百度团队提出的 Virtual Head Attention(VHA),训练后可以折叠成标准的 16Q/2KV GQA。在论文的 1.7B 匹配实验中,它与直接训练的 GQA 采用相同的推理结构,BF16 KV 缓存同为每层每 token 1 KB,八项零样本任务均分却从 53.09 提高到 54.50。推理时没有额外模块,差别出在训练过程。
长上下文推理时,历史 K/V 会随输入不断积累。减少 KV 头能直接省缓存,也让模型必须从更紧凑的历史表示中读出信息。VHA 关心的是:推理结构和缓存预算固定以后,训练过程还能不能把这个结构用得更好?论文已被 NeurIPS 2026 接收,代码现已开源。
01 缓存压缩之后,问题不只是少留几个头
GQA 把多个 Q 头接到同一组 K/V 上。KV 组越少,历史缓存越小;Q 不像 K/V 一样长期留在缓存中,却仍需要计算投影。因此,KV 头数、物理 Q 头数和最终参与注意力的查询路数可以分别调整,它们带来的成本和质量变化也不同。
论文在同一 1.7B 设置下做了两步压缩:从 16Q/8KV 改到 16Q/2KV,BF16 KV 缓存由 4 KB 降到 1 KB,八任务均分由 54.09 降到 53.09;KV 保持为 2 组,再把物理 Q 投影从 16 个减到 8 个,缓存不变,均分继续降到 52.38。两步分别省下长期存储和一部分训练计算,也分别带来质量损失。
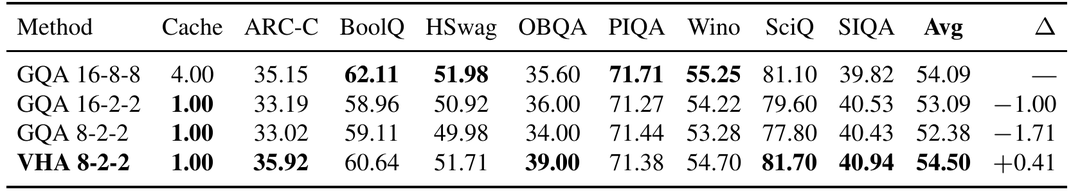
VHA 要解决的就是这个落差。它保留两组 K/V 的紧凑缓存,以及 8 个物理 Q 投影带来的训练计算优势;训练时仍让 16 路查询参与注意力,再重新组织读出的结果。
02 训练时改变路径,部署时回到标准 GQA
在 1.7B 模型里,Q Premix 为两组 K/V 分别学习线性变换,把 8 个物理 Q 扩展为 16 路虚拟查询。这样,来自同一个物理 Q 的查询也能以不同方式读取不同 KV 组。缓存仍只保存两组 K/V,训练时也只做 8 个物理 Q 投影;16 路注意力计算则保留下来。
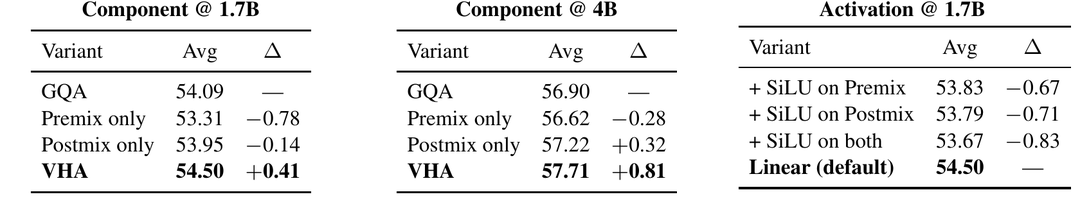
读出之后还有一层 Linear Postmix。它从恒等映射出发,用低秩残差让不同头的输出产生联系。关键是这两步都保持线性:RoPE 前的 Premix 可以并入 Q 投影,注意力后的 Postmix 可以并入原有的输出投影。训练结束后,模型回到标准的 16Q/2KV GQA。论文也试了加入 SiLU 的非线性版本:在这组评测中得分更低,而且无法保持同样的精确折叠。
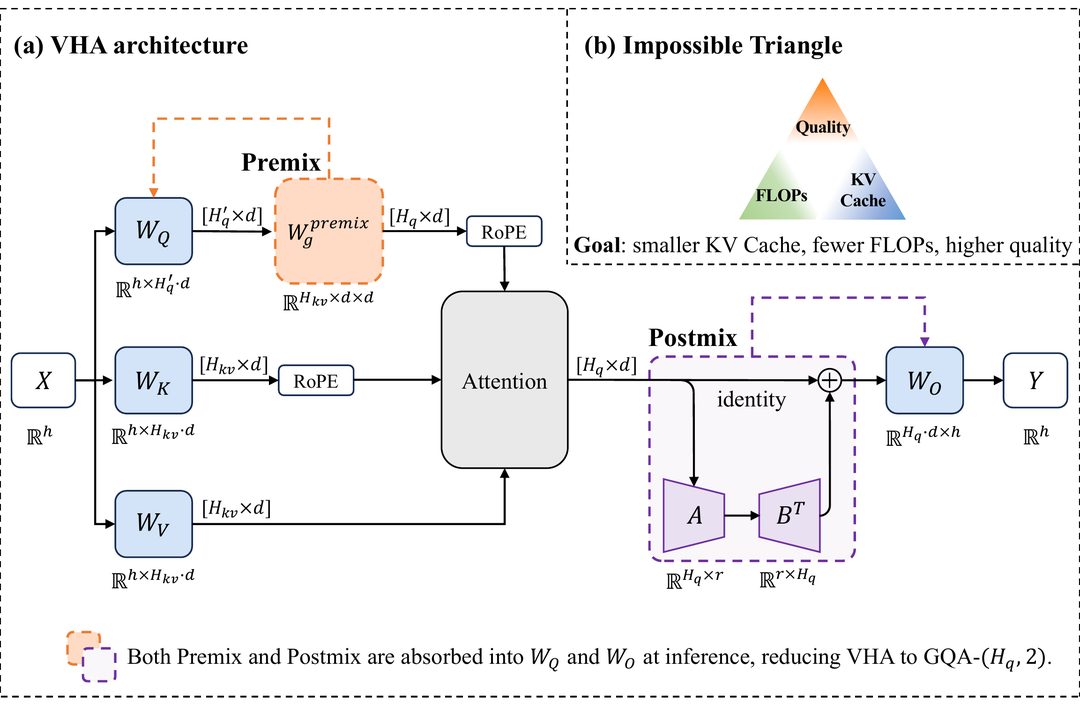
这种精确折叠也让实验更有说服力。VHA 与直接训练的 16Q/2KV GQA 最终使用相同的推理结构;如果分数不同,就不能用“推理时多了模块”来解释。问题因此变得很具体:同一套部署算子,换一条训练路径,会学出怎样的模型?
03 相同推理结构,不同训练结果
直接训练 16Q/2KV GQA 时,16 个 Q 投影彼此独立;VHA 折叠后的 Q 权重则来自共享的物理 Q,以及按 KV 组区分的变换,反而更受约束。标准 GQA 的参数空间本就能容纳 VHA 最终的 Q 权重,原有输出投影也能吸收 Postmix 的线性结果。VHA 在这些实验中取得更好结果,并不是因为部署模型多出一种线性表达能力;关键差异在训练时的参数组织。
一种可能的解释是:Premix 让同一组物理 Q 在不同 KV 组上经过不同变换;Postmix 从恒等映射出发,逐渐学会如何组合各头的输出。两者也许让模型更有效地读取紧凑的 KV 表示。消融与训练后的权重说明这些变换发挥了作用,但还不能据此判定具体的梯度或信息流机制。
04 匹配对照与模块消融
先看压缩带来的质量损失能否补回来:直接训练 8Q/2KV GQA 的八任务均分是 52.38,VHA 达到 54.50。再看更严格的同部署对照:直接训练的 16Q/2KV GQA 与折叠后的 VHA 有相同的推理计算图和 KV 缓存,均分却是 53.09 对 54.50。八项任务中,VHA 都高于这条同部署形态的基线。
两个模块各自做了什么?在 1.7B 上,只用 Premix、只用 Postmix、两者联用的均分分别是 53.31、53.95、54.50;4B 上,联用也高于任一单模块。论文还把 Postmix 的低秩分解宽度从 4 提高到 32 和 128。训练损失继续下降,任务均分却从 54.50 变为 54.24 和 54.15。Postmix 最终仍能并入原有输出投影,这个反差提示我们:训练约束如何影响学习,可能比增加线性参数本身更重要。
训练后的权重也留下了线索:1.7B 模型中,两组 Premix 变换彼此不同,而且都偏离单位阵;4B 模型的 Postmix 矩阵则出现非对角项,以组内联系为主,也有少量跨组联系。模块没有停留在初始化状态,学出的结构与消融结果相互呼应。
同部署对照确认了效果,消融说明两个模块都有贡献,权重分析则让我们看到它们学出了哪些组别差异和头间联系。这些观察为理解机制提供了线索;权重图本身还不能还原完整的注意力流。
05 把缓存、计算和质量放在一起看
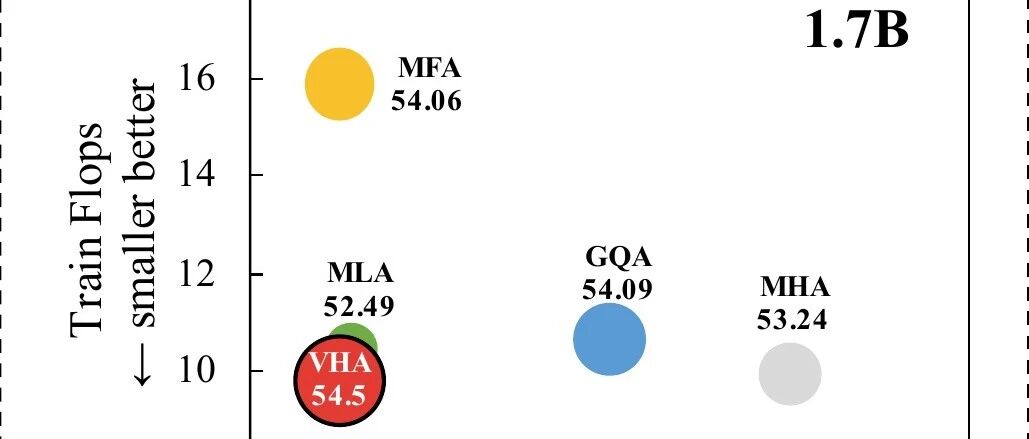
MLA 用潜在表示压缩 K/V,MFA 则在少数 KV 头上增大头维度。VHA 的额外变换留在训练阶段,部署时仍使用标准 GQA。在论文相同的 1.7B、50B-token、4K 设置下,VHA 的 BF16 KV 缓存为每层每 token 1 KB,八任务均分 54.50,未折叠训练结构的 FLOPs/token 为 9.78G;同为 1 KB 缓存的 MFA 是 54.06、15.90G;原 GQA-8 为 54.09、10.61G,但需要 4 KB 缓存。把这三项一起看,VHA 在这组比较中兼顾了质量、缓存和训练结构计算量。
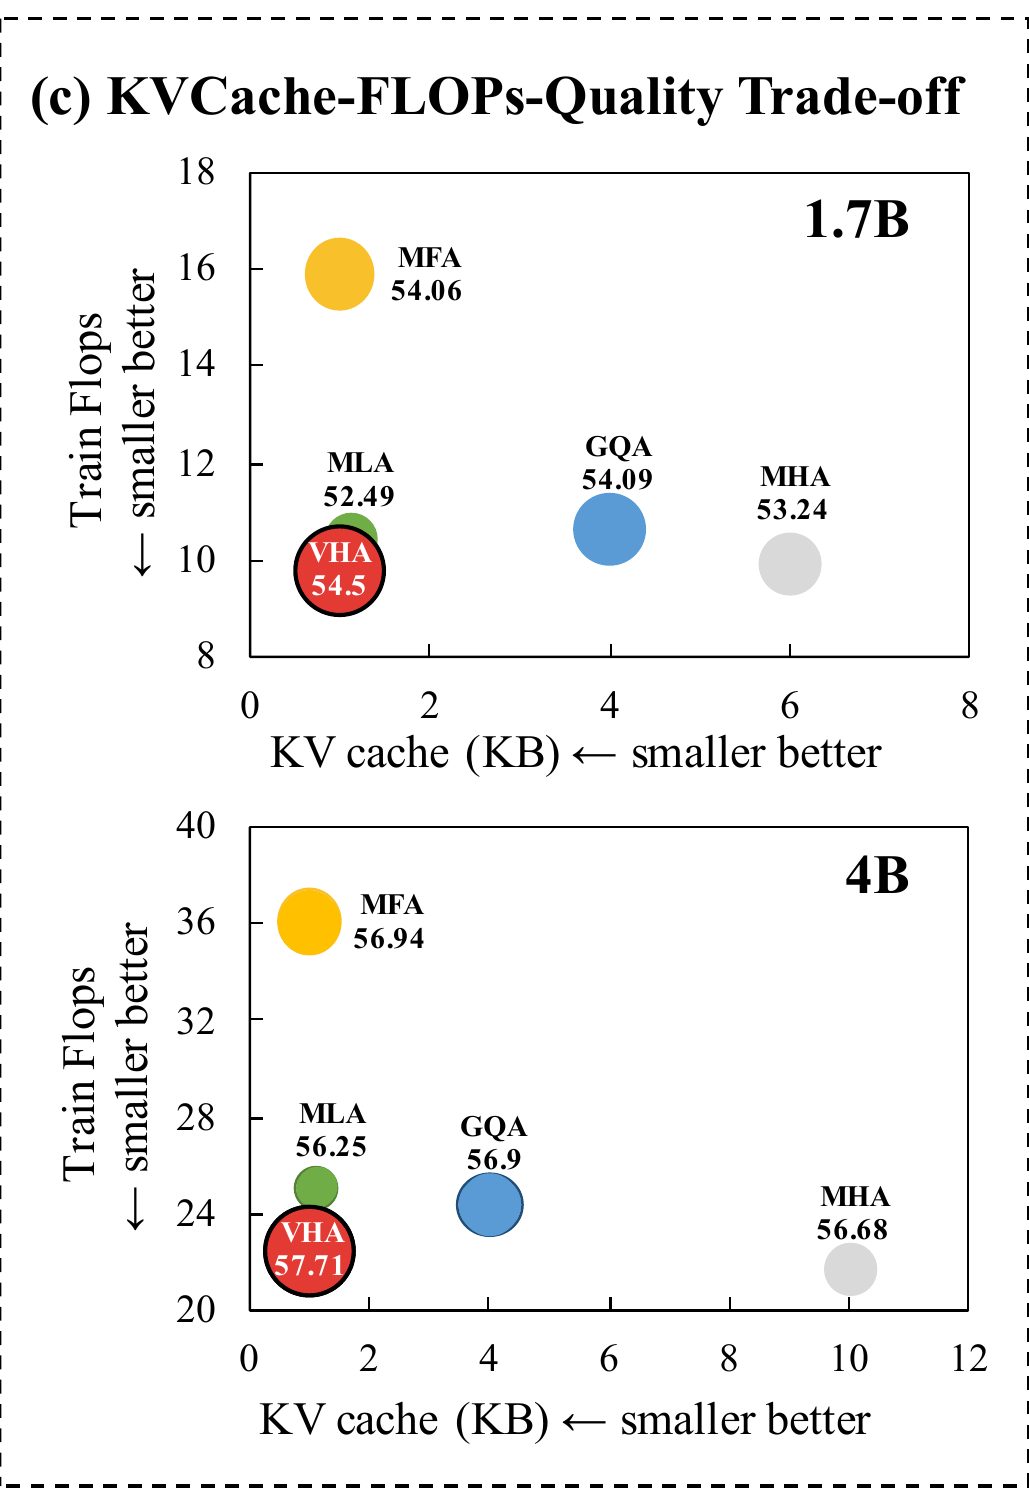
论文还做了四组各自匹配的 50B-token 预训练:0.6B、1.7B、4B 稠密模型,以及 8B-A1B MoE。四个规模上,VHA 的八任务均分都高于相应 GQA;稠密模型的 BF16 KV 缓存降到基线的四分之一,MoE 降到二分之一。按 4K、未折叠的训练结构估算,FLOPs/token 下降 6.5%–8.1%。不同规模的增益幅度不一样,但效果方向一致。
这里的 FLOPs 是未折叠训练结构的计算量,不等于实测推理速度;部署后的 VHA 仍使用标准 GQA 接口。
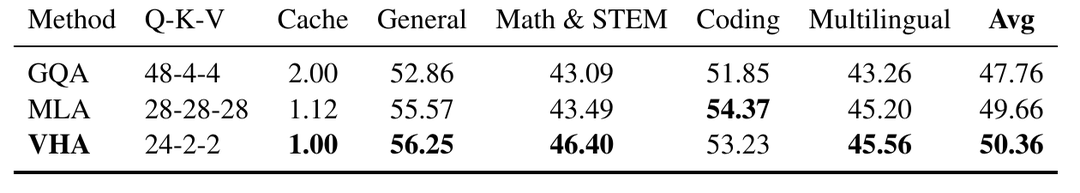
另一组实验把模型推到 30B-A3B MoE,并用 500B token、8K 上下文独立预训练。在 12 项基础模型评测的四类任务宏平均上,VHA、MLA 和 GQA-4 分别得到 50.36、49.66 和 47.76。VHA 领先其中三类,代码类则由 MLA 领先。这组独立实验检验了 VHA 在更大规模和不同训练设置下的表现。
06 长上下文:128K 的检验
KV 缓存会随上下文长度积累。头数减半之后,模型能否从更少的 K/V 中找回远处信息,是另一个关键检验。论文用匹配的 10B-A1B MoE 做长上下文实验:两组模型共用骨干、数据、优化设置和滑动窗口层,只在全注意力层分别采用 4 个 KV 头的 GQA 与 2 个 KV 头的 VHA。它们经历相同的 8K、32K、128K 训练阶段,再比较最终检查点。
在 RULER 的 8K、16K、32K、64K、128K 五档长度上,VHA 的最终检查点都高于 GQA,平均 84.4 对 73.0。128K 变量追踪子项尤其醒目:83.0 对 3.0。LongBench-v2、BABILong 和四类 ProLong 文本也支持这一方向;InfiniteBench 接近持平,HELMET 则随类别变化。这里缓存减半的范围仅是全注意力层。
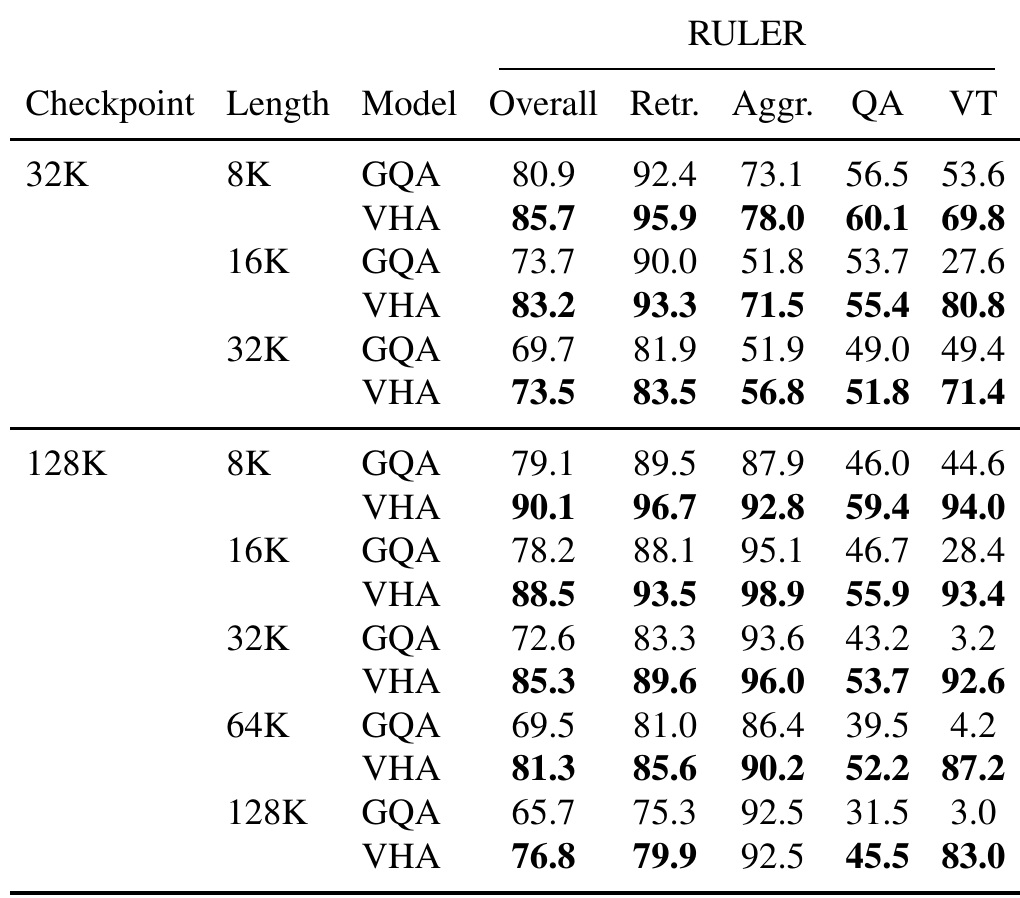
长上下文实验显示,少一半的全注意力层 KV 头,模型仍能在多个长距离任务上取得更好结果。这与“按 KV 组组织查询可能帮助读取历史”的解释相符,不过实验没有单独区分 Premix 与 Postmix 在长上下文里的贡献。模型究竟怎样利用这两组历史表示,还值得继续研究。
VHA 把查询如何复用、不同 KV 组如何分化、各头读出的结果如何组合,放到训练阶段去学习;部署时,这些变换又折叠回标准 GQA。匹配对照、模块消融以及跨规模和长上下文结果表明,这条训练路径在论文测试的设置里确实奏效。对于低缓存注意力,怎样训练模型使用有限的历史信息,和部署时留下多少头一样值得研究。
论文与代码
论文:Virtual Head Attention(NeurIPS 2026)
作者:Xibo Ding、Guoxia Wang、Jinle Zeng、Jiabin Yang、Sirui Tao、Chao Yang、Dianhai Yu
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。