英伟达显卡 AI 算力被人为限制了?有人成功解锁,性能接近翻倍
原创 青小蛙 2026-10-24 17:42 四川
最近,有开发者发现,部分英伟达 RTX 30 系列显卡的 Tensor Core 在执行特定矩阵运算时,存在人为设置的速度限制。开发者找到了通过软件绕过这一限制的方法。@Appinn
通过解锁,可以让部分 AI 矩阵计算性能提升 60%~近 100%。
目前已经出现两个开源项目:
• Linux:GPU Unlock
• Windows:Windows GPU Unlock
都是最近几天(2026年10月)刚出现的新项目。
英伟达限制了什么?
受影响的主要是采用 Ampere 架构、GA102 和 GA104 核心的显卡,包括 RTX 3090、3080、3070 等。
这些显卡本身具备相应的计算能力,但部分 Tensor Core 运算路径受到硬件配置限制。开发者找到了修改相关配置的方法,让显卡释放出原本未能充分发挥的计算吞吐率。
这不是超频,也不是凭空增加计算单元,而是解除部分计算路径的吞吐限制。
解锁后到底快多少?
目前已有多款显卡的用户提交实测:
显卡 | 解锁效果 |
|---|---|
RTX 3090 Ti | BF16 +80%,TF32 +94% |
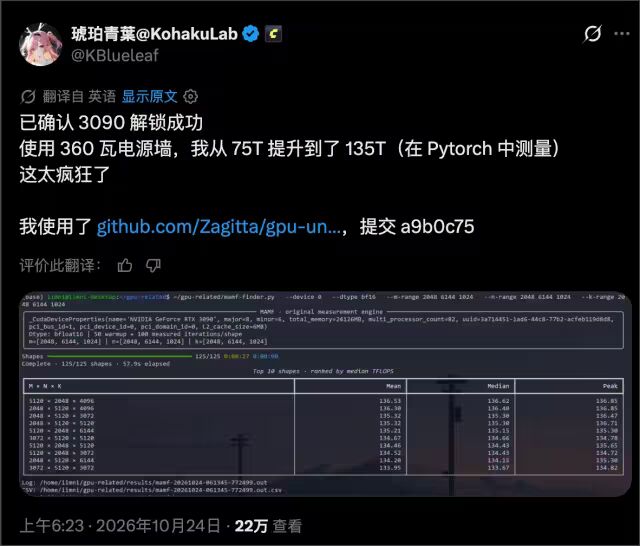
RTX 3090 | 75 → 135 TFLOPS,提升 80% |
RTX 3080 Ti | BF16 +67%,TF32 +73% |
RTX 3080 10GB | FP16/BF16 提升约 69%~74% |
RTX 3080 20GB 改装版 | 特定矩阵计算约翻倍 |
RTX 3070 | 已有成功解锁报告 |
其中,一位 RTX 3090 用户在 360W 功率上限下,使用 PyTorch 测得计算吞吐率从 75 TFLOPS 提升至 135 TFLOPS:
英伟达限制的并不是显卡本身的计算能力,而是某种计算方式的运行速度。
简单来说,显卡明明有能力算得更快,但在执行某些 AI 矩阵计算时,却被限制了速度。
这次解锁就是绕过了这道限制,这不是超频,不会提升游戏帧率,但如果模型和推理引擎使用了这种计算方式,确实可以提升性能。
KBlueleaf 认为,由于显卡原本就能通过其他计算方式达到类似的速度,解锁造成硬件损坏的风险应该很低。
运行本地大模型,也能快一倍吗?
昨天,有人用 RTX 3090 测试了本地大模型推理引擎 Strata:
• 16K 提示词处理速度:提升 16%
• 首个 token 等待时间:缩短约 14%
• 生成速度:基本没有变化
但另有用户测试 llama.cpp 量化模型,发现解锁前后几乎没有区别。
而青小蛙在群里听说:3090 解锁以后略牛逼,Prefill 速度接近翻倍了。
不同模型、不同程序间的差距很大。
Windows 也能解锁了吗?
可以,但目前还比较麻烦。
Linux 版本已经有多款显卡、不同主板甚至 Proxmox 虚拟机的成功案例。
Windows 版本则通过 UEFI 启动程序,在 NVIDIA 驱动加载之前完成解锁。目前只在有限的硬件配置上得到验证,并不是下载后双击就能使用。
两个项目都很新,涉及显卡底层操作,存在兼容性和稳定性风险,暂时不建议在主力电脑上直接尝试。
至于英伟达为什么设置这些限制,目前还没有官方解释。
不过,本地运行大模型这件事,最近两个月变化真快,从只是能跑起来,到可以跑的很快,没多少天。可以继续期待未来啊。
比如今天第二篇将推:Strata 0.2.4 更新:12GB 显卡运行 DeepSeek V4.1-Flash
本文转载自微信公众号「小众软件」,查看原文。版权归原作者所有,如有侵权请联系删除。