边想边看,能够捕获时空线索的视频智能体:Open-o3-Video-v2
原创 52CV 2026-10-24 22:48 江苏
一个基于视觉信息推理的智能体
作者:Open-o3-Video 团队(北大、复旦、南洋理工)
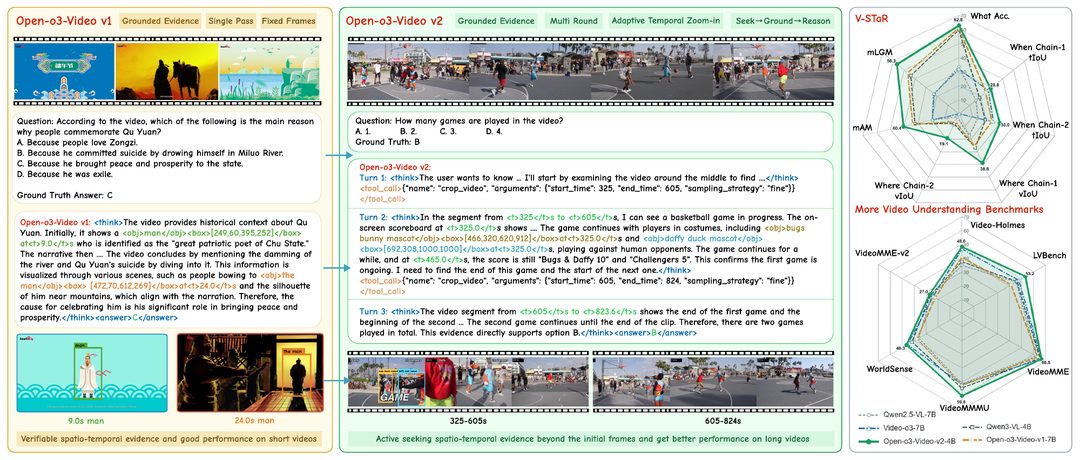
视频里真正决定答案的线索,可能只出现短短几秒,或者散落在视频的不同时刻。如果模型只看预先稀疏抽取的画面,关键动作、人物或物体很容易被漏掉。为缓解这一问题,来自北大、复旦等机构的研究团队在 Open-o3-Video [ICML 2026] 的基础上提出 Open-o3-Video-v2,它将视频推理从“基于固定画面给出有依据的回答”,推进为“发现信息缺口 → 主动检索片段 → 定位时空证据 → 融入推理”的智能体式推理过程。模型会针对问题补看相关片段,在补看的画面中标出关键时刻和物体,并将这些可核验的视觉线索纳入推理过程,使推理依据更加清晰。
研究背景:基于时空线索的视频推理
第一代 Open-o3-Video 已让模型在推理中明确指出“何时”和“何处”:时间戳与目标框使答案更容易核验。但它的观察来自最初的稀疏抽帧。一旦决定答案的线索恰好落在未采到的片段中,模型无法继续获取证据。
简单地增加抽帧密度也并非万能:长视频会带来更多计算开销和无关画面。更自然的做法,是让模型先根据问题和已有观察判断还缺什么,再有针对性地补看。
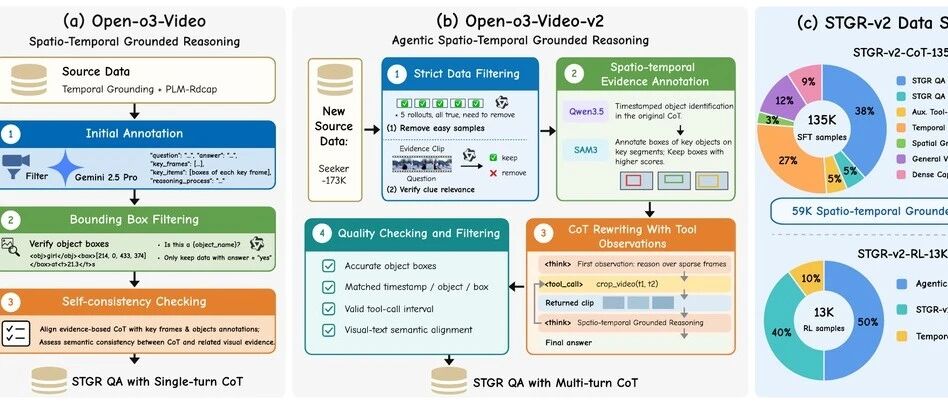
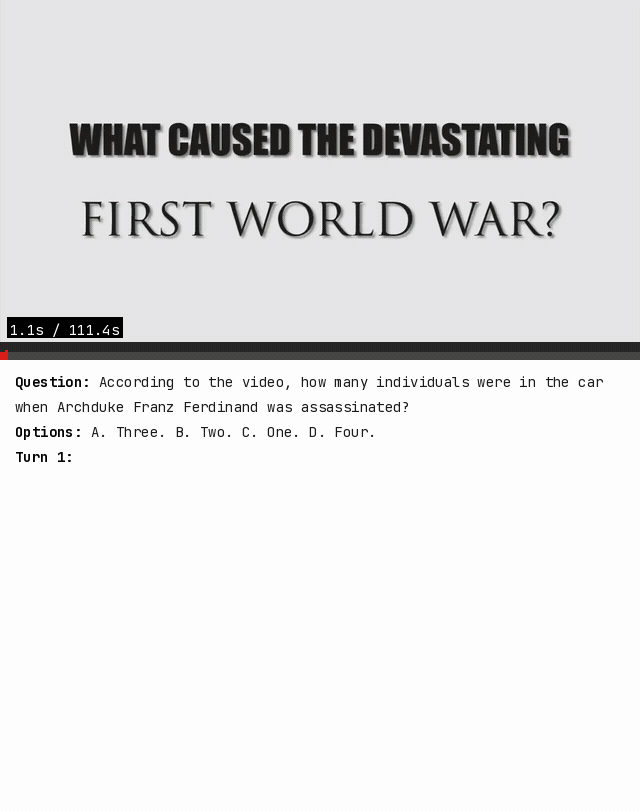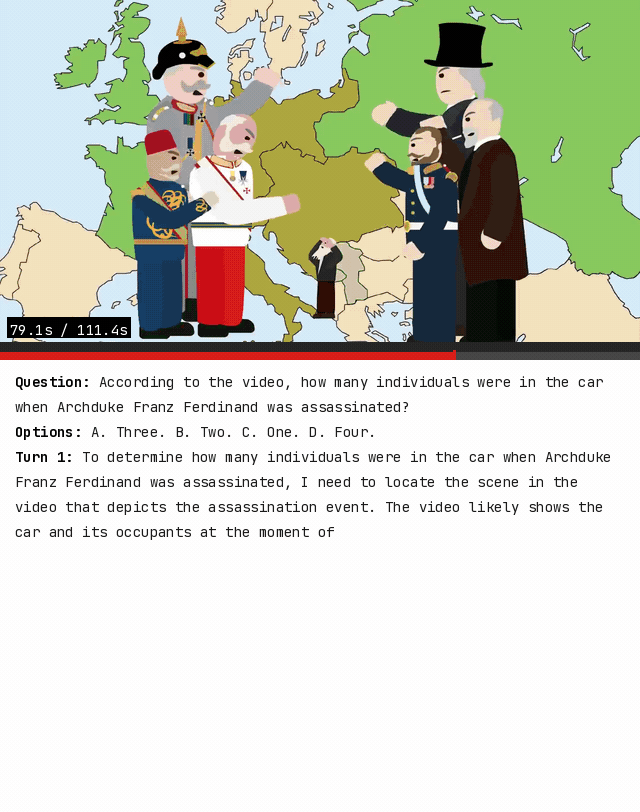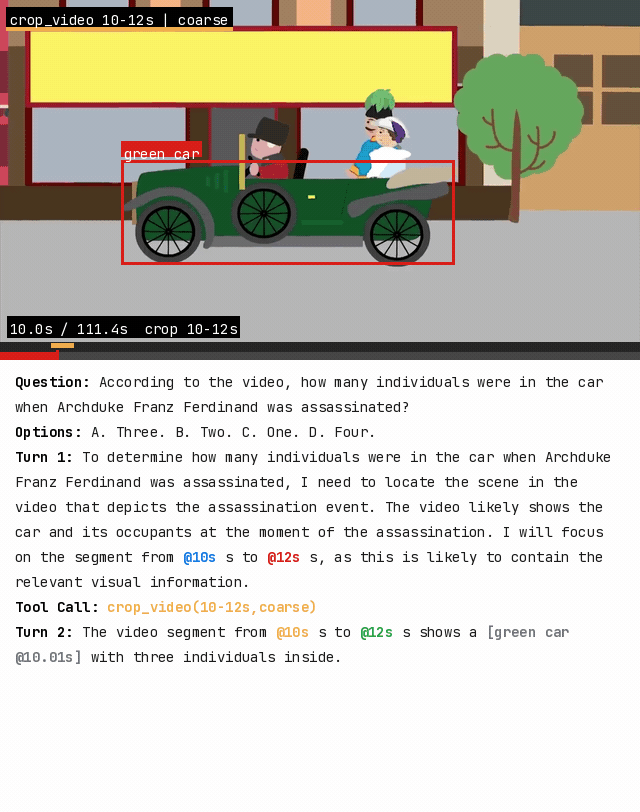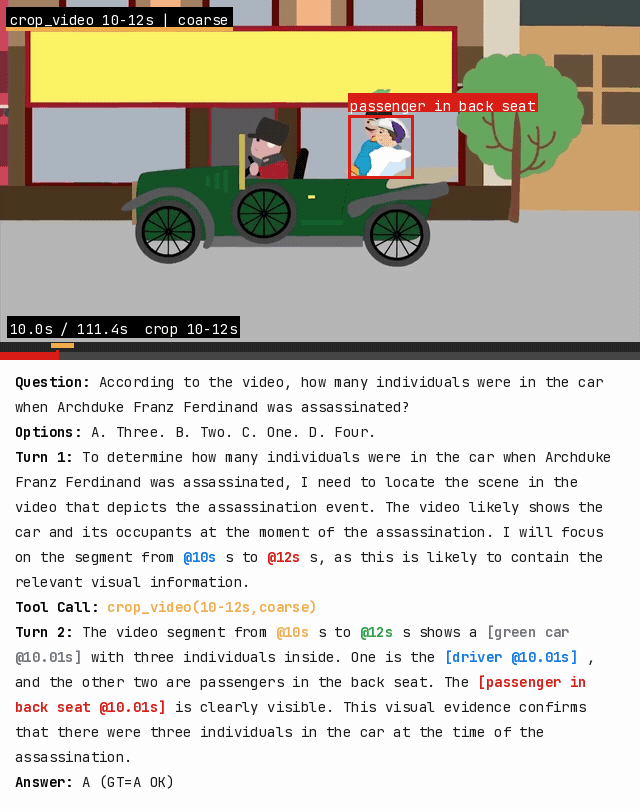
v2 的关键升级,是把“寻找线索”和“利用线索”合成一个连续过程。模型调用 crop_video 查看相关时间段后,进一步在返回的画面中定位与问题相关的时刻和物体位置;新证据成为下一步判断的明确前提,模型可以据此修正理解、继续检索,或给出答案。
与 v1 相比,重点变化在哪里?
视觉信息的利用:v1 依据初始稀疏采样的画面完成单次推理,并在画面中标注时间与目标框,视觉信息局限于初始输入;v2 能主动裁剪片段,对视觉内容密集采样,获取更有针对性的观察,并结合时空定位完成多轮推理。
训练数据与目标:v1 优化单次回答中的准确性、格式和证据定位;v2 进一步评价每次检索是否真正增加有效线索,鼓励及时停下无效或重复的搜索。此外,v2 在改进 v1 数据质量的基础上,构建了 52K 条多轮推理轨迹。
数据构建:STGR-v2
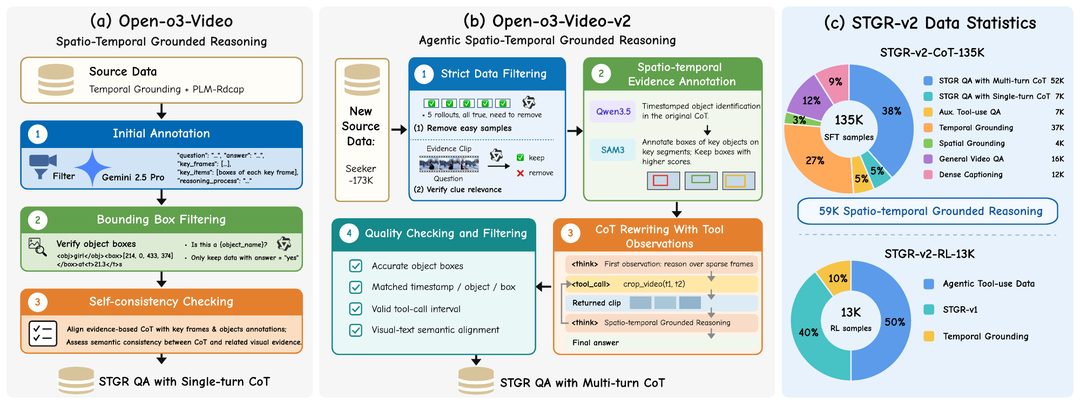
团队构建了 STGR-v2-CoT-135K 监督微调语料,其中包含 52K 条带有可定位时空证据的多轮视频问答轨迹;另构建 STGR-v2-RL-13K,用于后续强化学习。这 52K 条核心轨迹经过四步构造:
筛选真正需要补看的问题:剔除仅凭稀疏画面就能稳定回答的问题,也剔除即使给出标注线索片段仍无法回答的问题。
标注时空证据:确定与问题相关的时间片段和物体,在关键画面上借助 SAM3 生成目标框,并过滤不可靠标注。
改写多轮推理:把初始观察、定向裁剪、返回画面、显式的时空证据和最终答案串成连贯的交互轨迹。
检查证据一致性:核对目标框、时间戳与物体的对应关系,以及工具调用和推理陈述是否真正由画面支持。
135K 语料还结合了单轮时空定位、通用视频问答、稠密描述与辅助工具使用数据;13K 强化学习样本则保留能产生有区分度的正确与错误轨迹的问题。
训练策略:SFT + CS-GRPO
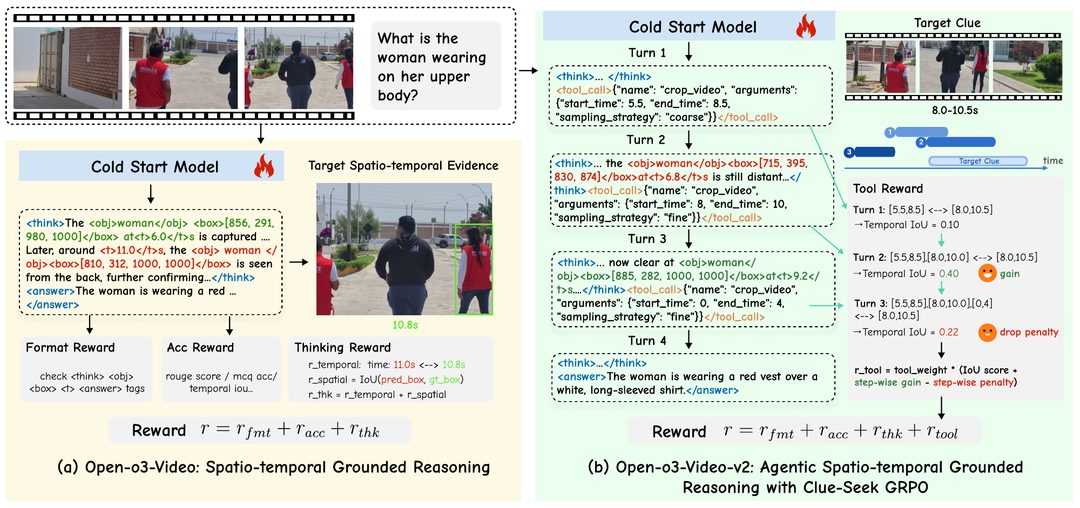
训练分为两个阶段。第一阶段是监督微调:用 STGR-v2-CoT-135K 引导模型生成推理过程,并在需要时调用 crop_video、查看返回画面、标注时空证据,最终给出答案。第二阶段是强化学习:从监督微调模型出发,在 STGR-v2-RL-13K 上优化完整的多轮交互轨迹。
常规强化学习主要根据最终答案给予奖励,难以判断多轮检索中哪些调用真正带来了有效线索。为此,我们提出 Clue-Seek GRPO(CS-GRPO):以每轮检索后累计片段与目标线索的时序交并比衡量证据状态,并联合奖励线索覆盖与逐步增益、惩罚低效检索。其中,累计证据状态表示为:
其中, 为第 次检索片段, 为标注的关键线索片段。
进一步,工具奖励为:
其中,奖励累计证据的质量提升超过 0.1 的后续检索;四项惩罚分别约束超过 3 次调用、高度重复(tIoU > 0.7)、碎片化连续检索、证据质量下降明显。
总奖励将工具使用与答案正确性、输出格式和时空证据定位联合优化:
因此,模型学习的不只是“会调用工具”,还包括何时值得再看、看哪里、哪些画面足以支持结论,以及何时停止。
实验结果:证据定位和回答准确度均提升
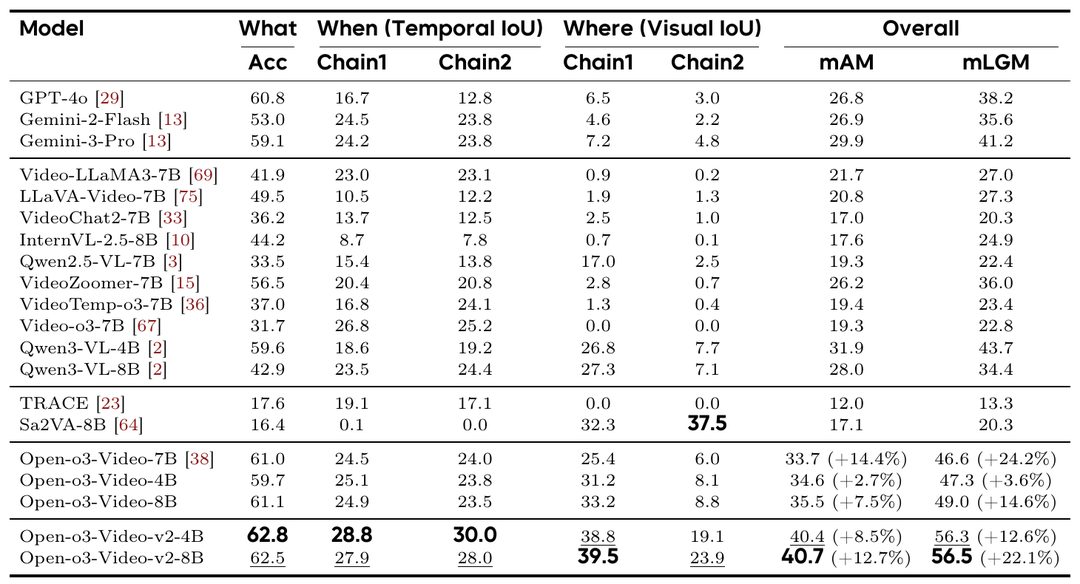
在相同 4B 规模下,Open-o3-Video-v2 的综合指标 mAM 从 34.6% 提升至 40.4%,mLGM 从 47.3% 提升至 56.3%。相较 Qwen3-VL-4B 基座,v2 的 mAM 和 mLGM 分别高出 8.5% 和 12.6%。
从 V-STaR 各个指标看,测试不仅要求答对问题(What),还要定位证据出现的时刻(When)和画面中的目标(Where)。与同为 4B、采用相同 Qwen3-VL 基座的 v1 相比,v2 的答案准确率由 59.7% 升至 62.8%;两种推理顺序下,时间定位的 IoU 由 25.1%/23.8% 升至 28.8%/30.0%,目标定位的视觉 IoU 由 31.2%/8.1% 升至 38.8%/19.1%。也就是说,提升既来自回答更准确,也来自证据定位更准。8B 版本进一步达到 40.7% mAM、56.5% mLGM。
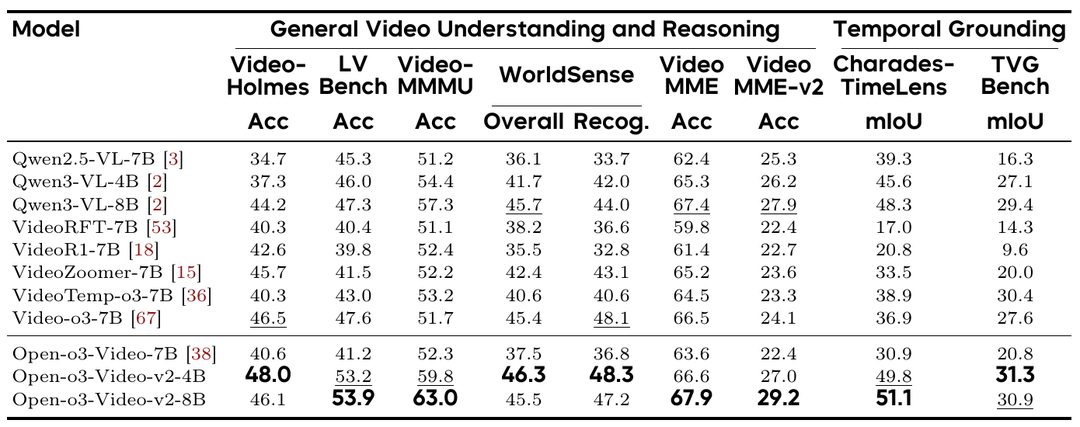
在通用视频理解和时间定位基准上,相较 Qwen3-VL-4B 基座,v2-4B 在需要串联多条线索的 Video-Holmes 上提高 10.7%,在长视频基准 LVBench 上提高 7.2%;TimeLens(Charades) 的时间定位 mIoU 从 45.6% 提高到 49.8%。8B 版本在 VideoMMMU 上达到 63.0%,相比Qwen3-VL-8B提升5.7%。这些结果表明“主动寻证+显式定位”有助于提升视频理解与推理能力。
此外,论文在消融实验中进一步证明了多轮寻证与显式时空证据各自的贡献:在相同基座、训练数据和评测设置下,从单轮无显式证据改为多轮寻证,Video-Holmes、LVBench 和 V-STaR mLGM 分别由 45.0%、48.8%、47.8% 升至 47.1%、51.9%、52.3%;再加入显式时空证据后,分别达到 48.0%、53.2%、56.3%。分阶段实验还显示:虽然 SFT 使得模型在 V-STaR 上的mLGM指标 从 43.7% 提升至 53.4%,但 VideoMME 准确率却有小幅下降(从 65.3%下降至63.7%);后续 CS-GRPO 缓解这一问题,将两项指标推至 56.3% 和 66.6%。
Demo展示:
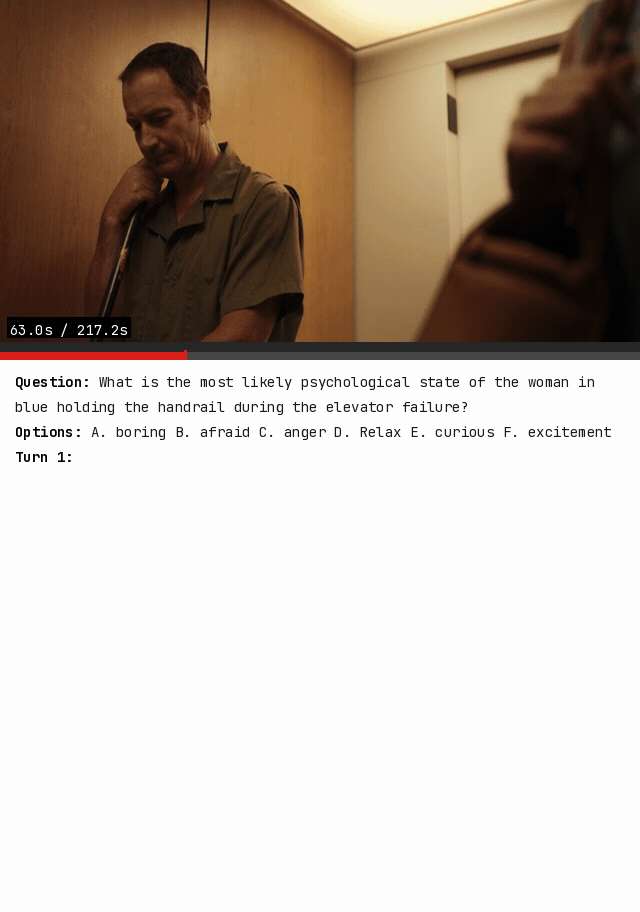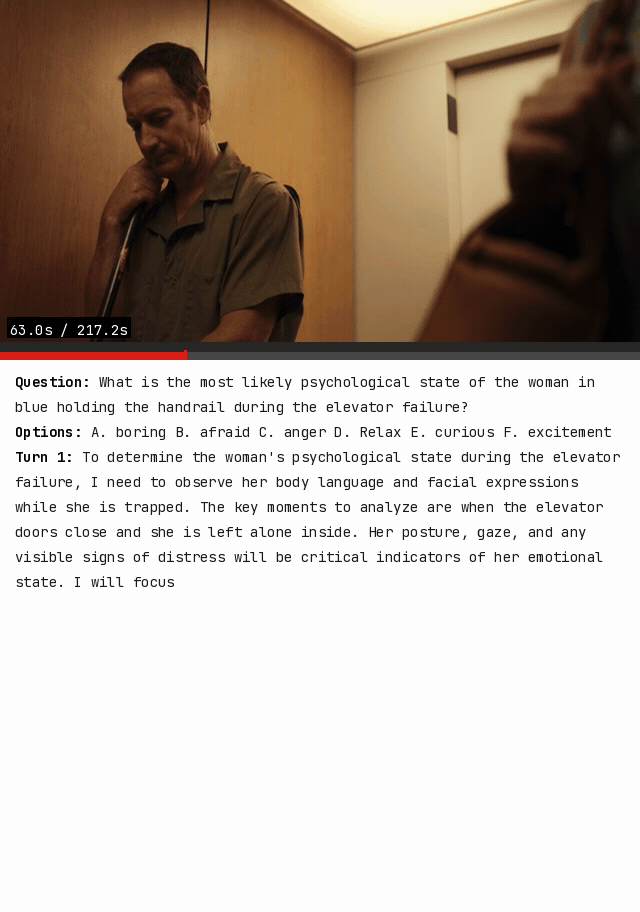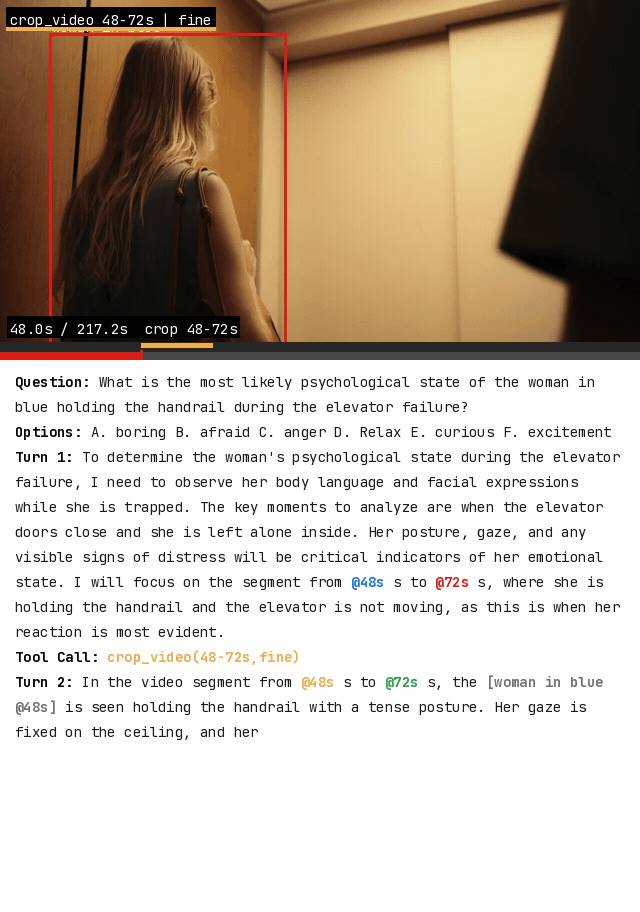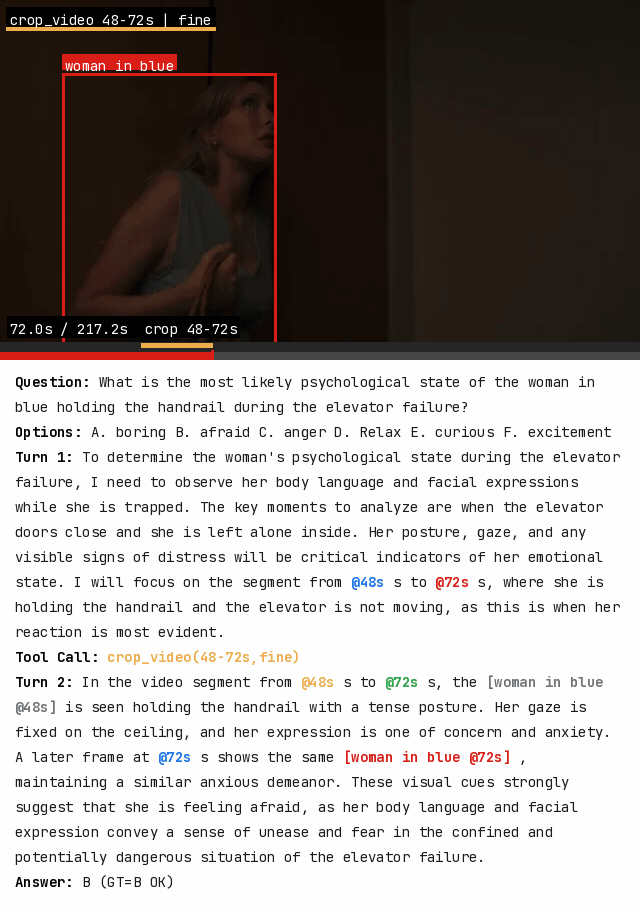
初始稀疏抽帧可能错过关键事件或局部视觉线索。Open-o3-Video-v2 根据问题主动检索相关片段,对局部画面进行更细致的观察,并定位相关主体与时空证据,提升对物体、事件及人物状态的理解。
更多可视化Demo和项目介绍,可参考https://msalab-pku.github.io/projects/Open-o3-Video-v2。
Open-o3-Video-v2 的核心,是建立一个基于视觉信息推理的智能体:发现信息缺口时主动补看相关画面,随后定位其中的时空证据,再把这些线索作为推理判断的依据。目前,其论文、代码、模型和数据已经开放:
🔗 项目主页:https://msalab-pku.github.io/projects/Open-o3-Video-v2/
📄 论文:https://huggingface.co/papers/2610.17656
💻 代码:https://github.com/Multimedia-Semantic-Analytics-Lab/Open-o3-Video-v2
🧠 模型:https://huggingface.co/marinero4972/Open-o3-Video-v2-4B
📦 数据:https://huggingface.co/datasets/marinero4972/Open-o3-Video-v2
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。