NeurIPS 2026|字幕缺词、音画掉线,SemMSA如何稳住情感判断?
原创 52CV 2026-10-26 22:54 江苏
一句“我并不喜欢这部电影”,如果字幕恰好漏掉了“不”,意思就会反过来。
人还可以听语气、看表情。但如果声音也断了一截,画面又缺了几帧,AI还能判断这究竟是在夸奖,还是在抱怨吗?
这正是不完整数据下的多模态情感分析要解决的问题:当文字、声音和画面都只剩一部分,怎样从残存线索中提取可靠的情感信息?
来自山东大学软件学院与深圳河套学院的研究团队提出了 SemMSA。它借助冻结大语言模型,在隐空间中提炼与情感相关的潜在语义,再将这些语义与文本、视觉、音频共同对齐,为信息缺失时的情感判断提供辅助。
该工作已被 NeurIPS 2026 接收。在英文 MOSI、MOSEI 和中文 SIMS 三项基准上,SemMSA 均取得了有竞争力的结果。其中,MOSI 七分类准确率较表中最佳基线提高 2.23 个百分点;在 MOSEI 的整模态缺失实验中,七种可用模态组合的平均 F1 较 CorrKD 提高 2.71 个百分点。
论文信息
题目:SemMSA: Latent Semantic-Aided Robust Multimodal Sentiment Analysis with Incomplete Data
作者:Wenhao Li、Zhibin Wu、Chong Xiao、Qiangchang Wang(通讯作者)
单位:山东大学软件学院、深圳河套学院
📄 论文:arxiv.org/abs/2609.30238
🌐 项目网站:peacelwh.github.io/SemMSA
💻 GitHub:github.com/peacelwh/SemMSA
🤗 Hugging Face:huggingface.co/datasets/Bluexxx/SemMSA
信息缺失时,难点在于保住情感含义
多模态情感分析通常结合三类线索:说了什么、怎么说,以及说话时的面部表现。理想情况下,它们可以相互补充;现实中,采集故障、传输丢包等问题却可能让三类信息同时残缺。
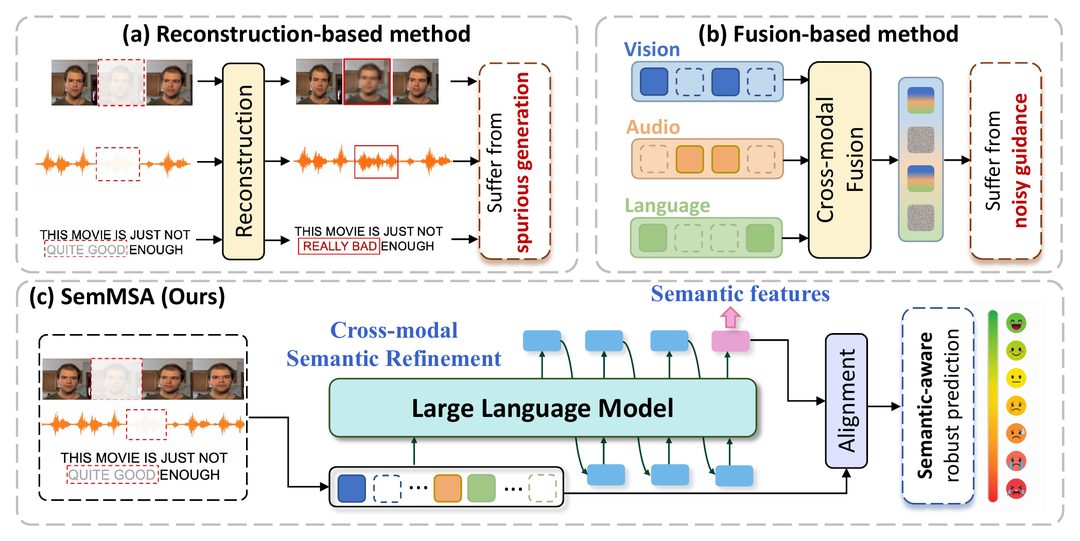
已有方法通常从两个方向入手:重建缺失特征,或设计更复杂的交互机制来融合剩余观测。这些方法面临一个共同难点:看起来合理的特征,不一定对应正确的情感含义。
同一句话可以带着赞许、讽刺或不满的语气。仅凭剩余信息补出来的特征,可能与真实情感并不一致。直接融合也有局限:如果关键线索已经丢失,再复杂的交互仍受制于输入质量。
对齐过程中还存在另一处隐患。如果始终让文本引导声音和画面,一旦关键文字缺失,其他模态就可能跟着不可靠的参照一起偏离。
SemMSA 因此引入两个相互配合的模块:跨模态语义细化(CSR)从已有观测中提炼情感语义,跨模态谱对齐(CSA)让语义与三种模态共同形成一致、可区分的表示。
让大模型在隐空间里提炼语义
SemMSA 的第一步,是把残存的文字、声音和画面,组织成大语言模型能够处理的输入。
视觉和音频分别经过轻量适配器,转换为大模型嵌入空间中的连续向量,再与文本嵌入拼接。适配器利用可学习提示向量,通过交叉注意力聚合视觉或音频中的可用证据,再通过自注意力交换信息;位置嵌入补充时序信息。
默认配置使用 Qwen3-1.7B,其参数保持冻结。训练时,适配器等任务模块通过情感预测目标,学习如何组织这些多模态线索。
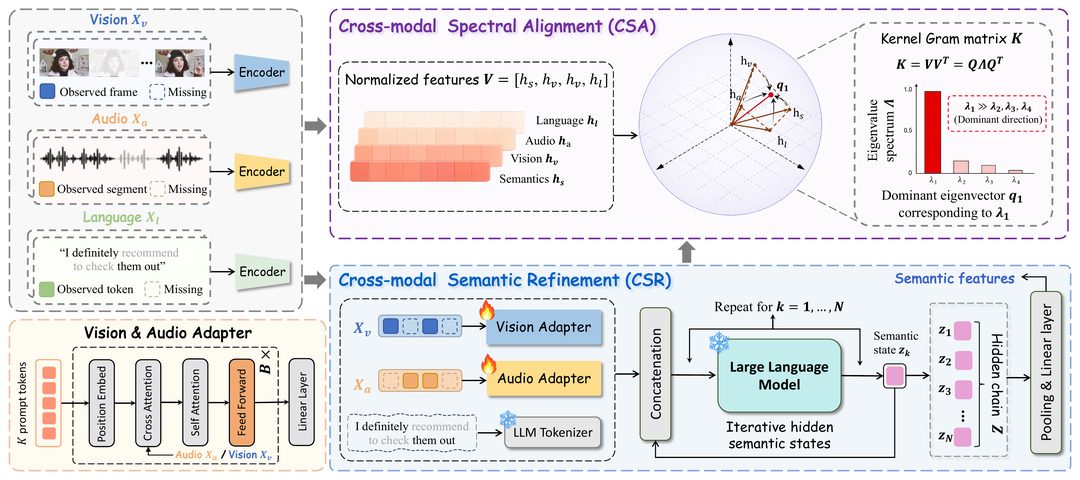
接下来是 CSR 的关键操作:取出大模型最后一层、最后一个位置的隐状态,将它作为一个新的连续词元追加到输入,再进行下一步计算。默认细化 4 步,得到的潜在语义状态经过池化与投影,形成用于融合的语义表示。
可以把它理解为:每一步都把当前上下文压缩成一个连续状态,再让这个状态参与下一步的上下文处理。
整个过程直接在隐空间中完成,省去了逐字生成自然语言描述的解码环节。得到的语义表示为情感预测提供辅助,但不会恢复原始的缺失词语、声音或视频帧,也不等同于一段可以直接阅读的推理说明。
四类表示共同对齐,保留样本之间的差异
引入潜在语义后,模型拥有了四类表示:语义、文本、视觉和音频。它们如何协同?
CSA 将四类表示归一化,通过径向基函数核构造一个 4×4 的核 Gram 矩阵,记录它们之间的核相似度,再利用矩阵的谱结构衡量整体一致性。
直观地说,如果同一样本的四类表示指向较为一致的潜在方向,矩阵就会呈现更突出的主导谱成分。训练目标会增强最大特征值相对于其余特征值的主导程度,推动四类表示共同对齐。这样,对齐过程无需预先指定某一种模态始终充当参照。
但样本内部一致,还要保留不同样本之间的区别。否则,不同情感的样本也可能被压成相似的表示。
为此,SemMSA 加入样本级谱分离约束:将主导特征向量映射回表示空间,得到每个样本的主导方向,并惩罚不同样本之间过高的方向相似度。
最终,四类表示逐元素相加,由线性预测头输出情感分数。训练联合使用预测误差、谱对齐损失与谱分离损失,使模型兼顾预测准确性、样本内部协同和样本之间的可区分性。
三项基准,检验缺失条件下的表现
论文在 MOSI、MOSEI 和 SIMS 上模拟模态内部缺失:缺失的视觉与音频片段置为零向量,缺失文本词元替换为 [UNK],各模态独立采样缺失位置。
测试缺失率从 0% 到 90%,每隔 10% 设置一档;训练时采用按样本的伯努利掩码,并保留 50% 的完整样本。下文的总体结果是十档缺失率下的平均表现,实验报告 3 个随机种子的平均值。
英文与中文数据上均有提升
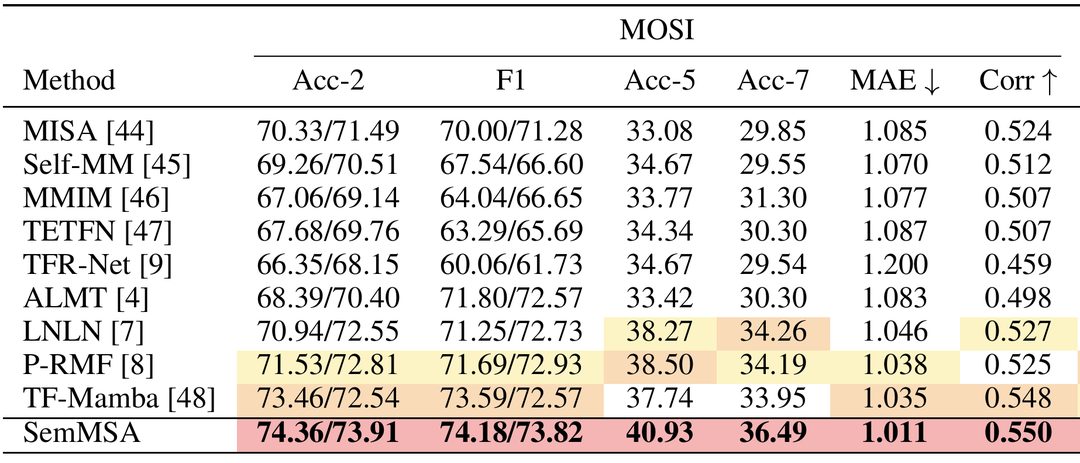
在 MOSI 上,SemMSA 的五分类准确率达到 40.93%,较最佳基线 P-RMF 提高 2.43 个百分点;七分类准确率达到 36.49%,较最佳基线 LNLN 提高 2.23 个百分点。情感分数预测的 MAE 降至 1.011,相关系数 Corr 达到 0.550。
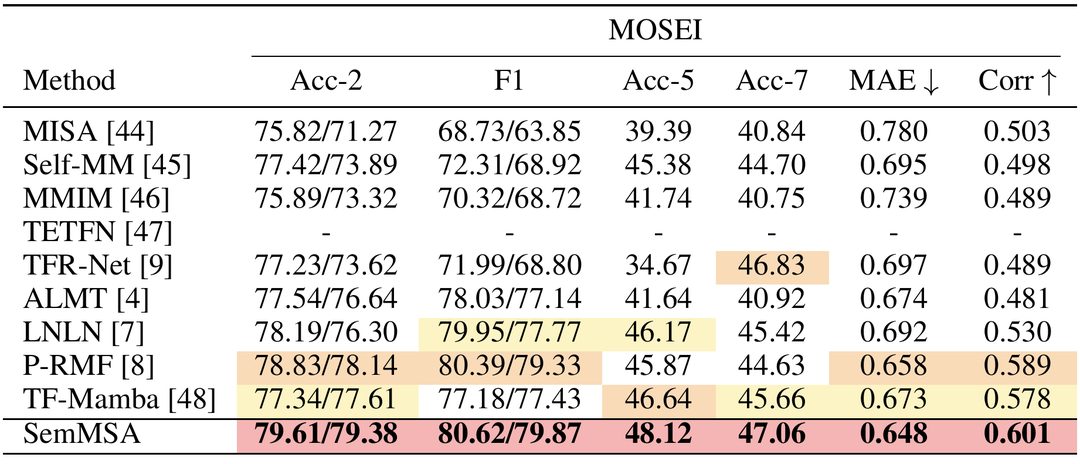
在规模更大的 MOSEI 上,SemMSA 的二分类准确率为 79.61%/79.38%,F1 为 80.62%/79.87%,MAE 为 0.648,Corr 为 0.601,在原表各项平均指标上均取得最优结果。
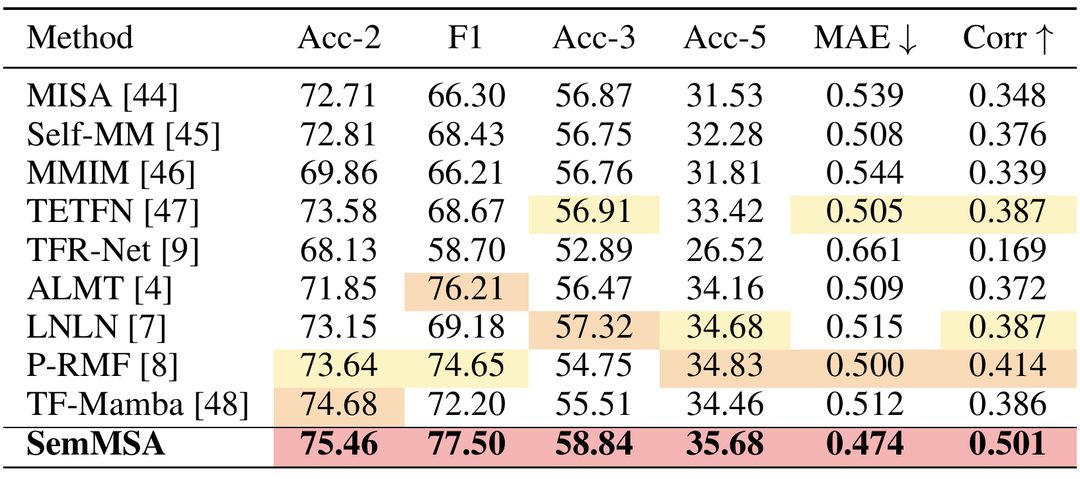
中文 SIMS 上也观察到了改进。SemMSA 的 F1 达到 77.50%,较 ALMT 的 76.21% 提高 1.29 个百分点;Corr 达到 0.501,较 P-RMF 的 0.414 增加 0.087。
缺失越来越严重时,优势能否保持
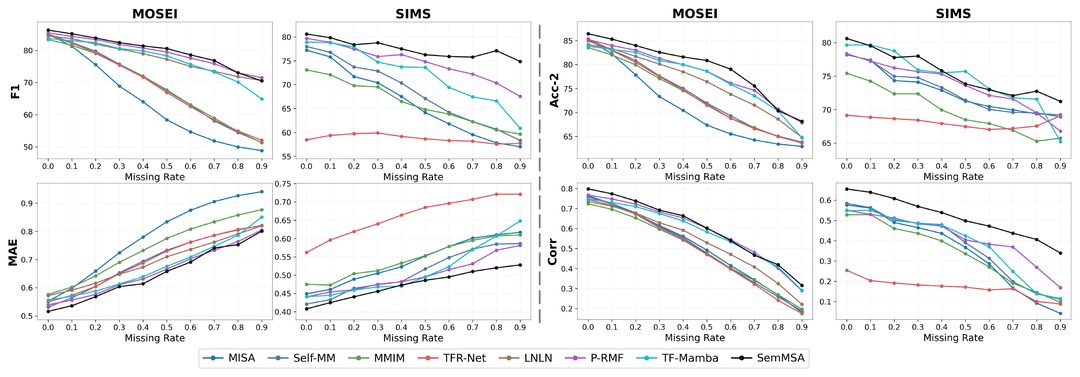
平均结果之外,缺失率曲线能展示模型如何随可用信息减少而变化。
在 MOSEI 和 SIMS 上,各方法的表现总体随缺失率升高而下降,SemMSA 在多数设置下保持较好的表现。极高缺失率仍会削弱其判别能力:潜在语义的作用依赖剩余证据,无法凭空补回所有信息。
整种模态缺失,也能利用剩余线索
如果完全拿掉一种模态,挑战会进一步加大。
在 MOSEI 上,仅保留音频和视觉、没有文本时,SemMSA 的 F1 达到 72.68%,较 CorrKD 提高 0.76 个百分点;只保留视觉时,F1 为 65.91%,提高 3.61 个百分点。
七种可用模态组合的平均 F1 为 77.89%,较 CorrKD 的 75.18% 提高 2.71 个百分点。该平均值包含三种模态均完整的组合。
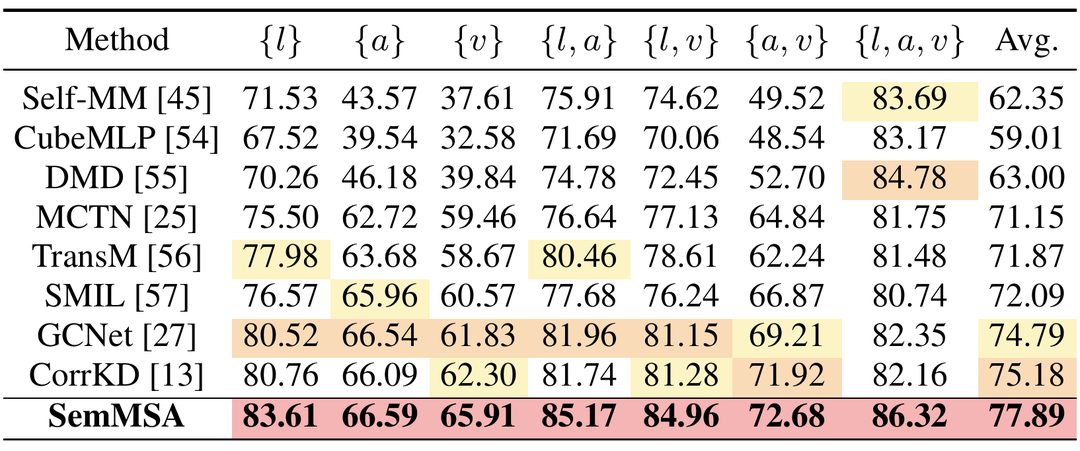
这些结果说明,SemMSA 能够利用非语言线索改善预测。不过,仅视觉或仅音频的分数仍明显低于保留文本的设置,文字依然是这项任务的重要信息来源。
提升来自哪里,额外成本有多大
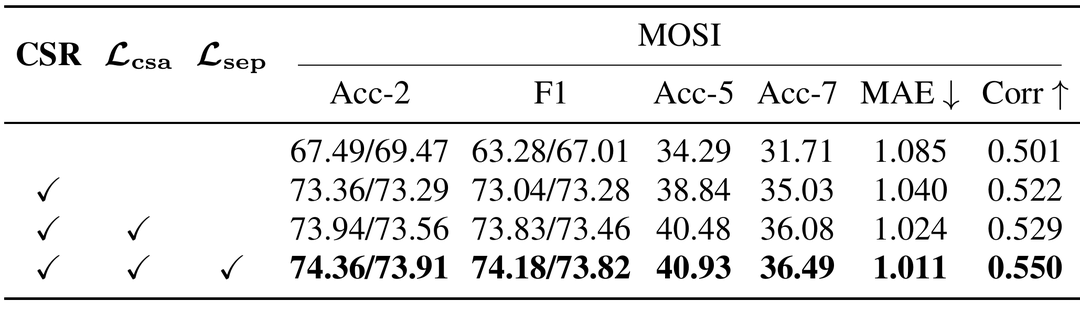
组件消融给出了更直接的证据。在 MOSI 上,按负类/非负类口径统计,基础模型的 F1 为 63.28%;加入 CSR 后升至 73.04%;继续加入谱对齐后达到 73.83%;完整模型进一步达到 74.18%。
语义细化带来了主要提升,两项谱约束则在此基础上继续改善结果。
引入冻结大模型之后,计算成本同样需要交代清楚。冻结参数并不意味着省去前向计算,因此论文分别报告任务模块计算量与完整流程开销。
在 MOSI 的效率实验中,SemMSA 的任务计算量为 4.8 GFLOPs,相比 P-RMF 的 9.7 GFLOPs 降低约 50.5%;完整流程延迟从 67.0 ms 降至 30.6 ms,降低约 54.3%。
这里,可训练参数与 Task GFLOPs 仅统计任务优化模块,显存与延迟则包含冻结大模型在内的完整流程。因而,50.5% 不能解读为整个系统计算量的降幅。
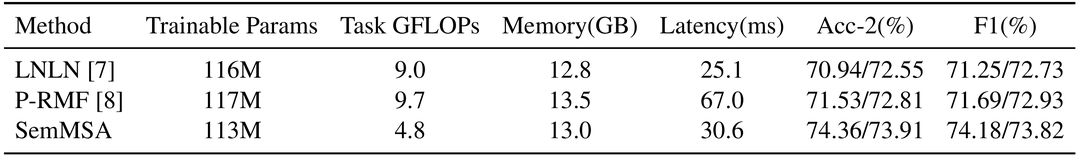
与 LNLN 相比,SemMSA 的任务计算量更低,但延迟更高(30.6 ms 对 25.1 ms)。语义细化仍有额外成本,完整模型在论文测试设置下获得了更好的预测表现。
一个案例:积极词语为什么可能表达负面态度
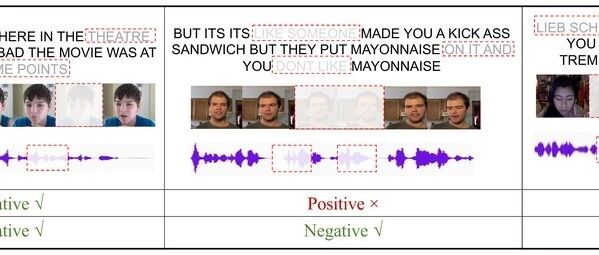
论文展示了 MOSI 测试集中的三段样本。第一例中,P-RMF 与 SemMSA 都正确判断为负面;第二、第三例中,两者给出了不同预测。
第二例尤其直观:说话者用三明治和蛋黄酱作比喻,局部出现了“kick ass”这样的积极表达,但整段话传达的是负面态度。部分文字、画面和声音缺失后,P-RMF 将其判为正面,SemMSA 则给出了与标签一致的负面判断。
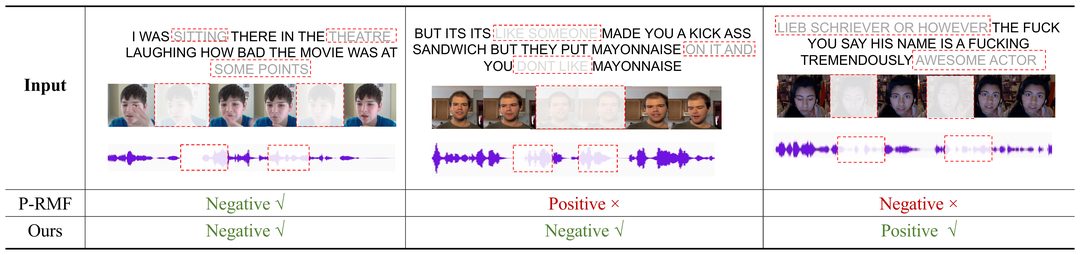
这个例子说明了多模态情感分析的一处难点:局部词语的情感色彩,未必等于整段表达的真实态度。案例结果支持从多模态上下文提炼语义的价值,但具体如何影响预测,仍需要更细致的可解释性分析。
从残存观测中,提炼更有用的语义
SemMSA 将大模型的上下文表示能力引入不完整多模态情感分析:通过 CSR 提炼潜在语义,再通过 CSA 与原始模态联合对齐,使有限观测能够更充分地服务于情感预测。
三项中英文基准、整模态缺失实验与组件消融,共同支持了这一设计。它也为多模态学习提供了一个可继续探索的方向:在输入难以完整获取时,如何用紧凑的高层语义辅助判断。
目前,实验主要覆盖视频观点表达场景,向对话情绪识别、讽刺检测和长时交互的泛化能力仍待验证。潜在语义缺少直接可读的解释;当剩余线索本身不可靠时,语义细化的帮助也会受到限制。
论文、项目网站、代码与 Hugging Face 数据集页面已公开,感兴趣的读者可以进一步查看方法细节与实验设置。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。