102 页综述逐章精读:视频基础模型如何「读、写、共享、交互」世界
原创 52CV 2026-10-27 22:08 江苏
导读
能回答视频问题、能生成流畅画面,是否意味着模型已经理解了世界?我们在这篇综述中给出的回答是:不一定,而且这两件事需要分开检验。 视频只是潜在动态世界的局部、有损、按时间排列的观测;真正需要检验的,是模型如何表示并预测观测背后的状态。
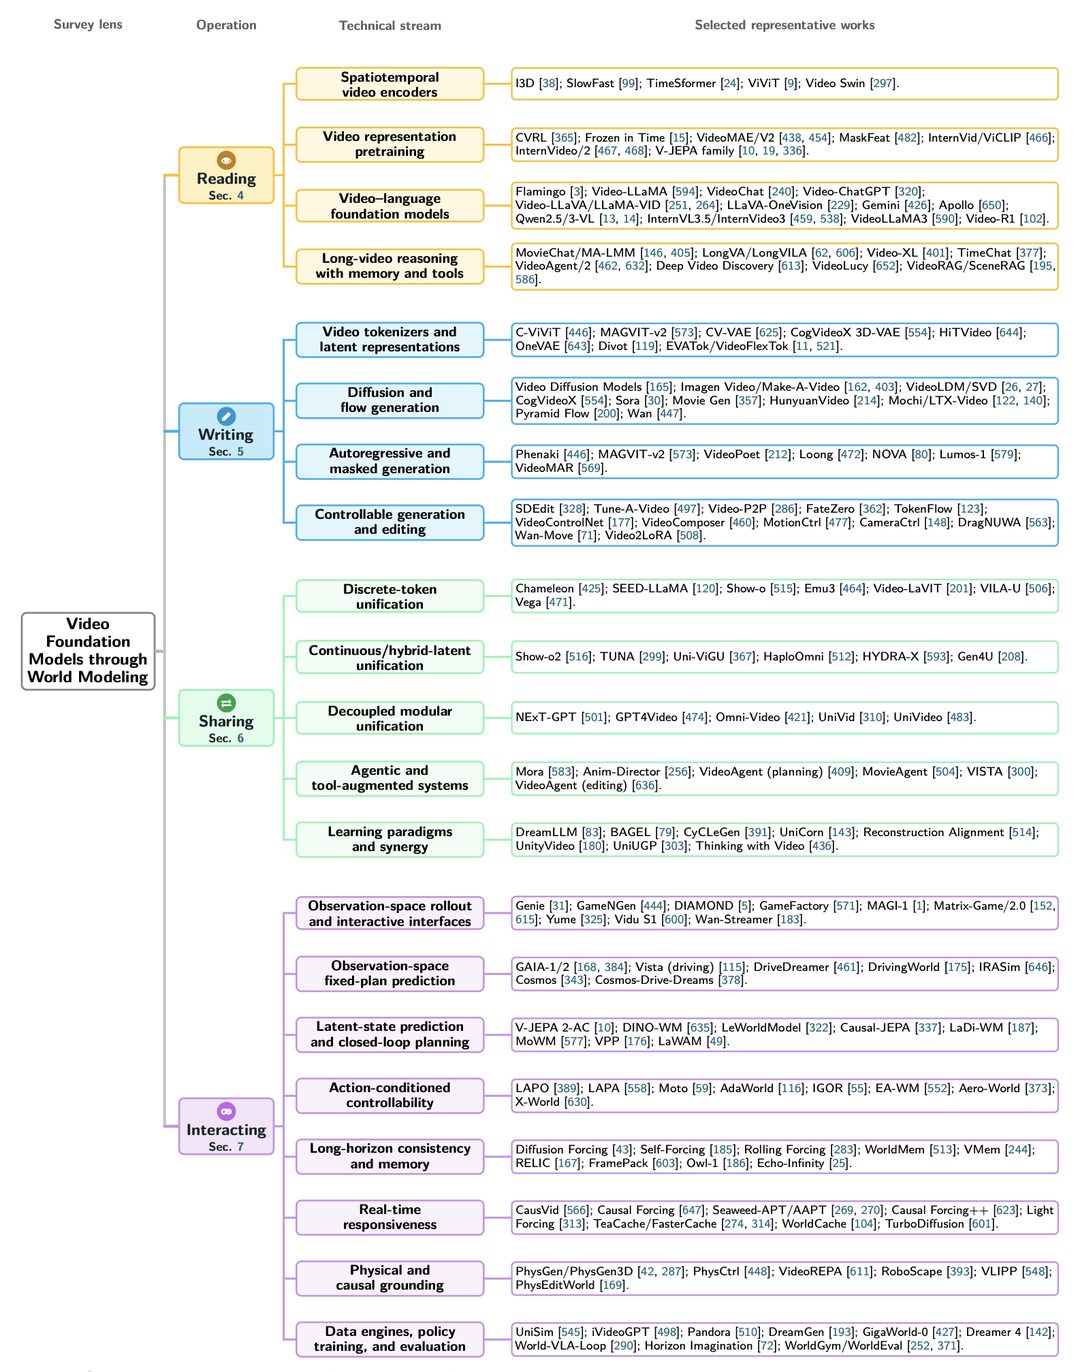
本文按原论文九章的顺序整理,每章保留核心定义、分类依据和我们的判断,并配以原文插图。原文是综述,没有新增统一的性能实验;下文也不把不同论文在不同设置下的结果混成一个排行榜。
论文信息
题目:Reading, Writing, Sharing, and Interacting with the World through Video: A Survey Toward Unified Video World Models
作者:Shengqiong Wu(牛津)、Meng Luo(NUS)、Bobo Li(牛津)、Ziwei Liu(NTU)、Shuicheng Yan(NUS)、Ming-Hsuan Yang(UC Merced)、Philip Torr(牛津)、Hao Fei(牛津,项目负责人 / 通讯)。* 为共同第一作者。
版本:arXiv v1,2026 年 10 月 22 日提交;102 页,17 幅图,19 张表,引用文献 600+ 篇
1 Introduction|引言
视频记录实体、关系和动作随时间的变化,往往还带着同步的音频、语音和文本。这一领域从动作识别和时空编码器出发,发展到视频语言模型、大规模生成器、理解生成统一系统,以及动作条件预测和交互式仿真。
这些方向共同涉及「观测」与「世界」的关系,却不能因为用了相似的视频数据,就被认定具有同样的能力。生成器可以依据描述合成片段;世界模型还应预测状态如何在条件、动作和反馈下演化。我们在全文中坚持一条原则:模型设计支持什么、训练数据监督了什么、评测真正证明了什么,必须分开。
综述的三项贡献:一个世界建模视角(四操作框架 + 世界模型的两轴分类);覆盖任务、表示、模型、系统、数据与基准的系统梳理和洞见;一份公开维护的资源列表。
2 The World-Modeling Lens|世界建模视角
2.1 世界、视频与表示状态
我们区分三个对象:
潜在时序世界:一个随机过程,每个状态 包含实体、属性、关系和相关的物理、动力学变量。
观测视频:由感知过程 生成, 是相机配置。我们把观测或生成的视频统称为痕迹(trace)。
表示状态:模型从可得的观测和动作中构造的内部表示。一般 ,它可能是显式几何、视频 token 或隐特征,也可能并不完整。
这三条定义描述的是一个部分可观测的动力系统,与基于模型的强化学习中的环境模型密切相关;但对通用视频基础模型而言,表示状态可能是隐式的,或者从整段序列构造而非在线更新。一个重要推论:「模型里有一个潜向量」本身,不是它已经恢复了物理状态的证据。
2.2 两种一致性
设 是模型生成或预测的痕迹:
时间连贯(temporally coherent):相邻帧局部一致,, 惩罚不合理的局部运动、外观变化或闪烁。
世界一致(world-consistent):存在至少一条合法的世界轨迹 和相机路径 ,使每一帧都落在 的支撑集内。 包含满足动力学、身份持续、空间关系以及指定干预下物理因果约束的轨迹。
二者互不蕴含。物体离开画面后换了身份、房间在两次到访之间换了布局、动作效果后来消失——这些都可以产生局部平滑但没有任何合法轨迹能解释的帧;反过来,电影的硬切违反局部平滑,却可以是世界一致的。真实录制的视频天然世界一致,所以这个区分只对模型写出或预测的痕迹有意义。由于 和 都不可观测,世界一致性是一个评价目标而非可直接计算的指标,需要通过重访、遮挡和干预测试来探测。
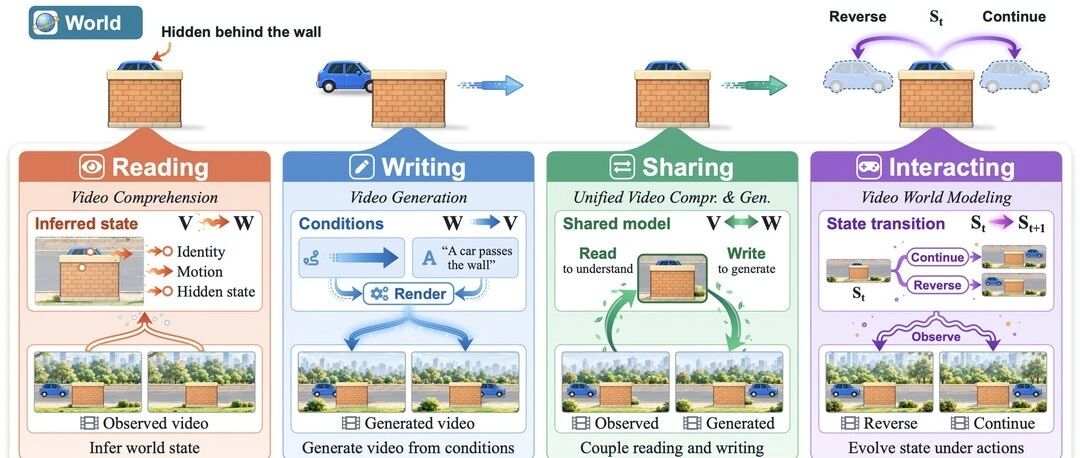
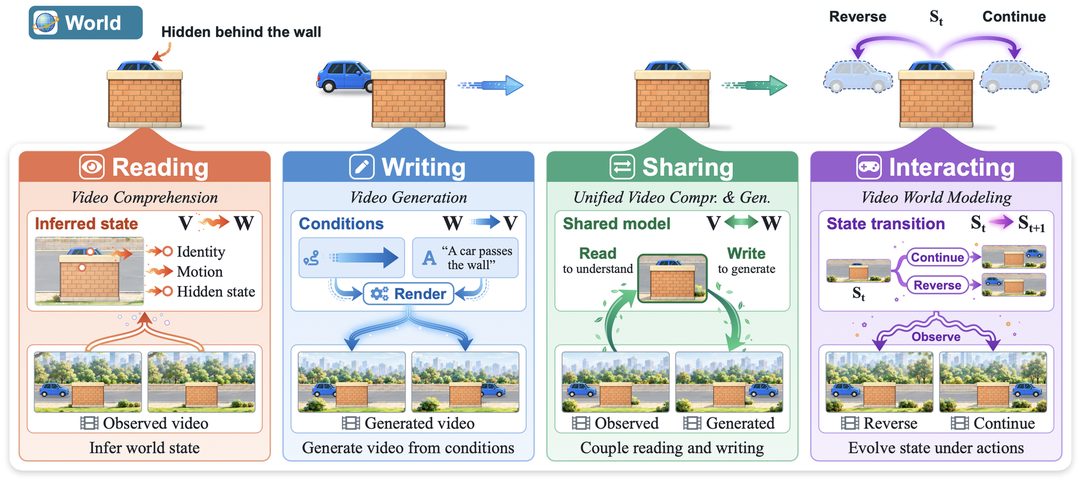
2.3 四种操作
🟠 Reading:从视频推断世界属性 , 覆盖语义、空间、时间、物理和因果。以对 的准确率和对遮挡 / 画面外内容的校准不确定性评价。
🔵 Writing:从条件采样痕迹 ,条件 只部分指定世界,生成器补全其余。以感知质量、条件遵循和世界一致性评价。
🟢 Sharing:读图 和写图 至少共享一个组件:参数、token / 表示、接口或训练目标。在三个层次评价:能力覆盖、架构共享、功能协同。
🟣 Interacting:推进转移模型 ,需要可见输出时解码 。以预测的变化是否跟随输入、是否世界一致来评价。
这里的箭头是概念简写:写只通过 触及 ,读和写也不是精确的逆映射。这些操作不是互斥标签;交互系统也会读历史、写画面。
证据阶梯
操作 | 1. 输出合理 | 2. 忠于证据 / 条件 | 3. 世界状态一致 | 4. 决策效用 |
|---|---|---|---|---|
Reading | 片段级标签和答案正确 | 答案依赖视频,排除捷径 | 状态跨遮挡、重访和流式输入保持 | 证据支撑智能体或驾驶决策 |
Writing | 感知质量与时间连贯 | 遵循文本、运动和参考条件 | 身份、布局、物理的世界一致 | 生成数据或计划改善下游模型 |
Sharing | 两个方向在一个系统里都能做 | 集成的、忠于源的变换 | 匹配资源下测得的迁移 | 共享预测改善规划或动作 |
Interacting | 预测帧或特征合理 | 预测变化跟随固定或在线控制 | 持久状态 + 对干预的合法响应 | 更好的规划、策略训练或策略排序 |
3 Preliminaries|预备知识
3.1 视频场景
常规短视频、有声视频、第一人称视频描述记录内容的形态;流式 / 在线、长视频、交互式视频描述模型如何访问观测、能否改变观测;驾驶、手术、体育、教学等领域视频横跨以上标签。离线模型可以看完整片段,在线模型只能用当前和过去的观测并在有限延迟内响应;长视频的证据稀疏且分布在相距很远的片段;交互视频的未来依赖交互历史。评测结论应注明观察条件。
3.2 视频大语言模型
典型 Video-LLM 用视频编码器 提取特征,经连接器 变为语言兼容序列 ,再送入 LLM。连接器从线性投影到可学习查询重采样器和门控交叉注意力不等。帧采样、时间池化和连接器共同决定保留的嵌入数 :更大的 保留更细的时空证据,但消耗更多上下文;更强的压缩更便宜,但可能丢掉短暂事件、小物体和长程关系。由于上下文窗口还要容纳指令、历史对话和输出,长视频模型必须在时间覆盖和视觉细节之间分配预算。
3.3 生成建模基础
扩散学习去噪,流匹配学习从噪声到数据的速度场;自回归按顺序预测离散或连续单元,掩码模型根据可见上下文恢复被遮位置。我们统一了记号:生成目标为 ,去噪步 。生成过程的步数 与视频世界中的时间 不是同一个变量。
3.4 视频世界模型的分类
视频世界模型执行「交互」操作,且状态以视频为中心。我们排除主要持久状态是显式 3D 结构(神经场、3D 高斯、占据栅格)的模型和纯符号 / 文本世界模型;只把 3D 结构作为辅助记忆的模型仍在范围内。来自基于模型的强化学习的世界模型,只有在状态从视频学得时才纳入。
两个独立的轴:预测空间(观测空间:预测未来帧、视频 token 或可解码成视频的生成潜变量;潜状态:预测不必解码的视频衍生特征)和转移接口(被动、动作条件、交互式)。由此得到六个格子,而不是把所有视频生成器一概称为交互式世界模型。
4 Video Comprehension|视频理解:读取世界
4.1 任务、数据与评测
我们按所需的世界状态维度组织理解任务:语义(实体、动作、事件)、空间(位置、身份、布局、视角)、时间(顺序、时长、边界、长程依赖)、物理(接触、重力、容纳、材料)、因果(效果、干预、反事实)。输出格式是独立的轴:标签、区间、掩码或句子都可以探测任一维度。
综合准确率不能说明模型用了预期的证据:很多问题可以从文本、单帧或静态外观回答。纯文本、单帧、打乱帧序、限制上下文这些基线能暴露捷径;TempCore 和 Video-Index 用它们把现有基准过滤成依赖视觉、对顺序敏感的子集;近似画面但答案相反的最小对(TimeBlind、MVP)阻断纯外观解法。
空间理解中,一组新基准测试画面外的状态:SCP-Bench 推断未见的过去或未来布局,Beyond3D 问被移动的物体现在在哪,OVO-S-Bench 只用目前看到的前缀作答——这正是世界模型必须维持的物体恒存和重访一致性。物理理解中,IntPhys、Physion、CLEVRER 之外,MVP 和 VisPhyWorld 检查答案是否基于物理证据而非先验,后者要求模型把场景重建为可执行的模拟器代码。
4.2 视频表示学习与编码
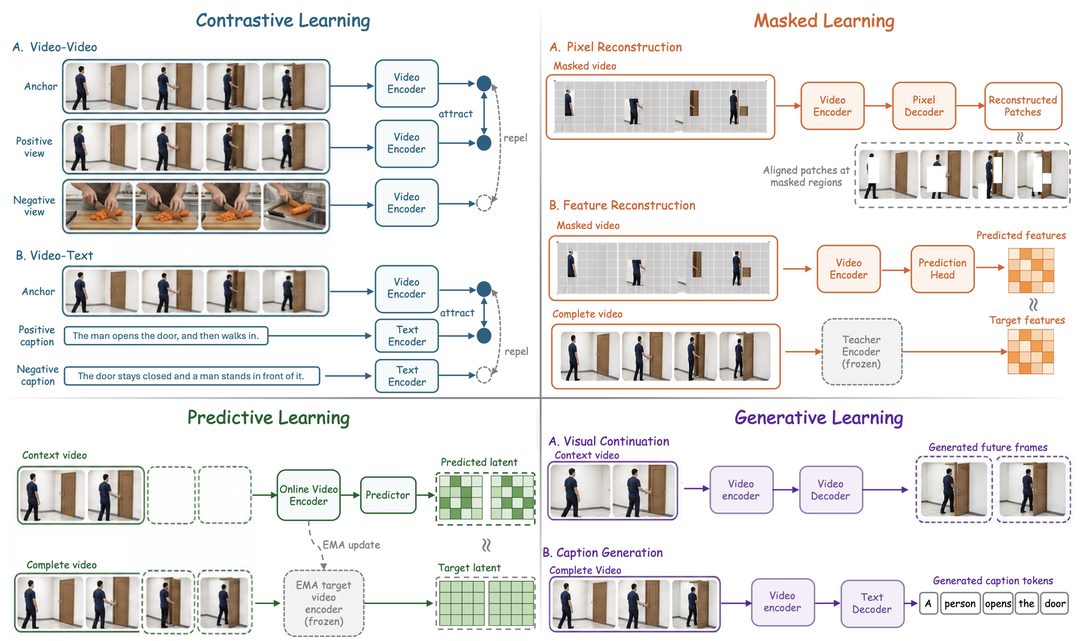
对比学习拉近匹配的视频或文本,适合语义对齐;掩码学习恢复像素或特征;预测学习从上下文预测缺失或未来的表示(V-JEPA);生成学习通过重建、续写或描述保留信息。几类可以重叠,分类依据是主要监督目标。重建能力、文本对齐与可恢复的物理状态并不等价:丢弃纹理可能有利识别却不利生成,只优化语言匹配也可能损失定量的物理变量。
4.3 视频语言基础建模
架构要平衡视频编码、视觉 token 压缩与语言推理;训练通常经历视觉语言对齐、指令微调和推理强化;测试时还可以增加证据搜索、分段分析或推理预算。更多的计算只有在补足相关证据时才有价值,不能把推理链变长直接解释为世界知识更准确。长视频模型应报告真正可用的历史,而不只是最大输入长度。
4.4 智能体式视频建模
视频智能体把「观看」变成迭代工作流:提出子问题、定位片段、调用检测 / 跟踪 / 语音识别 / 检索工具,再汇总证据;外部记忆帮助处理超长历史和反复查询。代价是工具输出、检索和中间摘要可能传播错误。评测应保留时间戳与来源,衡量证据命中、调用成本和最终判断。
💡 视频理解受限于状态,而不是上下文长度。 编码器压缩观测,Video-LLM 把证据映射为语言,智能体选择看什么;它们共同受限于保持并 grounding 了多少状态。更长的上下文只在能修正或稳定状态估计时才有用。
5 Video Generation|视频生成:写入世界
5.1 任务、条件与评测
文本、图像、视频前缀、音频、相机、轨迹和布局规定不同的条件,模型补全未指定的部分。评测应按属性分组:视觉保真与时间质量(FID 忽略时间顺序;FVD 依赖特征提取器且可能偏向静态样本;JEDi 用 V-JEPA 特征和 MMD 回避高斯假设)、条件对齐与组合性(cFreD 能惩罚被调换提示的视频;FETV、T2V-CompBench 拆分对象、属性、关系、动作和时间组合)、物理与世界一致性(VideoPhy / VideoPhy-2、PhysicsMind、PhyProbe)、人类偏好与学习型评估器(VideoScore、MJ-VIDEO,各自继承标注分布的偏差)、多镜头与音视频(MSVBench、JavisBench、LongAV-Compass)。
单一的综合分数会掩盖限制系统的那个失败。
5.2 视频潜表示学习
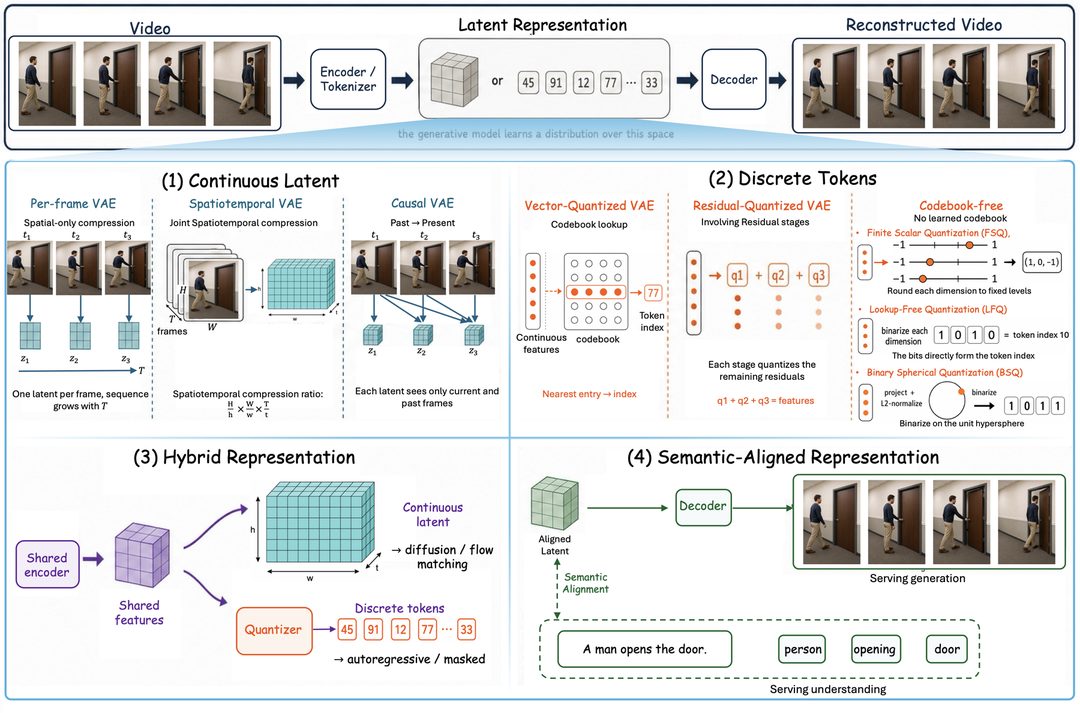
连续潜空间降低像素生成成本,离散 token 适合序列建模;混合或语义对齐的表示试图同时服务理解与生成。压缩要在重建细节、运动、长度和语义组织之间权衡:只按重建误差挑选编码器可能错过下游生成需要的结构,语义表示太抽象会丢失外观,过度保留像素又推高序列成本。
5.3 生成式视频基础建模
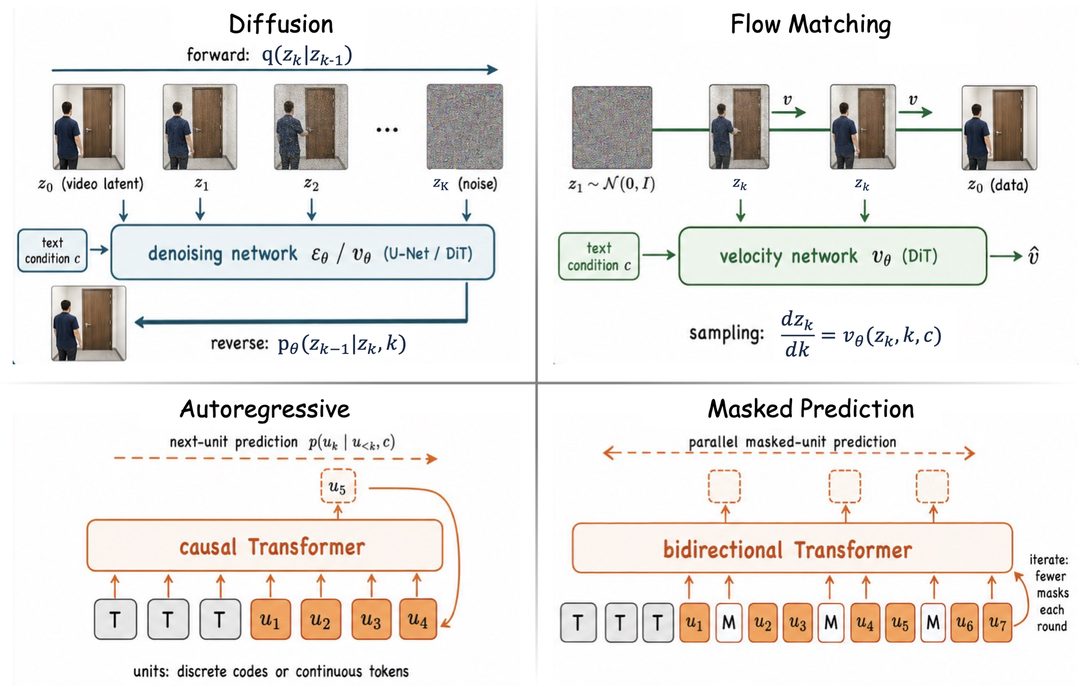
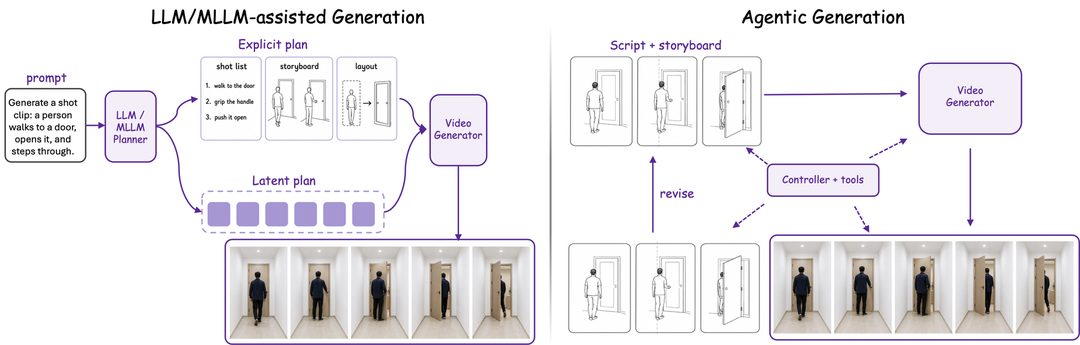
生成机制与系统工作流是两层选择,不应互斥分类。自回归会累积自身前缀误差,分块生成需要维持跨块的身份与运动,多步采样面临交互延迟。比较时应注明分辨率、长度、采样步数和硬件。
5.4 控制策略
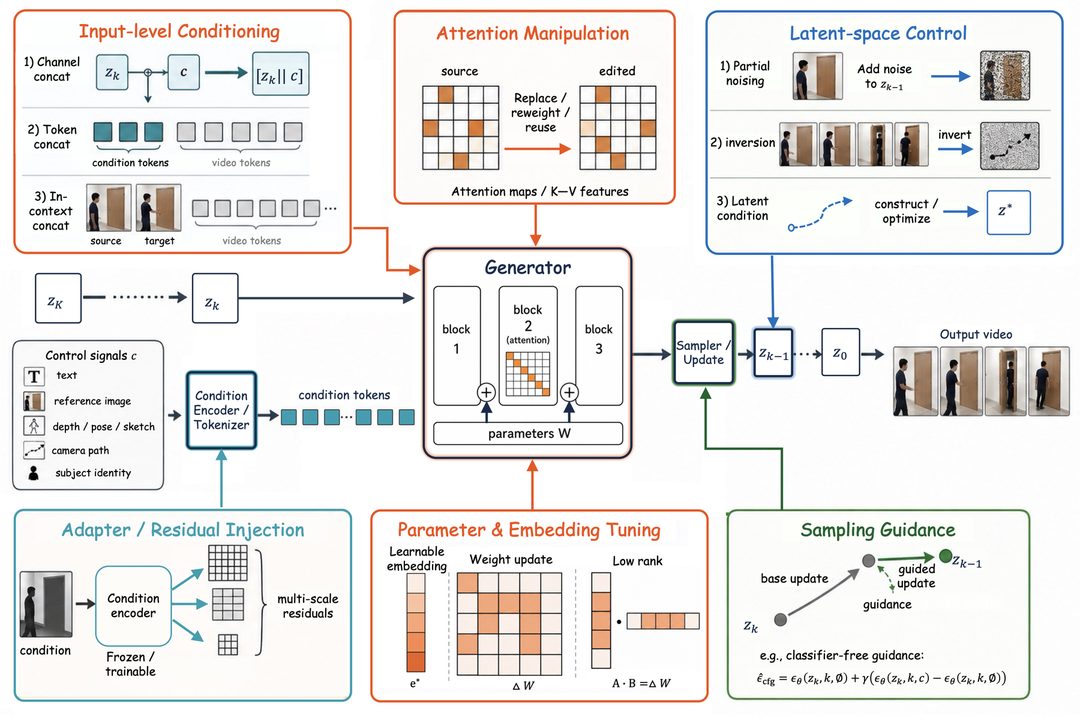
相机、姿态、对象身份和运动等信号可以通过多条路线进入,同一系统也可以组合使用。有效的控制应改变目标属性、保持无关属性、并让效果持续。调整一处运动却让背景或身份漂移,不能因为画质高就算成功。
5.5 应用
创意制作、角色动画、具身视频计划、具身与驾驶的合成数据。生成的计划一旦固定就不能自动响应新反馈,这和可在线更新的仿真器不同。合成数据应以真实感知或策略训练的收益来验证;带有视觉动作的片段不等于已经提供了正确的机器人动作标签——生成器和逆动力学标注器可能共同放大错误。
💡 渲染保真和有状态的控制是两条独立的扩展轴。 进展应该通过比较「有控制 vs 无控制」的匹配 rollout 来衡量。
6 Unified Video Models|统一视频模型:共享世界
6.1 统一架构
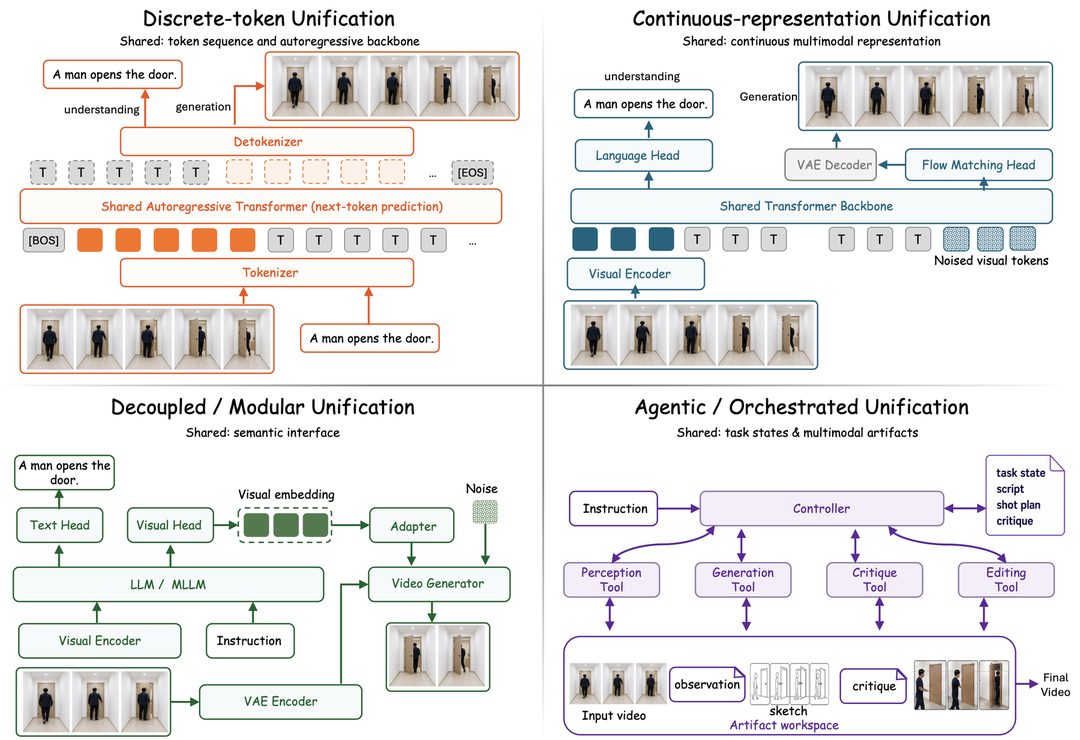
离散 token 方案共享序列和自回归骨干,但量化与长序列是瓶颈;连续方案共享潜空间,通常保留不同输出头;模块化方案用语义桥连接理解与生成专家,方便替换组件,却可能在桥接中丢失几何和运动;智能体方案共享任务状态并编排感知、生成、编辑与评审工具。共享骨干也不自动消除「理解需要的不变性」与「生成需要的细节」之间的张力。
6.2 学习范式
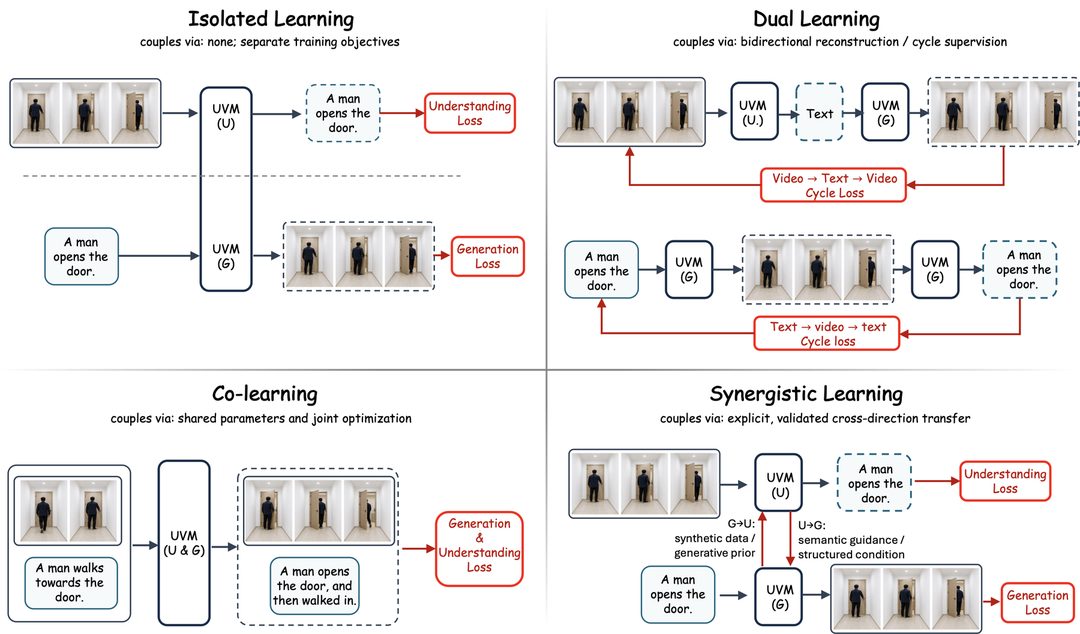
循环不是精确的逆映射:同一描述允许多种视频,约束应保留任务相关的身份、事件、视点和运动,容忍合理的外观变化。联合训练改善两项分数,也可能只是多用了数据和算力。协同学习的证据是接收方向上测得的增益:OmniWeaving 的思考模式提升意图驱动任务,ReViSE 用冻结 VLM 的答案概率作为可微奖励改善编辑,Lance 的数据混合消融给出双向的视频证据(理解数据改善 VBench,生成数据改善 MVBench),CounterVid 用合成的反事实动作片段减少动作和时间幻觉。除 Lance 外,受控的双向测试目前仍以图像域为主。
6.3 应用与 6.4 评测
指令编辑先理解原片再生成修改;生成式推理把预测的中间状态交给后续分析;感知—生成—规划系统把想象结果用于动作选择。中间产物应可检查,不能把答案藏在生成条件里再宣称推理提升。
评测分三层:分别评价(MVBench、Video-MME 等 vs VBench、VBench-2.0,分开报告,匹配单任务基线以发现干扰)、集成 / 交错评价(UniVBench 在多镜头视频上评理解、生成、编辑和重建,其重建和编辑任务检查源内容是否存活)、协同评价(比较匹配路线:理解引导的生成 vs 普通生成;有无生成中间物的理解)。往返协议(推断事件或布局 → 渲染 → 读回)需要定义要保留的不变量,并加入非统一和无循环的对照;还要控制训练—测试重叠、中间表示泄漏答案、以及不同裁判的偏差。
💡 协同需要受控的跨向迁移。 共享 token 或参数说明耦合,分开的分数说明能力,混合任务说明互操作;协同需要在匹配的数据、容量和算力下消融跨向路径。
7 Video World Models|视频世界模型:与世界交互
7.1 架构与训练范式
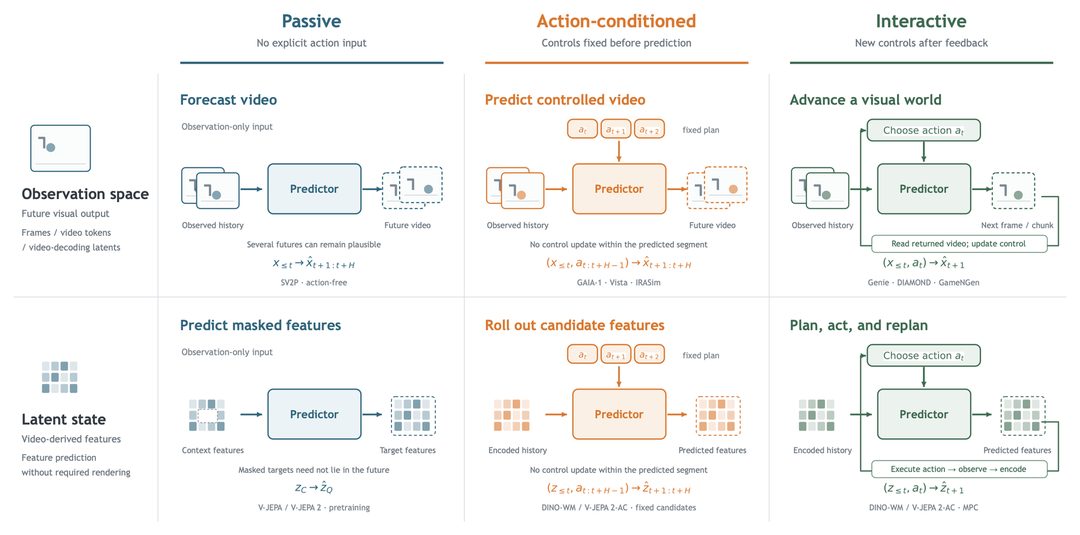
观测空间 · 被动:SV2P 的动作无关设置采样潜变量预测多个未来;Sora 作为「世界模拟器」的愿景、Physics-IQ 对真实开头的续写评分、Cosmos 动作后训练之前的基础模型都属于这里。它为受控格子提供动力学先验和不确定性估计。
观测空间 · 动作条件:整段的控制在生成前给定:GAIA-1 的文本和动作 token,GAIA-2 的自车动力学、智能体配置和道路语义,Vista 的指令、目标点和轨迹,IRASim 的帧级机器人动作。多数模型通过条件编码器、交叉注意力或控制分支改造预训练生成器。Vid2World、minWM、BiWM 把它们改造成因果生成以接受在线控制。
观测空间 · 交互式:Genie 从学得的潜动作预测 token,GameNGen 从历史帧和动作扩散下一帧,DIAMOND 既在生成的观测里训练策略也作为交互模拟器;Oasis、Hunyuan-GameCraft、Matrix-Game、Genie 3 实现实时可玩;Vidu S1/S2 和 Wan-Streamer 以语音为控制;Solaris 和 MultiWorld 让多个参与者共享一个世界。
潜状态 · 被动:V-JEPA / V-JEPA 2 的掩码特征预测。被遮区域可以从两侧帧预测,所以这不是因果预报;我们保留它们,是因为其预测器为动作条件的潜格子提供特征空间和初始化——单独来看它们是转移模型的预训练,而非完整的世界模型。
潜状态 · 动作条件:V-JEPA 2-AC 在机器人轨迹上后训练预测器,DINO-WM 学习冻结 DINOv2 特征在动作下的演化,LeWorldModel 从像素联合学习编码器和预测器。它们可以 rollout 候选动作并与目标表示比较而不渲染任何一帧。
潜状态 · 交互式:用 MPC 闭环:选动作前缀、执行、编码新观测、再规划。V-JEPA 2.1 在真实机械臂上完成到达、抓取和取放。潜 rollout 不花容量在纹理上,但潜距离可能漏掉任务相关细节;由于纠正性再规划能掩盖差的评分器,需要评分器层面的审计。
7.2 核心技术挑战
四个挑战贯穿整个网格:控制、记忆、延迟和物理 grounding,且相互作用——更长的记忆抬高推理成本,更少的去噪步改变 rollout 稳定性,更强的动作约束可能扰动预训练的视觉先验。
动作可控性。没有动作记录时,潜动作模型耦合逆动力学与前向动力学,用离散码本或连续瓶颈限制信息量(LAPO、LAPA、Moto、Genie;AdaWorld、IGOR 用连续潜动作)。但潜动作可能锁定错误的变化来源:LAOM 表明视觉干扰项会让潜动作编码背景或相机运动,少量动作监督能把它锚定到主体。有动作时,条件要绑定到正确的时间、视角、对象和后果:IRASim 逐帧注入动作,EA-WM 把运动学投影成相机视角下的视觉动作场,Aero-World 用冻结的潜物理探针检查惯性一致性。
长程一致与记忆。失败发生在两个尺度:局部的误差回流累积,全局的有限上下文丢弃不再可见的实体。前者需要训练与部署对齐——Diffusion Forcing 给序列元素独立噪声水平,CausVid / Self-Forcing / Causal Forcing 把双向多步教师蒸馏为因果少步学生,Rolling / Next / One / Delta Forcing 改变窗口、视界或目标。后者需要存储、压缩或递归更新:WorldMem 以位姿和时间检索存储帧,VMem 用 3D surfel 索引,RELIC 在 KV 缓存中保存压缩历史,Matrix-Game 3.5 用几何投影的潜 patch 和参考 token 避免把物体的旧位置误认为新物体;FramePack 给旧帧更小的表示预算;状态空间模型、Echo-Infinity、WorldTrace 保持固定大小的状态。但记住看见过的东西,不同于追踪画面外的变化:WorldDirector 让规划的物体在不可见时继续移动,LiveWorld 用虚拟监视器生成画面外实体的进展。
实时响应。响应性是新动作到第一个反映它的输出之间的延迟。Vidu S1 在消费级 GPU 上达到 540p / 42 FPS,Wan-Streamer 25 FPS;但有时间压缩时,一个预测潜变量解码出多帧,动作进入的频率可能低于显示帧率——Waypoint-1.5 因此分开报告渲染 FPS、潜 FPS 和控制率。加速路线包括少步蒸馏与对抗后训练(Seaweed-APT 一步生成、AAPT、Causal Forcing++),以及免训练的稀疏注意力(Light Forcing)、缓存(TeaCache、WorldCache)和量化(TurboDiffusion 报告两个数量级的端到端加速)。
物理与因果 grounding。显式路线让模拟器产生动力学、生成器负责渲染(PhysGen、PhysGen3D、PhysCtrl);隐式路线改变生成器学什么(VideoREPA 蒸馏自监督视频编码器的 token 关系,PhyGDPO 用物理合理性偏好后训练,VLIPP 用 VLM 规划粗粒度运动并转换为结构化噪声)。但合理性目标不记录是哪个力、动作或初始条件产生了运动。干预级证据固定初始状态、改变一个动作或物理参数,比较受影响的未来和不应改变的状态:PhysEditWorld 在不同重力下重放相同游戏回合,OneWorld 要求同一场景的多个动作条件未来共享一个潜在物理解释。
7.3 应用
按谁消费预测来区分:数据引擎(DreamGen、GigaWorld-0 合成带动作标签的轨迹;GAIA-2、Vista、Cosmos 供给罕见的驾驶场景)、想象中训练策略(Dreamer 4 在视频世界模型内用 RL 训练 Minecraft 智能体;World-VLA-Loop 把更新后策略的 rollout 回灌给模型,因为固定的模拟器最常在策略改变后访问的状态上失败)、策略评测环境(WorldGym、WorldEval 以生成的成功率是否保持真实策略排序来验证)、先预测再行动(UniPi、AVDC 生成视频计划再反推动作;NWM 用条件扩散 Transformer 预测候选导航动作下的第一人称观测;V-JEPA 2-AC、DINO-WM 不解码像素直接给候选动作评分)、面向人的交互模拟(Genie 3、GameNGen、Oasis、Matrix-Game 2.0;Vidu S1、Wan-Streamer 把输入从游戏动作扩展到语音)。
应用证据不能停留在视频质量:训练环境应提高真实策略表现,评测环境应正确排序候选策略,规划器应改善动作决策。
7.4 基准与评测
挑战导向:动作跟随(ACT-Bench、iWorld-Bench;MiraBench 测试在本应失败的动作下的「乐观」)、长程记忆(LoopBench 静态重访;但静态缓存也能通过重访测试——MBench、STEVO-Bench、MemoBench 要求画面外改变的物体以更新后的状态回归)、实时响应(应报告动作到达到首个受影响帧的延迟、持续吞吐和延迟方差)、物理因果(Physics-IQ 与真实结果比较,PhyWorldBench 的反物理提示,What-If World 的成对提示同时评结果差异和环境保持)、校准(PAWBench、CaliBench 从固定输入重复采样比较结果分布)。
应用导向:WorldGym / WorldEval 的策略排序一致性、RoboWM-Bench 把生成的操作视频转成动作在物理模拟器里执行、WorldArena 发现感知质量与效用两种排名不必一致、ARC-Bench 审计潜距离目标是否按执行代价给动作排序。不同提示、视界、动作空间和裁判使数字不宜直接横比。
💡 从预测状态到干预与效用。 证据应与转移协议匹配:被动模型展示预测结构,受控模型在动作作用处改变世界并保持其余不变,交互系统在反馈下保持这些后果,决策应用把它们变成更好的选择。
8 Open Challenges|开放挑战与未来方向
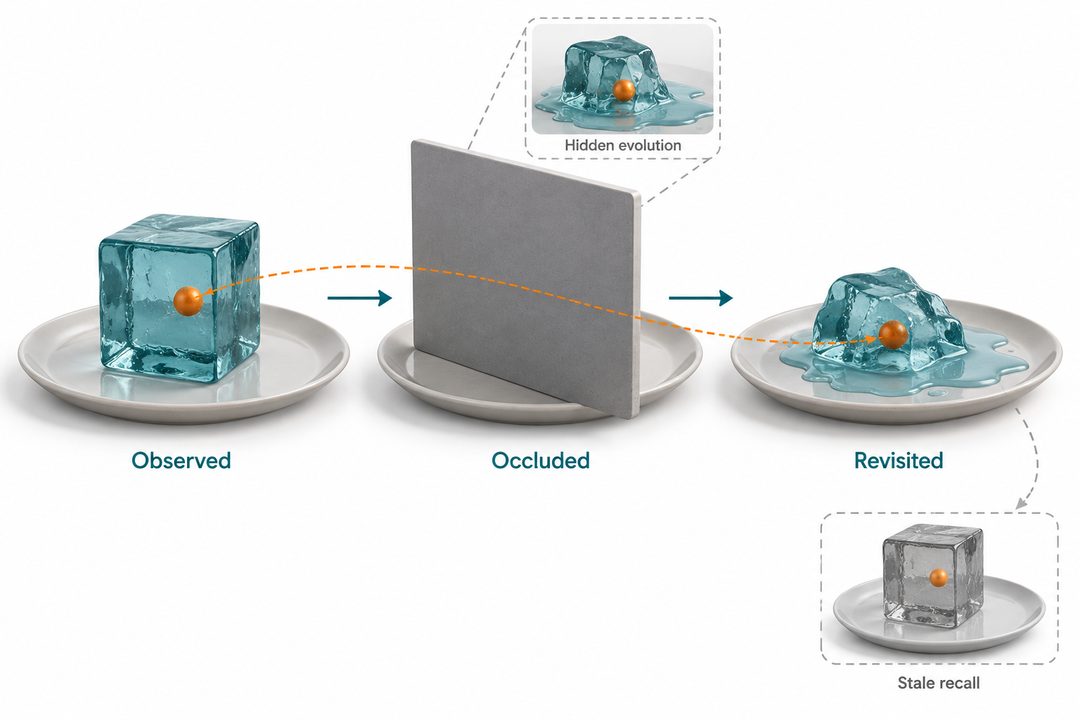
8.1 长程世界一致性。读取远处证据、保持不可见的状态、让它正确演化,是三种不同的能力。大多数记忆方法存储的是看见过的内容,而预测状态还要追踪画面外的变化:被挡住的冰块在融化,回放旧观测会得到一块过时的冰。方向是训练记忆在遮挡期间预测隐藏实体如何演化,并与抑制 rollout 误差的训练(如 LIVE 的前向—反向循环一致)结合;评测应分别改变 rollout 长度和重访距离,报告退化曲线而非终点总分。
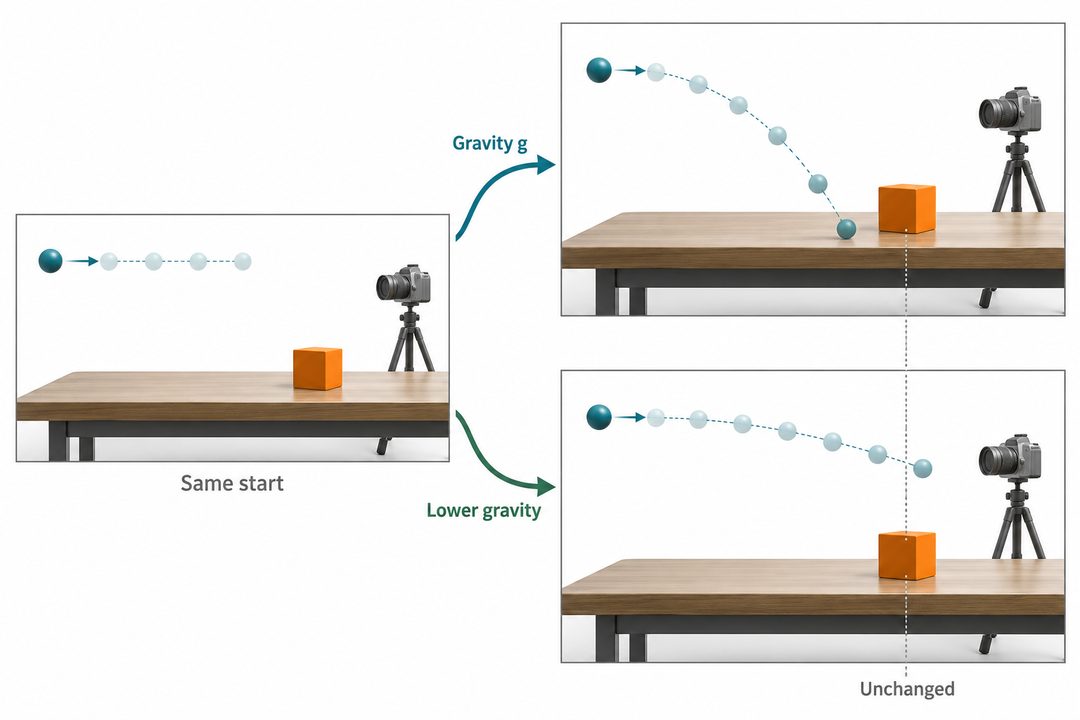
8.2 物理与因果 grounding。三个递进层次:识别(读)、合理生成(写)、对干预的正确响应(动作 / 参数条件)。同样的初速度、两种重力,球的轨迹应不同,相机和背景应不变。方向是把物理先验与干预配对数据结合,奖励预期的改变、惩罚其他地方的漂移;评测应定位首个被违反的约束及其出现时间。
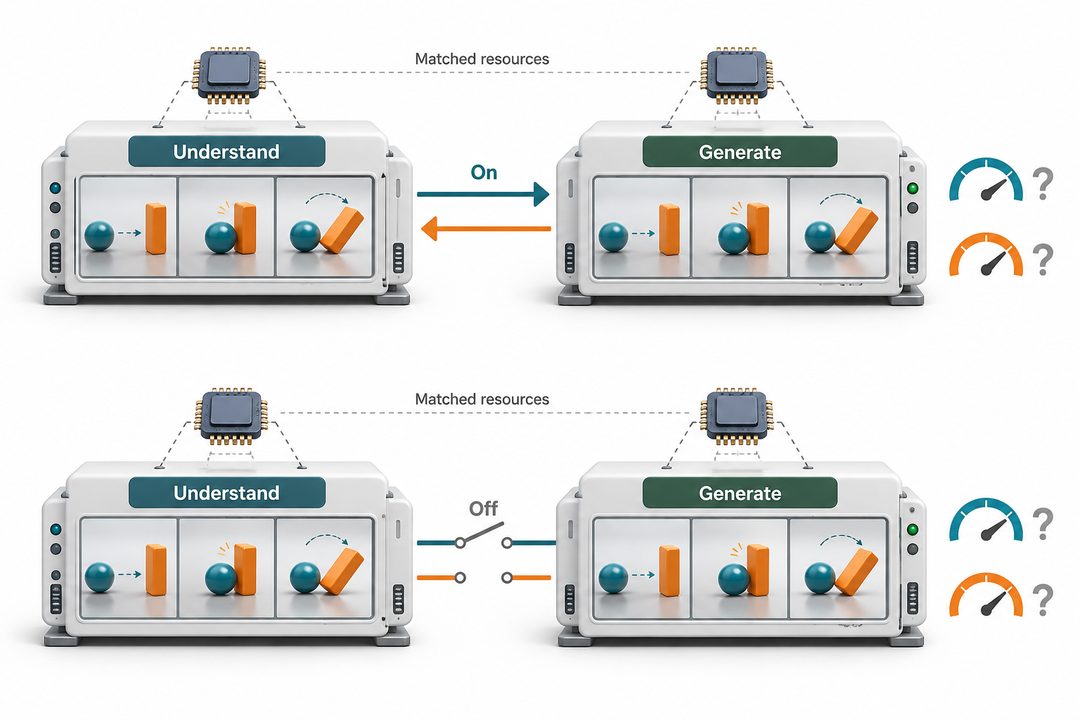
8.3 可测量的协同。开放问题是因果性的:增益来自信息共享,还是额外的数据、参数和监督?把每条迁移路径做成可独立关闭的组件,比较两套任务、数据、容量、算力都相同、只在跨向路径是否启用上不同的系统。往返协议要定义不变量,中间表示不得原样携带答案。
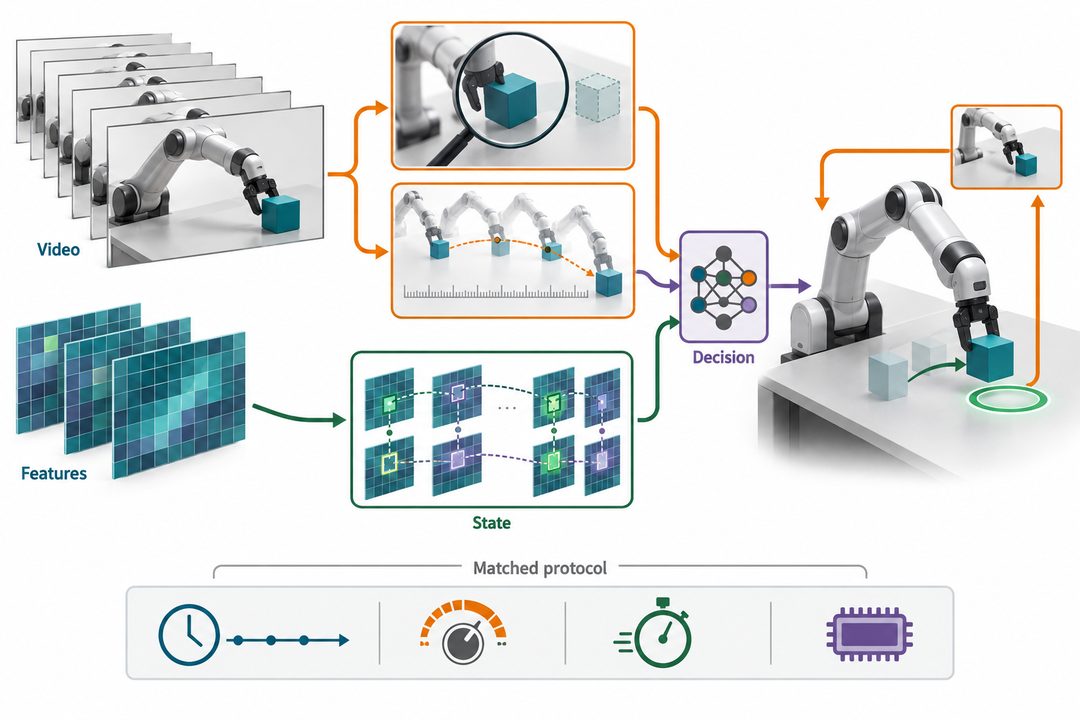
8.4 世界属性的标准化评测。两个预测器引导同一台机器人,一个输出视频、一个输出特征:视频可做视觉和轨迹检查,特征需要状态探针,两者都需要决策测试。报告标准应先把协议匹配到预测空间和转移接口,注明视界、动作频率、条件和裁判模型;实时声明需要控制到显示的延迟、持续吞吐和延迟方差。固定候选动作排序应与闭环成功率并列报告。
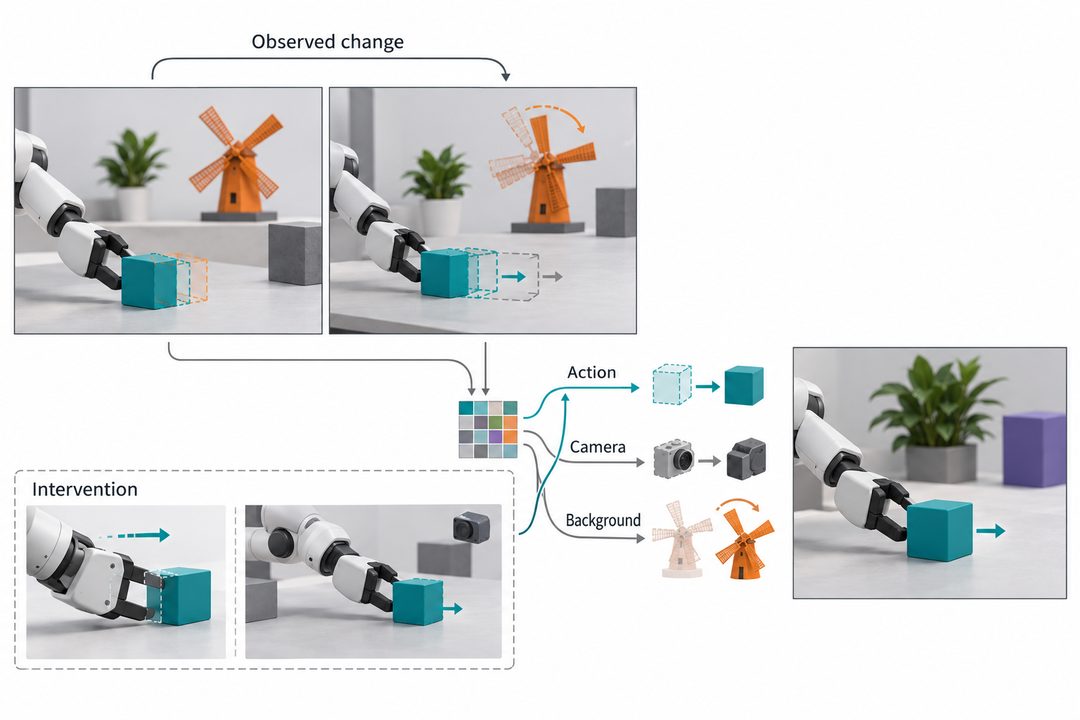
8.5 从无标注视频扩展控制。夹爪推动方块的同时相机在摇、风车在转,只有推动是主体的动作,而为重建而训练的潜码会一并吸收相机和背景运动。重建精度和码本利用率是控制的弱证据。少量标注锚定真实控制,多视角不变性分离相机运动,时间瓶颈丢弃与控制无关的细节,干预配对标记哪些变化属于主体。伪动作只有在受控环境或真机上产生预期效果时才有用。
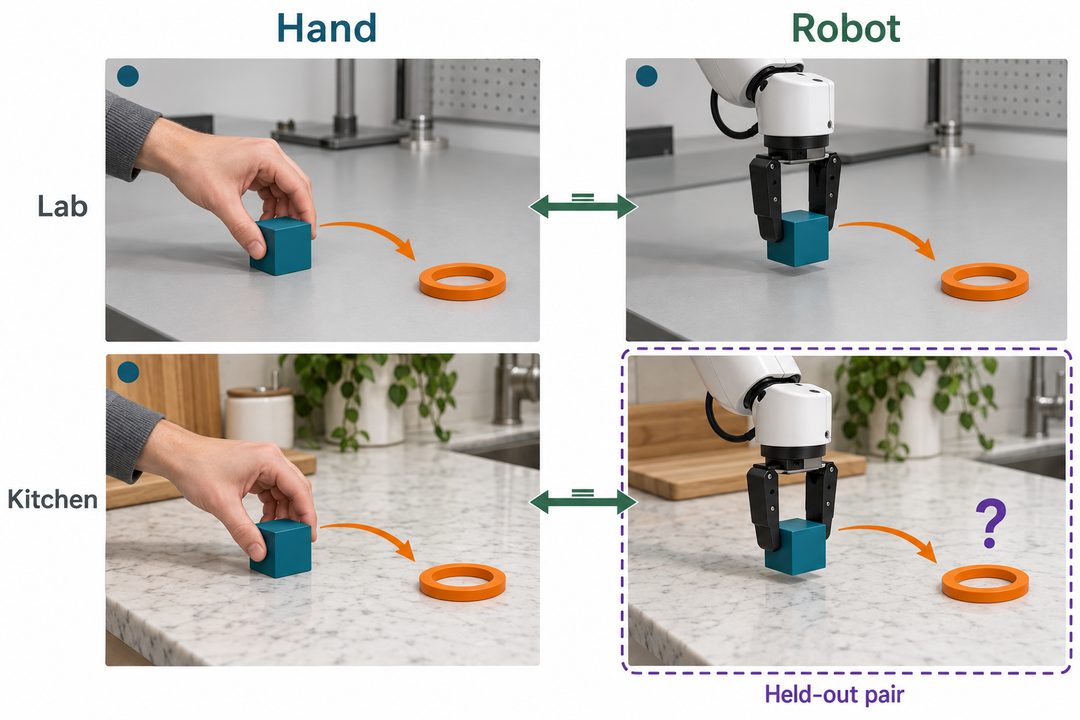
8.6 跨场景与跨具身泛化。新房间和新机器人不是同一种泛化。V-JEPA 2-AC 零样本迁移到新场景,但机器人类型在后训练中见过。方向是以物体位移、接触和任务完成等结果定义目标来训练效果保持的映射;评测交叉留出场景与身体组合,注明零样本、校准还是完全微调。
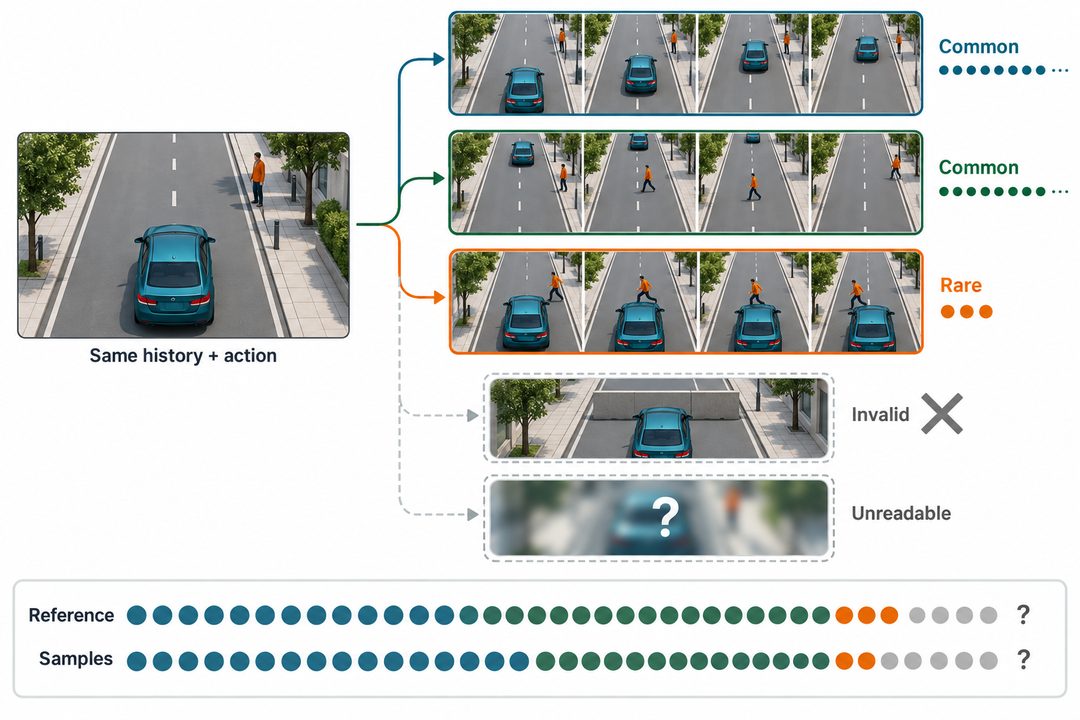
8.7 随机世界与罕见事件。同一历史和动作可能有多种有效未来。能按提示生成碰撞只提供一个案例,不代表知道真实的碰撞概率;多样性不能替代校准,best-of-many 评分隐藏错放的概率质量。方向是用经验事件率或合理的模拟器先验约束输出分布,在固定采样预算下报告恰当评分规则、校准曲线和模式覆盖,区分不可读与无效样本。
💡 扩展世界模型需要干预,而不只是更多片段。 观测规模告诉我们什么会共同出现;干预才告诉我们什么改变了什么。
9 Conclusion|结论
我们把视频视作潜在时序世界的观测痕迹,用读、写、共享、交互解释基础模型如何连接观测与表示状态。视频世界模型由它学到的转移定义——预测未来视频或视频衍生特征,以被动、固定动作序列或交互方式运行。时间连贯与世界一致的区分,把渲染质量和「模型追踪了画面背后的世界状态」的证据分开。
下一阶段需要更强的证据:能经受遮挡、重访和长程的状态;可控的动作效果;对干预的合法响应;闭环使用下满足控制预算的延迟;随机未来的覆盖与校准;统一模型中匹配的迁移证据;以及在受控环境或真实任务中改善决策。满足这些要求,领域才会从「渲染出令人信服的视频」走向「建模世界如何变化」。
本文转载自微信公众号「我爱计算机视觉」,查看原文。版权归原作者所有,如有侵权请联系删除。