ICLR 2026 | 除了卫星影像,人的移动还能告诉AI什么?
让你更懂AI的 2026-10-27 13:32 北京
城市AI不只看卫星
想象城市中两片建筑形态相近的区域:一片主要服务周边居民,另一片吸引来自城市各处的消费者。
卫星影像提供了建筑、道路和地表的信息,人们在不同地点留下的活动联系,则为理解两片区域的角色补充了另一类线索。
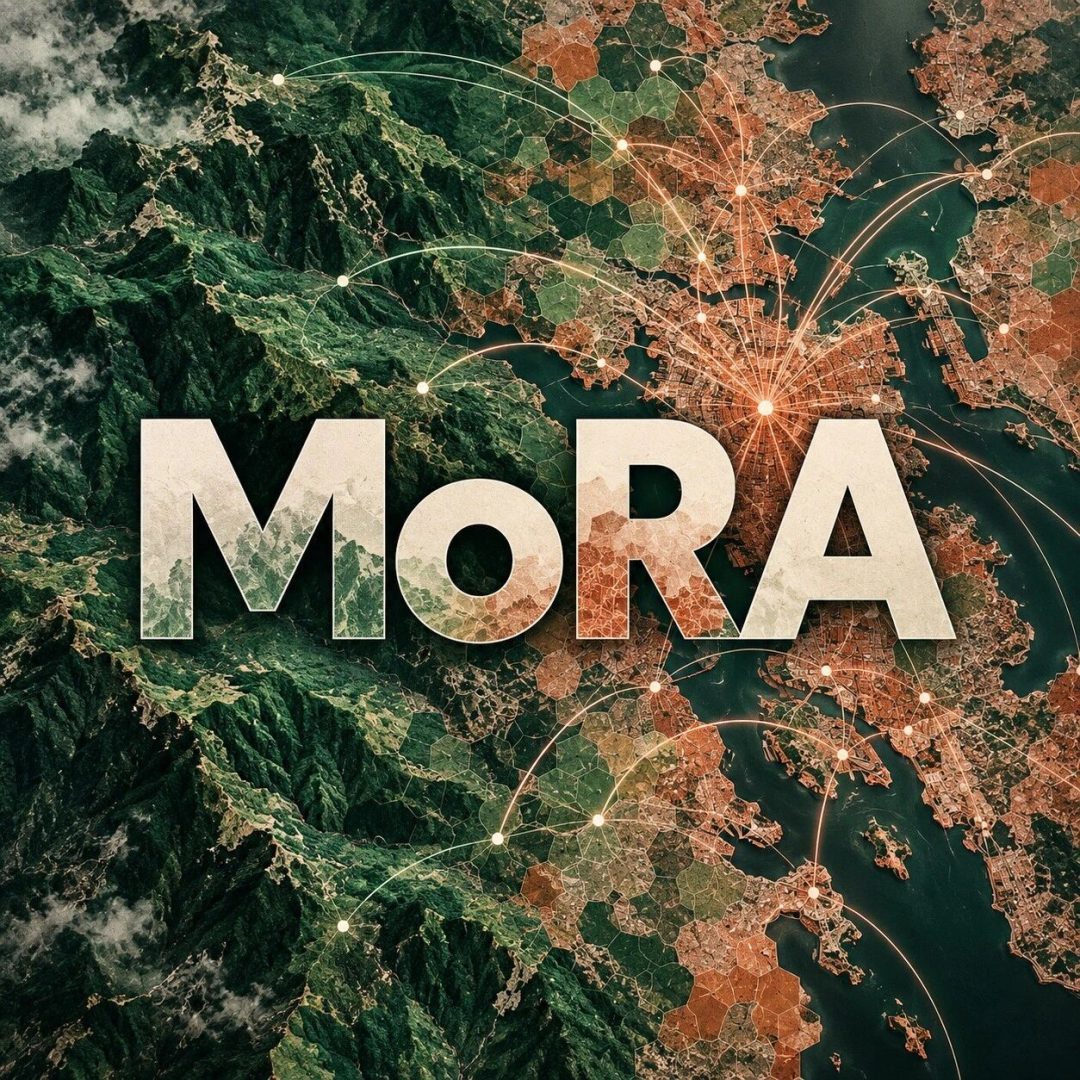
发表于 ICLR 2026 的 MoRA 围绕这一问题展开:能否把地点之间的人类活动联系,与兴趣点、卫星影像和人口统计信息结合,让模型更好地理解区域的社会经济特征?
论文的全国范围实验显示,MoRA 在九项任务中的八项取得了所比较方法中最高的平均 R²,同时保留了明确的数据覆盖与适用边界。
研究由来自香港大学、腾讯微信和香港城市大学的研究者合作完成,Ya Wen 与蔡纪烜(Jixuan Cai)为共同第一作者,Yulun Zhou 为通讯作者。
本文由共同第一作者蔡纪烜供稿,介绍论文的方法、主要发现与尚待验证的问题。
论文标题:
MoRA: Mobility as the Backbone for Geospatial Representation Learning at Scale
论文地址:
代码地址:
https://github.com/ylzhouchris/MoRA
让模型认识一个地方的联系
经纬度能告诉模型一个地方在哪里,却没有直接说明它在城市生活中扮演什么角色。
地理空间表示学习的目标,是为区域生成一组可复用的数字特征,供不同预测任务使用。MoRA 最终为每个区域生成一个 128 维向量。
地图上相邻的区域可能联系密切,相距较远的区域也可能共享活动人群。MoRA 采用移动网络组织这些关系,让模型从人类活动所连接的区域汇集信息,并与同一区域的其他数据对应起来。
这里的“移动”有具体的数据含义。研究将线下门店映射到 H3 网格,根据一周内不同网格间共享的交易活动联系建立网络,再汇总 54 周的数据,形成约 20 万个节点的图。
它反映的是交易活动可观测到的区域关联,不等同于逐次出行路线,也不能直接解释为覆盖所有人群的完整移动轨迹。主实验网格平均面积约 36 平方公里,因此分析对象是区域尺度的特征。
把移动网络与多模态信息对齐
方法分为三个主要步骤。
首先,用图嵌入方法 LINE 对移动网络进行预编码,再通过 LightGCN 图神经网络汇集相互关联区域的信息。
这样,一个区域的表示既包含自身信息,也受到与它相连的其他区域影响。
其次,分别编码辅助数据:兴趣点的名称和类别由 BGE-m3 文本模型处理,卫星影像由 RemoteCLIP 编码,人口统计信息由多层感知机处理。
研究使用了腾讯地图超过一亿个兴趣点,覆盖商店、企业和公共设施等场所。
最后,使用受 CLIP 启发的对比学习,把这些模态与移动表征对齐。
直观地说,同一区域的影像、设施和人口信息,应当与它在移动网络中的特征相对应;训练过程加强这些对应关系,从而得到可供后续任务使用的区域向量。
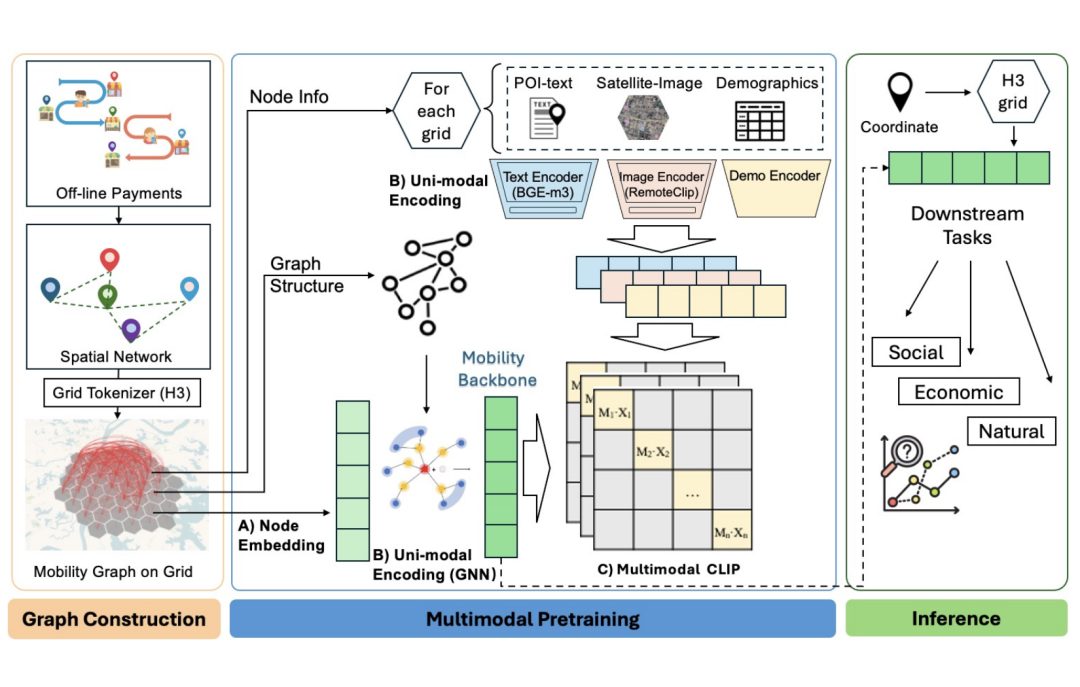
〓图1. MoRA的方法流程,来源于论文 Figure 1
九项预测任务给出了怎样的结果
论文评测了人口密度、平均受教育年限、老龄人口比例、人均住房面积、能源消耗和线下消费等九项社会经济任务。
模型先学习区域表示,再使用带标签的数据训练下游回归模型,因此这些结果并非无需任务训练的零样本预测。表 2 报告了十次重复训练的平均表现及标准差。
在全国范围比较中,MoRA 的平均 R² 在九项任务中的八项领先。R² 衡量回归模型对目标变量变化的解释程度,在相同评测设置下通常越高越好。
下表摘录了三项任务,其中夜间灯光是 MoRA 没有领先的例外。
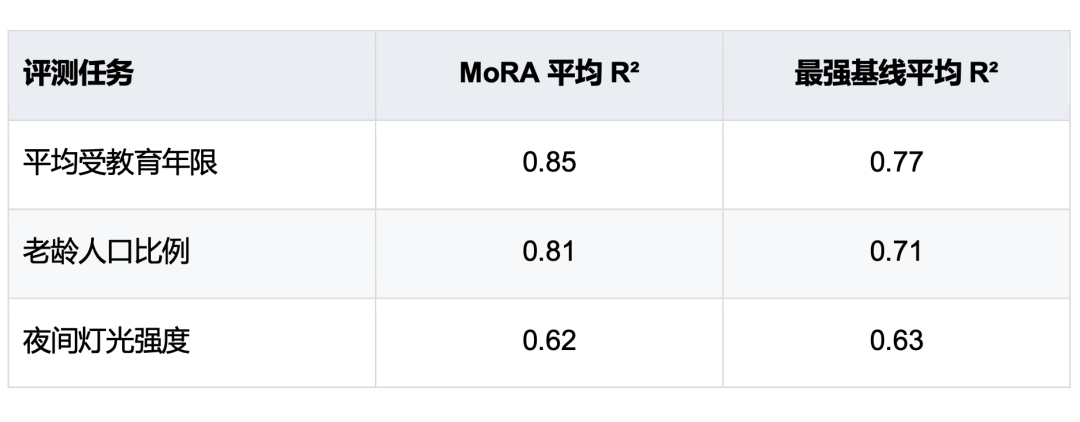
〓 数据摘自论文表2. 三项任务的最强基线均为AlphaEarth,数值按原表保留两位小数
论文报告的平均提升为 12.9%,指各任务相对于对应最强基线的 R² 相对变化的平均。它不是预测准确率提高 12.9 个百分点,各任务收益也并不相同。
主表中的方法使用了不同的数据来源,因此比较体现的是整套数据与方法组合的表现。
为了进一步检验移动关系的作用,研究团队进行了消融实验。把移动网络替换为只连接地理相邻网格的网络后,平均表现下降。
这支持了一个具体判断:在本研究的设置中,人的活动所建立的远距离联系,提供了地理邻近关系之外的有效信息。
扩大预训练范围有收益,也有边界
研究还比较了江苏、华东和全国三个预训练范围,并统一在江苏评测。
这三个范围都包含江苏。总体上,扩大预训练范围带来了收益,从江苏扩大到华东时尤为明显;继续扩大到全国后,平均收益减小,部分任务出现回落。
这一结果表明,研究一个区域可能受益于更广范围的活动联系。但三个嵌套地域的实验尚不足以建立普适的“地理空间标度律”,也没有直接验证模型在未见国家或城市中的零样本能力。
从研究结果到实际使用
项目提供了公开代码和蒸馏模型。蒸馏模型学习从经纬度近似生成 MoRA 的区域表示,调用时无需重新提供原来的四类数据,为其他研究者使用这些特征提供了便利。
不过,公开蒸馏版与完整模型在多项任务上表现不同,使用者需要根据自己的数据和目标重新验证,不能把完整模型的主表结果直接归到蒸馏版。
数据代表性也是应用中的关键问题。交易活动的覆盖受到平台、消费场景和参与人群的影响,不能自然代表所有居民。
人口和消费等评测任务与预训练输入之间还存在来源或统计内容上的关联,采用更独立的数据来源和更严格的跨地区测试,有助于进一步检验表征的适用范围。
论文描述了匿名化、网格聚合和模型蒸馏等措施,用于减少原始信息暴露。使用这些措施仍需结合具体流程与验证,不能据此作出对所有攻击都有效的隐私保证。
区域统计指标的预测表现,也不能用于推断具体个人的属性,或证明某种人类流动造成了社会经济差异。
MoRA 提供了一条把人类活动关系纳入地理空间表示的具体路径。
它让一个值得继续研究的问题变得可检验:当 AI 认识一个地方时,这个地方与其他地方的联系,能够补充多少仅靠本地属性难以获得的信息?
更多阅读
·
本文转载自微信公众号「PaperWeekly」,查看原文。版权归原作者所有,如有侵权请联系删除。