HAVING 只能配合 GROUP BY?这个SQL误区害了多少人……
dbaplus社群 2026-10-27 07:15 广东
集合论是 SQL 语言的根基,只有从集合的角度来思考,才能明白 SQL 的强大威力。
一、HAVING 回顾
关于 SQL 中的 HAVING,相信大家都不陌生,它往往与 GROUP BY 配合使用,为聚合操作指定条件,例如:
SELECT name, COUNT(*) FROM table GROUP BY name HAVING COUNT(*) > 2说到指定条件,我们最先想到的往往是 WHERE 子句,但 WHERE 子句只能指定行的条件,而不能指定组的条件。
集合论是 SQL 语言的根基,它里面有个阶的概念,我们必须掌握,具体可查看:神奇的 SQL 之层级 → 为什么 GROUP BY 之后不能直接引用原表中的列。
所以就有了 HAVING 子句,用来指定组的条件,我们来看案例。
现有学生班级表 tbl_student_class 以及数据:
CREATE TABLE tbl_student_class (id int(8) unsigned NOT NULL AUTO_INCREMENT COMMENT '自增主键',sno varchar(12) NOT NULL COMMENT '学号',cno varchar(5) NOT NULL COMMENT '班级号',cname varchar(50) NOT NULL COMMENT '班级名',PRIMARY KEY (id)) ENGINE=InnoDB DEFAULT CHARSET=utf8 COMMENT='学生班级表';-- ------------------------------ Records of tbl_student_class-- ----------------------------INSERT INTO tbl_student_class(sno, cno, cname) VALUES ('20190607001', '0607', '影视7班');INSERT INTO tbl_student_class(sno, cno, cname) VALUES ('20190607002', '0607', '影视7班');INSERT INTO tbl_student_class(sno, cno, cname) VALUES ('20190608003', '0608', '影视8班');INSERT INTO tbl_student_class(sno, cno, cname) VALUES ('20190608004', '0608', '影视8班');INSERT INTO tbl_student_class(sno, cno, cname) VALUES ('20190609005', '0609', '影视9班');INSERT INTO tbl_student_class(sno, cno, cname) VALUES ('20190609006', '0609', '影视9班');INSERT INTO tbl_student_class(sno, cno, cname) VALUES ('20190609007', '0609', '影视9班');
我们要查询学生人数等于3 的班级,这个SQL该如何写,相信大家都会,用 HAVING 很容易就实现了。
SELECT cno, COUNT(*) nums FROM tbl_student_class GROUP BY cno HAVING COUNT(*) = 3;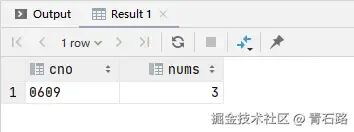
如果不使用 HAVING 子句,会是什么样的结果?我们来试试。
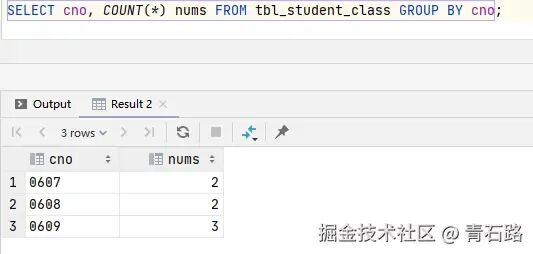
就是查询各个班的人数,能看出来吧?
所以我们可以总结下:
WHERE 先过滤出行,然后 GROUP BY 对过滤后的行进行分组,HAVING 再对组进行过滤,筛选出我们需要的组。
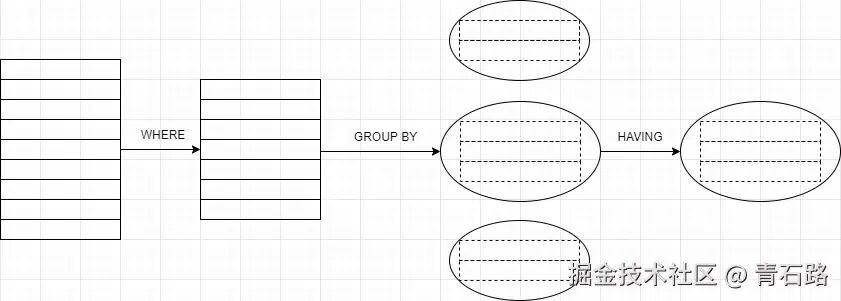
因为 HAVING 操作的对象是组,所以其子句构成要素有限制,只能是常数,聚合函数,聚合键。
聚合键: GROUP BY 子句中指定的列名,可以是一列,也可以是多列。
回到前面的案例 SQL,其中 HAVING COUNT(*) = 3,COUNT(*) 就是聚合函数,3 是常数,都在限制中;如果子句中有限制之外的条件,会是什么情况呢,我们来看个案例。
SELECT cno, COUNT(*) nums FROM tbl_student_class GROUP BY cno HAVING cname = '影视9班';执行报错,错误信息如下:
[Err] 1054 - Unknown column 'cname' in 'having clause'
翻译过来就是:不知道 having 子句中的 cname 列;因为 HAVING 操作的对象是组,而 cname 是 tbl_student_class 行记录的列名,而非组的属性,我们换个角度来理解下:GROUP BY 聚合后的结果(组)是 HAVING 子句的输入数据。我们回到案例,通过 cno 进行聚合后的结果如下:
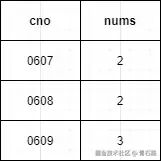
聚合后的这个结果并没有 cname 这个列,那么通过这个列来进行条件处理,肯定就报错了嘛。
如果你们细心点,就会发现:
HAVING 子句的构成要素和包含 GROUP BY 子句时的 SELECT 子句的构成要素是一样的,都是只能包含 常数 、 聚合函数和聚合键。
二、被忽视的魅力
HAVING 子句是 SQL 里一个非常重要的功能,是理解 SQL 面向集合这一本质的关键,我们结合几个具体的案例,来感受下 HAVING 那些被忽略的魅力。
1、是否存在缺失的编号
tbl_student_class 表中记录的 id 是连续的(id 的起始值不一定是 1),我们去掉其中 3 条。
DELETE FROM tbl_student_class WHERE id IN(2,5,6);此时表中数据如下:
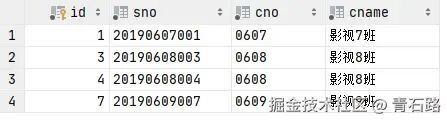
问:是否有编号缺失?
SQL 该如何实现,你们想想,我提供一种:
SELECT '存在缺失的编号' AS gapFROM tbl_student_classHAVING COUNT(*) <> MAX(id) - MIN(id) + 1;
上述 SQL 语句里没有 GROUP BY 子句,此时整张表会被聚合为一组,这种情况下 HAVING 子句也是可以使用的。
HAVING 不是一定要和 GROUP BY 一起使用。
更严谨的写法如下:
-- 无论如何都有结果返回SELECT CASE WHEN COUNT(*) = 0 THEN '表为空'WHEN COUNT(*) <> MAX(id) - MIN(id) + 1 THEN '存在缺失的编号'ELSE '连续' END AS gapFROM tbl_student_class;
延伸下问题:如果有编号缺失,如何找到那些缺失的编号?欢迎评论区留言。
2、众数
有一张表: tbl_student_salary,记录着毕业生首份工作的年薪。
CREATE TABLE tbl_student_salary (id int(8) unsigned NOT NULL AUTO_INCREMENT COMMENT '自增主键',name varchar(5) NOT NULL COMMENT '姓名',salary DECIMAL(15,2) NOT NULL COMMENT '年薪, 单位元',PRIMARY KEY (id)) ENGINE=InnoDB DEFAULT CHARSET=utf8 COMMENT='毕业生年薪标';insert into tbl_student_salary values (1,'李小龙', 1000000);insert into tbl_student_salary values (2,'李四', 50000);insert into tbl_student_salary values (3,'王五', 50000);insert into tbl_student_salary values (4,'赵六', 50000);insert into tbl_student_salary values (5,'张三', 70000);insert into tbl_student_salary values (6,'张一三', 70000);insert into tbl_student_salary values (7,'张二三', 70000);insert into tbl_student_salary values (8,'张三三', 60000);insert into tbl_student_salary values (9,'张三四', 40000);insert into tbl_student_salary values (10,'张三丰', 30000);
如果光从平均工资(149000)来看,感觉毕业生都能拿到很高的工资。但这个平均工资背后却有一些玄机,因为功夫大师李小龙在这一届毕业生中,由于他出众的薪资,将大家的平均薪资拉升了一大截。
简单地求平均值有一个缺点,那就是很容易受到离群值(outlier)的影响,这种时候就必须使用更能准确反映出群体趋势的指标,众数(mode)就是其中之一;那么如何用 SQL 来求众数了,请看我表演。
-- 使用谓词 ALL 求众数SELECT salary, COUNT(*) AS cntFROM tbl_student_salaryGROUP BY salaryHAVING COUNT(*) >= ALL (SELECT COUNT(*)FROM tbl_student_salaryGROUP BY salary);
执行结果如下:
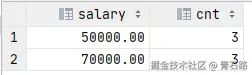
ALL 谓词用于 NULL 或空集时会出现问题,我们可以用极值函数来代替;这里要求的是元素数最多的集合,因此可以用 MAX 函数。
-- 使用极值函数求众数SELECT salary, COUNT(*) AS cntFROM tbl_student_salaryGROUP BY salaryHAVING COUNT(*) >= (SELECT MAX(cnt)FROM (SELECT COUNT(*) AS cntFROM tbl_student_salaryGROUP BY salary) TMP) ;
是不是触及到你们的知识盲区了?但你们先别慌,因为后面会让你们更慌。
3、中位数
当平均值不可信时,与众数一样经常被用到的另一个指标是中位数(median),它指的是将集合中的元素按升序排列后恰好位于正中间的元素。如果集合的元素个数为偶数,则取中间两个元素的平均值作为中位数。
回到表 tbl_student_salary,共有 10 条记录,那么 张三三, 60000 和 李四, 50000 的平均值 55000 就是中位数。
那么问题来了,通过 SQL 如何求中位数?实现也不复杂,将集合里的元素按照大小分为上半部分和下半部分两个子集,同时让这 2 个子集共同拥有集合正中间的元素,这样,共同部分的元素的平均值就是中位数,思路如下图所示:
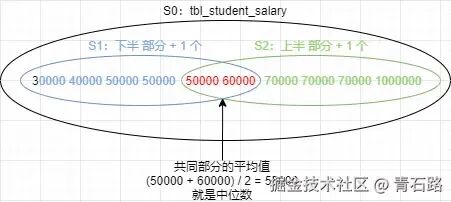
像这样需要根据大小关系生成子集时,就轮到 非等值自连接出场了:
-
- 求中位数的SQL 语句:在HAVING 子句中使用非等值自连接SELECT AVG(DISTINCT salary)FROM (SELECT T1.salaryFROM tbl_student_salary T1, tbl_student_salary T2GROUP BY T1.salary-- S1 的条件HAVING SUM(CASE WHEN T2.salary >= T1.salary THEN 1 ELSE 0 END) >= COUNT(*) / 2-- S2 的条件AND SUM(CASE WHEN T2.salary <= T1.salary THEN 1 ELSE 0 END) >= COUNT(*) / 2) TMP;
这条 SQL 语句的要点在于比较条件 >= COUNT(*)/2 里的等号,加上等号并不是为了清晰地分开子集 S1 和 S2,而是为了让这 2 个子集拥有共同部分;如果去掉等号,将条件改成 > COUNT(*)/2 ,那么当元素个数为偶数时,S1 和 S2 就没有共同的元素了,也就无法求出中位数了;加上等号是为了写出通用性更高的 SQL。
是不是满头大汗了?但别慌,把 SQL 拆开执行,根据结果来反推每个拆分 SQL 的逻辑含义,慢慢的你们就能理解了。
4、不包含 NULL 的集合
假设我们有一张学生报告提交记录表:tbl_student_submit_log:
CREATE TABLE tbl_student_submit_log (id int(8) unsigned NOT NULL AUTO_INCREMENT COMMENT '自增主键',sno varchar(12) NOT NULL COMMENT '学号',dept varchar(50) NOT NULL COMMENT '学院',submit_date DATE COMMENT '提交日期',PRIMARY KEY (id)) ENGINE=InnoDB DEFAULT CHARSET=utf8 COMMENT='学生报告提交记录表';insert into tbl_student_submit_log values(1,'20200607001', '理学院', '2020-12-12'),(2,'20200607002', '理学院', '2020-12-13'),(3,'20200608001', '文学院', null),(4,'20200608002', '文学院', '2020-12-22'),(5,'20200608003', '文学院', '2020-12-22'),(6,'20200612001', '工学院', null),(7,'20200617001', '经济学院', '2020-12-23');
学生提交报告后, submit_date 列会被写入日期,而提交之前是 NULL。
问:从这张表里找出哪些学院的学生全部都提交了报告,SQL 该怎么写?
如果只是用 WHERE submit_date IS NOT NULL 条件进行查询,那文学院也会被包含进来,结果就不正确了,正确的做法应该先以 dept 进行分组,然后对组进行条件的过滤,SQL 如下:
SELECT deptFROM tbl_student_submit_logGROUP BY deptHAVING COUNT(*) = COUNT(submit_date);
这里其实用到了 COUNT 函数,COUNT(*) 可以用于 NULL ,而 COUNT(列名) 与其他聚合函数一样,要先排除掉 NULL 的行再进行统计。
当然,更通用的实现是使用 CASE 表达式:
SELECT deptFROM tbl_student_submit_logGROUP BY deptHAVING COUNT(*) = SUM(CASE WHEN submit_date IS NOT NULL THEN 1ELSE 0 END);
三、聚合键条件归属
我们来看个有趣的东西,还是用表:tbl_student_class:
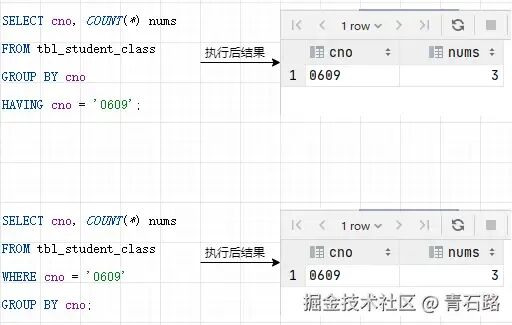
我们发现,聚合键所对应的条件既可以写在 HAVING 子句当中,也可以写在 WHERE 子句当中,虽然条件分别写在 HAVING 子句和 WHERE 子句当中,但是条件的内容,以及返回的结果都完全相同,因此,很多小伙伴就会觉得两种书写方式都没问题,单从结果来看,确实没问题,但其中有一种属于偏离了 SQL 规范的非正规用法,推荐做法是: 聚合键所对应的条件应该书写在 WHERE 子句中 ,理由有二:
1、语义更清晰
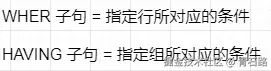
WHERE 子句和 HAVING 子句的作用是不同的;前面已经说过,HAVING 子句是用来指定 组 的条件的,而 行 所对应的条件应该写在 WHERE 子句中,这样一来,写出来的 SQL 语句不但可以分清两者各自的功能,而且理解起来也更容易。
2、执行速度更快
使用 COUNT 等函数对表中数据进行聚合操作时,DBMS 内部进行排序处理,而排序处理会大大增加机器的负担,从而降低处理速度;因此,尽可能减少排序的行数,可以提高处理速度;通过 WHERE 子句指定条件时,由于排序之前就对数据进行了过滤,那么就减少了聚合操作时的需要排序的记录数量;而 HAVING 子句是在排序之后才对数据进行分组的,与在 WHERE 子句中指定条件比起来,需要排序的数量就会多得多。
另外,索引是 WHERE 根据速度优势的另一个有利支持,在 WHERE 子句指定条件所对应的列上创建索引,可以大大提高 WHERE 子句的处理速度。
四、总结
1、SQL 的本质是集合论
集合论是 SQL 语言的根基,只有从集合的角度来思考,才能明白 SQL 的强大威力;学习 HAVING 子句的用法是帮助我们顺利地忘掉面向过程语言的思考方式并理解 SQL 面向集合特性的最为有效的方法。
2、HAVING 子句的三要素
常数、聚合函数和聚合键。
3、HAVING 与 WHERE
WHERE 子句是指定行所对应的条件,而 HAVING 子句是指定组所对应的条件;能放到 WHERE 子句的条件统统放到 WHERE 子句中,这样能够减少需要分组的记录数,从而提高分组后操作的效率。

本文转载自微信公众号「dbaplus社群」,查看原文。版权归原作者所有,如有侵权请联系删除。