集智百科:递归定理|张江
原创 集智百科团队 2026-10-28 14:30 日本
Stephen Cole Kleene提出的递归函数论,即可计算性理论中的一组基本定理
导语
“集智百科精选”是一个长期专栏,持续为大家推送复杂性科学相关的基本概念和资源信息。作为集智俱乐部的开源科学项目,集智百科希望打造复杂性科学领域最全面的百科全书,欢迎对复杂性科学感兴趣、热爱知识整理和分享的朋友加入,文末可以扫码报名加入百科志愿者!
↑↑↑扫码直达百科词条

张江 | 作者
作者简介
目录
1. 总览:两个定理各说了什么
2. 预备知识:读懂本词条所需的全部概念
2.1 “可计算”与“部分函数”
2.2 通用程序(解释器)
2.3 s-m-n 定理(柯里化 / 参数特化)
2.4 递归可枚举集(r.e. set)
2.5 “不动点”的两种含义
3. 历史背景
3.1 起源:一篇研究"序数记号"的 6 页短文
3.2 命名史
3.3 一个值得铭记的教训
4. 第一递归定理(FRT)
4.1 从“递归定义的函数”说起
4.2 定理表述
4.3 意义:递归定义的"存在性定理"
4.4 与第二递归定理的关系
5. 第二递归定理(SRT)
5.1 三种等价表述
5.2 证明
5.2.1 一行对角线
5.2.2 列表法(Cutland 1980):把"对角线"画成一张表
5.3 直观图景:程序如何"谈论"自己的代码
5.4 其它形式的第二递归定理
5.4.1 Uniform 形式
5.4.2 Smullyan双递归定理
5.4.3 算子递归定理(ORT)
5.5 推论:SRT 衍生出的若干重要结果
5.5.1 Rogers 同构定理(1958)
5.5.2 Arslanov 完全性判据(1981)
5.6 与其它不动点定理的关系
5.6.1 Gödel 不动点引理(对角引理)
5.6.2 Lawvere不动点定理
5.6.2.1 定理陈述
5.6.2.2 直观解释
5.6.2.3 与SRT的对应
5.6.3 与Y组合子的关系
5.7 SRT与自指
5.7.1 康托尔对角线论证(1891)
5.7.2 罗素悖论(1901)
5.7.3 图灵停机问题(1936)
5.7.4 哥德尔不完备定理(1931)
5.7.5 冯诺伊曼的自复制自动机(1948)
5.7.6 Quine(自打印程序)
5.7.7 自省程序与自省式自改进程序
5.7.8 统一性总结
5.8 SRT的其它应用
5.8.1 通用序数记号系统ω_1^CK
5.8.2 构造序数 = 递归序数
5.8.3 超算术层级与 Spector 唯一性定理
5.8.4 超算术集与有效描述集合论
5.8.5 r.e. 索引集理论:Rice、Rice-Shapiro 与 Myhill
5.8.5.1 Rice定理(1951)
5.8.5.2 Myhill定理:创造集 = 完备集
5.8.6 有效运算的连续性:Myhill–Shepherdson 与 KLS–Čeĭnin 定理
5.8.7 Solovay 可证性逻辑
5.8.8 应用地图一览
5.9 其它扩展研究
5.9.1 SRT 与计算复杂性理论
5.9.2 存在性与可构造性的分野
5.9.3 KRT 可以被分级
6. 评注与影响
递归定理(recursion theorem)是递归函数论,即可计算性理论(computability theory)中的一组基本定理,由Stephen Cole Kleene提出,合称 Kleene 递归定理,包括两条:第一递归定理: 任何用递归方式定义的函数方程都有可计算的(最小)解——机械式的递归定义永远合法、永远有解;第二递归定理: 对任何可计算的全函数
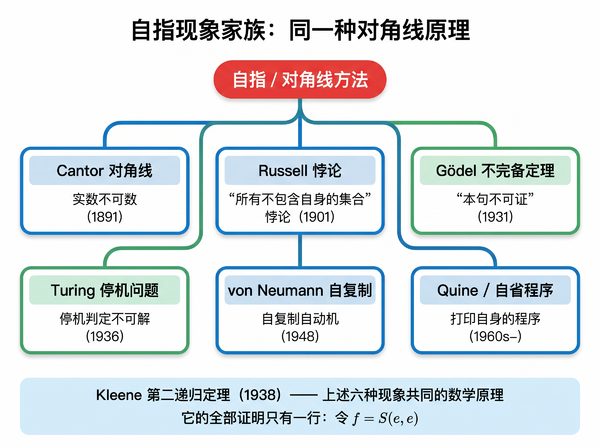
图1:六个经典自指现象——康托尔对角线(1891)、罗素悖论(1901)、哥德尔不完备定理(1931)、图灵停机问题(1936)、冯诺伊曼自复制(1948)、Quine(自打印程序,1960s)和自省程序(以及自省式自修改程序,2026)——都源于同一种对角线/自指原理;Kleene 第二递归定理是这一原理最一般的陈述。
第二递归定理可以用公式表达为:
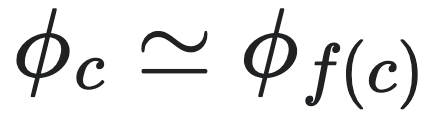
这里的
1. 总览:两个定理各说了什么
1. 总览:两个定理各说了什么
Kleene 递归定理是关于自指(self-reference,即一个系统"谈论"自身)不动点(fixed point,即变换后保持不变的点)两个基本定理的合称。先用日常语言各说一遍,再给出精确表述。
第一递归定理(日常语言版):任何递归定义的函数——即把一个函数在某处的值,写成它自己在其他输入上的值(比如阶乘
第二递归定理(日常语言版):对任何可计算的全函数
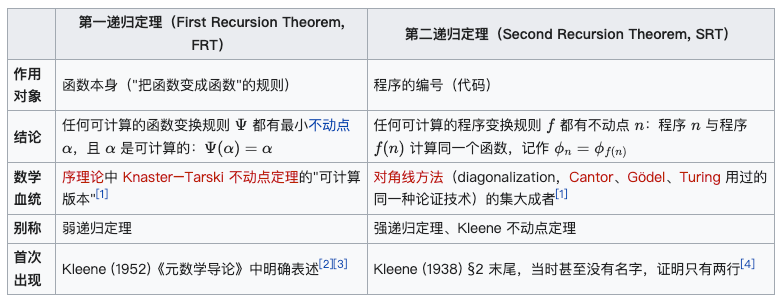
两个定理的对照表(其中涉及的符号会在下一节逐一解释,此处可先跳过细节):
第二递归定理被 Moschovakis 称为 "令人惊叹的"(amazing)定理——他的综述标题就叫 Kleene's Amazing Second Recursion Theorem[3];计算机科学家 Neil Jones 称之"可计算性的瑞士军刀"(A Swiss Pocket Knife for Computability)〔转引自 Kiselyov[5], §1〕。它的一行证明看似只是个小技巧,却支撑了从 哥德尔不完备定理到序数理论、从程序自复制到有效描述集合论的庞大理论大厦(详见第5)。
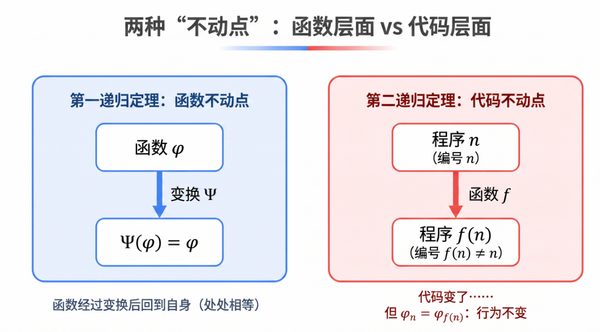
图2:两个定理的"不动点"含义截然不同——左:函数
2. 预备知识:读懂本词条所需的全部概念
2. 预备知识:读懂本词条所需的全部概念
本节用程序员熟悉的语言解释文中会反复出现的五个概念。已经熟悉的读者可以跳过。
2.1 “可计算”与“部分函数”
可计算的(computable / effective / recursive):一个函数是"可计算的",意思是存在一套固定的、有穷的指令(程序),使得对任何输入,只要机械地按指令执行有穷多步,就能得到输出。"可计算的"(computable)、"有效的"(effective)、"递归的"(recursive)在本文中是同义词——这是历史造成的术语冗余,三个词来自 Church、Turing、Gödel–Kleene 三条等价的技术路线[4]。
部分函数(partial function):一台机器在某些输入上可能永远不停机(死循环),这时它在这些输入上没有输出。我们把"在部分输入上有定义、在其余输入上无定义"的函数称为部分函数;在所有输入上都有定义的称为全函数(total function)。程序天然对应部分函数,而不是数学课本里那种"处处有值"的函数——这是可计算性理论与普通数学的第一个思维差异。
记号
2.2 通用程序(解释器)
存在一台"通用机器":给它输入
2.3 s-m-n 定理(柯里化 / 参数特化)
s-m-n 定理说:给定一个双输入程序和它的第一个输入,可以机械地生成一个"把第一个输入写死在程序里"的新单输入程序。用程序员的话说,就是柯里化(currying)或部分应用(partial application)总是可以机械完成的:存在可计算的全函数
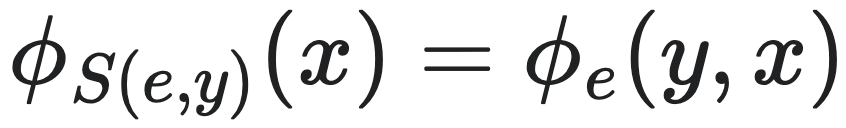
即"程序
2.4 递归可枚举集(r.e. set)
一个自然数集合称为递归可枚举的(recursively enumerable, 简写为r.e.),如果存在一台机器能把它的元素一个一个地全部列出来(允许重复、允许乱序;不在集合里的元素永远不会被列出)。等价地,r.e. 集就是某个程序有定义的输入的集合(即
2.5 “不动点”的两种含义
"不动点"在本文中出现于两个截然不同的层面,混淆它们是最常见的理解障碍:
函数层面的不动点(第一递归定理):变换规则
Ψ ϕ Ψ ( ϕ ) Ψ ( ϕ ) = ϕ ϕ Ψ f ( x ) = x
代码层面的不动点(第二递归定理):变换规则
f n f ( n ) f ( n ) ≠ n f ( n ) n ϕ n = ϕ f ( n )
3. 历史背景
3. 历史背景
3.1 起源:一篇研究“序数记号”的 6 页短文
第二递归定理诞生于 Kleene 1938 年发表于《符号逻辑杂志》(The Journal of Symbolic Logic)的一篇仅 6 页的短文《论序数的记号》(On Notation for Ordinal Numbers)[4]。这篇论文的主题表面上与"递归定理"毫不相干:
背景知识——序数(ordinal number):序数是"无限队列的长度"的数学化。数完 0, 1, 2, 3,
Church 与 Kleene 在 1930 年代问了一个构造性问题:能不能给每个可数序数起一个"机械可读的代号"(自然数编码),使得仅凭代号就能机械地判断:这个序数是 0、是某个序数的后继(+1)、还是某个递增序列的极限?并且在后两种情况下能机械地取出前驱代号或序列代号? 满足这些条件的编码方案称为一个序数记号系统(Kleene 称之为 r-system)[4]。
Kleene 在论文的 §2 中建立了可计算函数的基本技术(编号、通用函数、§2.3的S函数),然后在 §2 的最后顺手陈述并证明了一个当时没有名字的定理[4]:
若
ψ ( z , x ) f ϕ f ( x ) = ψ ( f , x ) x 证明:设 e 是函数
ψ ( S ( y , y ) , x ) f = S ( e , e )
——这就是第二递归定理的原始形态。Moschovakis说连Kleene自己都没有意识到,他发掘出的,是一颗珍贵的"小宝石"(little gem)[3];Kiselyov 则以"函数式珍珠(A Functional Pearl)"为题向函数式编程社区重新发掘了它[5]。
这颗"小宝石"随即在论文[4]的 §3 被用于证明该文的主要结果:存在一个"通用"序数记号系统 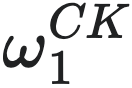 ,它是可数序数中第一个无法被任何机械记号系统触及的序数[4][1]。
3.2 命名史
Kleene 本人始终只叫它 "the recursion theorem"(递归定理)——即使在他 1952 年的《元数学导论》(Introduction to Metamathematics)中两个定理同时出现时,也未加区分[3]。
Rogers (1967)在其经典教材第 11 章首次建议:在两个定理同台的语境中,把关于"函数变换规则的不动点"的定理称为第一递归定理(Rogers 书中 Theorems XI、XII),把 Kleene 1938 的定理称为第二递归定理(Rogers 书中 Theorem IV,Second Recursion Theorem,后文简称SRT,)[1]。Moschovakis 明确表示支持:"在允许投票的场合,我投票采纳 Rogers 的命名"[3]。
有学生曾问 Kleene,这个"短得可疑、巧得离谱"的两行证明从何而来(指Kleene 第二递归定理的证明,见SRT的证明)?Kleene(也许是开玩笑地)回答说他只是"拿着 s-m-n 的性质瞎鼓捣"("fiddled around with (b)")就给出了这个证明[3]。Moschovakis 评论说,这种"鼓捣"很可能受到 lambda演算(Church 与 Kleene 此前共同发展的形式系统)中类似对角线构造的启发。
3.3 一个值得铭记的教训
1944 年,Kleene 曾错误地宣称他构造的记号集 O 具有较低的逻辑复杂度(属于 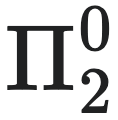 类,即由全称和存在量词构成的命题所定义的集合),因为他把第二递归定理给出的某一个不动点,误当作了归纳定义所要求的最小不动点。事实上 O 的复杂度要高得多(它是
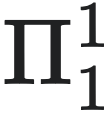 -完备),Kleene 直到 1955 年才纠正这个错误[3]。这个故事最生动地说明了:第二递归定理只保证"给你一个不动点",不保证给你"最小/最特殊的那个"——这正是它区别于第一递归定理的关键(见 4.4 与 5.8.6)。
4. 第一递归定理(FRT)
4. 第一递归定理(FRT)
4.1 从“递归定义的函数”说起
编程中最自然的定义方式是递归:定义阶乘时写 `fac(n) = n * fac(n-1)`,等号右边出现了正在定义的函数自己。抽象地看,这类定义都在解一个"函数方程":
α
其中
α
第一递归定理问的是:什么样的
4.2 定理表述
定义(可计算的变换规则):如果变换
1. 单调性:
2. 有限性/连续性:
直觉地说,第二条就是"机器在任何时刻只能查看有限多的已有计算结果"——这是"机械可执行"的数学化表达。阶乘、斐波那契数列、以及绝大多数程序语言中的递归定义都满足这两条[1]。
第一递归定理:设
1. Ψ
2. 最小性:任何其他解
3. 可计算性:
证明思路:从"处处无定义的空函数"出发,反复应用
例子:方程组
4.3 意义:递归定义的“存在性定理”
第一递归定理的角色,类似于分析学中用不动点定理(如 Banach压缩映射原理)证明微分方程解的存在性:它一劳永逸地保证"机械式递归定义必有可计算的解",从此定理出发定义递归函数时,我们无需逐个证明合法性。Rogers 指出,"递归定理"这个名字正来源于此——它是"解递归方程"的定理,类比集合论中沿序数递归定义函数的原理[1]。Kleene 本人甚至把第一递归定理视为支持 Church–Turing论题("可计算 = 递归/图灵可计算"这一哲学论题)的最强证据之一:它表明"可计算函数"这个类恰好封闭于最一般的机械递归定义方式之下,不多也不少[3]。
数学血统上,它是 Knaster–Tarski 不动点定理(序理论中"完备格上的单调映射必有不动点")在"可计算"约束下的有效化版本[1]。
4.4 与第二递归定理的关系
Rogers 证明了:第二递归定理(强)蕴含第一递归定理(弱)——存在统一的机械方法,把"函数层面的不动点问题"翻译成"代码层面的不动点问题",并且翻译后得到的不动点恰好是最小的[1]。反过来不成立:第五节中第二递归定理的应用几乎都无法由第一递归定理得到。因此两者中第二递归定理更基本、更强大[1]。
Moschovakis 还给出了一个统一形式:把"变换规则"同时允许依赖于"函数的编号"和"函数的值",所得不动点定理在两种极端情形下分别退化为第二递归定理(不依赖函数值)和第一递归定理(不依赖编号)[3]。
5. 第二递归定理(SRT)
5. 第二递归定理(SRT)
5.1 三种等价表述
表述 A(Kleene 原始形式,1938):对任意可计算的部分函数
ϕf(x)=ψ(f,x) (表述A)
即:存在一个程序
表述 B(Rogers 不动点形式,1967):对任意可计算的全函数
ϕn≃ϕf(n) (表述B)
这里,符号
表述 C(带参数的强化形式):A、B 只断言不动点"存在",表述C 进一步保证:不动点能被程序机械地找出来,并且能随参数连续变化。设想变换规则额外带一个参数
ϕz(y)(x)=ψ(z(y),y,x)(表述C)
对所有
5.2 证明
这里列举两种本质上相同的证明方法。
5.2.1 一行对角线
以表述A 为例,全部证明如下:
首先,根据s-m-n定理,对于任意的编号为
ϕ
其中,
其次,不难知道函数
ϕ
第一步是
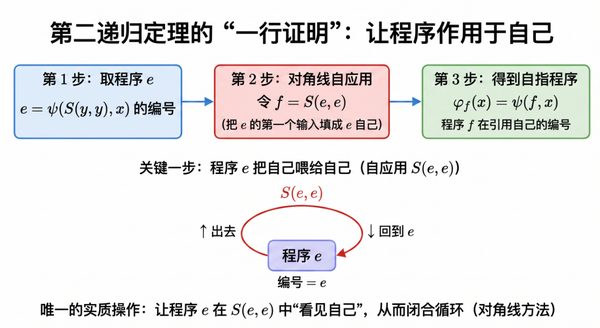
图3:第二递归定理证明的三步拆解与对角线自应用的视觉化——核心动作就是让程序
5.2.2 列表法(Cutland 1980):把"对角线"画成一张表
上面的一行证明把对角线方法压缩到了极致——好处是直接,坏处是看不出"对角线"长什么样。Cutland 在《Computability》[6] §2.3 (Theorem 2.3)中给出过一种更直观的列表法证明,用一张"行 = 枚举、列 = 位置"的二维表,把"对角线"和"沿对角线的循环"都画在纸面上。
这一方法分三步走。
1. 把"所有可计算函数的枚举"摆成一张表
按 §2.2,每个可计算部分函数都有一个编号;所有这种编号的全体记作

——双重编号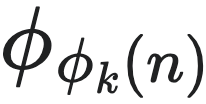 。把
2. 对角线枚举
D
把这张表沿主对角线的格子圈出来——它们正是
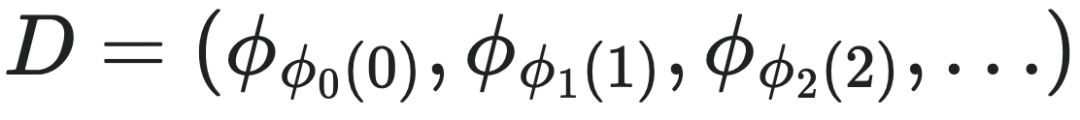
D 仍然是一个可计算的枚举:由

——因为 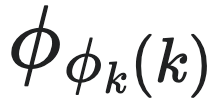 ,而
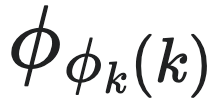 ,两者恰好对得上(图 6 右侧红字注释)。
3. 沿
D f f
设
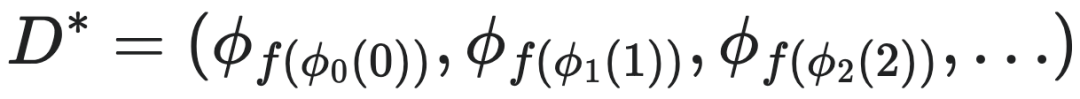
D
取 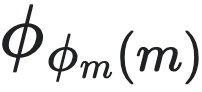 。而
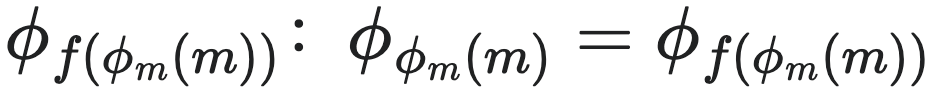
Cutland 用 Lemma 2.1 把"第
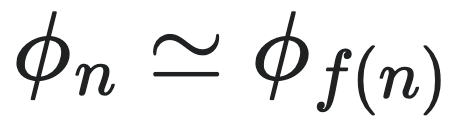
与"一行证明"的关系:§5.2.1 的证明把表上
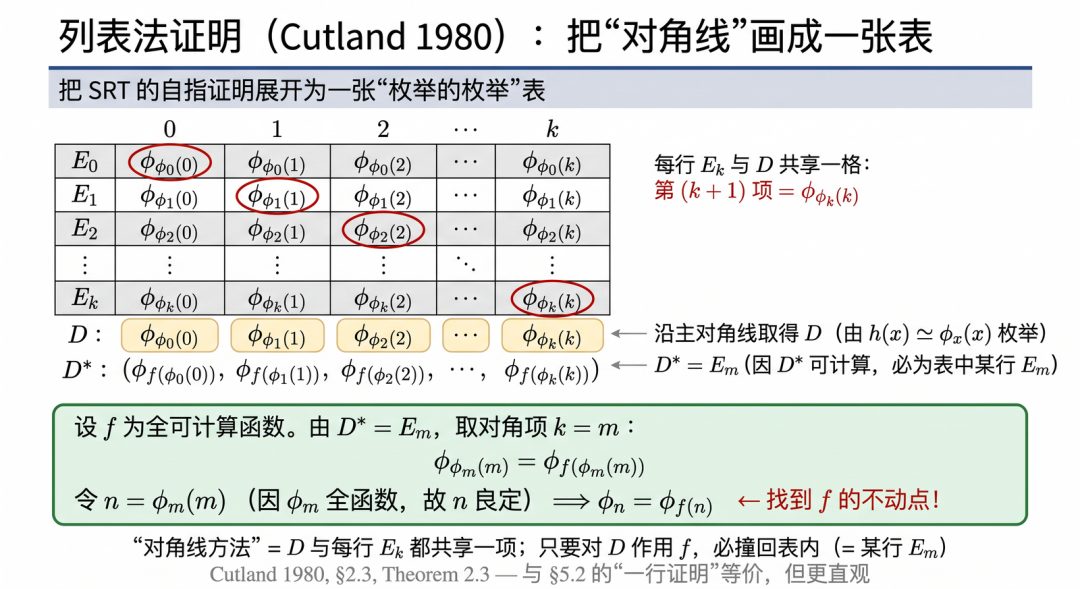
图6:Cutland (1980) 列表法证明的视觉化。上半:四行四列的"枚举之枚举"表 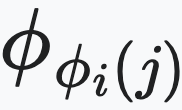 ;主对角线(红圈)上的格子构成对角枚举
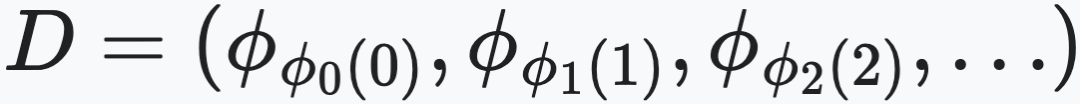 。
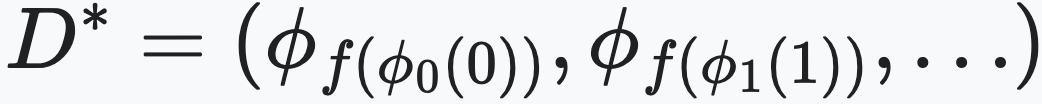 ——可计算
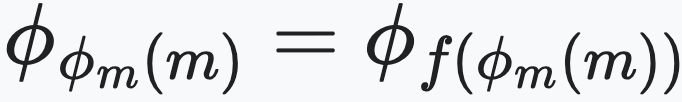
5.3 直观图景:程序如何"谈论"自己的代码
递归函数即可计算函数。然而,我们接触到的大部分程序都是使用字符串来编码,而并非使用自然数。这就使得初学者会对函数或程序的编码非常困惑,而第二递归定理(SRT)本身就是建立在两套编码对应的函数功能等价的基础之上的,因此造成很多的理解困惑。
实际上,一个递归函数,或可计算的图灵机程序,既可以被编码为自然数,又可以被编码为字符串,也就是源程序代码,二者本质上等价。要建立这种等价关系,我们只需要按照字典序为所有可能的字符串做自然数编码就可以了,于是任何一个字符串都对应了一个自然数,反之自然数也可以对应回字符串。这样,所有关于SRT的结论都自然能够平移到我们熟悉的以字符串对应函数编码的程序世界里。
程序世界里SRT的一个最简单的对应物就是Quine程序,即“打印自己源代码”的程序。
例 1(Quine,Python 版)〔示例取自 Wikipedia "Quine (computing)"[7];与 SRT 的关系见 Kiselyov[5], §2〕:所谓 quine 就是"打印出自己源代码的程序"。第二递归定理断言:这样的程序必然存在。下面这个 Python 程序就是教科书级的 quine——运行它,会原样打印出它自己的源码:

它的机制很简洁:字符串 `c` 本身是一个"打印模板"——`%r` 会带上引号打印出 c 自己的内容,`%%` 是格式化转义符(输出为单个 `%`)。于是 `print(c % c)` 打印出的结果,恰好就是这个程序的全部源码。程序把自己的源码当作数据、再把它打印出来——这正是第二递归定理"程序合法地引用自己的代码"在程序语言里的最小实现[7][5]。
把 Print 换成任意可计算操作 f:quine 是 SRT 在 f = Print 上的特例。上面那个 quine 里的 `print(c % c)` 可以立刻换成任意可计算操作。看下面这个程序——它不再"打印自己",而是"先把自己的源码施加一个变换 f、再打印结果"(这里 f = "给每一行加上行号"):
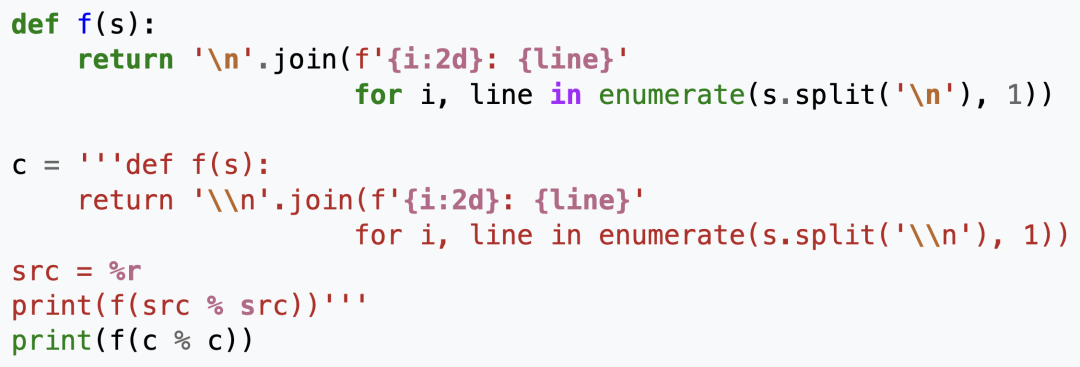
`c % c` 仍然是"自己的源码",但最后一行不再是 `print(c % c)`,而是 `print(f(src % src))`——也就是先调用 f 处理自己的源码、再打印结果。这个程序满足:c 的行为 = "对 c 的源码施加 f、再打印"的行为。
——用公式写就是
SRT 的证明,本身就是一个 Quine 构造——而且方向和 quine 完全相同。再回看 §5.2.1 那一行证明——给定
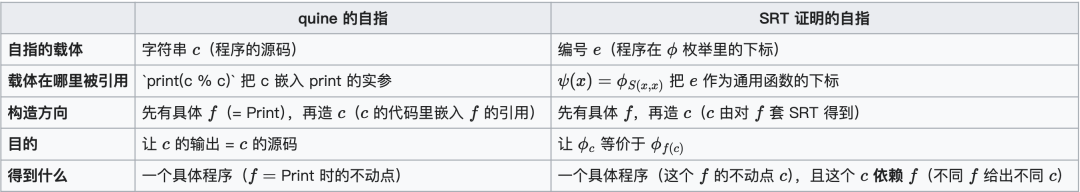
也就是说,SRT 证明与 quine 不是"互逆",而是同构——两者都是"先有一个具体的全可计算函数
例 2(自我命名的集合)[1]:是否存在程序
自指的机制(Rogers 的精辟分析)[1]:不动点程序
"the result of substituting 'the result of substituting "x" in "x"' in 'the result of substituting "x" in "x"'"(把 "把 x 代入 x 的结果" 代入 "把 x 代入 x 的结果" 所得到的结果)
——按规则展开后,这个短语恰好指称它自己[1][3]。
5.4 其它形式的第二递归定理
5.4.1 Uniform 形式
Uniform 不动点定理:存在一个全可计算函数
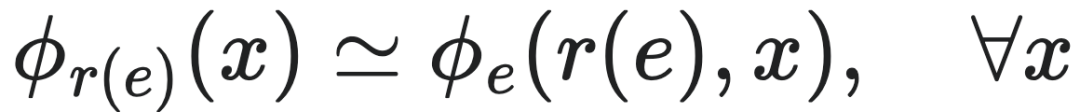
四个需要解释的点:
该定理的输入
e ψ ψ ψ y ψ r ϕ e ( · , · ) 为什么称该定理为Uniform的?数学中,一个性质或定理的表述可以看作是某一个参数的函数,就称为Uniform的(一致的)。第二递归定理的表述A显然是一种非Uniform的形式,因为它孤立地依赖于函数
ψ e 无条件的全称命题。注意陈述里没有“若
ϕ e e e ( r ( e ) , x ) r 该定理的证明如何构造?把 §5.2 展开版证明逐步查一遍——第 0 步用 s-m-n 造
a f = S ( e , e ) f e r
不难理解,表述B也可以改写为Uniform的形式:
存在全可计算函数
r n ϕ n
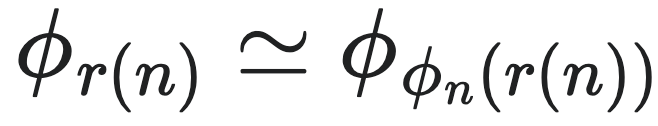
不难看出,这里的n就是表述B中的
5.4.2 Smullyan双递归定理
SRT 的联立推广:对任意两个可计算函数

——两个程序可以互相引用对方的代码,其中
由于这个Smullyan双递归定理是 SRT 的"二元推广",因此我们可直接由 SRT 的证明套用:
1. 根据带参数的 SRT 造"第二号程序":把"程序算 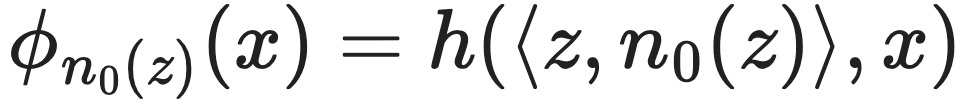 ;
2. 再由 s-m-n 造"第一号程序":令
3. 对
注意
该定理也可推广到 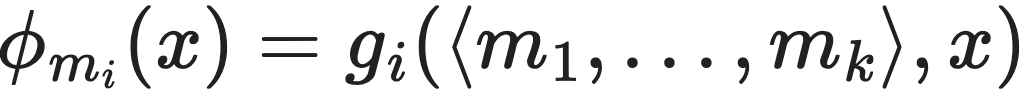 。
双递归定理是后续许多重要构造的核心:① §5.8.3 介绍的"两层超算术构造"里,Spector定理需要同时构造两个互相缠绕的函数;② Myhill-Shepherdson定理(§5.8.6 简述)描述"如何用 r.e. 集作为其它 r.e. 集的有效操作"时也需要联立不动点;③ 某些停机问题的"相对化"证明也走双递归路线[8][1].
另外,值得一提的是,这个双递归定理以及对应的n递归定理的推广形式,实际上可以看成是多个部分互相指涉,互相依赖的形式,由此自指构造可以走向分布式构造。
5.4.3 算子递归定理(ORT)
算子递归定理(operator recursion theorem,简称 ORT)是第二递归定理的"无穷化"推广,由Case在研究自复制自动机时提出[9]。它把自指的对象从一个程序升级为一整个可计算的程序族。
算子递归定理:设
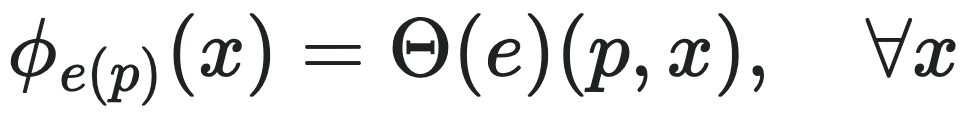
与第二递归定理(表述A)对比,有两处关键升级:
1. 从一个不动点到一个互引家族。
2. 直接工作在函数层而非源代码层。表述B 的对象是"程序变换"(对源代码的机械改写),而 ORT 的对象是可计算算子——它可以利用被作用函数的任何可计算信息,即便这个函数本身不可计算。这使 ORT 能表达"程序知道一个不可计算对象的可计算近似"这类构造。
ORT 可以由第二递归定理推出,因此二者在经典可计算性理论中等价;但 ORT 的表达形式在归纳推断(algorithmic learning theory,Gold 风格的可学习性理论)中远为顺手——从 Blum, L. 与Blum, M. 1975 年的奠基工作起[10],学习理论中需要自指构造的证明几乎都以 ORT 为标准引用形式[9][11]。Case 本人后来写了一篇教学性综述,用"程序先制造自身的静默副本再运行给定的使用方案"的意象讲解无穷自指的用法[11]。
5.5 推论:SRT 衍生出的若干重要结果
SRT 不是孤岛,但也不能把整片大陆都记在它名下。本节收录两条真正以 SRT 为证明枢纽的结果——它们的证明都必经 SRT,称"推论"名副其实:
Rogers 同构定理——SRT 的"编号独立性"推论:任意两个通用程序枚举之间必有保结构的可计算同构;
Arslanov 完全性判据——相对化 SRT 的"刻画性"等价定理:一个 r.e. 集何时是 r.e.-完备的。
5.5.1 Rogers 同构定理(1958)
任意两个通用程序枚举(即枚举出所有可计算函数的程序编号系统,详见 §2.2;下称 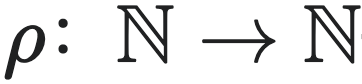 ——一部双向都可计算的"翻译词典",把
ϕ 等价:同一编号系统内,若两个程序
e 1 e 2 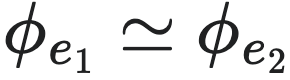 ,§2.1),就说它们 ϕ等价——编号只是程序的外衣,算出的函数才是实质。
保
ϕ e ϕ e ≃ ψ ρ ( e ) e ϕ ρ ( e ) ψ W 等价 / 保 W 等价:
W e e 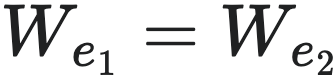 (接受的输入一模一样);保 W 等价指翻译也不破坏这层对应。由于词条约定
W e = dom ( ϕ e ) ϕ 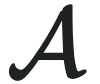 用的正是独立于
ϕ
直觉上:两个不同的程序编号系统乍看像不同的语言(一个把 quine 编号成 42,另一个编号成 100),但实质上说的是同一类对象;Rogers 定理说它们之间必有可计算的"翻译词典",且词典严格保结构。
证明思路:把"取
5.5.2 Arslanov 完全性判据(1981)
SRT 的相对化版本所给出的等价刻画:r.e. 集合
对每个 r.e. 集合
W f W W ≤ T C f W这里一下子出现了三个新名字,先逐个解释: r.e. 集合:见 §2.4。本词条统一用缩写 r.e.(recursively enumerable,递归可枚举)。
r.e.-完全:r.e. 集合这个"复杂度类别"里"最硬核"的一档——任何别的 r.e. 集合 W都能机械地归约到
C W x C Turing 归约 / W≤TC 通过 f
W:A能Turing 归约到B(记A≤TB),意思是"只要允许把B当神谕(oracle,下一条解释) A W ≤ T C f W f W x C
直觉上:Arslanov 判据说"装得下所有 r.e. 集合"等价于"对每个 r.e. 集合都有机械的相对化方式"——这和 SRT 中"对每个全可计算
Arslanov 判据在递归论里是教科书级工具:①用于证明 Gödel 不完备定理的算术陈述("PA不一致"这种陈述)的相对可计算性与停机问题同构;② 用于证明某些 r.e. 集"不可能被简化"[12][13] 。
5.6 与其它不动点定理的关系
SRT 衍生出许多重要推论(见 §5.5),但还有些定理与 SRT 的关系更微妙——它们与 SRT 同源(都基于对角线 / 自指),却走的是独立证明路线,或者处于更高层的范畴论概括下,或者是在lambda演算的框架下。这里集中讨论两个最重要的"不动点定理":Gödel 的不动点引理与 Lawvere 的范畴论的不动点定理,以及lambda演算中的Y组合子,重点说明 SRT 与它们的精确定位关系。
5.6.1 Gödel 不动点引理(对角引理)
对任何包含足够算术的递归可公理化理论
注:Gödel 不动点引理本身是 SRT 最干净、最纯粹的推论(既可以把 SRT 当证明工具来证它,也可以两边都用"自指 + 对角线"的同源手法独立证明)。它和 SRT 的关系是"同源、互为推论";但 Gödel 不完备定理 与 SRT 的关系则另当别论,见 §5.7.4 的"双重身份"分析。
5.6.2 Lawvere不动点定理
Lawvere不动点定理(也称为Lawvere对角线定理,1969年提出[14])是范畴论中统一刻画对角线自指与不动点现象的基础定理。它表明,只要一个笛卡尔闭范畴中存在对函数族的通用编码机制,那么输出对象上的所有自变换都必然存在不动点。
5.6.2.1 定理陈述
设
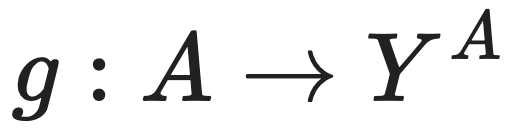
(即对每一个态射
t
其逆否命题等价于:若
5.6.2.2 直观解释
笛卡尔闭范畴的核心特征是函数空间本身可以作为范畴内的对象被处理,这使得“用论域元素给函数编码”的自指结构可以被形式化。 定理的核心洞察是:只要论域
5.6.2.3 与SRT的对应
第二递归定理(Second Recursion Theorem, SRT)是Lawvere不动点定理在部分递归函数范畴中的具体实现。二者的对应关系如下表所示:
Lawvere定理与SRT的对应
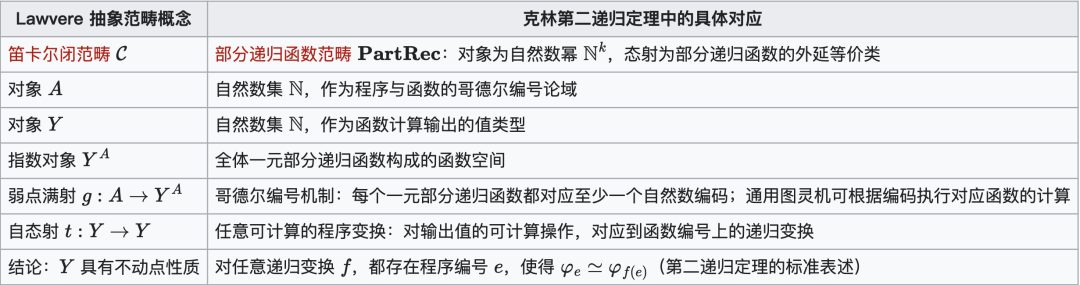
关系定性:
Lawvere 不动点定理不是 SRT 的"推论"(该定理没有反推 SRT,而是反过来把 SRT 概括出来);
Lawvere 也不仅是 SRT 的"更高层次表述"(它是数学基础层面的定理,把 SRT、Gödel 不动点引理、图灵停机问题的不可判定性、罗素悖论、康托尔对角线全部统一为这一个抽象结构的不同侧面);
因此应避免两种过度描述:①"Lawvere 推翻了 SRT 的独立性"(错,它们不在一个抽象层);②"SRT 是 Lawvere 的特例,所以 SRT 的定理就是 Lawvere 给出来的"(错,Lawvere 是更高层的解释,不是 SRT 证明的工具;SRT 证明仍然是 §5.2 的对角线论证)。
对读者的现实意义:如果你做的是程序语义、形式化验证、自指系统、AI反思架构等领域,理解 Lawvere 框架能让你看清为什么"自指"在这些领域无处不在——而不是递归论特有的怪癖。但若你只想用 SRT 构造自指程序做现实计算,§5.2 的对角线证明就是你所需要的——Lawvere 对那条一行的构造不增加任何可计算内容。
5.6.3 与Y组合子的关系
lambda演算(Church 1930 年代发明的、Lisp 等函数式语言的祖先)中有一个著名对象 Y 组合子:对任何函数
Kiselyov 在分阶段
这一视角澄清了 SRT 对计算机科学的意义:它陈述的是"任何合理的程序系统对自指构造封闭",是把高阶操作(程序变换)降阶到数据层面(编号)的不动点原理——部分求值(partial evaluation)、编译器自举(bootstrapping)、宏系统的理论基础。
5.7 SRT与自指
第二递归定理最直接、也最让人着迷的威力,是它一劳永逸地解释了"自指"现象为什么合法。但要先澄清一个容易混淆的关键点:这些里程碑可以从两个正交的维度来理解——
结论的性质:是"否定性"(证否某物不存在:Cantor、Russell、Turing、Gödel),还是"肯定性"(证实自指对象存在:自复制、quine、SRT 本身);
结论适用的领域:纯集合论(SRT不适用),还是程序 / 可计算世界(可以用SRT)。
两个维度交叉,得到下表:
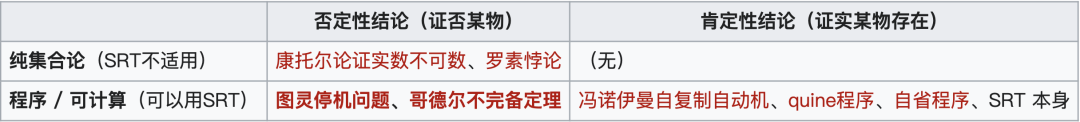
由此看清每个现象的双重身份:图灵停机问题、哥德尔不完备定理在"风格"上是否定性自指(与 康托尔不可数问题、罗素悖论同类),但它们活在程序世界,所以又能被 SRT 事后统一推出;康托尔不可数问题、罗素悖论位于纯集合论世界,SRT 造不出"实数"或"集合",只能算同源但独立。下面逐个讲清楚。
5.7.1 康托尔对角线论证(1891)
现象:实数集不可数。假设每个实数都被编号
与 SRT 的关系:同源,但独立。两者做了同一件事——取"第
5.7.2 罗素悖论(1901)
现象:考虑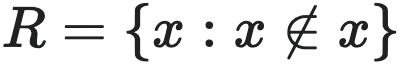 (所有"不属于自己"的集合组成的集合)。问
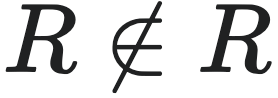 ;若
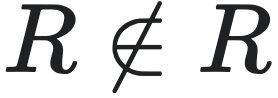 ,则按定义
与 SRT 的关系:同源,但独立。罗素悖论也是"把谓词'不属于自身'同时用于所有集合"的对角线操作,和 SRT 共享同一个技巧,但 SRT 同样推不出它——它是朴素集合论内部的问题,不涉及程序。真正值得注意的,是 Rogers 指出的一个类比:把"集合"换成"可枚举的集合 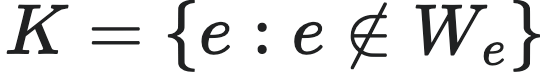 ——
5.7.3 图灵停机问题(1936)
现象:不存在算法
双重身份:停机不可判定在结论性质上是否定性的(证明"判定器不存在"),与康托尔、罗素问题同类;但因为它活在"程序"世界,又能被 SRT 推出。下面展示完整的"套用"过程——这是所有例子里最干净的一个,最能看清 SRT 到底在哪里发力。
套用 SRT 造否定性自指程序的完整演示:
1. 假设存在判定器
2. 写出"想要的行为",把"自己"写成参数
关键就在第 3 步:
4.7.4 哥德尔不完备定理(1931)
哥德尔不完备定理(简称哥德尔定理)指出:任何"足够强"的一致可公理化理论
术语解读:皮亚诺算术(PA)与 罗宾孙算术(Q):
PA是 Peano 算术(Peano Arithmetic)的缩写,是一阶算术的标准公理系统,用于形式化刻画自然数(0,1,2,…)及其加法、乘法。它由意大利数学家皮亚诺(G. Peano(1889))的公理发展而来,包含:①常元 0;②后继运算
Q(罗宾孙算术)是皮亚诺算术的一个弱化:保留①—③、去掉归纳公理模式,只留极有限的几条公理,是"足以推出不完备定理的最弱理论"之一(后文 Myhill定理即用它)。
与SRT的关系:与停机问题一样,哥德尔不完备定理在结论上是否定性的(证明"完备一致的理论不存在");哥德尔在1931的原证明走的是康托尔/罗素的否定性对角线老路、并不依赖 SRT。但因为它属于"形式系统可证性"这一可计算的世界,因此人们事后也能从 SRT 干净地推出它。这一推导的核心是不动点引理(Fixed Point Lemma),它是 SRT 最纯粹形式的直接推论:
不动点引理:设
T θ ( v ) σ T σ ⟺ θ σ σ σ θ σ T θ 证明:取
θ ( v ) v σ ⟺ " σ 不可证" σ ¬ σ σ σ ¬ σ θ ω Myhill定理(1955):罗宾逊算术 Q 的任何一致、可公理化扩张
T
合起来我们可以得到一个惊人结论:所有足够强的一致公理化理论(皮亚诺算术、ZFC公理系统
Rogers 还讨论过一个反向的自指:可以构造一个公理系统,其中包含断言自身一致性的句子(对任何公理集
5.7.5 冯诺伊曼的自复制自动机(1948)
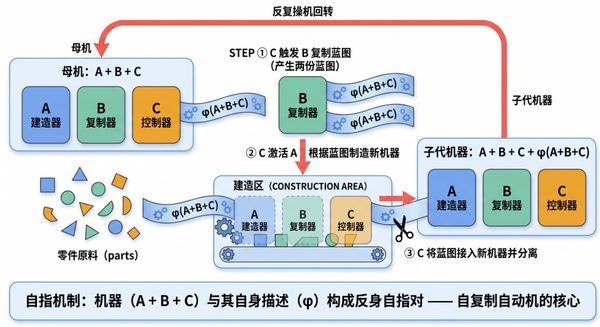
图4:自复制机的闭合回路——机器 M 的蓝图描述了 M 的全部部件(构造器 A、拷贝器 B、控制器 C);启动后 A 读蓝图 →造出 M 的新副本、B 复制蓝图、C 把它们组装起来。SRT 保证存在这样的蓝图,让有限指令即可闭合循环(驳斥了"蓝图之蓝图无穷倒退"的谬误)。
早在20世纪40年代,冯诺伊曼就开始思考一个问题,是否能在物理上构建一台自复制的自动机器。为了回答这个问题,冯诺伊曼采纳了其好友——数学家乌拉姆(Stan Ulam)的建议,开始在一个具有29个状态的二维元胞自动机上构建这样的虚拟机器,这就是冯诺伊曼的自复制自动机。这台机器的设计方案含四部分:通用构造器 A(读入一段指令,构造出该指令描述的任何机器)、通用拷贝器 B(复制指令)、控制器 C(指挥 A 与 B 协同运作、并把指令传给新机器)、以及一段描述 A、B、C 三者如何组合的蓝图(即指令带);机器 M
SRT 如何推出它:
定理(自复制图灵机):存在一台图灵机,从空白纸带出发,停机时纸带上恰好写着它自己的完整描述(转移表)[3]。
证明思路是 SRT 的典型用法:定义
ψ ( z ) z f f f
Rogers 给出更一般的框架:只要存在一台"通用建造机"(即 von Neumann 的 A 的抽象——给蓝图就造机器),就必存在一台机器,无论输入什么都造出自己的副本[1]。这直接驳倒了"自复制不可能"的谬误论证("复制需要蓝图,蓝图又需要蓝图的蓝图,无穷倒退"):SRT 表明系统能用有限指令闭合这个回环[1]。
5.7.6 Quine(自打印程序)
现象:一个不接受任何输入、只打印出自己源代码副本的程序[7]。它的约束很苛刻——不能读自己的源码(靠读文件输出自己、如 `cat $0`,被视为"作弊",不算 quine),只能靠"代码部分 + 代表代码文本的数据部分"来构造性地打印自己;§5.3 例 1 的 Python 程序就是一个标准 quine。"quine" 一词由 Hofstadter 在《哥德尔、艾舍尔、巴赫》中普及(借自哲学家 W. V. O. Quine 的名字,他构造过自指的句子)[21]。
SRT 如何推出它:把 SRT 里的变换规则
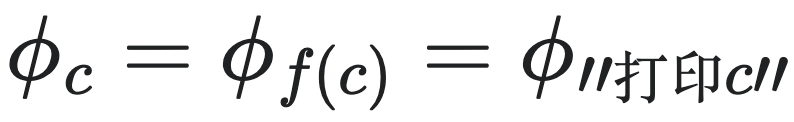
也就是说,程序
5.7.7 自省程序与自省式自改进程序
自省程序(introspective program):比 quine 强得多的自指——它能在运行"看到"自身(或自身的有界近似),并据此修改、调整自己的行为。Lisp 的 `eval`、Python 的 `inspect`/反射、调试器、动态语言的元对象协议都是它的化身。
这一思想最早是 Cutland 在 Computability: An Introduction to Recursive Function Theory(1980)§1.9 中以
假设给定一个全可计算函数
定理 1.9:存在一个程序
P ψ 证明:直接对可计算函数
f ( e , x ) = σ ∗ ( e , x , ψ ( x ) ) ϕ c = ϕ f ( c ) n ϕ n ( x ) = f ( n , x ) = P n ( x ) ψ
其中
SRT 的现代等价说法:与 quine 同构,只把
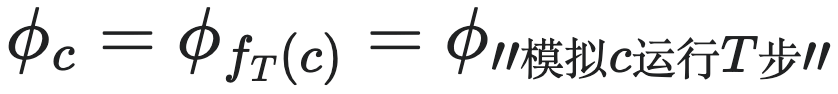
即程序
自省式自改进程序(introspective self-improving program):在自省基础上再进一步——程序不仅模拟自己,还基于自模拟结果来修改、改进自己。Zhang、Yuan & Zhang (2026) 用这一构造论证:存在能自我模拟、自我改进的程序,并把 von Neumann 的"复杂度阈值"重新诠释为大型语言模型递归自我改进所需的自省阈值(introspection threshold)——系统必须在自身描述中编码足够多的关于自身的信息,才能维持非退化的递归自我改进,否则会陷入熵退化或模型坍缩[22]。
5.7.8 统一性总结
上述现象共享同一个"对角线 / 自指"技巧,从结论性质(否定/肯定)和所在世界(集合论/可计算)两个维度看,完整谱系是:
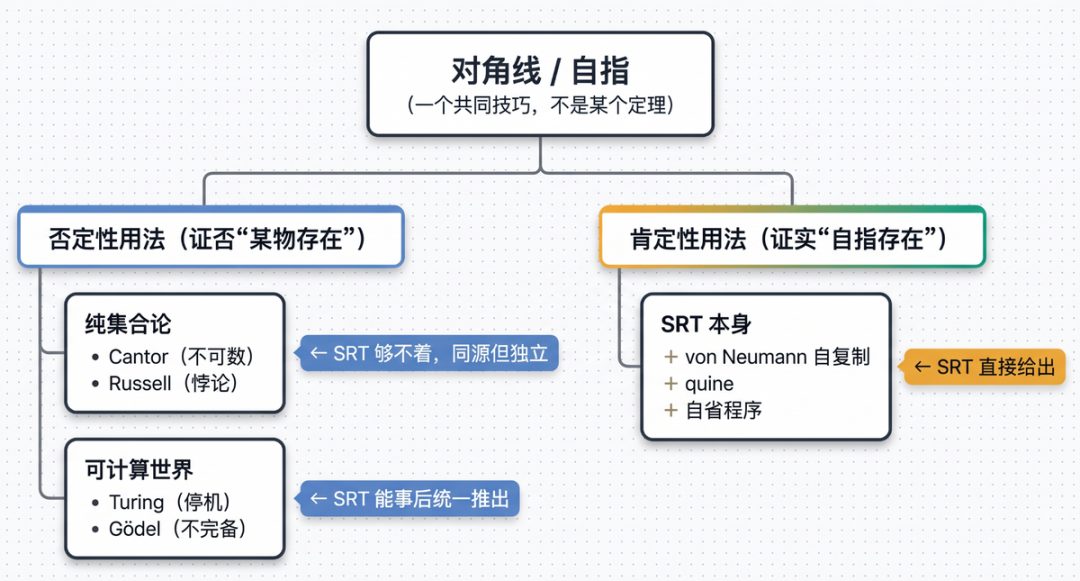
其中图灵停机问题、哥德尔不完备定理拥有双重身份:结论是否定性的(与康托尔、罗素问题同类),历史原证也走否定性对角线老路、不依赖 SRT;但因活在程序世界,又能被 SRT 事后更简洁地推出(§5.7.3 展示了停机问题的完整套用过程)。它们共同构成 SRT 的"自指"一面;SRT 还有另一面——"沿序数逐层构造"——见5.8节。
5.8 SRT的其它应用
上一节(§5.7)的那些现象都是"自指"本身的例子——程序或句子直接谈论自己。但 SRT 的威力远不止此:它同样是构造不直接涉及自指的复杂数学对象的基本工具。Moschovakis (2010) 以"回顾展"方式列举了 18 个 SRT 发挥关键作用的数学成果[3],其中最重要的一类是 Kleene 本人最钟爱的沿序数逐层构造(有效超限递归)——把递归定义从自然数推广到序数,从而定义出越来越复杂的对象。本节即以它开篇(前4个例子);此后转入其余主题——注意第5个板块中的 Rice 家族与 SRT 是“同源,但独立”的关系(并非 SRT 应用),详见该节导言。逻辑学家 Leo Harrington 用一句最为传神的话概括 SRT 所展示的威力:
"You need a number z? You got it!"(你需要一个这样的数 z?给你!)[3]5.8.1 通用序数记号系统ω_1^CK
这是 SRT 最初的应用(见 3.1)。回顾§3.1 的背景:序数记号系统给可数序数指派自然数代号,使得 0 / 后继 / 极限这三种构建可以被机械地(可计算的)判定,前驱与基本序列都可被机械地(计算地)取出。在进入定理之前,我们先把本节反复用到的几个概念交代清楚("序数"本身的背景见 §3.1 的背景框):
代号与所指:记号系统里的每个自然数
a | a | α α + 1 ω ω + 1 λ ω 0 , 1 , 2 , 3 , … 前驱与基本序列:后继代号 x的前驱(predecessor)记 P(x)——指序数x被"+1"之前那个序数的代号。极限代号 x 的基本序列(fundamental sequence)是一条可机械取出的递增代号列
x 0 x 1 , x 2 , … | x 0 | < | x 1 | < … | x | S
1的语法(S1是下文定理要构造的那个"通用"序数记号系统,Kleene 1938 为它设计的编码方案;后文的记号系统 O 沿用同一语法):0 的代号固定为 1;代号 a的后继的代号写成 2a;极限序数的代号写成 3⋅5e,并约定 |3⋅ 5 e | = lim | ϕ e ( n ) | e ϕ e × 5
定理(Kleene 1938):存在一个通用序数记号系统
证明的思路(这是"有效超限递归"的范式,值得细看):想要的翻译函数
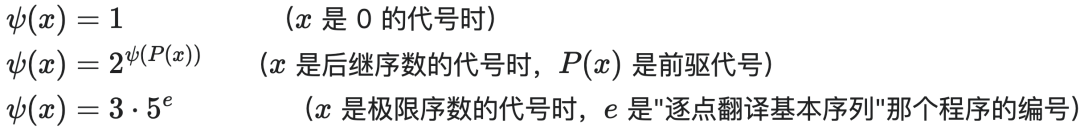
第三行的

("逐点翻译基本序列"说的就是它。)这里有两个层面的循环,性质完全不同:
值的层面(无害):
ψ ( x ) = 3 ⋅ 5 e e e ψ ( x 0 ) ψ ( x 1 ) , … x ψ ( x ) ψ ( x ) ψ ( x ) 代码的层面(真正的循环):程序
e x n ψ ψ ψ ψ ψ ψ
SRT 恰好合法化它:先用 s-m-n 定理(§2.3)造一个可计算函数
顺带分辨两行的差异:第二行
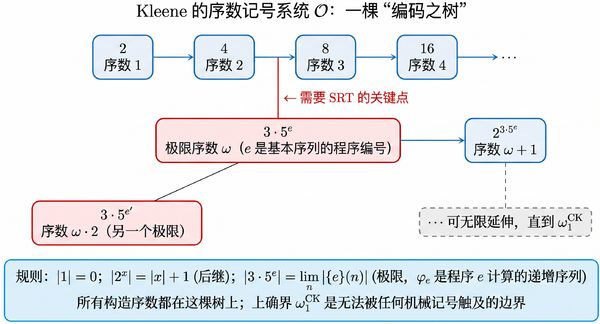
图5:Kleene 记号系统 O 的树状结构示意。每个自然数都是某个序数的代号——规则: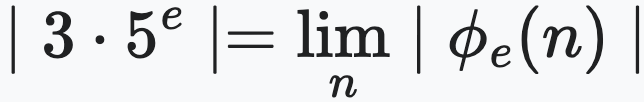 (极限——记号里携带基本序列程序的编号 e,这正是 SRT 大显身手的地方)。所有构造序数都在这棵树上生长;树顶是
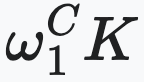 (无法被任何机械记号触及的边界)。
在

是逻辑学中最基本的"普适常数"之一:它是"机械命名能力"在序数世界中的绝对边界[4][1]。Rogers 用同样的 SRT 技术证明:O 上的"序数加法"可由一个可计算函数实现[1]。
Kiselyov 以现代眼光补充了这段历史的思想动机:Kleene 放弃用
5.8.2 构造序数 = 递归序数
可数序数有两种自然刻画:"构造序数"(能被某个机械记号系统命名,见 5.8.1)与"递归序数"( 存在某个程序可判定的排队规则,把全体自然数排成长度恰为该序数的良序队伍)。
Markwald–Spector 定理(1954/1955):两种刻画恰好等价——构造序数 ⟺ 递归序数[1][3]。
这是经典集合论事实"第二数类的两种刻画等价"的可计算版本;两个方向的证明都以 SRT 为归纳枢纽[3]。
5.8.3 超算术层级与 Spector 唯一性定理
需要先铺垫三个概念。
神谕(oracle):给程序外接一块只读"数据库"——集合 A。程序运行中可随时查询"数 n 是否属于 A"并立即得到正确答案。这样的 A 称为神谕;"以 A 为神谕可计算"衡量的是:若把 A 白送给你,你还能多算出什么。
图灵跳(Turing jump):对任何集合 A,把"哪些以 A 为神谕的程序会停机"这一问题本身收集成一个集合,记作 A′(读作"A 撇")。可以证明:A′ 以 A 为神谕仍不可计算——每跳一次,都得到一个严格更难的"相对版停机问题"。特别地,从空集
沿构造序数"盖楼":现在从
H
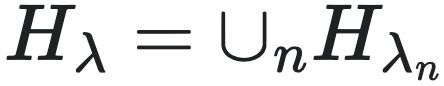 (极限层:把下面各层沿一条可计算上升的序列
在某一层 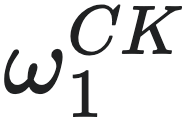 为止。HYP 因此是真正高于算术层级的层级——至于它究竟高到哪一步(恰好等价于一个"二阶量词"的定义能力),正是 5.8.4 的主题[3]。
问题来了:同一序数
Spector 唯一性定理(1955):不会。
H α α
证明需要同时构造两个互相缠绕的函数(互相引用对方编号),由双递归定理(见 §5.5 的 Smullyan 版本)合法化——这是有效超限递归技术的高峰之一。Kleene 对这个学生的工作推崇备至,他常讲自己如何"行为不端"地接受它作为博士论文、又作为期刊编辑指定自己为审稿人并立即录用——"这非常不合规矩,但我认为这最终有利于逻辑学!"[3]。
5.8.4 超算术集与有效描述集合论
背景:在自然数的集合(数学分析的对象)上,可以用"二阶量词"分层: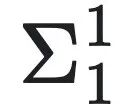 集是"存在一个实数使得某个可计算性质成立"的集合(由存在量词构成的命题定义的集合),
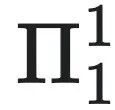 是其对偶(由二阶的全称量词构成的命题定义的集合),
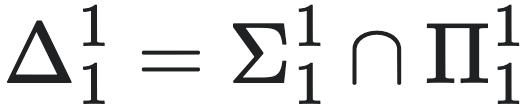 是"两面都可定义"的集合——可类比为分析学中"既可开逼近又可闭逼近"的集合。
Kleene 定理(1955):自然数的集合 A 是
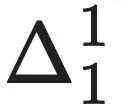 的,当且仅当 A 是超算术的(HYP)[24][3]。
这把可计算性理论(HYP,由机器和序数定义)与描述集合论(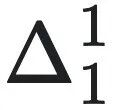 ,由投影/量化定义)两大传统焊接在一起,是 Kleene 获 1983 年 AMS Steele奖的核心成果之一。证明的两个引理(Kleene's O 是
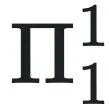 集、且是
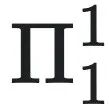 中"最复杂"的完备集)都靠 SRT 沿良基树作有效超限递归建立[3].
在此基础上,SRT 向实数空间(Baire 空间,即自然数无穷序列的空间)推广后,成为有效描述集合论的引擎,三个代表性结果:
1. Suslin–Kleene定理:Borel 集(从开集出发经可数次并、交、补生成的集合)与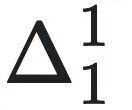 集之间可以可计算地互译。它同时蕴含经典 Suslin定理(
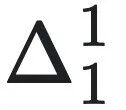 =
2. 赋范归纳定理(Moschovakis 1974):对带有良好"秩函数"结构的归纳定义,其最小/最大不动点保持在相应的可定义层级内。它的证明使用"关系版 SRT"(不动点代码
3. 编码引理(Moschovakis 1970):在 ZF+DC+AD(确定性公理,一个与大基数理论相关的集合论假设)下,若连续统可满射到基数
此外,Kleene 1940 年代为直觉主义数学(拒绝排中律的构造性数学)构造的可实现性(realizability)中,bar递归定义、bar归纳与连续性原理的验证也本质地使用 SRT 的各种形式[3]。
5.8.5 r.e. 索引集理论:Rice、Rice-Shapiro 与 Myhill
本板块把"程序行为性质"当作一个独立的研究对象。核心概念是索引集(index set):给定某类程序行为,把"行为落在这类里"的全部程序编号收集起来,就得到 的一个子集。若用程序 e 的定义域
 表示某类 r.e. 集,则写法是
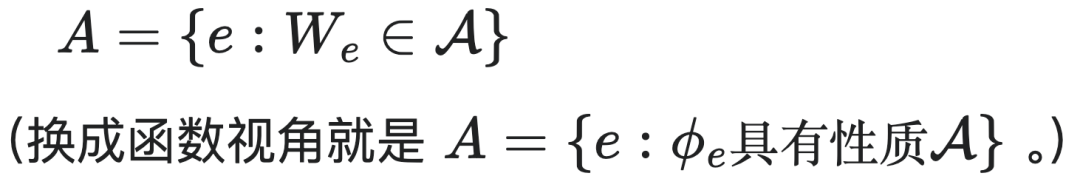
可判定、可枚举这类词只能作用于自然数集合,索引集正是那道翻译层——它把"程序行为问题"转写成  的子集,之后才能问"这个性质能判定吗、能枚举吗"。两个要点:其一,此类性质必须只看行为、不看代码(同一函数的两个不同编号在 A 中必须同真同假),否则退化为平凡的代码分析。
与 SRT 的关系必须先分清:下面三个结果中,只有 Myhill 定理是 SRT 的应用(其证明核心是"程序 z 引用 z 自己的编号",见 5.8.5.2)。
5.8.5.1 Rice定理(1951)
莱斯(Rice)定理:程序行为的任何非平凡性质都不可判定。精确地说:设  是某类部分可计算函数,既非空也非全体,则它的索引集
证明思路(停机归约——教科书标准路线,不依赖 SRT):
1. 取一个"见证"函数 
 中,就对"补性质"(行为不在

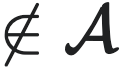 ;
2. 对每个
3. 于是
直觉:任何非平凡的"行为分类"都把停机问题吸收为自己内部的一个子问题——你若想机械地给每个程序的行为贴标签,就不得不先回答"程序
x
注(SRT 捷径,非本质):Rice 定理也可用 SRT 三行证完:设 A
5.8.5.2 Myhill定理:创造集 = 完备集
背景:停机问题集合
- Myhill定理(Myhill 1955):每个创造集都是 r.e.-完备的;两个概念重合
[26][1][3].
证明中用到了 SRT 的关键一步:想把任意 r.e. 集 B 归约到创造集 A,需要构造一个程序
5.8.6 有效运算的连续性:Myhill–Shepherdson 与 KLS–Čeĭnin 定理
背景:一个"程序变换"
Myhill–Shepherdson定理(1955):对可计算变换而言,两种方式恰好等价——任何"按代码"的可计算变换都能改写成"按值"的图灵机计算,反之亦然[26][3].
证明的两个关键引理(变换必然是单调的、必然是连续的)都依赖 SRT:构造一个"监视
Kreisel–Lacombe–Shoenfield–Čeĭnin定理(1957/1962):作用在全函数上的可计算变换必然是连续的——输出在任何点的值只依赖输入函数的有限个值;而且可用确定性图灵机实现[3]。
Čeĭnin 的版本——"构造度量空间之间的每个可计算算子都是有效连续的"——是俄罗斯构造性分析学派(用可计算性重新奠基数学分析)的中心结果之一[3]。证明中 SRT 出现两次,用法与上述如出一辙。
此外,Rogers 用 SRT 证明了 Blum定理:任意两个"通用部分函数"(即解释器)都只差一个可计算的重新编号(递归同构)——编号系统在"重新命名"意义下本质唯一[1].
5.8.7 Solovay 可证性逻辑
背景:可证性逻辑(provability logic)研究"可证"这个概念的抽象规律,把 "⌜
Solovay定理(1976):一个模态公式在皮亚诺公理体系中的所有解释下都可证,当且仅当它是 GL 的定理。即 GL 恰好完全刻画了皮亚诺公理体系的可证性逻辑[27][3]。
Solovay 的证明漫长精巧,其关键引理需要构造一个自指的函数 h,其中 h 的定义中引用 h 自己的编号。Solovay 本人用一句话带过:"表面上的循环用递归定理以通常方式处理"[3]。Moschovakis 评论到:无法想象不借助 SRT 如何凭空想出这个构造——在此意义上 SRT 是可证性逻辑这块基石中不可或缺的成分[3]。
应用地图一览
(表中"§"编号均指 Moschovakis 2010[3] 的章节。)
5.9 其它扩展研究
5.9.1 SRT 与计算复杂性理论
在复杂性理论中,递归定理主要扮演证明工具的角色。复杂性类的许多分离与结构定理采用"带时钟的对角化":让机器检查并躲开自己(或更早的机器)的行为;当这种自躲藏需要程序援引自己的代码时,严格化的抓手正是 SRT。这类证明有一个内禀的时序难题:对角化机器要躲开的对象可能就是它自己(或自己的更早版本),而它必须在对方"提交行为"之后才能可靠地反着做——处理这一难题的技术称为延迟对角化(delayed diagonalization)。这一思想的源头可以追溯到 Breidbart 的"分裂递归集"构造显式调用递归定理[28],后来被 Schmidt 统一为"复杂性类的递归论结构"定理,推论包括:除非 NP = P,NP 不等于 P 与 NP 完全类之并这类"可递归呈现类"的非平凡并[29]。延迟对角化由此成为分离复杂性类的标准武器——本质上,它是"带时钟的对角线"对自引用时序的形式化处理。
在Blum的机器无关复杂性理论中,SRT 与对角化结合产生了一批"存在性"结果。代表性的一例:Helm 与 Young 回答了 Blum 的一个问题——存在这样的可计算函数,任何为它"换上更快的程序"的尝试都要付出程序尺寸爆炸的代价,且刻画这一代价的增长函数快于任何递归函数[30]。"加速与简洁不可兼得"由此成为定理而非格言。
更微妙的是,我们能否把 SRT 本身复杂性化?如果把编号限制到多项式时间的程序族上,SRT 还成立吗?困难出在证明的两个枢纽操作上:通用模拟在 P-时间世界里没有多项式时间版本(万能解释器本身要超线性时间),s-m-n 实例化(把参数写死)也会放大运行时间。因此对一般的多项式时间编号,带时间界的 SRT 不成立;不过 Kleene 1938 年的直接证明不经过通用程序,所以某些没有通用程序的子递归系统仍保有递归定理。一句话主旋律:自指免费,高效自指则昂贵——不动点的"存在"有保证,"节省地存在"则没有。
5.9.2 存在性与可构造性的分野
把上一小节的主旋律展开:存在性原封不动地活着——不动点存在且可计算,这一保证不附带任何资源代价;可构造性一旦要求资源有界,就会在子递归系统中部分失效。而有意思的是,这片"失效地带"并非荒芜之地——为了刻画它,递归论与复杂性理论交叉出两种新工具,并在工程侧催生了一个终点形态。
工具一:Kolmogorov复杂性与DNR度。相对化之后 SRT 何时失效,有一个精确刻画:
工具二(工程终点):哥德尔机。Schmidhuber 把"资源有界的自引用"推到了最雄心勃勃的形式[32]:机器的初始代码包含自身硬件、环境、效用函数乃至整个初始软件的公理化描述,一个基于 Levin通用搜索的偏置最优证明搜索器(BIOPS)持续寻找证明——一旦证明某个对自身代码的改写能提升未来效用,就立即改写(包括改写证明搜索器本身)。由于改写前必须证明"继续搜索其他改写不值当",每次自改进都是全局最优的,没有局部极值。它的边界同样是哥德尔式的:只能改写"在形式系统内可证明有用"的部分,超出可证明范围的好处再大也拿不到。这条工程谱系与上文的自省程序一脉相承:自省程序"知道自己的有界执行轨迹",哥德尔机则"能证明地改写自己的任何部分"——自指从存在性工具,最终长成了资源有界的自改进机制[22]。
5.9.3 KRT 可以被分级
该词条表述的 SRT 默认在一个可接受编号(acceptable numbering,即同时满足通用性与s-m-n定理的编号系统)中工作;在此类编号之间,Rogers同构保证了彼此可计算互译。一个自然的追问是:换掉编号,递归定理还剩多少?
答案分两层。其一,Rogers 不动点形式(表述B)对一切可接受编号成立;但在一般的可计算编号(同样是全部一元偏可计算函数的一致枚举、却不满足可接受性的编号)中,Kleene 形式(表述A,文献中称 KRT)可以失效。其二,失效与否不是全有全无的:Case、Jain 与 Stephan 借用归纳推断的收敛标准,把"在编号
这带来一个概念上的反转:自指不再是"图灵等价世界"里的免费午餐,而是编号系统的一种资源。与上一小节的 DNR 刻画合观,结论是对称的:环境(oracle)与编码(编号)两个维度中任何一个被放宽,自指都可能失效,而失效的程度都可以被测量与分级。该文还证明了两个结构性事实:①一个编号"找不动点的能力"与它"作为学习最优假设空间的能力"相互独立;②若编号既对解释性学习最优、又在 Ex 意义下满足 KRT,则它还能在 Ex 意义下翻译其他编号的指标。这与正文 §5.1 的"表述C"形成呼应——uniform 性与可构造性本身,就是递归定理中最脆弱也最值钱的部分。
6. 评注和影响
6. 评注和影响
1. 简单性与普适性的反差。SRT 的全部证明只有一行对角线,应用却横跨逻辑学几乎所有分支。Moschovakis 指出:其广泛适用性恰恰源于这种简单——它极易被翻译到自然数以外的语境(实数空间、任意 Polish空间、高类型对象、模态逻辑),在每个语境中重新化身[3]。
2. 两个递归定理的分工。第一递归定理保证递归定义有最小解(函数层面、序理论的不动点);第二递归定理保证自指定义合法(代码层面的不动点)。前者回答"这个函数方程有解吗",后者回答"我能在定义中引用被定义者自己的代码吗"。强定理蕴含弱定理,反之不然(见 4.4)。
3. 自指的数学化。从 Gödel 的替换函数、通用图灵机、冯诺伊曼的自复制自动机,到 quine、计算机病毒、编译器自举,乃至人工智能中"系统改进自身"的设想,"系统谈论自身"的可行性边界都由同一种对角线结构划定。Kleene 递归定理是这一结构最干净、最一般的陈述。
4. 历史反讽。Kleene 1938 年发明 SRT 是为了构造序数记号,而 1944 年他恰恰因为"拿到一个不动点却误以为拿到最小不动点"而犯下著名错误,直到 1955 年才纠正(见 3.3)——这个故事最恰当地说明了理解两个递归定理区别的重要性。
5. Rogers 的总评:递归定理是"一个基本的研究工具、一个深刻的结果"(a basic research tool ... a deep result),它的深刻在于"以优雅和智识上的经济性,处理那些需要繁复构造的问题"[1];虽然它的直接效果常是产生各种"病态"结构(自我枚举的集合、自我打印的程序),但它在 Myhill 定理等结果中起到了"在此前独立定义的概念之间建立正则联系"的作用[1]。
参考文献
参考文献可上下滑动查看
本词条由集智俱乐部众包生产,难免存在纰漏和问题,欢迎大家留言反馈,一经采纳,可以获得对应的积分奖励噢!
加入我们
亲爱的社区伙伴与知识探索者:
我们诚挚邀请热爱知识分享的您,加入集智百科词条编写志愿团队!无论您是领域专家,还是对特定主题充满热忱的学习者,这里都有您的舞台。通过编写百科词条,您将为全球读者传递权威知识,同时获得专家指导与个人能力跃升的双重成长。
📝 志愿者职责
创作新词条:覆盖复杂系统、人工智能等前沿领域
迭代经典内容:更新现有词条,守护知识的准确性与时效性
质量守护者:参与内容校对审核,共建精品知识库
🌟 我们期待您
集智读书会成员(需完成一期字幕任务)
拥有清晰表达复杂概念的写作能力
对特定领域有深度研究或强烈兴趣
具备信息检索与整合素养
怀揣责任感与协作精神,愿为知识共享赋能
🎁 您将收获
百科积分(支持兑换集智俱乐部周边:文化衫、复杂科学知识卡以及提现)
集智俱乐部创始人张江教授亲自指导写作
科研志愿者晋升通道:表现优异者可加入张江教授科研团队从事科研志愿者
你的百科贡献之路,从一字一句开始!
第一步,从成为一名字幕志愿者开始!
只需完成一期读书会讲座字幕任务,这不仅是贡献,更是一次深度的学习。字幕任务过关后,您将升级为“百科志愿者”,开启编辑词条、整理术语的进阶旅程。
从字幕到百科,这是一条清晰的成长路径。立即行动,从第一个任务开始你的升级吧!

扫码加入
因果涌现第七季——从理论到应用
在神经系统中意识的生成、城市交通的拥堵演化、全球产业系统的协同与失稳之中,始终潜藏着一条贯穿微观与宏观的因果脉络:个体行为本身或许简单,却能在尺度跃迁中孕育出高度组织化、难以还原的整体结构。复杂现象并非微观规则的线性叠加,而是源于多尺度动力学作用下逐步形成的因果组织。正是在这一背景下,因果涌现理论被提出,并在因果涌现 2.0、工程化涌现以及多尺度因果抽象等工作中推进,逐渐发展出一套融合动力学分析、信息论度量以及谱方法与人工智能工具的研究框架,从而将研究重心从“复杂性本身”转向“因果结构如何出现、如何被度量并在现实系统中发挥作用”。
为系统梳理因果涌现领域的最新进展,北京师范大学系统科学学院教授、集智俱乐部创始人张江老师领衔发起「因果涌现第七季」读书会,组织对该主题感兴趣的研究者与探索者共同研读前沿文献、交流研究思路。读书会将于2026年2月22日起每周日上午(创建读书会暂定时间为10:00-22:00)线上开展,持续约10周,包含主讲分享与讨论交流,并提供会后视频回放,诚邀相关领域研究者及跨学科兴趣者参与。

详情请见:因果涌现第七季——从理论到应用

加入我们
亲爱的社区伙伴与知识探索者:
我们诚挚邀请热爱知识分享的您,加入集智百科词条编写志愿团队!无论您是领域专家,还是对特定主题充满热忱的学习者,这里都有您的舞台。通过编写百科词条,您将为全球读者传递权威知识,同时获得专家指导与个人能力跃升的双重成长。
📝 志愿者职责
创作新词条:覆盖复杂系统、人工智能等前沿领域
迭代经典内容:更新现有词条,守护知识的准确性与时效性
质量守护者:参与内容校对审核,共建精品知识库
🌟 我们期待您
集智读书会成员(需完成一期字幕任务)
拥有清晰表达复杂概念的写作能力
对特定领域有深度研究或强烈兴趣
具备信息检索与整合素养
怀揣责任感与协作精神,愿为知识共享赋能
🎁 您将收获
百科积分(支持兑换集智俱乐部周边:文化衫、复杂科学知识卡以及提现)
集智俱乐部创始人张江教授亲自指导写作
科研志愿者晋升通道:表现优异者可加入张江教授科研团队从事科研志愿者
你的百科贡献之路,从一字一句开始!
第一步,从成为一名字幕志愿者开始!
只需完成一期读书会讲座字幕任务,这不仅是贡献,更是一次深度的学习。字幕任务过关后,您将升级为“百科志愿者”,开启编辑词条、整理术语的进阶旅程。
从字幕到百科,这是一条清晰的成长路径。立即行动,从第一个任务开始你的升级吧!
扫码加入
因果涌现第七季——从理论到应用 在神经系统中意识的生成、城市交通的拥堵演化、全球产业系统的协同与失稳之中,始终潜藏着一条贯穿微观与宏观的因果脉络:个体行为本身或许简单,却能在尺度跃迁中孕育出高度组织化、难以还原的整体结构。复杂现象并非微观规则的线性叠加,而是源于多尺度动力学作用下逐步形成的因果组织。正是在这一背景下,因果涌现理论被提出,并在因果涌现 2.0、工程化涌现以及多尺度因果抽象等工作中推进,逐渐发展出一套融合动力学分析、信息论度量以及谱方法与人工智能工具的研究框架,从而将研究重心从“复杂性本身”转向“因果结构如何出现、如何被度量并在现实系统中发挥作用”。 为系统梳理因果涌现领域的最新进展,北京师范大学系统科学学院教授、集智俱乐部创始人张江老师领衔发起「因果涌现第七季」读书会,组织对该主题感兴趣的研究者与探索者共同研读前沿文献、交流研究思路。读书会将于2026年2月22日起每周日上午(创建读书会暂定时间为10:00-22:00)线上开展,持续约10周,包含主讲分享与讨论交流,并提供会后视频回放,诚邀相关领域研究者及跨学科兴趣者参与。 详情请见:因果涌现第七季——从理论到应用
推荐阅读
1. 张江:大语言模型中的自指——递归式自我改进的内省阈值|集智科学研究中心
3. arXiv:哥德尔智能体-具有递归自进化能力的agent框架
4. 9900分可兑换“涌现”文化衫,报名任意读书会送299积分!
5. 集智学园精品课程免费开放,解锁系统科学与 AI 新世界
点击“阅读原文”,报名读书
本文转载自微信公众号「集智俱乐部」,查看原文。版权归原作者所有,如有侵权请联系删除。