实测近一周,对 Kimi K3.1 Pro 的真实评价
原创 李秀奇 2026-10-27 21:55 浙江
Datawhale干货
作者:李秀奇,Datawhale成员
周六凌晨,月之暗面发布了 Kimi K3.1 Pro。
这近一周的时间,我们用 8 个高耗时、多步骤的重度任务深度测了它的能力。小到把笔记本电脑按物理结构拆成六层交互的视图,大到连续运行两天、独立交付通过 76 项检查的《原神》部分玩法 Godot 工程。
过一下官方技术报告公布的跑分:
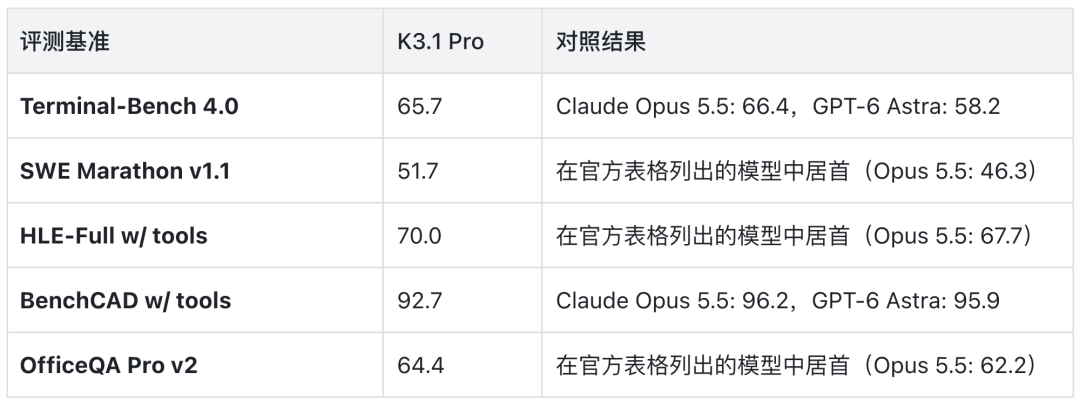
跑分能看出它的强项和不足。长程软件工程(SWE Marathon)和复杂办公(OfficeQA)两项,在官方列出的模型中排名第一。但在考察终端研究与科学计算的 Terminal-Bench Science 0.1 上,K3.1 Pro 得分为 38.1,与 GPT-6 Astra 的 68.1 仍有明显差距。
接下来看看这 8 个案例实际做得怎么样。
一、三维场景实测
第一题是经典的「鹈鹕骑自行车」,核心看动作协调度与镜头节奏。K3.1 Pro 直接生成了一段完整的三维骑行动画:鹈鹕双翅扶稳车把,脚蹼踩准踏板做连贯圆周运动,没有出现穿模;车轮滚动时两岸树木后退,镜头会顺着骑行节奏由远及近推拉。直接用代码跑出动态原型,是目前的主流用法。

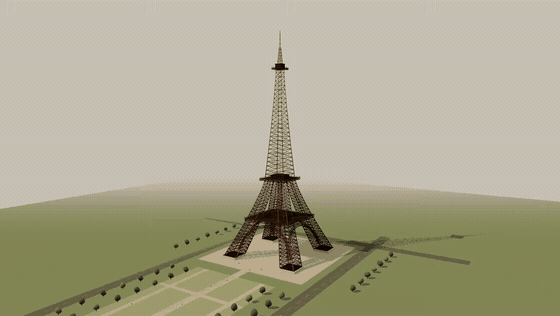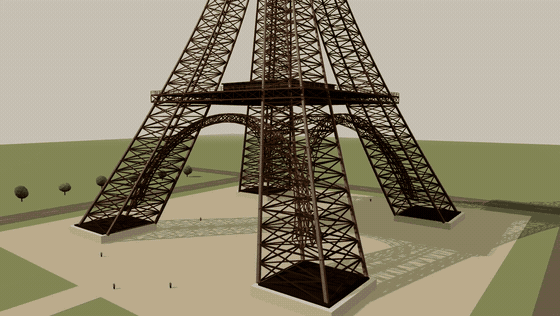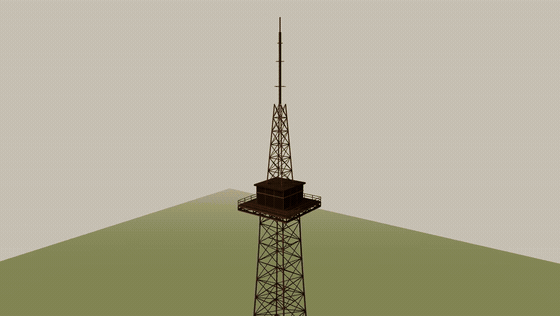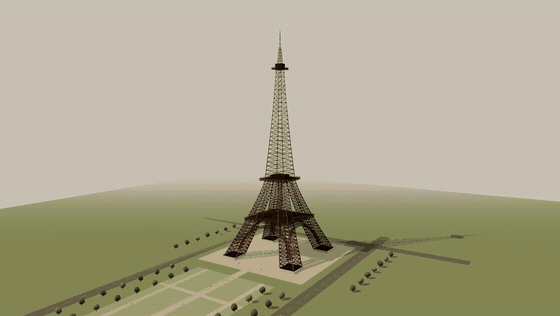
到了埃菲尔铁塔案例,测试大尺度建筑的比例与多视角还原。从底部拱券钢架、中层观景台,到往上收拢的塔身和顶部天线,模型把各构件的尺寸关系控制得很准。
拖动视角时,镜头能从远景全貌顺滑切入塔底仰视、移至中层俯瞰,最后拉近看清塔尖细节,拿来做建筑汇报或线上展厅比静态图直观得多。
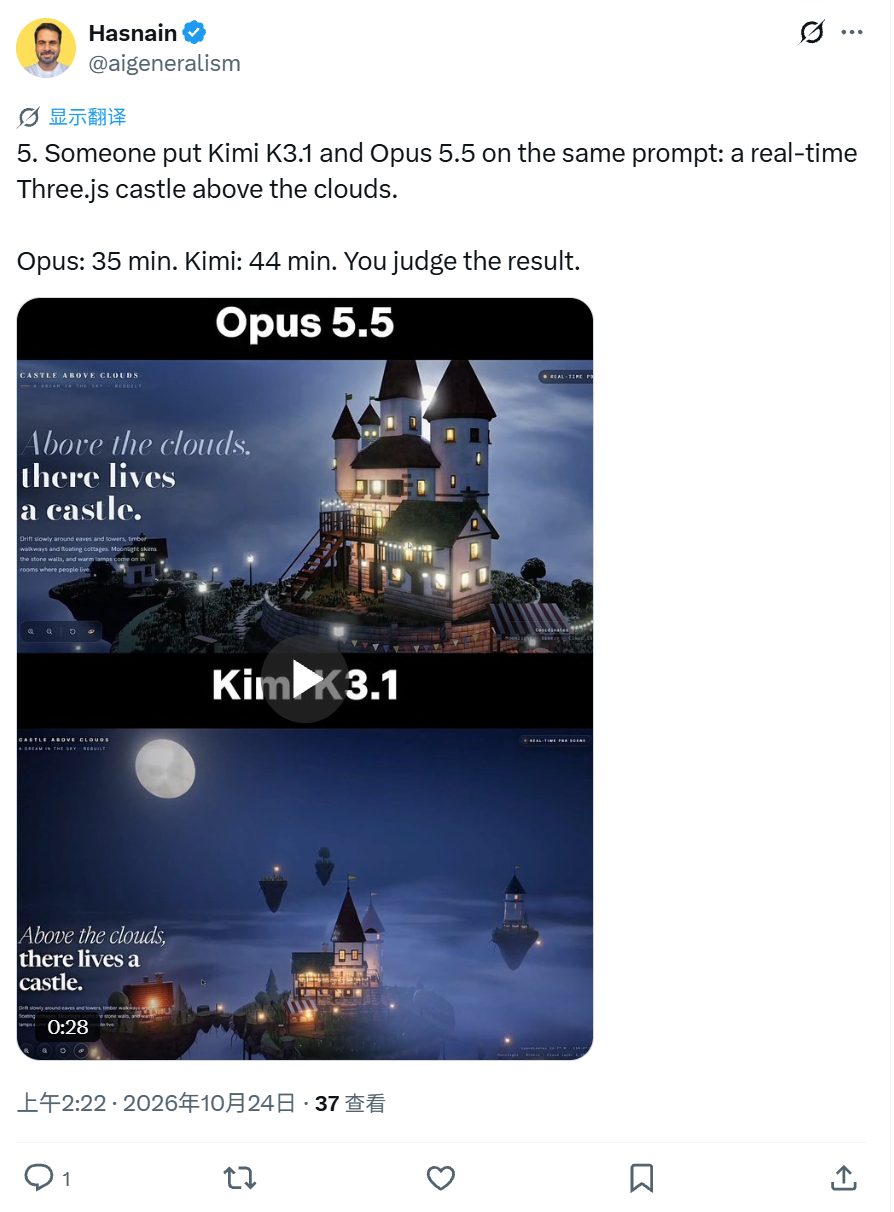
在 X 上,我们关注到海外测试者 Hasnain 用同一句提示词,让 Kimi K3.1 和 Claude Opus 5.5 同台生成 Three.js「云上城堡」。两边在云层厚度、塔楼细节和光影氛围上的完成度非常接近,主要差距在于耗时:Opus 5.5 用了 35 分钟,Kimi K3.1 跑了 44 分钟。
二、工程结构实测
接下来,我们让它拆一台笔记本电脑,测试其梳理复杂硬件层级的能力。生成的交互页面把外壳、屏幕、键帽、主板元器件、双散热风扇、导热铜管和电池,清晰地分到了六个物理构造层里。

页面可以在整机和六层展开视图之间平滑切换,也能换成半透明材质,或用剖面视图查看内部。点击某个部件,镜头会自动对焦并高亮显示,挡住视线的部件也能单独隐藏。讲解硬件结构时,让读者自己转一转、拆开看,比只看图纸容易理解。
如果给它真实的户型图和照片,它能把房子搭出来吗?
我们用「黑旋跃层」测试了这件事。输入同一套住宅的平面图和实景照片后,模型按图纸比例建立坐标,再参考照片中的材质,搭出了可以自由漫游的三维室内空间。黑色螺旋楼梯、16 级扇形踏板、客厅双向沙发、通高百叶窗,以及二层夹层卧室的位置关系,都能在场景里看到。

买家具或调整布局前,可以先在模型里走一圈,提前看看动线与采光。
不过,虚拟模型与真实照片的差距依然明显。在第三轮独立盲测中,我们将生成的餐厨通道、沙发、楼梯空井与实景照片放在一起对比,所有评审均投给了真实照片。模型在空间开阔感、家具比例和自然光过渡上还不够到位,实际施工仍需专业人员现场测量。
在更专业的工业建模上,官方展示的机械臂案例包含了 2317 个零件与 268 条动态走线,支持透明观察与剖面切开。

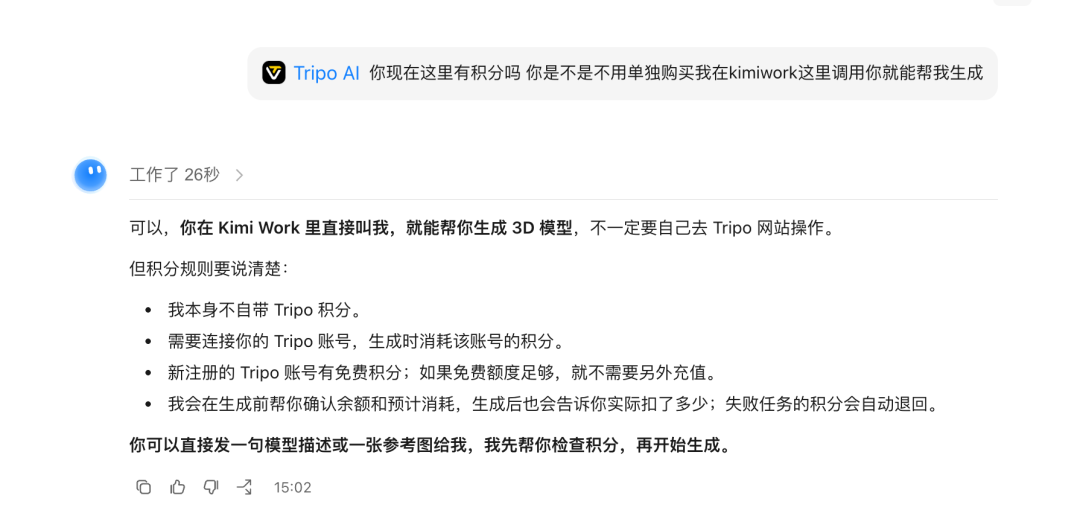
测试过程中关注到,Kimi 官网 和 App 一起上线了3D Make 功能。
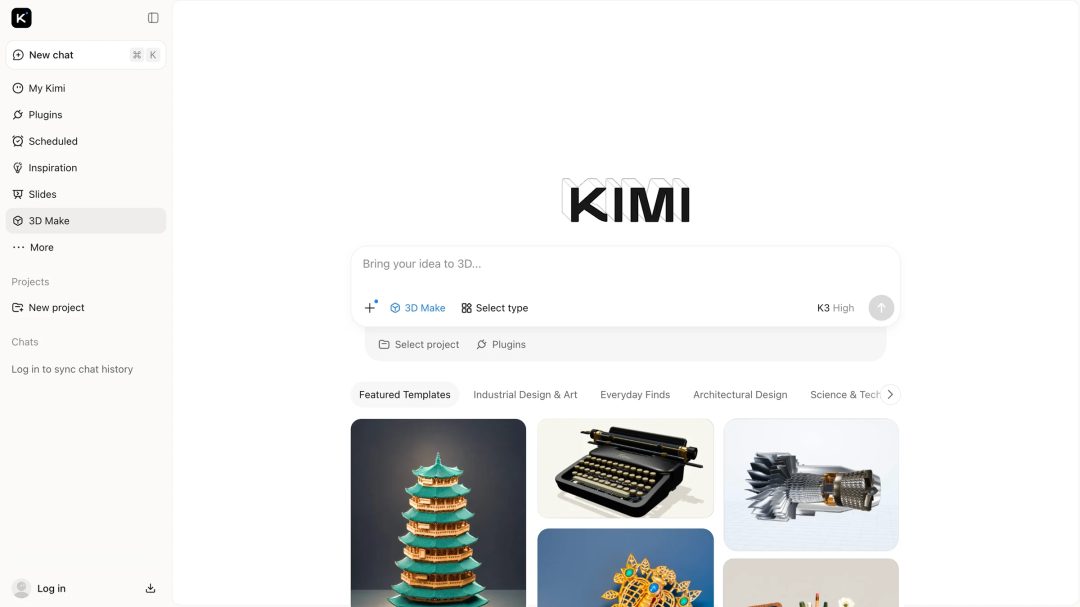
这个功能体验下来不全是模型的能力,通过调用 Tripo 等外部的 3D 工具,成功实现了在浏览器里转动模型、调节参数,并支持导出源文件。
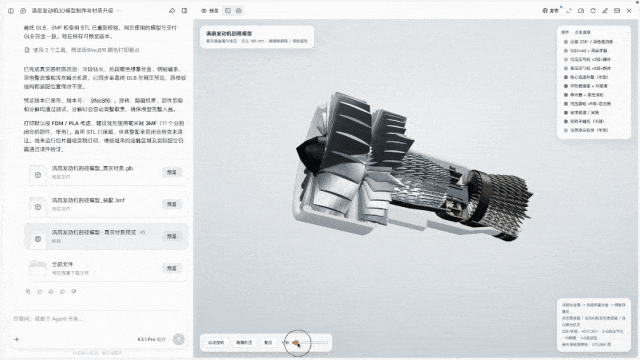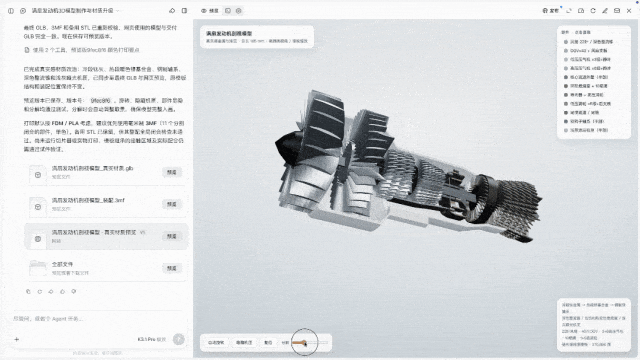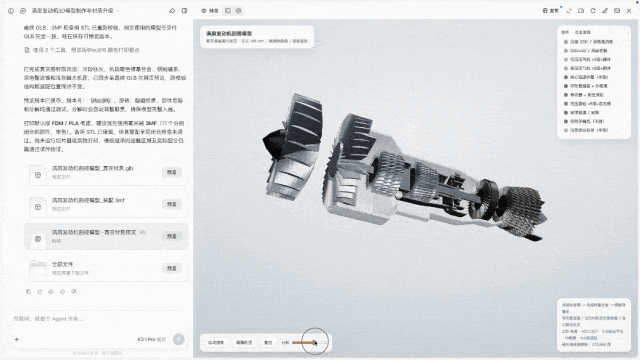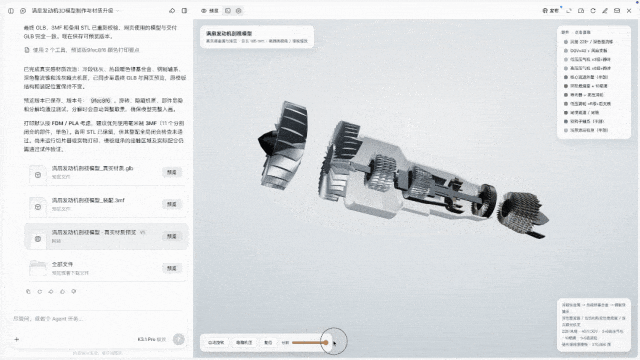
需要同样的效果,还可以用 KimiWork,稍微慢一点,但在整体场景方面的质感会好很多,大家可以根据需求自己挑。
三、复杂工程实测:复刻「原神」
前面的测试主要看三维场景与空间结构,这一部分我们重点看它在复杂游戏工程与真实后端项目维护上的表现。
先看从零搭建超长线工程的「复刻原神部分玩法」。我们要求模型自己在网上搜集美术素材、技术资料和参考视频,尽可能把游戏做出来。接下任务后,K3.1 Pro 在后台连续运行了一天多:自己找资源、搭 Godot 工程、写 GDScript 逻辑,遇到兼容性报错再自己修改,中途没有迷失目标或停滞。
最终它交付了一套可运行的 Godot 版原神。在同一个测试场景中,角色移动、攀爬、滑翔、四人无缝切换、元素战技与爆发、野外战斗、开宝箱、传送锚点和任务委托结算,都能正常运转。(此处可以回顾一下视频)
该工程在主场景下通过了 76 项正式检查,涵盖伤害结算、任务状态切换、背包和奖励触发等核心机制。
官方同步展示的虚幻引擎「天宫对战」与「人类行走仿真」,也体现了这种长程自我调试能力。
在行走仿真里,小人起初频频摔倒,模型通过在后台不断修正控制器参数,最终让它实现了稳定连续行走。

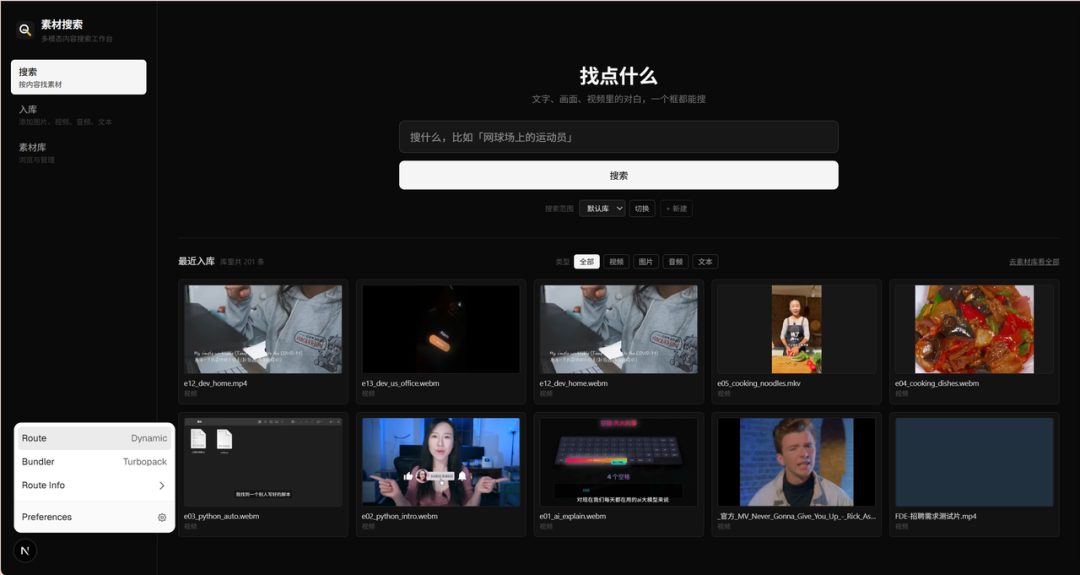
除了这种动辄跑两三天的复杂工程,我们也拿手头正在开发的一个多模态素材搜索开源项目 MaterialSeeker,测试了它在的日常排障体验。
https://github.com/li-xiu-qi/MaterialSeeker 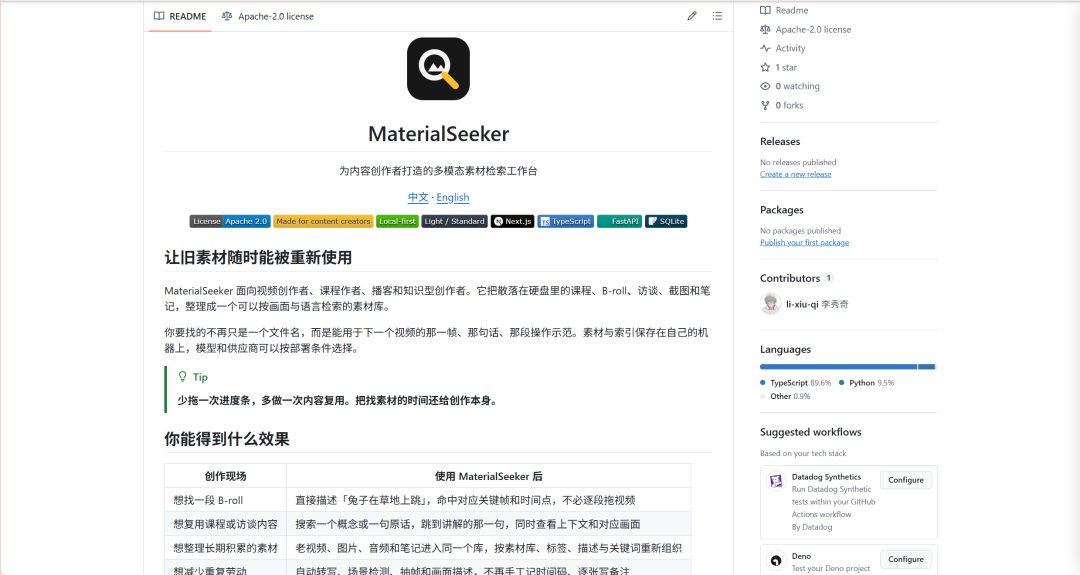
这个项目支持上传视频、音频、图片和文本素材,底层结合了关键词匹配与语义向量检索等多种搜索策略,让用户可以直接输入一段文字,跨模态搜出对应的视频、音频或图片内容。由于涉及多种检索策略与多模态数据处理,后端的调用链路比较复杂。
在开发过程中,遇到一个bug,直接点开报错信息丢给 Kimi Code 让它修复。
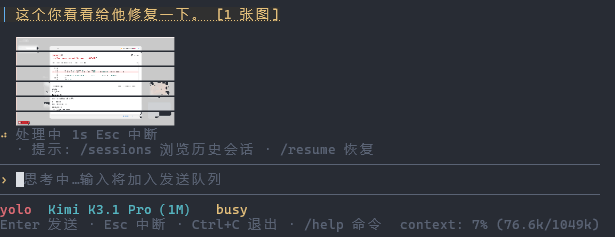
大概过了 2 分钟左右,它在代码库里定位到问题并直接修好了。在面对复杂的后端逻辑时,以后只要告诉它「这里有个报错」,K3.1 Pro 基本能做到指哪打哪。
四、视频制作实测
接下来,我们测试了两种视频任务:一支侧重动态设计,另一支要把脚本、动画、配音和剪辑完整做下来。
在时间轴驱动的视频制作上,测了两个方向。第一支「折线成场」侧重纯代码的动态视觉设计:一枚亮橙色圆点顺着文字排版滑出,依次形变为三维圆环和起伏曲面,穿过粒子空间后定格在片尾标题上,三维动画、文字、转场与电子音轨在同一时间轴上精准对齐。
片中流动的曲面用的是形态键和网格形变,没有进行真实的流体物理计算。
第二支近 30 秒的「Personal Agent」科普短片,则测试从脚本、动画、配音到合成的全流程串联。
模型先用 AvatarScript 生成人物动画并合成配音,再根据语音时长反推动态图解的展开节奏,自动对齐字幕与音效后直接输出 MP4 文件。
但实测下来,这套自动化视频流程目前仍需人工介入。字体选择、背景对比度、图层遮挡和音效时长都经过了我们的人工核对;角色嘴型目前仅套用通用动画,尚未对齐中文发音,音色也仍需调试。
此外,整理这 8 个案例时,有感觉到它的中文写作比以前自然了。给出技术背景和多项写作要求后,它能紧紧跟住长指令,段落连贯,少了很多翻译腔和空话,写技术文档时能减少来回修改的次数。
五、调用成本
这次跑完这 8 个任务,我们一共消耗了 80 亿左右的 Token,使用的 API 接入,端到端总吞吐 72 t/s。
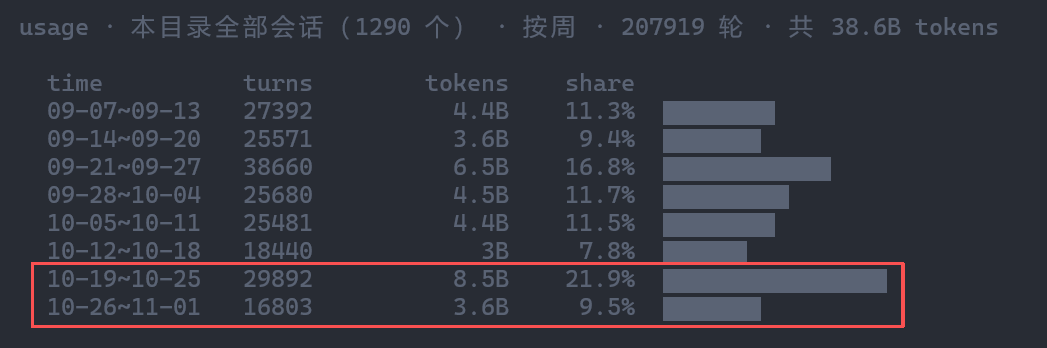
但落到订阅套餐上,体验就完全是另一回事了。我们同步拿 699 元的套餐去跑了一下长程任务,结果 5 小时窗口的额度很快就被蹬完了,只能干等重置。
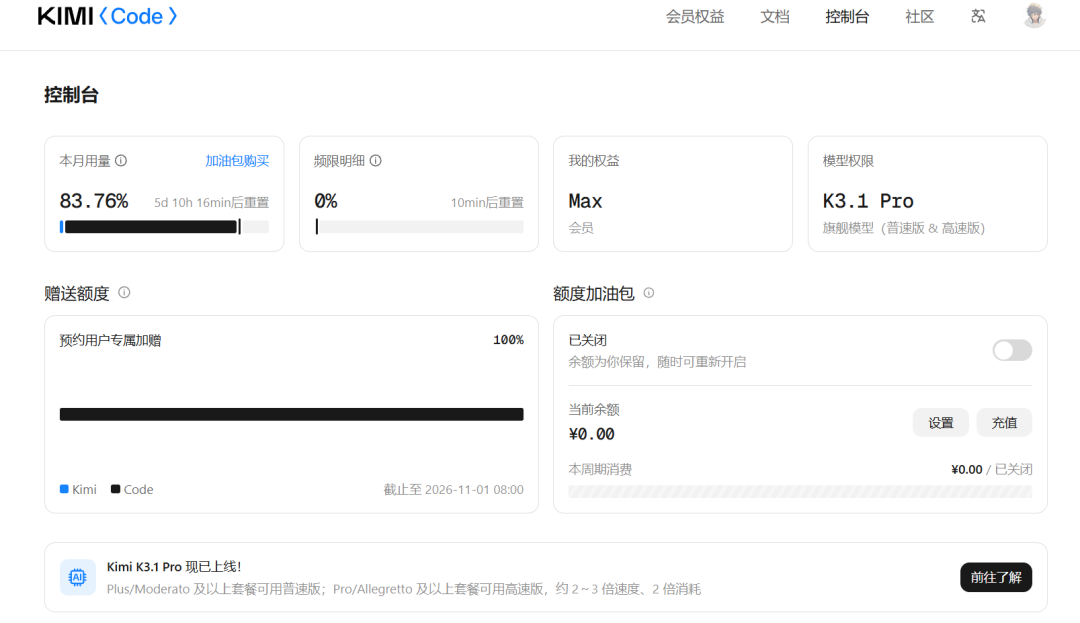
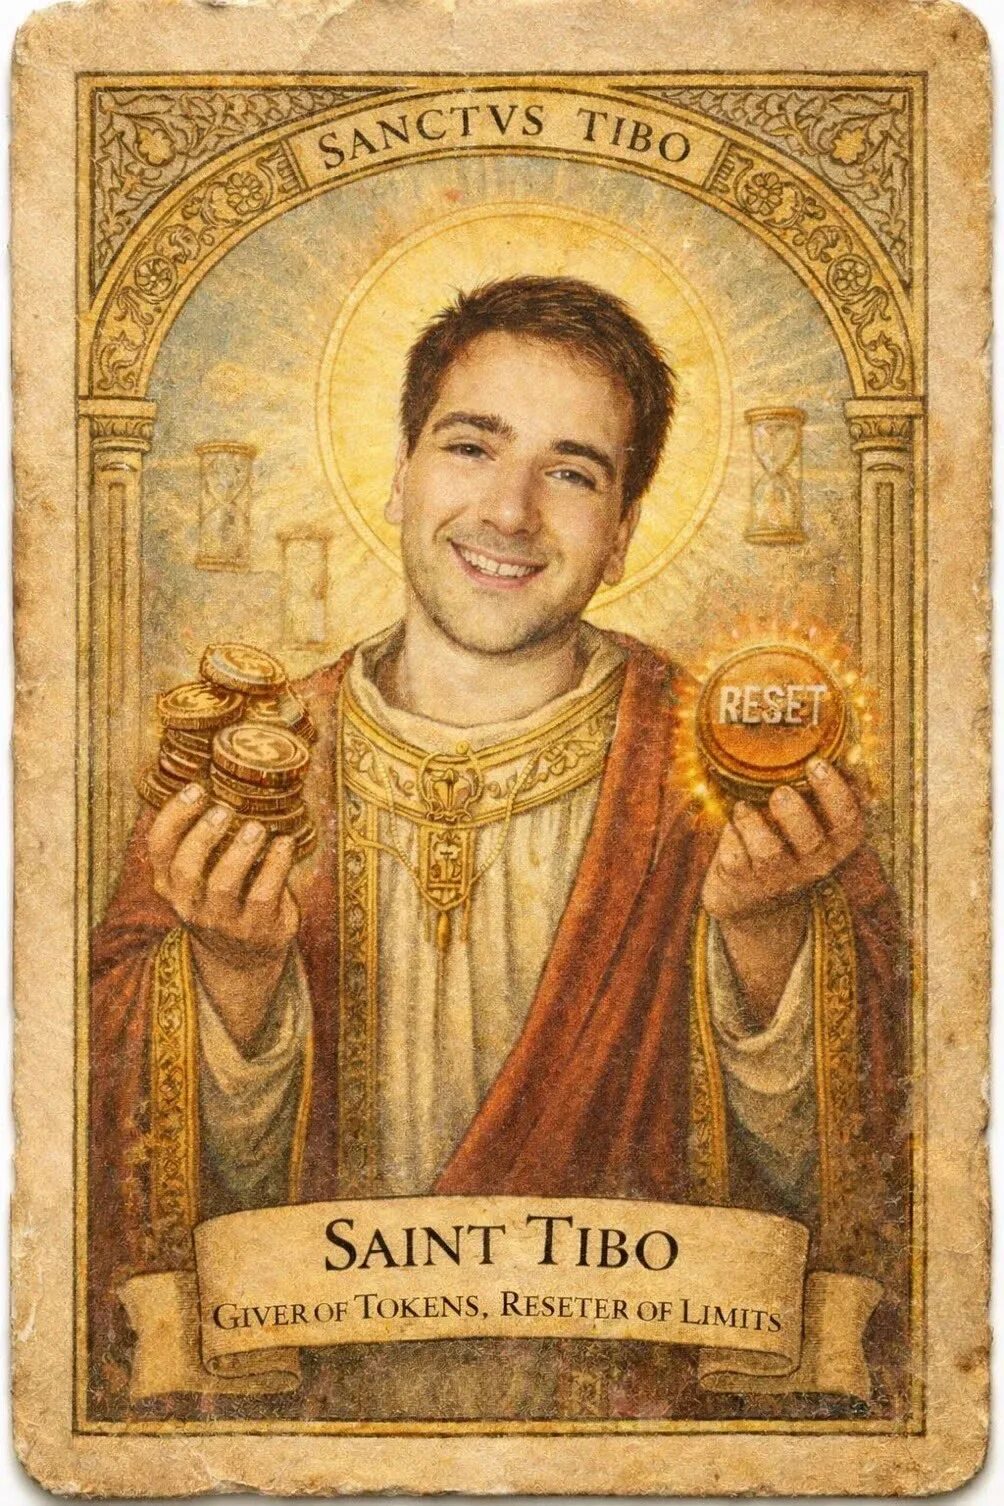
套餐已经卖到了这个价位,大家买回来却跑不了几个任务。期待官方后续能优化一下配额,实在不行,可以学习Tibo,让我们多领领鸡蛋。
写在最后
整理测评时,我们在朋友圈看到一位开发者写了这样一段话,挺有共鸣,分享给大家
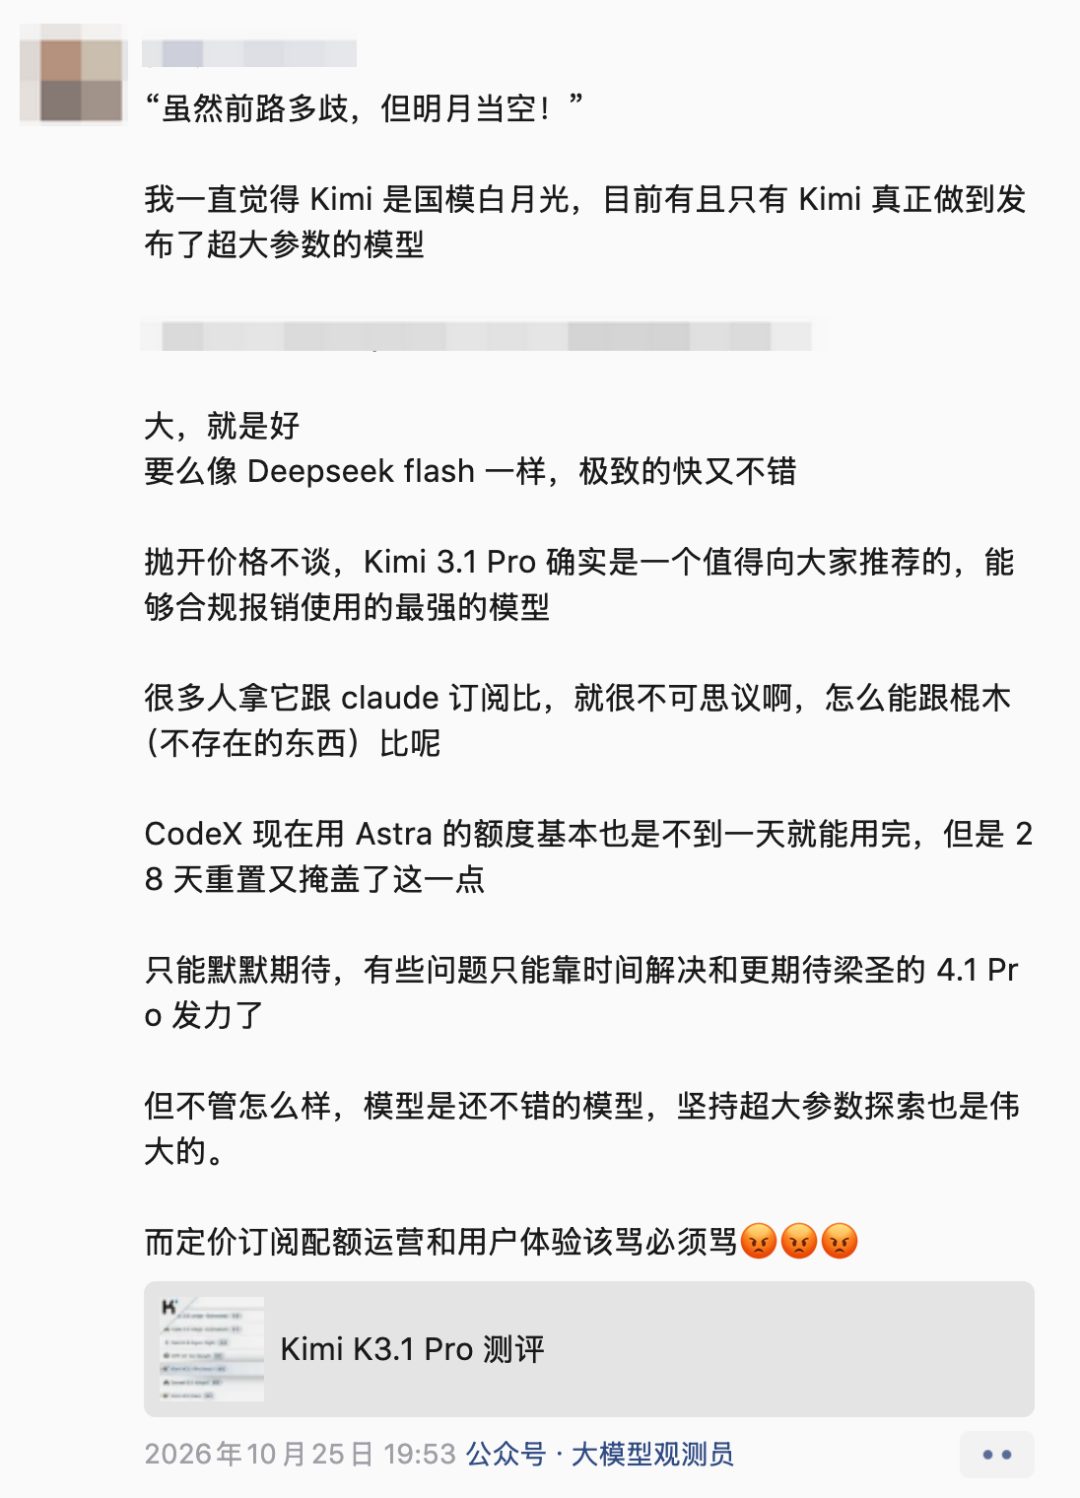
期待 Kimi 越来越好。
一起“点赞”三连↓
本文转载自微信公众号「Datawhale」,查看原文。版权归原作者所有,如有侵权请联系删除。