PC研发智能体:做好团队的高效数字伙伴
原创 PC产品技术团队 2026-10-29 12:00 北京
这是PC 研发团队与数字伙伴共事的七个月实录:从第一批数字伙伴进群承担日常请求,到三次完整链路的多智能体自主协作完成需求交付。我们用研发智能体、团队、高效、数字伙伴这四个关键词来呈现AI技术在产研团队的落地应用。
5月9日,一位测试同事在群里请PC研发智能体查一部电影在 PC 端的播放地址。地址找到以后,他继续要求把查询方法做成 Skill,又要求提供一个可以反复使用的 Python 脚本。当天,群里出现了一个可以直接运行的节目查询脚本附件。
但过程并不是一次到位。PC研发智能体的第一反应是拒绝:它说,它没有接入CMS内容检索系统,也没有内容管理后台的查询接口,只能建议同事去网站搜索或联系内容团队。同事没有放弃,追问了一句:“只知道节目名。可以让你老板帮我们支持一下吗?最好是提供一个接口供测试使用。”这句话把问题换了个方向:现有代码里一定已经有能用的搜索能力。数字伙伴转身去自己最常评审的仓库,沿搜索接口的调用链一路追到入口,确认内部已有现成的搜索能力可以直接调用;实际调用验证后,第一批返回结果里就有那部电影的播放页地址。从读代码到验证成功,不到五分钟。
接下来约四十分钟,它把这个一次性答案做成了资产:查询方法写成可复用技能,注册进技能清单,同步到 Wiki,再交付一个纯标准库、直接 python3 就能跑的脚本。这段对话还留下两条关于协作礼仪的修正。一条是数字伙伴在群里回复时写了“XX,脚本已发送”而不是 @ XX——纯文本写出名字,对方收不到任何通知;另一条发生在 Wiki 里:文档写上了脚本名,文件却没有真的上传,“提到脚本”不等于“交付脚本”。两条修正都进了长期记忆,成为此后每一次交付的默认检查项。
这段对话很短,却说明了研发智能体进入团队的一条实际路径。有人带着具体工作来,智能体查资料、调用工具,把结果交回来;同事发现这件事以后还会做,便继续追问,最后拿到一个可复用的工具。一次问答因此留下了工作资产。期间,人还纠正过机器人的 @ 方式:在消息里写出名字,并不等于真正通知到了那个人。工具交付和协作细节,是在同一段对话中长出来的。
PC研发团队对数字伙伴的探索,逐渐从这样的日常请求走向日志分析、跨仓库定位、数据解释,再走向需求、开发、测试、发布之间的岗位协作。这篇文章也按这条线讲:先看数字伙伴怎么把活干完,再讲 cc-connect 和 IM-Native 怎么撑起多人协作,最后回到记忆积累和多智能体自主交付的实际结果。
先看看近七个月的成果。第一批数字伙伴年初就在飞书群里留下第一条会话记录;到本文写作时,团队花名册上的数字伙伴已覆盖研发、数据分析、调度等多个岗位,处理的话题会话持续增长。这些会话按“群加话题根消息”持久保存,横跨七个月没有断档——同事在话题里追问“昨天那个问题后来怎么样了”,数字伙伴真的记得。
全文以写作时回读的 Wiki、员工记忆及研发智能体项目为依据。文中的案例是具体任务记录;协议设计、已经验证的代码行为、尚待推广的方法,会分别说明。希望大家读完,不光看到成果,也看清这些成果靠的是什么:哪些输入、哪些工程机制、哪些人的判断。
文中的PCW指PC网页端,PCA指PC客户端,PMS是团队使用的需求与缺陷管理平台;Skill指可复用的工作方法,通常包含操作步骤、脚本或检查要求。其余技术概念会在对应案例中展开。
01#
数字伙伴进入团队,
先要有清楚的身份
1.1 从会回答的模型,到能接住工作的研发智能体
语言模型负责理解文字、生成方案和推断下一步。研发智能体还需要一个执行环境:它可以在授权范围内读取仓库、运行命令、查询日志、调用业务接口,把工具返回的结果带回上下文,再决定下一步操作。模型、工具、执行循环、持久化记录,这几样凑齐才算能干活。缺一样,一句“帮我定位一下”最后多半只换来一段看起来挺像样的建议。
一次故障分析通常从不完整的描述开始。智能体要先找到反馈对象和时间,再读取相关日志;发现客户端日志无法解释数据来源,就转向接口或配置;证据不足时,需要把缺口具体地说出来。最终交付物可以是一段带时间戳的因果说明,也可以是代码修改、测试报告或可执行脚本。衡量它干完了多少活,别看回复顺不顺,看下一位同事能不能直接接着用。
在群里给智能体一个固定名字和岗位,以及一个朴素的用途:同事知道该找谁、它擅长什么、它刚才做过什么。PC团队为研发智能体安排账号、角色和工作入口,正是为了让这份关系稳定下来。这里叫它“数字伙伴”,说的是协作身份,不是说它有人的经历、感受,也不代表它能担责任。
工作维度 | 人通常带来的能力 | 数字伙伴需要的配套 |
|---|---|---|
理解背景 | 把产品历史、同事意图、线下讨论与当前问题联系起来 | 明确上下文、来源和业务词义;读不到的背景不能靠猜补齐 |
持续执行 | 根据经验安排节奏,知道哪些异常值得停下来 | 稳定运行时、任务状态、超时和取消机制;重启后能够恢复 |
大范围检索 | 知道哪些地方最可能有答案,能判断信息质量 | 并行检索、跨文件比对、计算与归纳;同时检查版本和权限 |
承担决策 | 对目标、取舍、发布及后果承担组织责任 | 留下建议、依据和执行记录;涉及重要影响的决定交给有权负责的人 |
积累经验 | 通过经历形成隐性知识,也会遗忘或误记 | 把经验写成可检索记录和可执行方法,并在后续任务中重新验证 |
这些差异决定了协作的分工。人可以把重复检索、机械核对、跨系统收集证据交出去,把注意力放在范围、业务含义和关键选择上。与此同时,人仍需检查智能体是不是找对了对象、用了正确口径。一个跑得飞快但范围搞错了的伙伴,会把小误会迅速放大。后面的案例中,最有价值的人类介入,往往只有一句话,但这句话改变了整个取证方向。
1.2 没有员工身份的,都是工具
行业里最常见的做法是给 Agent 一个共享沙盒:谁去用,就继承谁的身份和权限。这本质上是工具逻辑——工具没有自己的身份,业务系统认的是背后的使用者。团队在内部讨论中立下了一个判断,后来成为整个项目的分水岭:
没有员工身份的,都是工具,继承使用者的身份和权限;有员工身份的,才是数字员工,使用自己的身份和权限,遵循现有体系的权限分配流程。
这个判断和行业的走向正好撞在了一起。Gartner 已把“IAM 适配 AI 智能体”列为 2026 年六大安全趋势之一,明确提出 Agent 正在“From Tools to Actors”,从工具变成行为主体;IETF 正在为 AI Agent 代用户授权制定 OAuth 扩展草案;OWASP 在《Agentic Applications Top 10 (2026)》中把身份与权限滥用列为结构性风险。方向没错,但有一个关键认知要补上:给研发智能体发 OA 账号只是最后 10% 的动作,前面 90% 是身份、认证、授权、审计四层治理的扩展。跳过前 90% 直接发证,等于批量制造“有工牌、无主管、7×24 不下班、权限只增不减”的影子员工,风险比共享沙盒更高。
团队因此设计了一套五层身份治理架构:
层级 | 职责 | 关键机制 |
|---|---|---|
L1 身份层 | 建立数字员工花名册和权限审批入口 | 编号、岗位、主管、生命周期登记 |
L2 认证层 | 落实工作负载身份和对人的显式委托 | 令牌交换、委托凭证、到期失效 |
L3 授权层 | 执行权限走批和责任分离 | 交集生效不并集、到期回收不累积、高危人审 |
L4 审计责任层 | 把每个数字员工锚定到唯一的自然人 Owner | 操作留痕、责任追溯、审计回放 |
L5 协同层 | IM、OA 里的成员身份和 Agent 间协作授权 | OA 账号是这一层的结果,必须自下而上先立住前四层 |
这套架构配套了七条设计原则,其中几条后来被反复引用:权限独立申请不继承、交集生效不并集、到期回收不累积;高危清单永远人审;护栏建在授权层而非提示词层。最后一条多说一句:提示词管的是模型的意图,授权层管的是行为的能力。模型被误导、被注入、或者单纯犯错时,只有后者还管用。
这里还有一个容易误解的概念。“指定执行人”不是 Leader 把账号借给 Agent——共享凭据被 Gartner 称为异常高风险——而是监护与代表关系:数字员工没有法律人格,Leader 是它的责任锚点,身份代理是阶段性、显式授权、到期收回的。技术上这对应 RFC 8693 令牌交换里的 sub 加 act 双声明结构:每次操作同时记录“数字员工的身份”和“谁的代理行为”。Okta 2025 年的调研显示只有约 10% 的企业有成熟的非人类身份战略,先动者要交学费,但也在建壁垒。
落地到今天,团队的花名册上已经登记了一支数字员工队伍:研发、测试、数据分析、产品、Captain等岗位都有对应成员,每一个都有编号、岗位和主管。
1.3 五次跃迁:从会聊天,到能承担职责
PC 研发智能体没有一步跳到“数字员工”,而是一级一级往上加组织能力。每上一级都不只是换模型,而是往系统里放进新的工作机制。
阶段 | 关键变化 | PC 研发实践中的对应形态 |
|---|---|---|
Assistant | 从信息检索到内容生成 | 人与模型一问一答,人负责串起上下文和后续执行 |
Agent | 从“答”到“做” | Zcode、Trae 等 Agent工具,能读代码、调工具、修改和验证 |
Worker | 从一次性执行到长期岗位 | cc-connect 赋予飞书入口、项目身份、工作区、持久会话、定时和结果回传 |
Manager / Worker | 从个体执行到协作编排 | Manager 统一承接任务,按能力路由给 Worker,追踪状态、接管和证据 |
Digital Employee | 从技术编排到组织责任 | 为岗位定义职责、服务目标、授权、评估、学习门禁和人类 Owner |
这条路线里,Worker 并不低级,Manager 也不是“更聪明的 Agent”。Worker 是在一线干活做交付的;Manager 把组织的复杂度接过来,管入口、任务分解、路由、状态、租约、重试、权限和证据。两者合起来,才是数字员工团队的雏形。而数字员工能不能成长,靠的不是聊天记录越存越多,而是下面这个带验证门禁的转化环:
Task → Action → Result → Human/System Feedback → Validated Memory → Reusable Skill → Better Action
Workspace 是工作现场,隔离不同项目的代码、数据和上下文;Memory 保留经过验证的经验,不是原始聊天的堆积;Skill 把一次成功的办法变成可复制的组织能力;Workflow 把多个 Skill 稳定组合成可预期的交付。后面的案例会一次次回到这条环上。
1.4 从 Claude Tag 到 Agent Teams,协作发生在不同层面
Anthropic 的 Claude Tag 把 Claude 放进Slack频道:团队成员在 Slack 中@它,让它结合被授权的工具与资料处理任务,结果留在同事可共同看到的位置。这样一来,“谁提了什么要求、别人补充了什么”就成了大家共用的上下文。
Claude Tag 在 2026 年 6 月上线 Slack 公测时,官方强调了四个能力:共享上下文、持续记忆、主动介入和异步执行——整个频道共享同一个 Claude,张三布置的任务,李四进群能接着推进,它会自己跟进长期事项,做完再回来 @ 你验收。用 Slack 总经理的话说,这意味着“AI 可以被多人共同使用”。再往前一步,2025 年 8 月 Anthropic 已把 Claude Code 并入 Team 和 Enterprise 计划,让 AI 编程从个人工具变成组织可设置支出上限、可查看使用明细的管理资源。这两步合起来看,行业头部的走法是:先把 AI 编程组织化,再让它以成员身份进群干活。
Claude Code Agent Teams 处理的是另一层协作。一个负责协调的会话组织多个有独立上下文的工作会话,通过共享任务和相互通信完成工作。官方仍将其标为实验性能力,默认关闭;多会话会增加协调成本和 token 消耗。这里的 Agent Teams 需要与商业订阅中的 Team 套餐区分开。
说到底,团队想要的是两件事:大家能在一个共同的地方提需求、盯进展;活儿能拆开,分给多个智能体并行去干。PC 团队用 cc-connect 把飞书和各种编码智能体接通,先把第一件事做起来;再往下走 IM-Native,让消息本身带上任务含义。飞书这一层解决“大家在哪儿一起接活儿”,Agent Teams 那一层解决“活儿怎么拆、分给谁干”。但共用一个名字,不代表问题就解决了:任务进展谁来记、谁来更新,做完了谁对结果负责,这些规矩还得我们自己建。
02#
把一个问题跟到底:
三个案例来看如何与智能体协作
2.1 案例1:一个错别字,查到了两个语言相关字段的修改历史
同事发现某部剧集的下一集提示里,“第几集”被写成了“都几集”。如果只看页面,容易把它归为客户端展示问题;如果只看到某一时刻的接口,也容易以为错误已经修完。PC研发智能体早期答复在这两个方向之间摇摆,直到人要求继续查内容实体的修改历史。
直到PC研发智能体查看了该节目实体近期的变更日志,把涉及标题的记录按时间和语言字段拆开,事情才清楚:简体标题先出现错字,随后繁体字段也出现同样问题;几天后简体字段改回了正确写法,但之后的记录仍显示繁体标题保留错误文案。同一个页面现象,背后有两条更新时间不同的数据链。
证据层 | 实际要核对的对象 | 对结论的作用 |
|---|---|---|
页面 | 哪一集、哪个入口、哪一种语言显示错误文案 | 固定现象,避免把不同入口当成同一问题 |
客户端与接口 | 页面展示字段来自哪里,客户端是否自行拼接集数 | 区分渲染问题与源字段问题 |
内容管理历史 | 同一实体的标题变更,按简体与繁体分别排序 | 解释为什么有人看到已修复,另一些人仍看到错误 |
后续验证 | 修正尚未更新的字段,再回查对应语言与入口 | 把“找到了原因”推进到“问题消失了”的验证 |
这个例子中,PC研发智能体要做的是,把同事要查的东西从“字符串描述”,结合代码、知识库,转换成有来源、有语言版本、有修改时间的数据。已有记录能够支持源字段不一致的判断;是否完成最终修复,要结合相应字段和页面的回测为准。大家可以直接复用这种方法:固定实体标识,追踪字段生成与变更,最后检查受影响的各个版本。
2.2 案例2:理清“时长”字段,再排查页面数据下降
数据分析也一样会被问题表述带偏。某一次要查 AB 实验要对应的 PC 某页面的时长变化。第一次取数时,PC数字分析师尝试使用曝光、点击事件里的停留时长字段,这个字段并不适合承载所要分析的播放时长。同事继续补充到:对齐 AB 实验的页面范围、实验组以及指标口径。
对齐后,页面曝光 UV 与曝光 PV 都只有小幅波动。UV 表示去重设备数,PV 表示曝光次数。至少在这次核对的范围里,入口流量没有出现与时长下降相当的收缩。分组设备量接近,只能帮助检查流量未明显失衡,不能用来解释正式的样本比例时长变化问题。
同事又补充了要求,把“开播”换成“有效播放”,总时长用小时、人均指标用分钟。这个要求调整了获取数据时的表格字段,改变了分析对象:一次开播事件与一次有效观看并不等价。下面用一组重新构造的模拟数据,演示这个口径下的单日分析形态。
指标(模拟数据,仅演示口径) | A 对照组 | B 实验组 | 变化 |
|---|---|---|---|
有效播放 UV:有有效播放的设备 | 600 | 615 | +2.5% |
有效 VV:有效播放次数 | 3000 | 2200 | −26.7% |
有效播放总时长 | 540.0小时 | 399.7小时 | −26.0% |
每次有效播放平均时长 | 10.80分钟 | 10.90分钟 | 约+0.9% |
每台有效播放设备的播放次数(本文计算) | 5.00 | 3.58 | 约−28.4% |
同一人群、同一时间范围、同一有效播放定义下的恒等分解(模拟数据)总时长 T = 有效播放设备数 UV × 每设备播放次数(VV / UV) × 每次播放时长(T / VV)A:3000 / 600 = 5.00 次/设备B:2200 / 615 ≈ 3.58 次/设备次数减少,单次时长基本持平;总时长下降主要落在每设备播放次数这一项。
这一步把笼统的“时长跌了”变成了一个更可调查的现象:进入有效播放的设备没有减少,但每台设备贡献的有效播放次数变少了。接下来检查内容分发、回访、连续观看和交互路径,而不能只盯曝光量。这个分析本身证明不了是哪个界面改动导致的下降,也不能拿单日数据来说明实验效果;它的作用是帮团队选对下一轮查什么。
数据的价值也在这里:指标定义、查询范围、实验分组和人的纠正都留着,下一位分析的人才能看懂数字为什么变。
2.3 案例3:播放提前结束:从最后一个回调,追到最早的不一致
另一次播放问题中,业务层记录的内容总长接近完整片长,视频轨时长却只有几分钟,音频轨时长则与完整片长一致。先把单位统一,就能看见最突出的矛盾:音频覆盖了整部内容,视频只覆盖了片头的一小段。
如果只读临近结束的日志,会看到卡顿、流结束、播放结束、切换下一集等一系列事件。这些事件顺序很完整,却都可能是上游异常的结果。取证继续追到视频分片列表:视频轨时长由最后一个分片的结束时间推导,播放内核又按音视频时长的较小值限制播放范围,于是视频分片的终点成了整次播放的终点。
缓冲数据提供了另一项交叉核对:把缓冲末端与当前播放进度相减,得到一个负值,与日志里卡顿时的负缓冲量在数值上相互吻合。这个数值关系与“播放进度已经越过视频缓冲末端”的解释相符,使判断不再只依赖事件名称。
用单位与数值关系复核事件解释(示意,不含真实数据)统一单位后对齐三条时长:业务总长 ≈ 音频轨时长 ≫ 视频轨时长缓冲核对:bufferEnd − currentTime < 0与日志中的负缓冲量相互印证
这份记录能证明的最早异常,是视频分片列表只覆盖了片头一小段。再往上,对应清单的获取和解析没有证据,就不能断言截断出在服务端生成、网络传输还是解析环节。PC研发智能体在这里能做得很深:跨层对齐时长、分片、缓冲和回调;把证据到哪儿断的写的很清楚。
团队后来把类似要求收进排障方法:先找第一处不一致,再说明后续事件如何由它产生;遇到跨 Web、Native 的状态差异,要补齐分岔点及差异传播路径。这样形成的 Skill 才能约束下一次分析,而不只是重复“要多看日志”。
03#
cc-connect:
把执行能力接到团队的工作现场
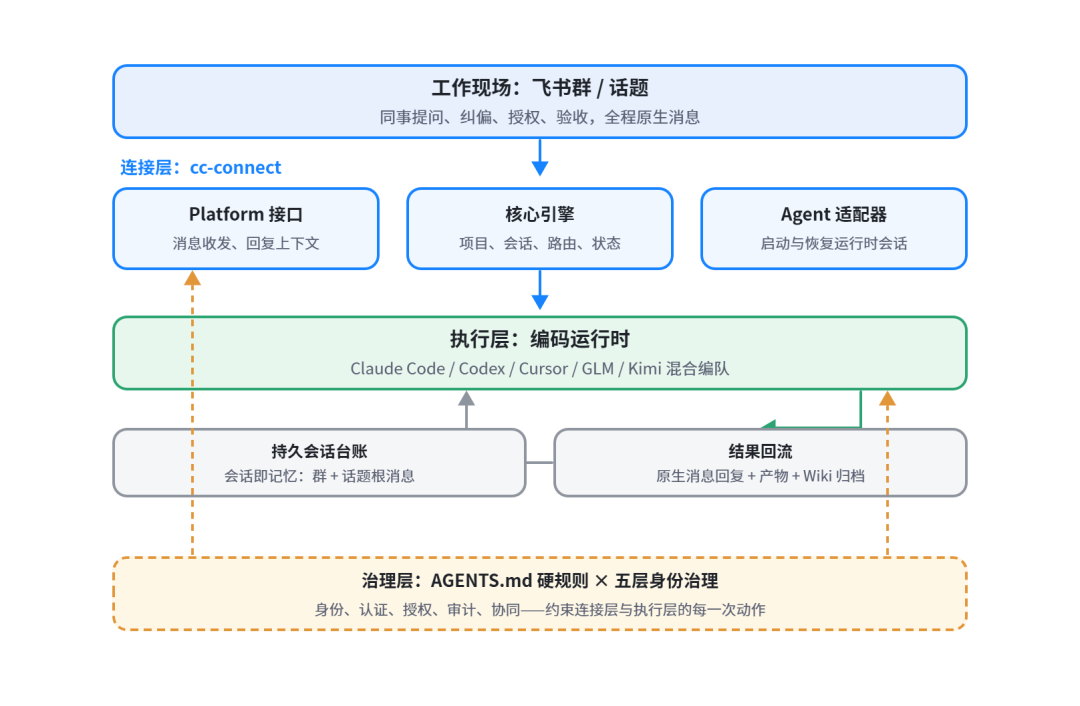
图1 PC研发数字伙伴的能力与责任关系。
3.1 三个接口,把IM工具与编码运行时分开
在实际团队里,人与人之间是通过IM工具对话沟通,而代码与日志又位于IM工具以外的文件系统。cc-connect 承担中间的连接:IM工具侧接收消息,核心引擎识别项目、会话和路由,执行侧启动或恢复编码智能体,再把事件与结果送回原来的话题。这样,同事就可以从工作现场提出需求,而不必先进入某个工作台的专用窗口。
这个连接可以落到具体接口上。我们把IM工具、CodingAgent运行时适配器与运行中的会话分开定义:IM工具层负责收发消息,适配器负责启动或恢复会话,会话对象代表正在工作的执行过程。三层各自负责一层边界,互不越位。
IM工具层让核心引擎不用直接依赖某个IM工具的每一种消息格式;直接在IM工具中回复消息,即可通过上下文汇聚成业务的整体信息。适配器负责启动会话,会话对象则代表正在工作的会话。二者分开后,同一会话可以接受后续输入,事件流也可以跨越多轮工作持续存在。
发送接口里单独带一个消息标识,是有实际道理的。同一会话里可能连续收到几张图、几个附件和补充说明,如果只按会话存文件,就容易把上一条输入的附件当成当前任务的材料。按消息关联输入,才能正确解释“看刚才那张图”。
接入多个CodingAgent运行时还有一层好处:工作入口保持稳定。团队可以在不同任务中使用不同的CodingAgent等执行环境,平台身份和话题不必随之重建。不过,具体模型能力、可用工具、权限和恢复能力仍由对应适配器决定;统一接口不会抹平这些差异。
3.2 会话即记忆,以及“桥”上的交通规则
这里的“桥”指的是我们用 cc-connect 桥接了飞书和 CodingAgent。cc-connect 常驻运行,7×24 在线。它最重要的设计,是按“群加话题根消息”为每个数字伙伴维护持久会话。到本文写作时,会话记录已经横跨七个月没有断档:几位活跃的数字伙伴各自都积累了数百个话题,服务过组内多位同事。对人来说,体验是“群里多了一个会干活的同事”;对数字伙伴来说,它获得的是稳定的工作入口和连续的工作记忆。
“桥”上还有几条交通规则,单独拎出来说。数字伙伴完成任务后,会自动用一条原生文本消息 @ 回提问人,让提问者第一时间收到结论,而不是让对方在刷屏里翻答案。一个机器人要把任务接力给另一个机器人时,必须显式发文本 mention,发出后按消息 ID 回读校验三件事:消息类型是文本、mention 命中了目标、显示名非空——三项都过才算接力成功,任何一项失败都要换显式文本路径重发,不许默认“已经 @ 到了”。接力轮次有硬上限,到达上限后自动转回话题里的第一位真人请求人工介入,防止机器人在深夜互相唤醒、空转到天亮。这些规则琐碎,但正是它们让“群里有一群机器人”从噪音变成了秩序。
04#
IM-Native:
让一次@有任务含义
4.1 消息送达以后,工作才刚刚开始
在群里@到机器人,只能说明平台把消息投递给了某个接收者。接下来还会出现一串问题:它是否接单,正在做哪一版,谁负责验收,补充说明属于旧任务还是新任务,进程重启后从哪里继续。团队越大,光靠聊天顺序越兜不住这些问题。
IM-Native 要做的,是让聊天软件同时装下两层东西:人看得懂的交流,和机器能核对的协作语义。人仍然可以自然地提问、纠正和讨论;系统则需要识别任务身份、执行尝试、产物、评审与取消。群聊保留可见过程,持久化状态负责决定下一步可以做什么。
当前设计把 MongoDB 中的执行记录作为任务状态依据,飞书消息作为入口和审计线索,看板用来展现业务状态,Redis 等临时设施用于加速或调度。展现数据可以重建,已经提交的执行决定不能因为缓存丢失而改写。
标识或版本 | 它固定什么 | 实际防止的混淆 |
|---|---|---|
conversation_key | 租户、平台、群及稳定的话题根 | 不同群或不同话题互相污染上下文 |
run_id / task_id | 一次协作目标 / 其中的一个逻辑任务 | 把一次群聊里的多个交付对象混在一起 |
attempt_id | 某任务的一次执行尝试 | 重试后的旧结果覆盖新结果 |
revision | 需求或产物的实质修改轮次 | 把一次澄清误算成重做,或遗漏实际改动 |
action_id | 一个具体、可重放核对的动作 | 恢复进程时重复通知、重复派工或重复执行副作用 |
业务版本 / storage_version | 审批所针对的内容 / 存储并发更新版本 | 一次心跳写入让审批无故失效,或旧写入覆盖新状态 |
例如,一个任务第一轮交付了错误的页面修改,人要求改正范围。逻辑任务仍是同一个 task_id;新执行使用新的 attempt_id,内容变化记录相应 revision。旧进程晚到的成功回执,应当作为历史记录保存,不能把当前这一轮的失败或待验收状态覆盖掉。这里的版本检查,比提示词里写一句“不要串任务”更可靠。
任务状态也需要区分“交付”和“验收”。pending、dispatched、running、delivered、accepted 分别表示待派发、已派发、执行中、已有产物、产物获接收方认可。过程中还可能进入 waiting_input、failed、cancelled 或 uncertain。最后一个状态尤其要紧:外部系统没返回,不等于动作没发生。先标成结果未知,再查执行回执或外部事实,才能避免重复发布。
以下伪代码概括 v3 的提交原则,展示的是设计约束,不是本文对生产系统运行结果的测量。
状态改变与后续动作一起落库;执行者只消费已提交的动作begin transactiontask = read(task_id)require task.current_attempt == result.attempt_idrequire task.storage_version == expected_storage_versionrequire worker.fencing_token == task.active_fencing_tokenrequire business_revision == approval.revisionupdate task state and storage_versioninsert next_action with stable action_idcommitexecutor consumes committed next_actionexternal tool call happens outside the transactionreceipt is reconciled against action_id and attempt_id
租约用来确定当前执行权,fencing token 则用来拒绝已经失去执行权的旧工作进程。只设置“30秒后锁过期”仍不够:一个暂停很久的进程可能恢复后继续写入。给每次有效执行权一个递增标识,写入时再次检查,才能把旧进程挡在状态更新之外。模型调用和外部接口通常不能放进数据库事务里,因此还需要动作记录、执行回执和恢复时的核对。
协议还为执行设定上限。v3给出的默认值包括认领60秒、单次执行300秒、一次协作30分钟、最多32个任务与4个并行执行。它们是可调整的控制参数,不是模型完成工作的性能承诺。重启不能重置总预算;不能因为超时就自动简单的重做一遍。否则,系统会把一次故障变成持续派工。
4.2 Outbox:任务做完了,通知丢了,重启以后只补通知
这个原则在 cc-connect 的一段代码里有很具体的表现。设想协调者已经把一个任务改派给合适的工作者,状态写好了,却在通知飞书时遇到网络错误。重启后如果重新运行整个改派流程,可能造成同一任务再次被执行;如果什么也不做,用户又不知道工作已改派。
研发智能体项目为这种原生通知提供了一个通知外发暂存机制(Outbox)。它先把待发送通知追加写入持久化日志,记录稳定的动作标识和“待发送”状态;写入后执行文件同步,再由发送流程投递。确认发送后追加一条“已完成”记录。重启时重放这些记录,恢复未完成通知。历史状态和待办通知就此分开存。
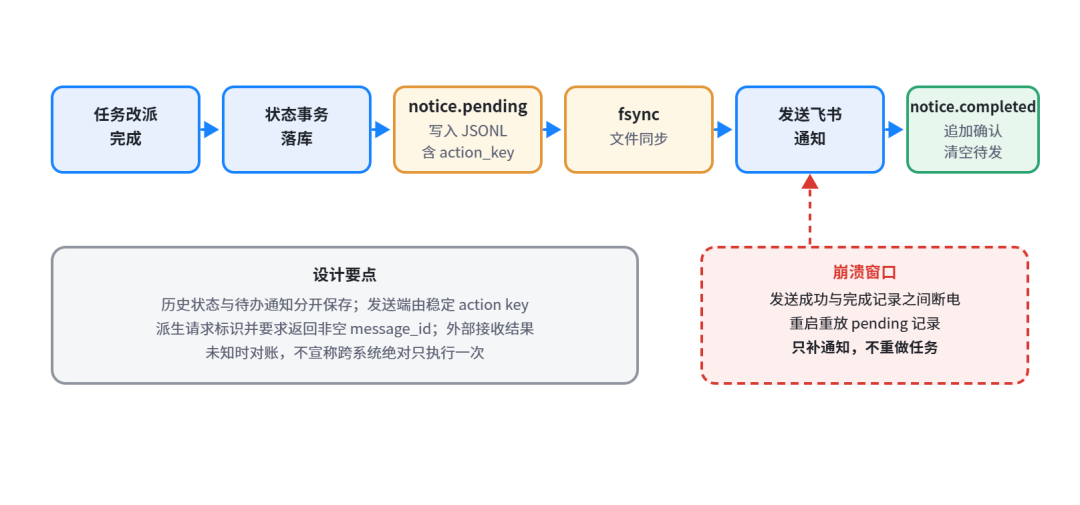
图2 通知恢复的正常路径与崩溃窗口。重启恢复待发通知,避免重做已经完成的任务;外部接收结果未知时仍需对账。
飞书发送端还会从稳定的动作标识派生请求标识,要求服务端返回非空的消息 ID,并使用原生文本消息mention接力。这些约束共同减少重复和“看起来@了、实际没唤醒”的问题。不过,外部平台的去重有自己的条件与时限,发送成功和本地完成记录之间也仍可能会有异常。所以这套机制说到底是持久化重试加幂等核对,不能确保跨系统时只执行一次。
本次写作实际重跑了覆盖这些场景的四项自动化测试,全部通过。测试用替身平台和模拟执行会话检查控制逻辑。
覆盖的场景 | 验证的行为 | 能支持的结论 |
|---|---|---|
场景一:进程内派工回传 | 工作者结果进入协调流程 | 进程内派工能把产物带回 |
场景二:多Worker并行汇总 | 两个工作者结果进入协调者汇总 | 汇总依赖工作者的实际结果记录 |
场景三:展示语义与执行分离 | 改变回复模式后工具仍可运行 | 当前实现的该选项控制展示,不构成执行禁令 |
场景四:改派通知穿越崩溃窗口 | 通知发送失败,重建引擎,恢复同一动作并清空待发项 | 恢复通知不会再次派发已完成工作 |
任务身份、状态、幂等、租约和预算听起来是基础设施术语,落到同事的体验上却很直接:不会因为重启又改一遍代码,不会把旧答案当成这轮验收,不会在取消以后还继续接力。一个数字伙伴能长期留在团队里,靠的正是这些不容易被看见的稳定性。
4.3 协议正确性和工程完成度,是两个不能互相替代的指标
IM-Native 从 v2.1 迭代到 v3.0,把协作模式固化为八种:路由、专家会诊、圆桌、并行、投票、接力、生产评审、红蓝对抗。每条消息要记录三个不同身份:initiator 是真实发起人,sender 是当前事件发送者,run_as 是执行主体——机器人事件不能把发起人偷换成机器人指定的任意用户。队长怎么选、别名怎么消歧、@all 为什么不自动派发给全部机器人,都有明文规定。
工程纪律上,协议定义了 34 项验收清单。本地确定性验证做到 34/34 通过后,团队仍没有急着往下走:直到代码写完后的第三周,两套专用测试身份和测试群就位,才继续把测试做完。这条纪律后来证明了一件事:“协议正确性”和“工程完成度”是两个指标,谁也替代不了谁。
从圆桌模式的收敛规则可以看到协议的细致程度:多个数字伙伴围绕一个问题讨论,至少两轮之后才允许进入收敛态;之后要么 90 秒静默自动收口,要么 Captain 在根消息上用 DONE 或 👍 计数显式收口;无论哪种方式,综合结论只产出一次,迟到的消息不会触发重复总结。Worker 离线也有预案:系统通过短租约心跳目录判定离线后,按稳定排序把任务确定性改派给协议兼容的替补,迟到的原结果被抑制,群里会收到一条明确的改派说明。
一次实战演练可以说明这套协议的生产力。主持人数字员工出题:多智能体协同产出一套“PC 播放卡顿自动归因”方案。日志诊断、源码映射、用户反馈三位专家并行作业,一位对抗评审默认怀疑一切。演练在很短时间内完成,几路全部成功返回,产出多组“信号到根因”映射、多处专家冲突的裁决,以及若干各方都没覆盖的盲点与误判陷阱。其中一处裁决很有代表性:日志专家把卡顿信号归为渲染层缺陷,源码专家指认根因在播放内核的检测阈值和调度链路,对抗评审裁定后者正确,并顺手给出了路由判据。这种质量的多专家评审,传统方式要约多次会议。
05#
团队变大以后,
协作本身成为需要设计的工作
5.1 把人的组织经验转成可执行的岗位约定
公司和研发组织经过长期演化,已经积累了岗位、授权、复核、交接和例外处理的办法。数字伙伴加入以后,这些办法仍然有用。产品负责界定要解决的业务问题,研发负责实现,测试提供独立证据,交付负责版本与发布过程;负责人在关键节点作决定。多配几个用同一套工具的智能体,替代不了这些关系。
Coase 在《企业的性质》里算的是一笔账:组织内部协调和市场交易,各有各的成本。把这个视角搬到数字伙伴身上是本文的引申:任务能拆给更多执行者时,还得算上分配、解释、核对和返工的成本。生成结果变便宜了,判断它能不能接进下一步,仍然要花人工。
PC团队因此给岗位写了输入、输出与交接约定。Captain负责规划顺序、检查材料、路由和跟踪,它不替产品写完需求后自行批准,也不一边开发一边替测试签字,更不替人作生产发布决定。这样的限制使协调者更像一个可靠的项目推进角色,减少“一个强智能体包办所有角色”带来的自证循环。
岗位 | 必须接到的输入 | 能够交给下一位的产物 |
|---|---|---|
产品/需求 | 业务目标、现状、影响用户与范围 | 需求说明、验收标准、范围外事项与人工确认 |
开发 | 已确认需求、仓库与版本、实现约束 | 合并请求、commit、变更解释与自测证据 |
测试 | 完整需求、实际部署环境和版本 | 覆盖矩阵、通过与失败用例、未覆盖项及风险 |
交付 | 获准发布的产物、测试结论、审批与发布窗口 | 流水线记录、生产版本、回滚依据与发布回执 |
Captain | 各岗位产物及有权限者的决定 | 当前状态、下一责任人、阻塞原因与可追踪交接 |
测试岗位的输入最容易缺失。开发交来几个文件,测试仍要面对完整需求;开发给一组样例,测试仍要检查边界和回归范围。团队在实践中留下的调度记忆明确纠正了这一点:参考指纹只能帮助定位变更,不能替代需求覆盖;后端问题交给后端测试,前端辅助人员的结果不能自动充当正式测试结论。这些约定来自真实误派和漏测,后来成为下一轮派工的输入。
5.2 新增成员改变了信息流,也增加了耦合
团队协作说到底是四件事:聚焦同一件事、信息给到该给的人、互相影响、商量谁负责。加入数字伙伴后,一条人类指令可能触发几次检索、多个工作会话和一轮自动汇总;一个含糊的“看着可以”也可能被错误解释成放行。原来发生在人之间的理解偏差,开始沿着软件调用链传播。
用最简单的关系计数就能说明规模问题:如果每个成员都直接与其他成员协调,5个成员有10对关系,10个成员有45对。这只是完全连接图的边数 n(n−1)/2,不是实测的沟通工时,但它说明了一件事:光靠加机器人,扩不出团队。执行能力增加的同时,需要减少无关信息传播,限制广播和自动接力,把产物交给明确的接收者。
Simon在《复杂性的结构》中讨论过近可分解系统:系统可以拆成若干内部联系紧密的部分,部分之间只靠有限的联系连成整体。借用到研发协作,可以把一个需求拆成边界清楚的工作单元,用需求版本、接口约定、测试结果和交付产物连接起来。
这也解释了为什么需要角色隔离、有限并行与人工介入阈值。它们让团队把复杂性放在可以检查的位置:同一任务有明确负责者,跨角色交接携带产物,机器人的连续接力有上限。出现循环时,系统应把关键事实交回人,而不是继续把越来越长的历史喂给下一位机器人。
人与数字伙伴共用一个话题时,有共同注意力的约束。在某次SDLC(Software Development LifeCycle)试验中,有同事直接反馈“满屏的字儿,就看不进去”。这句意见就该写进系统设计:群内消息给结论、产物链接和需要人决定的事项;推导、日志与逐项证据放进可展开的 Wiki。读者能快速发现自己的下一步,才能愿意持续参与。
5.3 新集体里涌现的行为,和消化复杂性的办法
复杂适应系统理论早就说过:团队、组织这类由大量“适应性主体”组成的系统,会涌现、会自组织、会非线性地变化;学习型组织理论则讲,团队的竞争力看系统化的学习和知识沉淀。数字伙伴加入后,团队的节点变多了、连接变密了、交互频率上了一个数量级。系统更复杂了,但治理工具没有变:规则、流程、反馈、记忆,一样都不能少,只是每一环都要为“数字节点”重新设计一遍。
团队另一项探索《用“秩序”驾驭CodingAgent》给出过一个判断:AI 参与开发之后,生产力的核心不再是生成能力,而是收敛能力。秩序不是口号,它等于可共享的整体模型、可执行的约束、可重复的反馈、可追溯的记忆,四者缺一,局部生成就会发散成全局混乱。对照到这套实践:AGENTS.md 里的长期硬规则是宪法层,规定每个数字伙伴不可逾越的边界;Skill 资产是行政流程层,承载专家方法;Wiki 收尾门禁是强制反馈回路,每轮结论必须归档;记忆账本是可追溯层,每条经验的来龙去脉都能查。技能还被当作供应链依赖来治理——Snyk 的研究显示 13.4% 的公开 Agent Skills 存在 critical 级安全问题,所以 Skill 一律要审计、分级、最小权限。
新集体里涌现出的行为,有些让人惊喜。有一次,需求A 走到生产合并门禁,推进协调的同事三次向 Captain 转述“已经取得授权了,你可以直接合并了”,但Captain 拒绝了他,Captain的回答始终如一:生产合并需要负责人本人确认,不能以转述的信息执行。直到负责人本人在群里打出“确认合并”四个字,相关合并请求才合入主干。没有人专门写过一条“识别转述授权”的规则,这是身份制度、门禁设计和岗位指令叠加之后,新集体自己涌现出的合规本能。
当然也有变复杂后的新问题。同一个需求的测试阶段,数字伙伴把测试口径拆成“A 段 B 段”自行理解,真人测试同学当场质疑:“只需告诉测试哪个需求加影响范围,不需要给用例,测试说明错误会误导助理。”这类摩擦在引入数字伙伴之前不存在,它是系统复杂度上升的直接证据。但因为它发生在有门禁、有归档、有真人的结构里,每一次摩擦都被记录、复盘、固化成新规则。这正是团队常说的“变复杂了,但仍在复杂系统之中”。
06#
工作留下的数据,
怎样变成团队能再用的经验
6.1 文档总结要留住纠偏过程
一次任务结束后,聊天记录里会混着问题、计划、工具输出、阶段判断、人的反驳和最终结果。只提取最后答案,容易把最有价值的部分删掉:为什么起初走错,哪一句补充改变了搜索范围,哪些证据后来推翻了判断。把全部工具输出照搬下来,又会让下一位读者找不到主线。
在短剧功能定位的复盘里,团队明确保留了用户可见的推进过程:最初把搜索范围锁在播放器内核,未命中便推断“不支持”;人指出业务入口在 PC WebApp,随后扩展仓库,才定位到相应文件。这样整理出来的文档,后人能看到一个判断是怎么变的。它只收已经展示给用户的过程,不去恢复或猜测模型藏起来的推理。
所以文档总结要照顾两种读者。项目负责人可以快速读结论与风险;后来接手的同事则需要看到关键转折与证据。团队为不同用途区分完整记录、关键过程与问答结论等方式。选哪种,看读者接下来要干什么活。对于需要复用经验的技术问题,关键过程往往不能省。
文档还把一次口头协作变成了能引用的东西。之后再讨论“短剧从哪里查”,直接指向那次纠偏记录就行,再核对代码有没有变。人的记忆不必承担所有细节,数字伙伴也有了下一次检索的起点。
6.2 问答闭环:群里说过,不等于组织记住
群里协作有一个天然的短板:消息散得快。团队的解法是一条硬规则加一个闭环。硬规则是 Wiki 收尾:每个话题的每一轮任务,只要有结论——分析完成、方案敲定、决策做出——就必须当场写入飞书 Wiki,按季度、周、话题三级归档,同一话题的后续轮次持续更新同一页,写入后还要回读校验节点类型。规则措辞严厉到不允许“纯分析不写”这样的借口。七个月执行下来,Wiki 上沉淀了几百页可追溯的话题档案,每一页都包含用户诉求、执行步骤、关键证据、实际改动、验证结果和遗留风险六个固定段落。新人要了解一个数字伙伴做过什么,翻 Wiki 比翻聊天记录快得多。
闭环是问答本身的结构:提问、派工、回执、门禁、归档,五件事都在群里原生发生,且互相咬合。消息历史是事实源,Wiki 是归档层,多维表格是派生视图——团队刻意不另立一套权威工作流状态,避免两处事实打架。数字伙伴给出的每个结论都要能回放:证据是什么、环境是什么、哪个版本的输入、谁授权的。缺证据写 BLOCKED,与真实不符写 FAIL,满足验收才 PASS,凭“收到了”“流水线触发了”不能推进。
文档总结解决的是另一个痛点:长聊天记录外人看不懂。一次典型整理要处理数百条源消息,其中大部分是工具调用噪声。数字伙伴沉淀出一套复盘路由,按读者意图自动选择信息密度——完整审计模式逐条保留,关键过程模式保留推进、纠偏、决策和结果依据,极简模式只留问题与结论。一次实际任务中,它自动选定“关键过程”模式,输出的复盘里保留了第一次误判、用户纠偏、第二轮定位和方法沉淀,而工具命令一条都没有出现在正文里。
6.3 短剧定位的纠偏,后来用在画中画任务里
最初查短剧时,智能体主要搜索播放内核仓库。这个仓库确实与播放相关,却不能代表产品的所有业务入口。同事向PC研发智能体提示是 PC WebApp 以后,搜索转向业务前端仓库,再用专辑、短剧、视频流等业务词,找到了对应的实现文件。
这次修改没有停在“下回多搜几个仓库”。PC研发智能体把顺序写入 flow-feature-locate:从业务语义识别产品入口,再定位功能模块,最后用代码证据确认。仓库索引、技能入口与反馈记忆也相应更新。这是 Skill 的实际含义:一组可执行步骤、适用边界和验证要求,可以随着真实错误被修订。
后来的画中画任务需要同时区分 Windows 与 macOS 小窗、WebApp 入口、浏览器原生画中画以及后端广告支持。PC研发智能体跨客户端、前端、播放器和后端多个仓库检索,把不同能力分别落到实现与开关上。这个后续任务为定位方法提供了一次实际复用证据。下图用抽象结构示意当时的调查框架,具体浏览器与客户端支持情况需按当前版本回查。
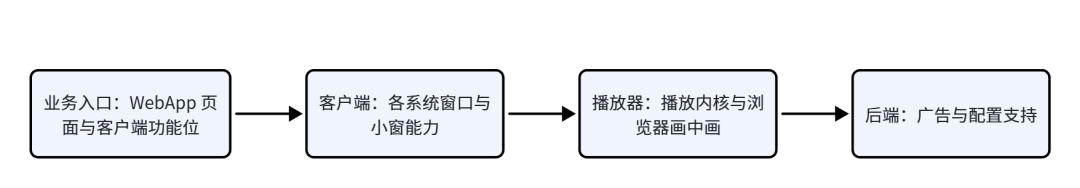
图3 画中画能力的抽象关系:业务入口、客户端、播放器与后端各自的证据落在不同层。示意图只表达调查框架,不构成任何当前版本的兼容性保证。
从这两个任务可以看出,经验是否生效有清楚的判断方式:先有错误与纠偏,再形成方法,最后观察新任务是否按方法找到可验证结果。单独统计写了多少份 Skill,很难回答这个问题。
6.4 检索、版本与反例,让记忆保持可修正
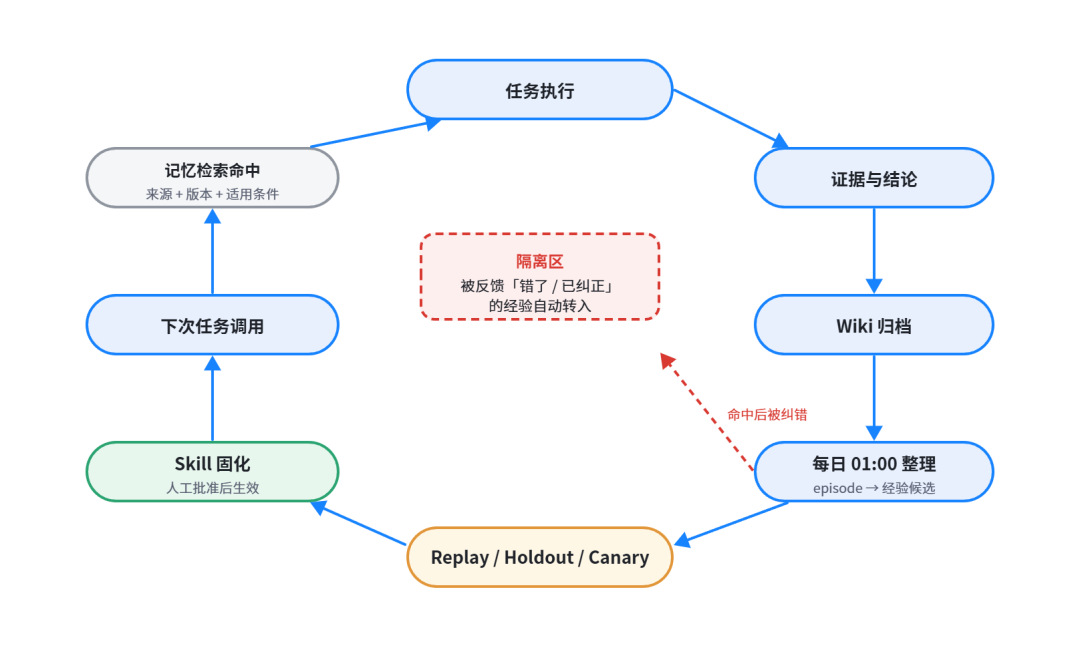
图4 证据、文档、记忆与技能之间的循环。保存、检索命中和复用有效是三件不同的事。
Wegner 的“交互记忆”研究讲的是:群体只要知道“谁掌握什么”、怎么向彼此取用信息,就能形成分布式的记忆能力。应用到人与数字伙伴组成的团队,我们更关心知识能否找到、来源能否核实、下一位执行者能否正确使用,而不要求所有成员都读完全部历史。这是把理论搬过来用与实践相结合。
PC团队使用内部的记忆库与检索机制,把会话、Wiki和本地记忆纳入召回流程。可复用经验至少需要携带来源路径、内容版本、适用条件和反馈。来源文件同名并不代表内容没变,所以后续索引改为结合路径与内容哈希保存版本;需要时回读现行来源,历史快照仍用于解释当时的判断。
反例同样要能回流。一个旧答案被证明不适用,负向反馈应当定位到那个内容版本及任务范围,避免它下次又被高排名召回。整页 Wiki 往往包含多轮记录,不能因为其中一段回答有用就宣布全页永远可信,也不能因为一段出错就抹掉所有历史。
这套机制也经历了自己的纠偏。一次检查发现控制器已有事件和候选记录,却没有产生预期的结果反馈;原因涉及一处管理名单字段与实际标签未对齐。这说明“系统每天都在运行”仍需落实到输入、命中、使用与结果几层证据。后来检索参数的比较还加入保留样本、逐例回归和失败回滚,但这些内部评估不等同于独立的人类验收,也不能直接换算成团队效率提升。
这里的成长都发生在外部资产上:新的索引、更清楚的流程、更准确的适用条件、经过复核的技能。这不代表基础模型的权重会跟着每段群聊自动更新。维护这套资产也需要负责人:旧链接会失效,仓库会迁移,岗位会变化,曾经正确的发布方式会过期。数字伙伴工作越久,这份维护责任越重要。
记忆侧也有一本账。记忆进化账本每天凌晨自动整理,扫描当天会话,把可复用的经验提炼成候选,账本里已经积累了大量过程记录与待审经验。晋升纪律是重头戏——候选要经过回放验证、保留样本、小流量试用三道关,最终批准必须由与提案创建者不同的人完成;召回时命中的经验如果被反馈“错了”或“已纠正”,会自动转入隔离区,避免下次又被高排名召回。账本只保存脱敏摘要和指纹,不保存会话原文。宁可慢,不可错。
技能侧的积累同样来自真实错误。一次桌面端“不显示选集”的回归事故,根因是布尔条件里少了一对括号,运算优先级改变了业务语义;反馈后很快完成回滚并确认恢复。但事故处理没有停在“修好了”:复盘把这类逻辑组合沉淀为 Code Review 检查项和测试组合,并提出流水线候选门禁。数字员工可不可靠,不看它犯不犯错,看每次错误能不能变成让下次更难再犯的机制。
07#
SDLC试验:
数字伙伴开始承担
完整交付链中的岗位
7.1 把生命周期拆成可检查的产物
SDLC(Software Development LifeCycle)是软件开发生命周期。Anthropic的 AI-native SDLC playbook 用 Plan、Design、Build、Test、Deploy、Maintain 描述从意图到持续维护的六类工作,并强调阶段之间可以反复往返。模型参与各阶段以后,人仍需要给出目标、约束和评审标准,产物则为后续协作保留上下文。
这套 Playbook 不是孤立出现的。Anthropic 过去一年走了三步棋,几乎每一步都能在 PC 团队的实践里找到呼应:
时间 | 动作 | 组织含义 |
|---|---|---|
2025 年 8 月 | Claude Code 并入 Team / Enterprise 计划 | AI 编程从个人工具变成组织可管理的资源:支出上限、使用明细 |
2026 年 6 月 | Claude Tag 上线 Slack 公测 | Claude 以自己的身份成为频道成员:共享上下文、持续记忆、主动介入、异步执行 |
2026 年 8 月 | 发布《The AI-Native SDLC Playbook》 | 用 intent、spec、门禁、Evals 重构软件开发生命周期 |
Playbook 把软件开发生命周期重构为六个阶段:规划阶段的 intent.md、设计阶段的 spec.md、构建阶段的 plan.md 与自动模式、测试阶段的持续 Evals、部署阶段的 Hooks 确定性门禁、运维阶段的闭环自愈——监控脚本发现指标突破控制带,自动调用 Claude 诊断,把结论写成新的 intent.md 重新进入循环,Claude Tag 在值班频道里做第一响应人。支撑这套流程的是一组数字:Claude 已经编写了 Anthropic 当前约 80% 的合入代码,工程师平均每季度交付的代码量达到 2021 至 2025 年时期的约 8 倍。
对照这三步看 PC 团队自己的路线:Claude Tag 做的事——频道成员身份、共享上下文、异步推进、主动介入——正是 cc-connect 加 IM-Native 在飞书里做的事,而且起步更早,在身份治理上走得更远(五层架构、指定执行人监护、接力轮次阻断)。区别主要在管理对象:Claude Tag 背后是同一家模型,而 PC 团队要管理一支混合编队,GLM、Kimi 各有脾气,所以必须多造一层协议和门禁。SDLC 层面,Playbook 发布时,我们就已经在评估测试了,intent、spec、门禁、证据这些概念几乎一一对应——方向被行业头部验证,这比任何内部汇报都更能说明问题。
“PC-AI-Native SDLC测试群”把这件事放进了实际研发流程。前端链路使用 Plan、Ui、FeDev、FeTest、FeRelease、Observe、Close 等阶段名:前两项确认需求与界面,Fe表示前端,Observe检查上线后表现,Close记录验收与遗留事项。遇到后端需求,则需要适配相应研发、测试和发布角色,不能机械复用前端路由。
一次交接至少要能回答三件事:交付对象是哪一版,依据在哪里,下一位具体检查什么。MR是代码合并请求;commit固定代码内容;构建版本固定测试或生产环境里的产物;流水线 run_id 固定一次交付运行;审批单固定获准执行的范围。这些标识各有各的用途,不能用一句“已完成”的文字回执顶替。
规则浓缩在一本《SDLC 全员职责与 IM-Native 融合手册》里:Captain 对授权需求从接入到上线观察、交接和关闭负责;专业角色对各自产物与结论负责;真人承担明确授权范围之外的决策。真人一侧保留五类门禁,每类都规定了介入时机和决策所需材料:
真人角色 | 保留的决策 | 介入时机 |
|---|---|---|
SDLC Sponsor | 角色资源冲突和超授权事项 | 协调失效或超出授权边界时 |
Product Owner | 目标、范围和验收语义 | 需求界定与最终验收 |
Code Owner | 高风险改动批准 | 触及高危清单的代码变更 |
QA Owner | 例外放行 | 测试未完全覆盖但申请放行时 |
Release Manager | 首次生产发布和回滚 | 发布与回滚节点 |
已有明确且仍有效的授权不应重复询问,需要决策时必须一次给出可审阅材料。同时,每个数字伙伴也应遵守的岗位指令:人和机器人参与讨论,不自动产生审批权。
下面是据此整理的最小交接记录示例,用来说明信息关系。
交接示例:版本、证据、裁决对象需要彼此对应requirement: <需求标识>stage: <当前阶段>revision: <当前修订标识>artifact:merge_request: "<合并请求编号>"environment: "<独立测试环境>"deployed_version: "<构建版本号>"evidence:report: "<本轮测试报告链接>"coverage: "<用例数,列明失败与未覆盖项>"decision:reviewer: "<本阶段有权确认的人>"applies_to: "<上述需求范围与实际版本>"next:owner: "<交付岗位>"prerequisite: "测试确认 + 发布范围确认 + 相应审批"
流程中的人工确认有明确对象:某份需求、某个测试版本、某次发布范围。需求或版本实质变化后,原先的批准不能自然延伸到新对象。团队后来经历的换分支与重测,正好把这个原则检验了一遍。
7.2 需求A :一处文案,跨了三个服务
需求A要把短剧、漫剧、短视频播放器左下角的提示改为“含AI生成内容”。从页面看,这像一个简单的文字替换。产品调查先发现文案来自门户服务的文案处理逻辑;开发在进入实现前又发现播放器服务有第二处硬编码;范围继续核对,一个频道二级页成为第三个改动点。
这个需求在一个工作日下午发起;PC研发智能体先完成代码调查并建好工单;负责开发的智能体在构建前核验时主动 BLOCKED——它发现的第二处硬编码在播放器服务,这个拦截直接避免了漏改;随后三个改动点的合并请求齐备,独立评审当天全部通过。从发起到评审通过,用时不到一个工作日。
同事持续补充了边界:PCW与PCA都覆盖,专辑流与播放流都覆盖,不改变点击行为与样式,兜底文案保持原样,PPC播放器不在本轮范围。需求说明经过多轮修订后到达v0.4。这个过程说明产品范围和代码范围要互相校正:页面上的一句话,背后可能挂着好几条服务链。
改动涉及的服务 | 核心改动位置 | 同时核对的行为 |
|---|---|---|
门户服务 | 文案处理逻辑的分支 | 文案与对应测试,补充验证用例 |
播放器服务 | 播放信息组装逻辑 | 修改目标文案,保留非目标分支行为 |
频道服务 | 工具逻辑与配置默认值 | 硬编码、云端配置默认值及各频道用例 |
三份合并请求完成,独立代码评审也给出通过意见,但测试仍出现了问题。早期报告计划10项,只执行7项,7项通过,另有3项未覆盖。测试同学继续追问完整需求测试链路与第三个改动点的覆盖范围。这时“已执行用例全部通过”不能被写成“全部需求验证通过”,更不能因为评审通过就略过测试。
后续补齐的交付记录包含21项完整链路用例,结论为有风险通过;预发回测中两个改动点分别全数通过。代码进入主干之前还有一次明确的人类授权。随后本批两个服务上线;播放器服务由专人另行上线,明确列为本批范围外。
线上验证也留下了对照。生产接口中,AI 相关样本返回新文案“含AI生成内容”,非目标类型样本保持原有文案不变。验证以旧文案表现为基线,记录了多个时间点,次日早晨又复查了一次。随后产品负责人明确回复“验收通过”,任务进入关闭状态。若干执行通道与独立验证途径等遗留项仍随交付移交,不能把这些空白涂成全绿。
整个过程并不顺,而这恰恰是案例的价值。测试阶段反复了几天:测试助理无回执、服务网关异常、口径拆分误导、覆盖缺口被真人测试同学当场质疑“未覆盖为什么算测试通过”。每一次波折都被门禁拦下,由真人纠偏,记进复盘。合并授权阶段的拉锯战前文已述——Captain 三次拒绝凭转述执行生产合并;随后两个服务先后全量上线,产品负责人验收关账。这是唯一一个由数字伙伴全流程推进、走完整链路的真实后端需求,复盘报告有完整的甘特图和逐日消息时间线,任何人可以回放审计。
这次试验的成果相当具体:数字伙伴能追踪分散在三个服务中的实现,形成代码与测试产物,配合人把它们送到生产并完成限定范围的验收。过程也把原本隐含的组织知识暴露出来——送测用哪个分支,谁能批准合并,什么时候通知测试,哪些未覆盖项必须单列。后续团队可以复用这些明确约定,而不必重新经历同样的误会。
7.3 需求B :一句口语,不能代替项目流程审批
需求B要把首页左侧导航的多处链接归一为HTTPS。开发产出合并请求,形成测试包;测试按最新口径独立执行,最终20项通过。当天流程完成了规划、界面、开发与测试阶段,随后按产品负责人要求终止,发布、线上观察与关闭阶段没有执行。平台将其记为 cancelled,不能把这次试验写成全流程上线成功。
过程中,测试负责人说“我看着可以pass”。Captain把这句口头印象当成了门禁通过,还向下游请示上线。测试负责人立即指出:“你在曲解我的意思。”研发智能体回滚了流程;直到测试负责人明确给出“测试pass”,测试阶段才继续推进。
这件事暴露的不是一个关键词识别问题。即便一句话里出现pass,系统也要知道谁在说、针对哪份产物、是不是作正式决定、前文是否仍在讨论。否则,自然语言里保留余地的表达,会在自动化链路中变成确定动作。复盘还记录了测试执行者误派、确认人绑定错误、重复@和群内长消息等问题,逐一形成了后续约定。
需求B的代码后来进入与需求C同包的交付链,属于后续事实;它不会改变那次演练按指令终止的状态。把任务边界和后续复用分清楚,团队才能准确评价一次流程到底走到了哪里。
7.4 需求C :从节前停线,到节后真实关闭
需求C 要求把首页隐私政策链接改为一个指定的 HTTP 地址。这里的 HTTP 是已确认的需求目标;其他属于需求B 的 HTTPS 改动保持各自范围。两个需求同包后,这个细小区别后来成了一次实际误判的来源。
长假前的最后一个工作日,数字伙伴完成需求确认、界面范围确认、开发和26项测试。进入交付时,发布白名单阻塞,随后按假期停线指令停止,当次流水线运行作废,当日生产零变更。早期复盘里的“数小时”描述的是这一阶段从发起到停线的历时,不能拿来代表最终上线耗时。
第一阶段的耗时构成,是复盘从完整的链路会话记录和路由日志里逐条抽取出来的:
阶段 | 状态 | 关键动作与通过条件 |
|---|---|---|
范围确认 ✅ | 完成 | 需求与界面范围确认,有权的产品与设计角色分别批准 |
开发 ✅ | 完成 | 提交合并请求,负责人评审后合并 |
独立测试 ✅ | 完成 | 全量用例在独立环境执行,测试负责人放行 |
人工批准 | 停线 | 假期停线指令到达,当次流水线运行作废,当日生产零变更 |

假期后恢复时,人的质询促使团队重新核对临时分支的依据及包内容。原先设想只带两个需求,实际包内却包含停线前的其他常规开发内容,原发布范围的前提不再成立。负责人裁定停掉原运行,切换到正式基线。开发重新摘取两个需求的改动,生成新的合并请求,核对改动等价性,单元测试全部通过,再进入构建和测试。
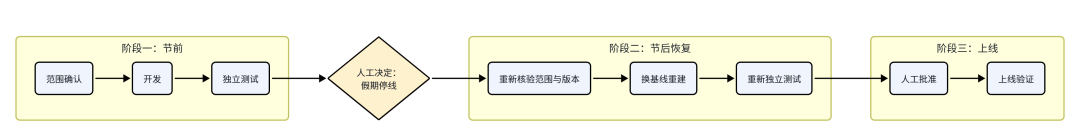
图5 需求C的三个阶段。节前开发测试完成不等于生产交付完成;节后范围与环境变化触发重新核验。
恢复日有两个细节,值得单拎出来说。第一是裁定过程:负责人发出恢复指令后,管理员要求上线前先完成代码评审,评审结论为无阻断项、有少量风险与建议;交付侧随后完成“假设证伪”——生产并不处于原设想的状态,旧包的上线增量不等于“恰好两笔改动”,原发布范围的前提不再成立;交付侧发起 A/B 裁定请示(A 照发知情增量,B 换正式基线停单重建重测),有权的同事裁定走 B。B 路随即执行:正式基线复跑全绿,生成新的合并请求并通过评审,重新构建测试包。期间还留下一条派工纠偏:交付派工只传“什么需求打包、哪个分支迭代”,不得夹带推断。这条口径后来固化进流程。
第二是测试端的多轮攻坚。第一轮全量用例绝大部分通过,但测试环境在测试过程中发生版本漂移,两条用例未能闭环;测试负责人随即给出指令:判定漂移是偶现还是必现,偶现重试,必现给原因与方案。第二轮判定为必现——固定入口的服务端链路持续提供不同版本。交付侧查到测试环境被当日例行构建污染,改投隔离车道,重打测试包。后续几轮卡在一个意想不到的地方:两条用例需要测试机管理员授权修改系统 hosts,数字伙伴多次阻断后转人工桌面执行;期间还发现备案入口目标站返回异常,数字伙伴据此提交了缺陷单并附多份证据。测试负责人发来一段真人操作视频复验,最终人工复验通过,问题定性为测试工具问题而非需求缺陷,测试门禁闭环:绝大部分用例直接通过,受阻的两条由人工复验通过。
负责人在群里发出确认上线;随后建立新的流水线运行,测试同学执行发车,进入三人逐级审批。夜间审批一度停滞,系统按规则催办、升级,随后转入夜间静默——系统没有替人催第三次,更没有替人作决定。
重新构建也没有消除所有问题。测试使用的环境被人工重发的旧包覆盖,新构建的包不再是实际被测对象,导致本轮测试失败。团队随后隔离车道,重新出包,再完成复测。这个问题说明测试报告至少要绑定“需求、代码、构建、环境中的实际版本”四者;仅有一个报告链接,无法保证验的是将要发布的内容。
假期后第二天,交付继续通过审批、发布、线上观察和回测。线上回测曾给出 FAIL,后来发现 Captain 在派工时把隐私链接目标误写成 HTTPS。重新读取权威数据源并对照需求中的 HTTP 目标后,结论改为 PASS。人对一句需求的限定,必须在跨岗位转述时保持准确;数字伙伴不能凭“通常更好”的惯例自行替换目标。
最终明确记录:流水线运行成功,审批单闭环,生产版本与需求范围一致;上线观察获测试负责人通过,相应角色完成关闭确认,任务 done。与此同时,需求管理平台中的完成日期和测试工作量仍列为待收尾。交付关闭、业务系统字段补齐和长期观察项需要分别跟踪。
关闭当天上午的收尾同样留痕完整:管理员说明“本需求非紧急需求,夜间可暂缓上线,今日上午会继续推进”;三人审批链在上午陆续通过;随后进入“测试确认”人工节点,测试侧放行;灰度加全量完成,生产版本完成升级,交付侧两次复测稳定;最后补发上线完成审批。全周期从授权到生产生效跨了一个假期:自然时间跨度超过一周,其中大部分是假期封网,有效执行约两个工作日,生产改动为一行。
复盘共归档了十余起协同事件,最大的一起就是临时分支与正式基线的选择假设错误;其余包括测试车道被例行构建污染、hosts 授权多次阻断、备案站异常误报建缺陷、需求平台报告人映射缺失、缺陷关联错项目等。几起流程沉淀已经落地:派工口径规范、需求平台回写兜底路径、测试工具问题人工复验定性先例、测试独占车道实践。这些条目读起来琐碎,但每一条都对应下一次同类需求可以少踩的一个坑。
真正值得注意的是这条跨了好几天、跨了节假日的链路本身:停线了能保住状态,恢复后重查前提,范围对不上就换线,环境漂了就重测,审批、版本和最终回执一路串下来。这已经不是单次代码生成能盖住的活了。人也没有退出,业务范围、技术争议、发布授权,还是人来拍板。
7.5 这些成果已经能证明什么
案例 | 留下的可验证成果 | 评价时保留的边界 |
|---|---|---|
需求A :AI提示文案 | 三个服务的合并请求、独立评审、补充测试;其中两个服务本批上线并验收关闭 | 播放器服务另行发布;风险与未覆盖项随交付移交 |
需求B :导航HTTPS | 合并请求、测试包、独立20项测试通过;语义误判得到纠正 | 演练按人指令终止,未执行当轮生产发布 |
需求C :隐私政策链接 | 换线合并请求、重建重测、流水线运行成功、生产生效后关闭 | 经历停线和返工;业务字段收尾及长期观察继续跟踪 |
三次试验展示了不同层面的进展:从定位跨服务实现,到形成独立测试,再到维持长周期交付状态和完成上线验收。它们也提供了一组比“机器人回答得很专业”更扎实的评价对象:代码差异、测试覆盖、环境版本、审批对象、生产回执和人的最终确认。
这些记录还证明不了所有需求都能无人处理,也算不出一个普遍适用的效率倍数。样本里仍有多次人工纠偏、路由修订和环境干扰。这些细节留着,才能对照判断自己手里的条件和约定够不够。
架构层面,M0 阶段还沉淀了三条写给后来者的决策:第一,流程是否发生以 SDLC 服务中的状态迁移成功为准,不以 LLM 判断或群聊消息为准;第二,Captain 是统一入口,不持有任务运行状态;第三,PMS 记录业务需求,SDLC 服务记录工作项和执行过程,群聊只承担协作、通知和过程可见性——三者各司其职,互不越位。
08#
把“高效”量清楚,
也给团队留出适应过程
8.1 等待流水线的时间,不能全算成数字员工工时
需求C 关闭后的复盘最初把交付工程师耗时记为一个明显偏高的数字。负责人提出疑问:这个数字明显比正常流水线执行时间还长。重新切分记录后发现,“派发到回执”的整段时间混入了构建流水线、发布流水线、部署与冒烟测试等系统运行时间。数字伙伴在其中主要做触发、核验和回执,它并没有在整个窗口里持续执行有效动作。
更正后的估算把交付工程师动作时间调低了一大半,其余划回流水线系统执行;全案数字员工累计估算也随之明显下修。其余角色中仍有根据回执区间估算的部分,不能把这个数当成精确的执行遥测,更不能当成已经节省的人工工时。
这个例子也解释了为什么不宜把所有时间简单相加。多个智能体可能并行,流水线与人的审批也可能交错。端到端历时描述用户等待了多久,各角色累计动作时间描述投入,两者回答不同问题。若想测净收益,还需要相近复杂度、相同验收标准的人工基线,以及人工复核和返工投入。
建议长期记录的指标 | 计算或记录方法 | 它帮助发现的改进点 |
|---|---|---|
端到端交付周期 | 从范围确认到最终验收;另列停线与业务等待 | 工作究竟卡在执行、审批还是排队 |
人工实际投入 | 提需求、澄清、复核、纠偏与接管分别记录 | 自动化是否真的减少同事负担 |
数字伙伴动作与系统等待 | 用任务时间线区分工具操作、模型处理、构建和外部等待 | 该优化模型、流程还是基础设施 |
首次通过与返工 | 按需求版本统计首次验收、重做原因和受影响阶段 | 快速产出是否换来了更多后续修补 |
交付可追溯性 | 需求、commit、构建、测试环境、审批与生产版本能否对齐 | 结果是否可以独立复核和恢复 |
协作噪声与中断 | 误派、重复通知、错误裁决、人工纠偏次数 | 团队的注意力是否被自动化消耗 |
这些指标可以先从少量任务开始记录,不必一开始搭建庞大的仪表盘。需求C 的一次工时质询,已经帮助团队看见了模型执行之外的构建吞吐问题。衡量方法越接近真实工作,就越容易决定下一步到底改哪里。
更早的规模数据来自季度运营报告,同样只使用可回溯的原始口径。出于口径与保密要求,具体数值不在本文列出,只保留趋势性结论:用户输入轮次、独立会话与活跃日都显示出持续的生产使用;任务包含大量真实工具交互,但有效执行仍需结合成功率与重试率判断;活跃 Worker 覆盖多个逻辑岗位;Wiki 证据沉淀有基础,但尚未完整覆盖。
价值报告还给过一个方向性测算:以会话样本估算人工耗时与 Agent 活跃耗时,得出一个节省工时与效率倍数的估计。这类数字必须带着口径一起读:它是基于任务分类与耗时假设的模型估算,不是工时系统的实测 KPI;Token 遥测的覆盖率也不完整,不足以推导完整成本。AI总喜欢把估算、模糊的只言片语当成依据来总结汇报,这是实践中要着重关注,需要对智能体进行约束。
8.2 适应时间取决于共同规则建立了多少
现有记录无法给出“一个团队需要几周适应数字伙伴”的通用答案。熟悉业务系统、已有规范与自动化基础的团队,和文档分散、接口权限缺失的团队,起点差别很大。PC团队从日常问答走到跨角色SDLC的这些案例横跨数月,也不能直接当作大家导入数字伙伴所需要的时间。
一个常见的问题是:团队要多久才能适应数字伙伴。PC 团队的回答是:从“能对话”到“能共事”,大约三个月;从“能共事”到“敢托付”,现在还在路上。周报里的时间线比任何总结都有说服力。年中时,数字伙伴之间刚能完成一轮像样的业务对话,成本还高得离谱;后来团队给 SDLC 能力做了一次自评,分数打得很低,评语写得很直白:“在较强人工护航下能完成一次端到端交付,还不能稳定、低人工、可度量地连续运行。”不久后,M0 闭环跑通。适应期的后半段不是线性爬坡,而是制度和协议就位之后的陡升。
适应是双向的。人这一侧的变化同样明显:派活的同事学会了把验收标准说清楚,因为“说清楚”直接决定数字伙伴的交付质量;做授权的同事学会了把授权边界给明确,因为模糊的授权会被门禁拦下;评审的同事学会了看证据链而不是看结论。数字伙伴这一侧最大的进步,是学会了说“无法确认”——在证据不足时拒绝归因。一支团队和一群数字伙伴,就这样互相改掉了对方的干活方式。
Tuckman关于小组发展的研究,把群体发展描述为形成、冲突、规范和有效协作等阶段。它来自对人类小组的研究,没有研究今天的研发智能体,也没有给出固定日程。拿它作类比,可以留意一种常见的变化:起初大家在试探能力,随后因范围和责任起摩擦,慢慢形成约定,最后才能稳定配合。
对人+数字伙伴组成的新团队来说,这种适应至少同时发生在三处。同事在学习怎样提供必要背景、怎样核验结果;数字伙伴的外部记忆与技能在补充团队的业务词义和操作规则;协作系统在修复消息投递、恢复、权限和版本绑定。只教人写更长的提示词,无法解决后两类问题。
照这个思路,可以设计一个按能力晋级的试点,不用承诺哪天一定成熟。第一阶段选择高频、可回查的小任务,例如资料查找与文档整理,检查引用和结果是否可靠。第二阶段让同类任务重复发生,观察上次纠偏能否在下一次生效。第三阶段接入开发与独立测试,要求交接产物和环境版本可核对。最后才扩到发布与长期维护,让人在明确节点作决定,并演练取消、重启与失败恢复。
每次晋级都要有实际任务证据。一个新伙伴可能检索能力很强,却还不会理解团队口语;另一个能改代码,却没有正确的生产权限与发布经验。允许它各项能力有先有后,保留随时退回人工的路,比一上来就按“全能员工”期待它,更容易处得长久。
09#
我们总结的七条建议
七个月的实践可以压缩成七条可操作的建议,每一条背后都有前文对应的案例或教训:
1、先身份,后账号。把数字员工登记进 IAM 花名册、锚定责任 Owner,再谈 OA 账号;跳过治理直接发证,是在批量制造“有工牌、无主管”的影子员工。
2、先门禁,后自治。高危清单永远人审;自治范围随证据成熟度逐步扩大,不以 LLM 的自我判断为准——流程是否发生,以状态系统的迁移记录为准。
3、先小闭环,后全链路。用一个真实需求端到端跑通,再谈平台化;成熟度要敢打低分,一次诚实的低分自评比漂亮的汇报数字有用得多。
4、教会数字伙伴说“无法确认”。证据文化比答案重要;分析结论标注“直接事实、代码推断、间接推断、无法确认”四档,没有证据闭环时禁止猜测。
5、结论必归档。群消息会消失,Wiki 不会;每轮结论当场落档,档案要包含诉求、证据、改动、验证和遗留风险;缺证据写 BLOCKED,而不是硬答。
6、记忆要治理。经验采纳生效要走 Replay、Holdout、Canary 和人工批准;被纠正的记忆自动隔离;账本只存脱敏摘要和指纹,不存会话原文。
7、保留失败。失败路径、停止条件和调整依据同样是可复用经验;复盘里如实记录误判,比只陈列成果更能帮助后来者。
10#
结语:数字伙伴的“人品”
回看这些实践,推动协作前进的往往是很日常的几句话:告诉数字伙伴“将脚本内容发给我”,让回答变成了工具;对测试覆盖的追问,让通过率恢复了真实含义;对一笔偏高工时的质疑,让工时统计重新贴近实际工作;“你在曲解我的意思”,让一句口语和一次门禁裁决从此分开。数字伙伴把检索、执行和记录承担起来,人则不断把业务语义、经验与责任补进过程。
七个月下来,团队对数字伙伴的信任,不来自它们有多聪明,而来自三件更朴素的事。可预期:它们在规则之内行事,深夜做的操作和白天一样,受同一套规则约束。可审计:每一步有证据、有归档、有回放。可成长:经验沉淀为资产,而且资产接受治理。
公司和组织架构是人类几百年进化的成果,它解决的核心问题从来不是“怎么让人干得更快”,而是“怎么让一大群人的协作不失序”。数字伙伴的加入不是绕过这套成果,而是融入它,让它继续演化。管好数字伙伴——守身份、守门禁、留证据、肯认错——是 PC 研发团队的做法,也是这篇文章最想交出去的经验。
一个团队从这些工作中积累下来的,不只有交付结果,还有后来者可以继续使用的脚本、证据、需求约定和排障方法。等下一位同事接到相似的问题,能找到前人的纠偏、回查当前事实、在同一条协作链上接着干,研发智能体才算真正成了团队里高效又可信的数字伙伴。
11#
参考阅读
外部原理与行业动态:
Anthropic, The AI-Native SDLC Playbook, 2026-08-21;How Anthropic secures its AI-native software development lifecycle, 2026-07-21
Anthropic, Claude Tag Slack 公测公告, 2026-06;Claude Code 并入 Team / Enterprise 计划, 2025-08;Claude Code Agent Teams 官方文档(实验性能力)
Gartner, 2026 年安全趋势:IAM 适配 AI 智能体 / From Tools to Actors
IETF, RFC 8693 OAuth 2.0 Token Exchange;AI Agent On-Behalf-Of 授权草案
OWASP, Agentic Applications Top 10 (2026),ASI03 身份与权限滥用
Okta 2025 非人类身份(Non-Human Identity)战略调研
Coase, The Nature of the Firm, 1937;Simon, The Architecture of Complexity, 1962;Tuckman, Developmental Sequence in Small Groups, 1965;Wegner, Transactive Memory
约翰·霍兰德《隐秩序:适应性造就复杂性》(复杂适应系统);彼得·圣吉《第五项修炼》(学习型组织)
Snyk,公开 Agent Skills 安全研究(13.4% 存在 critical 级问题)
本文转载自微信公众号「爱奇艺技术产品团队」,查看原文。版权归原作者所有,如有侵权请联系删除。